ملاحظة الكاتب: عند مقارنة تكاليف النماذج، قد يؤدي الاكتفاء بسعر كل مليون token إلى اختيار خاطئ. تقدم هذه المقالة إطارًا للحساب يعتمد على «سعر الوحدة × الاستهلاك الفعلي من token»، مع خطوات كاملة لإعادة الاختبار على عينة صغيرة من مهامك.
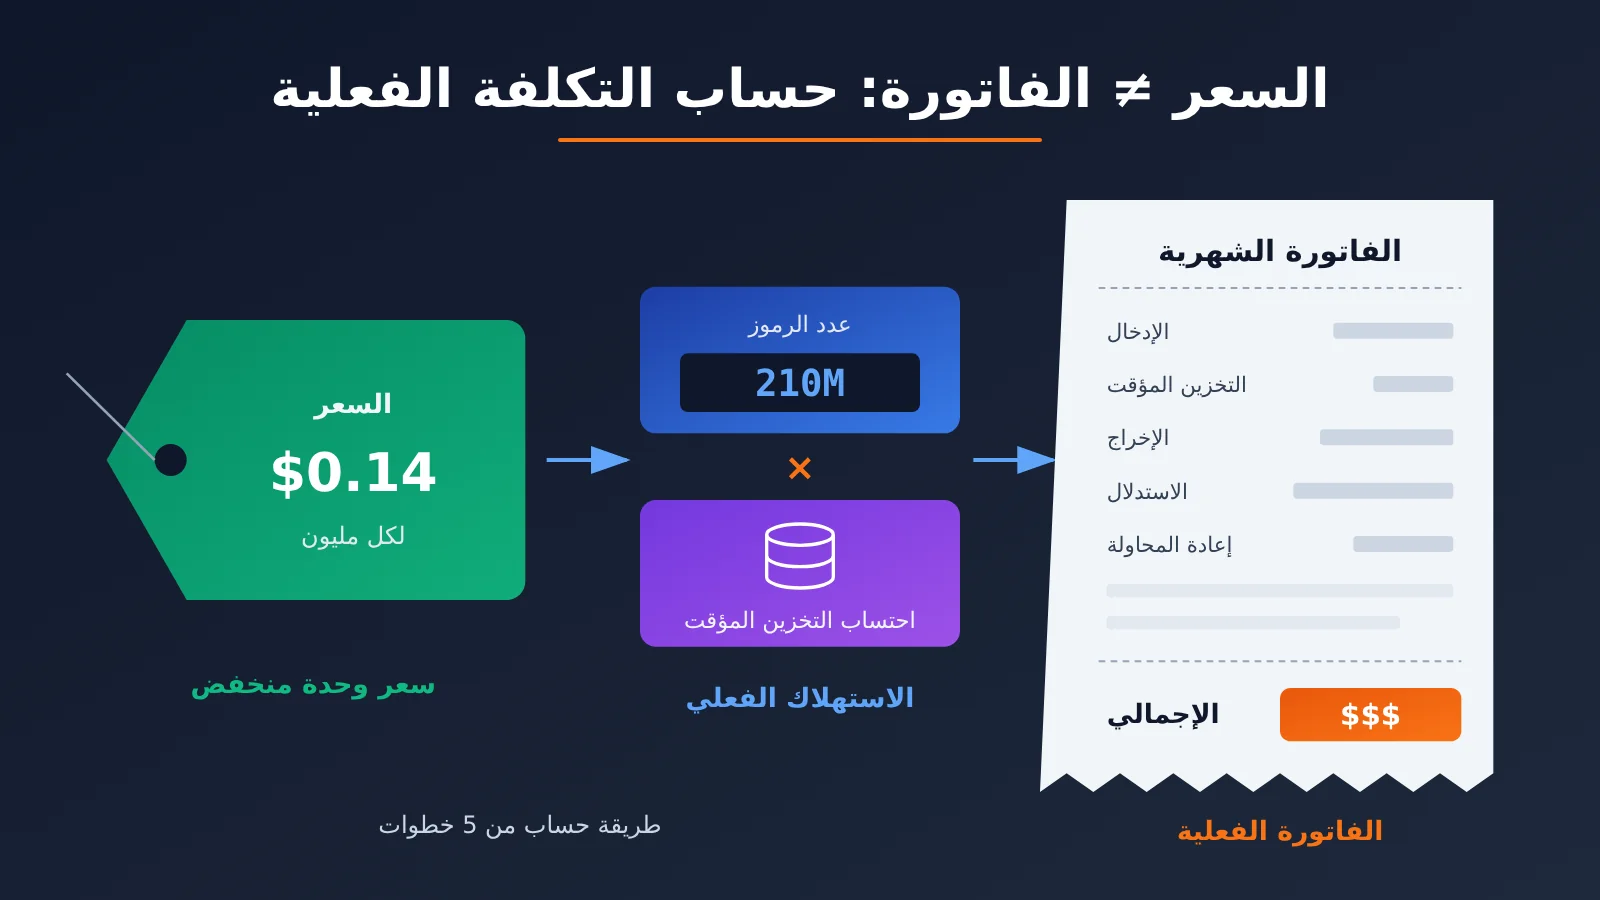
عند اختيار نموذج، تبدأ فرق كثيرة بصفحة الأسعار: ترى أن النموذج A لا يكلف سوى أجزاء من اليوان لكل مليون token، بينما يكلف النموذج B عدة دولارات، فتفترض أن A أوفر. لكن فاتورة نهاية الشهر كثيرًا ما تخالف التوقعات، وقد يكون النموذج «الرخيص» أكثر تكلفة في النهاية. تشرح هذه المقالة طريقة حساب التكلفة الفعلية: «سعر الوحدة × الاستهلاك الفعلي من token، مع احتساب أثر التخزين المؤقت»، لتساعدك على تقدير التكلفة بوضوح قبل اختيار النموذج.
هذه ليست مجرد مقالة أخرى تجمع جداول الأسعار. فجداول الأسعار تتغير، أما طريقة الحساب فتبقى مفيدة. سنستخلص إطارًا عامًا من حالات فردية في حسابات منشورة، ثم نعيد الاختبار باستخدام مهامك أنت.
الفائدة الأساسية: بعد قراءة المقالة، ستتمكن من توضيح سبب عدم تطابق السعر المنخفض مع فاتورة منخفضة، وقياس تكلفة المهمة الواحدة لكل نموذج مرشح باستخدام 20 إلى 50 طلبًا حقيقيًا.
أبرز النقاط حول التكلفة الفعلية للنموذج
| النقطة | التوضيح | أثرها على اختيار النموذج |
|---|---|---|
| سعر الوحدة مجرد عامل واحد | الفاتورة = عدد رموز token من كل نوع × سعره، ثم جمع النتائج | مقارنة أسعار الوحدات وحدها تعني النظر إلى نصف المعادلة فقط |
| اختلاف تقسيم النص إلى رموز | يختلف عدد رموز token التي يُقسَّم إليها النص نفسه من نموذج إلى آخر | يجب حساب تكلفة الإدخال بناءً على العدد الفعلي لكل نموذج |
| رموز الاستدلال | تُحاسَب عملية التفكير في نماذج الاستدلال عادةً بسعر الإخراج، رغم أن المستخدم لا يراها | قد تكون الإجابة الظاهرة قصيرة، لكن الفاتورة مرتفعة |
| استخدام ذاكرة التخزين المؤقت | عند العثور على بادئة متكررة في ذاكرة التخزين المؤقت، تُحاسَب بسعر أقل | يظهر فرق كبير مع موجهات النظام الطويلة والمحادثات متعددة الجولات |
| معدل النجاح وإعادة المحاولة | تتطلب الإجابات الخاطئة أو غير المطابقة للتنسيق إعادة التنفيذ | التكلفة الفعلية = تكلفة المحاولة الواحدة ÷ معدل النجاح |
لماذا تؤدي مقارنة سعر المليون token وحده إلى حساب خاطئ للتكلفة الفعلية؟
يقيس سعر المليون token «تكلفة كل token»، بينما تقيس الفاتورة «تكلفة إنجاز مهمة». وبين الاثنين متغير أساسي: عدد رموز token اللازمة لإنجاز المهمة. وغالبًا ما يكون الفرق بين النماذج في هذا المتغير أكبر من الفرق في أسعار الوحدات.
يظهر مثال على ذلك في حساب أجرته مدونة مستقلة في 1 أغسطس 2026: حصل كل من DeepSeek V4 Flash وGemini 3.6 Flash على الدرجة نفسها في Artificial Analysis، وهي 50 نقطة. وكان السعر المعلن للأول $0.14/M، وللثاني $1.50/M، أي بفارق يقارب 10 أضعاف. لكن في مجموعة الاختبارات نفسها، استهلك الأول نحو 210 ملايين token، والثاني نحو 59 مليونًا، بفارق يزيد على 3 أضعاف. وهكذا استهلك الفرق في عدد الرموز جزءًا كبيرًا من ميزة السعر، فأصبح الفارق الفعلي أقل بكثير من 10 أضعاف.
ومن الأمثلة الأخرى اختلاف تقسيم النص إلى رموز. ففي مقال نُشر في 12 أغسطس 2026 من المصدر نفسه، أُرسلت وثيقة متطابقة إلى 9 نماذج لحساب عدد رموزها. وتراوحت النتائج بين 614 و957 token، بفارق يقارب 56% بين الحدين الأدنى والأعلى. أي إنه حتى لو تساوى سعر الإدخال تمامًا بين نموذجين، فقد تزيد تكلفة إدخال الموجه نفسه في أحدهما على الآخر بأكثر من النصف.
💡 ملاحظة حول البيانات: الأرقام أعلاه مأخوذة من قياس واحد أجرته مدونة مستقلة. ومهام الاختبار وإصدارات النماذج والأسعار تتغير بمرور الوقت، لذا تصلح هذه الأرقام لإثبات وجود الظاهرة فقط، ولا يمكن استخدامها مباشرةً لإعداد ميزانيتك. عليك إعادة الاختبار باستخدام مهامك أنت.
مكوّنات فاتورة النموذج: ما أنواع الرموز التي تحدد التكلفة الفعلية؟
لحساب التكلفة بدقة، علينا أولًا معرفة بنود الفوترة. يمكن تقسيم رسوم معظم مقدمي الخدمة إلى الفئات التالية، مع الرجوع إلى الوثائق الرسمية لكل مقدم للتحقق من أسماء البنود وما إذا كانت تُحتسب منفصلة.
| بند الفوترة | المعنى | طريقة التسعير الشائعة | نقطة يسهل إغفالها |
|---|---|---|---|
| الإدخال غير الموجود في ذاكرة التخزين المؤقت | الموجه المرسل حديثًا الذي لم يُعثر عليه في ذاكرة التخزين المؤقت | سعر الإدخال | تؤثر طريقة تقسيم النص إلى رموز في التكلفة، فقد يختلف سعر النص نفسه |
| الإدخال الموجود في ذاكرة التخزين المؤقت | جزء البداية المطابق لطلب سابق | سعر قراءة ذاكرة التخزين المؤقت، وعادةً ما يكون أقل بكثير من سعر الإدخال | يجب أن تتطابق بداية الطلب تمامًا للاستفادة من ذاكرة التخزين المؤقت |
| الكتابة في ذاكرة التخزين المؤقت | يفرض بعض مقدمي الخدمة رسومًا منفصلة عند الكتابة الأولى في ذاكرة التخزين المؤقت | قد تكون أعلى من سعر الإدخال العادي | قد تصبح التكلفة أعلى عندما يكون معدل الاستفادة من ذاكرة التخزين المؤقت منخفضًا |
| المخرجات المرئية | الإجابة التي يراها المستخدم في النهاية | سعر الإخراج | يكون سعر الإخراج عادةً عدة أضعاف سعر الإدخال |
| رموز الاستدلال | عملية التفكير الداخلية للنموذج | تُحسب عمومًا بسعر الإخراج | لا تظهر في الإجابة، لكنها تُحتسب في الفاتورة |
يمكن جمع هذه البنود في المعادلات التي تشكل إطار الحساب الأساسي لهذا المقال:
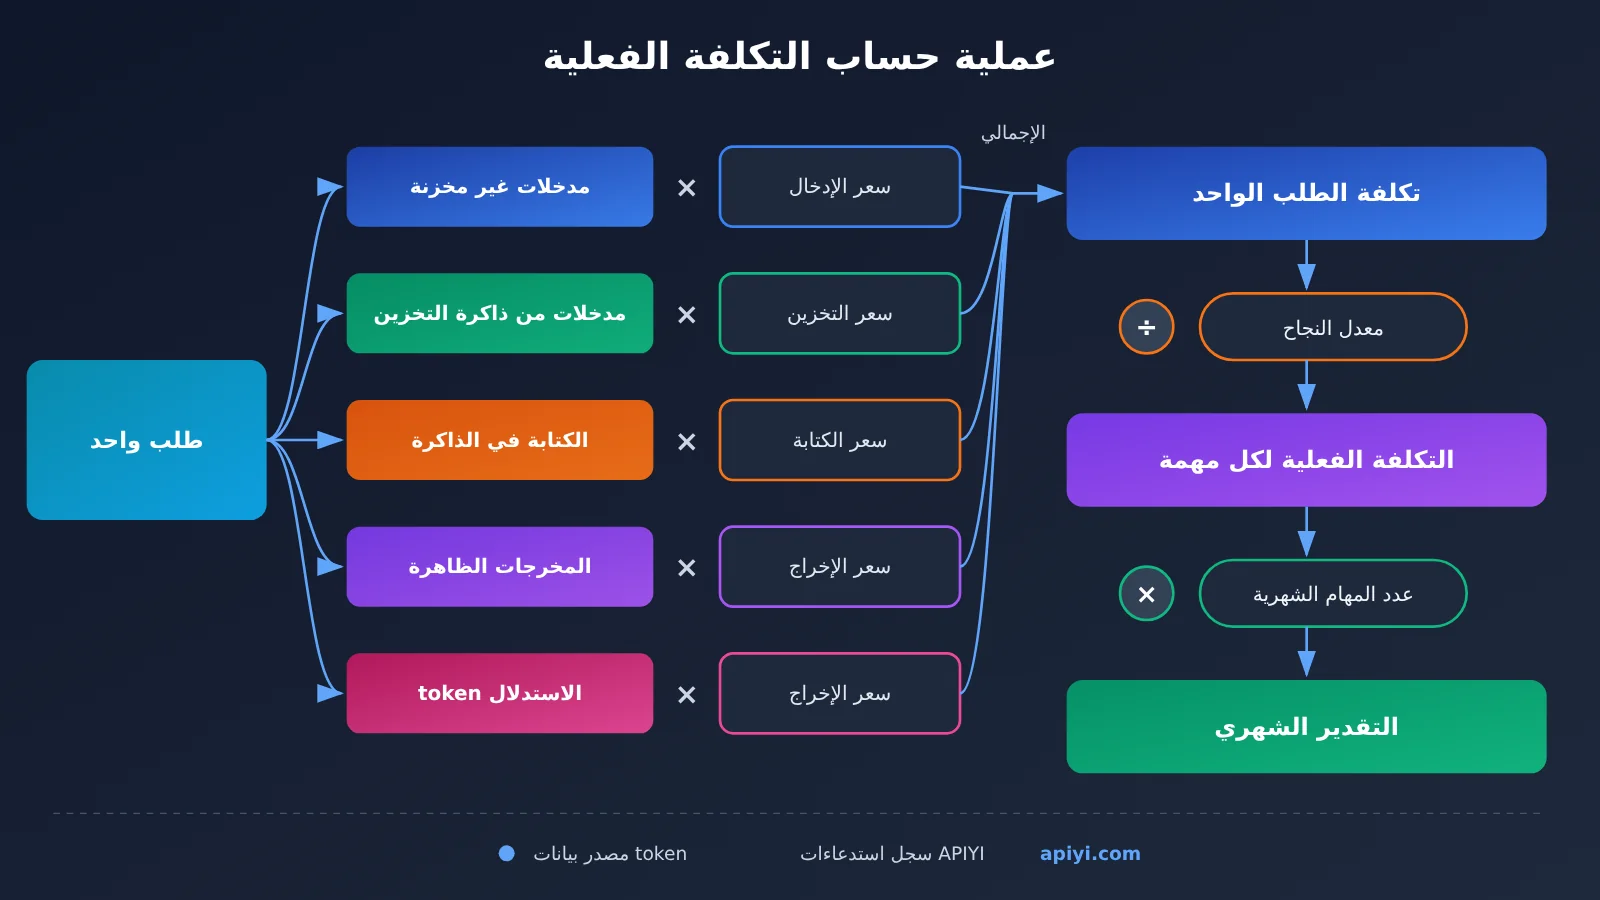
- تكلفة الطلب الواحد = رموز الإدخال غير الموجودة في ذاكرة التخزين المؤقت × سعر الإدخال + رموز الإدخال الموجودة في ذاكرة التخزين المؤقت × سعر قراءتها + رموز الكتابة في ذاكرة التخزين المؤقت × سعر الكتابة + (المخرجات المرئية + رموز الاستدلال) × سعر الإخراج
- التكلفة الفعلية للمهمة الواحدة = تكلفة الطلب الواحد × متوسط عدد الاستدعاءات ÷ معدل نجاح المهام
- التقدير الشهري = التكلفة الفعلية للمهمة الواحدة × عدد المهام الشهرية
غالبًا ما يُستهان بتأثير ذاكرة التخزين المؤقت. فقد ذكر مقال من المصدر نفسه، نُشر في 6 أغسطس 2026، أن سعر الإدخال الموجود في ذاكرة التخزين المؤقت لنموذج DeepSeek V4 Flash أقل بنحو 50 مرة من سعر الإدخال غير الموجود فيها، وأن أسعار ذاكرة التخزين المؤقت قد تختلف بما يصل إلى 28 ضعفًا بين مقدمي الاستضافة. وهذا يعني أن فاتورة النموذج نفسه قد تختلف تمامًا باختلاف قناة الوصول، لذا يجب التحقق من سعر ذاكرة التخزين المؤقت لدى القناة التي تستخدمها فعليًا.
كيف تضاعف رموز الاستدلال التكلفة الفعلية
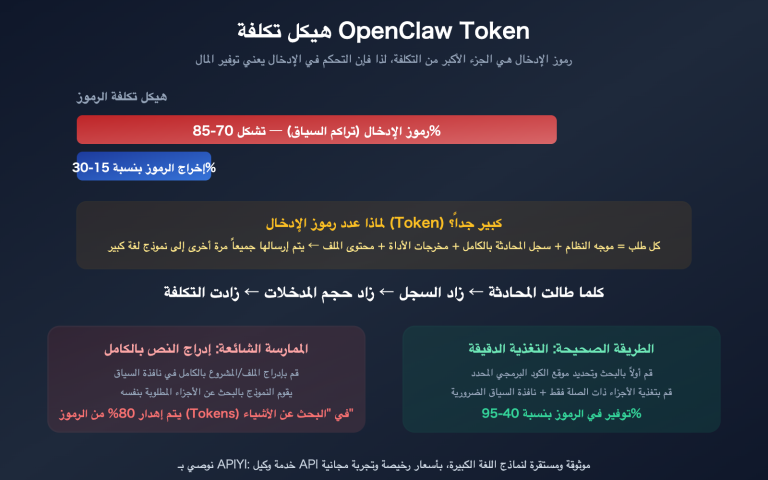
نماذج الاستدلال من أكثر الأسباب شيوعًا لظاهرة «سعر معلن منخفض وفاتورة مرتفعة». فقد يطرح المستخدم سؤالًا واحدًا، ويجيب النموذج في 200 كلمة، لكنه قد يستهلك داخليًا آلاف الرموز في التفكير قبل الإجابة. وعادةً ما تُحاسَب هذه الرموز بسعر الإخراج، الذي يزيد أصلًا بعدة أضعاف على سعر الإدخال.
تؤكد التقديرات المنشورة من جهات مستقلة ذلك أيضًا. فبحسب مقال نُشر في 4 أغسطس 2026، تفوّق Qwen 3.8 Max على DeepSeek V4 Flash بثلاث نقاط على منصة Artificial Analysis، لكنه كان أعلى تكلفة بنحو 345 ضعفًا وأبطأ بنحو 6 أضعاف في ثلاث مهام اختُبرت عمليًا. وفي مقال آخر من السلسلة نفسها، وباستخدام منهجية التقييم ذاتها، حقق Kimi K3 نتيجة 57 نقطة بتكلفة $2,437، وحقق DeepSeek V4 Flash نتيجة 50 نقطة بتكلفة $72، بينما حقق Qwen 3.7 Max نتيجة 46 نقطة بتكلفة $1,604. إذًا، قد يجمع النموذج فعلًا بين نتيجة أقل وتكلفة أعلى، وغالبًا ما يكمن السبب في عدد الرموز التي يستهلكها.
وقد تظهر فروق أيضًا بين إصدارات النماذج من الشركة نفسها. يشير أحد المقالات إلى أن إصدارات Claude Opus من 4.5 إلى 4.8 وOpus 5 لها السعر المعلن نفسه، وهو $5/$25، لكن الاختبارات أظهرت أن استهلاك الرموز في أحدها بلغ نحو 1.30 ضعف استهلاكه في إصدار آخر. أي إن السعر قد يبقى ثابتًا بينما تتغير الفاتورة بنسبة 30%، وهي نقطة يسهل إغفالها عند الترقية إلى إصدار أحدث من النموذج.
تقدير التكلفة الفعلية من استهلاك الرموز: 5 خطوات للبدء سريعًا
إليك طريقة لتقدير التكلفة باستخدام عينة صغيرة، دون الحاجة إلى كتابة نصوص برمجية معقدة. المبدأ الأساسي واحد: للمهمة والمدخلات نفسيهما، احسب رموز الإدخال والإخراج والتخزين المؤقت والاستدلال كلًا على حدة.
الخطوة 1: إعداد عينة تمثيلية من المهام
اختر من 20 إلى 50 طلبًا من بيئة الإنتاج أو من احتياجات فعلية، بحيث تشمل الأنواع الرئيسية مثل الأسئلة والأجوبة القصيرة، والمستندات الطويلة، والمحادثات متعددة الجولات. احتفظ بموجّه النظام والسياق كاملين في العينات، لأن الاستفادة من التخزين المؤقت تحدث أساسًا مع هذه المقدمات المتكررة. لا تكتفِ باختبار عبارة مثل «مرحبًا»، فلن يكشف ذلك عن اختلافات تجزئة النص إلى رموز أو أثر التخزين المؤقت.
الخطوة 2: ثبّت المتغيرات واستدعِ النماذج المرشحة كلًا على حدة
استخدم موجه النظام نفسه، ومدخل المستخدم نفسه، وإعدادَي max_tokens ودرجة الحرارة نفسيهما مع كل نموذج مرشح. وإذا كان نموذج الاستدلال يدعم ضبط مستوى الاستدلال، فسجّل المستوى المستخدم، لأن عدد رموز الاستدلال قد يختلف كثيرًا من مستوى إلى آخر.
في هذه الخطوة، يوفر استخدام نقطة وصول موحدة الكثير من الجهد. فمن خلال منصة تجميع مثل APIYI apiyi.com، يمكنك التبديل بين نماذج مزوّدين مختلفين باستخدام مفتاح API واحد وطريقة استدعاء واحدة متوافقة مع OpenAI. يكفي تغيير اسم النموذج لإجراء المقارنة كاملة، دون الحاجة إلى فتح حساب وشحن رصيد وتكييف SDK لكل مزوّد على حدة.
الخطوة 3: سجّل كل نوع من رموز token على حدة
بعد كل استدعاء، اقرأ عدد رموز token من حقل usage في الاستجابة. في التنسيق المتوافق مع OpenAI، تشمل الحقول الشائعة:
usage.prompt_tokens: إجمالي رموز الإدخالusage.prompt_tokens_details.cached_tokens: الجزء الذي جرى استرجاعه من ذاكرة التخزين المؤقتusage.completion_tokens: إجمالي رموز الإخراجusage.completion_tokens_details.reasoning_tokens: رموز الاستدلال ضمن إجمالي الإخراج
تختلف أسماء الحقول بين المزوّدين. على سبيل المثال، يستخدم تنسيق Anthropic الحقلين cache_read_input_tokens وcache_creation_input_tokens للتمييز بين القراءة من ذاكرة التخزين المؤقت والكتابة إليها. ارجع إلى وثائق كل مزوّد لمعرفة التفاصيل.
إذا كنت لا ترغب في تحليل الاستجابة بنفسك، يمكنك الاطلاع مباشرة على سجلات المنصة. توفر APIYI سجلات وإحصاءات استخدام لكل استدعاء، ما يساعدك على مقارنة استهلاك النماذج المختلفة لمجموعة العينات نفسها. لكن تحقق قبل إجراء التقديرات مما تعرضه لوحة التحكم وتوضحه سياسة الفوترة: هل تُدرج رموز التخزين المؤقت ورموز الاستدلال كلٌّ على حدة في السجلات؟ وهل تُسعَّر الاستفادة من ذاكرة التخزين المؤقت بشكل منفصل؟
🚀 البدء السريع: ننصح بإجراء مقارنة أولية صغيرة باستخدام 20 عينة على APIYI apiyi.com لتحديد مستوى استهلاك رموز token في كل نموذج، ثم تقرير ما إذا كنت ستزيد عدد العينات. وتكمن فائدة الفوترة برصيد موحد في تجميع تكاليف اختبار النماذج المتعددة في حساب واحد، ما يجعل مراجعة الحسابات بعد الاختبار أسهل.
الخطوة 4: تجميع النتائج وفق قالب التقدير
أدخل النتائج المسجّلة في القالب التالي، مع تخصيص صف لكل نموذج. احرص على ذكر تاريخ الاستعلام عن الأسعار ومصدرها في خانة سعر الوحدة.
| الحقل | إرشادات التعبئة | مصدر البيانات |
|---|---|---|
| النموذج والإصدار | اذكر رقم الإصدار المحدد أو اللاحقة التي تحمل التاريخ | معاملات الاستدعاء |
| سعر الوحدة وتاريخ الاستعلام | عمود لكل من المدخلات والمخرجات وقراءة ذاكرة التخزين المؤقت والكتابة إليها | صفحة الأسعار الرسمية أو صفحة أسعار المنصة المستخدمة |
| متوسط رموز الإدخال غير الموجودة في ذاكرة التخزين المؤقت | متوسط العينة | حقل usage في الاستجابة أو سجلات المنصة |
| متوسط رموز الإدخال الموجودة في ذاكرة التخزين المؤقت | متوسط العينة، مع حساب معدل العثور عليها | حقل usage في الاستجابة أو سجلات المنصة، مثل إحصاءات الاستخدام في APIYI |
| متوسط رموز المخرجات المرئية | إجمالي المخرجات مطروحًا منه رموز الاستدلال | حقل usage في الاستجابة |
| متوسط رموز الاستدلال | يُسجّل بشكل منفصل لنماذج الاستدلال | حقل usage في الاستجابة |
| معدل نجاح المهام | نسبة المهام التي اعتُبرت مقبولة بالتقييم البشري أو وفق قواعد محددة | سجلات التقييم |
| تكلفة المهمة الناجحة | تُحسب وفق المعادلة الواردة سابقًا | الحساب الإجمالي |
الخطوة 5: اتخذ القرار بناءً على التكلفة الفعلية لكل مهمة
في النهاية، لا نقارن سعر الوحدة، بل «التكلفة الفعلية لكل مهمة». نستخدم أدناه أسعارًا افتراضية لشرح طريقة الحساب؛ الأرقام مختلقة ولا تمثل أسعارًا حقيقية لأي نموذج.
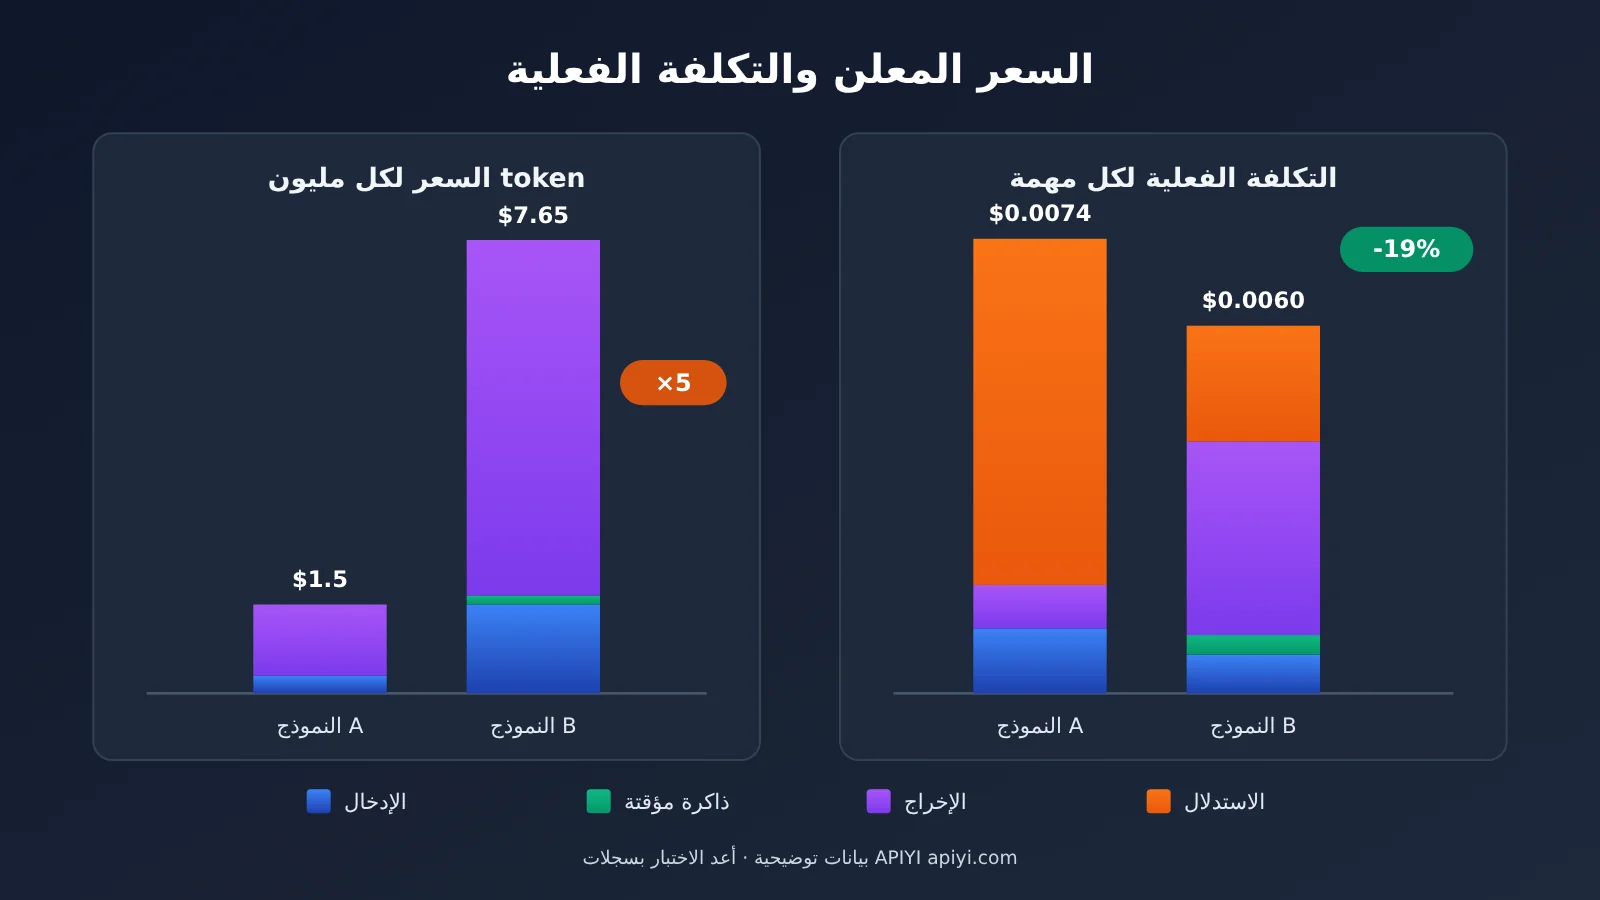
لنفترض أن السعر المعلن للنموذج A هو $0.3/M للإدخال و$1.2/M للإخراج، بينما سعر النموذج B هو $1.5/M للإدخال و$6/M للإخراج و$0.15/M لقراءة ذاكرة التخزين المؤقت. أي إن سعر وحدته يساوي خمسة أضعاف سعر النموذج A.
| عنصر الحساب | النموذج A (سعر معلن منخفض) | النموذج B (سعر معلن مرتفع) |
|---|---|---|
| رموز الإدخال غير الموجودة في ذاكرة التخزين المؤقت | 3,000 | 400 |
| الرموز الموجودة في ذاكرة التخزين المؤقت | 0 | 2,000 |
| رموز الإخراج المرئي + الاستدلال | 500 + 4,000 | 500 + 300 |
| تكلفة الإدخال | $0.0009 | $0.0006 + $0.0003 |
| تكلفة الإخراج | $0.0054 | $0.0048 |
| تكلفة الطلب الواحد | $0.0063 | $0.0057 |
| معدل نجاح المهمة | 85% | 95% |
| التكلفة الفعلية لكل مهمة | نحو $0.0074 | نحو $0.0060 |
في هذا المثال الافتراضي، يقسّم النموذج B النص إلى رموز بكفاءة أعلى، فيستخدم 600 رمز إدخال أقل. كما عُثر على معظم موجه النظام الطويل الخاص به في ذاكرة التخزين المؤقت، وكانت عملية الاستدلال أقصر بكثير. والنتيجة أن التكلفة الفعلية للنموذج B، رغم أن سعره المعلن أعلى بخمسة أضعاف، أقل من تكلفة A بنحو 19%. وقد تكون النتيجة معاكسة في الواقع، ولهذا من الضروري إعادة الاختبار باستخدام مهامك الخاصة.
ما يجب مراعاته عند حساب التكلفة الفعلية
إطار الحساب نفسه ليس معقدًا، لكن هناك بعض الأخطاء التي قد تؤثر في دقة النتائج. يجدر التحقق منها واحدة تلو الأخرى قبل البدء:
- يجب تحديد تاريخ الأسعار: تتغير أسعار النماذج باستمرار. فعلى سبيل المثال، تشير إحدى المصادر إلى أن DeepSeek V4 Pro 0813 يطبق أسعارًا مختلفة لأوقات الذروة وخارجها اعتبارًا من 16 أغسطس 2026. وقد يختلف سعر النموذج نفسه بحسب الوقت والقناة.
- انتبه إلى الإصدار الذي يشير إليه الاسم المستعار للنموذج: تذكر إحدى المقالات أن اسم نموذج يبدو «الأكثر استخدامًا» يستدعي في الواقع إصدارًا قديمًا. عند الحساب، سجّل معرّف النموذج المُعاد في الاستجابة لتجنب اختبار الإصدار A ونشر الإصدار B.
- يعتمد نجاح التخزين المؤقت على تطابق البادئة: وضع المحتوى المتغير، مثل الطابع الزمني أو معرّف المستخدم، في بداية الموجه يجعل البادئة مختلفة في كل مرة، ما يقلل فرص الاستفادة من ذاكرة التخزين المؤقت إلى حد كبير. استخدم عند القياس بنية الموجه نفسها المستخدمة في بيئة الإنتاج.
- نتائج الاختبارات الخارجية للاستئناس فقط: تعكس النتائج الإجمالية من جهات مثل Artificial Analysis، وكذلك التكلفة المحسوبة لكل مهمة، توزيع المهام لدى جهة التقييم، وليس بالضرورة سيناريو عملك.
- احتسب عمليات إعادة المحاولة: تتسبب إعادة التشغيل بسبب حد المعدل 429 أو أخطاء التنسيق أو الإجابات غير المقبولة في تكاليف إضافية. لذلك، احسب معدل النجاح بناءً على نتائج التقييم الفعلية.
💰 نصيحة لتحسين التكلفة: بعد الانتهاء من القياس، يمكنك اعتماد «التكلفة الفعلية لكل مهمة ناجحة» معيارًا رئيسيًا للاختيار، واستخدام نتائج الاختبارات وزمن الاستجابة شروطًا مقيّدة. على APIYI apiyi.com، لا يتطلب التبديل بين النماذج سوى تعديل اسم النموذج، ما يسهّل تحديث إعدادات الإنتاج سريعًا عند تغير نتائج القياس، مع الاستمرار في مراقبة الاستهلاك الفعلي عبر سجلات الاستدعاء.
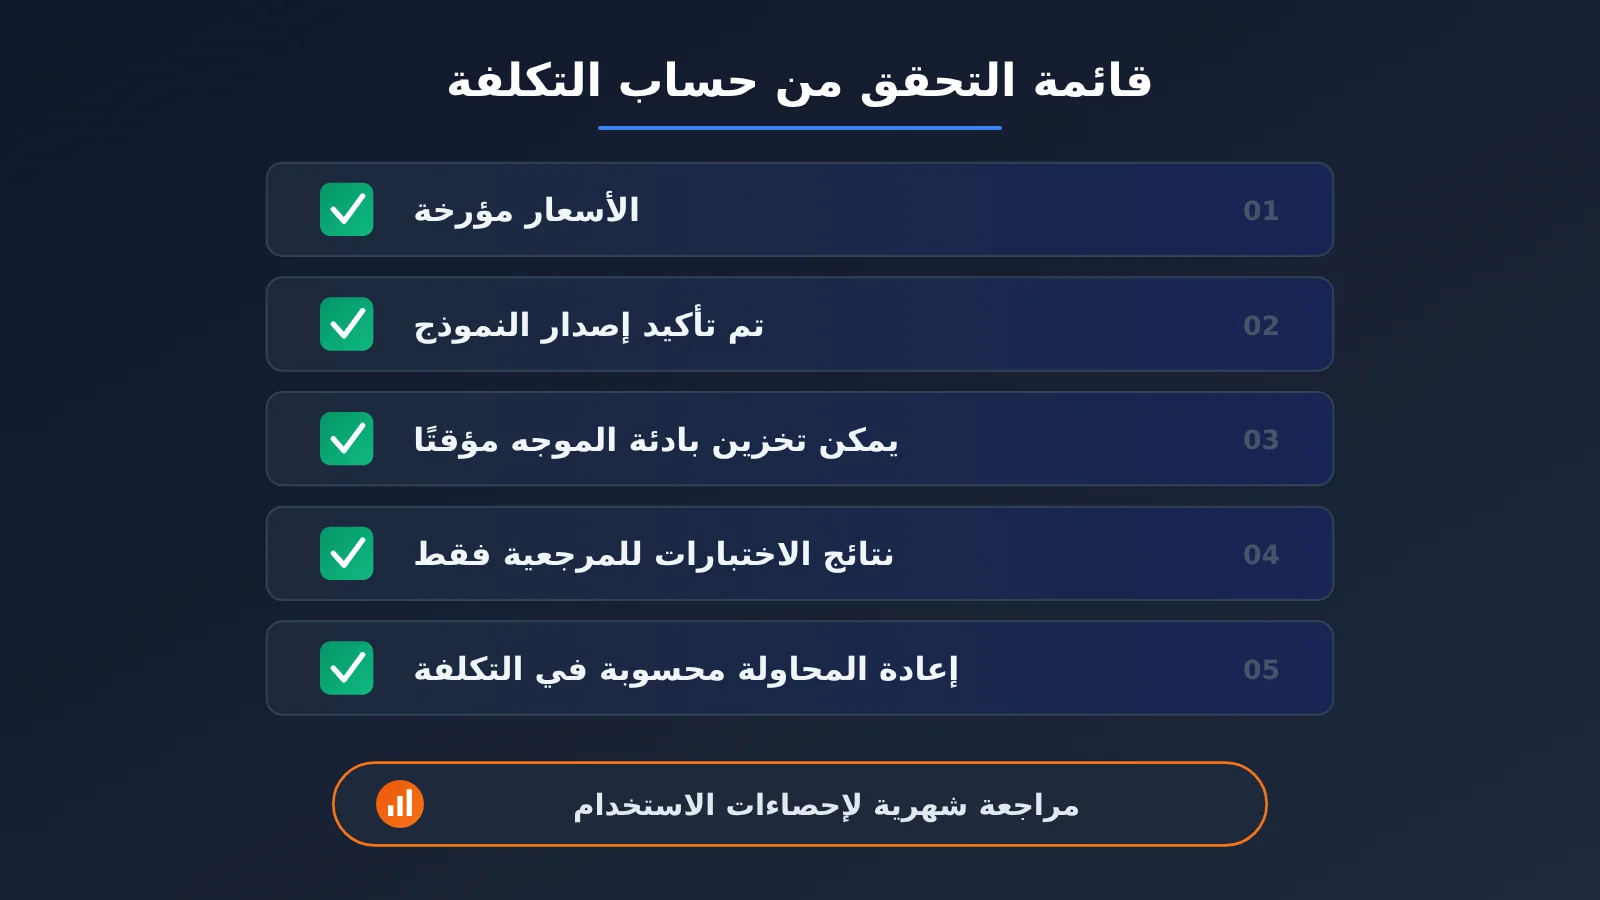
الأسئلة الشائعة FAQ
س1: ما المقصود بـ«التكلفة الفعلية» للنموذج؟
هي المبلغ المدفوع فعليًا لإتمام مهمة محددة، وليس السعر المعلن لكل مليون رمز (token). وتُحسب بضرب العدد الفعلي لكل نوع من الرموز، مثل رموز الإدخال غير الموجودة في ذاكرة التخزين المؤقت، والرموز المسترجعة منها، والرموز المكتوبة فيها، ورموز المخرجات المرئية، ورموز الاستدلال، في سعره المقابل، ثم احتساب التكلفة الفعلية للمهمة الواحدة مع مراعاة معدل النجاح وإعادة المحاولة.
س2: لماذا يختلف عدد الرموز للمستند نفسه بين النماذج؟
لأن كل نموذج يستخدم أداة مختلفة لتجزئة النص إلى رموز، وتختلف دقة التجزئة للنصوص الصينية والشفرة وعلامات الترقيم. في إحدى التقديرات المنشورة، تراوح عدد رموز المستند نفسه بين 614 و957 رمزًا عند استخدام 9 نماذج. لذلك يجب حساب تكلفة الإدخال وفق عدد الرموز الذي يبلّغ عنه كل نموذج، ولا يمكن تطبيق عدد رموز نموذج على النماذج الأخرى.
س3: هل يجب احتساب رموز الاستدلال ضمن التكلفة؟
نعم. يحتسب معظم المزوّدين رموز الاستدلال ضمن المخرجات ويفرضون عليها سعر المخرجات. وهي لا تظهر في نص الإجابة، لكنها قد تشكّل معظم رموز المخرجات. عند تقدير تكلفة نماذج الاستدلال، يُنصح بتسجيل `reasoning_tokens` بشكل منفصل والمقارنة عند مستوى كثافة الاستدلال نفسه.
س4: كم يمكن أن يوفّر استرجاع الرموز من ذاكرة التخزين المؤقت؟
يعتمد ذلك على تسعير التخزين المؤقت لدى المزوّد ومعدل نجاح الاسترجاع لديك. تذكر المصادر أن سعر الرموز المسترجعة من ذاكرة التخزين المؤقت في DeepSeek V4 Flash يبلغ نحو 1/50 من سعر الرموز غير المسترجعة، لكن أسعار التخزين المؤقت قد تختلف بما يصل إلى 28 ضعفًا بين جهات الاستضافة. وتحقق موجهات النظام الطويلة، والبادئات الثابتة لقواعد المعرفة، والمحادثات متعددة الجولات أكبر استفادة. راجع تفاصيل التسعير لدى الجهة التي تستخدمها لمعرفة القيم الدقيقة.
س5: كيف أقدّر تكلفة عدة نماذج بسرعة باستخدام عينة صغيرة؟
يُنصح باستخدام منصة تتيح الوصول الموحد إلى عدة نماذج:
1. سجّل في APIYI على apiyi.com واحصل على مفتاح API
2. جهّز من 20 إلى 50 عينة من مهام حقيقية، وثبّت الموجهات والمعلمات
3. بدّل اسم النموذج في كل استدعاء، واجمع أعداد الرموز من مختلف الأنواع باستخدام سجلات الاستدعاء وإحصاءات الاستخدام
4. احسب التكلفة الفعلية للمهمة الواحدة وفق القالب الوارد في هذا المقال
بهذه الطريقة، يمكنك إكمال المقارنة باستخدام حساب واحد وطريقة استدعاء واحدة، وتقليل تكلفة فتح حسابات لدى عدة مزوّدين ومطابقة فواتيرهم.
س6: هل يمكن استخدام «تكلفة المهمة الواحدة» المذكورة في مدونة خارجية مباشرة؟
لا يُنصح باستخدامها مباشرة لإعداد الميزانية. تفيد هذه البيانات في اكتشاف النماذج التي قد تختلف في استهلاك الرموز، وتساعدك على تضييق قائمة المرشحين. لكن مهام التقييم وإصدارات النماذج والأسعار وظروف التخزين المؤقت تختلف عن بيئة عملك، لذا عليك إعادة الاختبار بعيناتك الخاصة للوصول إلى الأرقام النهائية.
س7: ما حدود طريقة التقدير هذه؟
لا تعكس العينة الصغيرة سوى أنواع المهام التي تغطيها، لذا يجب إعادة الاختبار عند تغيّر توزيع مهام العمل. بالإضافة إلى ذلك، قد لا تميّز سجلات بعض المنصات بين رموز التخزين المؤقت ورموز الاستدلال؛ وعندها لا بد من جمع هذه البيانات من حقل `usage` في استجابة النموذج. وقد تتغير الأسعار وإصدارات النماذج أيضًا، لذا يُنصح بإجراء جولة اختبار جديدة بعد كل تعديل للأسعار أو ترقية.
أهم النقاط لحساب التكلفة الفعلية للنموذج
- سعر الوحدة ليس سوى نصف المعادلة: تعتمد الفاتورة على سعر الوحدة مضروبًا في عدد الرموز المستهلكة فعليًا.
- لا يمكن تجاهل اختلاف تقسيم النص إلى رموز: قد يختلف عدد رموز المستند نفسه بأكثر من 50% بين النماذج.
- رموز الاستدلال تزيد تكلفة المخرجات: تُحتسب عملية التفكير غير المرئية أيضًا ضمن تكلفة المخرجات.
- تختلف أسعار التخزين المؤقت باختلاف قناة الوصول: يحدد معدل الاستفادة من التخزين المؤقت وسعر رموزه معًا تكلفة الموجهات الطويلة.
- اتخذ القرار بناءً على التكلفة الفعلية للمهمة الواحدة: ضع معدل النجاح وإعادة المحاولة في الحسبان.
- استخدم واجهة موحدة لإعادة الاختبار: تتيح واجهة APIYI الموحدة وسجلات الاستدعاء اختبار نماذج متعددة بالعينة نفسها بسهولة أكبر.
الخلاصة
يعتمد تقدير التكلفة الفعلية للنموذج بناءً على استهلاك الرموز المميزة والتخزين المؤقت على ثلاث نقاط:
- فصّل الفاتورة: احسب كلاً من رموز الإدخال التي لم تُسترجع من ذاكرة التخزين المؤقت، والرموز المسترجعة منها، ورموز الكتابة إليها، ورموز الإخراج المرئية، ورموز الاستدلال، واضرب كل فئة في سعرها.
- أعد الاختبار باستخدام مهامك: اختبارات الأداء والأسعار المنشورة من جهات خارجية مفيدة للاستئناس فقط؛ أما البيانات الموثوقة فهي نتائج اختباراتك للمهمة نفسها وبالمدخلات نفسها.
- قارن التكلفة الفعلية لكل مهمة: أدخل معدل النجاح وعمليات إعادة المحاولة في الحساب، ثم ضع الميزانية بناءً على حجم المهام الشهري.
تتغير أسعار النماذج وتظهر نماذج جديدة باستمرار، لكن يمكنك إعادة استخدام طريقة التقدير هذه على المدى الطويل. قبل اختيار نموذجك التالي، جرّب مقارنة النماذج باستخدام 20 عينة حقيقية، ثم قرر أي نموذج ستستخدمه في الإنتاج. وإذا احتجت إلى التبديل سريعًا بين نماذج عدة مزودين لاختبارها، يمكنك الوصول إليها عبر واجهة موحدة من خلال APIYI على apiyi.com، والتحقق من الاستهلاك الفعلي لكل نموذج مباشرةً من سجلات الاستدعاء.
📚 المراجع
- الصفحة 23 من مدونة Ofox.ai: تتضمن ملخصات لمقالات تقارن استهلاك الرموز المميزة بين DeepSeek V4 Flash وGemini 3.6 Flash، وتتناول فروق أسعار التخزين المؤقت وتقديرات تكلفة سلسلة Qwen.
- الرابط:
ofox.ai/blog/page/23/ -
ملاحظة: نُشرت المقالات في أغسطس 2026، والبيانات ناتجة عن تقدير واحد أجرته جهة خارجية، ويُستأنس بها لفهم الظاهرة فقط.
-
الصفحة 22 من مدونة Ofox.ai: تتضمن مقارنة لعدد الرموز المميزة في المستند نفسه عبر 9 نماذج، وفروق استهلاك الرموز بين إصدارات Claude، وتسعير DeepSeek V4 Pro حسب وقت الاستخدام.
- الرابط:
ofox.ai/blog/page/22/ -
ملاحظة: مفيدة للاطلاع على أمثلة محددة لفروق تقسيم النص إلى رموز والفروق بين الإصدارات.
-
الصفحة 25 من مدونة Ofox.ai: تتضمن مقارنة تكلفة المهمة الواحدة بين Kimi K3 وGLM-5.2 وOpus 4.8.
- الرابط:
ofox.ai/blog/page/25/ - ملاحظة: الأسعار ونتائج اختبارات الأداء قابلة للتغير، لذا يُرجى الرجوع إلى صفحات التسعير الرسمية لكل مزود قبل الاستخدام.
الكاتب: الفريق التقني في APIYI
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com. ولمزيد من موارد التكامل، يمكنكم زيارة مركز التوثيق على docs.apiyi.com.