Zusammenfassung: Bei der Auswahl eines Modells für die Spieleentwicklung kommt es auf die Erfolgsquote bei derselben Aufgabe, die Ausführungszeit, die API-Kosten und den Aufwand für manuelle Nacharbeit an. Preistabellen und allgemeine Code-Benchmarks liefern nur ergänzende Anhaltspunkte.
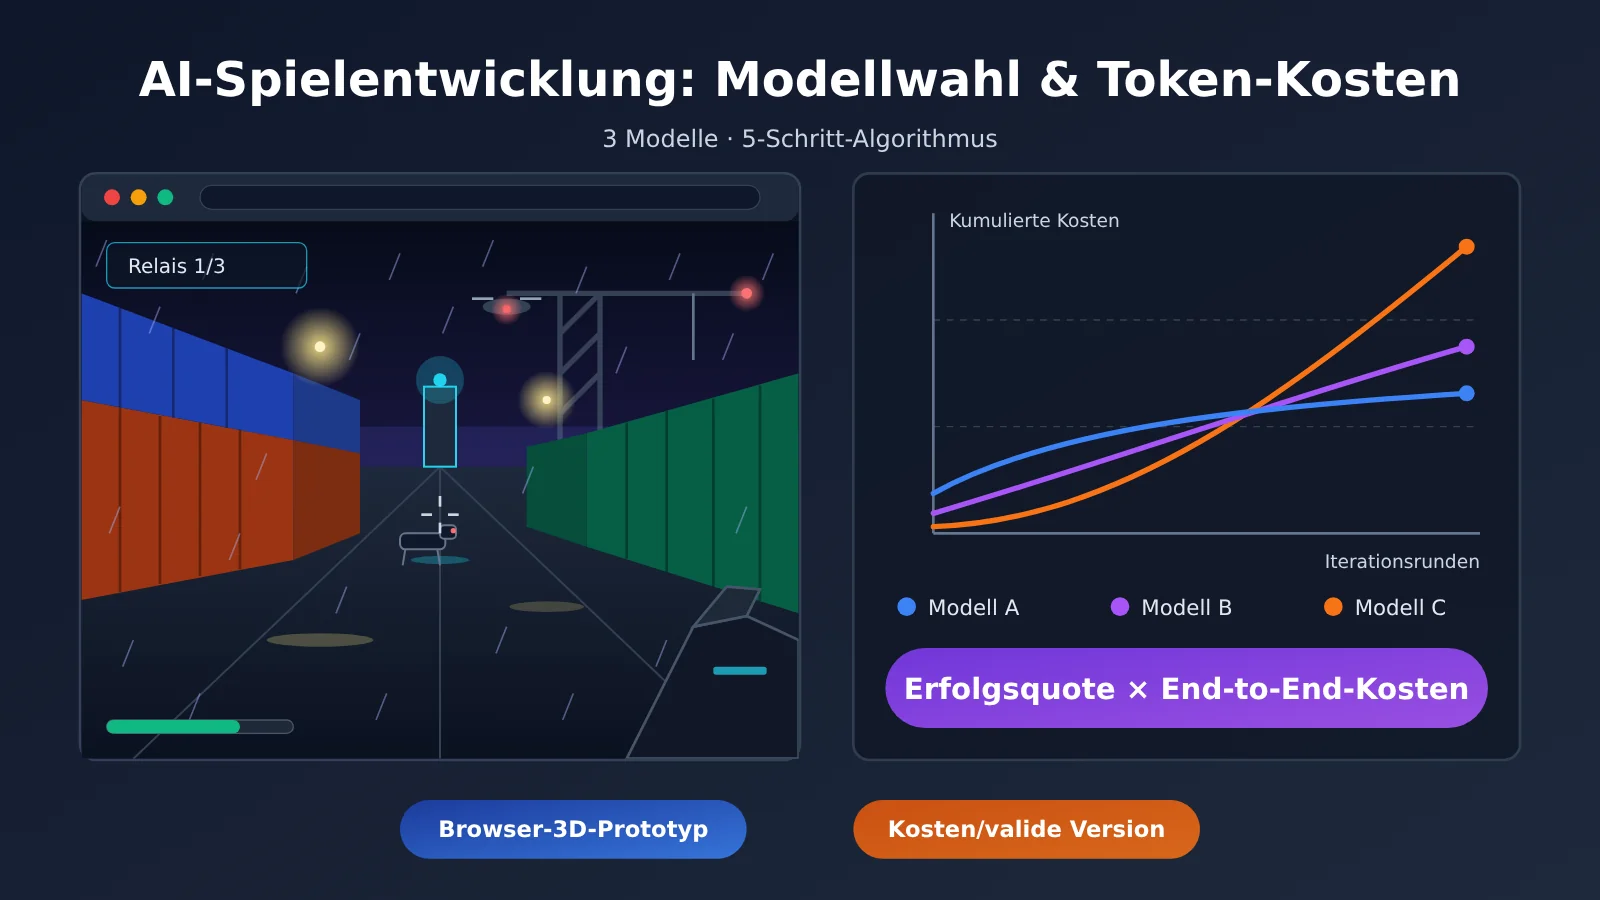
Fazit zuerst: Wenn eine KI selbstständig ein Spiel entwickeln soll, zählen am Ende die End-to-End-Kosten für eine lieferbare Version – nicht der Listenpreis pro Million Token. Im Saltline-Fall erzeugte Claude Fable 5.2 in rund 8 Stunden mit etwa 445 Millionen Eingabe-Token und rund 2,7 Millionen Ausgabe-Token einen im Browser lauffähigen 3D-Shooter-Prototyp. Die vom Entwickler anhand der API-Preise geschätzten Kosten lagen bei etwa 550 US-Dollar, wobei der Großteil der Eingabe aus dem Cache kam. Stand 16. November 2026 unterscheiden sich die Standard-API-Preise der drei Modelle um bis zu etwa das Fünffache. Wenn das günstigere Modell jedoch mehr Durchläufe benötigt, können die Gesamtkosten höher ausfallen. Eine verlässliche Auswahlmethode besteht deshalb darin, dieselbe Spielaufgabe an die Kandidatenmodelle zu geben, mehrere Durchläufe durchzuführen, Erfolgsquote, Token, Zeitaufwand und manuellen Nacharbeitsaufwand zu erfassen und daraus die „Kosten pro brauchbarer Version“ zu berechnen.
Inhaltsvorschau: Abschnitt 1 zerlegt anhand von Saltline die Token-Abrechnungsstruktur eines KI-Spieleentwicklungsexperiments. Abschnitt 2 vergleicht die offiziellen Preise der drei Modelle und erläutert, wie sich Caching auf die Gesamtkosten auswirkt. Abschnitt 3 erklärt, was SWE-bench Verified, Aider Polyglot und die historischen NIST-Benchmarks jeweils aussagen können. Abschnitt 4 stellt einen reproduzierbaren speziellen Benchmark-Plan für die Spieleentwicklung samt Code vor. Abschnitt 5 überführt die Ergebnisse in eine Modellauswahlstrategie.
Wissenswertes: Terminologie für die Modellauswahl in der KI-Spieleentwicklung
| Begriff | Erklärung |
|---|---|
| Eingabe-Token | Die Maßeinheit für Inhalte, die dem Modell zur Verarbeitung übergeben werden, einschließlich Eingabeaufforderungen, Codedateien, von Tools zurückgegebenen Ergebnissen usw. |
| Ausgabe-Token | Die Maßeinheit für vom Modell generierte Inhalte, z. B. Code, erklärender Text und Parameter für Tool-Aufrufe |
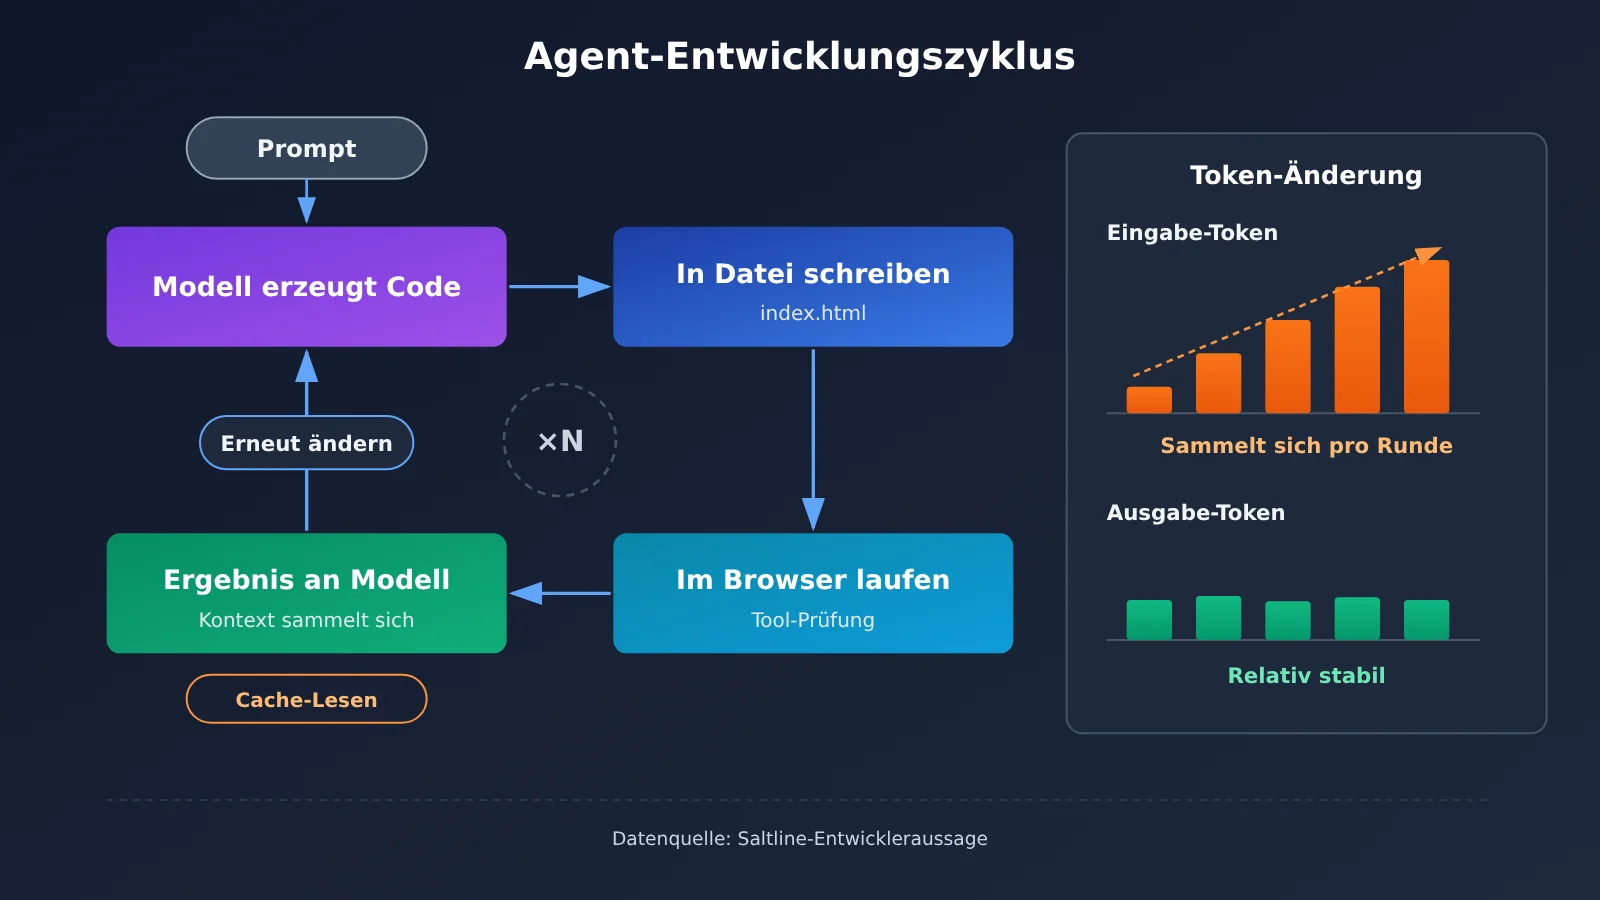
| Cache-Lesen | Die wiederholte Nutzung eines bereits zwischengespeicherten Kontexts; die Abrechnung liegt deutlich unter der für normale Eingaben |
| Cache-Schreiben | Die Kosten für das erstmalige Speichern des Kontexts im Cache; sie liegen normalerweise etwas höher als bei normaler Eingabe |
| SWE-bench Verified | Ein Benchmark mit 500 manuell geprüften Software-Engineering-Aufgaben aus echten Open-Source-Projekten |
| Aider Polyglot | Ein Benchmark zur Codeänderung, der 6 Programmiersprachen und 225 Übungsaufgaben abdeckt |
| Harness | Ein Ausführungsframework, das Modelle, Tools und Aufgaben-Schleifen organisiert, z. B. ein Agent-Gerüst |
| Erfolgsquote der Aufgaben | Der Anteil der Aufgaben, die nach vorab definierten Abnahmekriterien abgeschlossen werden |
| End-to-End-Kosten | Die Summe aus Modellaufrufen, Tool-Ausführung und Personalkosten zur Erledigung der gesamten Aufgabe |
| Manuelle Korrekturen | Menschliche Änderungen, die nötig sind, damit das generierte Ergebnis die Abnahmekriterien erfüllt |
| Prozedurale Generierung | Die Erzeugung von Geometrie, Texturen und Klängen mit Code und mathematischen Funktionen statt durch Import von Asset-Dateien |
| Shader | Ein Programm, das auf der GPU läuft und visuelle Effekte wie Farbe, Beleuchtung und Materialien berechnet |
1 Kostenbeispiel für ein eigenständig von KI entwickeltes Spiel: Wie viele Token hat Saltline verbraucht?
1.1 Welchen Umfang hat Saltline?
Am 9. November 2026 veröffentlichte der Anthropic-Ingenieur Felix Rieseberg ein Programmierexperiment mit Claude Fable 5.2. Er gab dem Modell nur eine einzige Eingabeaufforderung: Es sollte ein kleines First-Person-Shooter-Spiel bauen, dessen Optik so nah wie möglich an ein AAA-Spiel heranreicht – und das ohne jegliche menschliche Rückmeldung während des gesamten Prozesses. Das Ergebnis war Saltline: ein 3D-Shooter, der direkt im Browser läuft. Der Schauplatz ist ein Containerhafen in einer regnerischen Nacht. Die Spieler müssen drei Signalrelais abschalten und anschließend evakuieren. Als Gegner treten patrouillierende Luftdrohnen und mechanische Hetzhunde am Boden auf.
Vom Umfang her ist Saltline ein spielbarer Einzelspieler-Prototyp mit einem einzigen Level. „AAA“ ist hier Versuchsziel und visuelle Analogie, um den Grafikstil zu beschreiben; der Umfang ist weit von kommerziellen AAA-Produkten entfernt. Die im chinesischen Raum verbreitete Bezeichnung „几猫·国产3A大作“ (wörtlich etwa „Ein paar Katzen – ein heimischer AAA-Blockbuster“) ist eine chinesische Version oder Neuverpackung von Saltline. Der Name stammt aus dem Verbreitungsprozess und sagt nichts darüber aus, wer das Spiel entwickelt hat.
1.2 Zeit, Token und Kosten nach Angaben des Entwicklers
Die folgenden Daten stammen aus der Veröffentlichung des Entwicklers selbst auf X. Es handelt sich um eigene Schätzungen, die nicht von Dritten geprüft wurden:
- Entwicklungszeit: etwa 8 Stunden
- Eingabe-Token: etwa 445 Millionen, wobei in großem Umfang Caching zum Einsatz kam
- Ausgabe-Token: etwa 2,7 Millionen
- Geschätzte Kosten nach API-Preisen: etwa 550 US-Dollar
- Entwicklungsweise: eine einzige Eingabeaufforderung, keine Iterationen mit menschlichem Feedback
Dabei handelt es sich um einmalige Erzeugungskosten. Die erzeugten Spieldateien laufen anschließend lokal im Browser der Spieler; beim Spielen wird die Claude-API nicht aufgerufen. Die 550 US-Dollar lassen sich daher auch nicht als „KI-Kosten pro Spieler“ umlegen.
1.3 Die Rechnung mit den offiziellen Stückpreisen aufschlüsseln
Nach dem offiziellen Standardpreis von Claude Fable 5.2 (Ausgabe: 40 $ pro Million Token) entsprechen 2,7 Millionen Ausgabe-Token etwa 108 US-Dollar. Die restlichen rund 440 US-Dollar entfallen auf die Eingabeseite, also Cache-Schreiben, Cache-Lesen und normale Eingabe. Der Entwickler hat die jeweiligen Mengen der drei Bestandteile nicht offengelegt, weshalb sich das nicht weiter aufschlüsseln lässt.
Ein Blick auf zwei Grenzwerte zeigt, wie stark das Caching wirkt: Würden alle 445 Millionen Eingabe-Token zum normalen Eingabepreis von 8 $ abgerechnet, ergäbe das etwa 3.560 US-Dollar; würde alles zum Cache-Lesepreis von 0,20 $ abgerechnet, wären es etwa 89 US-Dollar. Die tatsächliche Schätzung liegt zwischen beiden Werten und deutlich näher an der Untergrenze. Das heißt: Bei lang laufenden Agent-Entwicklungsaufgaben entscheidet die Cache-Trefferquote auf der Eingabeseite über die Größenordnung der Rechnung, der Einfluss des Ausgabepreises ist vergleichsweise gering.
1.4 Warum eine Datei mit 1,4 MB 445 Millionen Token verbrauchen kann
Die eigenständige HTML-Version von Saltline ist rund 1,43 MB groß (1.425.707 Bytes). Der Entwickler erklärt, dass Modelle und Texturen im Spiel reiner Code sind: Die Geometrie wird programmatisch konstruiert, die Oberflächenbeschaffenheit von Shadern berechnet, auch der Sound entsteht prozedural – separate Bild- oder 3D-Modell-Assets gibt es nicht.
Das Ergebnis ist klein, der Weg dorthin dafür umso länger. Über acht Stunden hinweg hat der Agent die stetig wachsende Codedatei immer wieder neu gelesen, Tools ausgeführt, Ergebnisse geprüft und anschließend nachgebessert. In jeder dieser Runden musste ein großer Kontext erneut ins Modell geschickt werden. Der endgültige Token-Verbrauch stammt also vor allem aus dieser Schleife – nicht aus der Länge der fertigen Datei. Genau deshalb muss man bei der Bewertung von Modellen für die Spieleentwicklung auch die „Prozesskosten“ messen.
2 Preisvergleich der Spieleentwicklungs-Modelle: Unterschiede bei der Token-Abrechnung zwischen drei APIs
2.1 Offizielle Standardpreise der drei Modelle
Alle Preise in der folgenden Tabelle stammen von den offiziellen Seiten der jeweiligen Anbieter, Stand 16. November 2026. Die Einheit ist US-Dollar pro Million Token, angegeben ist die Standard-API-Preisstufe ohne Rabatte anderer Kanäle und ohne regionale Zuschläge.
| Modell | Normaler Input | Output | Cache-Lesen | Anmerkung |
|---|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 | Cache-Schreiben für 5 Minuten $10, Cache-Schreiben für 1 Stunde $16; Kontextfenster 1 Mio., maximaler Output 128K |
| GPT-6 Astra | $10 | $50 | $1 | Standard-Verarbeitungsstufe; Preise für andere Geschwindigkeiten, Batch-Verarbeitung und Regionen können abweichen |
| Gemini 4 Argon | $2 | $10 | $0.10 | Dieser Preis gilt bis 30. November 2026; ab 1. Dezember ist eine Anpassung auf Input $4 und Output $20 geplant |
Für Claude Fable 5.2 gibt es außerdem einen Fast Mode mit Input $16 und Output $80. Laut Anbieter lässt sich die Output-Geschwindigkeit damit auf bis zu das 2,5-Fache steigern. Bei langen Aufgaben, die in einer festen Zeitspanne durchlaufen müssen, verändert die Geschwindigkeitsstufe sowohl die Laufzeit als auch die Kosten – bei der Evaluation sollte sie deshalb als eigene Konfiguration erfasst werden.
💡 Vergleichstipp: Die Schnittstellen und Abrechnungsfelder der drei Modelle unterscheiden sich, für eine eigene Testumgebung muss man sie also jeweils separat anbinden. APIYI apiyi.com bietet eine OpenAI-kompatible, einheitliche Schnittstelle: Mit einem einzigen API-Schlüssel lassen sich Claude, GPT, Gemini und weitere Modelle aufrufen, sodass man sie in ein und demselben Evaluationsskript austauschen kann. Welche Modelle verfügbar sind und zu welchem Preis, richtet sich nach der jeweiligen Plattformliste.
2.2 Preisunterschiede bei gleicher Token-Menge
Um den Unterschied bei den Stückpreisen direkt zu spüren, kann man die Output-Menge von Saltline (2,7 Mio. Token) in die Preise der drei Anbieter einsetzen: Claude Fable 5.2 kommt auf rund 108 US-Dollar, GPT-6 Astra auf rund 135 US-Dollar und Gemini 4 Argon auf rund 27 US-Dollar. Würden alle 445 Mio. Input-Token aus dem Cache gelesen, wären es jeweils etwa 89, 445 und 45 US-Dollar.
Diese Zahlen beschreiben nur die Abrechnungsstruktur – und sie setzen voraus, dass alle drei Modelle exakt dieselbe Token-Menge verbrauchen. In der Praxis trifft diese Annahme so gut wie nie zu. Je nach Modell unterscheiden sich die Anzahl der Runden, die nötig sind, um dieselbe Aufgabe zu lösen, der pro Runde gelesene Kontext und die Länge des generierten Codes. Und wenn ein Lauf scheitert und wiederholt werden muss, vervielfachen sich die Kosten.
2.3 Cache-Preise verdienen mehr Beachtung als Input-Preise
Bei der Agent-artigen Entwicklung besteht ein Großteil des Inputs aus wiederkehrendem Kontext. Der Cache-Lesepreis von GPT-6 Astra liegt bei 1/10 des normalen Input-Preises, bei Claude Fable 5.2 bei 1/40 und bei Gemini 4 Argon bei 1/20. Je kleiner das Verhältnis von Cache-Lesepreis zu normalem Input-Preis ist, desto stärker lassen sich die Input-Kosten langer Aufgaben drücken.
Caches haben aber auch Schreibkosten und eine begrenzte Gültigkeitsdauer. Bei Claude unterscheiden sich die Schreibpreise für den 5-Minuten-Cache und den 1-Stunden-Cache. Liegt der Abstand zwischen zwei Aufrufen des Agenten über der Cache-Gültigkeit, muss der Cache neu geschrieben werden. Wer die Kosten langer Aufgaben schätzt, sollte deshalb die Anzahl der Cache-Schreibvorgänge, die Trefferquote und die Gültigkeitsdauer gemeinsam in die Rechnung einbeziehen.
3 Was Programmier-Benchmarks aussagen können: eine Leistungsreferenz für Spieleentwicklungsmodelle
3.1 SWE-bench Verified: Software-Engineering-Aufgaben aus echten Repositories
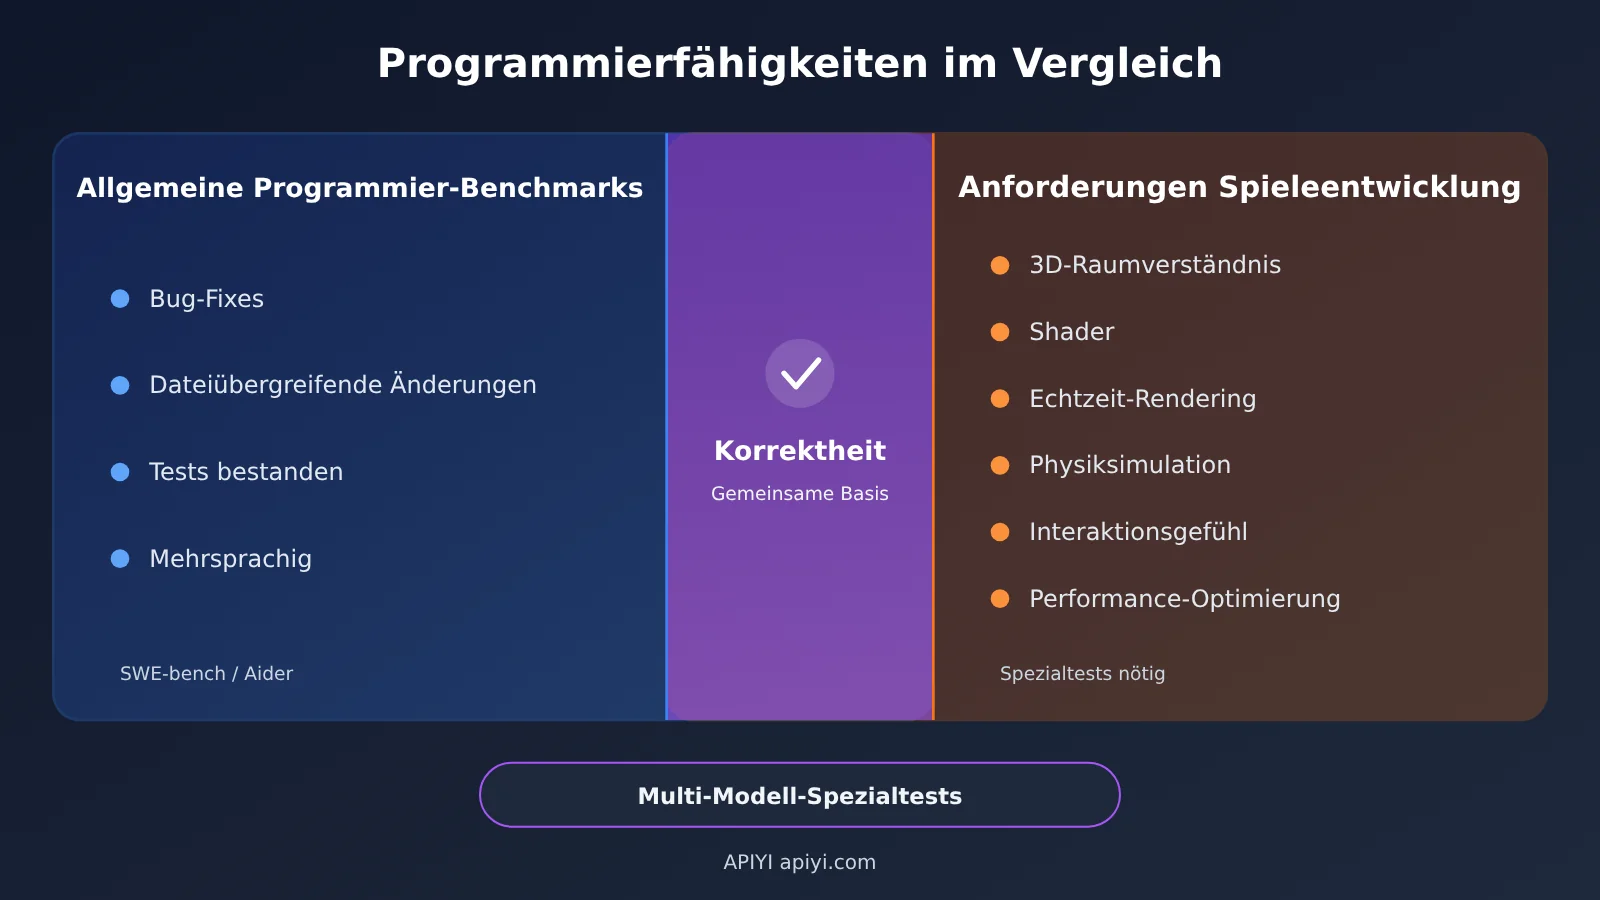
SWE-bench Verified enthält 500 manuell kuratierte und validierte Probleme aus echten Open-Source-Projekten. Das Modell muss den Repository-Kontext verstehen und Aufgaben wie Bugfixing, Änderungen an bestehendem Code, Behebung fehlgeschlagener Tests und dateiübergreifende Änderungen bewältigen – das kommt realer Ingenieursarbeit deutlich näher als reine Code-Vervollständigung.
Bei der Nutzung ist der Einfluss des Harness zu beachten. Laut offizieller Dokumentation vermischt die vollständige Rangliste verschiedene Agent-Systeme; für einen reinen Modellvergleich sollte eine einheitliche mini-SWE-agent-Konfiguration verwendet werden. Agent-Konfiguration, Tools, Eingabeaufforderungen und Versionen verändern die Punktzahl, daher sollten Ergebnisse unterschiedlicher Konfigurationen getrennt betrachtet werden.
3.2 Aider Polyglot: Genauigkeit und Kosten gleichzeitig erfassen
Aider Polyglot verwendet 225 Programmierübungen aus den Bereichen C++, Go, Java, JavaScript, Python und Rust und beurteilt anhand von Testfällen, ob ein Modell den Code korrekt ändert. Seine öffentlichen Ergebnisse dokumentieren neben der Genauigkeit auch den Token-Verbrauch, die Laufzeitkosten, fehlerhafte Ausgaben, Formatfehler sowie die Ausführungszeit jeder einzelnen Aufgabe.
Für die Modellauswahl ist diese Art der Erfassung von „Genauigkeit + Kosten“ sehr wertvoll – sie entspricht dem Bewertungsrahmen, der später in diesem Artikel vorgestellt wird. Die Aufgaben selbst sind jedoch eigenständige Übungsaufgaben, deren Umfang und Form sich deutlich von einem vollständigen 3D-Spielprojekt unterscheiden.
3.3 Historische NIST-Evaluierung: auf Modellversion und Zeitpunkt achten
Im Modellbewertungsbericht, den das CAISI – eine Unterabteilung des US-amerikanischen National Institute of Standards and Technology (NIST) – im Jahr 2025 veröffentlicht hat, wurden die SWE-bench-Verified-Ergebnisse einer Reihe von Modellen getestet. Bei den folgenden Daten handelt es sich ausschließlich um historische Modelle und Versuchskonfigurationen aus diesem Bericht; sie geben nicht die Rangliste der neuesten Modelle vom November 2026 wieder.
| Modell (im Bericht von 2025 getestete Version) | SWE-bench-Verified-Ergebnis |
|---|---|
| Anthropic Opus 4 | 66.7% |
| GPT-5 | 63.0% |
| DeepSeek V3.1 | 54.8% |
| DeepSeek R1-0528 | 44.6% |
| gpt-oss | 42.6% |
| DeepSeek R1 | 25.4% |
Der Bericht gibt zugleich Standardfehler an, was verdeutlicht, dass die Ergebnisse desselben Benchmarks von Natur aus statistischen Schwankungen unterliegen. Unterschiede von einigen Prozentpunkten können innerhalb der Fehlermarge möglicherweise keine praktische Trennschärfe besitzen. Die in diesem Artikel verglichenen Modelle Claude Fable 5.2, GPT-6 Astra und Gemini 4 Argon tauchen in diesem Bericht allesamt nicht auf; für die Modellauswahl muss man daher nach aktuellen Evaluierungen suchen, die sich auf die gegenwärtige Version beziehen und die Konfiguration ausweisen – oder selbst messen.
3.4 Die Kluft zwischen allgemeinen Programmierfähigkeiten und Spieleentwicklungsfähigkeiten
Die Spieleentwicklung umfasst viele Aufgaben, die von allgemeinen Software-Engineering-Benchmarks nur unzureichend abgedeckt werden: 3D-Raumverständnis, Shader-Programmierung, Echtzeit-Rendering, Animationssysteme, Physiksimulation, Interaktionsgefühl und Laufzeit-Performance-Optimierung. Projekte wie Saltline verlangen außerdem, dass das Modell visuelle Assets per Code generiert, was auf einem Verständnis von Computergrafik und visuellen Effekten beruht.
Ein Modell kann sehr gut darin sein, Bugs in Python-Repositories zu beheben, und bei komplexen WebGL-Szenen trotzdem nur mittelmäßig abschneiden. SWE-bench und Aider eignen sich gut, um Kandidaten mit offensichtlich unzureichenden Code-Fähigkeiten auszufiltern; die endgültige Rangfolge muss jedoch durch spezielle Spieleentwicklungs-Benchmarks entschieden werden.
4 Wie man KI-Modelle für die Spieleentwicklung vergleicht: Ein spezielles Bewertungsschema für dieselbe Aufgabe
4.1 Eine einheitliche Browser-3D-Spielaufgabe entwerfen
In Anlehnung an die Form von Saltline lässt sich die Aufgabe so definieren: Aus einer Eingabeaufforderung einen 3D-Spielprototyp generieren, der im Browser lauffähig ist. Alle Kandidatenmodelle verwenden dabei exakt dieselben Anforderungen:
- Ein vollständiges Projekt generieren, das sich direkt im Browser öffnen und ausführen lässt
- Eine steuerbare Spielfigur und eine 3D-Umgebung enthalten
- Kollision oder grundlegende Physik enthalten
- Klare Missionsziele sowie Sieg- und Niederlagebedingungen enthalten
- Während der Bewertung sind keine manuellen Änderungen am Kerncode erlaubt
Die Schwierigkeit der Aufgabe sollte deinen tatsächlichen Anforderungen entsprechen. Teams, die Casual-Minispiele entwickeln, überschätzen mit einem FPS-Prototyp-Test das benötigte Modellniveau; Teams, die komplexe 3D-Projekte umsetzen, unterschätzen es mit einer einfachen 2D-Aufgabe.
4.2 Zehn Bewertungskriterien
| Dimension | Bewertungsinhalt | Empfohlene Erfassungsmethode |
|---|---|---|
| Funktionsvollständigkeit | Sind die zentralen Spielfunktionen umgesetzt? | Funktionsliste Punkt für Punkt abhaken |
| Visuelle Qualität | Szene, Materialien, Beleuchtung, Animation | Blindbewertung durch mehrere Personen |
| Lauffähigkeit | Lässt sich die Anwendung normal starten? | Ja / Nein |
| Interaktionsvollständigkeit | Funktionieren Eingaben und Feedback? | Bediencheckliste Punkt für Punkt testen |
| Stabilität | Treten offensichtliche Abstürze auf? | Bei fester Spielzeit die Anzahl der Abstürze protokollieren |
| Performance | FPS, Startzeit, Speicher | Auf festgelegter Hardware messen |
| Codequalität | Lesbarkeit, Modularität, Fehlerbehandlung | Bewertung durch Code-Review |
| Token-Kosten | Eingabe, Ausgabe, Cache | Aus dem Feld usage der API aufsummieren |
| Gesamtdauer | Von Beginn bis zur lauffähigen Version | Zeitmessung |
| Manuelle Nacharbeit | Erforderlicher menschlicher Eingriff zum Erreichen der Zielvorgaben | Arbeitsstunden erfassen |
Dabei sollten „Lauffähigkeit“, „Funktionsvollständigkeit“ und „Interaktionsvollständigkeit“ als harte Abnahmekriterien gelten, um zu entscheiden, ob ein Durchlauf erfolgreich war. Visuelle Qualität, Performance und Codequalität dienen dazu, erfolgreiche Ergebnisse untereinander zu ranken.
Ihre Nachricht enthält die Übersetzungsrichtlinien und das Glossar, aber keinen eigentlichen chinesischen Quelltext, den ich übersetzen könnte. Es fehlt der zu übertragende Artikelinhalt (die Abschnitte, Codeblöcke, SVG-Platzhalter usw.).
Bitte senden Sie mir den chinesischen Ausgangstext – dann liefere ich die deutsche Fassung direkt als Body-Inhalt (ohne YAML-Front-Matter) und beachte dabei:
- vollständige Erhaltung der Markdown-Struktur (Überschriften, Listen, Links, Tabellen)
- unveränderte Code-Fences inkl. Sprach-Tags, Einrückung, Bezeichner, URLs, Pfade, Platzhalter und Literale – nur Kommentare und Docstrings werden ins Deutsche übersetzt
- exakte Beibehaltung aller
{{SVG_TEXT_N}}-Platzhalter sowie der SVG-Attribute; Übersetzung ausschließlich des Textinhalts in<text>/<tspan> - konsistente Verwendung der Glossarbegriffe (APIYI, Großes Sprachmodell, Eingabeaufforderung, API-Schlüssel, API-Proxy-Dienst, Modellaufruf, Gesichtskonsistenz, Bilderzeugung, Text-zu-Bild, Bild-zu-Bild, multimodal, Kontextfenster, Referenzbild)
- natürliches, kollegiales Hochdeutsch ohne Übersetzungsstil und ohne bürokratische Formulierungen
Sobald der Quelltext vorliegt, lege ich los.
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # mehrere Kandidatenmodelle über APIYI aufrufen
)

PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

TASK_PROMPT = "生成一个可在浏览器运行的单文件 3D 游戏原型……(所有模型使用同一提示词)"

def price(model, usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    return ((usage.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + usage.completion_tokens * p["output"]) / 1_000_000

def run_once(model, max_rounds=30):
    """Vereinfachte Agent-Schleife: Generieren → Prüfen → Ergebnis zurückspielen → Überarbeiten"""
    messages = [{"role": "user", "content": TASK_PROMPT}]
    total_cost, start = 0.0, time.time()
    for _ in range(max_rounds):
        resp = client.chat.completions.create(model=model, messages=messages)
        total_cost += price(model, resp.usage)
        code = resp.choices[0].message.content
        report = check_game(code)  # selbst implementieren: in Datei schreiben, Headless-Browser starten, Funktionsliste durchlaufen
        if report["passed"]:
            return True, total_cost, time.time() - start
        messages += [{"role": "assistant", "content": code},
                     {"role": "user", "content": f"检查结果:{report['log']},请修复"}]
    return False, total_cost, time.time() - start

def evaluate(model, trials=5, human_fix_cost=0.0):
    results = [run_once(model) for _ in range(trials)]
    successes = sum(r[0] for r in results)
    api_cost = sum(r[1] for r in results)
    rate = successes / trials
    per_success = (api_cost + human_fix_cost) / successes if successes else float("inf")
    print(f"{model}: 成功率 {rate:.0%},API 总费用 ${api_cost:.2f},"
          f"每个合格版本成本 ${per_success:.2f}")

for m in PRICES:
    evaluate(m)
🚀 Schnellstart: Beim Aufbau einer solchen Evaluierung empfiehlt es sich, das Skript zuerst mit einer kleinen Aufgabe zum Laufen zu bringen und erst danach auf die vollständige Spielaufgabe umzustellen. APIYI apiyi.com stellt neuen Nutzern kostenloses Testguthaben bereit – damit lässt sich die Harness- und Abrechnungslogik erst einmal validieren, bevor das eigentliche Evaluierungsbudget fließt.
5 Wie man Modelle für die AI-Spieleentwicklung auswählt: Token-Kosten bei komplexen Aufgaben kontrollieren
5.1 Die Erfolgsrate entscheidet über die Gesamtkosten
Die vollständigen Entwicklungskosten setzen sich aus drei Komponenten zusammen:
Gesamtkosten einer Aufgabe = Modellaufrufkosten + Werkzeugausführungskosten + Kosten für manuelle Reparaturen
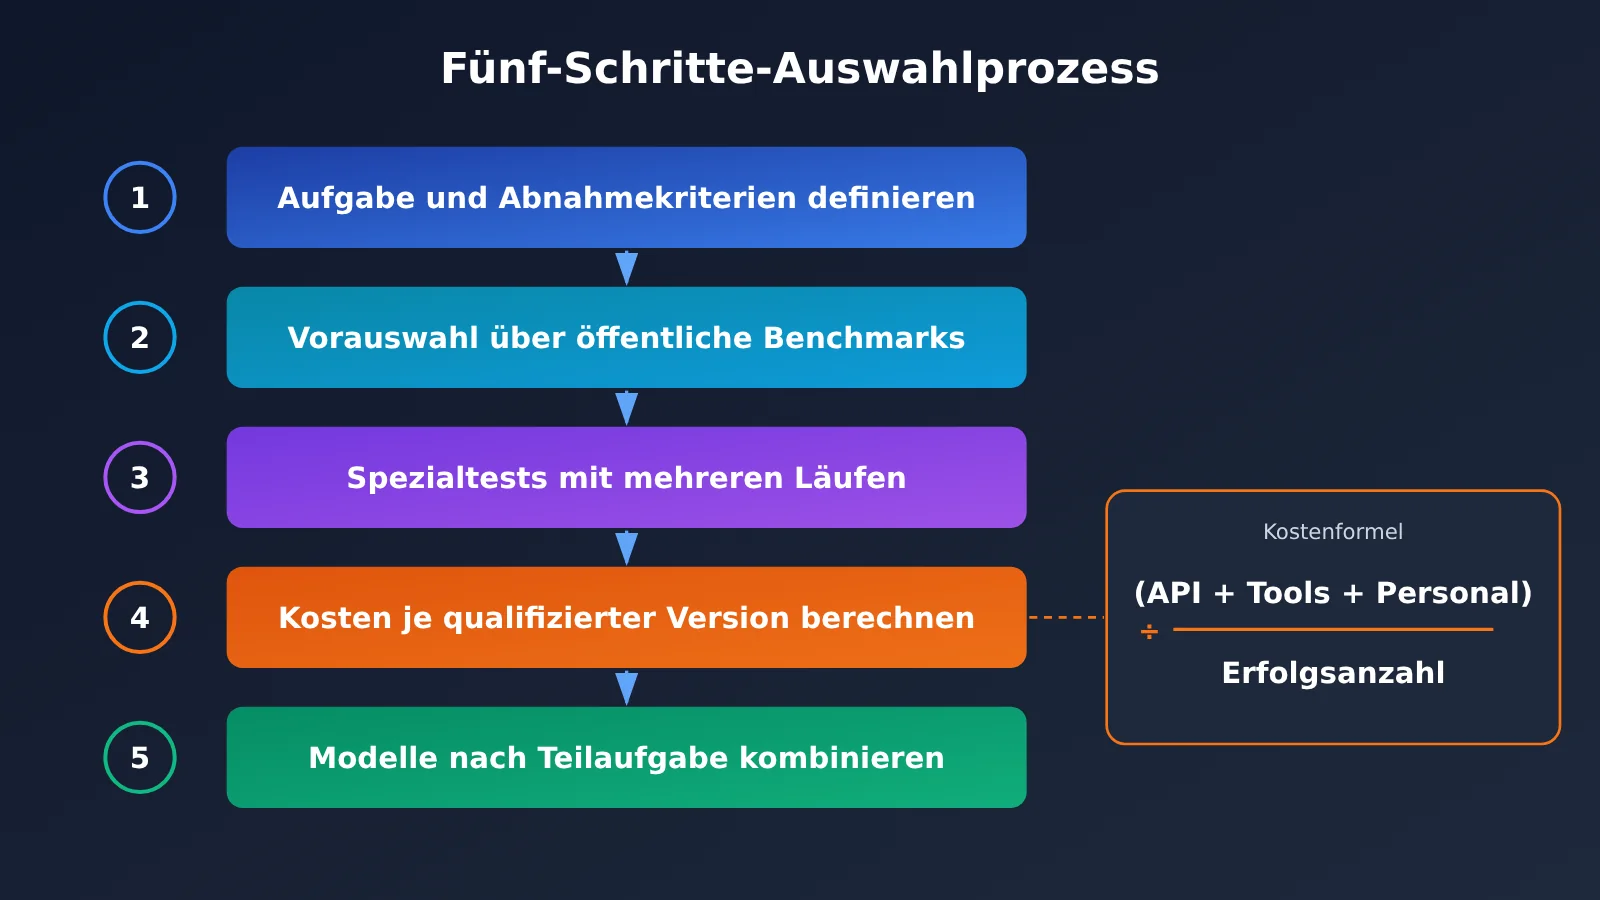
Bezieht man die Erfolgsrate mit ein, ist ein praktischerer Vergleichsmaßstab die „Kosten pro qualifizierter Version“: die Gesamtausgaben aller Versuche geteilt durch die Anzahl der Erfolge. Angenommen, Modell A kostet 100 US-Dollar pro Versuch bei einer Erfolgsrate von 80 % – dann kostet jede qualifizierte Version etwa 125 US-Dollar. Modell B kostet 30 US-Dollar pro Versuch bei einer Erfolgsrate von 20 % – dann kostet jede qualifizierte Version etwa 150 US-Dollar, zuzüglich der Zeit für die Fehlersuche an gescheiterten Versionen. Das Modell mit dem niedrigeren Stückpreis ist in diesem Beispiel also tatsächlich teurer.
Manuelle Reparaturen sind oft der größte Posten. Wenn ein Ingenieur mehrere Stunden damit verbringt, ein generiertes Ergebnis zu reparieren, können die Personalkosten die gesamten API-Kosten übersteigen. Deshalb sollte man bei der Bewertung die Dauer manueller Eingriffe ehrlich erfassen und sie mit dem tatsächlichen Personalkostensatz des Teams in die Gesamtkosten einrechnen.
5.2 Drei Strategien zur Modellauswahl
| Strategie | Geeignete Szenarien | Vorteile | Zu beachtende Kosten |
|---|---|---|---|
| Leistungsstarke Modelle | Komplexe Architektur, Entwicklung mit langem Kontext, Zusammenarbeit mehrerer Module, Lokalisierung komplexer Bugs | Hohe Erfolgsquote, weniger erneute Läufe und manuelle Nacharbeit | Hoher Stückpreis; Eingabekosten müssen über Caching kontrolliert werden |
| Kostengünstige Modelle | Einfache Funktionen, Code-Erklärungen, repetitive Änderungen, Testunterstützung | Niedriger Stückpreis, geeignet für häufige Aufrufe | Bei komplexen Aufgaben sind mehrere Fehlversuche möglich, die Gesamtkosten steigen dann sogar |
| Zusammenarbeit mehrerer Modelle | Ein Modell übernimmt die Architektur, eines die Implementierung, ein unabhängiges Modell das Code-Review | Fähigkeiten und Preis werden pro Phase passend abgestimmt | Übergaben zwischen Modellen übertragen den Kontext erneut und erhöhen Token- sowie Koordinationskosten |
Wie sehr die Zusammenarbeit mehrerer Modelle Kosten spart, hängt von den Übergabekosten ab. Bei jeder Übergabe muss der Projektkontext erneut an ein anderes Modell geschickt werden, und Caches lassen sich zwischen verschiedenen Modellen nicht gemeinsam nutzen. Die Zusammenarbeit lohnt sich nur, wenn die kostengünstigen Modelle genügend Phasen übernehmen und die Zahl der Übergaben klein genug bleibt – auch das muss praktisch getestet und bestätigt werden.
💰 Kostenhinweis: Bei der Zusammenarbeit mehrerer Modelle werden in einem Projekt gleichzeitig Modelle mehrerer Anbieter aufgerufen. Mit APIYI apiyi.com lassen sich diese über denselben Key und denselben Code anbinden. Das reduziert den Aufwand für die Verwaltung mehrerer Konten und die Anpassung der Schnittstellen und erleichtert es, Architektur, Implementierung und Review auf verschiedene Modelle zu verteilen und die Kosten anschließend einheitlich zu erfassen.
5.3 Ein umsetzbarer Fünf-Schritte-Prozess zur Modellauswahl
- Aufgabe und Abnahmekriterien definieren: Funktionsliste, Zielplattformen und Mindestleistung klar festhalten – das ist die Grundlage, um Erfolg überhaupt beurteilen zu können.
- Mit öffentlichen Benchmarks vorfiltern: Ergebnisse aus SWE-bench Verified und Aider Polyglot in der aktuellen Version mit eindeutig dokumentierter Konfiguration heranziehen und Modelle aussortieren, deren Codefähigkeiten offensichtlich nicht ausreichen.
- Gezielte Evaluierung durchführen: In einer einheitlichen Umgebung jedes Kandidatenmodell dieselbe Spielaufgabe 5 bis 10 Mal laufen lassen und dabei die zehn Kennzahlen aus Abschnitt 4.2 protokollieren.
- Kosten je tauglicher Version berechnen: API-Kosten plus Tool-Kosten plus manuelle Reparaturkosten, geteilt durch die Anzahl der Erfolge.
- Modelle nach Prozessschritt kombinieren: Komplexe Schritte an Modelle mit hoher Erfolgsquote geben, repetitive Schritte an kostengünstige Modelle – und dann messen, ob die Kombination wirklich günstiger ist.
Preise ändern sich; für Gemini 4 Argon ist bereits eine Preisanpassung ab dem 1. Dezember angekündigt. Bei den Bewertungsergebnissen sollten die ursprünglichen Token-Daten erhalten bleiben – ändern sich die Preise, genügt es, die neuen Einzelpreise einzusetzen, um die Schlussfolgerung zu aktualisieren.
6 Häufig gestellte Fragen (FAQ) zur Modellauswahl in der KI-Spieleentwicklung
Q1: Sind die 550 US-Dollar bei Saltline eine tatsächliche Rechnung?
Es handelt sich nicht um eine geprüfte Abrechnung. Die 550 US-Dollar sind eine Schätzung des Entwicklers Felix Rieseberg auf Basis der API-Preise; auch die begleitenden Daten (rund 8 Stunden, etwa 445 Millionen Eingabe-Token, rund 2,7 Millionen Ausgabe-Token) stammen aus seiner eigenen Darstellung. Beim Input wurde stark auf Caching gesetzt; das genaue Verhältnis von Cache-Schreibvorgängen und Cache-Lesevorgängen wurde nicht veröffentlicht.
Q2: Ist das Modell mit dem niedrigsten Stückpreis auch das günstigste?
Das hängt von der Erfolgsquote ab. Der Stückpreis bestimmt nur den Preis pro Token; wie viele Token ein Modell für die Erledigung einer Aufgabe benötigt, wie oft es neu gestartet werden muss und wie viel manuelle Nacharbeit nötig ist, hängt von der Modellfähigkeit ab. Sinnvoll ist ein Vergleich über „Gesamtkosten ÷ Anzahl erfolgreicher Ausführungen“.
Q3: Ist das Modell auf Platz 1 des SWE-bench am besten für die Spieleentwicklung geeignet?
SWE-bench Verified misst die Software-Engineering-Fähigkeit in echten Open-Source-Repositories; die Abdeckung von Shadern, 3D-Raumverständnis, Echtzeit-Rendering und Interaktionsgefühl ist begrenzt. Es eignet sich für eine Vorauswahl; für die endgültige Rangfolge in der Spieleentwicklung braucht es spezielle Evaluierungen.
Q4: Können die Werte im NIST-Bericht die heutigen Modelle repräsentieren?
Nein. Der NIST-CAISI-Bericht wurde 2025 veröffentlicht und testete historische Modelle wie GPT-5, Opus 4 und DeepSeek V3.1 sowie bestimmte experimentelle Konfigurationen. Für neue Modelle von November 2026 müssen neue Evaluierungen für deren jeweilige Version herangezogen werden.
Q5: Wie baut man schnell einen Vergleichstest für mehrere Modelle auf?
Am einfachsten ist eine Aggregator-Plattform mit OpenAI-kompatibler Schnittstelle. Nach der Registrierung bei APIYI apiyi.com und dem Abrufen des API-Schlüssels setzen Sie die base_url im Skript dieses Artikels auf `https://api.apiyi.com/v1` und ändern den model-Parameter, um mehrere Modelle mit demselben Skript zu testen. Neue Nutzer können das Skript zunächst mit dem kostenlosen Kontingent verifizieren.
Q6: Wie lassen sich die Token-Kosten bei der Evaluierung am genauesten erfassen?
Maßgeblich ist das Feld usage in der API-Antwort: Summieren Sie pro Aufruf die normalen Eingabe-, Cache-Lese- und Ausgabe-Token und rechnen Sie sie dann mit dem offiziellen Preis und der Abrechnungsstufe des jeweiligen Tages. Zusatzkosten wie Cache-Schreibvorgänge und Geschwindigkeitsstufen müssen nach den Regeln des jeweiligen Anbieters separat hinzugerechnet werden. Beim Aufruf über APIYI apiyi.com können Sie die Statistik auch mit den Verbrauchsprotokollen im Backend der Plattform abgleichen.
Q7: Können KI-generierte Spielprototypen direkt live gehen?
Prototypen wie Saltline belegen, dass Modelle ohne menschliches Feedback eine spielbare Version produzieren können. Ein kommerzieller Livegang umfasst jedoch browserübergreifende Kompatibilität, Mobilgeräte-Anpassung, Performance-Optimierung und langfristige Wartung. Browserspiele sind durch lokale Hardware und den Browser begrenzt; die Saltline-Seite weist auch auf Probleme wie eine langsame Initialisierung und die Notwendigkeit hin, bei Ruckeln auf niedrigere Grafikqualität umzuschalten. Die Test- und Optimierungskosten vor dem Livegang sollten in die Gesamtentwicklungskosten eingerechnet werden.
7 Zentrale Erkenntnisse zur Modellauswahl für die KI-Spielentwicklung
- Zentrale Kennzahl: Vergleichen Sie die End-to-End-Kosten jeder geeigneten Version, nicht den Preis pro Million Token.
- Saltline-Abrechnung: Die rund 550 US-Dollar sind eine vom Entwickler selbst genannte Schätzung; etwa 108 US-Dollar entfallen auf die Ausgabe, der Rest auf die Eingabeseite.
- Caching bestimmt die Größenordnung: Bei langen Aufgaben macht der Eingabeanteil den größten Teil aus; der Preis für Cache-Lesevorgänge und die Trefferquote haben den größten Einfluss.
- Preise sind zeitgebunden: Die Preise in diesem Artikel gelten Stand 16. November 2026; Gemini 4 Argon plant ab dem 1. Dezember eine Preisanpassung.
- Benchmarks dienen der Vorauswahl: SWE-bench und Aider messen allgemeine Programmierfähigkeiten; die Fähigkeiten für die Spieleentwicklung müssen gesondert evaluiert werden.
- Mehrfachdurchläufe: Jedes Modell unter gleichen Bedingungen 5- bis 10-mal ausführen und Schlussfolgerungen anhand der Erfolgsrate statt anhand eines Einzelergebnisses ziehen.
- Einstieg: Über die einheitliche Schnittstelle von APIYI (apiyi.com) zwischen Modellen wechseln – so lassen sich Kosten mit demselben Skript vergleichen.
8 Fazit: Methodik zur Modellauswahl für die eigenständige Spieleentwicklung mit KI
Wenn KI ein Spiel eigenständig entwickeln soll, sind bei der Modellauswahl drei Kernpunkte entscheidend:
- Kosten vollständig erfassen: Die Gesamtkosten einer Aufgabe umfassen Modellaufrufe, Tool-Ausführung und manuelle Korrekturen; die API-Kosten sind nur einer dieser Posten.
- Fähigkeiten praktisch testen: Öffentliche Benchmarks dienen der Vorauswahl; die endgültige Rangfolge für die Spieleentwicklung ergibt sich aus mehreren spezifischen Evaluierungen unter einheitlichen Bedingungen.
- Nach Arbeitsschritten kombinieren: Für komplexe Schritte Modelle mit hoher Erfolgsrate einsetzen, für repetitive Schritte kostengünstige Modelle; auch Kombinationslösungen müssen praktisch validiert werden.
Saltline liefert eine Größenordnung als Referenz: eine einzelne Eingabeaufforderung, rund 8 Stunden und geschätzte Kosten von etwa 550 US-Dollar für einen spielbaren 3D-Prototyp im Browser. Wie viel Ihr Projekt benötigt, hängt von der Aufgabenkomplexität und der Erfolgsrate der ausgewählten Modelle ab. Am zuverlässigsten ist es, mit dem Framework aus diesem Artikel eine eigene Evaluierung durchzuführen.
Empfohlen: Bauen Sie über APIYI (apiyi.com) schnell eine Vergleichsumgebung für mehrere Modelle auf. Die Plattform bietet eine OpenAI-kompatible Schnittstelle und kostenloses Guthaben für neue Nutzer, sodass sich Preise und Erfolgsraten bequem im selben Skript messen lassen.
Referenzen
- Saltline – eigenständige Demo-Seite: Spiel-Demo und Hinweise zu häufigen Fragen
- Link:
saltline.games -
Beschreibung: Enthält Informationen zur Initialisierung, zum Umschalten der Grafikqualität, zur Steuerung usw.
-
Saltline – Code-Mirror und README: Hinweise zur Datenherkunft für Entwickler
- Link:
github.com/realcodebear/saltline-fable-5.2 -
Beschreibung: Dokumentiert Erstellungszeitpunkt, Token und die Quelle der geschätzten Kosten
-
Jimao – Repository der chinesischen Version: Archiv der chinesisch verpackten Saltline-Version
- Link:
github.com/Megasu/jimao-3a-game -
Beschreibung: Bietet Daten wie die Dateigröße von index.html
-
Claude Fable 5.2 – Modellspezifikationen und Preise: Offizielle Anthropic-Dokumentation
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview -
Beschreibung: Preise für Input, Output, Caching und Fast Mode
-
GPT-6 Astra – Modelldokumentation: Offizielle OpenAI-Preise
- Link:
developers.openai.com/api/docs/models/gpt-6-astra -
Beschreibung: Maßgeblich für die Preise der Standardverarbeitungsstufe
-
SWE-bench Verified: Offizielle Seite des Software-Engineering-Benchmarks
- Link:
swebench.com/verified.html -
Beschreibung: 500 manuell geprüfte Aufgaben sowie Hinweise zur einheitlichen Konfiguration von mini-SWE-agent
-
Aider Leaderboards: Ergebnisse des Aider-Polyglot-Benchmarks
- Link:
aider.chat/docs/leaderboards -
Beschreibung: Erfasst gleichzeitig Korrektheit, Token-Verbrauch und Betriebskosten
-
NIST CAISI-Bewertungsbericht (2025): Unabhängige Bewertung früherer Modelle
- Link:
nist.gov/system/files/documents/2025/09/30/CAISI_Evaluation_of_DeepSeek_AI_Models.pdf - Beschreibung: Enthält historische Ergebnisse aus SWE-bench Verified samt Standardfehlern
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com – weitere Integrationsmaterialien finden Sie im Dokumentationszentrum docs.apiyi.com