Ringkasan: Saat memilih model untuk pengembangan game, fokuslah pada tingkat keberhasilan pada tugas yang sama, waktu eksekusi, biaya API, dan biaya perbaikan manual; tabel harga serta benchmark kode generik hanyalah bahan pendukung.
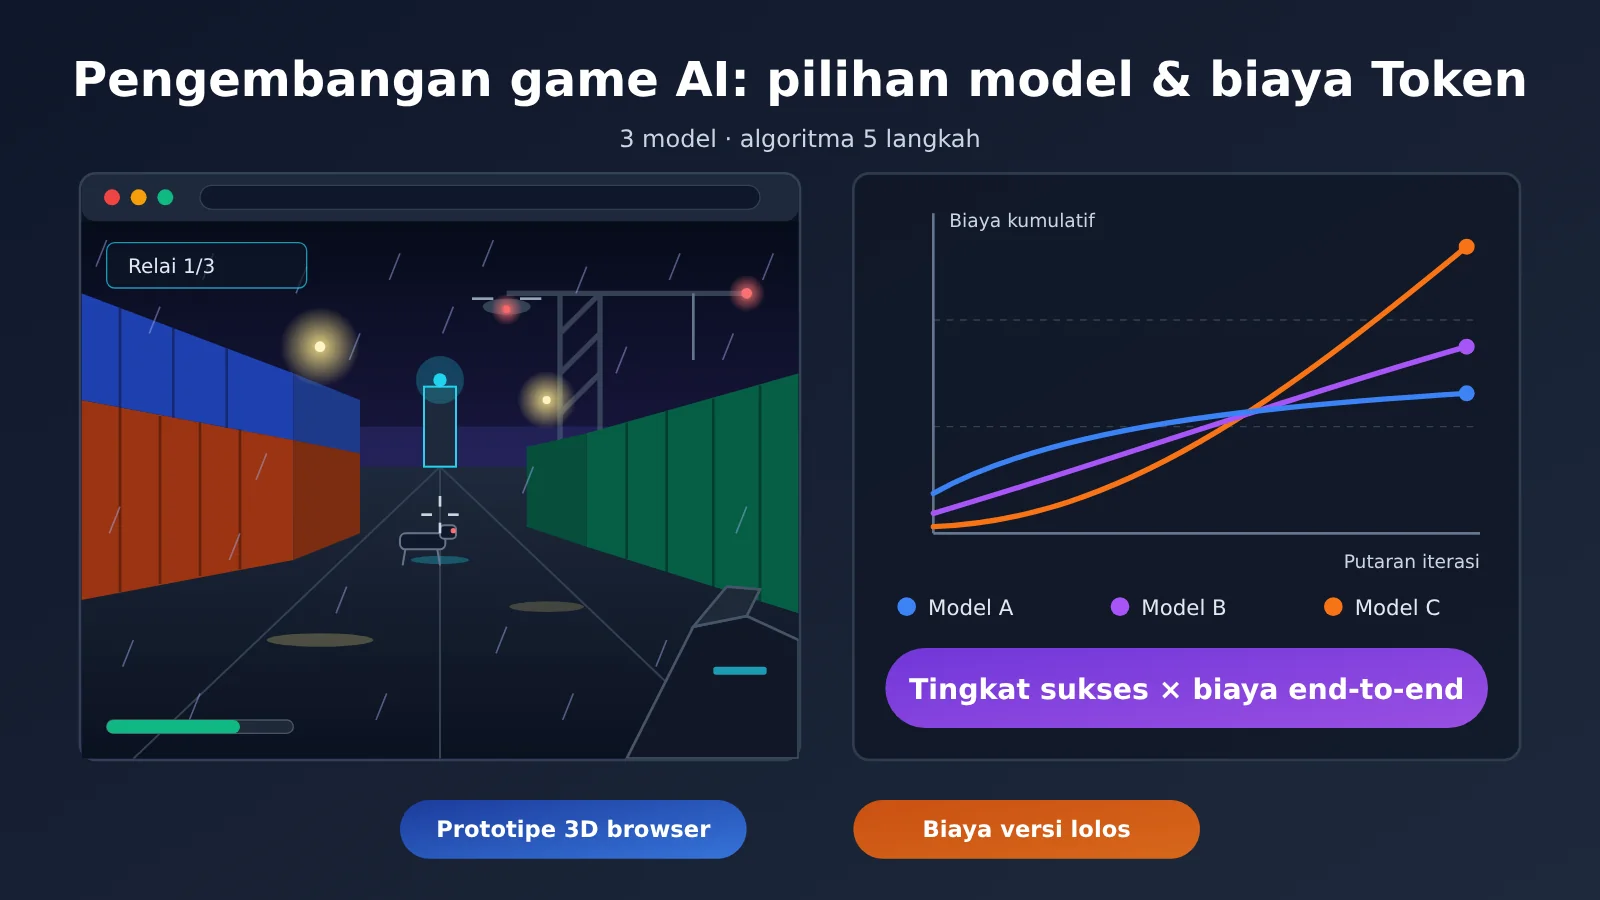
Kesimpulan di awal: Saat membiarkan AI mengembangkan game secara mandiri, yang pada akhirnya dibandingkan adalah biaya end-to-end untuk menyelesaikan satu versi yang dapat diserahkan, bukan harga per juta token. Dalam studi kasus Saltline, Claude Fable 5.2 menghabiskan sekitar 8 jam, sekitar 445 juta token input, dan sekitar 2,7 juta token output untuk menghasilkan prototipe game tembak 3D yang dapat berjalan di browser. Berdasarkan harga API, pengembang memperkirakan biayanya sekitar US$550, dan sebagian besar input menggunakan cache. Per 16 November 2026, harga satuan API standar dari ketiga model berselisih hingga sekitar 5 kali; namun jika model dengan harga satuan lebih rendah membutuhkan lebih banyak putaran, biaya totalnya bisa lebih tinggi. Jadi, metode pemilihan yang andal adalah: berikan tugas game yang sama kepada model kandidat, jalankan berulang kali, catat tingkat keberhasilan, token, waktu, dan beban perbaikan manual, lalu hitung “biaya per versi yang memenuhi syarat”.
Pratinjau konten: Bagian 1 membedah struktur tagihan token dari eksperimen pengembangan game AI menggunakan Saltline. Bagian 2 membandingkan harga resmi ketiga model dan menjelaskan dampak cache terhadap total biaya. Bagian 3 membahas apa yang dapat dijelaskan oleh SWE-bench Verified, Aider Polyglot, dan evaluasi historis NIST. Bagian 4 menyajikan rencana evaluasi khusus pengembangan game yang dapat direproduksi beserta kode. Bagian 5 mengubah hasilnya menjadi strategi pemilihan model.
Yang Perlu Diketahui: Terminologi Pemilihan Model untuk Pengembangan Game AI
| Istilah | Penjelasan |
|---|---|
| Token masukan | Ukuran konten yang dikirim untuk diproses model, termasuk petunjuk, file kode, hasil yang dikembalikan alat, dan sebagainya |
| Token keluaran | Ukuran konten yang dihasilkan model, misalnya kode, teks penjelasan, dan parameter pemanggilan alat |
| Pembacaan cache | Menggunakan kembali konteks yang sudah di-cache; biayanya jauh lebih rendah daripada masukan biasa |
| Penulisan cache | Biaya saat pertama kali menyimpan konteks ke cache, biasanya sedikit lebih tinggi daripada masukan biasa |
| SWE-bench Verified | Benchmark berisi 500 tugas rekayasa perangkat lunak dari proyek sumber terbuka nyata yang telah diverifikasi manual |
| Aider Polyglot | Evaluasi perubahan kode yang mencakup 6 bahasa pemrograman dan 225 soal latihan |
| Harness | Kerangka eksekusi yang mengatur model, alat, dan siklus tugas, misalnya kerangka kerja Agen |
| Tingkat keberhasilan tugas | Proporsi tugas yang diselesaikan sesuai kriteria penerimaan yang ditetapkan sebelumnya |
| Biaya end-to-end | Jumlah biaya pemanggilan model, eksekusi alat, dan tenaga manusia untuk menyelesaikan seluruh tugas |
| Perbaikan manual | Modifikasi manual yang dilakukan agar hasil generasi memenuhi kriteria penerimaan |
| Pembuatan prosedural | Membuat geometri, tekstur, dan suara dengan kode serta fungsi matematika, bukan dengan mengimpor file aset |
| Shader | Program yang berjalan di GPU untuk menghitung warna, pencahayaan, material, dan efek visual lainnya |
1 Studi kasus biaya game yang dikembangkan sendiri oleh AI: berapa Token yang dihabiskan Saltline
1.1 Seberapa besar skala game Saltline
Pada 9 November 2026, engineer Anthropic Felix Rieseberg mempublikasikan sebuah eksperimen pemrograman Claude Fable 5.2. Ia hanya memberikan satu petunjuk kepada model: buatkan game first-person shooter berskala kecil dengan tampilan visual yang sedekat mungkin dengan game AAA, dan sepanjang proses tidak ada umpan balik manusia sama sekali. Hasilnya adalah Saltline: game tembak-menembak 3D yang langsung berjalan di browser, berlatar pelabuhan peti kemas di malam hujan, di mana pemain harus mematikan tiga stasiun relai sinyal lalu mengevakuasi diri, dengan musuh berupa drone patroli udara dan anjing mekanik darat.
Dari segi skala, Saltline adalah prototipe yang bisa dimainkan, satu pemain, satu level. “3A” di sini adalah target eksperimen dan analogi visual untuk menggambarkan gaya grafisnya; ukurannya sangat jauh dari produk AAA komersial. “几猫·国产3A大作” yang beredar di Tiongkok adalah versi bahasa Mandarin atau versi kemasan ulang dari Saltline; namanya muncul dari proses penyebaran dan tidak mewakili kepemilikan pengembangannya.
1.2 Waktu, Token, dan biaya menurut pengakuan pengembang
Data berikut semuanya berasal dari unggahan pengembang sendiri di X, berupa estimasi berdasarkan keterangan pribadi dan belum diaudit pihak ketiga:
- Waktu pengembangan: sekitar 8 jam
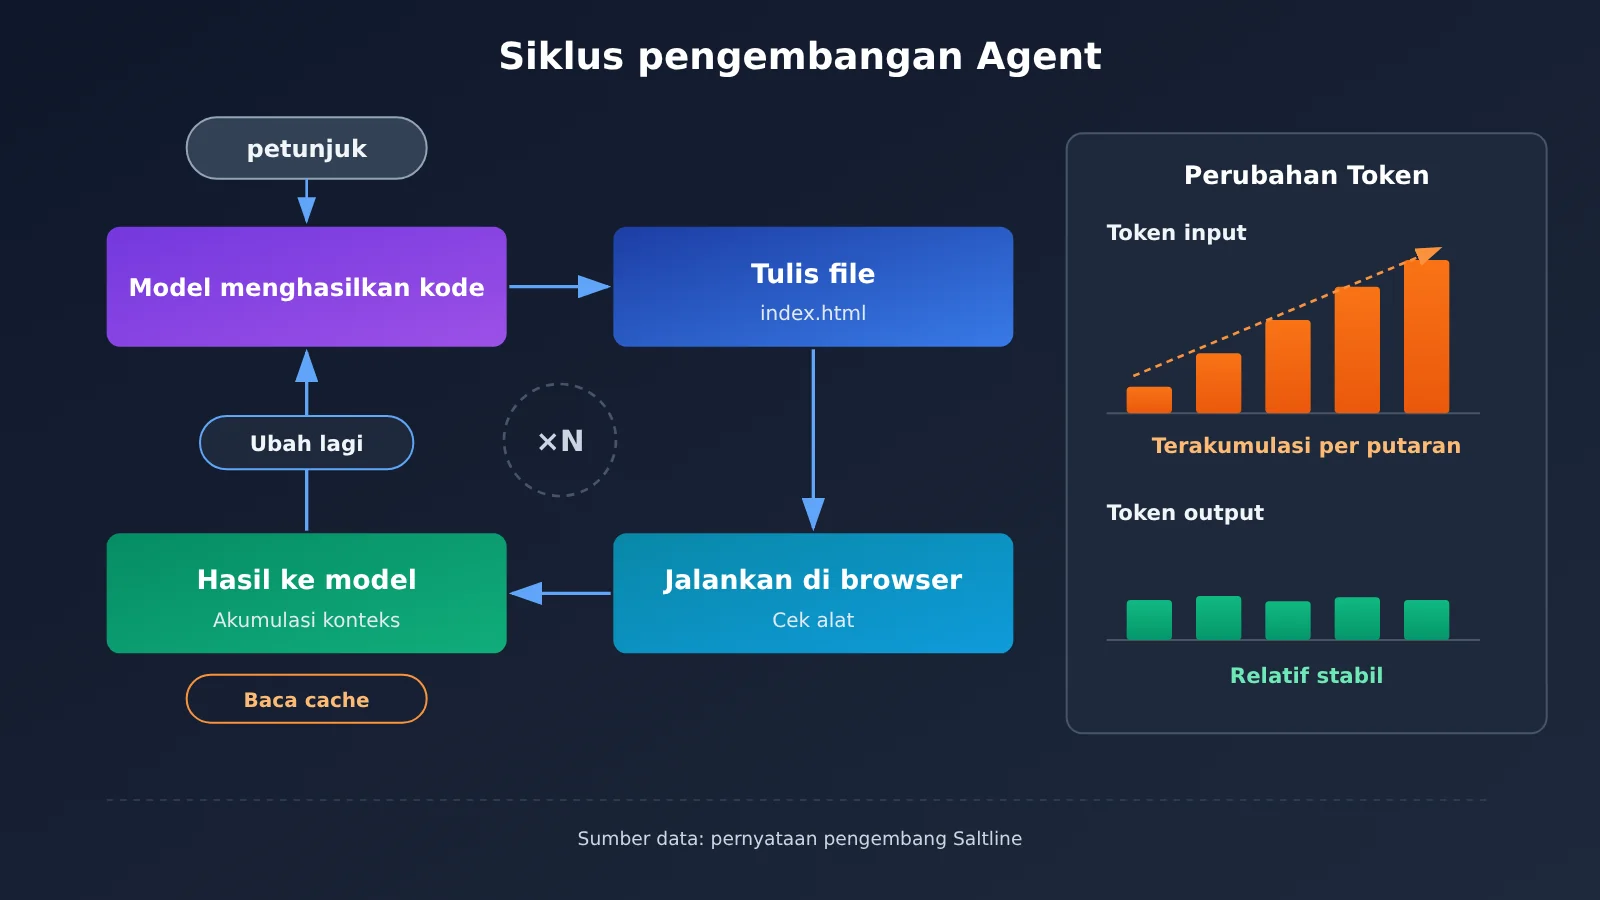
- Token input: sekitar 445 juta, sebagian besar menggunakan cache
- Token output: sekitar 2,7 juta
- Perkiraan biaya berdasarkan harga API: sekitar 550 dolar AS
- Cara pengembangan: satu kali petunjuk, iterasi tanpa umpan balik manusia
Uang ini adalah biaya generasi sekali pakai. Setelah file game dihasilkan, game berjalan secara lokal di browser pemain, dan saat bermain pemain tidak memanggil Claude API. Jadi 550 dolar AS itu tidak bisa dialokasikan sebagai “biaya AI per pemain”.
1.3 Membedah biaya ini dengan harga satuan resmi
Menurut harga standar resmi Claude Fable 5.2 (output $40 / juta Token), 2,7 juta Token output setara sekitar 108 dolar AS. Sisanya sekitar 440 dolar AS berada di sisi input, mencakup penulisan cache, pembacaan cache, dan input biasa. Pengembang tidak mempublikasikan jumlah masing-masing dari ketiganya, sehingga tidak bisa diurai lebih jauh.
Dengan membandingkan dua nilai batas saja sudah terlihat peran cache: jika 445 juta input semuanya dihitung dengan harga input biasa $8, hasilnya sekitar 3.560 dolar AS; jika semuanya dihitung dengan harga pembacaan cache $0,20, hasilnya sekitar 89 dolar AS. Estimasi aktual berada di antara keduanya, dan jelas lebih dekat ke batas bawah. Ini menunjukkan bahwa dalam tugas pengembangan Agent yang berjalan lama, tingkat cache hit di sisi input menentukan besaran tagihan, sedangkan pengaruh harga satuan output relatif sekunder.
1.4 Mengapa file 1,4MB bisa menghabiskan 445 juta Token
Versi HTML mandiri Saltline berukuran sekitar 1,43MB (1.425.707 byte). Pengembang menjelaskan bahwa model dan tekstur di dalam game semuanya adalah kode, struktur geometri dibangun secara programatik, kualitas permukaan dihitung oleh shader, dan suara juga dihasilkan secara programatik — tidak ada aset gambar atau model 3D terpisah.
Hasil generasinya kecil, tetapi prosesnya panjang. Selama 8 jam, Agent berulang kali membaca file kode yang terus bertambah, menjalankan alat, memeriksa hasil, lalu merevisi; setiap putaran harus mengirim ulang konteks dalam jumlah besar ke model. Konsumsi Token pada akhirnya sebagian besar berasal dari siklus ini, bukan dari panjang file akhir. Inilah sebabnya saat mengevaluasi model untuk pengembangan game, “biaya proses” wajib diukur.
2 Perbandingan harga model pengembangan game: perbedaan penagihan Token di tiga API
2.1 Harga standar resmi ketiga model
Semua harga pada tabel berikut diambil dari halaman resmi masing-masing penyedia per 16 November 2026, dalam dolar AS per satu juta Token, dengan tingkat penagihan harga API standar, tanpa diskon dari saluran lain maupun biaya tambahan regional.
| Model | Input biasa | Output | Pembacaan cache | Catatan |
|---|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 | Penulisan cache 5 menit $10, penulisan cache 1 jam $16; konteks 1M, output maksimum 128K |
| GPT-6 Astra | $10 | $50 | $1 | Tingkat pemrosesan standar; harga untuk opsi kecepatan lain, batch, dan regional bisa berbeda |
| Gemini 4 Argon | $2 | $10 | $0.10 | Harga ini berlaku hingga 30 November 2026; mulai 1 Desember direncanakan berubah menjadi input $4, output $20 |
Claude Fable 5.2 juga punya Fast Mode, dengan input $16 dan output $80; pihak resmi menyebut kecepatan output bisa meningkat hingga 2,5 kali. Untuk tugas panjang yang harus selesai dalam batas waktu tetap, tingkat kecepatan akan mengubah durasi sekaligus biaya, jadi saat evaluasi sebaiknya dicatat sebagai konfigurasi tersendiri.
💡 Saran perbandingan: Antarmuka dan bidang penagihan ketiga model berbeda-beda, jadi saat membangun lingkungan evaluasi sendiri Anda perlu menghubungkannya satu per satu. APIYI apiyi.com menyediakan antarmuka terpadu yang kompatibel dengan OpenAI; satu kunci API saja sudah bisa memanggil model seperti Claude, GPT, dan Gemini, sehingga memudahkan pergantian model dalam satu skrip evaluasi. Model yang tersedia dan harganya mengikuti daftar di platform.
2.2 Selisih harga resmi pada jumlah Token yang sama
Untuk merasakan langsung perbedaan harga satuan, Anda bisa memasukkan volume output Saltline (2,7 juta Token) ke harga ketiga penyedia: Claude Fable 5.2 sekitar $108, GPT-6 Astra sekitar $135, dan Gemini 4 Argon sekitar $27. Jika 445 juta input semuanya kena pembacaan cache, ketiganya masing-masing sekitar $89, $445, dan $45.
Angka-angka ini hanya menggambarkan struktur penagihan, dengan asumsi ketiga model menghabiskan Token yang persis sama—padahal dalam praktiknya asumsi itu hampir tidak pernah terpenuhi. Jumlah putaran yang dibutuhkan untuk menyelesaikan tugas yang sama, konteks yang dibaca di setiap putaran, dan panjang kode yang dihasilkan berbeda-beda antar model; menjalankan ulang setelah gagal pun akan melipatgandakan biaya.
2.3 Harga cache lebih layak diperhatikan daripada harga input
Dalam pengembangan gaya Agent, sebagian besar input adalah konteks yang berulang. Harga pembacaan cache GPT-6 Astra adalah 1/10 dari input biasa, Claude Fable 5.2 adalah 1/40, dan Gemini 4 Argon adalah 1/20. Semakin kecil rasio harga pembacaan cache terhadap harga input biasa, semakin mudah biaya input tugas panjang ditekan.
Cache juga punya biaya penulisan dan masa berlaku. Harga penulisan cache 5 menit dan cache 1 jam pada Claude berbeda; jika jeda antara dua putaran pemanggilan Agent melebihi masa berlaku cache, cache harus ditulis ulang. Saat memperkirakan biaya tugas panjang, jumlah penulisan cache, tingkat hit, dan masa berlaku perlu dihitung bersama.
3 Apa yang Bisa Dijelaskan Benchmark Pemrograman: Referensi Kemampuan Model Pengembangan Game
3.1 SWE-bench Verified: tugas rekayasa perangkat lunak pada repositori nyata
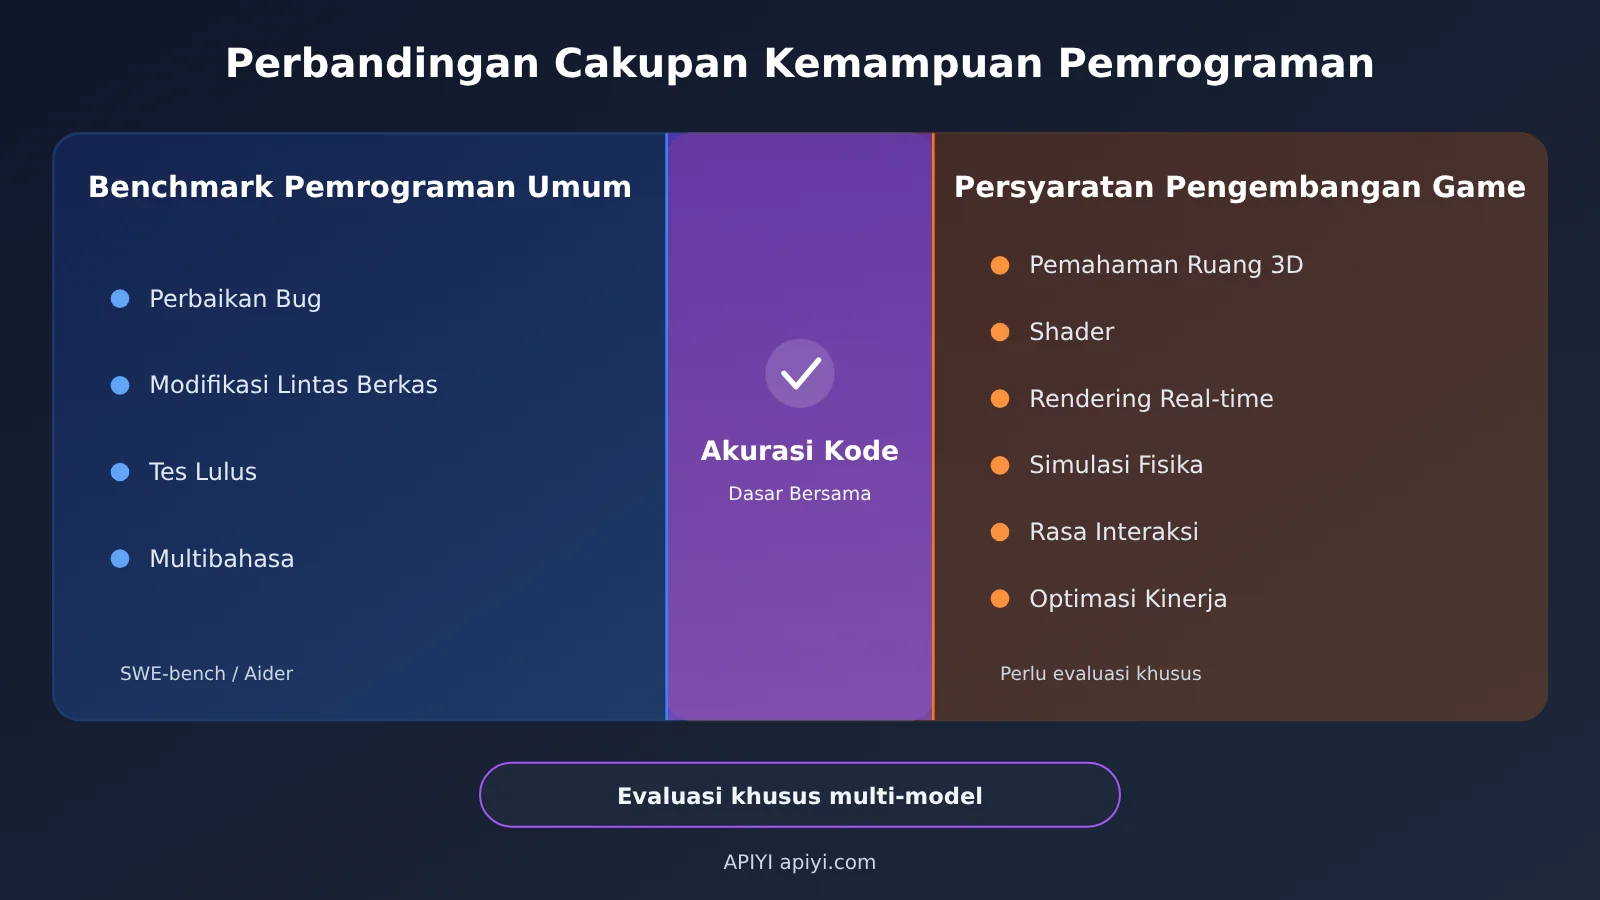
SWE-bench Verified berisi 500 masalah yang telah disaring dan diverifikasi secara manual dari proyek open-source nyata. Model perlu memahami konteks repositori, menyelesaikan perbaikan bug, mengubah kode yang ada, mengatasi kegagalan pengujian, dan melakukan perubahan lintas file—lebih mendekati rekayasa nyata dibandingkan sekadar penyelesaian kode.
Saat menggunakannya, perhatikan pengaruh Harness. Penjelasan resmi menyebutkan bahwa papan peringkat lengkap mencampur berbagai sistem Agent; perbandingan model murni sebaiknya menggunakan konfigurasi mini-SWE-agent yang seragam. Konfigurasi Agent, alat, petunjuk, dan versi semuanya dapat mengubah skor, sehingga hasil dari konfigurasi berbeda harus dilihat secara terpisah.
3.2 Aider Polyglot: mencatat akurasi dan biaya sekaligus
Aider Polyglot menggunakan 225 latihan pemrograman yang mencakup C++, Go, Java, JavaScript, Python, dan Rust, serta menggunakan kasus uji untuk menilai apakah model mengubah kode dengan benar. Hasil publiknya tidak hanya mencatat akurasi, tetapi juga konsumsi Token, biaya operasional, keluaran kesalahan, kesalahan format, dan waktu eksekusi setiap tugas.
Untuk pemilihan model, cara pencatatan “akurasi + biaya” ini sangat bernilai dan sejalan dengan kerangka evaluasi yang akan dibahas nanti di artikel ini. Soal-soalnya sendiri merupakan latihan mandiri, sehingga skala dan bentuknya jelas berbeda dari proyek game 3D yang utuh.
3.3 Evaluasi historis NIST: perhatikan versi model dan waktu
Dalam laporan evaluasi model yang diterbitkan pada 2025 oleh CAISI di bawah National Institute of Standards and Technology (NIST) Amerika Serikat, sekelompok model diuji pada SWE-bench Verified. Data berikut semuanya merupakan model historis dan konfigurasi eksperimen dalam laporan tersebut, bukan peringkat model terbaru pada November 2026.
| Model (versi yang diuji dalam laporan 2025) | Skor SWE-bench Verified |
|---|---|
| Anthropic Opus 4 | 66.7% |
| GPT-5 | 63.0% |
| DeepSeek V3.1 | 54.8% |
| DeepSeek R1-0528 | 44.6% |
| gpt-oss | 42.6% |
| DeepSeek R1 | 25.4% |
Laporan tersebut juga menyertakan galat standar, yang menunjukkan bahwa skor pada benchmark yang sama mengandung fluktuasi statistik. Selisih beberapa poin persentase mungkin tidak memiliki daya pembeda nyata dalam rentang galat. Claude Fable 5.2, GPT-6 Astra, dan Gemini 4 Argon yang dibandingkan dalam artikel ini tidak muncul dalam laporan tersebut; saat memilih model, carilah evaluasi terbaru yang ditujukan untuk versi saat ini dan mencantumkan konfigurasi, atau ujilah sendiri.
3.4 Kesenjangan antara kemampuan pemrograman umum dan kemampuan pengembangan game
Pengembangan game mencakup banyak pekerjaan yang kurang tercakup oleh benchmark rekayasa perangkat lunak umum: pemahaman ruang 3D, penulisan shader, rendering real-time, sistem animasi, simulasi fisika, sensasi interaksi, dan optimasi performa saat berjalan. Proyek seperti Saltline juga menuntut model menghasilkan aset visual dengan kode, yang bergantung pada pemahaman grafika dan efek visual.
Sebuah model bisa sangat mahir memperbaiki bug di repositori Python, tetapi hanya tampil biasa pada scene WebGL yang kompleks. SWE-bench dan Aider cocok untuk menyaring kandidat yang kemampuan kodenya jelas kurang, tetapi peringkat akhir perlu ditentukan oleh evaluasi khusus pengembangan game.
4 Cara Membandingkan Model Pengembangan Game AI: Skema Evaluasi Khusus untuk Tugas yang Sama
4.1 Merancang Tugas Game 3D Browser yang Seragam
Dengan mengacu pada format Saltline, tugas dapat didefinisikan sebagai: menghasilkan prototipe game 3D yang dapat dijalankan di browser dari satu petunjuk. Semua model kandidat menggunakan persyaratan yang persis sama:
- Menghasilkan proyek lengkap yang bisa langsung dibuka dan dijalankan di browser
- Mencakup karakter yang dapat dikendalikan dan lingkungan 3D
- Mencakup deteksi tabrakan atau fisika dasar
- Mencakup tujuan tugas yang jelas serta kondisi menang-kalah
- Tidak boleh ada modifikasi manual pada kode inti selama proses evaluasi
Tingkat kesulitan tugas harus mendekati kebutuhan nyata Anda. Tim yang membuat game kasual mini akan menaksir terlalu tinggi kelas model yang dibutuhkan jika menguji dengan prototipe FPS; tim yang mengerjakan proyek 3D kompleks akan menaksir terlalu rendah jika menguji dengan tugas 2D sederhana.
4.2 Sepuluh Metrik Evaluasi
| Dimensi | Hal yang Dievaluasi | Cara Pencatatan yang Disarankan |
|---|---|---|
| Kelengkapan fungsional | Apakah fungsi inti game telah diimplementasikan | Centang per item sesuai daftar fitur |
| Kualitas visual | Adegan, material, pencahayaan, animasi | Beri skor melalui penilaian buta (blind review) oleh beberapa orang |
| Kemampuan berjalan | Apakah dapat dijalankan dengan normal | Ya / Tidak |
| Kelengkapan interaksi | Apakah input dan umpan balik berjalan normal | Uji per item sesuai daftar operasi |
| Stabilitas | Apakah ada crash yang jelas | Catat jumlah crash selama durasi bermain tetap |
| Kinerja | FPS, waktu mulai, memori | Pengukuran langsung pada perangkat tetap |
| Kualitas kode | Keterbacaan, modularitas, penanganan error | Beri skor melalui review kode |
| Biaya Token | Input, output, cache | Akumulasi dari field API usage |
| Total waktu | Dari mulai hingga versi yang dapat dijalankan | Ukur waktu |
| Perbaikan manual | Intervensi manual yang dibutuhkan agar memenuhi standar | Catat jam kerja manual |
Di antara semuanya, “kemampuan berjalan”, “kelengkapan fungsional”, dan “kelengkapan interaksi” harus dijadikan syarat penerimaan yang bersifat wajib, untuk menentukan apakah suatu eksekusi berhasil; sedangkan visual, kinerja, dan kualitas kode digunakan untuk mengurutkan di antara hasil yang berhasil.
4.3 Mengontrol Lingkungan Pengujian
Apakah hasil evaluasi dapat dibandingkan atau tidak bergantung pada apakah variabel-variabelnya terkendali. Kondisi yang perlu diseragamkan meliputi: browser yang sama, perangkat yang sama, petunjuk yang sama, alur pengujian yang sama, anggaran waktu yang sama, serta apakah akses internet diizinkan. Jika model diizinkan memanggil alat, mencari materi, atau membuat file sendiri, maka izin alat untuk semua model juga harus sama.
Harness juga harus tetap. Model yang sama, jika diganti dengan framework Agent yang berbeda, tingkat keberhasilan dan konsumsi Token bisa berubah drastis, jadi laporan evaluasi harus mencantumkan framework yang digunakan, versi, dan parameternya, misalnya temperature, panjang output maksimum, dan tingkat kecepatan.
4.4 Setiap model dijalankan minimal beberapa kali
Pembuatan Model Bahasa Besar bersifat acak. Satu kali berhasil bisa jadi hanya keberuntungan, dan satu kali gagal bisa jadi hanya kebetulan. Setiap model sebaiknya dijalankan beberapa kali dalam kondisi yang sama (misalnya 5 hingga 10 kali), lalu dihitung tingkat keberhasilannya, serta rata-rata Token, waktu, dan skor kualitas dari sampel yang berhasil. Saltline sendiri juga hanya eksperimen tunggal—ia membuktikan bahwa hal ini bisa dilakukan, tetapi tidak bisa memberikan tingkat keberhasilan model tersebut pada tugas sejenis.
Skrip di bawah ini memanggil model melalui antarmuka yang kompatibel dengan OpenAI, lalu menghitung biaya satu kali pemanggilan berdasarkan field usage sesuai harga di Bagian 2:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI, ganti model cukup ubah model
)

# Satuan: dolar AS / juta Token, per harga resmi standar 2026-11-16
PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

def call_and_price(model: str, messages: list) -> tuple[str, float]:
    resp = client.chat.completions.create(model=model, messages=messages)
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + u.completion_tokens * p["output"]) / 1_000_000
    return resp.choices[0].message.content, cost
Nama model harap mengacu pada daftar model di platform pemanggilan yang benar-benar digunakan. Biaya penulisan cache dan biaya tambahan tingkat kecepatan perlu ditambahkan ke perhitungan sesuai aturan masing-masing penyedia.
Lihat skrip evaluasi multi-ronde dan ringkasan biaya
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Memanggil beberapa model kandidat melalui APIYI
)

PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

TASK_PROMPT = "生成一个可在浏览器运行的单文件 3D 游戏原型……(所有模型使用同一提示词)"

def price(model, usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    return ((usage.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + usage.completion_tokens * p["output"]) / 1_000_000

def run_once(model, max_rounds=30):
    """Loop Agent yang disederhanakan: hasilkan → periksa → kirim balik hasil → modifikasi"""
    messages = [{"role": "user", "content": TASK_PROMPT}]
    total_cost, start = 0.0, time.time()
    for _ in range(max_rounds):
        resp = client.chat.completions.create(model=model, messages=messages)
        total_cost += price(model, resp.usage)
        code = resp.choices[0].message.content
        report = check_game(code)  # Implementasikan sendiri: tulis file, luncurkan browser headless, jalankan daftar fitur
        if report["passed"]:
            return True, total_cost, time.time() - start
        messages += [{"role": "assistant", "content": code},
                     {"role": "user", "content": f"检查结果:{report['log']},请修复"}]
    return False, total_cost, time.time() - start

def evaluate(model, trials=5, human_fix_cost=0.0):
    results = [run_once(model) for _ in range(trials)]
    successes = sum(r[0] for r in results)
    api_cost = sum(r[1] for r in results)
    rate = successes / trials
    per_success = (api_cost + human_fix_cost) / successes if successes else float("inf")
    print(f"{model}: 成功率 {rate:.0%},API 总费用 ${api_cost:.2f},"
          f"每个合格版本成本 ${per_success:.2f}")

for m in PRICES:
    evaluate(m)
🚀 Mulai cepat: Saat membangun evaluasi semacam ini, sebaiknya jalankan skrip dengan tugas kecil terlebih dahulu, baru kemudian ganti dengan tugas game lengkap. APIYI apiyi.com menyediakan kuota uji coba gratis untuk pengguna baru — Anda bisa memakainya untuk memverifikasi Harness dan logika perhitungan biaya sebelum mengalokasikan anggaran evaluasi resmi.
5 Cara Memilih Model untuk Pengembangan Game AI: Mengendalikan Biaya Token pada Tugas Kompleks
5.1 Tingkat Keberhasilan Menentukan Total Biaya
Biaya pengembangan secara keseluruhan terdiri dari tiga komponen:
Total biaya tugas = biaya pemanggilan model + biaya eksekusi alat + biaya perbaikan manual
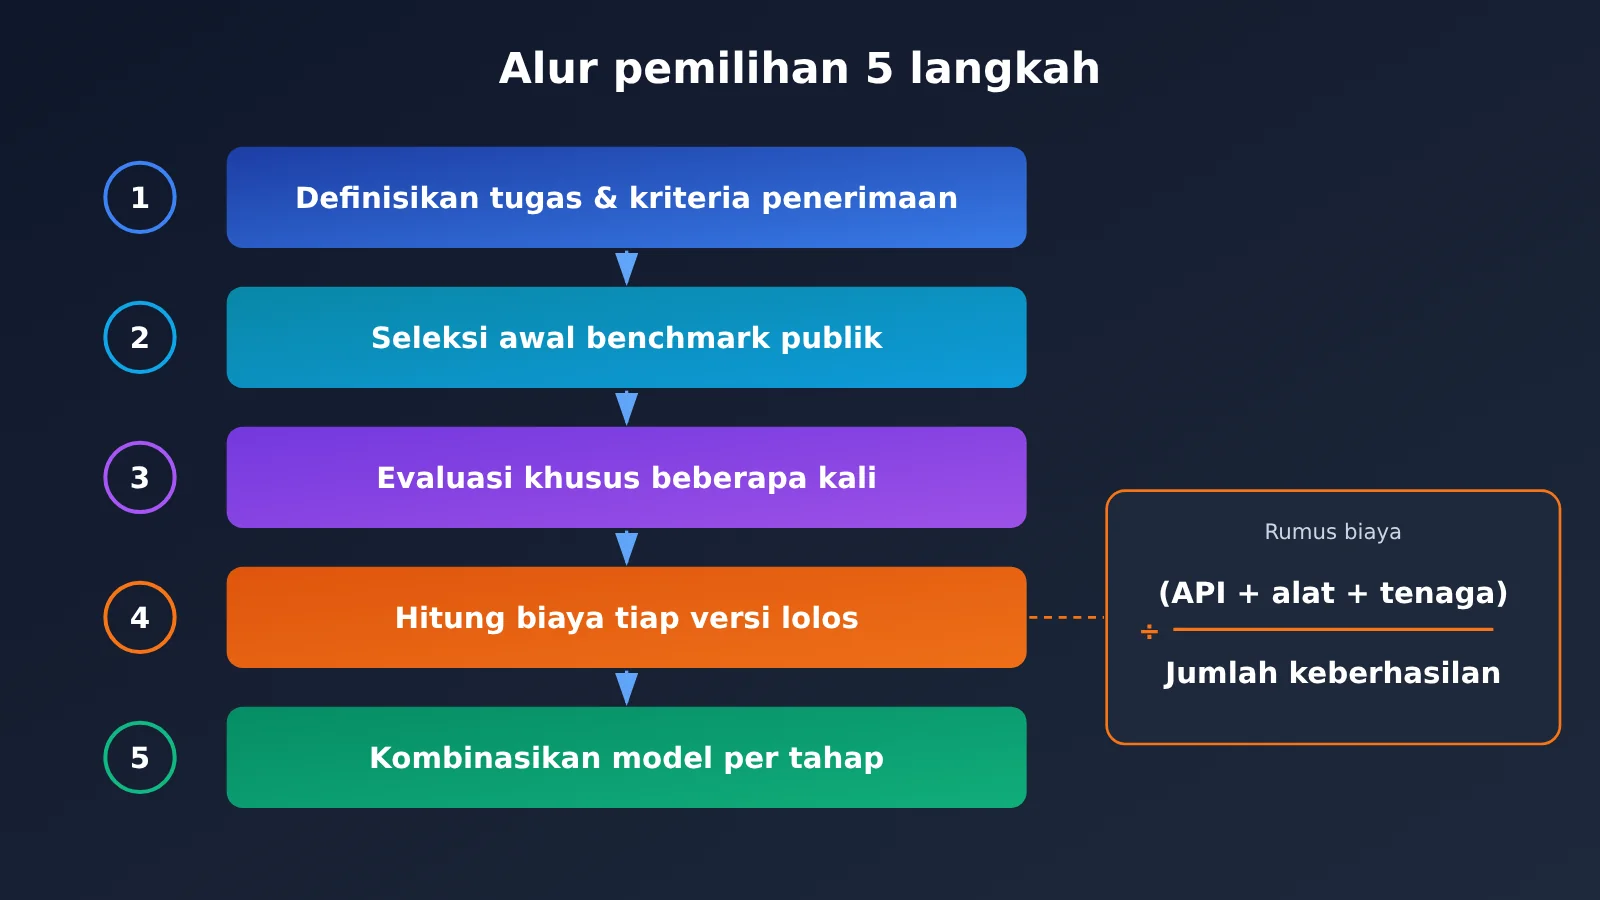
Jika tingkat keberhasilan turut diperhitungkan, indikator perbandingan yang lebih praktis adalah “biaya per versi yang lolos”: total pengeluaran seluruh percobaan dibagi dengan jumlah keberhasilan. Misalkan model A membutuhkan 100 dolar per percobaan dengan tingkat keberhasilan 80%, maka biaya per versi yang lolos sekitar 125 dolar; sementara model B hanya 30 dolar per percobaan dengan tingkat keberhasilan 20%, biaya per versi yang lolos justru sekitar 150 dolar, ditambah lagi waktu untuk menelusuri versi yang gagal. Dalam contoh ini, model dengan harga satuan lebih murah malah menjadi lebih mahal.
Perbaikan manual sering kali menjadi komponen terbesar. Seorang engineer yang menghabiskan beberapa jam untuk memperbaiki hasil generasi bisa menimbulkan biaya tenaga kerja yang melebihi keseluruhan biaya API. Karena itu, saat evaluasi, catatlah durasi intervensi manual secara akurat, lalu konversikan ke dalam total biaya berdasarkan tarif tenaga kerja aktual tim.
5.2 Tiga strategi pemilihan model
| Strategi | Skenario penggunaan | Keunggulan | Biaya yang perlu diperhatikan |
|---|---|---|---|
| Model berkemampuan tinggi | Arsitektur kompleks, pengembangan dengan konteks panjang, kolaborasi multi-modul, pelacakan Bug yang rumit | Tingkat keberhasilan tinggi, mengurangi pengulangan dan perbaikan manual | Harga per unit tinggi, perlu mengandalkan cache untuk mengendalikan biaya input |
| Model berbiaya rendah | Fitur sederhana, penjelasan kode, perubahan berulang, bantuan pengujian | Harga per unit rendah, cocok untuk pemanggilan frekuensi tinggi | Tugas kompleks bisa gagal berkali-kali, biaya total justru naik |
| Kolaborasi multi-model | Satu model menangani arsitektur, satu menangani implementasi, model independen melakukan tinjauan kode | Mencocokkan kemampuan dan harga per tahap | Serah-terima antar model mengirim ulang konteks, menambah Token dan biaya koordinasi |
Efek penghematan dari kolaborasi multi-model bergantung pada biaya serah-terima. Setiap serah-terima berarti konteks proyek harus dikirim ulang ke model lain, sementara cache antar model yang berbeda tidak bisa dibagi. Kolaborasi baru akan menguntungkan bila model berbiaya rendah menangani cukup banyak tahap dan jumlah serah-terima cukup sedikit — ini pun perlu dikonfirmasi lewat pengujian nyata.
💰 Saran biaya: Kolaborasi multi-model mengharuskan pemanggilan beberapa model sekaligus dalam satu proyek. Dengan mengaksesnya melalui APIYI apiyi.com menggunakan kunci API yang sama dan satu set kode yang sama, Anda bisa mengurangi pekerjaan pengelolaan banyak akun dan adaptasi antarmuka, sehingga lebih mudah membagi arsitektur, implementasi, dan tinjauan ke model berbeda lalu menghitung biaya secara terpadu.
5.3 Alur pemilihan lima langkah yang bisa langsung dijalankan
- Definisikan tugas dan kriteria penerimaan: tuliskan daftar fitur, platform target, dan batas minimal performa sebagai dasar penilaian keberhasilan.
- Saring awal dengan benchmark publik: gunakan skor SWE-bench Verified dan Aider Polyglot versi terkini dengan konfigurasi yang jelas, lalu singkirkan model yang kemampuan codingnya jelas kurang.
- Jalankan evaluasi khusus: dalam lingkungan yang seragam, jalankan tugas game yang sama 5 sampai 10 kali untuk setiap model kandidat, dan catat sepuluh metrik dari bagian 4.2.
- Hitung biaya setiap versi yang lolos: biaya API ditambah biaya alat ditambah biaya perbaikan manual, lalu dibagi jumlah keberhasilan.
- Kombinasikan model per tahap: serahkan tahap kompleks ke model dengan tingkat keberhasilan tinggi, tahap berulang ke model berbiaya rendah, lalu uji apakah kombinasi tersebut benar-benar lebih hemat.
Harga bisa berubah, misalnya Gemini 4 Argon sudah mengumumkan rencana penyesuaian harga mulai 1 Desember. Hasil evaluasi harus menyimpan data Token mentah; setelah harga berubah, cukup masukkan kembali harga satuan untuk memperbarui kesimpulan.
6 FAQ Umum tentang Pemilihan Model untuk Pengembangan Game AI
Q1: Apakah 550 dolar Saltline merupakan tagihan sebenarnya?
Bukan tagihan yang telah diaudit. 550 dolar adalah perkiraan biaya yang dihitung oleh developer Felix Rieseberg berdasarkan harga API, dan data pendukungnya (sekitar 8 jam, sekitar 445 juta Token input, sekitar 2,7 juta Token output) juga berasal dari keterangan pribadinya. Sebagian besar input menggunakan cache, namun proporsi pasti antara cache write dan cache read tidak dipublikasikan.
Q2: Apakah model dengan harga per unit terendah paling hemat?
Tergantung tingkat keberhasilannya. Harga per unit hanya menentukan harga per Token; berapa Token yang dibutuhkan model untuk menyelesaikan tugas, berapa kali harus dijalankan ulang, dan berapa banyak perbaikan manual yang diperlukan, semuanya ditentukan oleh kemampuan model. Perbandingan baru bermakna jika menggunakan “total biaya ÷ jumlah keberhasilan”.
Q3: Apakah model peringkat pertama di SWE-bench paling cocok untuk membuat game?
SWE-bench Verified mengukur kemampuan rekayasa perangkat lunak pada repositori open source nyata, dan cakupannya terbatas untuk Shader, pemahaman ruang 3D, rendering real-time, dan feel interaksi. Ini cocok untuk penyaringan awal, tetapi penentuan peringkat akhir untuk pengembangan game memerlukan evaluasi khusus.
Q4: Apakah skor dalam laporan NIST bisa mewakili model saat ini?
Tidak. Laporan NIST CAISI diterbitkan pada tahun 2025, menguji model-model historis seperti GPT-5, Opus 4, dan DeepSeek V3.1 serta konfigurasi eksperimen tertentu. Model baru per November 2026 memerlukan evaluasi baru yang khusus untuk versinya.
Q5: Bagaimana cara cepat menyiapkan evaluasi perbandingan multi-model?
Menggunakan platform agregator dengan antarmuka kompatibel OpenAI adalah cara paling praktis. Setelah mendaftar di APIYI apiyi.com dan mendapatkan API Key, atur base_url skrip di artikel ini ke `https://api.apiyi.com/v1`, ubah parameter model, dan Anda dapat menguji beberapa model dalam satu set skrip yang sama. Pengguna baru dapat memverifikasi skrip terlebih dahulu dengan kuota gratis.
Q6: Bagaimana cara paling akurat menghitung biaya Token saat evaluasi?
Gunakan field usage dalam respons API sebagai acuan, akumulasikan Token input biasa, cache read, dan output secara bertahap, lalu hitung berdasarkan harga resmi dan tier penagihan pada hari pemanggilan. Biaya tambahan seperti cache write dan tier kecepatan perlu ditambahkan secara terpisah sesuai aturan masing-masing penyedia. Saat memanggil melalui APIYI apiyi.com, Anda juga dapat mencocokkan hasil perhitungan dengan catatan konsumsi di backend platform.
Q7: Apakah prototipe game yang dihasilkan AI bisa langsung dirilis?
Prototipe seperti Saltline membuktikan bahwa model dapat menghasilkan versi yang dapat dimainkan tanpa umpan balik manusia, tetapi peluncuran komersial masih melibatkan kompatibilitas lintas browser, adaptasi mobile, optimasi performa, dan pemeliharaan jangka panjang. Game browser dibatasi oleh perangkat keras lokal dan browser; halaman Saltline juga memperingatkan masalah seperti inisialisasi yang lambat dan kebutuhan beralih ke kualitas grafis rendah saat lag. Biaya pengujian dan optimasi sebelum peluncuran harus diperhitungkan dalam total biaya pengembangan.
7 Poin Penting dalam Memilih Model untuk Pengembangan Game AI
- Metrik utama: bandingkan biaya end-to-end setiap versi yang memenuhi syarat, bukan harga satuan per juta Token.
- Tagihan Saltline: sekitar 550 dolar adalah estimasi yang disampaikan sendiri oleh pengembang, dengan output sekitar 108 dolar dan sisanya di sisi input.
- Cache menentukan skala: pada tugas panjang, input mendominasi, sehingga harga baca cache dan tingkat hit paling berpengaruh.
- Harga bisa berubah: harga dalam artikel ini per 2026-11-16, dan Gemini 4 Argon direncanakan menyesuaikan harga mulai 1 Desember.
- Benchmark untuk penyaringan awal: SWE-bench dan Aider mengukur pemrograman umum, sedangkan kemampuan game perlu evaluasi khusus.
- Jalankan beberapa kali: setiap model dijalankan 5 sampai 10 kali dengan kondisi sama, lalu simpulkan berdasarkan tingkat keberhasilan, bukan hasil sekali jalan.
- Cara memulai: berganti model lewat antarmuka terpadu APIYI apiyi.com, memudahkan perbandingan biaya dengan skrip yang sama.
8 Ringkasan: Metode Memilih Model agar AI Mengembangkan Game Secara Mandiri
Ada tiga poin inti saat memilih model untuk membuat AI mengembangkan sebuah game secara mandiri:
- Hitung biayanya secara menyeluruh: total biaya tugas mencakup pemanggilan model, eksekusi alat, dan perbaikan manual; biaya API hanyalah salah satu komponen.
- Kemampuan harus diukur langsung: benchmark publik dipakai untuk penyaringan awal, sedangkan urutan akhir dalam pengembangan game berasal dari evaluasi khusus yang dijalankan berkali-kali dengan kondisi seragam.
- Kombinasikan per tahap: tahap rumit pakai model dengan tingkat keberhasilan tinggi, tahap berulang pakai model berbiaya rendah; skema kombinasi juga harus diverifikasi lewat pengukuran.
Saltline memberi gambaran besaran yang bisa dijadikan acuan: satu kali petunjuk, sekitar 8 jam, estimasi biaya sekitar 550 dolar, menghasilkan satu prototipe 3D browser yang bisa dimainkan. Berapa biaya yang dibutuhkan proyek Anda bergantung pada kompleksitas tugas dan tingkat keberhasilan model yang dipilih; cara paling andal adalah menjalankan evaluasi Anda sendiri dengan kerangka dari artikel ini.
Disarankan membangun lingkungan perbandingan multi-model dengan cepat melalui APIYI apiyi.com; platform ini menyediakan antarmuka yang kompatibel dengan OpenAI dan kuota gratis untuk pengguna baru, sehingga memudahkan pengukuran harga dan tingkat keberhasilan dalam satu set skrip yang sama.
Referensi
- Halaman pengalaman mandiri Saltline: Demo game dan penjelasan FAQ
- Tautan:
saltline.games -
Keterangan: Berisi informasi pengalaman seperti inisialisasi, pengalihan kualitas grafis, dan cara pengoperasian
-
Mirror kode dan README Saltline: Keterangan atribusi data pengembang
- Tautan:
github.com/realcodebear/saltline-fable-5.2 -
Keterangan: Mencatat sumber waktu pembuatan, Token, dan estimasi biaya
-
Repositori versi bahasa Mandarin Jimao: Arsip versi kemasan bahasa Mandarin Saltline
- Tautan:
github.com/Megasu/jimao-3a-game -
Keterangan: Menyediakan data seperti ukuran file index.html
-
Spesifikasi dan harga model Claude Fable 5.2: Dokumentasi resmi Anthropic
- Tautan:
platform.claude.com/docs/en/models/fable-5-2/overview -
Keterangan: Harga input, output, cache, dan Fast Mode
-
Dokumentasi model GPT-6 Astra: Harga resmi OpenAI
- Tautan:
developers.openai.com/api/docs/models/gpt-6-astra -
Keterangan: Harga tingkat pemrosesan standar mengacu pada ini
-
SWE-bench Verified: Halaman resmi benchmark rekayasa perangkat lunak
- Tautan:
swebench.com/verified.html -
Keterangan: 500 tugas yang diverifikasi secara manual dan penjelasan konfigurasi terpadu mini-SWE-agent
-
Aider Leaderboards: Hasil evaluasi Aider Polyglot
- Tautan:
aider.chat/docs/leaderboards -
Keterangan: Mencatat secara bersamaan akurasi, konsumsi Token, dan biaya operasional
-
Laporan evaluasi NIST CAISI (2025): Evaluasi independen model historis
- Tautan:
nist.gov/system/files/documents/2025/09/30/CAISI_Evaluation_of_DeepSeek_AI_Models.pdf - Keterangan: Berisi skor historis SWE-bench Verified dan error standar
Penulis: Tim teknis APIYI
Komunikasi teknis: Silakan hubungi kami di halaman utama situs APIYI apiyi.com. Untuk lebih banyak materi integrasi, kunjungi pusat dokumentasi docs.apiyi.com