ملاحظة المؤلف: انطلاقًا من هيكل تكاليف خدمة الاستدلال، نوضّح لماذا يسهل أن تُسجّل خدمة Token خسائر، ونقدّم قائمة عملية لتقييم مزوّدي خدمة API للنماذج.
صار Token يُباع في البث المباشر، ومع ذلك لا تزال النتائج المالية لمزوّدي خدمة الاستدلال مثل «硅基流动» غير مبشّرة. وفي خبر آخر، وجدت شركة أن Claude مكلف جدًا، فانتقلت إلى GLM، واستخدمت 56 بطاقة B200 لدعم 2000 مهندس، فانخفضت تكاليف الذكاء الاصطناعي بنحو 90%. وإذا نظرنا إلى الأمرين معًا، نجد أن هيكل تكاليف خدمة Token له قواعده الخاصة. ستنطلق هذه المقالة من هيكل تكاليف خدمة الاستدلال لتشرح لماذا تخسر خدمة Token، ثم تنتقل إلى ما يهم المطورين فعلًا: كيف تقيّم مزوّد خدمة API للنماذج وهل هو موثوق؟
ليست مجرد مقالة أخرى لتحليل أخبار الصناعة. كل التفكيكات في هذه المقالة تدور حول متغيرات تقنية، بما في ذلك استهلاك GPU، ومعدل الاستخدام، وفارق التكلفة بين Prefill وDecode، وKV Cache، ومعدل إصابة التخزين المؤقت، واستراتيجيات الدعم. بعد القراءة يمكنك استخدامها مباشرة في تقييم الاختيار.
القيمة الأساسية: بعد قراءة هذا المقال، ستفهم مكوّنات التكلفة التي تقف خلف سعر Token، وستتقن منهجية تقييم مزوّدي الخدمة من 6 أبعاد. وستعرف أيضًا كيف تتحقق من شفافية الفوترة باستخدام بيانات الاستدعاء الحقيقية.
لماذا تخسر خدمة Token؟ النقاط الأساسية في هيكل تكاليف الاستدلال
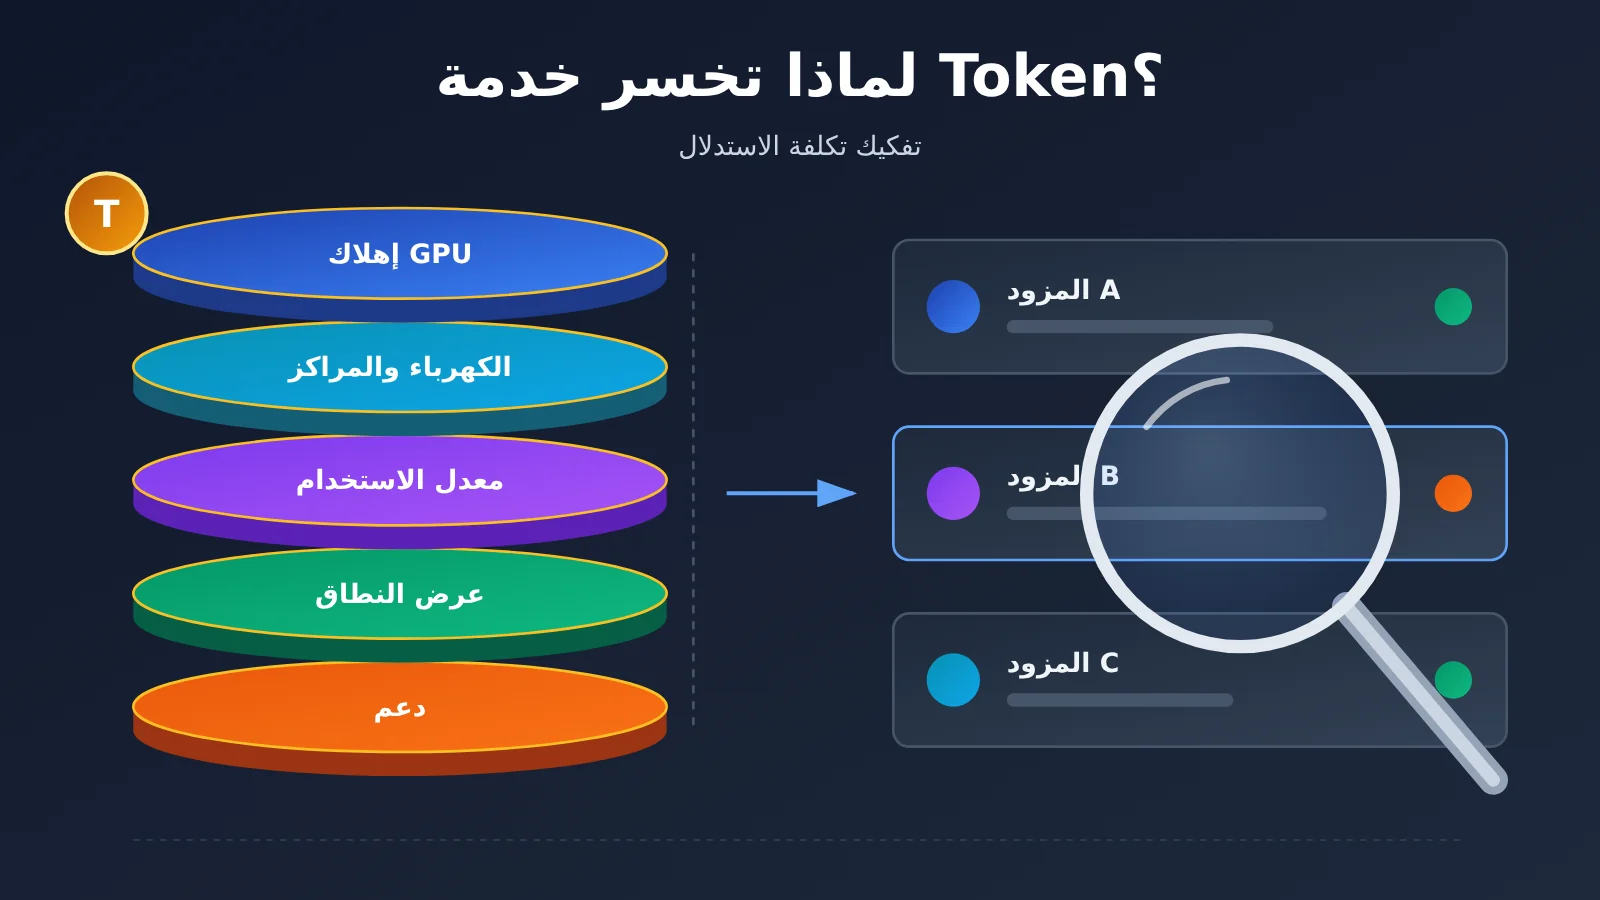
نبدأ بالخلاصة: معظم تكلفة خدمة الاستدلال هي تكاليف ثابتة، بينما تُحتسب الإيرادات حسب كمية Token، والرابط بينهما هو «معدل الاستخدام». إذا لم يرتفع معدل الاستخدام، أو دفعت المنافسة السعر إلى ما يقارب التكلفة الحدية، فستظهر خسائر في الحسابات.
| عنصر التكلفة | الوصف | تأثيره على سعر Token |
|---|---|---|
| النفقات الرأسمالية لـ GPU والإهلاك | تكلفة شراء وحدات GPU عالية الأداء أو استئجارها طويل الأمد، وتُوزّع على سنوات العمر الإنتاجي | تكلفة ثابتة؛ كلما انخفض معدل الاستخدام ارتفع نصيب كل Token منها |
| مركز البيانات والكهرباء والشبكة | الاستضافة والتبريد وعرض النطاق الترددي والتعافي من الكوارث بين المناطق | تكلفة شبه ثابتة، ولا يمكن تخفيفها إلا بعد تحقيق حجم كافٍ |
| معدل استخدام GPU | نسبة الوقت الذي يعمل فيه GPU فعليًا في الاستدلال، ومدى تشبع المعالجة الدفعية | الرافعة الأساسية للربح والخسارة؛ الفرق بين الذروة والانخفاض يلتهم الأرباح مباشرة |
| بنية Prefill / Decode | معالجة الإدخال على التوازي، وتوليد الإخراج Token بعد Token | Token الإخراج أغلى، وسيناريوهات الإخراج الطويل تزيد الضغط |
| السياق الطويل وKV Cache | احتلال ذاكرة الفيديو بالذاكرة المؤقتة، ما يقلل سعة التزامن | طلبات السياق الطويل تقلص عدد المستخدمين الذين يمكن خدمتهم |
| الدعم واكتساب العملاء | الحصص المجانية، والأسعار المخفضة لجذب الزيارات، وحصص القنوات | ترفع الحجم على المدى القصير، وتخفض هامش الربح الإجمالي على المدى الطويل |
شرح مفصل لنقاط هيكل تكاليف خدمة Token
عدم التطابق بين التكاليف الثابتة والإيرادات المرتبطة بالاستهلاك هو السبب الأول. خادم GPU مجهز بالكامل تظل تتراكم عليه تكاليف الإهلاك والكهرباء ومركز البيانات سواء وصلته طلبات أم لا. لكن المستخدم يدفع فقط مقابل Token الذي يستهلكه فعليًا. وقت الذروة نهارًا يحتاج إلى حجز قدرة حسابية كافية لضمان زمن الاستجابة، وفي فترات الانخفاض ليلًا تبقى هذه القدرة عاطلة. وفي النهاية تُحمَّل تكلفة أوقات الخمول على Token الذي يُباع في أوقات الذروة. وإذا كان التسعير يعتمد فقط على «التكلفة النظرية عند الحمل الكامل»، فمن شبه المؤكد أن التشغيل الفعلي سيخسر.
المنافسة السعرية تدفع سعر الوحدة نحو التكلفة الحدية هو السبب الثاني. أوزان النماذج مفتوحة المصدر متاحة للجميع، وكثير من مزودي الاستدلال ينشرون النموذج نفسه، لذا فإن مساحة التميّز ضيقة، ويصبح السعر وسيلة المنافسة الرئيسية. وعندما تُطرح عروض Token في البث المباشر، فهذا يعني أن هذا النوع من المنتجات أصبح قريبًا من «سلعة موحّدة». في هذه الحالة يصعب على المزوّد تغطية التكاليف الثابتة عبر هامش سعري مرتفع، ولا يبقى أمامه سوى المنافسة بالحجم وكفاءة الجدولة.
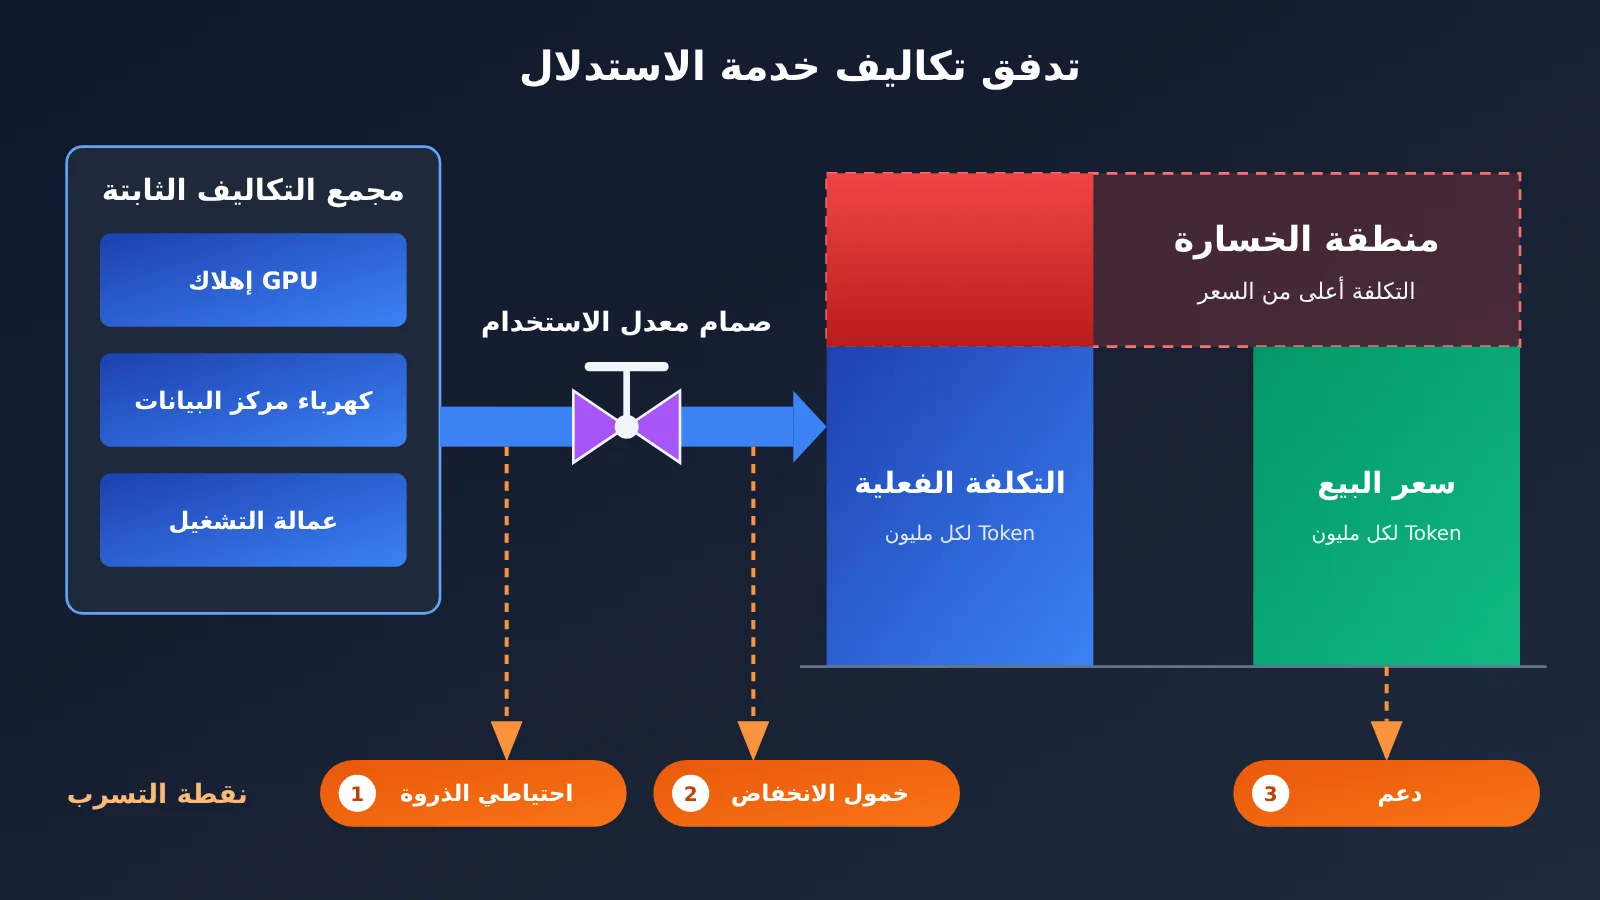
تفكيك تكلفة خدمة الاستدلال: كيف يُحسب سعر وحدة الـ Token؟
لفهم سبب خسارة خدمات الـ Token، علينا تقسيم طلب الاستدلال الواحد إلى مرحلتين. تختلف الموارد المستهلكة في كل مرحلة، وبالتالي تختلف طريقة الفوترة. وهذا هو السبب وراء قيام كثير من مزودي الخدمة بتسعير المدخلات والمخرجات والتخزين المؤقت بشكل منفصل.
Prefill وDecode: لماذا يكون Token المخرجات أغلى؟
يدخل الطلب أولاً إلى مرحلة Prefill. يعالج النموذج جميع Tokens المدخلات على التوازي، وهو مكثّف حسابيًا لكنه عالي الكفاءة، إذ يمكن استغلال قدرة GPU الحسابية بالكامل. ثم ينتقل إلى مرحلة Decode، حيث يولّد النموذج Token واحدًا فقط في كل مرة، ويضطر إلى قراءة KV Cache السابق مرارًا وتكرارًا. هذه المرحلة أكثر تقييدًا بعرض نطاق ذاكرة الفيديو، ويصعب فيها إشباع القدرة الحسابية لـ GPU.
لذلك، بالنسبة للعدد نفسه من Tokens، تكون تكلفة الوحدة للمخرجات عادةً أعلى بوضوح من المدخلات. كما أن تسعير المزودين الرئيسيين يميل عمومًا إلى جعل سعر وحدة المخرجات أعلى من سعر وحدة المدخلات. وإذا كانت الأعمال تعتمد بشكل أساسي على المخرجات الطويلة، مثل توليد الشيفرة أو كتابة النصوص الطويلة أو الاستدلال متعدد الجولات عبر Agent، فستتركز التكلفة في جانب المخرجات. عند تقييم مزودي الخدمة، ينبغي إعطاء الأولوية لسعر وحدة المخرجات وإنتاجية المخرجات.
KV Cache والسياق الطويل: ضريبة خفية على ذاكرة GPU
لا تقتصر تكلفة طلبات السياق الطويل على “إدخال أكبر” فحسب. إذ يستهلك KV Cache مساحة أكبر من ذاكرة GPU مع زيادة طول السياق، وينخفض بالتالي عدد الطلبات التي يمكن لبطاقة واحدة خدمتها في الوقت نفسه. أي أن مستخدمًا واحدًا بسياق طويل جدًا قد يشغل مواقع التزامن الخاصة بعدة مستخدمين عاديين. وقد لا تظهر هذه التكلفة كاملة في سعر الوحدة، لذا يضطر مزودو الخدمة إلى موازنتها عبر التسعير المتدرج أو تحديد المعدل أو فرض حدود على طول السياق.
إصابة التخزين المؤقت: وسيلة لخفض التكلفة وفخ تسعيري في آن
يتيح التخزين المؤقت للموجه (Prompt Caching) عدم إعادة حساب البادئات المتكررة، وتُحتسب الأجزاء المطابقة بسعر قراءة أقل من التخزين المؤقت. وفي أنظمة مثل Agent وRAG التي تكون فيها الموجهات النظامية طويلة ومتكررة، يؤثر معدل إصابة التخزين المؤقت تأثيرًا واضحًا في الفاتورة النهائية. يجدر الانتباه إلى أن مزودي الخدمة يختلفون في طريقة احتساب كتابة التخزين المؤقت وقراءته ومدة صلاحيته، وبعضهم يتطلب تفعيله صراحةً. عند التقييم، تأكد من أن حقل usage المُعاد يتضمن إحصاءات التوكن المتعلقة بالتخزين المؤقت.
| بند الفوترة | خصائص استهلاك الموارد | ما يجب التحقق منه عند التقييم |
|---|---|---|
| توكنات الإدخال | حساب Prefill على التوازي، بكفاءة أعلى | هل يُسعّر حسب شرائح طول السياق |
| توكنات الإخراج | توليد Decode رمزًا تلو الآخر، محدود بعرض نطاق ذاكرة GPU | سعر الإخراج، وإنتاجية الإخراج (Token/s) |
| كتابة التخزين المؤقت | الكتابة الأولى في التخزين المؤقت، وتُحتسب منفصلة على بعض المنصات | هل تُضاف تكلفة على الكتابة، وما مدة الصلاحية |
| قراءة التخزين المؤقت | مطابقة البادئة وتجاوز الحساب المتكرر | خصم الجزء المطابق، وهل يظهر في usage |
| توكنات التفكير الاستدلالي | عملية التفكير الداخلية لنماذج الاستدلال | هل تُحتسب ضمن الإخراج، وهل يمكن تحديد ميزانية لها |
💰 توضيح حول أساس التسعير: يوضح الجدول أعلاه أبعاد الفوترة فقط، ولا يتناول أسعارًا محددة. أما أسعار الإدخال والإخراج وقراءة/كتابة التخزين المؤقت للنماذج المذكورة في هذا المقال، فيرجى الاعتماد على البيانات الفعلية في صفحة أسعار APIYI:
https://docs.apiyi.com/models. قد تختلف طريقة التسعير بين النماذج والمجموعات المختلفة، لذا تحقق من كل بند قبل الطلب.
الاستدلال المُستضاف ذاتيًا مقابل استدعاء API: كيف نحسب تكلفة الرموز (Token)؟
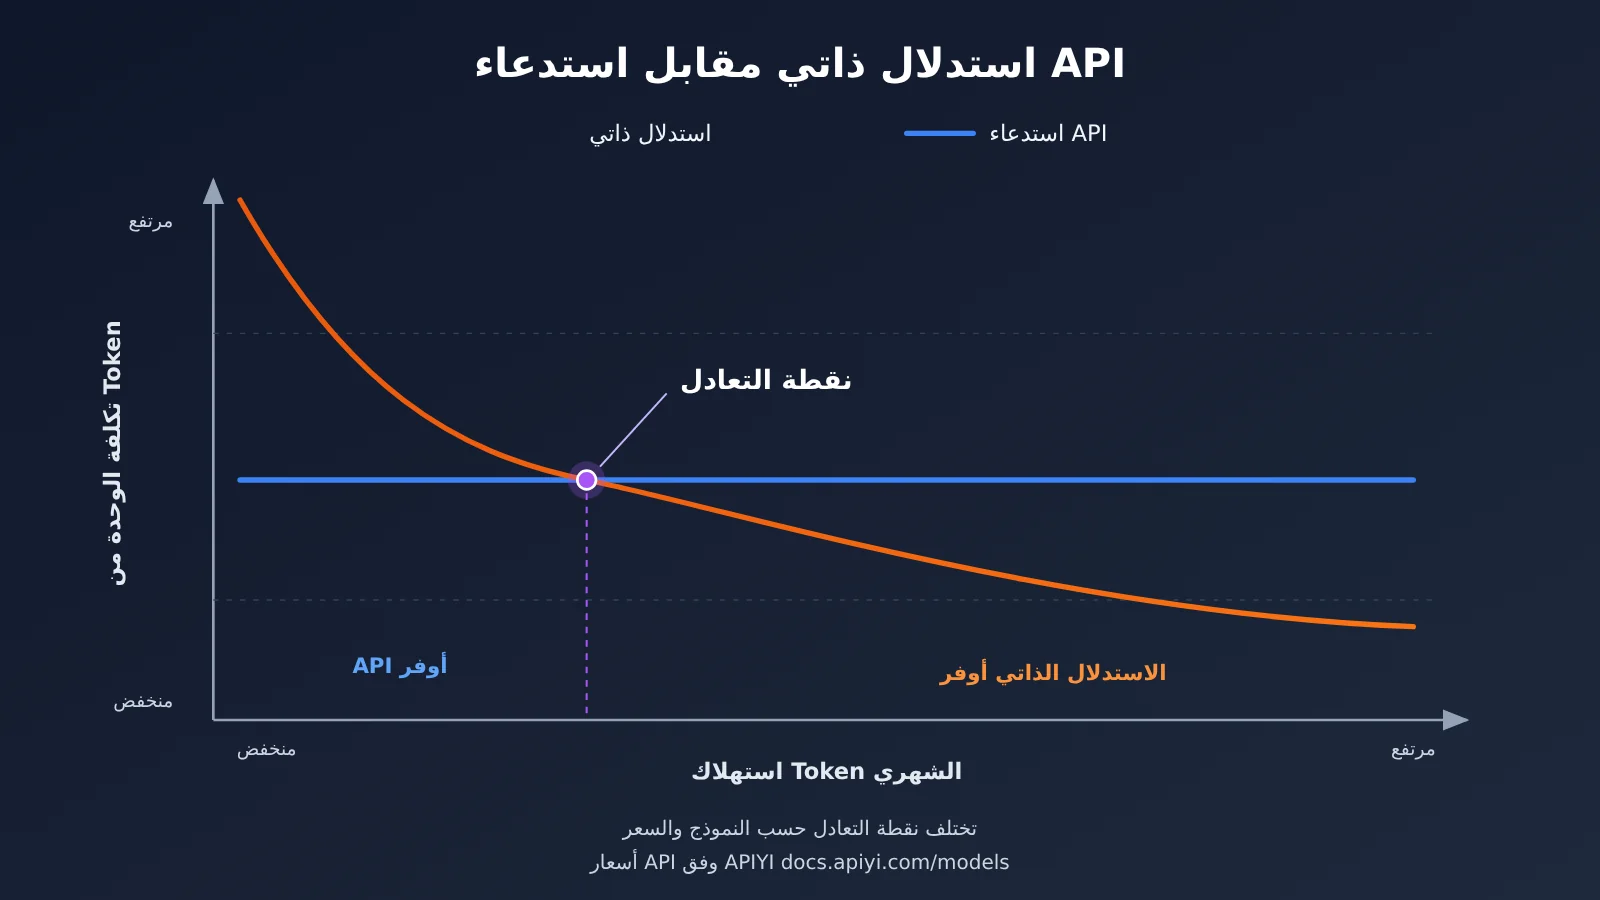
حتى تصبح حالة «56 بطاقة B200 تدعم 2000 مهندس وتخفض التكلفة بنحو 90%» قابلة للتطبيق، لا بد من توافر عدة شروط. فحمل العمل لدى الشركة يأتي من مهندسين داخليين، وحجم الطلبات كبير ومستقر نسبيًا. كما أن الطلبات تتركز في ساعات العمل، ما يجعلها قابلة للتنبؤ بدرجة عالية. وقد استُخدم نموذج GLM مفتوح المصدر القابل للنشر ذاتيًا. هذه العوامل الثلاثة تسمح بتوزيع التكلفة الثابتة على حجم استخدام كبير، فتتجنب الشركة المشكلة الأكبر التي تؤرق مزودي خدمات الاستدلال العام: انخفاض معدل الاستخدام.
وعلى الجانب الآخر، لا تعني هذه الحالة أن كل الفرق ينبغي أن تبني بنيتها التحتية بنفسها. فإذا كان حجم الطلبات صغيرًا أو متقلبًا، أو إذا كانت الحاجة ملحة إلى التبديل المتكرر بين عدة نماذج مغلقة المصدر، فإن تكلفة خمول عنقود GPU المُستضاف ذاتيًا ستتجاوز فاتورة API بسرعة. وتكمن قيمة مزودي خدمات الاستدلال العام في أنهم يوزعون أحمال عملاء كثر بين فترات الذروة والهدوء، فيحصلون على معدل استخدام إجمالي أعلى.
| الخيار | هيكل التكلفة | السيناريوهات المناسبة | المخاطر الرئيسية |
|---|---|---|---|
| عنقود GPU مُستضاف ذاتيًا | تكلفة ثابتة مرتفعة، وتكلفة حدية منخفضة | الفرق الكبيرة ذات الاستخدام الكبير والحمل المستقر والنموذج الثابت | هدر بسبب الخمول، وأعباء التشغيل البشري، وانخفاض قيمة العتاد مع تحديثاته |
| API الرسمي لنموذج واحد | دفع حسب الاستخدام فقط | الأعمال التي تعتمد بشدة على نموذج مغلق المصدر بعينه | سعر موحد، وتكلفة تبديل مرتفعة، ومحدودية التوافر الإقليمي |
| منصة تجميع API متعددة النماذج | دفع حسب الاستخدام، وواجهة موحدة | الحاجة إلى المقارنة بين عدة نماذج أو التبديل بينها أو مزجها | ضرورة التحقق من شفافية الفوترة واستقرار الخدمة |
| بنية هجينة | المهام المتكررة كثيفة الاستخدام تُنفَّذ ذاتيًا، والمهام طويلة الذيل تمر عبر API | حجم أعمال متوسط إلى كبير، مع تقسيم واضح لطبقات النماذج | ارتفاع تعقيد البنية |
تحليل مقارن لخيار الاستضافة الذاتية: تتمتع الاستضافة الذاتية بأفضلية في الحد الأدنى للتكلفة لكل وحدة، لكن بشرط أن يكون معدل الاستخدام مرتفعًا بما يكفي، وأن يمتلك الفريق القدرة على التعامل مع النشر والتكميم والتوسع والتقلص واستعادة الخدمة بعد الأعطال. وفي المقابل، تكون تكلفة الوحدة في خيار API أكثر قابلية للتنبؤ، وتناسب أكثر الفرق التي يتقلب حملها وتحتاج إلى التحقق من عدة نماذج بالتوازي.
تحليل مقارن لمنصة التجميع: يتمتع API الرسمي بأفضلية في سرعة إتاحة النماذج الجديدة، لكن في معظم الحالات لا يغطي الحساب الواحد سوى نماذج جهة واحدة. أما منصة تجميع النماذج المتعددة فتتيح ربط عدة نماذج عبر واجهة واحدة، ما يسهّل إجراء مقارنات A/B وتقسيم التكاليف بحسب الطبقات. ومنصات مثل APIYI apiyi.com متوافقة مع تنسيقي واجهات OpenAI وAnthropic، لذا يمكن تبديل النموذج بتغييرات صغيرة في الشيفرة الحالية.
كيفية تقييم مزوّدي خدمة API للنماذج: قائمة سريعة من 6 أبعاد للبدء
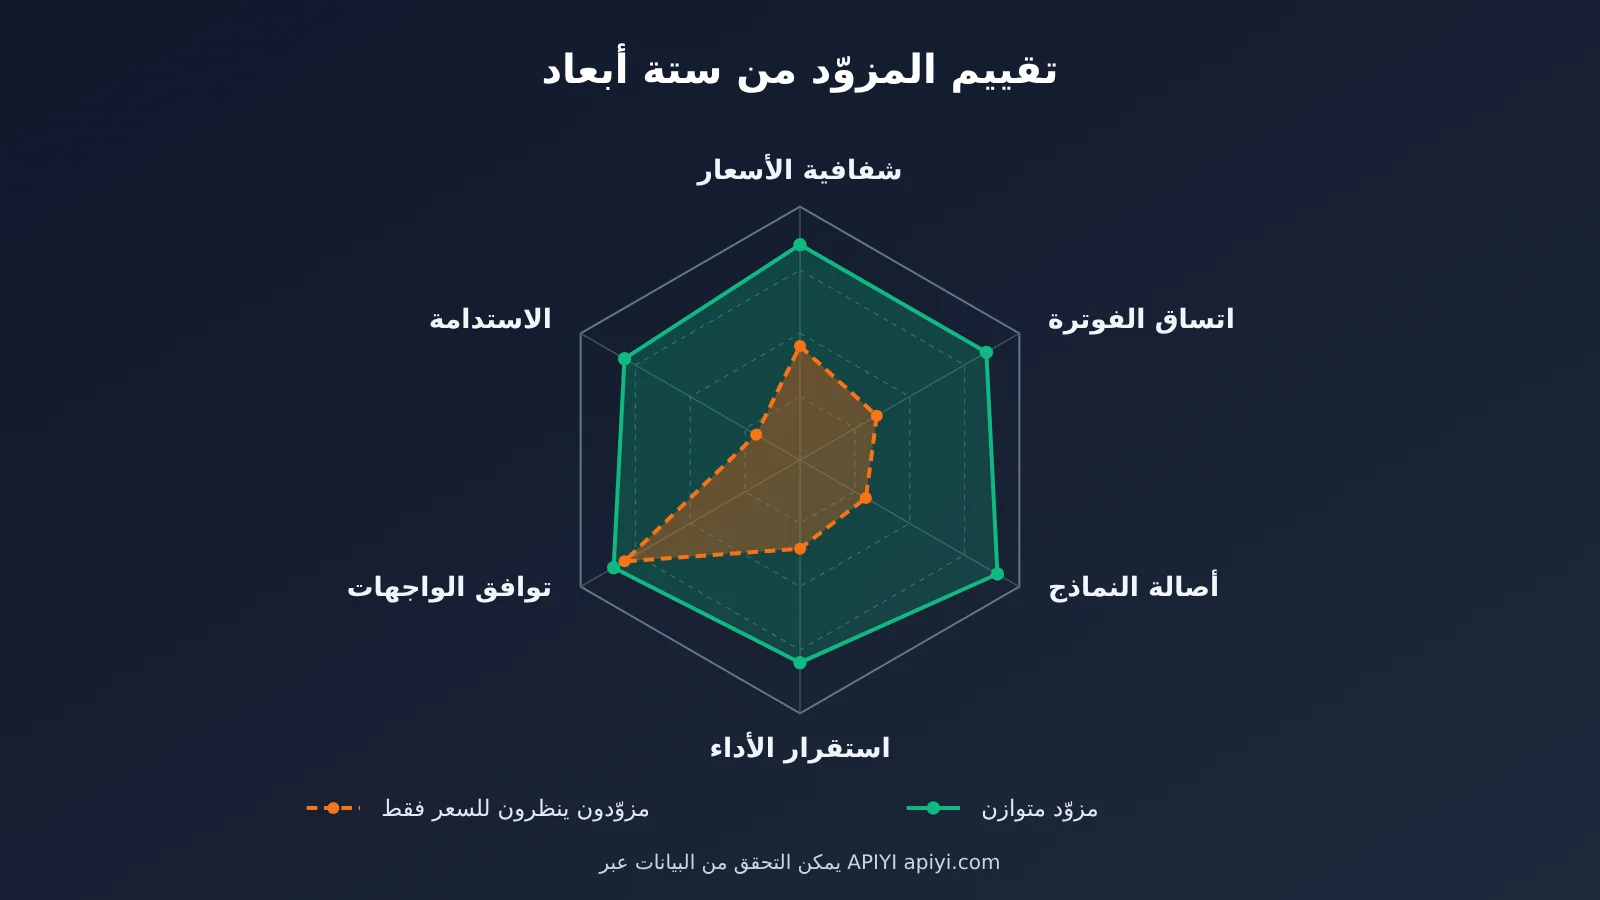
بعد فهم هيكل التكلفة، يمكنك استنتاج حكم مهم: السعر الأقل من التكلفة على المدى الطويل غير مستدام. فإما أن يوفّر مزوّد الخدمة في مرحلة ما، أو يعتمد على الدعم ليبقى لفترة. عند تقييم مزوّد الخدمة، لا يكفي النظر إلى السعر المعلن فقط، بل يجب النظر إلى الأبعاد الستة التالية معًا.
| البُعد | السؤال الأساسي | طريقة التحقق |
|---|---|---|
| 1. شفافية السعر | هل يُعلن عن سعر الإدخال والإخراج والتخزين المؤقت بشكل منفصل؟ | راجع صفحة الأسعار وسجّل أساس الحساب لكل بند |
| 2. اتساق الفوترة | هل يتطابق الخصم الفعلي مع usage؟ |
نفّذ استدعاءات بكميات صغيرة ثم راجع تفاصيل الفاتورة |
| 3. حقيقية النموذج | هل يوجد تخفيض للمستوى أو خلط للنماذج أو تكميم مفرط؟ | قارن جودة المخرجات باستخدام مجموعة اختبار ثابتة |
| 4. استقرار الأداء | كيف هي زمن الوصول إلى أول رمز، والإنتاجية، ومعدل الأخطاء؟ | اختبر جولة في وقت الذروة وجولة في وقت الانخفاض |
| 5. توافق الواجهة | هل تتوافق مع تنسيق OpenAI / Anthropic؟ | استخدم SDK الحالي وغيّر base_url فقط للاختبار |
| 6. الاستدامة | هل السعر أقل بوضوح من نطاق التكلفة المعقول؟ | قيّم مخاطر الدعم بالاستناد إلى هيكل التكلفة |
الخطوة الأولى: الاتصال عبر واجهة متوافقة وإجراء أدنى استدعاء
يمكن توضيح مسار الاختبار بوضوح دون كتابة أي كود. إذا كان مشروعك يستخدم OpenAI SDK بالفعل، فغالبًا لا تحتاج إلا إلى تغيير إعدادين: استبدل api_key بالمفتاح الذي يقدمه مزود الخدمة، واستبدل base_url بعنوان الواجهة الخاص بالمزود. وبالنسبة إلى APIYI، فإن base_url بالتنسيق المتوافق مع OpenAI هو https://api.apiyi.com/v1، وتمر طلبات المحادثة عبر المسار /v1/chat/completions، ويكفي أن تضع اسم النموذج المستهدف في الحقل model.
إذا كان المشروع يعتمد على Anthropic SDK، مثل استخدام نماذج سلسلة Claude أو أدوات من نوع Claude Code، فيمكنك أيضًا استبدال عنوان الواجهة واستخدام التنسيق الأصلي لـ Anthropic عبر المسار /v1/messages. للحصول على العناوين وأسماء النماذج الدقيقة، اعتمد على وثائق APIYI: https://docs.apiyi.com. عند إجراء أدنى استدعاء، يُنصح بتفعيل الإخراج التدفقي stream في الوقت نفسه، لتسهيل قياس زمن الوصول إلى أول رمز لاحقًا.
الخطوة الثانية: التحقق من منهجية الفوترة وحقل usage
في استجابة كل استدعاء، يعيد تنسيق OpenAI الحقلين usage.prompt_tokens وusage.completion_tokens، وبعض النماذج تعيد أيضًا cached_tokens عند إصابة التخزين المؤقت. وفي تنسيق Anthropic يقابل ذلك input_tokens وoutput_tokens، إضافة إلى حقول قراءة وكتابة التخزين المؤقت. يمكنك تقدير تكلفة الاستدعاء الواحد بمعادلة بسيطة: عدد رموز الإدخال مضروبًا في سعر الإدخال، يضاف إليه عدد رموز الإخراج مضروبًا في سعر الإخراج، ثم يضاف عدد رموز قراءة/كتابة التخزين المؤقت مضروبًا في سعر التخزين المؤقت المقابل.
قارن القيمة التقديرية بتفاصيل فاتورة المنصة، وينبغي أن يكون أي فرق قابلاً للتفسير. إذا تكرر على المدى الطويل ظهور حالة «الفاتورة أكبر مما تشير إليه حسابات usage»، أو إذا لم تظهر إصابات التخزين المؤقت في الفوترة إطلاقًا، فاحترس. أما الأسعار المستخدمة في التقدير، فاعتمد فيها على البيانات المعلنة في صفحة أسعار APIYI: https://docs.apiyi.com/models.
الخطوة الثالثة: اختبار الأداء والجودة وساعات الذروة
في اختبار الأداء، يُستحسن تسجيل ثلاثة مؤشرات: زمن الوصول إلى أول رمز (TTFT)، وإنتاجية الإخراج (عدد الرموز في الثانية)، ومعدل الأخطاء (المهلات، وتقييد المعدل 429، وأخطاء 5xx). اختبر جولة في ذروة أيام العمل وأخرى في فترة الانخفاض الليلي؛ فكلما كان التذبذب أصغر دلّ ذلك على أن تخطيط سعة مزود الخدمة أكثر كفاية. وفي اختبار الجودة، استخدم مجموعة ثابتة من الموجهات تغطي البرمجة والاستدلال والنصوص الطويلة، وقارن المخرجات بشكل متقاطع مع القنوات الرسمية أو منصات أخرى؛ فهذا يساعد على كشف ما إذا كان النموذج قد خُفّض أو استُبدل.
| بند الاختبار | المعاملات / الحقول الرئيسية | مرجع القبول |
|---|---|---|
| زمن الوصول إلى أول رمز | تفعيل stream، وتسجيل وقت أول chunk |
ألا يكون الفارق بين الذروة والانخفاض كبيرًا |
| إنتاجية الإخراج | completion_tokens ÷ زمن التوليد |
قريبة من القنوات الأخرى للنموذج نفسه |
| مراجعة الفوترة | حقول usage × سعر الوحدة في صفحة الأسعار |
انحراف قابل للتفسير مقارنة بتفاصيل الفاتورة |
| إصابة التخزين المؤقت | cached_tokens أو حقل قراءة التخزين المؤقت |
وجود إصابة في الطلبات المتكررة ذات البادئة الطويلة |
| الاستقرار | عدد مرات 429 / 5xx / المهلات | معدل أخطاء منخفض مع توضيح لإعادة المحاولة |
🚀 بداية سريعة: إذا أردت مقارنة تكلفة وأداء عدة نماذج عبر الواجهة نفسها، يمكنك أولاً التسجيل عبر APIYI apiyi.com والحصول على رصيد اختباري. توفر المنصة استدعاءات API للنماذج الرئيسية الواردة في هذا المقال، وتتوافق مع تنسيقات واجهات OpenAI وAnthropic؛ ما عليك سوى تغيير
base_urlإلىhttps://api.apiyi.com/v1لبدء التحقق. تكون أسعار كل نموذج وفقًا لما ورد فيhttps://docs.apiyi.com/models.
الأسئلة الشائعة (FAQ)
س1: لماذا تتكبد خدمات الـ Token خسائر؟
تتكون خدمات الاستدلال أساسًا من تكاليف ثابتة مثل إهلاك وحدات GPU وكهرباء مركز البيانات، بينما تُحتسب الإيرادات بحسب كمية الـ Token. في أوقات الذروة تحتاج إلى حجز قدرة حوسبة احتياطية، وفي أوقات الانخفاض تبقى هذه القدرة معطلة، فيصعب الحفاظ على معدل استخدام مرتفع على المدى الطويل. أضف إلى ذلك حروب الأسعار الناتجة عن تشابه النماذج مفتوحة المصدر، ودعم الحصص المجانية، فتصبح الأسعار عرضة للضغط إلى ما دون التكلفة.
س2: لماذا يكون سعر رموز الإخراج (Token) أعلى عمومًا من رموز الإدخال؟
يُحسب الإدخال في مرحلة Prefill على نحو متوازٍ، ما يجعل استفادة GPU من الحوسبة عالية. أما الإخراج فيُولَّد رمزًا تلو الآخر في مرحلة Decode، ويحتاج إلى قراءة KV Cache مرارًا وتكرارًا، وهو محدود أساسًا بعرض نطاق ذاكرة GPU، لذا تكون تكلفة الوحدة أعلى. لذلك ينبغي للتطبيقات ذات المخرجات الطويلة أن تركّز على سعر وحدة الإخراج ومعدل الإنتاجية (Throughput).
س3: هل بناء بنية GPU خاصة أرخص دائمًا من استدعاء API؟
ليس بالضرورة. حالات مثل «56 وحدة B200 تخدم 2000 مهندس» تعتمد على حمل داخلي كبير ومستقر وقابل للتنبؤ. أما الفرق ذات الاستخدام الصغير أو المتقلب فتصبح لديها بعد البناء الذاتي قدرة معطلة كبيرة، وتصبح تكلفة الوحدة أعلى في الواقع. يُنصح أولاً بتشغيل API للحصول على منحنى الاستخدام الحقيقي، ثم تقييم نقطة التعادل.
س4: هل يمكن التعامل مع مزودي خدمة API بأسعار منخفضة جدًا؟
يمكنك الاختبار، لكن ينبغي التحقق أكثر. فالسعر الأقل بوضوح من النطاق المعقول للتكلفة يعني عادةً أحد الأمور التالية: دعم مالي، أو تحديد معدل الطلبات، أو تخفيض جودة النموذج، أو خصم مقابل الاستقرار. والتحقق من الجودة والفوترة وفق قائمة الأبعاد الستة الواردة في هذا المقال أكثر موثوقية من النظر إلى السعر المعلن وحده.
س5: كيف أقارن أداء API لعدة نماذج بتكلفة منخفضة؟
يُنصح باستخدام منصة متعددة النماذج متوافقة مع صيغ الواجهات السائدة لإجراء اختبار موحّد:
1. سجّل حسابًا في APIYI apiyi.com واحصل على مفتاح API
2. اضبط واجهة متوافقة مع OpenAI أو Anthropic وفق الوثائق `https://docs.apiyi.com`
3. استخدم مجموعة اختبار ثابتة وبدّل حقل `model` بالتناوب، وسجّل زمن الاستجابة والجودة وقيم `usage`
يمكنك إجراء مقارنة أفقية بالشيفرة نفسها، وتكلفة التبديل منخفضة جدًا.
س6: كيف أتحقق من أسعار التخزين المؤقت (Cache)؟ وهل المعايير موحدة بين المنصات؟
لا، ليست موحدة. بعض المنصات تفرض رسومًا منفصلة على كتابة التخزين المؤقت، وبعضها يقدّم خصمًا على القراءة فقط، كما تختلف مدة الصلاحية وطريقة التفعيل. عند الاستدعاء عبر APIYI، اعتمد على البيانات الفعلية في صفحة الأسعار `https://docs.apiyi.com/models` لأسعار قراءة وكتابة التخزين المؤقت، وتحقق من الفوترة بالاستناد إلى حقول التخزين المؤقت في `usage` المُعاد.
س7: ما المؤشر الأكثر إغفالاً عند تقييم مزودي الخدمة؟
اتساق الفوترة والاستقرار في أوقات الذروة. كثير من الفرق تُجري اختبارًا واحدًا في أوقات انخفاض الطلب ثم تُطلق الخدمة، لتواجه بعد ذلك أخطاء 429 أو انتهاء المهلة بشكل متكرر في أوقات الذروة. وهناك أيضًا فرق كثيرة لا تتحقق أبدًا من تطابق `usage` مع الفاتورة. وينبغي إدراج هذين البندين ضمن الفحوصات الثابتة قبل الإطلاق.
أهم النقاط حول تكلفة خدمة Token وتقييم مزوّدي API
- جذر الخسارة: ارتفاع التكاليف الثابتة، والإيرادات القائمة على الاستهلاك، وتقلّب معدل الاستخدام — هذا الخلل الثلاثي يجعل خدمة Token عرضة للخسارة
- الإخراج أغلى: يتأثر فك التشفير (Decode) بعرض نطاق ذاكرة الفيديو، لذا على الأعمال ذات المخرجات الطويلة مراقبة سعر الإخراج ومعدل الإنتاجية عن كثب
- السياق الطويل له تكلفة خفية: تستهلك ذاكرة KV Cache مساحة ذاكرة الفيديو وتقلل من التزامن، لذا يضطر المزوّد إلى الموازنة عبر التسعير المتدرّج وتحديد المعدل
- الاستضافة الذاتية لها عتبة: لا يمكن تخفيف تكلفة GPU الثابتة إلا بأحمال كبيرة ومستقرة، لذا يُفضّل للفرق الصغيرة استخدام API
- التقييم عبر ستة أبعاد: شفافية السعر، اتساق الفوترة، أصالة النموذج، استقرار الأداء، توافق الواجهة، الاستدامة
- طريقة البدء: اختبر عمليًا وبسرعة عبر APIYI المتوافق مع صيغ OpenAI / Anthropic، والأسعار معتمدة وفق
docs.apiyi.com/models
الخلاصة: فهم خدمة Token من خلال هيكل التكلفة، واختيار مزود API للنماذج المناسب
لماذا تتعرض خدمة Token للخسارة؟ في المحصلة النهائية، يحدد ذلك هيكل تكلفة خدمة الاستدلال:
- جانب التكلفة: استهلاك إهلاك وحدات GPU وكهرباء مركز البيانات تكاليف ثابتة، ومعدل الاستخدام هو رافعة الربح والخسارة، كما أن رموز الإخراج (Output Tokens) والسياق الطويل يرفعان التكلفة أكثر
- جانب الإيرادات: تماثل النماذج مفتوحة المصدر يجعل حرب الأسعار أمرًا لا مفر منه، والدعم المالي لجذب الحجم يقلل هامش الربح الإجمالي
- جانب الاختيار: السعر المنخفض لا يعني أنه مربح، بل يجب الحكم باستخدام 6 أبعاد مجتمعة: شفافية السعر، واتساق الفوترة، وحقيقة النموذج، واستقرار الأداء، وتوافق الواجهة، والاستدامة
بالنسبة للمطورين، بدلًا من تخمين أي مزود خدمة يمكنه الصمود طويلًا، من الأفضل الاعتماد على بيانات الاستدعاء الفعلية. ابدأ بحجم صغير للتحقق من الفوترة ومقارنة الجودة، ثم قرر النموذج الأساسي والقنوات الاحتياطية.
نوصي بالتحقق السريع من النتائج عبر APIYI على apiyi.com. توفر المنصة استدعاء API للنماذج المذكورة في هذا المقال، وهي متوافقة مع صيغ واجهات OpenAI وAnthropic، ويمكن الاطلاع على وثائق التكامل عبر https://docs.apiyi.com. تتبع جميع أسعار الإدخال والإخراج والتخزين المؤقت للنماذج البيانات الفعلية في صفحة الأسعار https://docs.apiyi.com/models.
📚 المراجع
- 36Kr – وصلت الرموز (Token) إلى غرفة البث المباشر للي جياقي، فلماذا لا تزال شركات مثل SiliconFlow تتكبد الخسائر؟: تقرير عن معضلة ربحية مزودي خدمات الاستدلال
- الرابط:
36kr.com/p/4055385238017664 -
الوصف: خلفية صناعية لفهم تسليع الرموز (Token) وخسائر مزودي خدمات الاستدلال
-
36Kr – البعض يحرق 10,000 دولار شهريًا ويرى أن Claude باهظ للغاية، فتحولت هذه الشركة إلى GLM: حالة عملية لبناء الاستدلال الذاتي لخفض التكاليف
- الرابط:
36kr.com/p/4055383551038595 -
الوصف: حالة لبناء استدلال ذاتي بـ 56 بطاقة B200 يدعم 2000 مهندس، تساعد في فهم الحدود بين البناء الذاتي واستخدام API
-
مركز توثيق APIYI: دمج الواجهات وأسعار النماذج
- الرابط:
docs.apiyi.com - الوصف: طرق الدمج المتوافقة مع OpenAI / Anthropic، والأسعار معتمدة وفقًا لـ
docs.apiyi.com/models
المؤلف: فريق APIYI التقني
التواصل التقني: للأسئلة المتعلقة باختيار النماذج وتقييم تكاليف الرموز (Token)، يسعدنا تواصلكم معنا عبر الموقع الرسمي لـ APIYI على apiyi.com، ولمزيد من مواد الدمج يمكن زيارة مركز التوثيق docs.apiyi.com