Resumen: al elegir un modelo para desarrollo de juegos, conviene fijarse en la tasa de éxito para una misma tarea, el tiempo de ejecución, el costo de API y el esfuerzo de reparación manual; las tablas de precios y los benchmarks generales de código son solo referencias auxiliares.
Conclusión primero: cuando una IA desarrolla un juego de forma autónoma, lo que realmente hay que comparar es el costo de extremo a extremo de completar una versión entregable, y no el precio de lista por millón de tokens. En el caso de Saltline, Claude Fable 5.2 tardó unas 8 horas, usó aproximadamente 445 millones de tokens de entrada y unos 2.7 millones de tokens de salida, y generó un prototipo de juego de disparos en 3D que se ejecuta en el navegador. El desarrollador estimó, según los precios de API, un costo de aproximadamente 550 dólares, y la mayor parte de la entrada se sirvió desde caché. A fecha de 16 de noviembre de 2026, los precios unitarios estándar de API de los tres modelos difieren hasta en unas 5 veces, pero si el modelo con menor precio unitario necesita más rondas, el costo total puede ser más alto. Por eso, un método fiable para elegir modelo consiste en dar la misma tarea de juego a los modelos candidatos, ejecutarla varias veces, medir la tasa de éxito, los tokens, el tiempo y el esfuerzo de reparación manual, y luego calcular «el costo por versión aceptable».
Avance del contenido: la sección 1 desglosa, con Saltline, la estructura de la factura de tokens de un experimento de desarrollo de juegos con IA. La sección 2 compara los precios oficiales de tres modelos y explica el impacto de la caché en el costo total. La sección 3 presenta qué pueden mostrar, respectivamente, SWE-bench Verified, Aider Polyglot y las evaluaciones históricas de NIST. La sección 4 ofrece un plan de evaluación específico y reproducible para desarrollo de juegos, junto con el código. La sección 5 convierte los resultados en una estrategia de selección de modelos.
Para saber: Terminología de selección de modelos para desarrollo de videojuegos con IA
| Término | Explicación |
|---|---|
| Token de entrada | Unidad de medida del contenido que se envía al modelo para su procesamiento, incluidos indicaciones, archivos de código y resultados devueltos por herramientas |
| Token de salida | Unidad de medida del contenido generado por el modelo, como código, texto explicativo y parámetros de invocación de herramientas |
| Lectura de caché | Reutilización de contexto ya almacenado en caché; su costo es mucho menor que el de una entrada normal |
| Escritura de caché | Costo de guardar el contexto en caché por primera vez; normalmente es algo más alto que el de una entrada normal |
| SWE-bench Verified | Benchmark con 500 tareas de ingeniería de software de proyectos reales de código abierto, verificadas manualmente |
| Aider Polyglot | Evaluación de modificación de código que cubre 6 lenguajes de programación y 225 ejercicios |
| Harness | Marco de ejecución que organiza el modelo, las herramientas y el ciclo de tareas; por ejemplo, el andamiaje de un agente |
| Tasa de éxito de la tarea | Proporción de tareas completadas según los criterios de aceptación definidos de antemano |
| Costo de extremo a extremo | Suma de los costos de invocación del modelo, ejecución de herramientas y trabajo humano necesarios para completar toda la tarea |
| Corrección manual | Modificación manual realizada para que el resultado generado cumpla los criterios de aceptación |
| Generación procedural | Generar geometría, texturas y sonido mediante código y funciones matemáticas, en lugar de importar archivos de recursos |
| Shader | Programa que se ejecuta en la GPU para calcular efectos visuales como color, iluminación y materiales |
1. Caso de costos de desarrollo independiente de un juego con IA: cuántos tokens gastó Saltline
1.1 ¿Qué escala tiene Saltline?
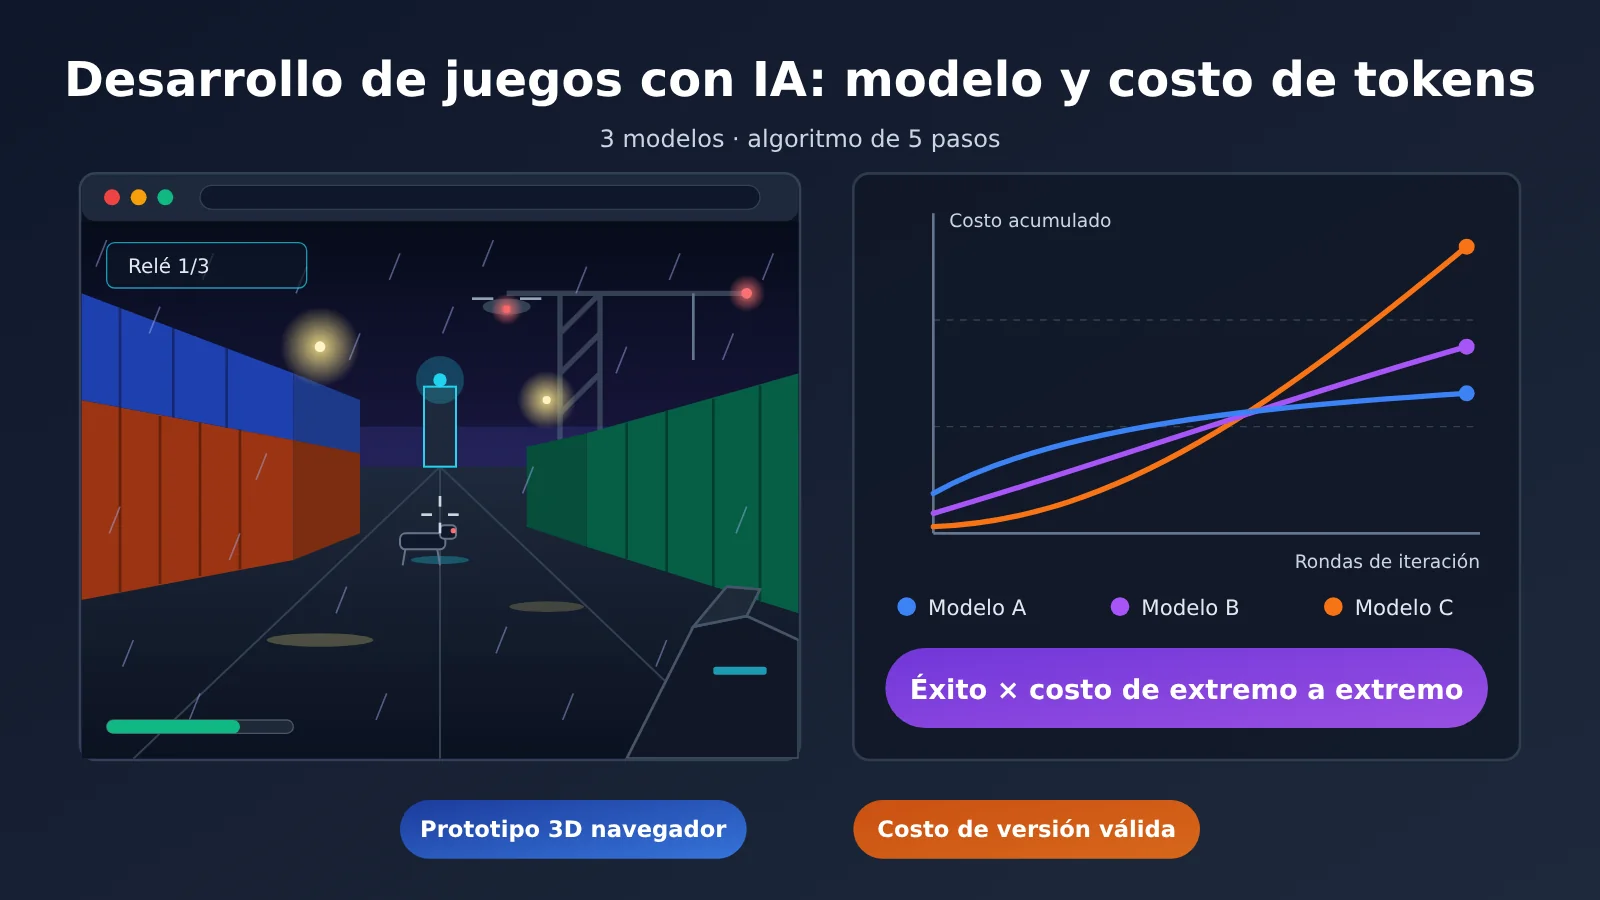
El 9 de noviembre de 2026, el ingeniero de Anthropic Felix Rieseberg publicó un experimento de programación con Claude Fable 5.2. Solo le dio al modelo una indicación: crear un juego de disparos en primera persona, de pequeña escala, con un aspecto visual lo más cercano posible a un juego AAA, y no proporcionó retroalimentación humana en ningún momento. El resultado fue Saltline: un juego de disparos 3D que se ejecuta directamente en el navegador, ambientado en un puerto de contenedores durante una noche lluviosa. El jugador debe apagar tres estaciones de retransmisión de señal y evacuar; los enemigos incluyen drones de patrulla aérea y sabuesos mecánicos terrestres.
En cuanto a escala, Saltline es un prototipo jugable para un solo jugador y un solo nivel. «AAA» aquí es un objetivo experimental y una analogía visual para describir el estilo gráfico; su envergadura está muy lejos de la de un producto AAA comercial. La etiqueta china «几猫·国产3A大作» que se difundió en China es la versión china de Saltline, o una versión reempaquetada. El nombre surgió del proceso de difusión y no representa la autoría del desarrollo.
1.2 Tiempo, tokens y costo declarados por el propio desarrollador
Los siguientes datos provienen de publicaciones del propio desarrollador en X. Se trata de estimaciones declaradas por él, sin auditoría independiente:
- Tiempo de desarrollo: aproximadamente 8 horas
- Tokens de entrada: aproximadamente 445 millones, con un uso intensivo de caché
- Tokens de salida: aproximadamente 2,7 millones
- Costo estimado según los precios de API: alrededor de 550 dólares
- Método de desarrollo: una única indicación, sin iteraciones con retroalimentación humana
Este dinero es un costo de generación único. Una vez generados los archivos del juego, estos se ejecutan localmente en el navegador del jugador. Cuando el jugador juega, no se llama a la API de Claude, así que esos 550 dólares tampoco pueden prorratearse como “costo de IA por jugador”.
1.3 Desglose de esta cuenta con el precio unitario oficial
Según el precio estándar oficial de Claude Fable 5.2 (salida a $40 por millón de tokens), 2,7 millones de tokens de salida equivalen a unos 108 dólares. Los aproximadamente 440 dólares restantes corresponden a la parte de entrada, incluidos escritura en caché, lectura de caché y entrada normal. El desarrollador no publicó las cantidades de cada uno de estos tres conceptos, por lo que no se puede desglosar más.
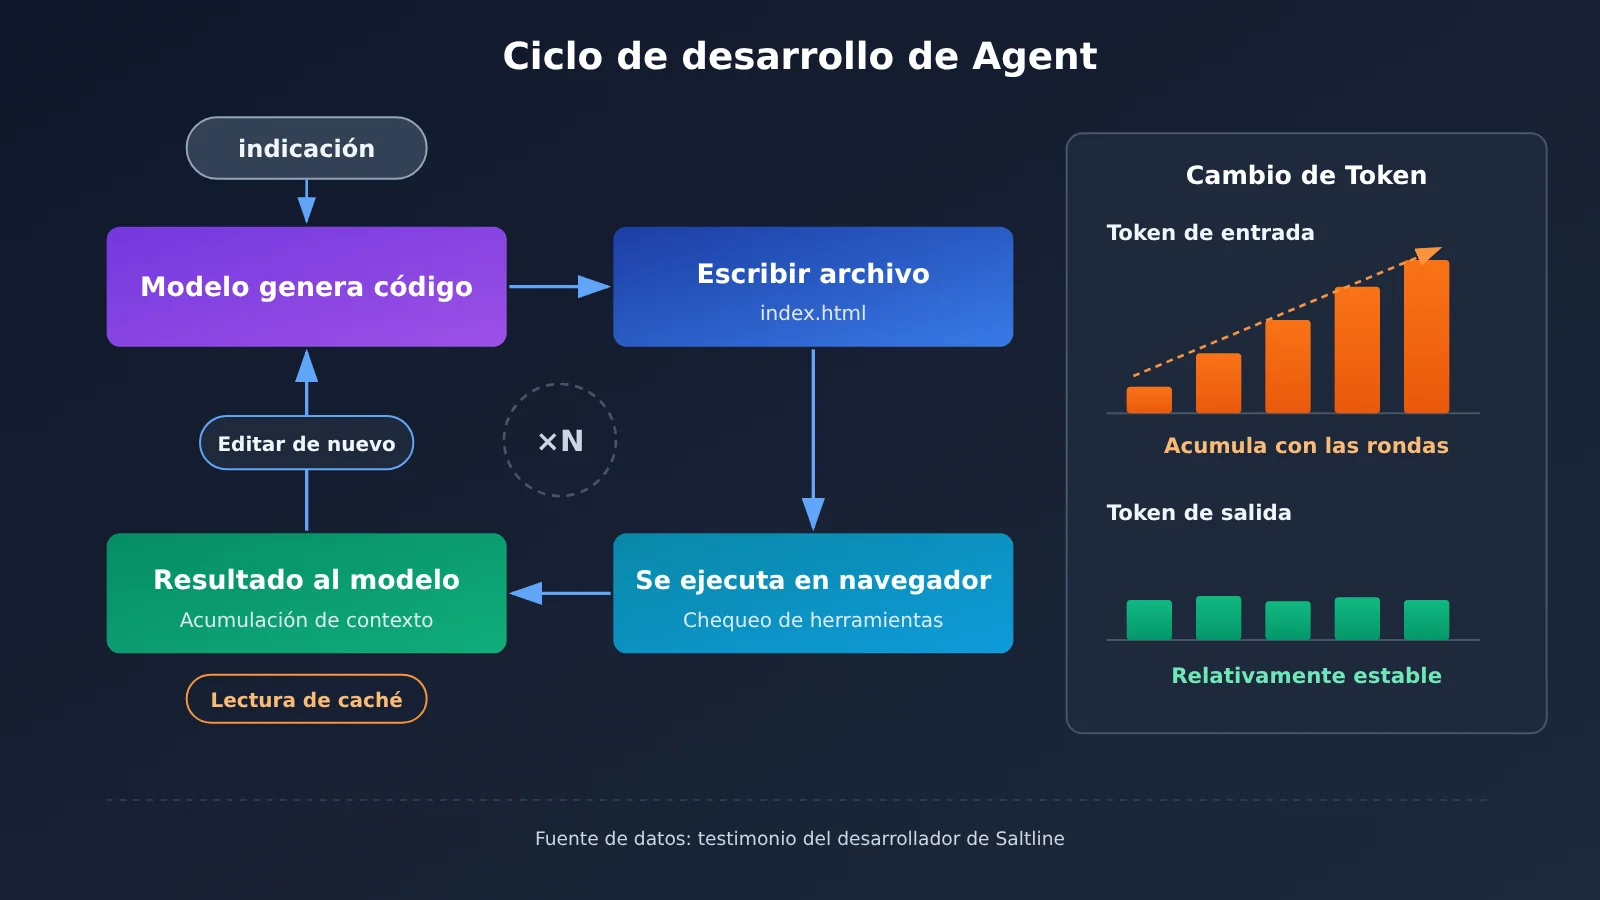
Basta comparar los dos valores límite para ver el papel de la caché: si los 445 millones de tokens de entrada se cobraran todos al precio de entrada normal de $8, serían unos $3,560; si todos se cobraran al precio de lectura de caché de $0.20, serían unos 89 dólares. La estimación real cae entre ambos valores y se acerca claramente al límite inferior. Esto muestra que, en tareas de desarrollo con agentes de larga duración, la tasa de aciertos de caché en la entrada determina el orden de magnitud de la factura, mientras que el impacto del precio unitario de salida es relativamente secundario.
1.4 Por qué un archivo de 1.4MB puede consumir 445 millones de tokens
La versión independiente en HTML de Saltline ocupa unos 1.43MB (1.425.707 bytes). El desarrollador explica que los modelos y las texturas del juego son código: la geometría se construye por procedimientos, la apariencia de las superficies se calcula con shaders y el sonido también se genera de forma procedural. No hay imágenes ni modelos 3D sueltos como recursos.
El resultado es pequeño, pero el proceso es largo. Durante 8 horas, el agente lee una y otra vez archivos de código que no dejan de crecer, ejecuta herramientas, revisa los resultados y vuelve a modificar; en cada ronda tiene que enviar de nuevo al modelo un contexto enorme. El consumo final de tokens viene sobre todo de ese bucle, no de la longitud del archivo final. Es justamente por eso que, al evaluar un modelo para desarrollo de juegos, hay que medir también el «coste del proceso».
2 Comparativa de precios de modelos para desarrollo de videojuegos: diferencias de facturación por Token entre las tres APIs
2.1 Precios estándar oficiales de los tres modelos
Los precios de la tabla siguiente provienen de las páginas oficiales de cada proveedor, con fecha de corte al 16 de noviembre de 2026, expresados en dólares por millón de Tokens, correspondientes a la tarifa estándar de API y sin incluir descuentos de otros canales ni recargos regionales.
| Modelo | Entrada normal | Salida | Lectura de caché | Notas |
|---|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 | Escritura de caché de 5 minutos $10, escritura de caché de 1 hora $16; contexto 1M, salida máxima 128K |
| GPT-6 Astra | $10 | $50 | $1 | Nivel de procesamiento estándar; los precios de otras opciones de velocidad, procesamiento por lotes y región pueden variar |
| Gemini 4 Argon | $2 | $10 | $0.10 | Este precio aplica hasta el 30 de noviembre de 2026; a partir del 1 de diciembre está previsto un ajuste a entrada $4 y salida $20 |
Claude Fable 5.2 cuenta además con un Fast Mode (modo rápido), con entrada $16 y salida $80; según el proveedor, la velocidad de salida puede aumentar hasta 2.5 veces. Para tareas largas que deben completarse en un tiempo fijo, el nivel de velocidad modifica tanto el tiempo de ejecución como el costo, por lo que conviene registrarlo como una configuración independiente durante la evaluación.
💡 Consejo para la comparación: las interfaces y los campos de facturación de los tres modelos son distintos, así que al montar tu propio entorno de evaluación tendrás que integrarlos por separado. APIYI apiyi.com ofrece una interfaz unificada compatible con OpenAI: con una sola clave API puedes invocar modelos como Claude, GPT y Gemini, lo que facilita cambiar de modelo dentro del mismo conjunto de scripts de evaluación. Los modelos disponibles y los precios concretos están sujetos a la lista de la plataforma.
2.2 Diferencias de precio de lista con el mismo volumen de Tokens
Para hacerte una idea intuitiva de la diferencia de precio unitario, podemos sustituir el volumen de salida de Saltline (2.7 millones de Tokens) en los precios de los tres modelos: Claude Fable 5.2 rondaría los $108, GPT-6 Astra los $135 y Gemini 4 Argon los $27. Si los 445 millones de entrada se leyeran todos desde caché, las cifras serían aproximadamente $89, $445 y $45 respectivamente.
Estas cifras solo ilustran la estructura de facturación, y parten de la premisa de que los tres modelos consuman exactamente los mismos Tokens, algo que en la práctica casi nunca se cumple. Distintos modelos necesitan un número diferente de turnos para completar la misma tarea, leen distintos volúmenes de contexto en cada turno y generan código de diferente longitud; además, volver a ejecutar tras un fallo multiplica los costos.
2.3 El precio de la caché importa más que el precio de entrada
En el desarrollo con estilo de Agent, la mayor parte de la entrada es contexto repetido. El precio de lectura de caché de GPT-6 Astra es 1/10 del de la entrada normal, el de Claude Fable 5.2 es 1/40 y el de Gemini 4 Argon es 1/20. Cuanto menor sea la relación entre el precio de lectura de caché y el precio de entrada normal, más fácil resulta comprimir el costo de entrada de las tareas largas.
La caché también tiene costos de escritura y un período de validez. En Claude, el precio de escritura de la caché de 5 minutos difiere del de la caché de 1 hora; si el intervalo entre dos invocaciones del Agent supera la validez de la caché, hay que volver a escribirla. Al estimar el costo de tareas largas, es necesario incorporar al cálculo el número de escrituras de caché, la tasa de aciertos y el período de validez.
3 Qué pueden indicar los benchmarks de programación: una referencia de las capacidades de los modelos de desarrollo de juegos
3.1 SWE-bench Verified: tareas de ingeniería de software en repositorios reales
SWE-bench Verified contiene 500 problemas seleccionados y verificados manualmente, provenientes de proyectos de código abierto reales. El modelo debe comprender el contexto del repositorio y llevar a cabo tareas como corregir errores, modificar código existente, resolver fallos de pruebas y hacer cambios en varios archivos, lo que se acerca mucho más a la ingeniería real que la simple autocompletación de código.
Al usarlo, hay que tener en cuenta la influencia del Harness. La documentación oficial indica que la clasificación completa mezcla distintos sistemas Agent, por lo que, para comparar modelos puros, conviene usar una configuración uniforme de mini-SWE-agent. La configuración del Agent, las herramientas, las indicaciones y la versión alteran la puntuación, por lo que los resultados de distintas configuraciones deben analizarse por separado.
3.2 Aider Polyglot: registrar a la vez la precisión y el costo
Aider Polyglot utiliza 225 ejercicios de programación que abarcan C++, Go, Java, JavaScript, Python y Rust, y emplea casos de prueba para determinar si el modelo modifica el código correctamente. Sus resultados públicos, además de la tasa de precisión, también registran el consumo de tokens, el costo de ejecución, la salida de errores, los errores de formato y el tiempo de ejecución de cada tarea.
Para la selección de modelos, esta forma de registrar «precisión + costo» resulta muy valiosa, y coincide con el enfoque del marco de evaluación que veremos más adelante en este artículo. Los ejercicios en sí son problemas independientes, y su escala y forma difieren notablemente de las de un proyecto completo de juego 3D.
3.3 Evaluaciones históricas de NIST: atención a la versión del modelo y la fecha
En el informe de evaluación de modelos publicado en 2025 por CAISI, dependiente del Instituto Nacional de Estándares y Tecnología (NIST) de Estados Unidos, se probaron las puntuaciones de SWE-bench Verified de un conjunto de modelos. Los siguientes datos corresponden a modelos históricos y configuraciones experimentales de dicho informe, y no representan el ranking de los modelos más recientes de noviembre de 2026.
| Modelo (versión probada en el informe de 2025) | Puntuación de SWE-bench Verified |
|---|---|
| Anthropic Opus 4 | 66.7% |
| GPT-5 | 63.0% |
| DeepSeek V3.1 | 54.8% |
| DeepSeek R1-0528 | 44.6% |
| gpt-oss | 42.6% |
| DeepSeek R1 | 25.4% |
El informe también proporciona el error estándar, lo que indica que las puntuaciones de una misma referencia presentan fluctuaciones estadísticas. Las diferencias de unos pocos puntos porcentuales pueden no tener una distinción real dentro del margen de error. Los modelos comparados en este artículo —Claude Fable 5.2, GPT-6 Astra y Gemini 4 Argon— no aparecen en este informe, por lo que a la hora de seleccionar un modelo conviene buscar las evaluaciones más recientes dirigidas a la versión actual y con la configuración indicada, o realizar pruebas propias.
3.4 La brecha entre la capacidad de programación general y la capacidad de desarrollo de videojuegos
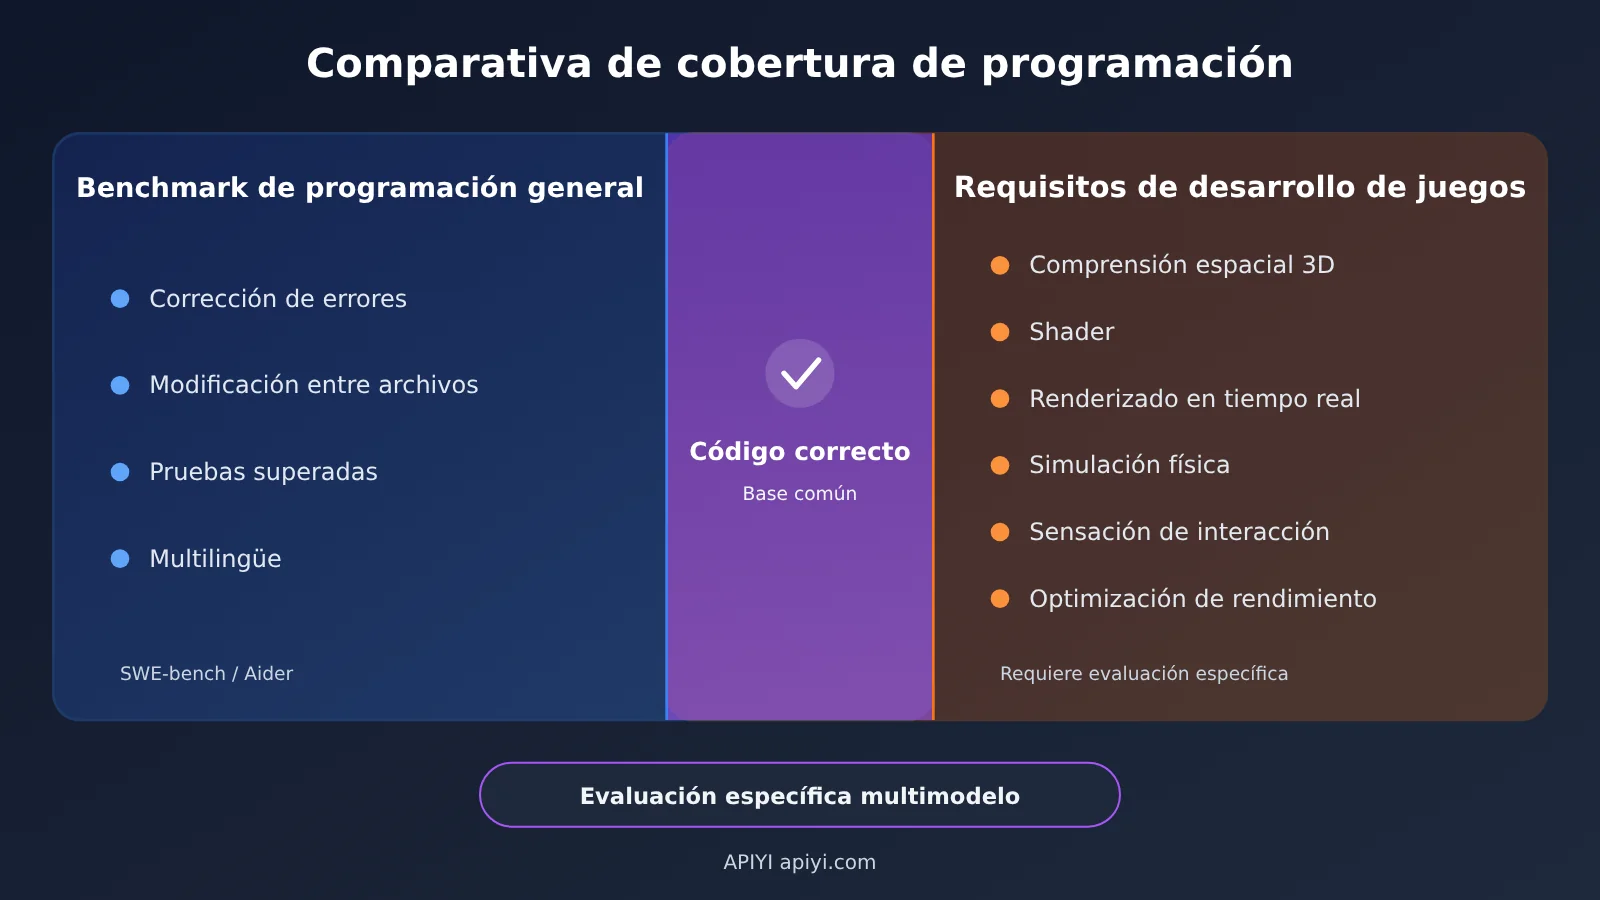
El desarrollo de videojuegos incluye una gran cantidad de tareas que los benchmarks de ingeniería de software general no cubren lo suficiente: comprensión espacial 3D, escritura de shaders, renderizado en tiempo real, sistemas de animación, simulación física, sensación de interacción y optimización del rendimiento en ejecución. Proyectos como Saltline además exigen que el modelo genere recursos visuales mediante código, lo cual depende del dominio de gráficos y efectos visuales.
Un modelo puede ser muy bueno reparando bugs en repositorios de Python y, aun así, rendirse con relativa facilidad en escenas WebGL complejas. SWE-bench y Aider sirven para descartar candidatos con capacidades de código claramente insuficientes; la clasificación final depende de una evaluación especializada en desarrollo de videojuegos.
4 Cómo comparar modelos de IA para el desarrollo de videojuegos: un plan de evaluación especializada sobre la misma tarea
4.1 Diseñar una tarea unificada de juego 3D para navegador
Inspirándonos en el formato de Saltline, podemos definir la tarea así: generar, a partir de una indicación, un prototipo de juego 3D que se pueda ejecutar en el navegador. Todos los modelos candidatos reciben exactamente los mismos requisitos:
- Generar un proyecto completo que se pueda abrir y ejecutar directamente en el navegador
- Incluir un personaje controlable y un entorno 3D
- Incluir colisiones o física básica
- Incluir objetivos de misión claros y condiciones de victoria/derrota
- No permitir modificaciones manuales del código central durante la evaluación
La dificultad de la tarea debe ajustarse a tus necesidades reales. Un equipo que hace minijuegos casuales sobreestimará el nivel de modelo necesario si prueba con un prototipo FPS; un equipo que desarrolla proyectos 3D complejos lo subestimará si prueba con una tarea 2D sencilla.
4.2 Diez métricas de evaluación
| Dimensión | Contenido evaluado | Forma de registro sugerida |
|---|---|---|
| Completitud funcional | Si se implementan las funciones centrales del juego | Marcar cada elemento de la lista de funciones |
| Calidad visual | Escenario, materiales, iluminación, animación | Puntuación ciega por varias personas |
| Ejecutabilidad | Si arranca correctamente | Sí / No |
| Integridad de interacción | Si la entrada y la retroalimentación funcionan correctamente | Probar cada elemento de la lista de operaciones |
| Estabilidad | Si hay caídas evidentes | Registrar el número de caídas durante un tiempo de juego fijo |
| Rendimiento | FPS, tiempo de arranque, memoria | Medición real en un dispositivo fijo |
| Calidad del código | Legibilidad, modularidad, manejo de errores | Puntuación mediante revisión de código |
| Costo de tokens | Entrada, salida, caché | Acumular desde el campo API usage |
| Tiempo total | Desde el inicio hasta la versión ejecutable | Cronometrar |
| Reparación manual | Intervención humana necesaria para cumplir los criterios | Registrar horas de trabajo manual |
De ellas, «ejecutabilidad», «completitud funcional» e «integridad de interacción» deben usarse como criterios de aceptación obligatorios para determinar si una ejecución fue exitosa; la calidad visual, el rendimiento y la calidad del código sirven para clasificar entre los resultados exitosos.
4.3 Controlar el entorno de prueba
Que los resultados de la evaluación se puedan comparar depende de si las variables están bajo control. Las condiciones que hay que unificar incluyen: el mismo navegador, el mismo dispositivo, la misma indicación, el mismo flujo de prueba, el mismo presupuesto de tiempo y si se permite o no el acceso a internet. Si se permite que los modelos invoquen herramientas por su cuenta, busquen información o creen archivos, los permisos de herramientas de todos los modelos también deben ser consistentes.
El harness también debe fijarse. Un mismo modelo con un framework de Agent distinto puede cambiar enormemente su tasa de éxito y su consumo de Tokens, así que el informe de evaluación debe especificar el framework utilizado, la versión y los parámetros, por ejemplo la temperatura, la longitud máxima de salida y el nivel de velocidad.
4.4 Ejecutar cada modelo varias veces como mínimo
La generación de modelos de lenguaje grandes tiene aleatoriedad: un acierto puede ser suerte y un fallo puede ser algo puntual. Cada modelo debe ejecutarse varias veces bajo las mismas condiciones (por ejemplo, entre 5 y 10 veces), registrando la tasa de éxito y el promedio de Tokens, tiempo y puntuación de calidad de las muestras exitosas. Saltline en sí también es un experimento único: demuestra que esto se puede hacer, pero no puede dar la tasa de éxito de ese modelo en tareas similares.
El siguiente script llama al modelo mediante una interfaz compatible con OpenAI y calcula el costo de una sola llamada según los precios de la sección 2, usando el campo usage:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI, interfaz unificada; para cambiar de modelo solo hay que cambiar model
)

# Unidad: dólares / millón de Tokens, precio estándar oficial hasta el 2026-11-16
PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

def call_and_price(model: str, messages: list) -> tuple[str, float]:
    resp = client.chat.completions.create(model=model, messages=messages)
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + u.completion_tokens * p["output"]) / 1_000_000
    return resp.choices[0].message.content, cost
Los nombres de los modelos deben basarse en la lista de modelos de la plataforma de invocación real. Los costos de escritura en caché y los recargos por nivel de velocidad deben añadirse por separado al cálculo según las reglas de cada proveedor.
Ver el script de evaluación multi-ronda y resumen de costos
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Llamar a varios modelos candidatos a través de APIYI
)

PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

TASK_PROMPT = "生成一个可在浏览器运行的单文件 3D 游戏原型……(所有模型使用同一提示词)"

def price(model, usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    return ((usage.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + usage.completion_tokens * p["output"]) / 1_000_000

def run_once(model, max_rounds=30):
    """Bucle simplificado del Agent: generar → verificar → devolver el resultado → modificar"""
    messages = [{"role": "user", "content": TASK_PROMPT}]
    total_cost, start = 0.0, time.time()
    for _ in range(max_rounds):
        resp = client.chat.completions.create(model=model, messages=messages)
        total_cost += price(model, resp.usage)
        code = resp.choices[0].message.content
        report = check_game(code)  # Implementar por tu cuenta: escribir el archivo, lanzar el navegador sin interfaz y ejecutar la lista de funciones
        if report["passed"]:
            return True, total_cost, time.time() - start
        messages += [{"role": "assistant", "content": code},
                     {"role": "user", "content": f"检查结果:{report['log']},请修复"}]
    return False, total_cost, time.time() - start

def evaluate(model, trials=5, human_fix_cost=0.0):
    results = [run_once(model) for _ in range(trials)]
    successes = sum(r[0] for r in results)
    api_cost = sum(r[1] for r in results)
    rate = successes / trials
    per_success = (api_cost + human_fix_cost) / successes if successes else float("inf")
    print(f"{model}: 成功率 {rate:.0%},API 总费用 ${api_cost:.2f},"
          f"每个合格版本成本 ${per_success:.2f}")

for m in PRICES:
    evaluate(m)
🚀 Inicio rápido: al montar este tipo de evaluación, conviene primero hacer funcionar el script con una tarea pequeña y después cambiarla por la tarea completa del juego. APIYI apiyi.com ofrece crédito de prueba gratuito a los usuarios nuevos: úsalo para validar el Harness y la lógica de conteo de facturación antes de comprometer el presupuesto real de la evaluación.
5 Cómo elegir un modelo al desarrollar juegos con IA: controlar el costo de tokens en tareas complejas
5.1 La tasa de éxito determina el costo total
El costo total de desarrollo se compone de tres partes:
Costo total de la tarea = costo de invocación del modelo + costo de ejecución de las herramientas + costo de reparación manual
Si tomamos en cuenta la tasa de éxito, un indicador de comparación más práctico es el «costo por versión válida»: el gasto total de todos los intentos dividido por el número de éxitos. Supongamos que el modelo A cuesta 100 dólares por intento y tiene una tasa de éxito del 80 %: cada versión válida sale unos 125 dólares. El modelo B cuesta 30 dólares por intento con una tasa de éxito del 20 %: cada versión válida sale unos 150 dólares, y a eso todavía hay que sumarle el tiempo de diagnóstico de las versiones fallidas. En este ejemplo, el modelo con el precio unitario más bajo termina siendo, en realidad, el más caro.
La reparación manual suele ser el rubro más grande. Un ingeniero que pasa varias horas arreglando el resultado generado puede acumular un costo de mano de obra superior al de toda la llamada a la API. Por eso, al evaluar hay que registrar con honestidad el tiempo de intervención manual y convertirlo al costo total usando la tarifa real de mano de obra del equipo.
5.2 Tres estrategias de selección de modelos
| Estrategia | Casos de uso | Ventajas | Costes a vigilar |
|---|---|---|---|
| Modelo de alta capacidad | Arquitectura compleja, desarrollo con contextos largos, colaboración entre múltiples módulos, localización de bugs complejos | Alta tasa de éxito, menos re-ejecuciones y correcciones manuales | Precio unitario alto; hay que apoyarse en la caché para controlar el coste de entrada |
| Modelo de bajo coste | Funcionalidad sencilla, explicación de código, modificaciones repetitivas, apoyo a pruebas | Precio unitario bajo, adecuado para invocaciones frecuentes | Las tareas complejas pueden fallar durante varias rondas y el coste total acaba subiendo |
| Colaboración entre múltiples modelos | Un modelo se encarga de la arquitectura, otro de la implementación y un modelo independiente hace la revisión de código | Ajustar capacidad y precio a cada etapa | El traspaso entre modelos duplica el envío de contexto y aumenta los tokens y los costes de coordinación |
El ahorro que aporta la colaboración entre múltiples modelos depende del coste de los traspasos. Cada traspaso implica volver a enviar el contexto del proyecto a otro modelo, y las cachés no se comparten entre modelos distintos. La colaboración solo resulta rentable cuando el modelo de bajo coste asume suficientes etapas y los traspasos son lo bastante pocos; esto también hay que confirmarlo con pruebas reales.
💰 Consejo de costes: la colaboración entre múltiples modelos requiere invocar varios modelos a la vez en un mismo proyecto. Accediendo a través de APIYI apiyi.com con la misma clave API y el mismo código, se reduce el trabajo de gestionar varias cuentas y adaptar interfaces, y resulta más fácil asignar arquitectura, implementación y revisión a distintos modelos para luego contabilizar los gastos de forma unificada.
5.3 Un proceso ejecutable de cinco pasos para elegir el modelo
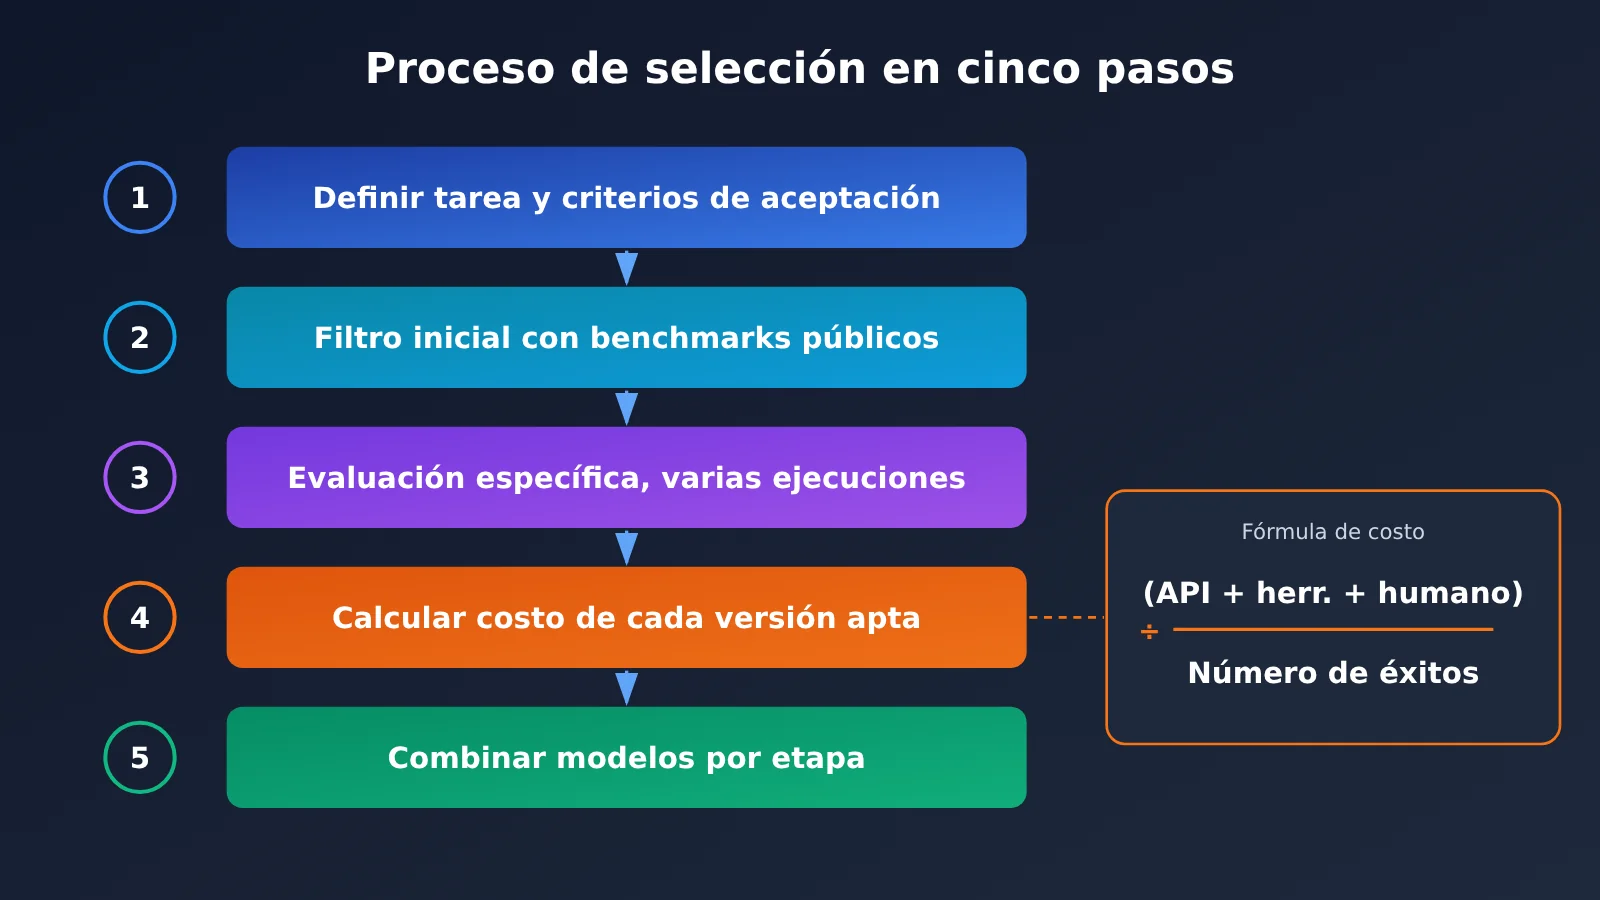
- Define la tarea y los criterios de aceptación: deja por escrito la lista de funcionalidades, las plataformas objetivo y el nivel mínimo de rendimiento; serán la base para determinar si algo es un éxito.
- Haz una primera criba con benchmarks públicos: toma como referencia los resultados actuales de SWE-bench Verified y Aider Polyglot, con su configuración bien especificada, y descarta los modelos cuya capacidad de código sea claramente insuficiente.
- Ejecuta evaluaciones específicas: en un entorno unificado, corre la misma tarea de juego de 5 a 10 veces con cada modelo candidato y registra las diez métricas de la sección 4.2.
- Calcula el costo de cada versión apta: costo de API más costo de herramientas más costo de reparación manual, dividido entre el número de éxitos.
- Combina modelos por etapa: asigna las etapas complejas a los modelos con mayor tasa de éxito y las etapas repetitivas a los modelos de bajo costo; luego comprueba en la práctica si la combinación realmente sale más barata.
Los precios cambian; por ejemplo, Gemini 4 Argon ya anunció un ajuste de precios a partir del 1 de diciembre. Conserva los datos originales de tokens de las evaluaciones: cuando cambien los precios, basta con volver a aplicar el precio unitario para actualizar las conclusiones.
6 Preguntas frecuentes sobre la selección de modelos de IA para el desarrollo de juegos
P1: ¿Los 550 dólares de Saltline son una factura real?
No es una factura auditada. Los 550 dólares son un cálculo de costos estimado por el desarrollador Felix Rieseberg según los precios de la API, y los datos que lo acompañan (aproximadamente 8 horas, unos 445 millones de tokens de entrada y unos 2,7 millones de tokens de salida) también provienen de su propia declaración. Se usó caché intensivamente en la entrada, y la proporción exacta de escritura y lectura de caché no se hizo pública.
P2: ¿El modelo con el precio unitario más bajo es el que más ahorra?
Depende de la tasa de éxito. El precio unitario solo determina el costo por token; cuántos tokens necesita el modelo para completar la tarea, cuántas veces hay que volver a ejecutarla y cuánta reparación manual requiere dependen de la capacidad del modelo. Solo tiene sentido comparar usando «costo total ÷ número de éxitos».
P3: ¿El modelo número uno en SWE-bench es el más adecuado para hacer juegos?
SWE-bench Verified mide la capacidad de ingeniería de software en repositorios de código abierto reales, y tiene cobertura limitada sobre shaders, comprensión espacial 3D, renderizado en tiempo real y la sensación de interacción. Sirve para una primera criba, pero la clasificación final para el desarrollo de juegos requiere evaluaciones especializadas.
P4: ¿Las puntuaciones del informe NIST representan a los modelos actuales?
No. El informe NIST CAISI se publicó en 2025 y evaluó modelos históricos como GPT-5, Opus 4 y DeepSeek V3.1, junto con configuraciones experimentales específicas. Para los nuevos modelos de noviembre de 2026 hay que buscar evaluaciones nuevas correspondientes a sus versiones.
P5: ¿Cómo montar rápidamente una evaluación comparativa de múltiples modelos?
Lo más cómodo es usar una plataforma agregadora con interfaz compatible con OpenAI. Después de registrarse en APIYI apiyi.com y obtener la clave API, configure el `base_url` del script de este artículo como `https://api.apiyi.com/v1` y modifique el parámetro model para probar varios modelos con el mismo conjunto de scripts. Los usuarios nuevos pueden validar primero el script con la cuota gratuita.
P6: ¿Cómo contabilizar el costo de tokens durante la evaluación de la forma más precisa?
Tome como referencia el campo usage de la respuesta de la API, acumule llamada por llamada los tokens de entrada normales, de lectura de caché y de salida, y luego calcule según el precio oficial del día de la llamada y el tramo de facturación. Los cargos adicionales, como la escritura de caché y los niveles de velocidad, deben sumarse por separado según las reglas de cada proveedor. Al invocar a través de APIYI apiyi.com, también puede contrastar sus estadísticas con el registro de consumo del panel de la plataforma.
P7: ¿Se puede publicar directamente un prototipo de juego generado por IA?
Prototipos como Saltline demuestran que un modelo puede producir una versión jugable sin retroalimentación humana, pero la publicación comercial también implica compatibilidad entre navegadores, adaptación a móviles, optimización de rendimiento y mantenimiento a largo plazo. Los juegos de navegador están limitados por el hardware local y el navegador; la página de Saltline también advierte sobre problemas como el inicio lento y la necesidad de cambiar a una calidad gráfica baja cuando hay tirones. Los costos de pruebas y optimización antes del lanzamiento deben incluirse en el costo total de desarrollo.
7 Puntos clave para elegir modelos en el desarrollo de videojuegos con IA
- Métrica central: comparar el costo de extremo a extremo de cada versión que cumpla los requisitos, no el precio por millón de tokens.
- Factura de Saltline: unos 550 USD según la estimación declarada por el desarrollador; la salida representa alrededor de 108 USD y el resto corresponde a la entrada.
- La caché marca la escala: en tareas largas, la entrada representa la mayor parte; el precio de lectura de caché y la tasa de aciertos son los factores que más influyen.
- Los precios tienen vigencia: los precios de este artículo están actualizados a 2026-11-16; Gemini 4 Argon tiene previsto ajustar sus precios a partir del 1 de diciembre.
- Los benchmarks sirven para un filtro inicial: SWE-bench y Aider miden programación general; las capacidades para videojuegos requieren evaluaciones específicas.
- Ejecutar varias veces: correr cada modelo de 5 a 10 veces en las mismas condiciones y sacar conclusiones con la tasa de éxito, no con un único resultado.
- Cómo empezar: cambiar de modelo mediante la interfaz unificada de APIYI (apiyi.com), para comparar costos con el mismo script.
8 Resumen: cómo elegir modelos para que la IA desarrolle videojuegos de forma autónoma
Para que la IA desarrolle un videojuego de forma autónoma, hay tres puntos clave al elegir el modelo:
- Hay que calcularlo todo: el costo total de la tarea incluye la invocación del modelo, la ejecución de herramientas y la corrección manual; la tarifa de API es solo uno de esos componentes.
- Las capacidades deben medirse en la práctica: los benchmarks públicos sirven para un filtro inicial; la clasificación final para el desarrollo de videojuegos proviene de múltiples evaluaciones específicas bajo condiciones homogéneas.
- Combinar según la etapa: usar modelos con alta tasa de éxito en etapas complejas y modelos de bajo costo en etapas repetitivas; la solución combinada también debe validarse con pruebas reales.
Saltline ofrece un orden de magnitud como referencia: una sola indicación, unas 8 horas y un costo estimado de aproximadamente 550 USD para producir un prototipo 3D jugable para navegador. Cuánto necesitará tu proyecto depende de la complejidad de la tarea y de la tasa de éxito de los modelos elegidos; lo más fiable es ejecutar una ronda de evaluación propia con el marco de este artículo.
Se recomienda montar rápidamente un entorno de comparación de varios modelos a través de APIYI (apiyi.com); la plataforma ofrece una interfaz compatible con OpenAI y crédito gratuito para nuevos usuarios, lo que facilita medir precios y tasas de éxito dentro del mismo conjunto de scripts.
Materiales de referencia
- Página de demostración independiente de Saltline: instrucciones de prueba del juego y preguntas frecuentes
- Enlace:
saltline.games -
Descripción: incluye información sobre la experiencia, como la inicialización, el cambio de calidad gráfica y los controles
-
Espejo de código y README de Saltline: notas sobre la atribución de datos del desarrollador
- Enlace:
github.com/realcodebear/saltline-fable-5.2 -
Descripción: registra la fecha de generación, los tokens y el origen de la estimación de costos
-
Repositorio de la versión china de Jimao: archivo de la versión con envoltorio chino de Saltline
- Enlace:
github.com/Megasu/jimao-3a-game -
Descripción: proporciona datos como el tamaño del archivo index.html
-
Especificaciones y precios del modelo Claude Fable 5.2: documentación oficial de Anthropic
- Enlace:
platform.claude.com/docs/en/models/fable-5-2/overview -
Descripción: precios de entrada, salida, caché y Fast Mode
-
Documentación del modelo GPT-6 Astra: precios oficiales de OpenAI
- Enlace:
developers.openai.com/api/docs/models/gpt-6-astra -
Descripción: los precios del nivel de procesamiento estándar se basan en esta fuente
-
SWE-bench Verified: página oficial del benchmark de ingeniería de software
- Enlace:
swebench.com/verified.html -
Descripción: 500 tareas verificadas manualmente y la explicación de la configuración unificada de mini-SWE-agent
-
Aider Leaderboards: resultados de la evaluación Aider Polyglot
- Enlace:
aider.chat/docs/leaderboards -
Descripción: registra al mismo tiempo la tasa de precisión, el consumo de tokens y el costo de ejecución
-
Informe de evaluación NIST CAISI (2025): evaluación independiente de modelos históricos
- Enlace:
nist.gov/system/files/documents/2025/09/30/CAISI_Evaluation_of_DeepSeek_AI_Models.pdf - Descripción: incluye los resultados históricos de SWE-bench Verified y el error estándar
Autor: equipo técnico de APIYI
Contacto técnico: pueden contactarnos en la página principal de APIYI apiyi.com; para más material de integración, visiten el centro de documentación docs.apiyi.com