요약: 게임 개발 모델을 고를 때는 같은 작업의 성공률, 실행 시간, API 비용, 수동 수정 비용을 봐야 해요. 가격표와 범용 코드 벤치마크는 보조 근거일 뿐이에요.
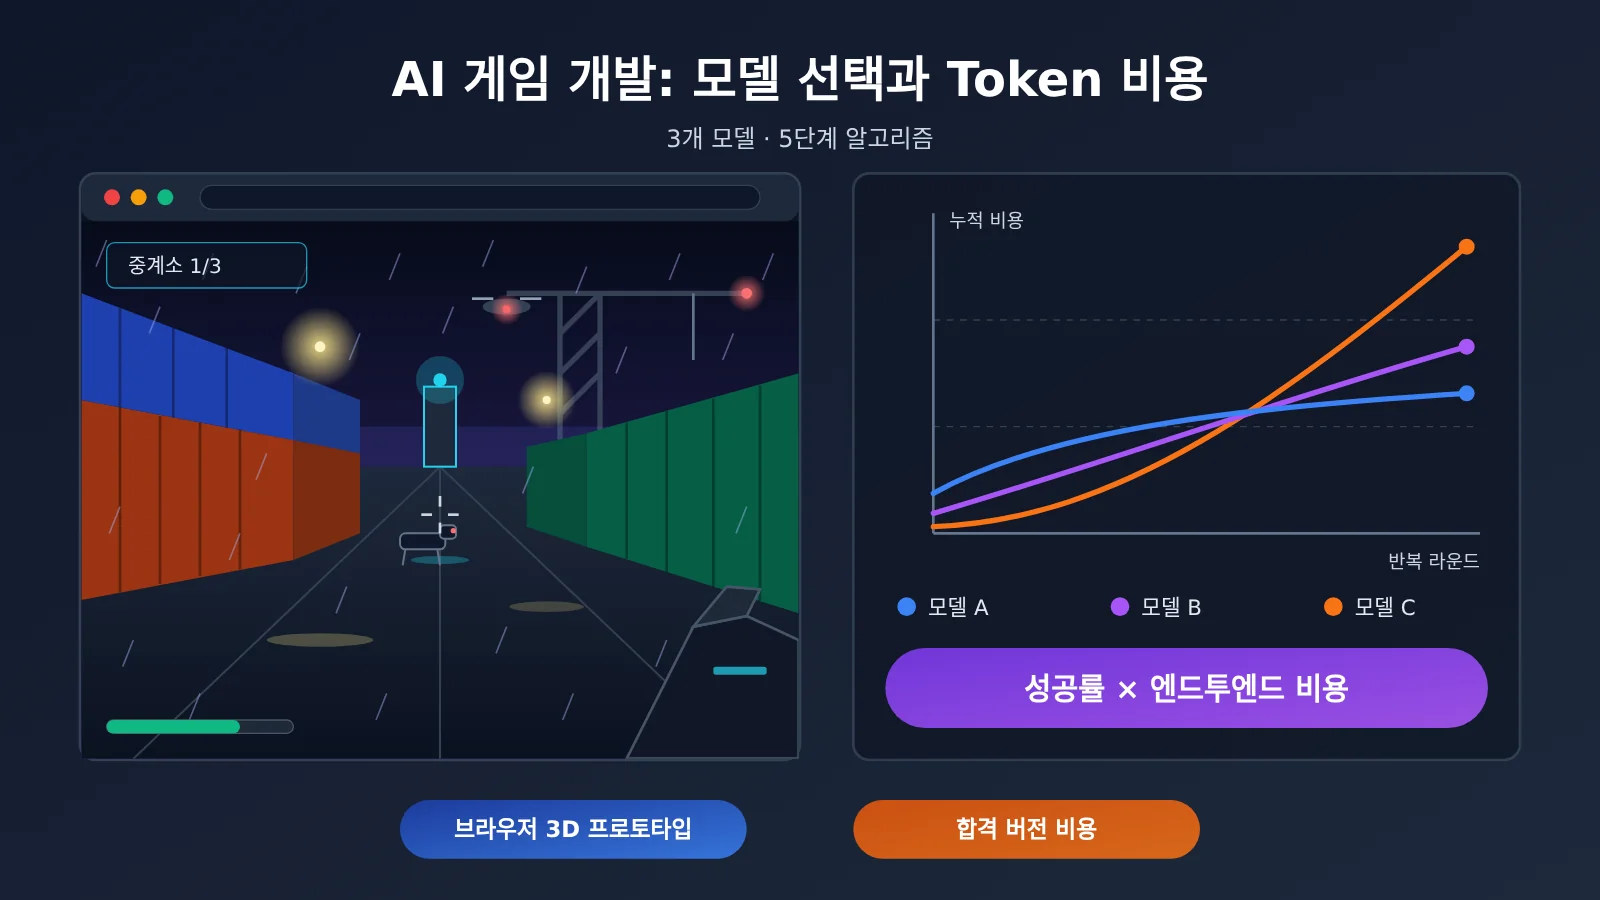
결론부터: AI가 게임 한 편을 독립적으로 개발하게 할 때, 결국 비교해야 하는 것은 납품 가능한 버전을 완성하는 엔드투엔드 비용이지, 백만 Token당 표시 가격이 아니에요. Saltline 사례에서 Claude Fable 5.2는 약 8시간, 약 4억 4500만 입력 Token, 약 270만 출력 Token으로 브라우저에서 실행되는 3D 슈팅 프로토타입을 생성했어요. 개발자가 API 가격으로 추산한 비용은 약 550달러였고, 입력의 대부분은 캐시를 거쳤어요. 2026년 11월 16일 기준으로 세 모델의 표준 API 단가는 최대 약 5배 차이가 나지만, 단가가 낮은 모델이 더 많은 라운드를 필요로 하면 총비용은 오히려 더 높을 수 있어요. 따라서 신뢰할 수 있는 선택 방법은 같은 게임 작업을 후보 모델에 맡기고 여러 번 실행해 성공률, Token, 소요 시간, 수동 수정 작업량을 집계한 뒤 “합격 버전당 비용”을 계산하는 거예요.
내용 미리보기: 1절에서는 Saltline으로 AI 게임 개발 실험 한 번의 Token 청구 구조를 분석해요. 2절에서는 세 모델의 공식 가격을 비교하고, 캐시가 총비용에 미치는 영향을 설명해요. 3절에서는 SWE-bench Verified, Aider Polyglot, NIST 과거 평가가 각각 무엇을 보여줄 수 있는지 소개해요. 4절에서는 재현 가능한 게임 개발 전용 평가 방안과 코드를 제공해요. 5절에서는 결과를 모델 선택 전략으로 바꿔볼게요.
To Know: AI 게임 개발 모델 선정 용어
| 용어 | 설명 |
|---|---|
| 입력 토큰 | 모델에 처리하도록 제출한 내용의 측정 단위로, 프롬프트, 코드 파일, 도구 반환 결과 등을 포함해요 |
| 출력 토큰 | 모델이 생성한 내용의 측정 단위로, 코드, 설명 텍스트, 도구 호출 파라미터 등을 포함해요 |
| 캐시 읽기 | 캐시된 컨텍스트를 재사용하는 방식으로, 일반 입력보다 과금이 훨씬 낮아요 |
| 캐시 쓰기 | 컨텍스트를 처음 캐시에 저장할 때 드는 비용으로, 보통 일반 입력보다 약간 높아요 |
| SWE-bench Verified | 사람이 검수한 실제 오픈소스 프로젝트의 소프트웨어 엔지니어링 작업 500개를 포함한 벤치마크예요 |
| Aider Polyglot | 6개 프로그래밍 언어, 225개 연습 문제를 아우르는 코드 수정 평가예요 |
| 하네스(Harness) | 모델, 도구, 작업 루프를 묶어 실행하는 프레임워크로, 예를 들어 Agent 스캐폴드가 있어요 |
| 작업 성공률 | 사전에 정의한 인수 기준을 충족해 작업을 완료한 비율이에요 |
| 엔드투엔드 비용 | 전체 작업을 완료하는 데 드는 모델 호출, 도구 실행, 인건비의 합계예요 |
| 수동 수정 | 생성 결과가 인수 기준에 도달하도록 사람이 직접 수정하는 작업이에요 |
| 절차적 생성 | 소재 파일을 가져오는 대신 코드와 수학 함수로 기하, 텍스처, 사운드를 생성하는 방식이에요 |
| 셰이더 | GPU에서 실행되어 색상, 조명, 재질 등 시각 효과를 계산하는 프로그램이에요 |
1 AI가 게임을 독립 개발한 비용 사례: Saltline은 토큰을 얼마나 썼을까
1.1 Saltline은 어떤 규모의 게임인가
2026년 11월 9일, Anthropic 엔지니어 Felix Rieseberg가 Claude Fable 5.2 프로그래밍 실험을 공개했어요. 그는 모델에 프롬프트 하나만 주고, 시각적 효과가 최대한 AAA 게임에 가까운 소규모 1인칭 슈팅 게임을 만들어 달라고 요청했으며, 전 과정에서 사람의 피드백을 전혀 제공하지 않았어요. 결과물이 Saltline이에요. 브라우저에서 바로 실행되는 3D 슈팅 게임으로, 배경은 비 오는 밤의 컨테이너 항구예요. 플레이어는 세 개의 신호 중계소를 닫고 탈출해야 하고, 적으로는 공중 순찰 드론과 지상의 기계 사냥개가 등장해요.
규모로 보면 Saltline은 1인 플레이, 단일 레벨로 구성된 플레이 가능한 프로토타입이에요. 여기서 “3A”는 실험 목표와 시각적 비유로 쓰인 표현이며, 화면 스타일을 설명하기 위한 것이에요. 상용 3A 제품과의 체급 차이는 아주 커요. 중국에서 퍼진 “几猫·国产3A大作”는 Saltline의 중국어 버전 또는 재포장 버전이며, 이름은 유통 과정에서 붙은 것으로 개발 주체를 뜻하지 않아요.
1.2 개발자가 밝힌 시간, 토큰, 비용
아래 데이터는 모두 개발자 본인이 X에 올린 내용에서 나온 자체 추정치이며, 제3자 감사를 받지 않았어요.
- 개발 시간: 약 8시간
- 입력 토큰: 약 4억 4,500만. 상당 부분은 캐시를 사용했어요.
- 출력 토큰: 약 270만
- API 가격 기준 추정 비용: 약 550달러
- 개발 방식: 단일 프롬프트, 사람의 피드백 없는 반복
이 비용은 일회성 생성 비용이에요. 게임 파일이 생성된 뒤에는 플레이어 브라우저에서 로컬로 실행되며, 플레이 중에는 Claude API를 호출하지 않아요. 따라서 550달러를 “플레이어 1인당 AI 비용”으로 나눠 계산할 수는 없어요.
1.3 공식 단가로 이 비용을 뜯어보기
Claude Fable 5.2 공식 표준 가격 기준(출력 백만 토큰당 $40)으로 보면, 270만 출력 토큰은 약 108달러예요. 나머지 약 440달러는 입력 쪽에 해당하며, 여기에는 캐시 쓰기, 캐시 읽기, 일반 입력이 포함돼요. 개발자가 세 가지 각각의 수량을 공개하지 않아서 더 세분화할 수 없어요.
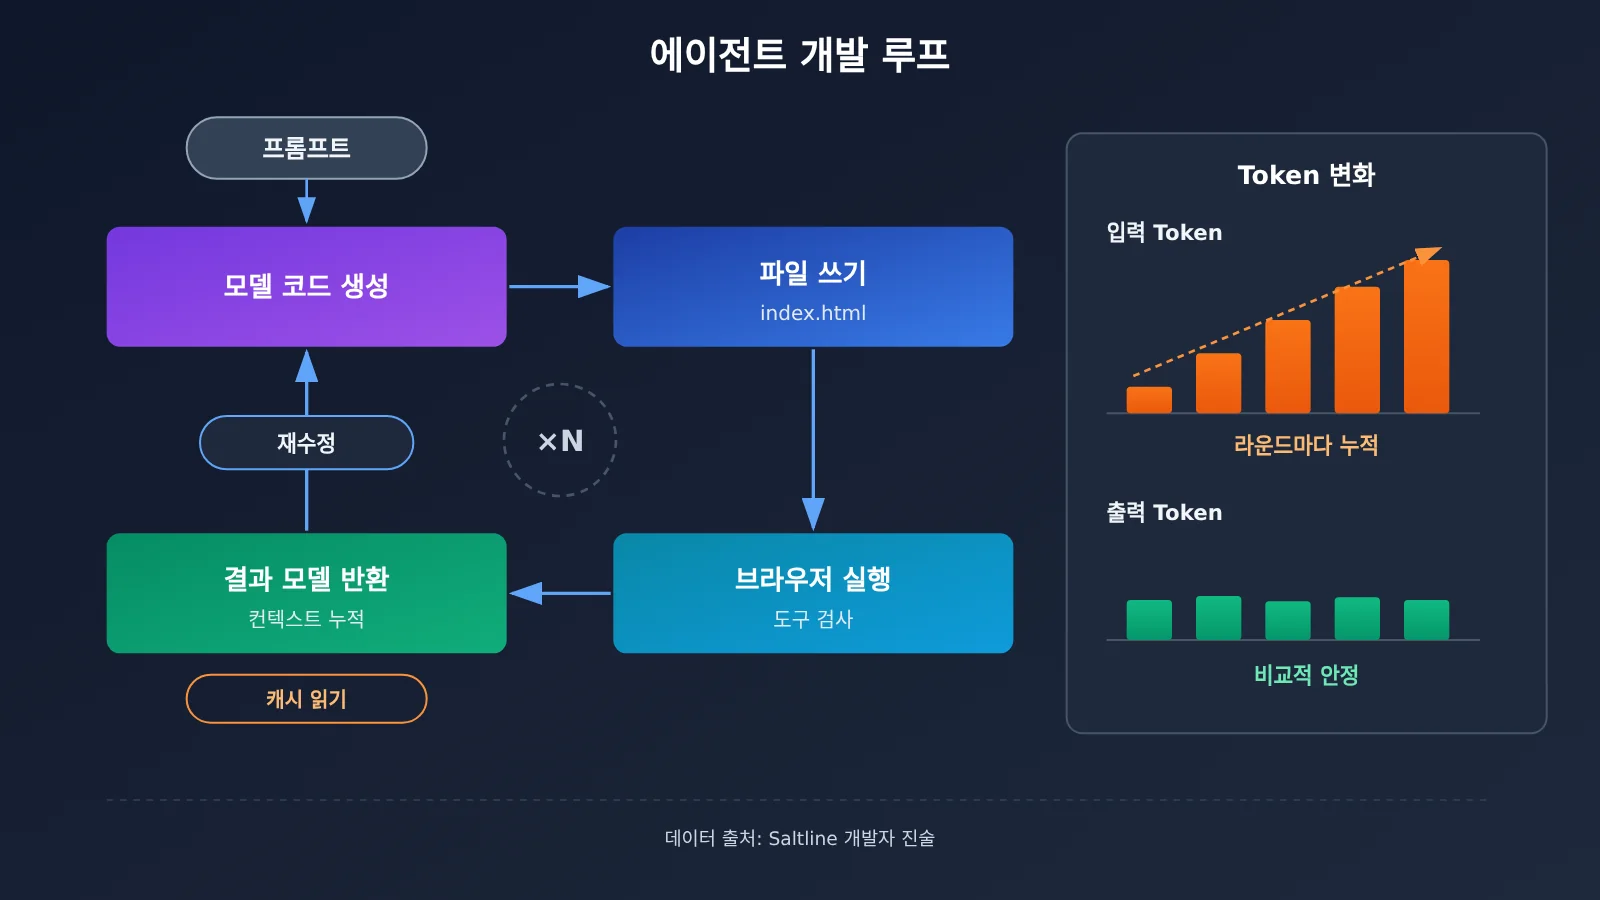
두 경계값과 비교해 보면 캐시의 효과가 분명해져요. 4억 4,500만 입력이 전부 일반 입력 가격인 $8로 과금된다면 약 3,560달러이고, 전부 캐시 읽기 가격인 $0.20로 과금된다면 약 89달러예요. 실제 추정치는 두 값 사이에 있고, 하한 쪽에 분명히 가까워요. 이는 장시간 실행되는 에이전트 개발 작업에서 입력 쪽 캐시 적중률이 청구서 규모를 결정하고, 출력 단가의 영향은 상대적으로 작다는 뜻이에요.
1.4 1.4MB 파일이 4억 4,500만 토큰을 소비한 이유
Saltline의 독립 HTML 버전은 약 1.43MB(1,425,707바이트)예요. 개발자에 따르면 게임 속 3D 모델과 텍스처는 모두 코드이고, 기하 구조는 프로그램으로 구성하며, 표면 질감은 셰이더로 계산하고, 소리도 프로그램으로 생성해요. 별도의 이미지나 3D 모델 에셋은 없어요.
결과물은 작지만 과정은 길어요. 에이전트는 8시간 동안 계속 커지는 코드 파일을 반복해서 읽고, 도구를 실행하고, 결과를 확인한 뒤 다시 수정했어요. 매 라운드마다 방대한 컨텍스트를 다시 모델에 넣었죠. 결국 토큰 소비는 주로 이런 순환에서 발생하며, 최종 파일 길이에서 나오는 것이 아니에요. 그래서 게임 개발 모델을 평가할 때 ‘과정 비용’을 반드시 측정해야 해요.
2 게임 개발 모델 가격 비교: 세 API의 토큰 과금 차이
2.1 세 모델의 공식 표준 가격
아래 표의 가격은 모두 각 사 공식 페이지에서 가져온 것이며, 2026년 11월 16일 기준입니다. 단위는 미국 달러/백만 토큰이고, 과금 기준은 표준 API 가격으로 다른 채널 할인 및 지역 추가 요금은 포함하지 않습니다.
| 모델 | 일반 입력 | 출력 | 캐시 읽기 | 비고 |
|---|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 | 5분 캐시 쓰기 $10, 1시간 캐시 쓰기 $16; 컨텍스트 1M, 최대 출력 128K |
| GPT-6 Astra | $10 | $50 | $1 | 표준 처리 등급; 다른 속도, 배치 처리, 지역 옵션 가격은 다를 수 있음 |
| Gemini 4 Argon | $2 | $10 | $0.10 | 이 가격은 2026년 11월 30일까지 적용; 12월 1일부터 입력 $4, 출력 $20으로 조정 예정 |
Claude Fable 5.2에는 Fast Mode가 따로 있는데, 입력 $16, 출력 $80이고 공식 설명에 따르면 출력 속도를 최대 2.5배까지 높일 수 있다고 해요. 정해진 시간 안에 끝내야 하는 긴 작업에서는 속도 등급이 소요 시간과 비용을 동시에 바꾸기 때문에, 평가할 때는 독립적인 설정으로 기록해야 합니다.
💡 비교 제안: 세 모델의 인터페이스와 과금 필드는 각각 달라서, 직접 평가 환경을 구축할 때는 각각 연동해야 해요. APIYI apiyi.com은 OpenAI 호환 통합 인터페이스를 제공하며, 하나의 API 키로 Claude, GPT, Gemini 등의 모델을 호출할 수 있어 같은 평가 스크립트 안에서 모델을 전환하기 편합니다. 구체적으로 사용 가능한 모델과 가격은 플랫폼 목록을 기준으로 하세요.
2.2 동일한 토큰 양에서의 정가 차이
단가 차이를 직관적으로 느끼기 위해 Saltline의 출력량(270만 토큰)을 세 모델 가격에 대입해 볼 수 있어요. Claude Fable 5.2는 약 108달러, GPT-6 Astra는 약 135달러, Gemini 4 Argon은 약 27달러입니다. 4억 4500만 입력이 모두 캐시 읽기로 처리된다면 세 모델은 각각 약 89달러, 445달러, 45달러가 됩니다.
이 숫자들은 과금 구조만 보여줄 뿐이고, 전제는 세 모델이 완전히 동일한 토큰을 소비한다는 것입니다. 그런데 실제 상황에서는 이 전제가 거의 성립하지 않아요. 모델마다 같은 작업을 완료하는 데 필요한 라운드 수, 매 라운드 읽는 컨텍스트, 생성하는 코드 길이가 다르고, 실패 후 재실행하면 비용이 몇 배로 커지기도 합니다.
2.3 캐시 가격은 입력 가격보다 더 주목할 만해요
Agent 방식 개발에서는 대부분의 입력이 반복되는 컨텍스트입니다. GPT-6 Astra의 캐시 읽기 가격은 일반 입력의 1/10, Claude Fable 5.2는 1/40, Gemini 4 Argon은 1/20입니다. 캐시 읽기 가격과 일반 입력 가격의 비율이 낮을수록 긴 작업의 입력 비용을 더 쉽게 줄일 수 있어요.
캐시에는 쓰기 비용과 유효 기간도 있습니다. Claude의 5분 캐시와 1시간 캐시는 쓰기 가격이 다르고, Agent의 두 호출 간격이 캐시 유효 기간을 넘으면 다시 써야 해요. 긴 작업 비용을 추정할 때는 캐시 쓰기 횟수, 적중률, 유효 기간을 함께 계산에 넣어야 합니다.
3 프로그래밍 벤치마크가 말해주는 것: 게임 개발 모델의 역량 참고 기준
3.1 SWE-bench Verified: 실제 저장소의 소프트웨어 엔지니어링 작업
SWE-bench Verified에는 실제 오픈소스 프로젝트에서 가져와 사람이 선별하고 검증한 500개의 문제가 담겨 있어요. 모델은 저장소 컨텍스트를 이해한 뒤 버그 수정, 기존 코드 변경, 테스트 실패 해결, 파일 간 수정 같은 작업을 수행해야 하는데, 단순한 코드 자동 완성보다는 실제 엔지니어링에 훨씬 가까운 과제예요.
이 벤치마크를 볼 때는 Harness의 영향을 염두에 두어야 해요. 공식 설명에 따르면 전체 리더보드는 서로 다른 Agent 시스템이 섞여 있기 때문에, 순수 모델 비교에는 통일된 mini-SWE-agent 설정을 사용해야 해요. Agent 구성, 도구, 프롬프트, 버전이 모두 점수를 바꾸기 때문에 설정이 다른 결과는 따로 봐야 하죠.
3.2 Aider Polyglot: 정확도와 비용을 함께 기록
Aider Polyglot은 C++, Go, Java, JavaScript, Python, Rust를 아우르는 225개의 프로그래밍 연습 문제를 사용하고, 테스트 케이스로 모델이 코드를 올바르게 수정했는지 판정해요. 공개 결과에는 정확도뿐 아니라 토큰 소비량, 실행 비용, 오류 출력, 형식 오류, 태스크별 실행 시간까지 기록돼요.
모델 선정 관점에서 이런 “정확도 + 비용” 기록 방식은 상당히 유용해요. 이 글 뒤에서 다룰 평가 프레임워크와도 같은 접근이죠. 다만 문제 자체는 독립된 연습문제라서 규모와 형태 면에서 완전한 3D 게임 프로젝트와는 차이가 커요.
3.3 NIST 과거 평가: 모델 버전과 시점을 주의하세요
미국 국립표준기술연구소(NIST) 산하 CAISI가 2025년에 발표한 모델 평가 보고서에서는 여러 모델의 SWE-bench Verified 점수를 테스트했어요. 아래 데이터는 모두 해당 보고서에 담긴 과거 모델과 실험 설정 기준이며, 2026년 11월 최신 모델의 순위를 뜻하지 않아요.
| 모델(2025년 보고서 테스트 버전) | SWE-bench Verified 점수 |
|---|---|
| Anthropic Opus 4 | 66.7% |
| GPT-5 | 63.0% |
| DeepSeek V3.1 | 54.8% |
| DeepSeek R1-0528 | 44.6% |
| gpt-oss | 42.6% |
| DeepSeek R1 | 25.4% |
보고서는 표준 오차도 함께 제시했는데, 같은 벤치마크의 점수 자체에도 통계적 변동이 있다는 뜻이에요. 몇 퍼센트포인트 차이는 오차 범위 안에 들어가면 실질적인 구분이 되지 않을 수 있죠. 이 글에서 비교하는 Claude Fable 5.2, GPT-6 Astra, Gemini 4 Argon은 모두 이 보고서에 등장하지 않기 때문에, 모델을 고를 때는 현재 버전을 대상으로 설정까지 명시한 최신 평가를 찾아보거나 직접 측정해야 해요.
3.4 일반 프로그래밍 역량과 게임 개발 역량의 격차
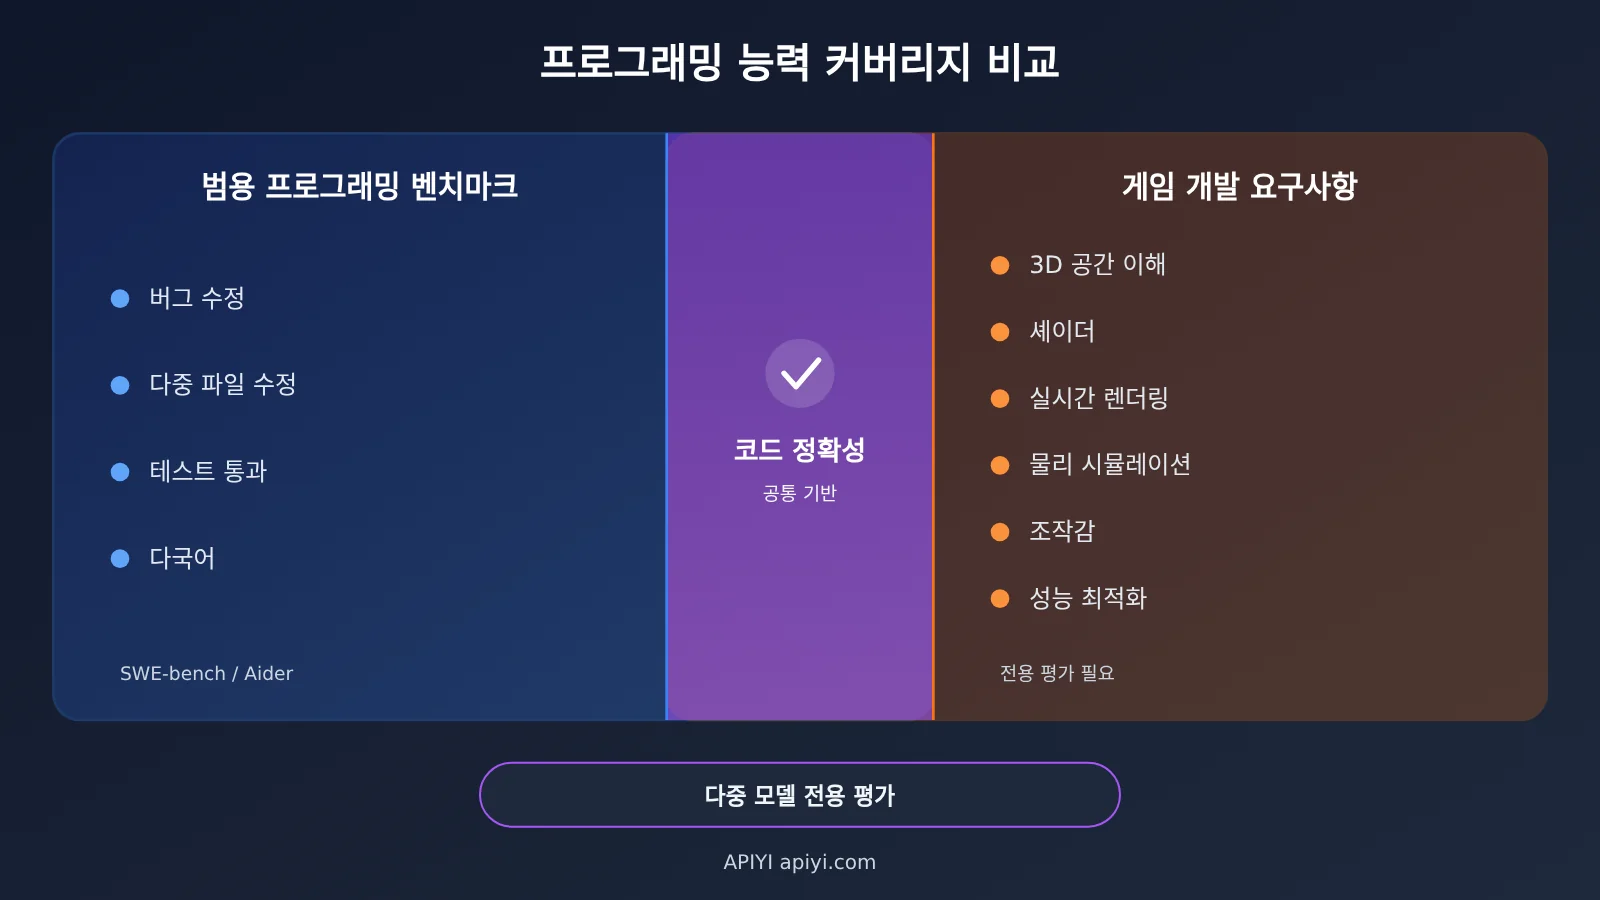
게임 개발에는 범용 소프트웨어 엔지니어링 벤치마크가 충분히 다루지 못하는 작업이 많아요. 3D 공간 이해, Shader 작성, 실시간 렌더링, 애니메이션 시스템, 물리 시뮬레이션, 인터랙션 감각, 실행 성능 최적화가 그렇죠. Saltline 같은 프로젝트는 모델이 코드로 시각적 에셋을 생성해야 하기 때문에 그래픽스와 시각 효과에 대한 이해가 필요해요.
어떤 모델이 Python 저장소의 버그 수정에는 아주 능숙하지만, 복잡한 WebGL 장면에서는 평범한 성적을 낼 수도 있어요. SWE-bench와 Aider는 코드 역량이 확실히 부족한 후보를 걸러내는 용도로 적합하고, 최종 순위는 게임 개발 전용 평가로 정해야 해요.
4 AI 게임 개발 모델을 비교하는 방법: 동일 과제 기반 특화 평가 방안
4.1 통일된 브라우저 3D 게임 과제 설계
Saltline의 형태를 참고하면, 과제를 다음과 같이 정의할 수 있습니다. 바로 하나의 프롬프트에서 브라우저에서 실행 가능한 3D 게임 프로토타입을 생성하는 것이죠. 모든 후보 모델에는 완전히 동일한 요구사항을 적용합니다.
- 브라우저에서 바로 열어 실행할 수 있는 완전한 프로젝트 생성
- 조작 가능한 캐릭터와 3D 환경 포함
- 충돌 또는 기본 물리 포함
- 명확한 과제 목표와 승패 조건 포함
- 평가 과정에서 핵심 코드를 인위적으로 수정하는 것 금지
과제 난이도는 실제 요구에 가깝게 설정해야 합니다. 캐주얼 미니게임을 만드는 팀이 FPS 프로토타입으로 테스트하면 필요한 모델 등급을 과대평가하게 되고, 복잡한 3D 프로젝트를 만드는 팀이 간단한 2D 과제로 테스트하면 오히려 과소평가하게 됩니다.
4.2 열 가지 평가 지표
| 차원 | 평가 내용 | 권장 기록 방식 |
|---|---|---|
| 기능 완성도 | 핵심 게임 기능이 구현되었는지 | 기능 목록별 항목 체크 |
| 시각적 품질 | 장면, 재질, 조명, 애니메이션 | 여러 명이 블라인드 평가로 점수 매기기 |
| 실행 가능성 | 정상적으로 시작되는지 | 예 / 아니오 |
| 상호작용 완성도 | 입력과 피드백이 정상인지 | 조작 목록별 항목 테스트 |
| 안정성 | 뚜렷한 크래시가 있는지 | 정해진 시간 동안 플레이하며 크래시 횟수 기록 |
| 성능 | FPS, 시작 시간, 메모리 | 고정 기기에서 실측 |
| 코드 품질 | 가독성, 모듈화, 오류 처리 | 코드 리뷰 점수 |
| Token 비용 | 입력, 출력, 캐시 | API usage 필드에서 누적 |
| 총 소요 시간 | 시작부터 실행 가능 버전까지 | 시간 측정 |
| 수동 수정 | 기준 달성에 필요한 수동 개입 | 수동 작업 시간 기록 |
이 가운데 “실행 가능성”, “기능 완성도”, “상호작용 완성도”는 필수 검수 조건으로 삼아 한 번의 실행이 성공인지 판정하는 데 쓰고, 시각적 품질, 성능, 코드 품질은 성공한 결과들 사이의 순위를 매기는 데 써요.
4.3 테스트 환경 제어하기
평가 결과를 비교할 수 있는지는 변수가 얼마나 잘 통제되었는지에 달려 있어요. 통일해야 할 조건에는 동일한 브라우저, 동일한 기기, 동일한 프롬프트, 동일한 테스트 절차, 동일한 시간 한도, 그리고 네트워크 연결 허용 여부가 포함돼요. 모델이 스스로 도구를 호출하거나 자료를 검색하거나 파일을 생성하도록 허용한다면, 모든 모델의 도구 권한도 똑같아야 해요.
하네스(Harness) 역시 고정해야 해요. 같은 모델이라도 Agent 프레임워크를 바꾸면 성공률과 Token 소모가 크게 달라질 수 있으니, 평가 보고서에는 사용한 프레임워크, 버전, 파라미터를 명시해야 해요. 예를 들어 temperature, 최대 출력 길이, 속도 단계 같은 것들이요.
4.4 모든 모델을 최소 여러 번 실행하기
대규모 언어 모델의 생성에는 무작위성이 있어요. 한 번 성공한 건 운이 좋았을 수도 있고, 한 번 실패한 것도 우연일 수 있죠. 각 모델은 동일한 조건에서 여러 번(예: 5~10회) 실행해서 성공률과 함께 성공한 샘플의 평균 토큰, 소요 시간, 품질 점수를 집계해야 해요. Saltline 자체도 단일 실험이기 때문에, 이 작업이 가능하다는 점은 보여주지만 해당 모델이 같은 유형의 작업에서 얼마나 성공하는지는 알려주지 못해요.
아래 스크립트는 OpenAI 호환 인터페이스로 모델을 호출하고, usage 필드를 바탕으로 2절의 가격에 따라 호출 1회 비용을 계산해요:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, 모델 전환 시 model만 바꾸면 됩니다
)

# 단위: 미국 달러 / 백만 토큰, 2026-11-16 기준 공식 표준가
PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

def call_and_price(model: str, messages: list) -> tuple[str, float]:
    resp = client.chat.completions.create(model=model, messages=messages)
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + u.completion_tokens * p["output"]) / 1_000_000
    return resp.choices[0].message.content, cost
모델 이름은 실제 호출 플랫폼의 모델 목록을 기준으로 확인하세요. 캐시 쓰기 비용이나 속도 등급附加费(할증료)는 각 사업자의 규칙에 따라 따로 계산에 더해야 해요.
다중 라운드 평가 및 비용 집계 스크립트 보기
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI를 통해 여러 후보 모델 호출
)

PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

TASK_PROMPT = "生成一个可在浏览器运行的单文件 3D 游戏原型……(所有模型使用同一提示词)"

def price(model, usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    return ((usage.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + usage.completion_tokens * p["output"]) / 1_000_000

def run_once(model, max_rounds=30):
    """간소화된 Agent 루프: 생성 → 검사 → 결과 반환 → 수정"""
    messages = [{"role": "user", "content": TASK_PROMPT}]
    total_cost, start = 0.0, time.time()
    for _ in range(max_rounds):
        resp = client.chat.completions.create(model=model, messages=messages)
        total_cost += price(model, resp.usage)
        code = resp.choices[0].message.content
        report = check_game(code)  # 직접 구현: 파일 쓰기, 헤드리스 브라우저 실행, 기능 체크리스트 실행
        if report["passed"]:
            return True, total_cost, time.time() - start
        messages += [{"role": "assistant", "content": code},
                     {"role": "user", "content": f"检查结果:{report['log']},请修复"}]
    return False, total_cost, time.time() - start

def evaluate(model, trials=5, human_fix_cost=0.0):
    results = [run_once(model) for _ in range(trials)]
    successes = sum(r[0] for r in results)
    api_cost = sum(r[1] for r in results)
    rate = successes / trials
    per_success = (api_cost + human_fix_cost) / successes if successes else float("inf")
    print(f"{model}: 成功率 {rate:.0%},API 总费用 ${api_cost:.2f},"
          f"每个合格版本成本 ${per_success:.2f}")

for m in PRICES:
    evaluate(m)
🚀 빠른 시작: 이런 종류의 평가를 구축할 때는 먼저 작은 작업으로 스크립트를 정상 동작시킨 뒤, 전체 게임 작업으로 바꾸는 것을 권장해요. APIYI apiyi.com은 신규 사용자에게 무료 테스트 크레딧을 제공하니, 이를 활용해 Harness와 과금 집계 로직을 먼저 검증한 다음 본격적인 평가 예산을 투입하세요.
5 AI로 게임을 개발할 때 모델 선택법: 복잡한 작업의 Token 비용 제어
5.1 성공률이 총비용을 좌우해요
전체 개발 비용은 세 부분으로 구성돼요:
작업 총비용 = 모델 호출 비용 + 도구 실행 비용 + 수동 수정 비용
성공률까지 고려하면 더 실용적인 비교 지표는 ‘합격 버전당 비용’이에요. 모든 시도의 총비용을 성공 횟수로 나눈 값이죠. 예를 들어 모델 A는 시도 1회당 100달러, 성공률 80%라서 합격 버전 하나당 약 125달러예요. 모델 B는 시도 1회당 30달러, 성공률 20%라서 합격 버전 하나당 약 150달러이고, 여기에 실패한 버전을 살펴보는 시간까지 더해야 해요. 이 사례에서는 단가가 낮은 모델이 오히려 더 비싼 셈이죠.
수동 수정은 대개 가장 큰 비중을 차지해요. 엔지니어 한 명이 몇 시간을 들여 생성 결과를 고치면, 인건비가 API 비용 전체를 넘어설 수도 있죠. 그래서 평가할 때는 사람이 개입한 시간을 사실대로 기록하고, 팀의 실제 인건비 단가로 환산해 총비용에 포함해야 해요.
5.2 세 가지 모델 선택 전략
| 전략 | 적용 시나리오 | 장점 | 주의해야 할 비용 |
|---|---|---|---|
| 고성능 모델 | 복잡한 아키텍처, 긴 컨텍스트 개발, 다중 모듈 협업, 복잡한 버그 위치 파악 | 성공률이 높아 재실행과 수동 수정을 줄임 | 단가가 높으므로 캐시를 활용해 입력 비용을 제어해야 함 |
| 저비용 모델 | 단순 기능, 코드 설명, 반복적인 수정, 테스트 보조 | 단가가 낮아 빈번한 호출에 적합 | 복잡한 작업은 여러 차례 실패할 수 있어 총비용이 오히려 증가함 |
| 다중 모델 협업 | 한 모델은 아키텍처, 한 모델은 구현, 독립 모델은 코드 리뷰 담당 | 단계별로 성능과 가격을 매칭 | 모델 간 인계 시 컨텍스트를 반복 전송해 토큰과 조율 비용이 증가함 |
다중 모델 협업의 비용 절감 효과는 인계 비용에 달려 있어요. 인계할 때마다 프로젝트 컨텍스트를 다른 모델에 다시 전달해야 하고, 서로 다른 모델 간에는 캐시를 공유할 수 없거든요. 저비용 모델이 담당하는 단계가 충분히 많고 인계 횟수가 충분히 적을 때에만 협업 방식이 경제성이 있어요. 이 역시 실제 측정으로 확인해야 해요.
💰 비용 제안: 다중 모델 협업은 한 프로젝트에서 여러 모델을 동시에 호출해야 해요. APIYI apiyi.com을 통해 동일한 Key와 동일한 코드 세트로 접속하면 다중 계정 관리와 인터페이스 적응 작업을 줄일 수 있고, 아키텍처·구현·리뷰를 서로 다른 모델에 할당한 뒤 비용을 통합 집계하기도 쉬워요.
5.3 실행 가능한 5단계 모델 선정 프로세스
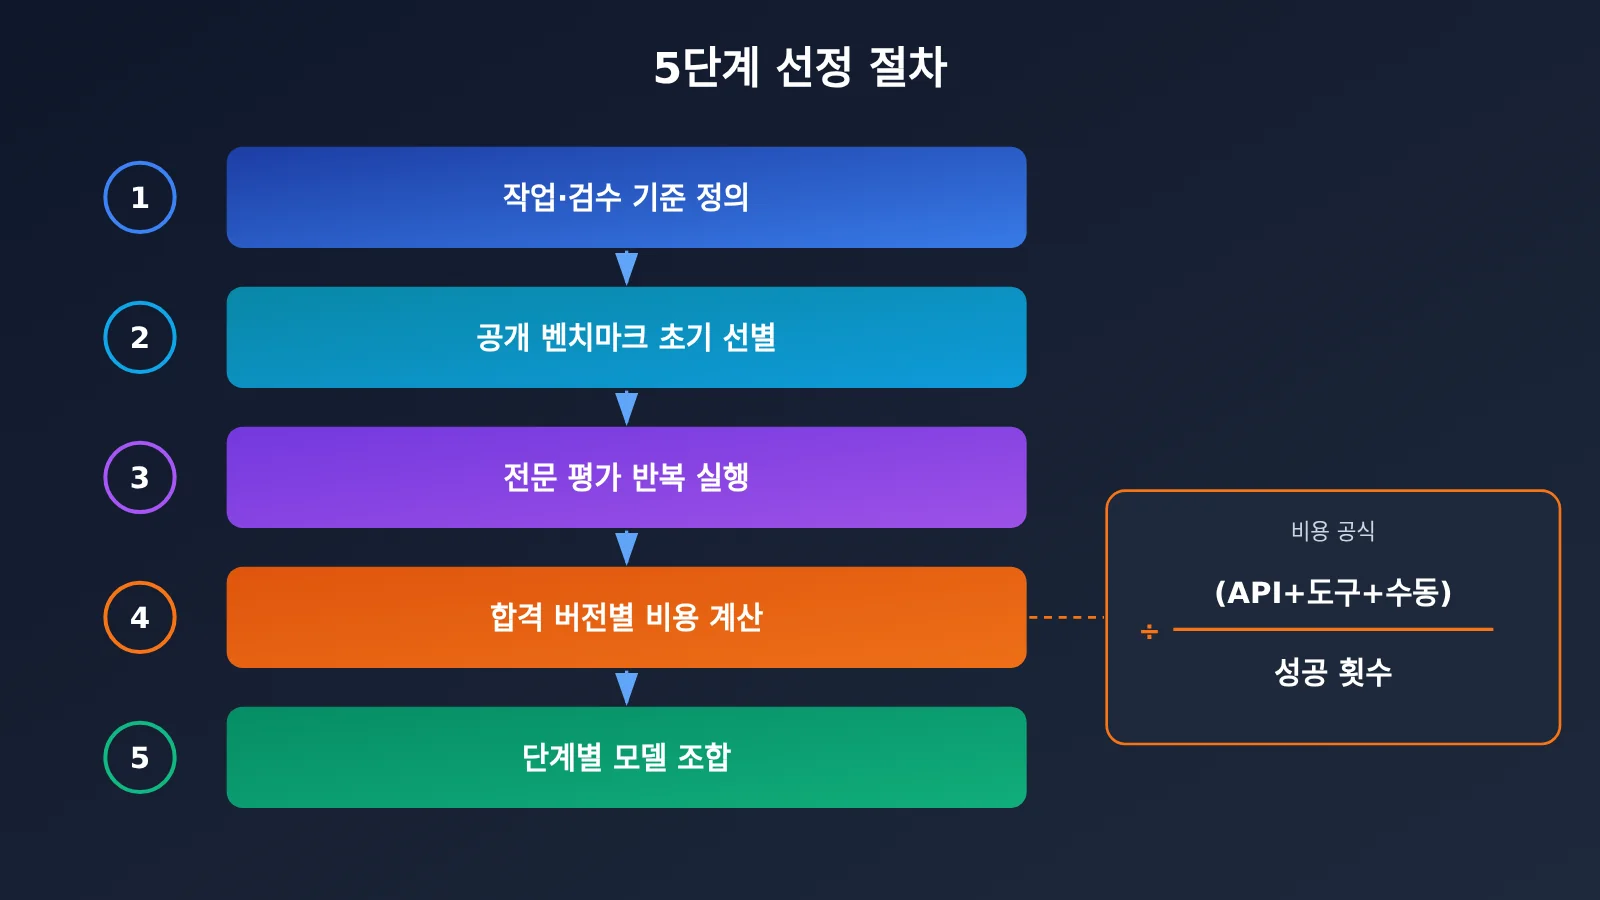
- 작업과 수용 기준 정의하기: 기능 목록, 대상 플랫폼, 성능 하한선을 명확히 적어 두고, 이를 성공 판정의 근거로 삼아요.
- 공개 벤치마크로 1차 필터링하기: 현재 버전과 구성이 명확한 SWE-bench Verified, Aider Polyglot 점수를 참고해서 코드 능력이 확연히 부족한 모델은 걸러내요.
- 전용 평가 실행하기: 동일한 환경에서 후보 모델마다 같은 게임 작업을 5~10회 실행하고, 4.2절의 열 가지 지표를 기록해요.
- 합격 버전별 비용 계산하기: API 비용에 도구 비용과 수동 수정 비용을 더한 뒤, 성공 횟수로 나눠요.
- 단계별로 모델 조합하기: 복잡한 단계는 성공률이 높은 모델에, 반복적인 단계는 저비용 모델에 맡기고, 그 조합안이 실제로 더 절약되는지 직접 측정해 봐요.
가격은 변동돼요. 예를 들어 Gemini 4 Argon은 12월 1일부터 적용되는 가격 조정 계획을 이미 공개했죠. 평가 결과에는 원본 토큰 데이터를 반드시 보관해야 하고, 가격이 바뀐 뒤에는 단가만 다시 대입하면 결론을 갱신할 수 있어요.
6 AI 게임 개발 모델 선택 관련 자주 묻는 질문 FAQ
Q1: Saltline의 550달러는 실제 청구서인가요?
감사를 거친 청구서는 아니에요. 550달러는 개발자 Felix Rieseberg가 API 가격을 기준으로 추정한 비용이며, 함께 공개된 데이터(약 8시간, 약 4억 4,500만 입력 Token, 약 270만 출력 Token) 역시 본인의 자체 보고에서 나온 것이에요. 입력에는 캐시가 대량으로 사용되었고, 캐시 쓰기와 읽기 비율은 구체적으로 공개되지 않았어요.
Q2: 단가가 가장 낮은 모델이 비용을 가장 아끼는 건가요?
성공률을 봐야 해요. 단가는 Token 한 개의 가격만 결정할 뿐이고, 모델이 작업을 완료하는 데 얼마나 많은 Token이 필요한지, 몇 번이나 다시 실행해야 하는지, 수동 수정이 얼마나 필요한지는 모두 모델의 능력이 결정해요. “총비용 ÷ 성공 횟수”로 비교해야 의미가 있어요.
Q3: SWE-bench 1위 모델이 게임 개발에 가장 적합한가요?
SWE-bench Verified는 실제 오픈소스 저장소에서의 소프트웨어 엔지니어링 능력을 측정하는 지표라서 Shader, 3D 공간 이해, 실시간 렌더링, 인터랙션 감각에 대한 평가 범위는 제한적이에요. 초기 스크리닝 용도로는 적합하지만, 게임 개발에서 최종 순위를 매기려면 특화 평가가 필요해요.
Q4: NIST 보고서의 점수가 지금 모델을 대표할 수 있나요?
그럴 수 없어요. NIST CAISI 보고서는 2025년에 발표되었고, GPT-5, Opus 4, DeepSeek V3.1 같은 과거 모델과 특정 실험 설정을 대상으로 테스트했어요. 2026년 11월의 신규 모델은 해당 버전에 맞는 새로운 평가를 찾아봐야 해요.
Q5: 여러 모델을 빠르게 비교 평가하려면 어떻게 해야 하나요?
OpenAI 호환 인터페이스를 지원하는 집계 플랫폼을 쓰는 게 가장 간편해요. APIYI apiyi.com에서 가입해 API 키를 발급받은 뒤, 이 글의 스크립트에서 base_url을 `https://api.apiyi.com/v1`로 설정하고 model 파라미터만 바꾸면 같은 스크립트에서 여러 모델을 테스트할 수 있어요. 새로 가입한 사용자는 먼저 무료 크레딧으로 스크립트를 검증해 볼 수 있어요.
Q6: 평가할 때 Token 비용은 어떻게 집계하는 게 가장 정확한가요?
API 응답의 usage 필드를 기준으로 삼아, 일반 입력, 캐시 읽기, 출력 Token을 호출마다 누적한 다음, 호출 당일의 공식 가격과 과금 구간에 따라 계산하는 게 가장 정확해요. 캐시 쓰기, 속도 구간 같은 부가 비용은 각 제공사의 규칙에 따라 별도로 더해야 해요. APIYI apiyi.com을 통해 호출할 때는 플랫폼 백오피스의 소비 기록과 대조해 집계 결과를 검증할 수도 있어요.
Q7: AI가 생성한 게임 프로토타입을 바로 출시할 수 있나요?
Saltline 같은 프로토타입은 모델이 수동 피드백 없이도 플레이 가능한 버전을 만들어낼 수 있다는 걸 보여줬어요. 하지만 실제 상용 출시에는 여러 브라우저 호환성, 모바일 대응, 성능 최적화, 장기 유지 관리까지 따라붙어요. 브라우저 게임은 로컬 하드웨어와 브라우저의 제약을 받으며, Saltline 페이지에서도 초기화가 느리고 버벅일 때는 낮은 화질로 전환해야 한다는 안내가 나와 있어요. 출시 전 테스트와 최적화 비용도 전체 개발 비용에 포함해서 계산해야 해요.
7 AI 게임 개발 모델 선택 핵심 요약
- 핵심 지표: 100만 토큰당 단가가 아니라, 적합한 각 버전의 엔드투엔드 비용을 비교하세요.
- Saltline 청구서: 약 550달러는 개발자가 직접 밝힌 추정치이며, 출력이 약 108달러를 차지하고 나머지는 입력 측에 있어요.
- 캐시가 규모를 좌우해요: 긴 작업에서는 입력이 대부분을 차지하므로 캐시 읽기 가격과 적중률이 가장 큰 영향을 미쳐요.
- 가격은 시점에 따라 달라져요: 이 글의 가격은 2026-11-16 기준이며, Gemini 4 Argon은 12월 1일부터 가격 조정이 예정되어 있어요.
- 벤치마크는 1차 선별에 활용해요: SWE-bench와 Aider는 범용 프로그래밍을 측정하므로, 게임 능력은 별도 전문 평가가 필요해요.
- 여러 번 실행하세요: 각 모델을 동일 조건에서 5~10회 실행하고, 단일 결과가 아니라 성공률로 결론을 내려요.
- 시작하는 방법: APIYI apiyi.com의 통합 인터페이스로 모델을 전환하면 같은 스크립트에서 비용을 비교하기 쉬워요.
8 정리: AI가 스스로 게임을 개발하도록 할 때의 모델 선택 방법
AI가 게임 하나를 독립적으로 개발하도록 할 때, 모델 선택의 핵심은 세 가지예요.
- 비용은 전체를 계산해야 해요: 작업 총비용에는 모델 호출, 도구 실행, 수동 수정이 포함되며, API 비용은 그중 하나일 뿐이에요.
- 능력은 실제로 측정해야 해요: 공개 벤치마크는 1차 선별에 쓰고, 게임 개발의 최종 순위는 동일 조건에서 여러 번 진행한 전문 평가로 정해요.
- 단계별로 조합하세요: 복잡한 단계에는 성공률 높은 모델을, 반복적인 단계에는 저비용 모델을 쓰되, 조합안 역시 실제 측정으로 검증해야 해요.
Saltline은 참고할 만한 규모를 제시했어요. 단일 프롬프트, 약 8시간, 약 550달러의 추정 비용으로 플레이 가능한 브라우저 3D 프로토타입을 만들어냈죠. 프로젝트에 얼마가 필요한지는 작업 복잡도와 선택한 모델의 성공률에 달려 있어요. 가장 신뢰할 수 있는 방법은 이 글의 프레임워크로 직접 한 차례 평가를 돌려보는 거예요.
APIYI apiyi.com을 통해 여러 모델 비교 환경을 빠르게 구축하는 것을 추천해요. 플랫폼은 OpenAI 호환 인터페이스와 신규 사용자 무료 크레딧을 제공해서, 같은 스크립트 안에서 가격과 성공률을 실제로 측정하기 편리해요.
참고 자료
- Saltline 독립 체험 페이지: 게임 체험 및 자주 묻는 질문 안내
- 링크:
saltline.games -
설명: 초기화, 화질 전환, 조작 방식 등 체험 정보 포함
-
Saltline 코드 미러 및 README: 개발자 데이터 출처 안내
- 링크:
github.com/realcodebear/saltline-fable-5.2 -
설명: 생성 시간, Token, 추정 비용의 출처 기록
-
几猫 중국어 버전 저장소: Saltline 중국어 래핑 버전 아카이브
- 링크:
github.com/Megasu/jimao-3a-game -
설명: index.html 파일 크기 등의 데이터 제공
-
Claude Fable 5.2 모델 사양 및 가격: Anthropic 공식 문서
- 링크:
platform.claude.com/docs/en/models/fable-5-2/overview -
설명: 입력, 출력, 캐시 및 Fast Mode 가격
-
GPT-6 Astra 모델 문서: OpenAI 공식 가격
- 링크:
developers.openai.com/api/docs/models/gpt-6-astra -
설명: 표준 처리 등급 가격은 이를 기준으로 해요
-
SWE-bench Verified: 소프트웨어 공학 벤치마크 공식 페이지
- 링크:
swebench.com/verified.html -
설명: 500개 수동 검증 작업 및 mini-SWE-agent 통합 구성 안내
-
Aider 리더보드: Aider Polyglot 평가 결과
- 링크:
aider.chat/docs/leaderboards -
설명: 정확도, Token 소비, 실행 비용을 동시에 기록
-
NIST CAISI 평가 보고서 (2025년): 역사 모델 독립 평가
- 링크:
nist.gov/system/files/documents/2025/09/30/CAISI_Evaluation_of_DeepSeek_AI_Models.pdf - 설명: SWE-bench Verified 역사 성적 및 표준 오차 포함
저자: APIYI 기술팀
기술 교류: APIYI apiyi.com 웹사이트 첫 페이지에서 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요.