摘要:选择游戏开发模型,应看同一任务的成功率、执行时间、API 费用与人工修复成本;价格表和通用代码基准只是辅助依据。
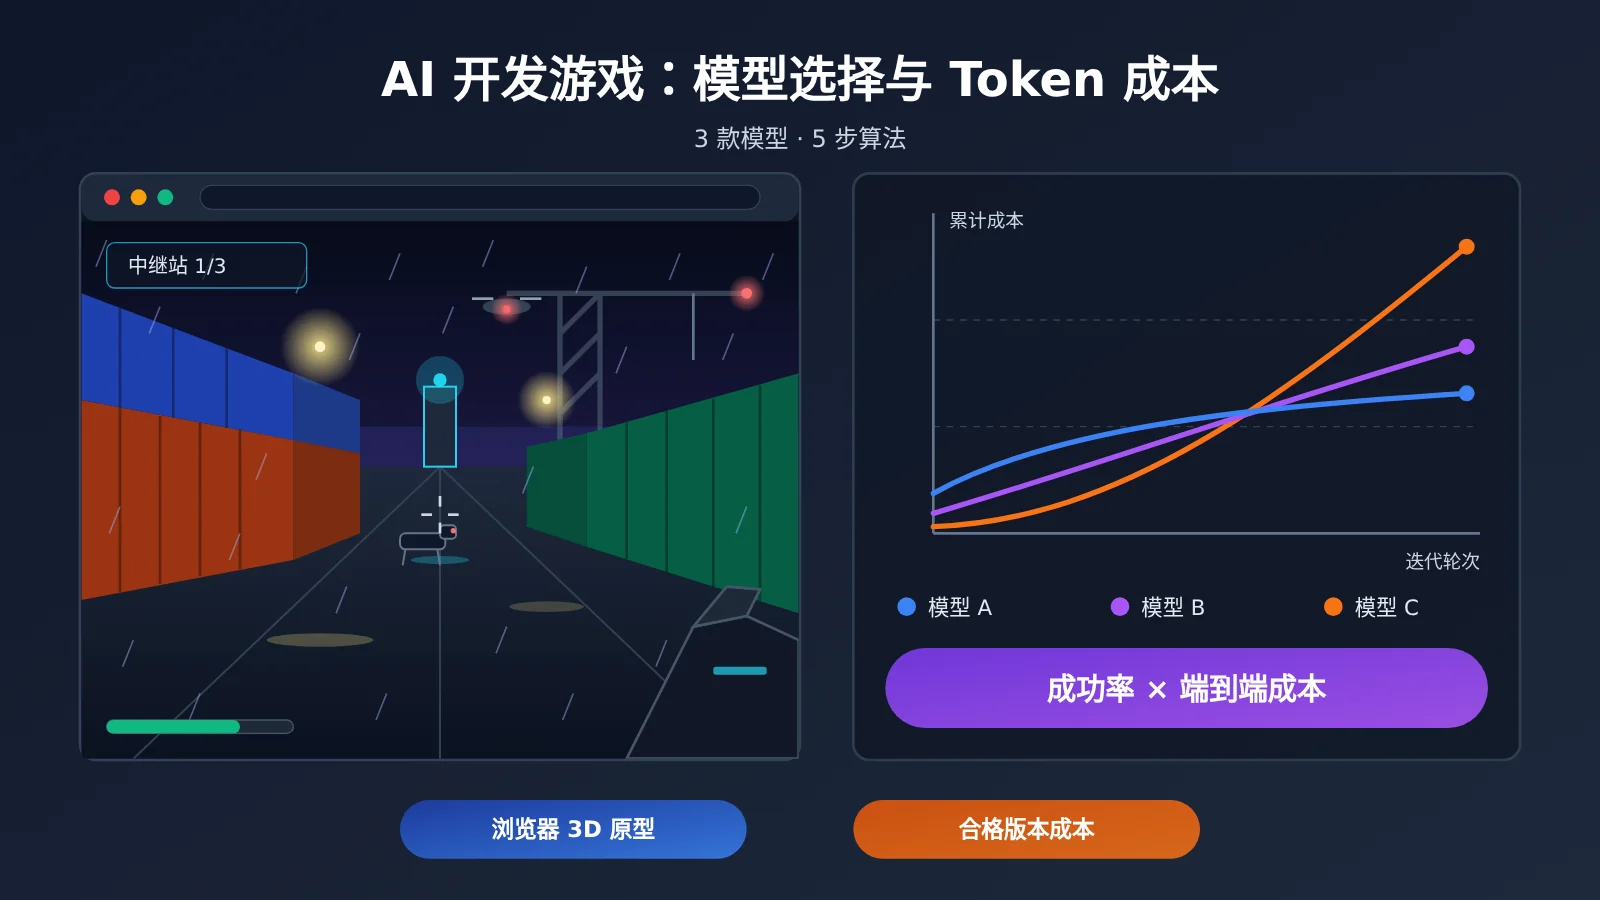
结论先行:让 AI 独立开发一款游戏时,最终要比较的是 完成一个可交付版本的端到端成本,而不是每百万 Token 的标价。Saltline 案例中,Claude Fable 5.2 用约 8 小时、约 4.45 亿输入 Token 和约 270 万输出 Token,生成了一个可在浏览器运行的 3D 射击原型。开发者按 API 定价估算的费用约为 550 美元,而且大部分输入走了缓存。截至 2026 年 11 月 16 日,三家模型的标准 API 单价最多相差约 5 倍,但单价低的模型需要更多轮次时,总成本可能更高。因此,可靠的选型方法是:把同一个游戏任务交给候选模型,多次运行,统计成功率、Token、耗时和人工修复工作量,再计算“每个合格版本的成本”。
内容预告:第 1 节用 Saltline 拆解一次 AI 游戏开发实验的 Token 账单结构。第 2 节对比三家模型的官方价格,并说明缓存对总费用的影响。第 3 节介绍 SWE-bench Verified、Aider Polyglot 和 NIST 历史评测分别能说明什么。第 4 节给出一套可复现的游戏开发专项评测方案和代码。第 5 节把结果转化为模型选择策略。
To Know:AI 游戏开发模型选型术语
| 术语 | 解释 |
|---|---|
| 输入 Token | 提交给模型处理的内容计量,包括提示词、代码文件、工具返回结果等 |
| 输出 Token | 模型生成内容的计量,例如代码、说明文字和工具调用参数 |
| 缓存读取 | 重复使用已缓存的上下文,计费远低于普通输入 |
| 缓存写入 | 首次把上下文存入缓存的费用,通常略高于普通输入 |
| SWE-bench Verified | 包含 500 个经人工核验的真实开源项目软件工程任务的基准 |
| Aider Polyglot | 覆盖 6 种编程语言、225 道练习题的代码修改评测 |
| Harness | 组织模型、工具和任务循环的执行框架,例如 Agent 脚手架 |
| 任务成功率 | 按事先定义的验收标准完成任务的比例 |
| 端到端成本 | 完成整个任务的模型调用、工具执行与人工费用之和 |
| 人工修复 | 为使生成结果达到验收标准而进行的人工修改 |
| 程序化生成 | 用代码和数学函数生成几何、纹理、声音,而非导入素材文件 |
| Shader | 运行在 GPU 上的程序,用来计算颜色、光照、材质等视觉效果 |
1 AI 独立开发游戏的成本案例:Saltline 花了多少 Token
1.1 Saltline 是一个什么规模的游戏
2026 年 11 月 9 日,Anthropic 工程师 Felix Rieseberg 公开了一项 Claude Fable 5.2 编程实验。他只给模型一条提示词,要求做一款视觉效果尽量接近 AAA 游戏的小规模第一人称射击游戏,并且全程不提供人工反馈。结果是 Saltline:一个在浏览器中直接运行的 3D 射击游戏,场景是雨夜集装箱港口,玩家要关闭三个信号中继站并撤离,敌人有空中巡逻无人机和地面机械猎犬。
从规模看,Saltline 是单人、单关卡的可玩原型。“3A”在这里是实验目标和视觉类比,用来描述画面风格,它的体量与商业 3A 产品差距很大。国内传播的“几猫·国产3A大作”是 Saltline 的中文版本或重新包装版本,名称来自传播过程,不代表开发归属。
1.2 开发者自述的时间、Token 和费用
以下数据均来自开发者本人在 X 上的发布,属于自述估算,未经第三方审计:
- 开发时间:约 8 小时
- 输入 Token:约 4.45 亿,其中大量使用缓存
- 输出 Token:约 270 万
- 按 API 定价估算的费用:约 550 美元
- 开发方式:单次提示词,无人工反馈迭代
这笔钱是一次性的生成成本。游戏文件生成后由玩家浏览器在本地运行,玩家游玩时不调用 Claude API,所以 550 美元也不能摊算成“每位玩家的 AI 成本”。
1.3 用官方单价拆解这笔账
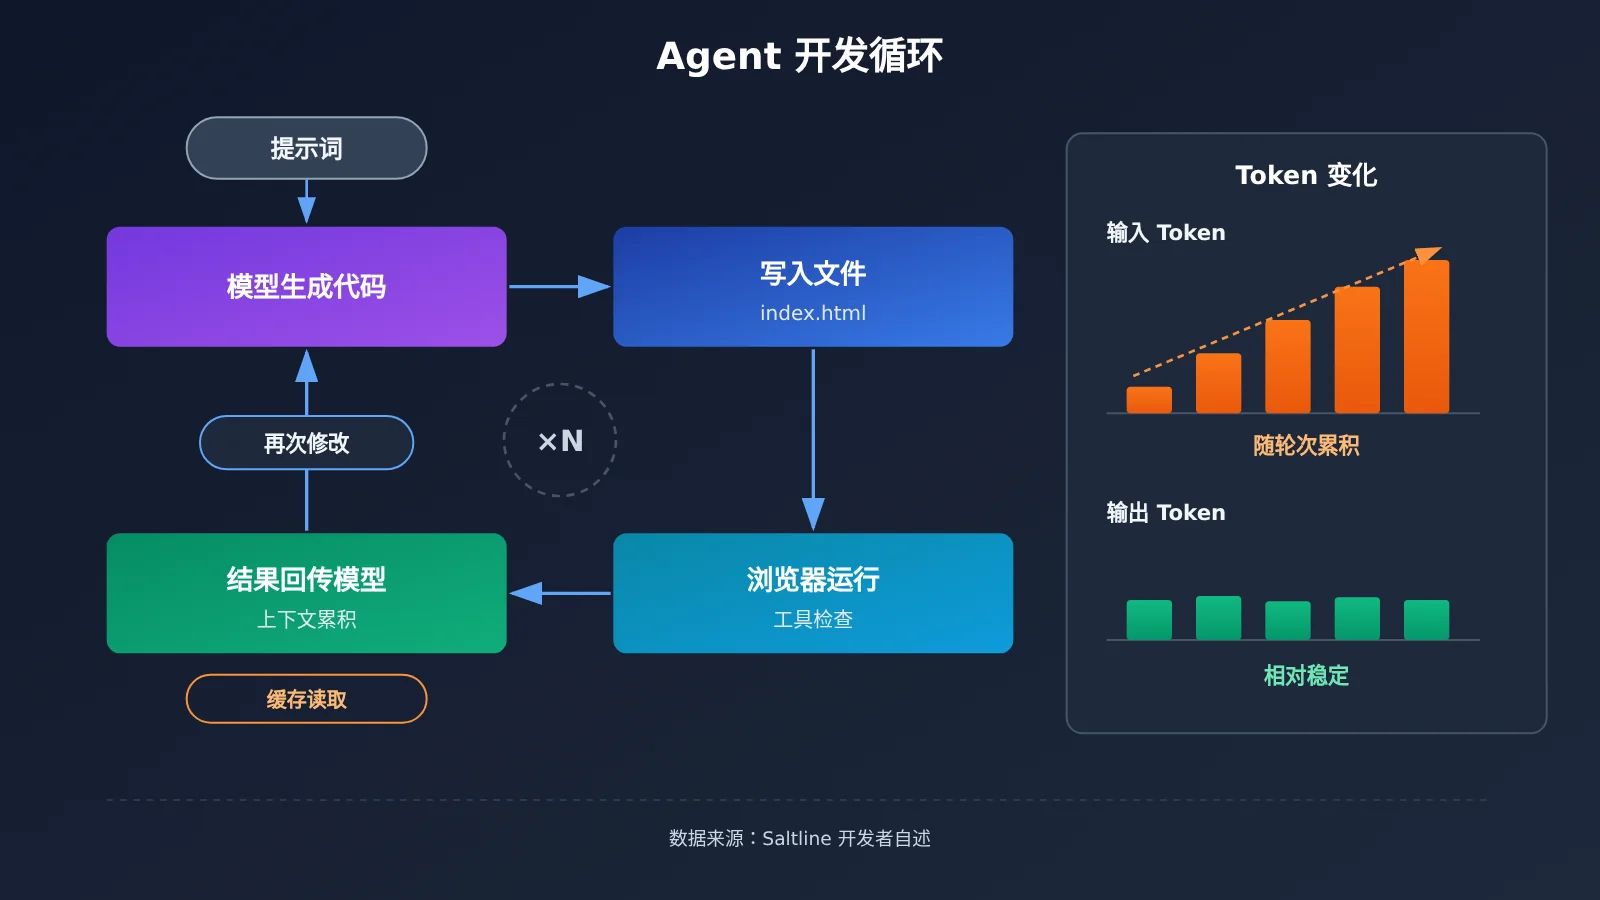
按 Claude Fable 5.2 官方标准价格(输出 $40 / 百万 Token),270 万输出 Token 约为 108 美元。剩余约 440 美元对应输入侧,包括缓存写入、缓存读取和普通输入。开发者没有公开三者各自的数量,所以无法进一步拆分。
对照两个边界值就能看出缓存的作用:4.45 亿输入如果全部按普通输入价 $8 计费,约为 3,560 美元;全部按缓存读取价 $0.20 计费,约为 89 美元。实际估算落在两者之间,并且明显靠近下限。这说明长时间运行的 Agent 开发任务中,输入侧的缓存命中率决定了账单量级,输出单价的影响相对次要。
1.4 为什么一个 1.4MB 的文件能消耗 4.45 亿 Token
Saltline 的独立 HTML 版本约 1.43MB(1,425,707 字节)。开发者说明,游戏中的模型、纹理都是代码,几何结构由程序构造,表面质感由 Shader 计算,声音也由程序生成,没有单独的图片或 3D 模型素材。
生成物很小,过程却很长。Agent 在 8 小时里反复读取不断增长的代码文件、运行工具、查看结果再修改,每一轮都要把大量上下文重新送入模型。最终 Token 消耗主要来自这种循环,而非最终文件长度。这也是评估游戏开发模型时必须测量“过程成本”的原因。
2 游戏开发模型价格对比:三家 API 的 Token 计费差异
2.1 三款模型的官方标准价格
下表价格均来自各家官方页面,截至 2026 年 11 月 16 日,单位为美元 / 百万 Token,计费档位为标准 API 价格,不含其他渠道折扣和地区附加费用。
| 模型 | 普通输入 | 输出 | 缓存读取 | 备注 |
|---|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 | 5 分钟缓存写入 $10,1 小时缓存写入 $16;上下文 1M,最大输出 128K |
| GPT-6 Astra | $10 | $50 | $1 | 标准处理档位;其他速度、批处理和地区选项价格可能不同 |
| Gemini 4 Argon | $2 | $10 | $0.10 | 该价格适用至 2026 年 11 月 30 日;12 月 1 日起计划调整为输入 $4、输出 $20 |
Claude Fable 5.2 另有 Fast Mode,输入 $16、输出 $80,官方称输出速度最高可提升至 2.5 倍。对需要在固定时间内跑完的长任务,速度档位会同时改变耗时和费用,评测时应作为独立配置记录。
💡 对比建议:三家模型的接口和计费字段各不相同,自己搭评测环境时要分别对接。API易 apiyi.com 提供 OpenAI 兼容的统一接口,一个 API Key 即可调用 Claude、GPT、Gemini 等模型,便于在同一套评测脚本里切换模型,具体可用模型和价格以平台列表为准。
2.2 同等 Token 量下的标价差异
为了直观感受单价差距,可以把 Saltline 的输出量(270 万 Token)代入三家价格:Claude Fable 5.2 约 108 美元,GPT-6 Astra 约 135 美元,Gemini 4 Argon 约 27 美元。如果 4.45 亿输入全部命中缓存读取,三者分别约 89 美元、445 美元和 45 美元。
这组数字只说明计费结构,前提是三个模型消耗完全相同的 Token,而实际情况中这个前提几乎不成立。不同模型完成同一任务所需的轮次、每轮读取的上下文、生成代码的长度都不同,失败后重跑还会成倍放大费用。
2.3 缓存价格比输入价格更值得关注
在 Agent 式开发中,大部分输入是重复上下文。GPT-6 Astra 的缓存读取价是普通输入的 1/10,Claude Fable 5.2 是 1/40,Gemini 4 Argon 是 1/20。缓存读取价与普通输入价之比越低,长任务的输入成本越容易被压缩。
缓存还有写入成本和有效期。Claude 的 5 分钟缓存和 1 小时缓存写入价格不同,如果 Agent 两轮调用间隔超过缓存有效期,就要重新写入。估算长任务费用时,需要把缓存写入次数、命中率和有效期一起纳入计算。
3 编程基准能说明什么:游戏开发模型的能力参考
3.1 SWE-bench Verified:真实仓库的软件工程任务
SWE-bench Verified 包含 500 个经过人工筛选和验证的问题,来自真实开源项目。模型需要理解仓库上下文,完成修复 Bug、修改现有代码、解决测试失败和跨文件修改等工作,比单纯代码补全更接近真实工程。
使用它时要注意 Harness 的影响。官方说明,完整排行榜混合了不同 Agent 系统,纯模型比较应使用统一的 mini-SWE-agent 配置。Agent 配置、工具、提示词和版本都会改变得分,不同配置的成绩应分开看。
3.2 Aider Polyglot:同时记录正确率与成本
Aider Polyglot 使用 225 道编程练习,覆盖 C++、Go、Java、JavaScript、Python 和 Rust,用测试用例判断模型修改代码是否正确。它的公开结果除了正确率,还会记录 Token 消耗、运行成本、错误输出、格式错误和每个任务的执行时间。
对选型来说,这种“正确率 + 成本”的记录方式很有价值,它和本文后面的评估框架思路一致。题目本身属于独立练习题,规模和形态与完整 3D 游戏项目差距明显。
3.3 NIST 历史评测:注意模型版本和时间
美国国家标准与技术研究院(NIST)下属 CAISI 在 2025 年发布的模型评测报告中,测试了一组模型的 SWE-bench Verified 成绩。以下数据均为该报告中的历史模型和实验配置,不代表 2026 年 11 月最新模型的排名。
| 模型(2025 年报告测试版本) | SWE-bench Verified 得分 |
|---|---|
| Anthropic Opus 4 | 66.7% |
| GPT-5 | 63.0% |
| DeepSeek V3.1 | 54.8% |
| DeepSeek R1-0528 | 44.6% |
| gpt-oss | 42.6% |
| DeepSeek R1 | 25.4% |
报告同时给出了标准误差,说明同一基准的分数本身存在统计波动。几个百分点的差距,在误差范围内可能没有实际区分度。本文对比的 Claude Fable 5.2、GPT-6 Astra、Gemini 4 Argon 均未出现在这份报告中,选型时需要查找针对当前版本、标明配置的最新评测,或者自己测。
3.4 通用编程能力与游戏开发能力的差距
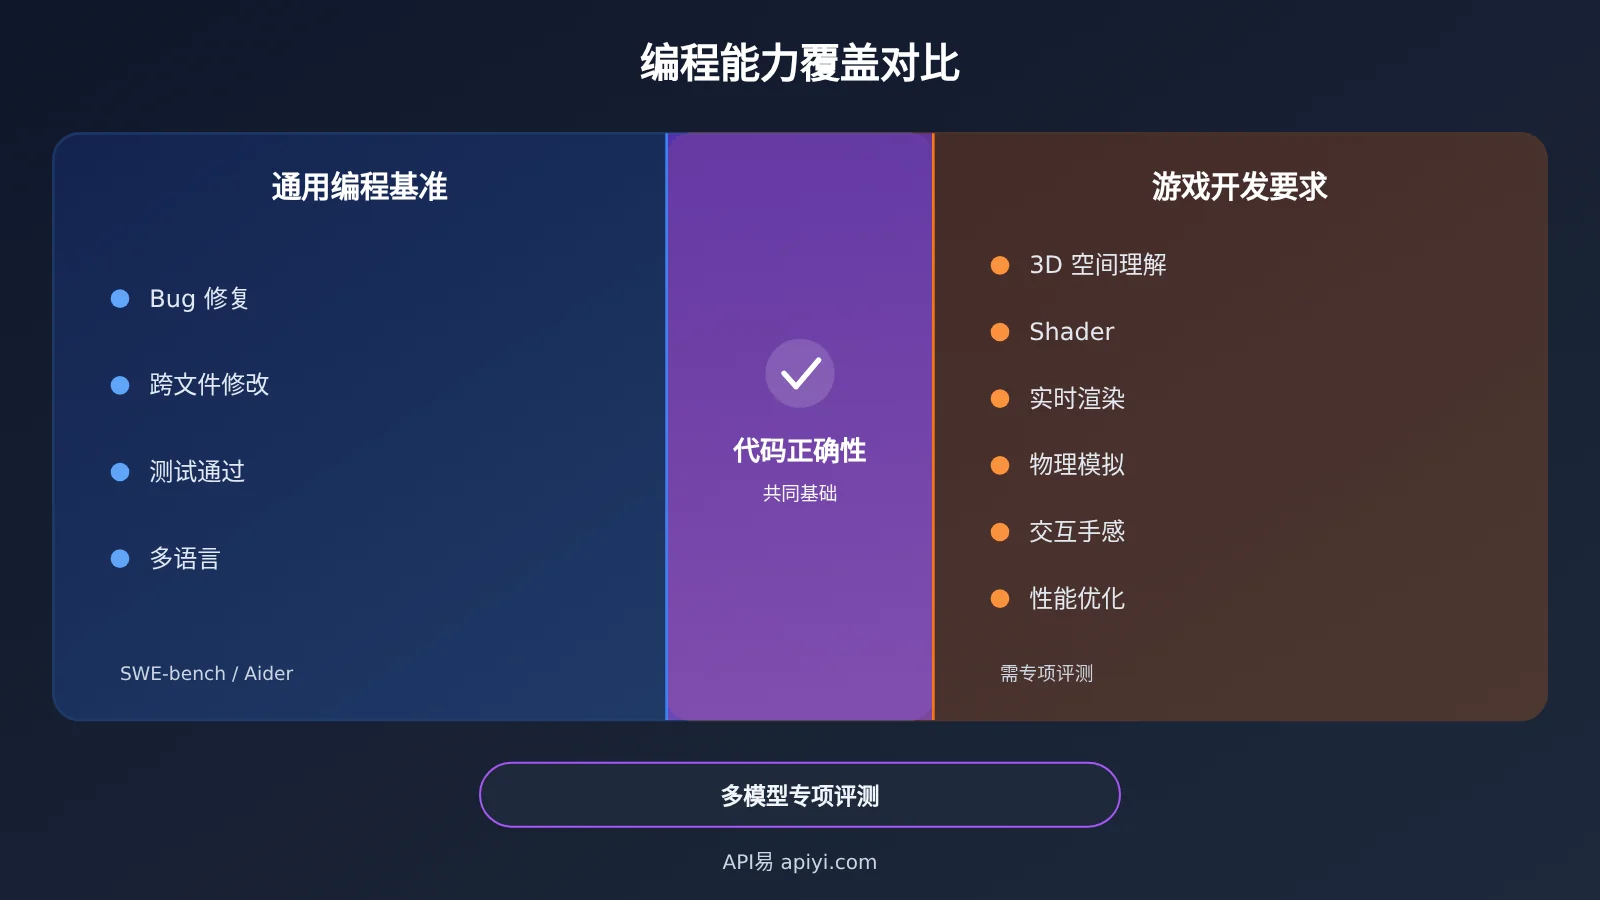
游戏开发包含大量通用软件工程基准覆盖不足的工作:3D 空间理解、Shader 编写、实时渲染、动画系统、物理模拟、交互手感和运行性能优化。Saltline 这类项目还要求模型用代码生成视觉资产,这依赖对图形学和视觉效果的把握。
一个模型可能很擅长修复 Python 仓库中的 Bug,却在复杂 WebGL 场景上表现一般。SWE-bench 和 Aider 适合用来筛掉代码能力明显不足的候选,最终排序需要游戏开发专项评测来决定。
4 如何对比 AI 游戏开发模型:同一任务的专项评测方案
4.1 设计统一的浏览器 3D 游戏任务
参考 Saltline 的形态,可以把任务定义为:从一条提示词生成一个可在浏览器运行的 3D 游戏原型。所有候选模型使用完全相同的要求:
- 生成完整项目,可直接在浏览器打开运行
- 包含可操作的角色和 3D 环境
- 包含碰撞或基本物理
- 包含明确的任务目标与胜负条件
- 评测过程中不允许人工修改核心代码
任务难度应贴近你的真实需求。做休闲小游戏的团队,用 FPS 原型测试会高估所需模型档位;做复杂 3D 项目的团队,用简单 2D 任务测试则会低估。
4.2 十项评估指标
| 维度 | 评价内容 | 建议记录方式 |
|---|---|---|
| 功能完整度 | 核心游戏功能是否实现 | 按功能清单逐项打勾 |
| 视觉质量 | 场景、材质、光照、动画 | 多人盲评打分 |
| 可运行性 | 能否正常启动 | 是 / 否 |
| 交互完整性 | 输入与反馈是否正常 | 按操作清单逐项测试 |
| 稳定性 | 是否存在明显崩溃 | 固定时长游玩记录崩溃次数 |
| 性能 | FPS、启动时间、内存 | 固定设备实测 |
| 代码质量 | 可读性、模块化、错误处理 | 代码审查打分 |
| Token 成本 | 输入、输出、缓存 | 从 API usage 字段累计 |
| 总耗时 | 从开始到可运行版本 | 计时 |
| 人工修复 | 达标所需人工介入 | 记录人工工时 |
其中“可运行性”“功能完整度”“交互完整性”应作为硬性验收条件,用来判定一次运行是否成功;视觉、性能、代码质量用于在成功的结果之间排序。
4.3 控制测试环境
评测结果能否比较,取决于变量是否受控。需要统一的条件包括:相同浏览器、相同设备、相同提示词、相同测试流程、相同时间预算,以及是否允许联网。如果允许模型自行调用工具、搜索资料或创建文件,所有模型的工具权限也必须一致。
Harness 同样要固定。同一个模型换一套 Agent 框架,成功率和 Token 消耗可能大幅变化,所以评测报告里要写明使用的框架、版本和参数,例如温度、最大输出长度和速度档位。
4.4 每个模型至少运行多次
大模型生成有随机性,一次成功可能是运气,一次失败也可能是偶发。每个模型应在相同条件下运行多次(例如 5 到 10 次),统计成功率以及成功样本的平均 Token、耗时和质量分数。Saltline 本身也是单次实验,它证明了这件事可以做到,但无法给出该模型在同类任务上的成功率。
下面的脚本用 OpenAI 兼容接口调用模型,并根据 usage 字段按第 2 节的价格计算单次调用费用:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口,切换模型只需改 model
)

# 单位:美元 / 百万 Token,截至 2026-11-16 官方标准价
PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

def call_and_price(model: str, messages: list) -> tuple[str, float]:
    resp = client.chat.completions.create(model=model, messages=messages)
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + u.completion_tokens * p["output"]) / 1_000_000
    return resp.choices[0].message.content, cost
模型名称请以实际调用平台的模型列表为准。缓存写入费用、速度档位附加费需要按各家规则另行加入计算。
查看多轮评测与成本汇总脚本
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通过 API易 调用多个候选模型
)

PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

TASK_PROMPT = "生成一个可在浏览器运行的单文件 3D 游戏原型……(所有模型使用同一提示词)"

def price(model, usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    return ((usage.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + usage.completion_tokens * p["output"]) / 1_000_000

def run_once(model, max_rounds=30):
    """简化的 Agent 循环:生成 → 检查 → 回传结果 → 修改"""
    messages = [{"role": "user", "content": TASK_PROMPT}]
    total_cost, start = 0.0, time.time()
    for _ in range(max_rounds):
        resp = client.chat.completions.create(model=model, messages=messages)
        total_cost += price(model, resp.usage)
        code = resp.choices[0].message.content
        report = check_game(code)  # 自行实现:写入文件、无头浏览器启动、跑功能清单
        if report["passed"]:
            return True, total_cost, time.time() - start
        messages += [{"role": "assistant", "content": code},
                     {"role": "user", "content": f"检查结果:{report['log']},请修复"}]
    return False, total_cost, time.time() - start

def evaluate(model, trials=5, human_fix_cost=0.0):
    results = [run_once(model) for _ in range(trials)]
    successes = sum(r[0] for r in results)
    api_cost = sum(r[1] for r in results)
    rate = successes / trials
    per_success = (api_cost + human_fix_cost) / successes if successes else float("inf")
    print(f"{model}: 成功率 {rate:.0%},API 总费用 ${api_cost:.2f},"
          f"每个合格版本成本 ${per_success:.2f}")

for m in PRICES:
    evaluate(m)
🚀 快速开始:搭建这类评测时,建议先用小任务跑通脚本,再换成完整游戏任务。API易 apiyi.com 为新用户提供免费测试额度,可以先用它验证 Harness 和计费统计逻辑,再投入正式评测预算。
5 AI 开发游戏如何选模型:控制复杂任务的 Token 成本
5.1 成功率决定总成本
完整开发成本由三部分组成:
任务总成本 = 模型调用成本 + 工具执行成本 + 人工修复成本
把成功率考虑进来,更实用的比较指标是“每个合格版本的成本”:所有尝试的总花费除以成功次数。假设模型 A 单次尝试 100 美元、成功率 80%,每个合格版本约 125 美元;模型 B 单次尝试 30 美元、成功率 20%,每个合格版本约 150 美元,还要再加上失败版本的排查时间。单价低的模型在这个例子里反而更贵。
人工修复往往是最大的一项。一名工程师花几小时修好生成结果,人力成本可能超过整次 API 费用。所以评测时要如实记录人工介入时长,并按团队实际人力单价折算进总成本。
5.2 三种模型选择策略
| 策略 | 适用场景 | 优势 | 需要注意的开销 |
|---|---|---|---|
| 高能力模型 | 复杂架构、长上下文开发、多模块协作、复杂 Bug 定位 | 成功率高,减少重跑和人工修复 | 单价高,需依赖缓存控制输入成本 |
| 低成本模型 | 简单功能、代码解释、重复性修改、测试辅助 | 单价低,适合高频调用 | 复杂任务可能多轮失败,总成本反升 |
| 多模型协作 | 一个模型负责架构,一个负责实现,独立模型做代码审查 | 按环节匹配能力与价格 | 模型间交接会重复传输上下文,增加 Token 和协调成本 |
多模型协作的省钱效果取决于交接成本。每次交接都要把项目上下文重新送给另一个模型,而不同模型之间的缓存无法共享。只有当低成本模型承担的环节足够多、交接次数足够少时,协作方案才划算,这同样需要实测确认。
💰 成本建议:多模型协作需要在一个项目里同时调用多家模型。通过 API易 apiyi.com 用同一个 Key 和同一套代码接入,可以减少多账户管理和接口适配的工作量,便于把架构、实现、审查分配给不同模型后统一统计费用。
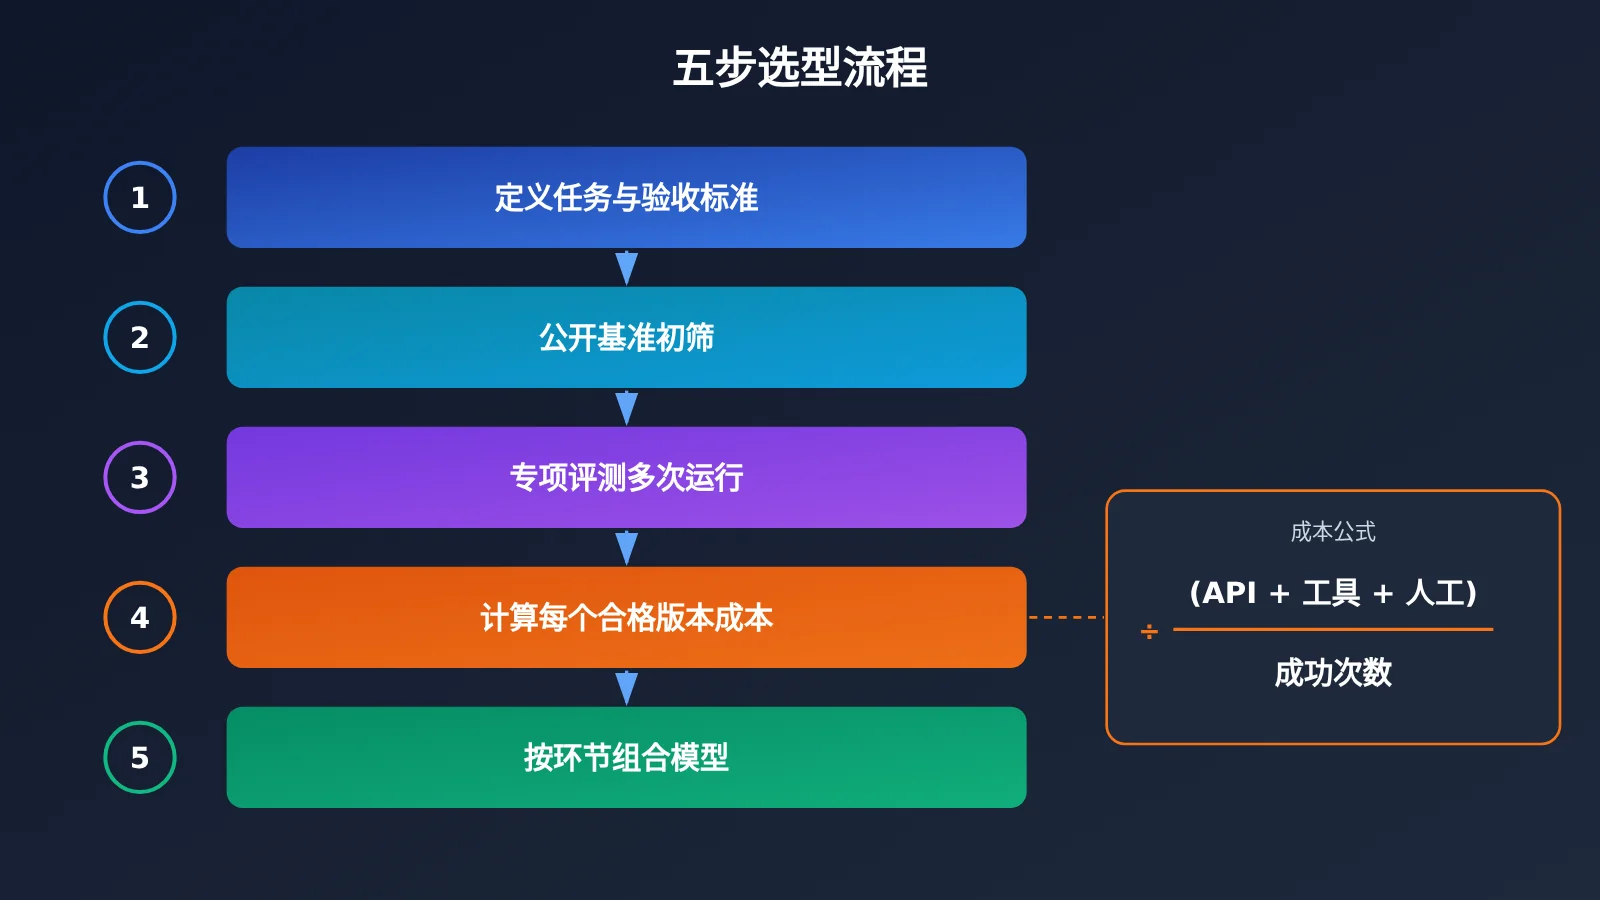
5.3 可执行的五步选型流程
- 定义任务和验收标准:写清功能清单、目标平台和性能底线,作为判定成功的依据。
- 用公开基准做初筛:参考当前版本、配置明确的 SWE-bench Verified 和 Aider Polyglot 成绩,排除代码能力明显不足的模型。
- 跑专项评测:在统一环境下,每个候选模型运行同一游戏任务 5 到 10 次,记录第 4.2 节的十项指标。
- 计算每个合格版本的成本:API 费用加工具费用加人工修复费用,除以成功次数。
- 按环节组合模型:复杂环节交给成功率高的模型,重复性环节交给低成本模型,再实测组合方案是否真的更省。
价格会变动,例如 Gemini 4 Argon 已公布 12 月 1 日起的调价计划。评测结果要保留原始 Token 数据,价格变动后只需重新代入单价即可更新结论。
6 AI 游戏开发模型选择常见问题 FAQ
Q1:Saltline 的 550 美元是实际账单吗?
不是经过审计的账单。550 美元是开发者 Felix Rieseberg 按 API 定价估算的费用,配套数据(约 8 小时、约 4.45 亿输入 Token、约 270 万输出 Token)同样来自本人自述。输入中大量使用了缓存,具体缓存写入和读取的比例未公开。
Q2:单价最低的模型是不是最省钱?
要看成功率。单价只决定每个 Token 的价格,模型完成任务需要多少 Token、要重跑几次、需要多少人工修复,都由模型能力决定。用“总花费 ÷ 成功次数”比较才有意义。
Q3:SWE-bench 排名第一的模型最适合做游戏吗?
SWE-bench Verified 衡量的是真实开源仓库中的软件工程能力,对 Shader、3D 空间理解、实时渲染和交互手感覆盖有限。它适合做初筛,游戏开发的最终排序需要专项评测。
Q4:NIST 报告里的分数能代表现在的模型吗?
不能。NIST CAISI 报告发布于 2025 年,测试的是 GPT-5、Opus 4、DeepSeek V3.1 等历史模型和特定实验配置。2026 年 11 月的新模型需要查找针对其版本的新评测。
Q5:如何快速搭建多模型对比评测?
使用 OpenAI 兼容接口的聚合平台最省事。在 API易 apiyi.com 注册获取 API Key 后,把本文脚本的 base_url 设为 `https://api.apiyi.com/v1`,修改 model 参数即可在同一套脚本中测试多个模型,新用户可以先用免费额度验证脚本。
Q6:评测时 Token 成本怎么统计最准确?
以 API 响应中的 usage 字段为准,逐次累计普通输入、缓存读取和输出 Token,再按调用当日的官方价格和计费档位计算。缓存写入、速度档位等附加费需按各家规则单独加入。通过 API易 apiyi.com 调用时,也可以对照平台后台的消费记录核对统计结果。
Q7:AI 生成的游戏原型能直接上线吗?
Saltline 这类原型证明了模型能在无人工反馈下产出可玩版本,但商业上线还涉及多浏览器兼容、移动端适配、性能优化和长期维护。浏览器游戏受本地硬件和浏览器限制,Saltline 的页面也提示了初始化较慢、卡顿时需切换低画质等问题,上线前的测试和优化成本应计入完整开发成本。
7 AI 游戏开发模型选择 Key Takeaways
- 核心指标:比较每个合格版本的端到端成本,而非每百万 Token 单价。
- Saltline 账单:约 550 美元为开发者自述估算,输出约占 108 美元,其余在输入侧。
- 缓存决定量级:长任务中输入占绝大部分,缓存读取价和命中率影响最大。
- 价格有时效:本文价格截至 2026-11-16,Gemini 4 Argon 12 月 1 日起计划调价。
- 基准用于初筛:SWE-bench、Aider 衡量通用编程,游戏能力需专项评测。
- 多次运行:每个模型同条件跑 5 到 10 次,用成功率而非单次结果下结论。
- 上手方式:通过 API易 apiyi.com 统一接口切换模型,便于同脚本对比成本。
8 总结:让 AI 独立开发游戏的模型选择方法
让 AI 独立开发一款游戏,模型选择的核心要点有三条:
- 账要算全:任务总成本包括模型调用、工具执行和人工修复,API 费用只是其中一项。
- 能力要实测:公开基准用于初筛,游戏开发的最终排序来自统一条件下的多次专项评测。
- 按环节组合:复杂环节用成功率高的模型,重复性环节用低成本模型,组合方案同样要实测验证。
Saltline 给出了一个可参照的量级:单次提示词、约 8 小时、约 550 美元的估算费用,产出一个可玩的浏览器 3D 原型。你的项目需要多少,取决于任务复杂度和所选模型的成功率,最可靠的办法是用本文的框架跑一轮自己的评测。
推荐通过 API易 apiyi.com 快速搭建多模型对比环境,平台提供 OpenAI 兼容接口和新用户免费额度,方便在同一套脚本中完成价格与成功率的实测。
参考资料
- Saltline 独立体验页面:游戏试玩与常见问题说明
- 链接:
saltline.games -
说明: 包含初始化、画质切换、操作方式等体验信息
-
Saltline 代码镜像与 README:开发者数据归属说明
- 链接:
github.com/realcodebear/saltline-fable-5.2 -
说明: 记录生成时间、Token 和估算成本的来源
-
几猫中文版本仓库:Saltline 中文包装版本存档
- 链接:
github.com/Megasu/jimao-3a-game -
说明: 提供 index.html 文件大小等数据
-
Claude Fable 5.2 模型规格与价格:Anthropic 官方文档
- 链接:
platform.claude.com/docs/en/models/fable-5-2/overview -
说明: 输入、输出、缓存及 Fast Mode 价格
-
GPT-6 Astra 模型文档:OpenAI 官方价格
- 链接:
developers.openai.com/api/docs/models/gpt-6-astra -
说明: 标准处理档位价格以此为准
-
SWE-bench Verified:软件工程基准官方页面
- 链接:
swebench.com/verified.html -
说明: 500 个人工核验任务及 mini-SWE-agent 统一配置说明
-
Aider Leaderboards:Aider Polyglot 评测结果
- 链接:
aider.chat/docs/leaderboards -
说明: 同时记录正确率、Token 消耗和运行成本
-
NIST CAISI 评测报告(2025 年):历史模型独立评测
- 链接:
nist.gov/system/files/documents/2025/09/30/CAISI_Evaluation_of_DeepSeek_AI_Models.pdf - 说明: 含 SWE-bench Verified 历史成绩与标准误差
作者: APIYI 技术团队
技术交流: 欢迎在 API易 apiyi.com 网站首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心