作者注:Artificial Analysis Search Index 的 2026-11-09 榜單顯示,固定一個回答模型,只更換搜索配置,綜合得分可以從 33 分變化到 83 分。不過,選型時還需要同時看任務成本、耗時和評測邊界。
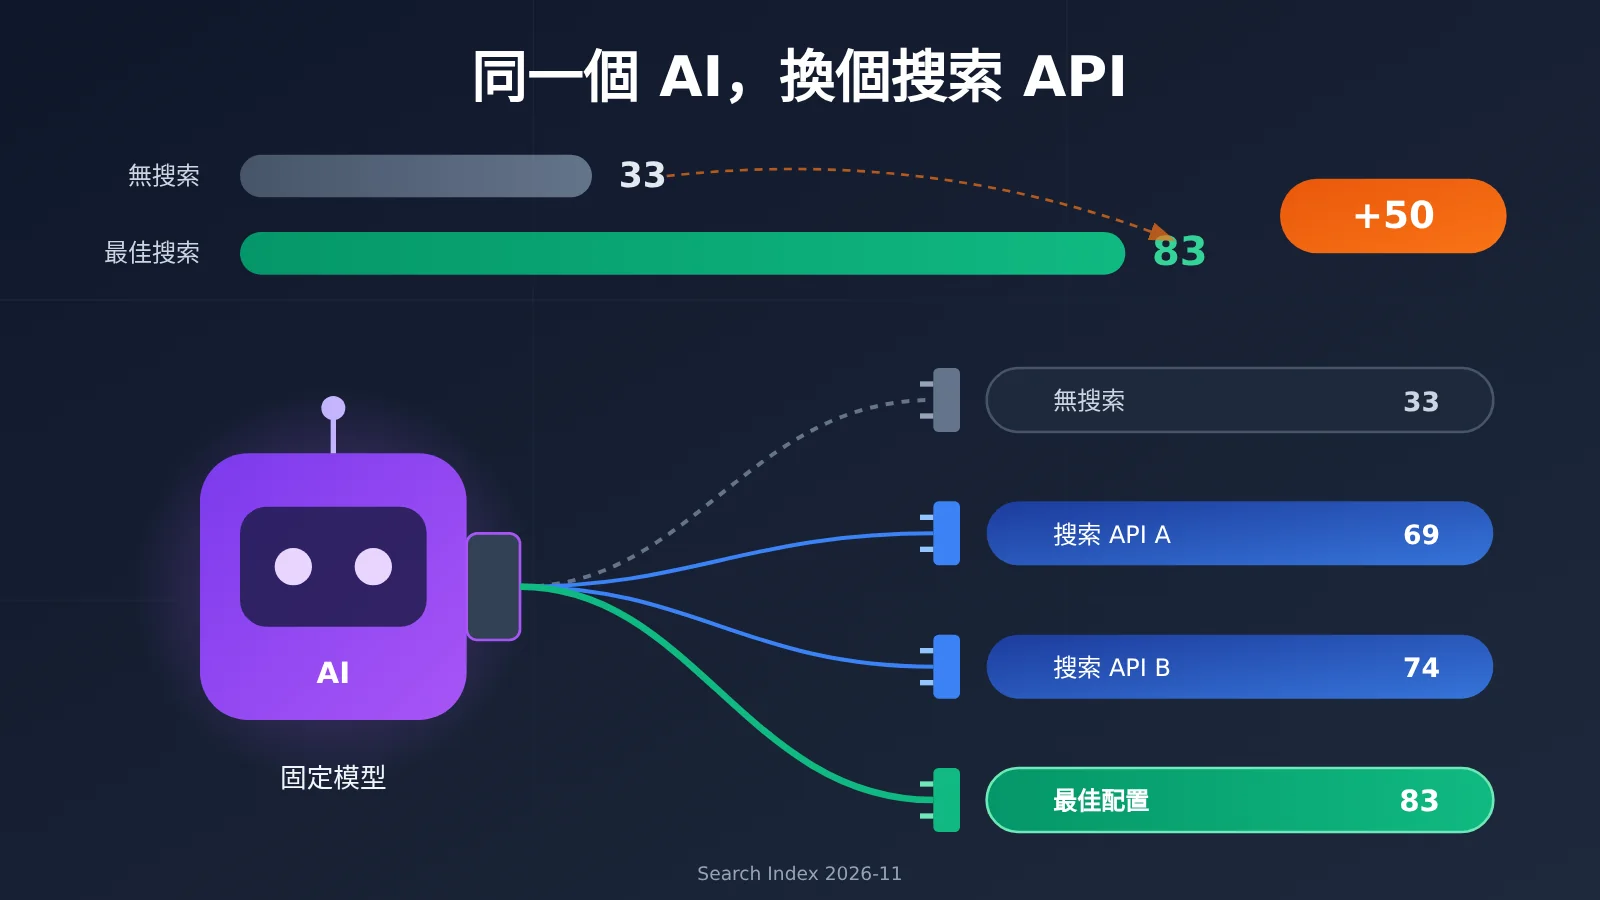
很多人做 Agent 時會先挑模型,再順手接一個搜索工具。在不少團隊眼裏,搜索只是“能聯網就行”的配件。Artificial Analysis 在 2026 年 11 月 9 日更新的 Search Index 給出了不一樣的結果:同一個模型,不接搜索時得 33 分,換上最好的搜索 API 配置可以到 83 分。
這不是又一份“各家各有千秋”的榜單搬運。 本文會拆開說明 83 分的計算方式和測試條件,並把質量、完整任務耗時、搜索費與模型費放在一起比較。最後按場景說明這份榜單能用在哪些決策上,以及在哪些地方不能直接套用。
核心價值:讀完本文,你能用公開榜單篩出搜索 API 候選,再結合自己的任務做二次對比,避免只看最高分做決定。
讀懂搜索 API 榜單前的 to know 術語
一句話摘要:Search Index 比較的是同一模型在不同搜索配置下的表現,分差最大達到 50 分。但“分高”不等於“最適合你”,還要看成本、耗時和評測覆蓋範圍。
讀榜單之前,先統一下面幾個術語:
- Search Index:由指定檢索基準按規則彙總出來的綜合分數。本文特指 Artificial Analysis 的搜索 API 評測指數,滿分 100。
- F1:精確率與召回率的調和平均。答案是“一組實體”時,用它衡量答得準不準、全不全。
- Harness:組織模型輸入、工具執行和任務計分的測試框架。Artificial Analysis 使用的 Agent 循環名爲 Stirrup。
- Search API:按查詢返回網頁鏈接、標題、相關片段等檢索結果的接口,例如 Exa、Brave、Perplexity Search API。
- Token:模型處理文本的計量單位。搜索結果越冗長,送進模型的 Token 越多,模型費就越高。
搜索 API 居然能讓同一個 AI 差 50 分?
Artificial Analysis 在 2026 年 8 月 18 日推出搜索 API 基準測試。最新公開數據更新於 2026 年 11 月 9 日,覆蓋 14 家服務商、26 款 Search API 產品或配置。它評的不是模型,而是搜索服務放進 Agent 之後的實際效果。
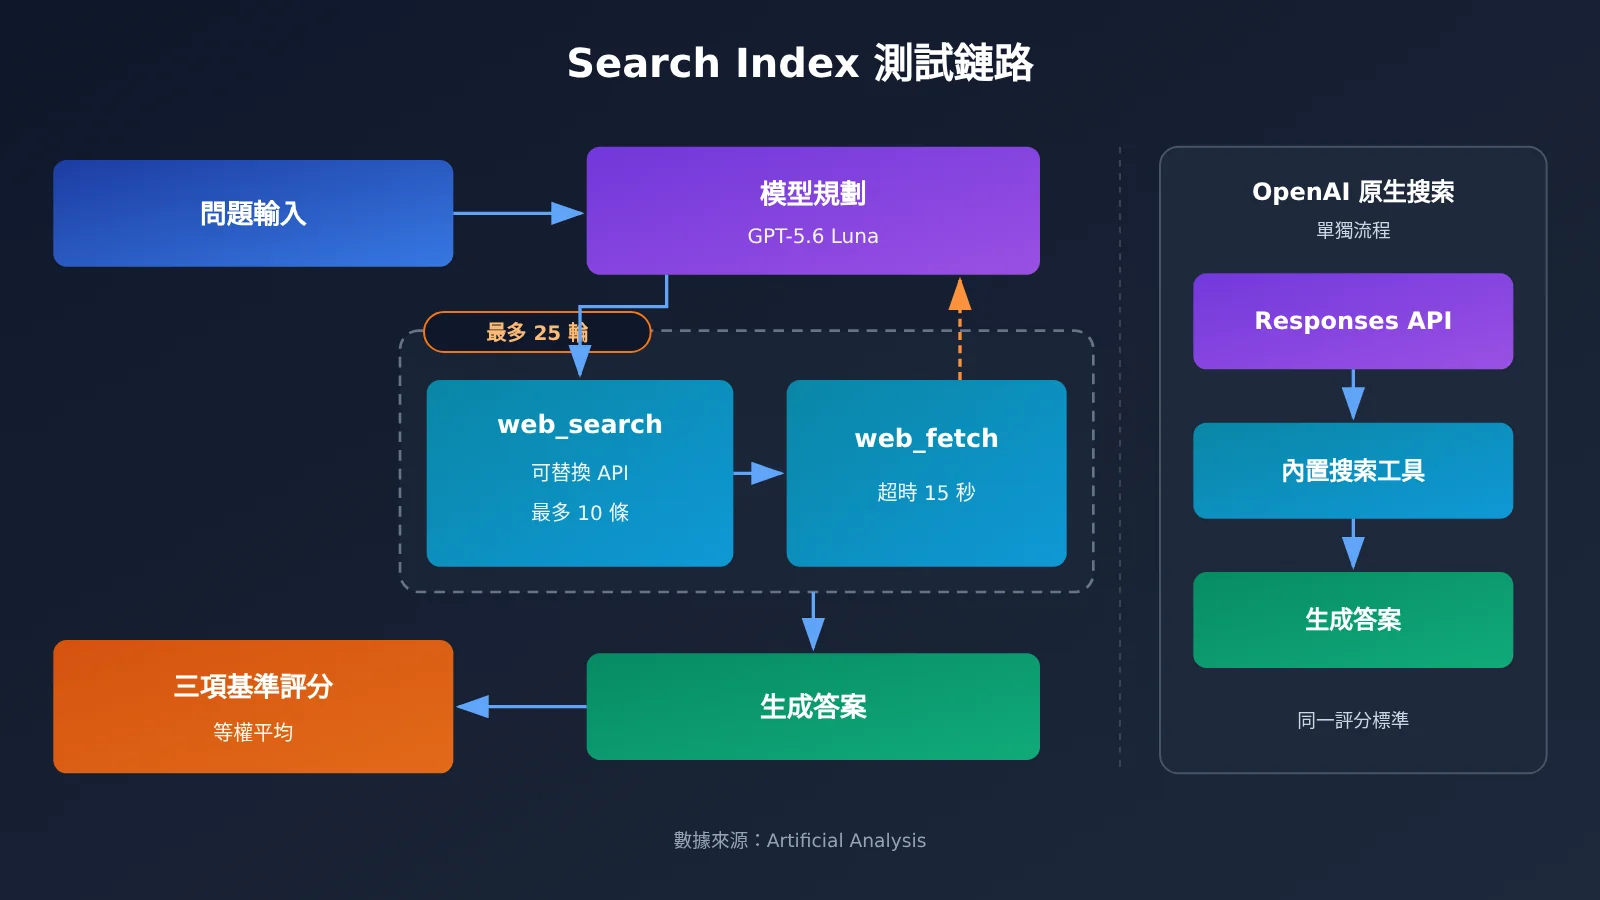
實驗設計的關鍵在於“控制變量”。候選回答模型固定爲 GPT-5.6 Luna(medium),Agent 框架也固定不變,只替換搜索服務。在這個條件下,不使用搜索工具的基線只有 33 分,排名第一的 Keenable Pro 達到 83 分,相差 50 個指數分數點。即使在接了搜索的配置之間,從 DeepSeek Search Summary 的 69 分到 Keenable Pro 的 83 分,差距也有 14 分。
有一個例外需要單獨說明:OpenAI 原生 Web Search 的運行方式不同。其他獨立 Search API 都跑在 Artificial Analysis 的外部 Agent 循環中。OpenAI Web Search 則使用 Responses API 的內置工具流程,搜索次數和執行方式由 OpenAI 自己決定。因此它的 74 分可以作爲參考,但不能看作完全相同條件下的“換 API”實驗。
還要注意,這 50 分是同一評測體系裏的搜索增強效果。它不代表任何人用任何模型接上搜索都能提升 50 個百分點。
Search Index 的 83 分到底是怎麼測出來的?
Search Index 三項基準與計分方式
綜合分由三個基準等權平均得到,每項各佔三分之一:
| 基準 | 任務規模 | 任務類型 | 評分指標 |
|---|---|---|---|
| DeepSearchQA | 900 個 | 複雜事實研究,答案常爲集合 | 答案集合 F1 |
| BrowseComp | 200 個 | 難度較高的網頁檢索問答 | 精確答案準確率 |
| AA-Omniscience | 600 個 | 事實問答 | 事實問答準確率 |
三項合計 1,700 個任務,但綜合分不是把 1,700 道題合併起來算正確率。以 Keenable Pro 爲例,三項分數依次爲 88、87、73,平均約 82.67,四捨五入後顯示爲 83。所以,83 分不等於“答對率 83%”。
Search Index 的測試條件
方法論中公開的關鍵配置如下:
| 實驗項目 | 實際設置 |
|---|---|
| 候選回答模型 / 評分模型 | GPT-5.6 Luna(medium) |
| 最大 Agent 輪次 | 25 輪,輪次內工具調用次數不限 |
| 可用工具 | web_search、web_fetch(獨立網頁讀取) |
| 每次搜索結果 | 最多 10 條 |
| 正文抓取超時 | 每頁 15 秒 |
| 返回給模型的內容 | 服務商原生響應內容 |
| 無搜索基線 | 同一模型,不使用搜索工具 |
從這張表可以看出兩點。第一,返回給模型的是“服務商原生響應”。片段長度、摘要方式、高亮組織都會進入模型上下文,所以分數反映的不只是底層網頁索引質量,也包括信息的組織方式。第二,429、5xx 或超時等致命錯誤會被持續重試,直到成功,且這些錯誤不計入最終結果。這意味着榜單衡量的是“跑通時”的質量,不能拿來證明各家在生產環境中的可用性或故障率。
最新 Search Index 排名:誰的搜索 API 效果最好?
下表中,質量分數和 BrowseComp 來自 2026-11-09 榜單。耗時採用 2026-11-13 讀取的榜單值,指一個標準測試任務從開始到結束的平均耗時,不是搜索 API 單次請求的網絡延遲。
| 搜索配置 | 綜合分(11-09) | BrowseComp | 平均任務耗時(11-13) |
|---|---|---|---|
| Keenable Pro | 83 | 87% | 16.6 秒 |
| Keenable Realtime | 82 | 86% | 16.0 秒 |
| Exa Auto + Dynamic Highlights | 80 | 83% | 36.7 秒 |
| Perplexity Search Medium | 80 | 87% | 31.1 秒 |
| Exa Lite + Dynamic Highlights | 79 | 81% | 19.4 秒 |
| Parallel Advanced | 75 | 77% | 未在本次耗時更新中列出 |
| Brave LLM Context | 75 | 77% | 未在本次耗時更新中列出 |
| OpenAI Web Search Medium(Responses 內置流程) | 74 | 74% | 33.1 秒 |
| DeepSeek Search Summary | 69 | 63% | 22.4 秒 |
| 無搜索基線 | 33 | 17% | — |
搜索 API 排名中的三個典型差距
同分不同速。 Exa Auto 與 Perplexity Medium 都是 80 分,但完整任務耗時分別爲 36.7 秒和 31.1 秒。Keenable Pro 分數更高,耗時卻只有 16.6 秒左右。對需要實時響應的 Agent 來說,這種差距用戶能直接感受到。
BrowseComp 不完全跟隨綜合分。 Perplexity Medium 的 BrowseComp 達到 87%,與 Keenable Pro 持平,但綜合分低 3 分。差距主要出在另外兩項基準上。如果你的業務更接近“難題網頁檢索”,可以單獨參考 BrowseComp 這一列。
同一廠商的不同模式差別很大。 Exa Lite 與 Exa Auto 只差 1 分,耗時卻相差近一倍。所以應當按具體產品模式解讀,不要把 Exa Lite、Exa Auto 合併成一個“Exa 分數”。
💡 數據說明:以上分數爲 Artificial Analysis 第三方評測結果,耗時爲標準任務耗時。如果想在自己的業務問題上覆現類似對比,可以通過 API易 apiyi.com 固定一個回答模型,再分別接入不同的搜索工具做 A/B 測試。
搜索 API 最高分就是最划算的嗎?
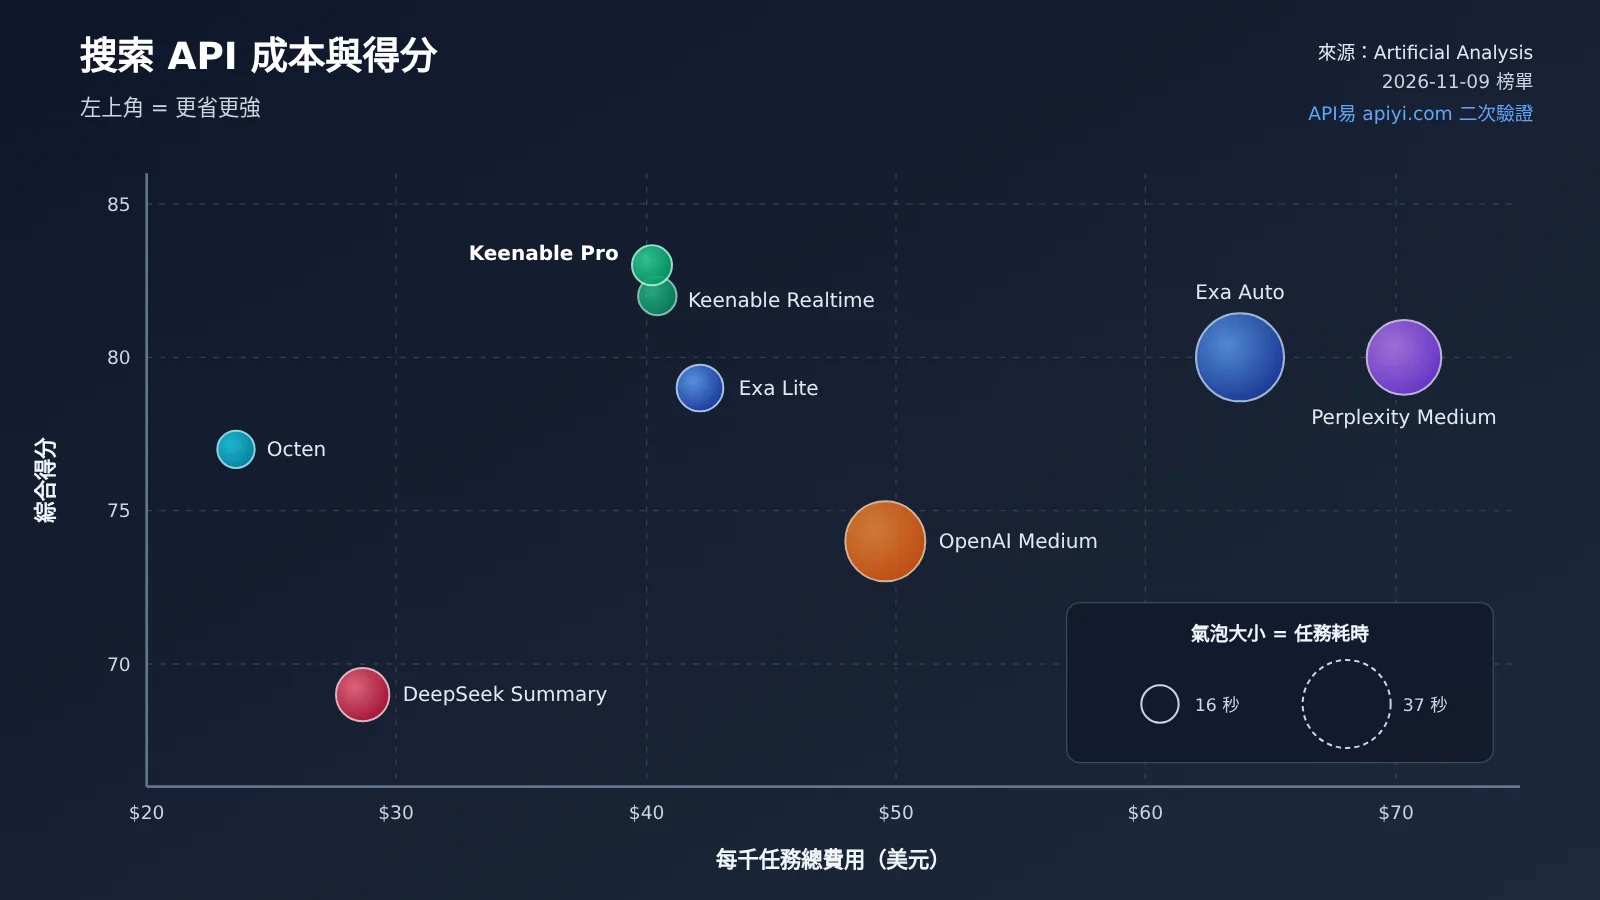
Artificial Analysis 還公開了每 1,000 個基準任務的估算費用,並拆分爲搜索費和模型費(2026-11-09 榜單,美元)。“每分成本”一列是本文編輯按“總費用 ÷ 綜合分”粗略推導的,僅用於橫向參考,不是官方指標。
| 搜索配置 | 質量分 | 搜索費 + 模型費 | 總費用/千任務 | 每分成本(編輯推導) | 任務耗時(11-13) |
|---|---|---|---|---|---|
| Keenable Pro | 83 | 31.87 + 8.35 | $40.22 | 約 $0.48 | 16.6 秒 |
| Keenable Realtime | 82 | 31.94 + 8.52 | $40.46 | 約 $0.49 | 16.0 秒 |
| Exa Auto + Highlights | 80 | 53.17 + 10.60 | $63.77 | 約 $0.80 | 36.7 秒 |
| Perplexity Medium | 80 | 62.30 + 8.04 | $70.34 | 約 $0.88 | 31.1 秒 |
| Exa Lite + Highlights | 79 | 31.20 + 10.95 | $42.15 | 約 $0.53 | 19.4 秒 |
| Octen Highlights | 77 | 9.07 + 14.50 | $23.57 | 約 $0.31 | 15.6 秒 |
| OpenAI Web Search Medium | 74 | 40.19 + 9.40 | $49.59 | 約 $0.67 | 33.1 秒 |
| DeepSeek Search Summary | 69 | 8.47 + 20.19 | $28.66 | 約 $0.42 | 22.4 秒 |
搜索 API 成本表裏的三個結論
最高分不一定最貴。 Keenable Pro 以 83 分排第一,每千任務約 $40.22,摺合單個任務約 $0.04,在樣本中處於中等水平。Perplexity Medium 分數低 3 分,總費用卻高出約 75%。
1 分的差距,成本可能差三成多。 Exa Lite + Highlights 爲 79 分、$42.15/千任務,Exa Auto + Highlights 爲 80 分、$63.77/千任務,前者便宜約 34%,耗時也更短。參考 Exa 官方定價頁(截至 2026-11-13 的資料),Lite 檔位爲每 1,000 次請求 $4,Auto 檔位爲每 1,000 次請求 $7。榜單中搜索費的差異與這個價位結構是一致的。
搜索費低,模型費可能更高。 DeepSeek Search Summary 的搜索費只有 $8.47,但模型費達到 $20.19,是表中最高的。Octen 的總費用最低,但模型費也高於 Keenable、Exa、Perplexity。搜索結果給得不夠有效,Agent 就會多搜幾輪、多讀幾頁,Token 消耗隨之上升。所以計算成本時,應當以“完成一個任務的總費用”爲單位,而不是隻看搜索 API 的單次標價。
這份 Search Index 榜單能指導哪些實際選擇?
Search Index 是英文爲主的通用事實檢索評測,不是中文互聯網專項基準。下面把它和常見 Agent 場景對應起來,標出哪些場景可以直接參考,哪些需要補充測試。
| Agent 場景 | 最關鍵的指標 | 榜單參考價值 | 建議候選 |
|---|---|---|---|
| 事實型問答 | 準確率、引用正確率 | 高,可直接參考 AA-Omniscience | Keenable、Exa Lite、Perplexity |
| 複雜多來源研究 | 多跳檢索、集合召回 | 高,重點看 DeepSearchQA 與 BrowseComp | Keenable Pro、Exa Auto、Perplexity Medium |
| 低延遲 Agent | 完整任務耗時、P95 延遲 | 中,任務耗時只能作參考 | Keenable Realtime、Octen、Exa Lite |
| 中文資訊檢索 | 中文來源覆蓋、國內站點可達 | 低,需自建中文測試集 | 加入百度千帆、博查、阿里雲百鍊對照 |
| 編程文檔檢索 | 官方文檔覆蓋、版本信息 | 低到中,需用真實技術問題複測 | Exa、Perplexity、Parallel |
用 Search Index 做搜索 API 二次對比的方法
更合理的做法是把公開榜單當作“初篩工具”,再用自己的任務做第二輪比較:
- 按質量、耗時、總費用三項,從榜單中選出 3–4 個候選配置;
- 準備 50–100 道自己的業務問題,覆蓋簡單事實、近期新聞、多跳問題、中文和跨語言查詢;
- 固定同一個回答模型、相同的最大輪次和結果條數,只替換搜索工具;
- 記錄準確率、引用正確率、單任務總費用、P50/P95 耗時以及空結果和超時次數;
- 生產環境的穩定性另做壓測,因爲榜單已經排除了重試後的致命錯誤。
搜索 API 選型決策建議與快速上手
🎯 選擇建議:追求綜合質量和速度,優先測試 Keenable Pro/Realtime;對成本敏感又想要接近 80 分的質量,Exa Lite + Highlights 和 Octen 值得重點測試;已經深度使用 OpenAI 生態的團隊可以直接用內置 Web Search,但要接受它的執行流程不可控。實際落地時,我們建議通過 API易 apiyi.com 統一調用回答模型,把搜索工具做成可插拔模塊,這樣換搜索 API 時不用改模型側的代碼。
極簡示例:模型側走統一接口
下面的代碼固定回答模型,把搜索工具聲明爲函數,具體由哪家 Search API 實現,在本地代碼中替換即可:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,模型可替換
)

tools = [{"type": "function", "function": {
    "name": "web_search",
    "description": "聯網搜索,返回最多10條結果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 換成你要評測的模型
    messages=[{"role": "user", "content": "Exa 3.0 是哪天發佈的?"}],
    tools=tools,
)
print(resp.choices[0].message)
查看完整代碼:同一模型 A/B 對比多個搜索 API
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"   # 固定回答模型,保持控制變量
MAX_TURNS = 25          # 與 Search Index 一致的輪次上限

# 各家搜索 API 的適配函數,按官方文檔自行實現
def search_provider_a(query: str) -> list:
    return []  # 返回 [{"title":..., "url":..., "snippet":...}]

def search_provider_b(query: str) -> list:
    return []

TOOLS = [{"type": "function", "function": {
    "name": "web_search",
    "description": "聯網搜索,返回最多10條結果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

def run_task(question: str, search_fn) -> dict:
    messages = [{"role": "user", "content": question}]
    start, searches = time.time(), 0
    for _ in range(MAX_TURNS):
        resp = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS)
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return {"answer": msg.content, "searches": searches,
                    "seconds": round(time.time() - start, 1)}
        messages.append(msg)
        for call in msg.tool_calls:
            query = json.loads(call.function.arguments)["query"]
            results = search_fn(query)[:10]
            searches += 1
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": json.dumps(results, ensure_ascii=False)})
    return {"answer": None, "searches": searches,
            "seconds": round(time.time() - start, 1)}

for name, fn in [("A", search_provider_a), ("B", search_provider_b)]:
    print(name, run_task("Perplexity 何時推出獨立 Search API?", fn))
🚀 快速開始:新用戶可以在 API易 apiyi.com 領取免費測試額度,先用少量業務問題跑通上面的 A/B 腳本,再決定把哪家搜索 API 納入正式方案。
常見問題 FAQ
Q1:什麼是 Search Index?
Search Index 是 Artificial Analysis 推出的搜索 API 評測指數。它固定回答模型和 Agent 框架,只替換搜索服務,用 DeepSearchQA、BrowseComp、AA-Omniscience 三項基準的等權平均分衡量搜索效果,滿分 100。
Q2:83 分是不是表示答對率 83%?
不是。83 是三項基準分數的平均值,三項的指標也不一樣:DeepSearchQA 用 F1,另外兩項用準確率。Keenable Pro 三項依次爲 88、87、73,平均約 82.67,顯示爲 83。
Q3:榜單數據是什麼時候的?
質量分和費用數據來自 2026-11-09 榜單更新,完整任務耗時採用 2026-11-13 讀取的值。榜單會持續更新,引用時應註明日期。
Q4:榜單裏的耗時能當作搜索 API 的響應速度嗎?
不能。表中的耗時是一個標準任務的完整耗時,包括多輪搜索、網頁讀取和模型推理。單次 HTTP 延遲需要單獨測量,最好同時記錄 P50 和 P95。
Q5:如何快速對比不同搜索 API 在我業務裏的效果?
固定一個回答模型,只替換搜索工具。可以通過 API易 apiyi.com 用 OpenAI 兼容接口調用模型,把 base_url 設爲 `https://api.apiyi.com/v1`,再套用本文的 A/B 腳本。如果還想看換模型之後搜索效果的變化,同一個 Key 可以切換 OpenAI、Claude、Gemini 等模型。
Q6:Search Index 有哪些侷限?
主要有四點:它不是中文互聯網專項基準;OpenAI 原生搜索的執行流程與其他配置不同;429、5xx、超時等錯誤經重試後不計入結果,不能反映生產環境的穩定性;費用基於評測任務估算,與你的真實賬單可能不一致。中文新聞和國產技術文檔檢索,建議另建測試集,並通過 API易 apiyi.com 結合國產模型一起驗證。
Search Index 搜索 API 選型 Key Takeaways
- 搜索是獨立變量:同一模型從 33 分提升到 83 分,搜索 API 的選擇直接影響 Agent 的質量。
- 83 分不是正確率:它是三項基準的等權平均,計分口徑各不相同。
- 耗時看完整任務:Keenable 約 16 秒,Exa Auto 約 37 秒,都不是單次 API 延遲。
- 成本要拆開看:搜索費低可能換來模型費高,應以單任務總費用比較。
- 1 分可能差 34%:Exa Lite 與 Auto 只差 1 分,前者便宜約三成多。
- 榜單隻做初篩:中文、編程文檔等場景需要用自己的任務做二次 A/B 對比。
總結
這份 Search Index 榜單最有價值的地方,是用“同一模型、不同搜索工具”的設計,把搜索質量對 Agent 的影響單獨測了出來:
- 質量:無搜索 33 分,最高 83 分。即使都接了搜索,配置之間也有約 14 分的差距;
- 速度:同爲 80 分,完整任務耗時可以相差 5 秒以上;高分配置也可以很快;
- 成本:Keenable Pro 質量最高,成本處於中等;Exa Lite、Octen 在成本效率上表現突出;DeepSeek Summary 的例子說明低搜索費不等於低總成本。
建議先用榜單選出 3–4 個候選,再在自己的問題集上固定模型做 A/B 測試。推薦通過 API易 apiyi.com 統一調用回答模型,把搜索工具做成可替換模塊,用質量、速度、成本三項數據來定最終方案。
參考資料
- Artificial Analysis Search API 榜單:質量分、費用與耗時數據
- 鏈接:
artificialanalysis.ai/agents/search-api -
說明:本文分數、費用與耗時的主要來源
-
Artificial Analysis Search API 評測方法:測試配置與計分規則
- 鏈接:
artificialanalysis.ai/methodology/search-api -
說明:包含模型、輪次、結果條數、重試規則等說明
-
Exa Pricing:Lite、Auto 等檔位定價
- 鏈接:
exa.ai/pricing -
說明:用於理解榜單中 Exa 不同模式的搜索費差異
-
Exa 3.0 公告:Lite 模式與 Dynamic Highlights
- 鏈接:
exa.ai/blog/exa-3 -
說明:2026-10-19 發佈,含廠商自測數據
-
OpenAI Web Search 文檔:Responses API 內置搜索工具
- 鏈接:
developers.openai.com/api/docs/guides/tools-web-search -
說明:瞭解 OpenAI 原生搜索的執行方式與參數
-
Perplexity Search API 定價:標準與 Fast 檔位
- 鏈接:
docs.perplexity.ai/docs/getting-started/pricing - 說明:瞭解按請求計費的規則
作者:API易 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心