
GPT、Claude、Kimi寫作測試摘要:先說判斷
英文文章優先試 GPT-6.1 Sol;強調文風的長稿優先試 Claude Opus 5.5;解釋科普值得加入 Kimi K3。 Kimi K3.1 Pro 的英文綜合表現也很強,與 GPT 在 ToneBench 中接近。
三份測試覆蓋的任務、語言和評價方法不同。最實用的結論是建立候選名單,再用自己的稿件驗證,而非給三個模型家族頒一座永久獎盃。
上手建議:可通過 API易 apiyi.com 的統一接口調用候選模型,用同一份資料包比較初稿。新用戶免費測試額度以平臺當前規則爲準。
GPT、Claude、Kimi寫作測試:後文會說什麼?
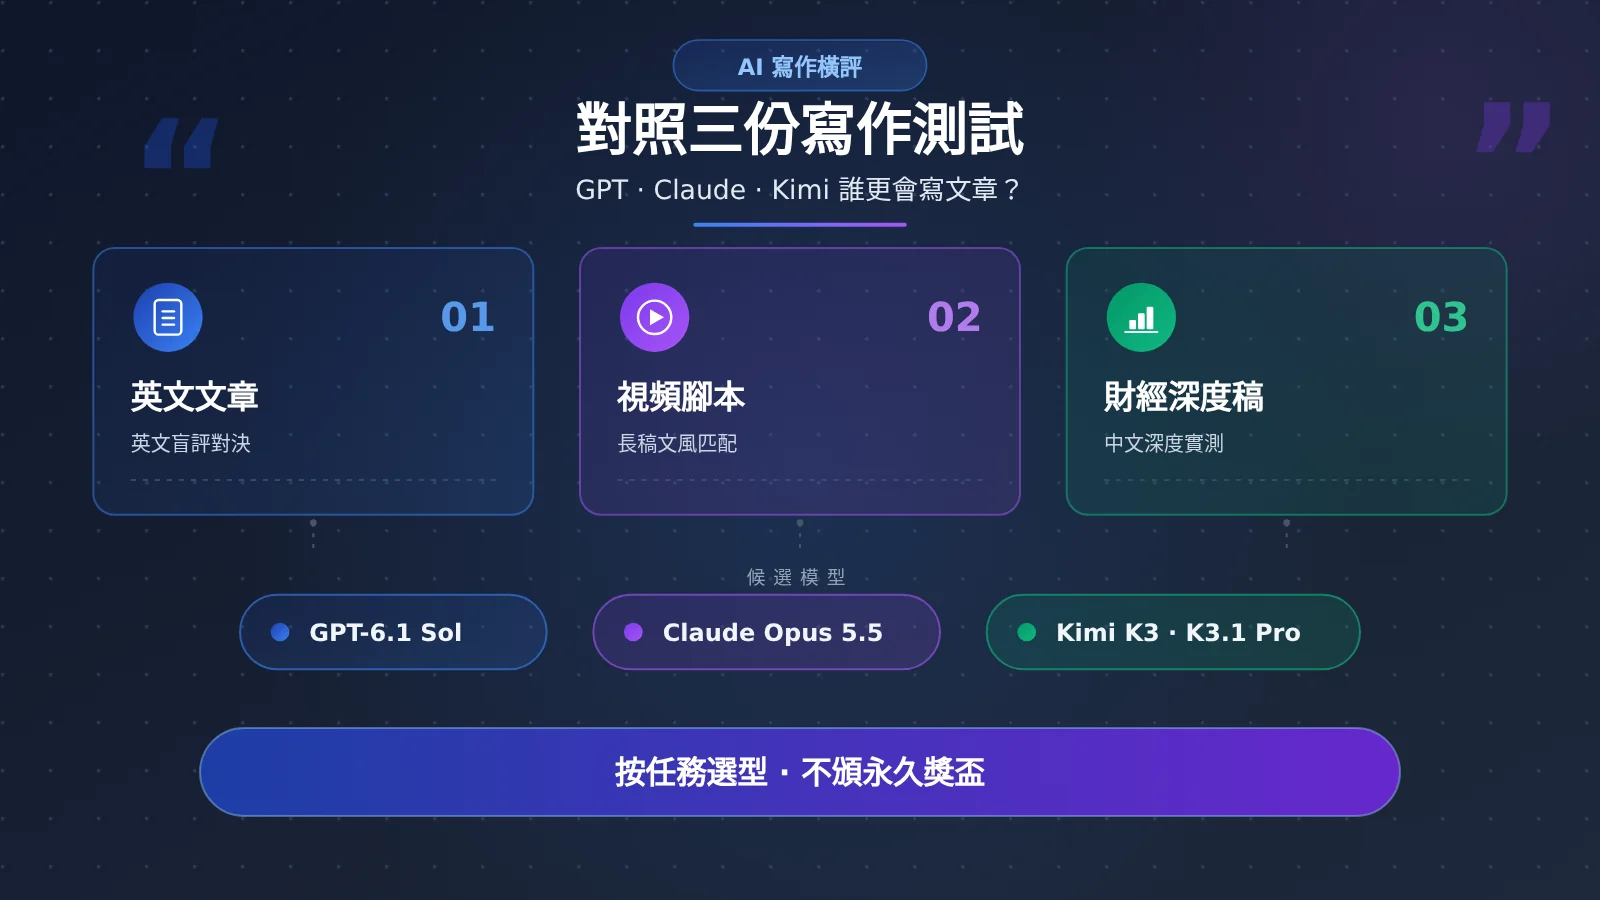
本文依次拆解英文寫作榜、風格化視頻長稿測試和中文財經深度稿實測。最後給出場景選擇、盲測步驟與調用示例,重點看文章質量和人工編輯成本。
先約定兩個術語:寫作基準是按既定任務評價輸出的測試;盲評是隱藏模型身份後比較文本。盲評可以由人或模型完成,閱讀結果時要分清評審是誰。
GPT、Claude、Kimi寫作測試一:英文文章看 GPT
AI Writing Benchmark 是 Johannes Eva 維護的英文寫作項目,聲明未接受模型廠商付費。本文采用 2026 年 11 月 11 日更新、11 月 12 日查詢的結果。
項目覆蓋 115 款模型,記錄 131,507 次公開盲評對決。它通過匿名文本比較評價寫作,AI 評審排名與人類投票排名分別展示。
| 模型 | 英文綜合得分 | 結果口徑 |
|---|---|---|
| GPT-6.1 Sol | 95.3 | 綜合榜第一 |
| Claude Opus 5.5 | 92.9 | 綜合榜第二 |
| Kimi K3.1 Pro | 91.9 | 綜合榜第三 |
綜合得分彙總多類任務;任務分類得分只反映某類題目。GPT-6.1 Sol 在文章、博客、編輯類內容中的分類得分爲 98.5,需要與綜合分 95.3 分開記錄。
這些是基準內部的相對分數。項目把 50 定義爲擊敗當前語言和類別平均模型的估計概率爲二分之一,讀者應關注競爭位置,而非把分數當成可發佈內容比例。
直白地說:若任務是英文博客或編輯類文章,GPT-6.1 Sol 有充分理由進入首輪測試。 至於中文文章,需要另找中文證據。
另一個值得關注的結果是:Kimi K3 在解釋與科普分類中以 94.9 領先。這裏獲勝的是 K3,綜合榜第三則是 K3.1 Pro,版本名要跟成績一起保存。
GPT、Claude、Kimi寫作測試二:長稿文風看 Claude
ToneBench 讓模型讀取創作 Brief、研究資料包和風格指南,再生成完整 YouTube 腳本。模型看不到原作者成稿,也不能聯網或調用外部工具。
本文采用 2026 年 11 月 10 日更新的資料。任務是特定創作者的視頻長稿;所給資料未明確列出全部任務語種,因此這裏按腳本場景解讀。
測試包含 87 款模型、151 種配置,每種配置完成 10 項任務,每項獨立生成 5 次。共生成 7,550 份稿件,由四名 AI 評審完成 30,200 次評分。
它尤其關注風格匹配,即語氣、節奏和表達方式是否接近目標創作者。文風匹配權重爲 19%,內容深度、準確性與價值爲 15%,還評價連貫性和篇幅控制。
下表採用各模型最佳配置的 Writing Score,以及資料列出的模型排名。Claude 對應 xhigh;資料未給出另兩款的具體推理配置名稱,複測時應補齊。
| 模型 | 模型排名 | Writing Score | 測試估算單篇成本 |
|---|---|---|---|
| Claude Opus 5.5 | 1 | 85.8 | $1.003 |
| GPT-6.1 Sol | 8 | 82.4 | $0.239 |
| Kimi K3.1 Pro | 9 | 82.5 | $0.251 |
Writing Score 是該測試彙總寫作表現的指標,排名則涉及 Elo 口徑。因此,Kimi 分數高 0.1、排名低一位,應理解爲兩者表現接近。
Claude 在這組結果中領先,測試估算成本約爲 GPT 的 4.2 倍。這是 ToneBench 的成本估算,不能直接套用爲其他平臺的文章報價。
爲了理解排名,最好把任務和評審也放在同一張圖裏。通過 API易 apiyi.com 複測時,建議保留配置記錄,再回到原榜單核對比較口徑。
ToneBench 的第一、第二名置信區間重疊,移除任意一份參考腳本也會改變榜首。研究還發現評審存在一定廠商偏好,不過排除單位評審後 Claude 仍居首。
核心判斷是:需要吸收資料、維持創作者聲音的長稿,Claude 值得優先試。 這個結果適合指導候選選擇,優勢幅度仍需自己的稿件驗證。
另需留意,GPT-6 Sol 的 Least Slop 單項成績屬於另一版本、另一指標,不能拿來替換 GPT-6.1 Sol 的 Writing Score。
GPT、Claude、Kimi寫作測試三:中文深稿看什麼?
OmniTools 的測試發生於 2026 年 10 月 26 日至 11 月 3 日,對象爲 PANews 中文財經深度稿。它比較了 10 款模型、26 篇文章。
| 模型 | AI 盲評分 | 測試篇數 | 自然度評分 |
|---|---|---|---|
| Claude Opus 5.5 | 8.25 | 7 | 8.3 |
| GPT-6.1 Sol | 6.33 | 3 | 5.5 |
這項測試中,Claude 的整體評分和自然度更高。對於中文財經深度稿,Claude Opus 5.5 是更值得先試的候選。
但樣本少、各模型篇數不均衡,而且 Kimi 未參與。因此,這份資料只能補充 GPT 與 Claude 的中文場景證據,無法給出三者完整的中文排名。
評審使用 Claude Opus 5.5 和 DeepSeek V4 Pro,並設置不評審自身模型的規則。發佈方具有 API 路由服務商業背景,閱讀時應保留這一來源信息。
編輯評價是另一套記錄。Claude 的 100% 編輯採用率僅對應 1/1 輪,適合當案例觀察;長期採用情況仍需更多稿件支持。
一句話總結:這裏提供了 Claude 寫中文財經長稿的積極信號,證據範圍就落在這個場景裏。
GPT、Claude、Kimi寫作測試:按場景選候選
把三份結果放在一起,應該形成一張選型表,而不是把分數相加。文章語言、任務和目標文風,決定哪些證據與你有關。
| 寫作場景 | 優先候選 | 選擇依據 |
|---|---|---|
| 英文博客、編輯類文章 | GPT-6.1 Sol | 英文文章分類領先 |
| 創作者風格視頻長稿 | Claude Opus 5.5 | ToneBench 當前領先 |
| 中文財經深度稿 | Claude Opus 5.5 | 中文小樣本實測領先 |
| 英文解釋、科普 | Kimi K3 | 解釋與科普分類領先 |
| 資料包驅動的長內容 | 三款共同盲測 | GPT 與 Kimi 在 ToneBench 接近 |
| 調用驗證平臺 | API易 apiyi.com | 統一接口便於切換模型 |
中文技術教程、產品介紹等場景,現有三份證據沒有完整覆蓋。更穩妥的做法是同時測試候選,看誰能把技術講清楚、把事實寫準確。
GPT、Claude、Kimi寫作測試:如何自己做對照?
建議選擇真實選題,給各模型完全相同的資料、策劃、篇幅和工具權限。每款獨立生成至少三次,隱去模型名後交給編輯評價。
評分可從五項開始:事實準確性、策劃執行、表達自然度、結構清晰度、內容價值。權重由團隊任務決定,並標明這是自建規則。
再記錄人工編輯成本:修改到可發佈狀態所需的工作量。最好同時記錄修改時間、重寫段落、事實錯誤和最終採用情況。
配置建議:在 API易 apiyi.com 使用一個 API Key 切換模型,可減少重複接入工作。測試時保留模型版本、參數與實際 Token 用量,方便復現。
下面是最小調用示例。把相同的實際資料包放入 brief,切換模型名即可生成對照初稿;密鑰應由運行環境安全提供。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

brief = """請依據以下資料和策劃生成文章。
只使用資料支持的事實,遵守目標篇幅與文風。
這裏替換爲各模型共同使用的實際資料包和策劃。
"""

for model in [
    "gpt-6.1-sol",
    "claude-opus-5-5",
    "kimi-k3.1-pro",
]:
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": brief}],
    )
    print(model, result.choices[0].message.content)
這段代碼用於起步,正式盲測還應重複生成、匿名呈現並記錄配置。若要驗證解釋分類的領先模型,需要額外加入 Kimi K3。
GPT、Claude、Kimi寫作測試 FAQ
GPT、Claude、Kimi寫作測試中,Kimi 應該測哪個版本?
解釋科普優先加入 Kimi K3;比較本文綜合榜與 ToneBench 結果時使用 K3.1 Pro。通過 API易 apiyi.com 調用前,覈對模型列表和具體模型名,避免版本串線。
GPT、Claude、Kimi寫作測試中,怎樣比較實際費用?
比較“單篇合格成本”:累計調用費用加上編輯工作量。在 API易 apiyi.com 測試時,記錄實際用量與重試次數,再按當時價格覈算,比只看初稿費用更貼近生產。
GPT、Claude、Kimi寫作測試結尾:選更省編輯的模型
英文文章先試 GPT,風格化長稿和中文財經深稿先試 Claude,解釋科普加入 Kimi。 這些是具體任務下的優先順序,而非整個模型家族的永久排名。
推薦通過 API易 apiyi.com 用同一資料包驗證效果。最終選誰,就看誰更準確地完成策劃、保留更多可用段落,讓編輯少加一輪班。
GPT、Claude、Kimi寫作測試參考資料
-
AI Writing Benchmark:aiwritingbenchmark.com
英文綜合榜與分類榜,採用 2026 年 11 月 11 日更新口徑。 -
Towards AI ToneBench:benchmark.towardsai.com/models/
視頻腳本測試、模型排名、配置與成本估算,採用 2026 年 11 月 10 日資料。 -
OmniTools 深度長文寫作實測:omnitools.ai/evals/longform-writing
PANews 中文財經深度稿測試,測試期爲 2026 年 10 月 26 日至 11 月 3 日。
作者:API易技術內容團隊。歡迎通過 API易 apiyi.com 交流模型配置、盲測方法與編輯經驗。


