Примечание автора: в рейтинге Artificial Analysis Search Index за 2026-11-09 видно, что если зафиксировать одну модель для ответов и менять только конфигурацию поиска, итоговая оценка может меняться с 33 до 83 баллов. Правда, при выборе нужно ещё смотреть на стоимость задачи, время выполнения и границы оценки.
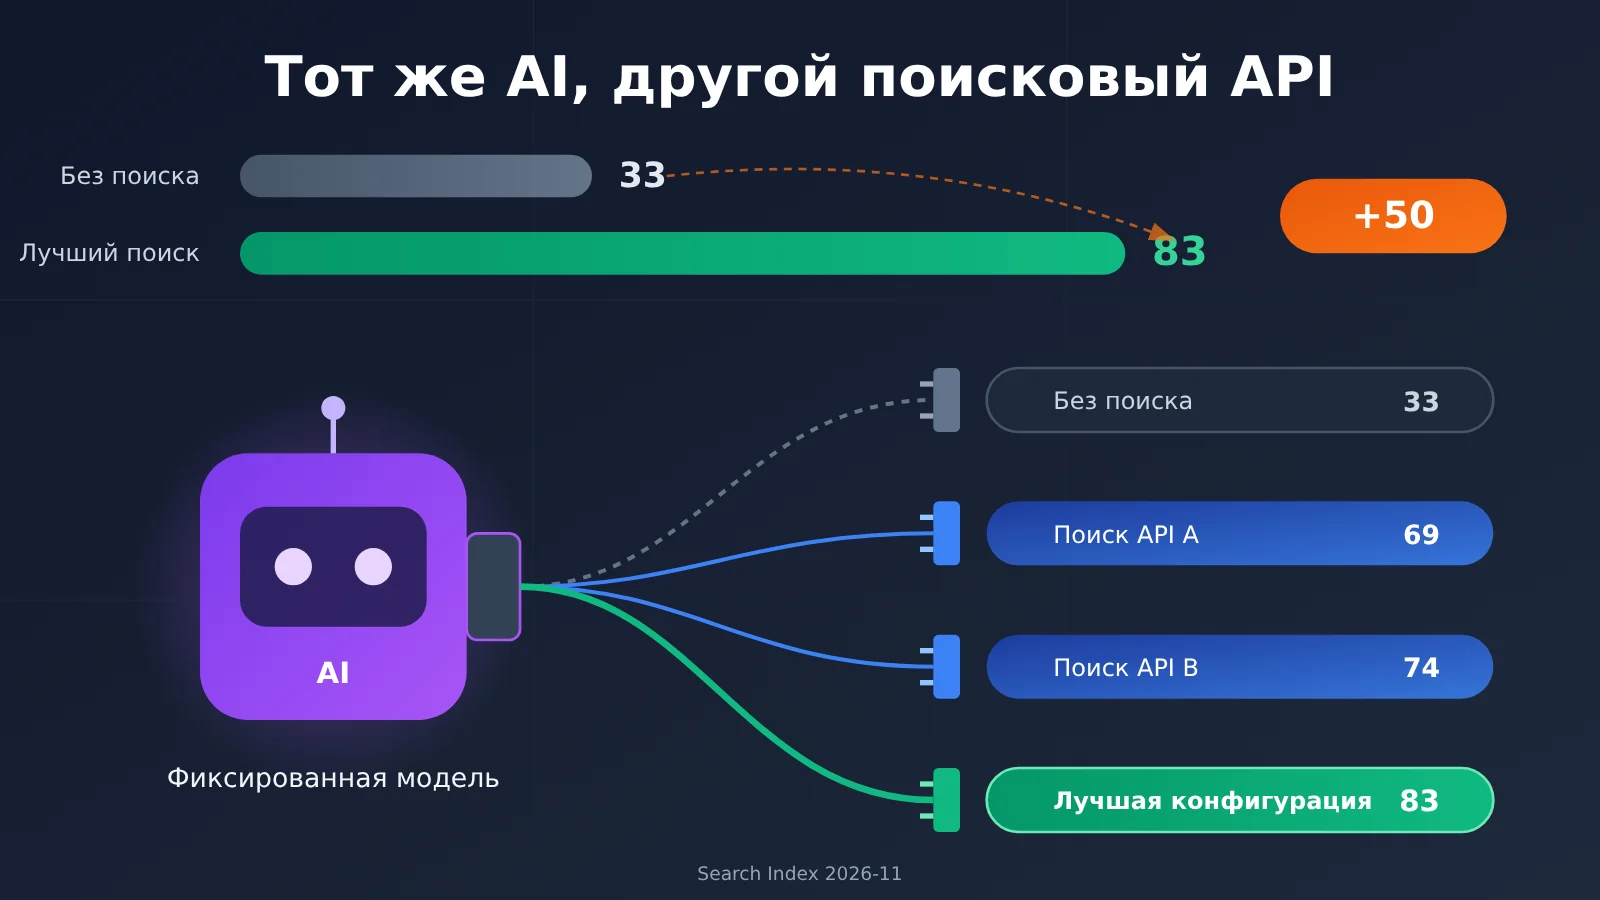
Многие при сборке агента сначала выбирают модель, а потом просто подключают какой-нибудь инструмент поиска. Во многих командах поиск воспринимают как аксессуар — «лишь бы был интернет». Search Index от Artificial Analysis, обновлённый 9 ноября 2026 года, показывает иную картину: одна и та же модель без поиска получает 33 балла, а с лучшей конфигурацией API поиска — 83 балла.
Это не очередной пересказ рейтинга в духе «у каждой модели свои сильные стороны». В статье мы разберём, как считаются 83 балла и в каких условиях проводились тесты, а также сравним качество, полное время выполнения задачи, расходы на поиск и на модель. В конце — по сценариям: для каких решений этот рейтинг годится, а где его нельзя применять напрямую.
Ключевая ценность: после прочтения вы сможете по публичному рейтингу отобрать кандидатов среди API поиска, а затем сделать повторное сравнение под свою задачу — чтобы не принимать решение, ориентируясь только на максимальный балл.
Термины, которые стоит знать перед чтением рейтинга Search API
Резюме в одну фразу: Search Index сравнивает работу одной и той же модели при разных конфигурациях поиска, и разница в баллах достигает 50. Но «высокий балл» не значит «лучше всего подходит именно вам» — ещё нужно смотреть на стоимость, время выполнения и охват оценки.
Прежде чем читать рейтинг, давайте договоримся о нескольких терминах:
- Search Index: сводная оценка, которая вычисляется по правилам на основе заданного поискового бенчмарка. В этой статье речь конкретно об индексе оценки поисковых API от Artificial Analysis, максимум — 100 баллов.
- F1: гармоническое среднее точности и полноты. Когда ответ представляет собой «набор сущностей», с его помощью измеряют, насколько ответ точный и полный.
- Harness: тестовый фреймворк, который организует входные данные модели, выполнение инструментов и оценку задач. Цикл агента, который использует Artificial Analysis, называется Stirrup.
- Search API: интерфейс, возвращающий по запросу результаты поиска — ссылки на веб-страницы, заголовки, релевантные фрагменты и т. п. Например, Exa, Brave, Perplexity Search API.
- Token: единица измерения текста, обрабатываемого моделью. Чем длиннее результаты поиска, тем больше токенов отправляется в модель и тем выше её стоимость.
Может ли поисковый API дать разницу в 50 баллов для одного и того же ИИ?
Artificial Analysis 18 августа 2026 года представила бенчмарк поисковых API. Последнее обновление публичных данных — 9 ноября 2026 года; охвачено 14 провайдеров и 26 продуктов или конфигураций Search API. Оценивается не модель, а реальный эффект от поискового сервиса, подключённого к агенту.
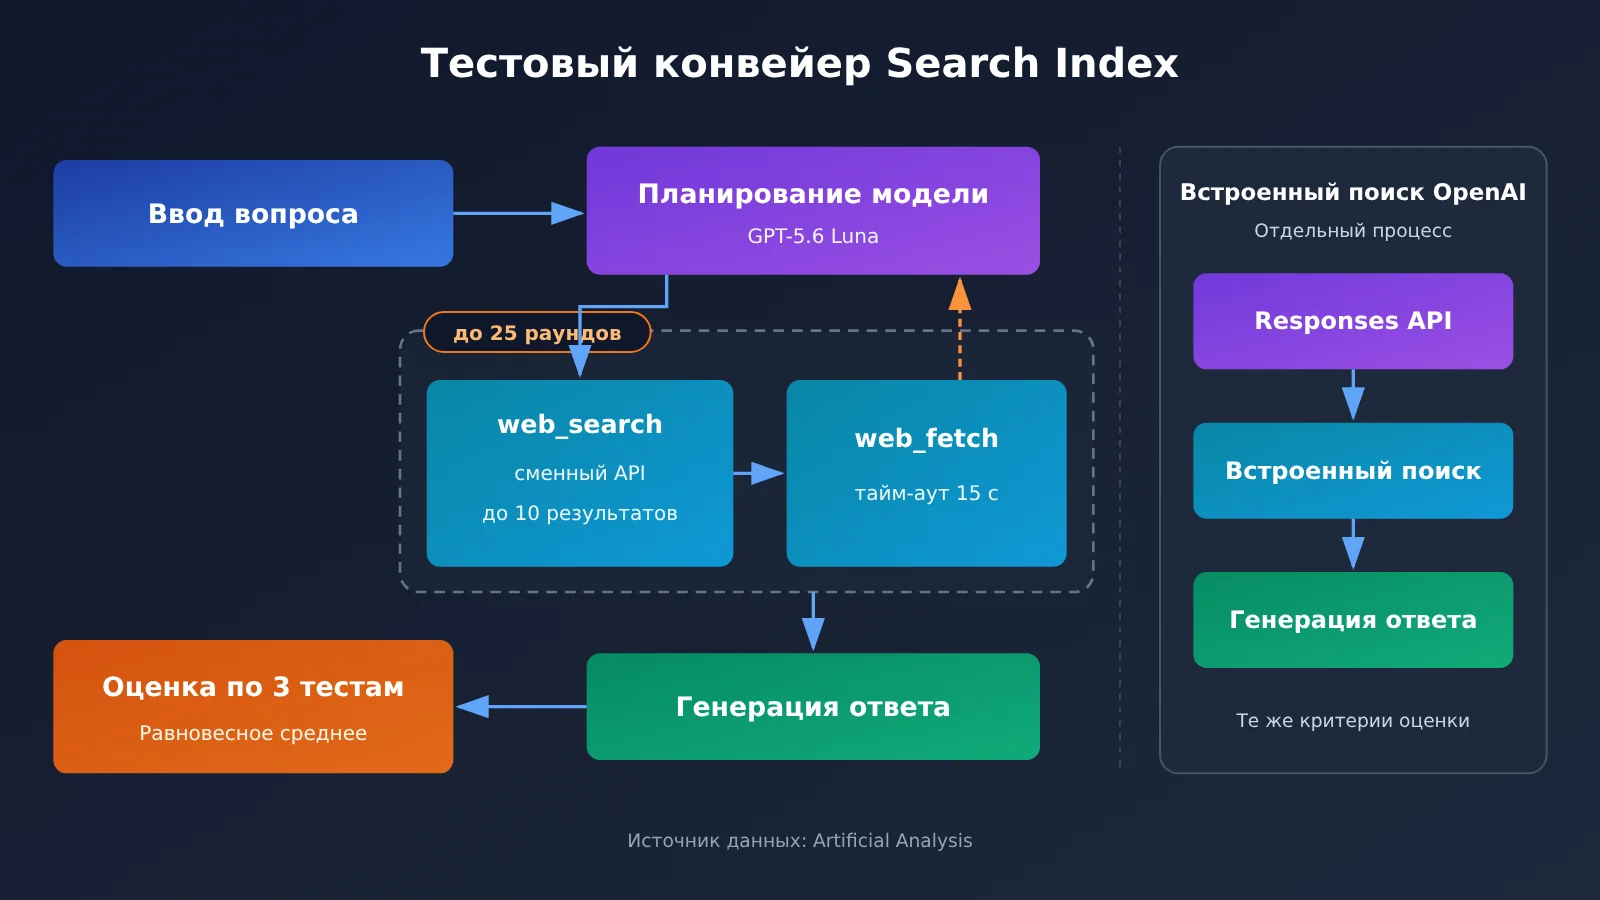
Ключ к дизайну эксперимента — «контроль переменных». Модель-ответчик фиксирована: GPT-5.6 Luna (medium), фреймворк агента тоже не меняется — заменяется только поисковый сервис. В этих условиях базовый уровень без поискового инструмента — всего 33 балла, а занявший первое место Keenable Pro — 83 балла, разница в 50 индексных пунктов. Даже между конфигурациями с подключённым поиском разрыв есть: от 69 баллов у DeepSeek Search Summary до 83 у Keenable Pro — 14 баллов.
Есть одно исключение, о котором стоит сказать отдельно: нативный Web Search от OpenAI работает иначе. Все прочие независимые Search API работают во внешнем цикле агента Artificial Analysis. А OpenAI Web Search использует встроенный инструментальный процесс Responses API, где количество поисков и способ выполнения определяет сам OpenAI. Поэтому его 74 балла можно воспринимать как ориентир, но не как эксперимент «замены API» в полностью одинаковых условиях.
И ещё: эти 50 баллов — эффект от поиска в рамках одной и той же системы оценки. Это не значит, что кто угодно с любой моделью, подключив поиск, получит прирост в 50 процентных пунктов.
Как на самом деле получаются 83 балла Search Index?
Три бенчмарка Search Index и способ подсчёта
Итоговый балл — это равновзвешенное среднее трёх бенчмарков, каждый даёт ровно треть:
| Бенчмарк | Объём заданий | Тип заданий | Метрика оценки |
|---|---|---|---|
| DeepSearchQA | 900 заданий | Сложные фактологические исследования, ответ часто представляет собой набор | F1 по набору ответов |
| BrowseComp | 200 заданий | Более сложные вопросы веб-поиска | Точность точного ответа |
| AA-Omniscience | 600 заданий | Фактологические вопросы | Точность ответов на фактологические вопросы |
Всего три бенчмарка дают 1 700 заданий, но итоговый балл — не общая доля правильных ответов по всем 1 700 вопросам. У Keenable Pro три оценки — 88, 87 и 73; среднее около 82,67, после округления — 83. Поэтому 83 балла не означают «83% правильных ответов».
Условия тестирования Search Index
В методологии опубликованы такие ключевые настройки:
| Параметр эксперимента | Фактическая настройка |
|---|---|
| Модель для ответов / модель-оценщик | GPT-5.6 Luna (medium) |
| Максимум раундов агента | 25 раундов, число вызовов инструментов внутри раунда не ограничено |
| Доступные инструменты | web_search, web_fetch (самостоятельное чтение веб-страниц) |
| Результатов на каждый поисковый запрос | не более 10 |
| Тайм-аут загрузки основного текста | 15 секунд на страницу |
| Что возвращается модели | Исходный ответ провайдера |
| Базовый вариант без поиска | Та же модель, без инструментов поиска |
Из этой таблицы видны два момента. Во-первых, модели возвращается «исходный ответ провайдера». Длина фрагментов, способ суммирования и организация подсветки попадают в контекст модели — значит, баллы отражают не только качество нижележащего веб-индекса, но и то, как организована информация. Во-вторых, фатальные ошибки вроде 429, 5xx или тайм-аута будут повторяться до успеха и не учитываются в итоговом результате. Получается, рейтинг измеряет качество при условии, что запрос успешно проходит, и его нельзя использовать как доказательство доступности или частоты сбоев у разных провайдеров в продакшене.
Актуальный рейтинг Search Index: у кого поисковый API работает лучше всех?
В таблице ниже оценки качества и результаты BrowseComp взяты из рейтинга от 2026-11-09. Значения времени — из рейтинга, считанного 2026-11-13: это среднее время выполнения стандартной тестовой задачи от начала до конца, а не сетевая задержка одного запроса к поисковому API.
| Конфигурация поиска | Итоговый балл (09.11) | BrowseComp | Среднее время задачи (13.11) |
|---|---|---|---|
| Keenable Pro | 83 | 87% | 16,6 сек. |
| Keenable Realtime | 82 | 86% | 16,0 сек. |
| Exa Auto + Dynamic Highlights | 80 | 83% | 36,7 сек. |
| Perplexity Search Medium | 80 | 87% | 31,1 сек. |
| Exa Lite + Dynamic Highlights | 79 | 81% | 19,4 сек. |
| Parallel Advanced | 75 | 77% | не указано в этом обновлении замеров времени |
| Brave LLM Context | 75 | 77% | не указано в этом обновлении замеров времени |
| OpenAI Web Search Medium (встроенный процесс Responses) | 74 | 74% | 33,1 сек. |
| DeepSeek Search Summary | 69 | 63% | 22,4 сек. |
| Базовый вариант без поиска | 33 | 17% | — |
Три типичных разрыва в рейтинге поисковых API
Одинаковый балл — разная скорость. У Exa Auto и Perplexity Medium по 80 баллов, но полное время выполнения задачи — 36,7 и 31,1 секунды соответственно. У Keenable Pro балл выше, а времени уходит всего около 16,6 секунды. Для агента, которому нужен отклик в реальном времени, такую разницу пользователь почувствует сразу.
BrowseComp не полностью повторяет итоговый балл. У Perplexity Medium BrowseComp достигает 87% — столько же, сколько у Keenable Pro, — но итоговый балл ниже на 3 пункта. Разрыв в основном возникает на двух других бенчмарках. Если ваш бизнес-сценарий ближе к «поиску по сложным веб-страницам», можно отдельно смотреть на столбец BrowseComp.
Разные режимы одного производителя сильно отличаются. Exa Lite и Exa Auto различаются всего на 1 балл, а по времени — почти вдвое. Поэтому стоит интерпретировать результаты по конкретному режиму продукта и не объединять Exa Lite и Exa Auto в один «балл Exa».
💡 Пояснение к данным: приведённые баллы — результаты стороннего тестирования Artificial Analysis, время — время выполнения стандартной задачи. Если хотите воспроизвести похожее сравнение на собственных бизнес-задачах, можно через APIYI apiyi.com зафиксировать одну модель для ответов, а затем по очереди подключить разные поисковые инструменты и провести A/B-тестирование.
Всегда ли поисковый API с самым высоким баллом — самый выгодный?
Artificial Analysis также опубликовал оценку стоимости каждых 1 000 эталонных задач и разделил её на плату за поиск и плату за модель (рейтинг от 2026-11-09, долл. США). Столбец «Стоимость за балл» редакция этой статьи вывела приблизительно как «общая стоимость ÷ итоговый балл». Это лишь ориентир для сравнения, а не официальный показатель.
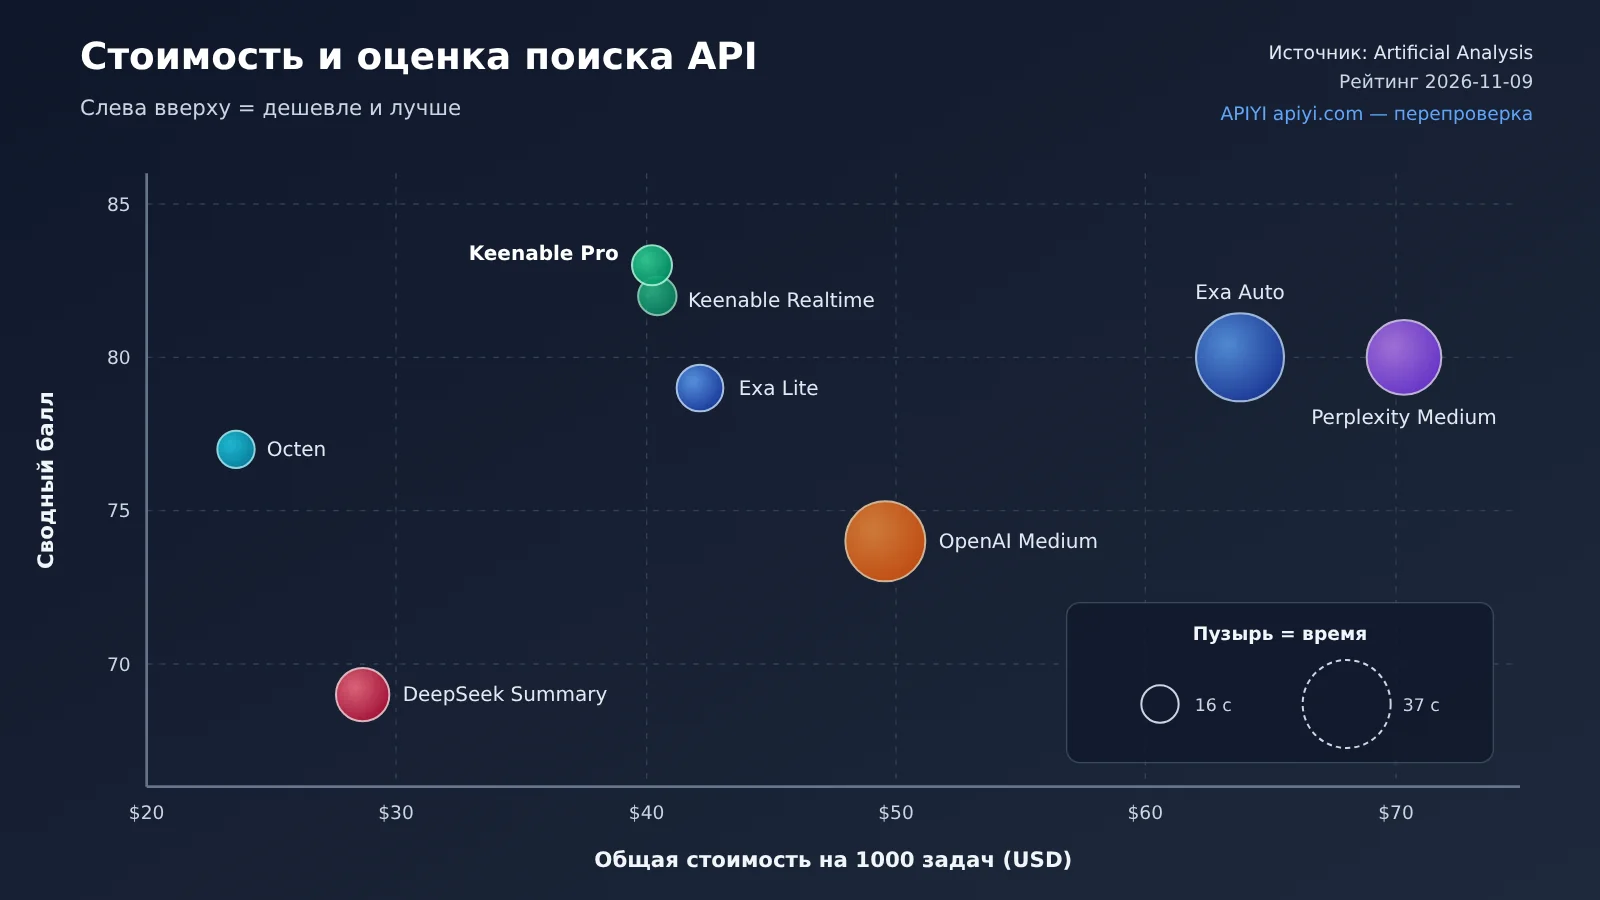
| Конфигурация поиска | Балл качества | Плата за поиск + плата за модель | Общая стоимость / 1 000 задач | Стоимость за балл (расчёт редакции) | Время выполнения задачи (11-13) |
|---|---|---|---|---|---|
| Keenable Pro | 83 | 31.87 + 8.35 | $40.22 | около $0.48 | 16.6 с |
| Keenable Realtime | 82 | 31.94 + 8.52 | $40.46 | около $0.49 | 16.0 с |
| Exa Auto + Highlights | 80 | 53.17 + 10.60 | $63.77 | около $0.80 | 36.7 с |
| Perplexity Medium | 80 | 62.30 + 8.04 | $70.34 | около $0.88 | 31.1 с |
| Exa Lite + Highlights | 79 | 31.20 + 10.95 | $42.15 | около $0.53 | 19.4 с |
| Octen Highlights | 77 | 9.07 + 14.50 | $23.57 | около $0.31 | 15.6 с |
| OpenAI Web Search Medium | 74 | 40.19 + 9.40 | $49.59 | около $0.67 | 33.1 с |
| DeepSeek Search Summary | 69 | 8.47 + 20.19 | $28.66 | около $0.42 | 22.4 с |
Три вывода из таблицы затрат на API поиска
Высший балл — не значит самая высокая цена. Keenable Pro занимает первое место с 83 баллами, стоит около $40.22 за тысячу задач — примерно $0.04 за задачу, что является средним уровнем в выборке. Perplexity Medium отстаёт на 3 балла, но общая стоимость выше примерно на 75%.
Разница в один балл может обернуться разницей в стоимости более чем на треть. Exa Lite + Highlights — 79 баллов и $42.15 за тысячу задач, Exa Auto + Highlights — 80 баллов и $63.77 за тысячу задач; первый вариант примерно на 34% дешевле, и времени он занимает меньше. Согласно официальной странице тарифов Exa (по данным на 2026-11-13), тариф Lite — $4 за 1,000 запросов, тариф Auto — $7 за 1,000 запросов. Разница в стоимости поиска в рейтинге соответствует этой структуре тарифов.
Низкая плата за поиск может означать более высокую плату за модель. У DeepSeek Search Summary плата за поиск всего $8.47, но плата за модель достигает $20.19 — это самый высокий показатель в таблице. У Octen самая низкая общая стоимость, но плата за модель тоже выше, чем у Keenable, Exa и Perplexity. Если результаты поиска недостаточно эффективны, агент выполняет больше поисковых запросов и просматривает больше страниц, а расход токенов растёт. Поэтому при расчёте затрат стоит считать «общую стоимость выполнения одной задачи», а не смотреть только на цену одного вызова поискового API.
Какие практические решения помогает выбрать этот рейтинг Search Index?
Search Index — это универсальный бенчмарк для поиска фактов с преобладанием английского языка, а не специализированный тест для китайского интернета. Ниже мы сопоставим его с типичными сценариями Agent и отметим, для каких случаев можно ориентироваться на него напрямую, а где нужны дополнительные тесты.
| Сценарий Agent | Ключевая метрика | Ценность рейтинга | Рекомендуемые кандидаты |
|---|---|---|---|
| Вопросы на факты | Точность, корректность цитирования | Высокая, можно напрямую ориентироваться на AA-Omniscience | Keenable, Exa Lite, Perplexity |
| Сложные многоисточниковые исследования | Многошаговый поиск, полнота召回 множества | Высокая, обращайте внимание на DeepSearchQA и BrowseComp | Keenable Pro, Exa Auto, Perplexity Medium |
| Agent с низкой задержкой | Время выполнения полной задачи, задержка P95 | Средняя, время выполнения задачи можно использовать только как ориентир | Keenable Realtime, Octen, Exa Lite |
| Поиск информации на китайском | Покрытие китайских источников, доступность сайтов внутри страны | Низкая, нужен собственный китайский тестовый набор | Добавить Baidu Qianfan, Bocha, Alibaba Cloud Bailian для сравнения |
| Поиск по документации для программирования | Покрытие официальной документации, информация о версиях | От низкой до средней, нужно повторно тестировать на реальных технических вопросах | Exa, Perplexity, Parallel |
Как использовать Search Index для повторного сравнения поисковых API
Более разумный подход — воспринимать публичный рейтинг как «инструмент первичного отбора», а затем проводить второй этап сравнения на собственных задачах:
- По трём критериям — качество, время выполнения и общая стоимость — выберите из рейтинга 3–4 кандидатные конфигурации;
- Подготовьте 50–100 собственных бизнес-вопросов, охватывающих простые факты, свежие новости, многошаговые вопросы, запросы на китайском и кросс-языковые запросы;
- Фиксируйте одну и ту же модель для ответов, одинаковое максимальное число раундов и количество результатов, заменяя только поисковый инструмент;
- Записывайте точность, корректность цитирования, общую стоимость одной задачи, время выполнения P50/P95, а также количество пустых результатов и таймаутов;
- Стабильность в продакшене проверяйте отдельным нагрузочным тестированием, поскольку рейтинг уже исключает фатальные ошибки после повторных попыток.
Рекомендации по выбору поискового API и быстрый старт
🎯 Рекомендации по выбору: если важны общее качество и скорость — в первую очередь тестируйте Keenable Pro/Realtime; если бюджет ограничен, но хочется качество близкое к 80 баллам — стоит присмотреться к Exa Lite + Highlights и Octen; командам, которые уже глубоко в экосистеме OpenAI, можно сразу использовать встроенный Web Search, но придётся смириться с тем, что его процесс выполнения неконтролируем. На практике мы рекомендуем вызывать модель ответов через APIYI apiyi.com единообразно, а поисковый инструмент делать подключаемым модулем — тогда при смене поискового API не придётся менять код на стороне модели.
Минимальный пример: единый интерфейс со стороны модели
В приведённом ниже коде модель для ответов фиксирована, а инструмент поиска объявлен как функция; какую именно Search API использовать — достаточно подставить в локальном коде:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI, модель можно заменить
)

tools = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Здесь подставьте модель, которую хотите тестировать
    messages=[{"role": "user", "content": "Exa 3.0 是哪天发布的?"}],
    tools=tools,
)
print(resp.choices[0].message)
Посмотреть полный код: A/B-сравнение нескольких Search API на одной модели
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"   # Фиксированная модель для ответов, чтобы сохранить контроль переменных
MAX_TURNS = 25          # Тот же лимит числа шагов, что и в Search Index

# Функции-адаптеры для Search API разных провайдеров — реализуйте по официальной документации
def search_provider_a(query: str) -> list:
    return []  # Возвращает [{"title":..., "url":..., "snippet":...}]

def search_provider_b(query: str) -> list:
    return []

TOOLS = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

def run_task(question: str, search_fn) -> dict:
    messages = [{"role": "user", "content": question}]
    start, searches = time.time(), 0
    for _ in range(MAX_TURNS):
        resp = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS)
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return {"answer": msg.content, "searches": searches,
                    "seconds": round(time.time() - start, 1)}
        messages.append(msg)
        for call in msg.tool_calls:
            query = json.loads(call.function.arguments)["query"]
            results = search_fn(query)[:10]
            searches += 1
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": json.dumps(results, ensure_ascii=False)})
    return {"answer": None, "searches": searches,
            "seconds": round(time.time() - start, 1)}

for name, fn in [("A", search_provider_a), ("B", search_provider_b)]:
    print(name, run_task("Perplexity 何时推出独立 Search API?", fn))
🚀 Быстрый старт: новые пользователи могут получить бесплатный тестовый лимит в APIYI apiyi.com — сначала прогоните приведённый выше A/B-скрипт на нескольких рабочих вопросах, а потом решайте, какую Search API включить в основной план.
Частые вопросы (FAQ)
В1: Что такое Search Index?
Search Index — это индекс оценки поисковых API, представленный Artificial Analysis. В нём фиксируются модель, дающая ответ, и агентный фреймворк, а подменяется только поисковый сервис. Эффективность поиска измеряется средним с равными весами по трём бенчмаркам — DeepSearchQA, BrowseComp и AA-Omniscience — по 100-балльной шкале.
В2: Означают ли 83 балла, что доля правильных ответов — 83%?
Нет. 83 — это среднее трёх оценок по бенчмаркам, причём метрики у них разные: в DeepSearchQA используется F1, в двух других — точность. У Keenable Pro три оценки — 88, 87 и 73, в среднем около 82,67, что отображается как 83.
В3: На какую дату данные в рейтинге?
Оценки качества и затрат взяты из обновления рейтинга от 2026-11-09, полное время выполнения задачи — значения, считанные 2026-11-13. Рейтинг обновляется постоянно, поэтому при цитировании указывайте дату.
В4: Можно ли время из рейтинга принимать за скорость отклика поискового API?
Нет. Указанное в таблице время — это полное время выполнения стандартной задачи, включающее несколько поисковых проходов, чтение веб-страниц и вывод модели. Задержку отдельного HTTP-запроса нужно измерять самостоятельно, желательно фиксируя и P50, и P95.
В5: Как быстро сравнить эффективность разных поисковых API в моём бизнесе?
Фиксируйте одну модель для ответов и меняйте только поисковый инструмент. Через APIYI apiyi.com можно вызывать модели по OpenAI-совместимому интерфейсу, указав base_url `https://api.apiyi.com/v1`, а затем применить A/B-скрипт из этой статьи. Если хочется посмотреть, как меняется эффект поиска при смене модели, тот же ключ позволяет переключаться между OpenAI, Claude, Gemini и другими моделями.
В6: Какие ограничения есть у Search Index?
Есть четыре основных ограничения: это не специализированный бенчмарк для китайского интернета; процесс выполнения нативного поиска OpenAI отличается от остальных конфигураций; ошибки 429, 5xx и таймауты после повторных попыток не попадают в результат и не отражают стабильность в продакшене; затраты оцениваются по задаче бенчмарка и могут не совпадать с вашим фактическим счётом. Для поиска китайских новостей и технической документации на китайском рекомендуем создать отдельный тестовый набор и проверять его через APIYI apiyi.com в связке с китайскими моделями.
Ключевые выводы: выбор Search API в рейтинге Search Index
- Поиск — это независимая переменная: одна и та же модель поднимается с 33 до 83 баллов, и выбор поискового API напрямую влияет на качество агента.
- 83 балла — это не точность: это равновзвешенное среднее по трём бенчмаркам, причём методики подсчёта у них разные.
- Время считаем по всей задаче: Keenable — около 16 секунд, Exa Auto — около 37 секунд; это не задержка одного вызова API.
- Стоимость нужно разбирать по частям: низкая плата за поиск может обернуться высокой платой за модель, поэтому сравнивайте по общей стоимости одной задачи.
- 1 балл может означать разницу в 34%: Exa Lite и Auto различаются всего на 1 балл, но первый дешевле примерно на треть с лишним.
- Рейтинг — только для первичного отбора: для китайского языка, документации по программированию и подобных сценариев нужен свой A/B-тест на собственных задачах.
Итог
Самое ценное в этом рейтинге Search Index — дизайн «одна модель, разные поисковые инструменты», который позволил отдельно измерить, как качество поиска влияет на агента:
- Качество: без поиска 33 балла, максимум — 83. Даже когда поиск подключён везде, между конфигурациями остаётся разрыв примерно в 14 баллов;
- Скорость: при одинаковых 80 баллах время выполнения полной задачи может различаться более чем на 5 секунд; конфигурации с высоким баллом тоже могут быть быстрыми;
- Стоимость: Keenable Pro — лучшее качество при средней стоимости; Exa Lite и Octen выделяются эффективностью затрат; пример DeepSeek Summary показывает, что низкая плата за поиск не означает низкую общую стоимость.
Советую сначала по рейтингу отобрать 3–4 кандидата, а потом зафиксировать модель и провести A/B-тест на собственном наборе вопросов. Рекомендую вызывать модель ответов через APIYI apiyi.com единообразно, сделать поисковый инструмент заменяемым модулем и определять финальное решение по трём показателям: качество, скорость и стоимость.
Справочные материалы
- Рейтинг Artificial Analysis Search API: данные по качеству, стоимости и времени выполнения
- Ссылка:
artificialanalysis.ai/agents/search-api -
Описание: основной источник оценок, стоимости и времени выполнения в этой статье
-
Методология оценки Artificial Analysis Search API: конфигурация тестов и правила подсчёта баллов
- Ссылка:
artificialanalysis.ai/methodology/search-api -
Описание: включает описание моделей, раундов, количества результатов, правил повторных попыток и т. п.
-
Exa Pricing: цены на тарифы Lite, Auto и другие уровни
- Ссылка:
exa.ai/pricing -
Описание: помогает понять разницу в стоимости поиска между разными режимами Exa в рейтинге
-
Анонс Exa 3.0: режим Lite и Dynamic Highlights
- Ссылка:
exa.ai/blog/exa-3 -
Описание: опубликовано 2026-10-19, содержит данные собственного тестирования вендора
-
Документация OpenAI Web Search: встроенный инструмент поиска в Responses API
- Ссылка:
developers.openai.com/api/docs/guides/tools-web-search -
Описание: о том, как выполняется нативный поиск OpenAI и какие параметры используются
-
Цены Perplexity Search API: стандартный тариф и Fast
- Ссылка:
docs.perplexity.ai/docs/getting-started/pricing - Описание: о правилах оплаты за запрос
Автор: техническая команда APIYI
По техническим вопросам: свяжитесь с нами на главной странице сайта APIYI; больше материалов по подключению — в центре документации docs.apiyi.com