Nota do autor: com base nos dados de testes do Kimi K3, cujo código já foi aberto, estimamos os requisitos de hardware, o custo mensal, o custo por token e o ponto de equilíbrio para implantar o K3.1 Pro localmente. Assim, você pode decidir quando alugar, comprar ou simplesmente usar a API.
Vamos direto ao ponto: o Kimi K3.1 Pro está prestes a ser disponibilizado com pesos abertos, mas a implantação local não é para uso pessoal. A empresa informou que os pesos completos serão publicados até 4 de novembro. O modelo é descrito como um modelo de pesos abertos da classe de 3T. Em 26 de outubro de 2026, os pesos do K3.1 Pro ainda não haviam sido publicados. Todos os números de hardware e memória de GPU deste artigo são estimativas baseadas em testes com o Kimi K3, já disponibilizado com pesos abertos, e deverão ser revisados após a publicação dos pesos.
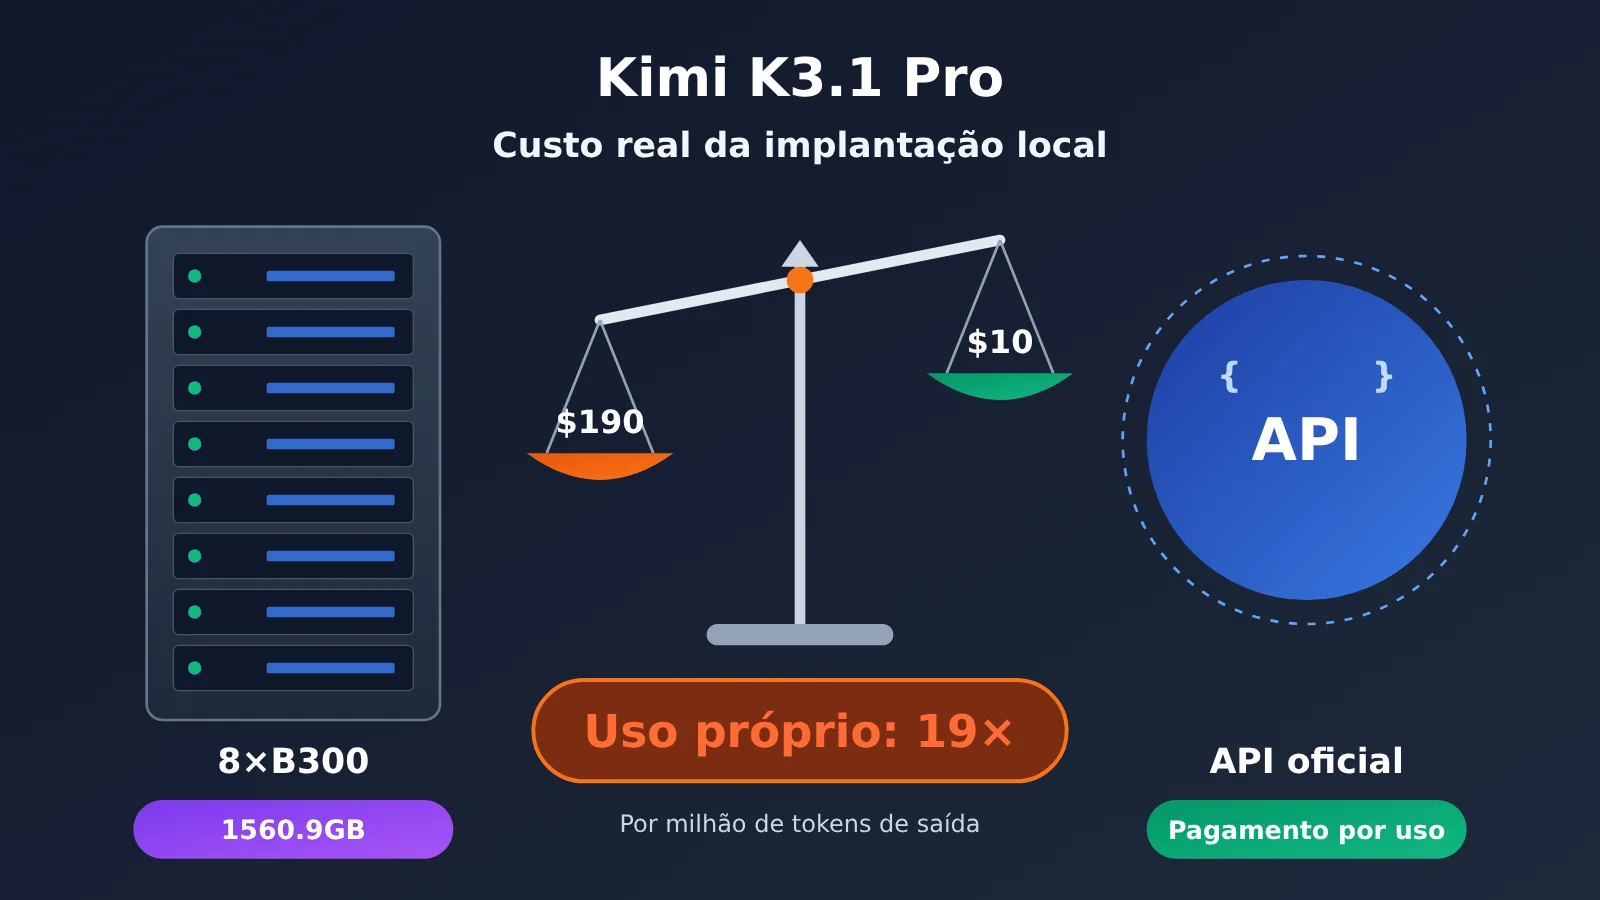
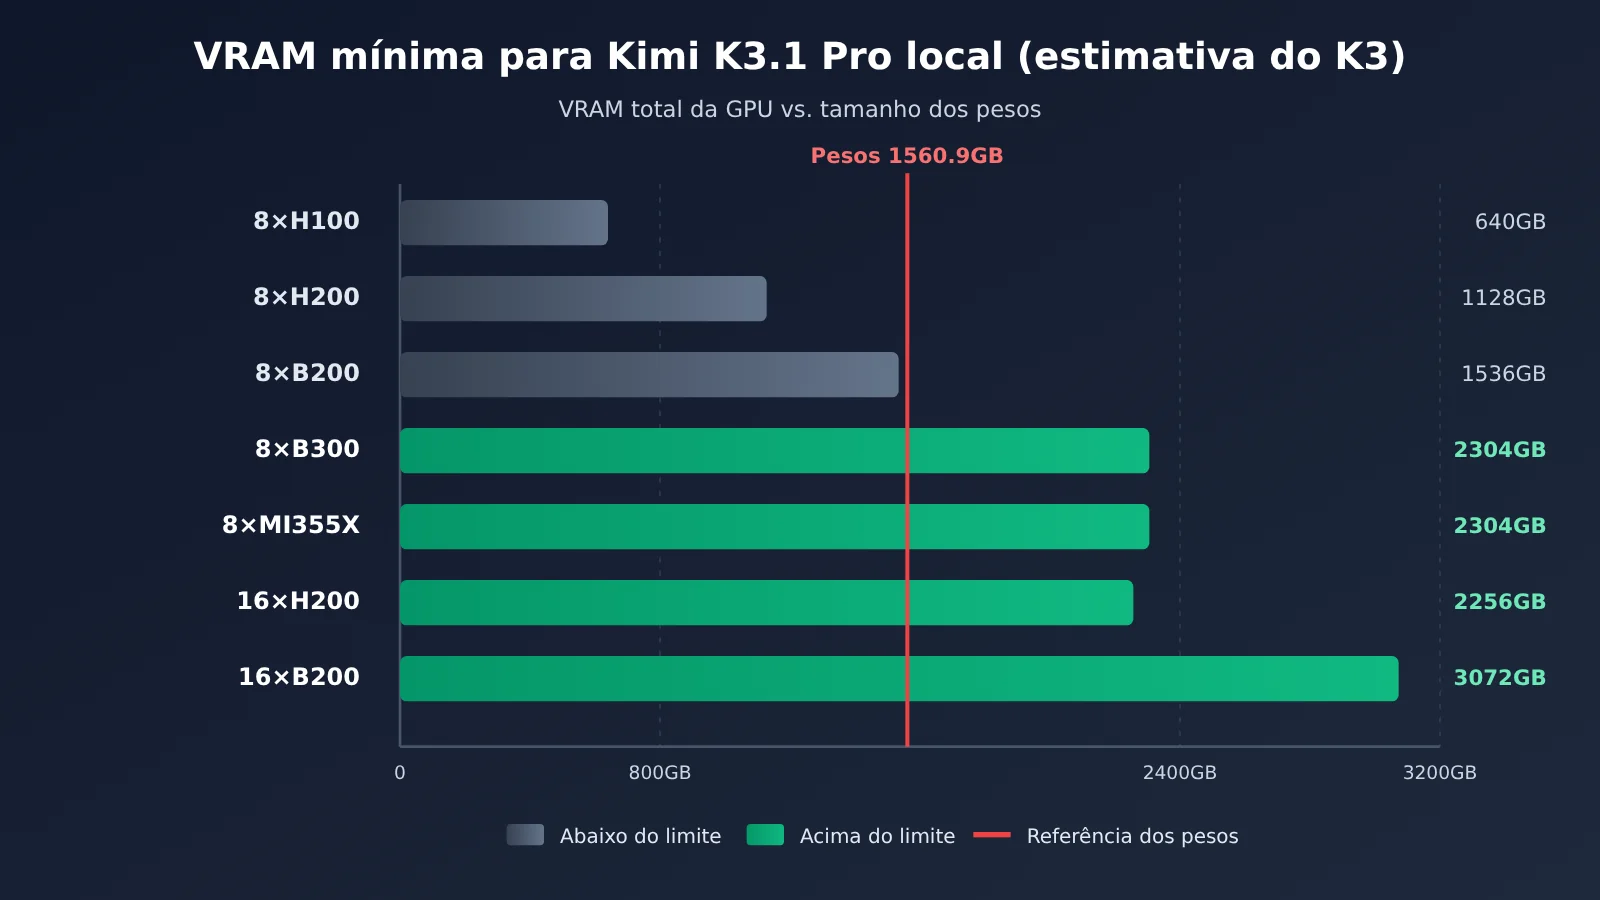
Nos testes com o K3, só os pesos ocupam 1560,9 GB. Oito GPUs B300 são suficientes, mas oito H200 ainda ficam cerca de 400 GB abaixo do necessário. Se uma máquina com 8×B300 for usada exclusivamente por você, o custo será de aproximadamente US$ 190,00 por milhão de tokens de saída — 19 vezes o preço da API oficial (US$ 10,00).
Este artigo não tem o objetivo de desencorajar você, mas de ajudar a decidir se vale a pena montar uma infraestrutura própria. Cada número indica se veio de uma fonte oficial, de testes de terceiros ou de uma estimativa deste artigo, para que você possa fazer as contas com base no volume da sua operação.
O principal benefício: ao terminar a leitura, você terá uma noção clara do custo real de executar o Kimi K3.1 Pro por conta própria e poderá usar a lista de verificação para decidir se deve alugar uma máquina, comprar uma ou simplesmente chamar a API.
Principais pontos sobre a implantação local do Kimi K3.1 Pro
| Ponto | Conclusão | Nível de evidência |
|---|---|---|
| Status dos pesos | Ainda não foram lançados; a declaração oficial diz que serão lançados antes de 4 de novembro | Texto oficial |
| Tamanho dos pesos | Os pesos do K3 ocupam 1.560,9 GB, e o K3.1 Pro mantém a mesma arquitetura | Testes de terceiros (K3) |
| Configuração mínima em uma máquina | 8×B300 / 8×GB300 / 8×MI355X | Configurações de frameworks de inferência + testes práticos |
| Custo unitário para uso próprio | Cerca de US$ 190,00 por milhão de tokens de saída | Fatura de testes de terceiros |
| Condição para igualar o custo da API | Manter uma saída estável acima de 1.500 tok/s por um longo período | Estimativa deste artigo |
Como interpretar os níveis de evidência sobre a implantação local do Kimi K3.1 Pro
Este artigo divide as informações em três níveis. Ao ler, fique atento às diferenças entre eles. Texto oficial se refere às declarações da Moonshot no blog kimi.ai, na documentação platform.kimi.ai e no cartão do modelo no Hugging Face. Testes de terceiros são dados de testes divulgados publicamente por usuários da AWS, GPUStack, OpenZeka e Modal, entre outros. As fontes e datas serão indicadas ao longo do texto. Estimativa deste artigo são cálculos feitos com base em preços e taxas de processamento públicos. As fórmulas e premissas serão informadas, e os valores não representam dados oficiais.
A estimativa também se baseia em informações oficiais: o K3.1 Pro é uma versão pós-treinada do Kimi K3 (post-trained version of Kimi K3) e mantém a mesma arquitetura, mas usa mais poder computacional no pós-treinamento com RL. Por isso, o número de parâmetros, o formato de quantização e o tamanho dos pesos do K3 podem servir como referência razoável para estimar os requisitos mínimos de implantação do K3.1 Pro.
Requisitos de hardware para implantar o Kimi K3.1 Pro localmente: por que o mínimo são 8 placas B300
【Informações oficiais】O cartão do modelo K3 informa: 2,8 T de parâmetros no total, 104 B de parâmetros ativos e 93 camadas; 896 especialistas roteados, dos quais 16 são selecionados para cada token, além de 2 especialistas compartilhados; janela de contexto de 1.048.576 tokens. Os pesos usam MXFP4 e as ativações, MXFP8. O treinamento com consciência de quantização é aplicado desde a etapa de SFT.
【Testes de terceiros】Alguém contou os arquivos do repositório no Hugging Face: os 96 fragmentos safetensors somam 1.560.936.091.448 bytes, ou cerca de 1.560,9 GB. O tamanho medido supera o valor teórico de “2,8 T × 0,5 byte = 1.400 GB” porque algumas partes listadas na lista de permissões da configuração — como camadas de atenção, especialistas compartilhados, lm_head e a torre visual — mantêm maior precisão. A configuração mínima de VRAM indicada pela receita do vLLM é de 1.680 GB, e ela especifica que são necessárias pelo menos 8×GB300. Para tráfego real de produção, são necessários vários nós.
| Configuração | VRAM total | Consegue executar? | Observações |
|---|---|---|---|
| 8×H100 80GB | 640GB | Não | Os pesos ocupam 2,4 vezes a VRAM disponível |
| 32×H100 | 2,56TB | Com dificuldade | O SGLang tem uma receita, mas a arquitetura Hopper não oferece suporte nativo a MXFP4; é preciso fazer a desquantização em tempo de execução |
| 8×H200 141GB | 1,13TB | Não | Faltam cerca de 400GB; é a opção que fica mais perto |
| 16×H200 (duas máquinas) | 2,26TB | Sim | Também exige desquantização |
| 8×B200 180GB | 1,44TB | Não | Faltam cerca de 120GB |
| 16×B200 / GB200 | 2,88TB | Sim | Configuração de referência Blackwell |
| 8×B300 / GB300 | 2,30TB | Sim | Caminho padrão oficial; cabe por pouco em uma única máquina |
| 8×MI355X | 2,30TB | Sim | Validação day-0 da AMD |
| Uma placa / RTX 4090 / Mac com 512GB | — | Não | Seriam necessárias 75 RTX 4090 para acomodar os pesos |
O cache KV, por outro lado, não é o gargalo. Apenas 24 camadas do K3 usam Gated MLA, com cerca de 27 KiB por token; as outras 69 camadas usam KDA e precisam apenas de um estado fixo por sequência. Os cálculos de terceiros estimam cerca de 29,5GB de cache KV para um usuário com contexto de 1M e aproximadamente 0,7GB para um contexto de 8K. O verdadeiro obstáculo são os próprios pesos, que ocupam 1,56TB.
Se ainda assim você quiser fazer a implantação, estes são os requisitos obrigatórios do lado dos frameworks (com base nas receitas do vLLM e no cookbook do SGLang para o K3):
- Imagem do vLLM:
vllm/vllm-openai:kimi-k3. Há apenas uma versão para CUDA 13, que exige driver r580 ou superior e vLLM ≥ 0.27.0. - Estratégias de paralelismo: TP / TEP exigem pelo menos 8 placas; DEP exige pelo menos 16. O cache KV distribuído está marcado como não suportado em todo o hardware listado.
- Planejamento de nós no SGLang: B300 usa 1 nó com 8 placas; B200 e H200 exigem 2 nós com 8 placas cada.
- Recomendação da Moonshot para agosto de 2026 (segundo relatos de terceiros): em produção, recomenda-se usar um supernó com mais de 64 aceleradores.
Custo real da implantação local do Kimi K3.1 Pro: custo mensal em quatro cenários
A estimativa abaixo considera uma máquina com 8 GPUs B300 funcionando 24 horas por dia, todos os dias. Para os cálculos, usamos a cotação fixa de US$ 1 = ¥ 7,25. Os preços vêm de três fontes: tarifas por uso coletadas pela ComputeUnion em 24 e 25 de outubro de 2026, faturas reais de usuários da Modal e atas do relatório Pesquisa do setor de aluguel de capacidade computacional (republicado pela Sina Finance em 20 de maio de 2026).
⚠️ Os preços de aluguel e compra de máquinas completas na China — como cerca de ¥ 80 mil por mês por máquina H200, ¥ 160 mil a ¥ 190 mil por mês por máquina B300 em contrato de cinco anos e ¥ 6,8 milhões a ¥ 7 milhões por máquina B300 no mercado à vista — são referências de uma pesquisa do setor, não preços divulgados pelos fabricantes. Servem apenas como estimativa de ordem de grandeza. A oferta mais comum é de máquinas completas com oito GPUs, com contrato mínimo de um ano.
| Cenário | Base de cálculo | Custo mensal | Observações |
|---|---|---|---|
| Aluguel por uso no exterior (24/7) | Máquina completa com B300: ¥ 342–464 por hora × 730 horas | Cerca de ¥ 249,8 mil–¥ 338,7 mil (US$ 34,5 mil–US$ 46,7 mil) | Cotação de terceiros + estimativa deste artigo |
| Medição real da Modal (24/7) | US$ 56,79 por hora × 730 horas | US$ 41.457,00, cerca de ¥ 300,6 mil | Fatura real de terceiros |
| Aluguel de máquina completa na China por cinco anos | Referência de pesquisa do setor | ¥ 160 mil–¥ 190 mil | Preço não divulgado publicamente; contrato mínimo de um ano |
| Compra + eletricidade | Máquina por ¥ 6,8 milhões–¥ 7 milhões, depreciada linearmente em três anos, mais cerca de ¥ 8,8 mil de eletricidade | Cerca de ¥ 198 mil–¥ 203 mil | Não inclui equipe de operação e manutenção, peças de reposição, espaço no datacenter nem largura de banda |
| Desligamento após apenas quatro horas de uso por dia | Tarifas por uso no exterior | Cerca de ¥ 26 mil–¥ 30 mil | Cada reinicialização exige uma inicialização a frio de cerca de 27 minutos |
A estimativa de eletricidade deste artigo considera uma carga de 13,2 kW, PUE de 1,3 e tarifa de ¥ 0,7/kWh, o que dá cerca de ¥ 12 por hora. Comprar a máquina parece a opção mais barata, mas a tabela não inclui o custo da mão de obra dos engenheiros de operação e manutenção — justamente o maior custo oculto para equipes pequenas.
Desligar a máquina depois de apenas quatro horas de uso por dia parece econômico, mas é difícil colocar isso em prática. Em testes reais da Modal, a inicialização a frio levou cerca de 27 minutos: é preciso carregar 1,56 TB de pesos, executar a compilação JIT e capturar 51 CUDA graphs. Em tarefas curtas, o tempo de espera pode acabar sendo maior do que o tempo de inferência.
Custo por unidade do Kimi K3.1 Pro: o throughput determina quantas vezes ele custa mais que a API
A mensalidade é só a parte visível da conta. O que realmente determina se vale a pena é o custo por milhão de tokens. A fórmula estimada neste artigo é: custo por milhão de tokens de saída = custo da máquina por hora ÷ tokens de saída por hora (em milhões). Para o numerador, usamos o valor medido pela Modal: US$ 56,79 por hora.
【Medições de terceiros】Confira alguns dados de throughput de configurações com 8×B300:
- Modal em uma máquina (TP8, MXFP4 nativo): 92 tok/s em regime estável, TTFT de 0,92–1,02 segundo
- OpenZeka (DGX B300, TP8, vLLM): 105,7 tok/s com concorrência 1; 32,45 tok/s por usuário com concorrência 64. Estima-se que a configuração suporte 150 usuários em chats ou 50 usuários em tarefas de agente
- Exemplo oficial da AWS (29 de julho de 2026, p6-b300.48xlarge): 516 tok/s com concorrência 8 e throughput total de 4.634 tok/s com alta concorrência
- GPUStack (30 de julho de 2026): com entrada de 64K e concorrência 10, o tempo de ponta a ponta no vLLM foi de 100,5 segundos; o throughput agregado de prefill ficou em torno de 19K–23K tok/s
| Throughput de saída estável | Saída por hora | Custo por milhão de tokens de saída | Comparação com a API oficial a US$ 10,00 |
|---|---|---|---|
| 92 tok/s (uma solicitação usando toda a capacidade) | 0,33M | US$ 171,50 (US$ 190,00 segundo o cálculo do autor original) | cerca de 17–19 vezes |
| 500 tok/s | 1,80M | US$ 31,50 | cerca de 3 vezes |
| 1.000 tok/s | 3,60M | US$ 15,80 | cerca de 1,6 vez |
| 1.500 tok/s | 5,40M | US$ 10,50 | praticamente o mesmo custo |
| 3.000 tok/s | 10,80M | US$ 5,30 | cerca da metade |
| 4.634 tok/s (pico medido pela AWS) | 16,68M | US$ 3,40 | cerca de um terço |
Para uma pessoa ou um grupo pequeno, o cenário real fica na primeira linha. Sem concorrência suficiente, a máquina passa a maior parte do tempo ociosa, e o custo por milhão de tokens de saída fica em torno de US$ 190,00. É daí que vem o «19 vezes mais caro» do título. Só vale a pena operar a infraestrutura por conta própria quando a demanda consegue manter o throughput acima de 1.500 tok/s por longos períodos; é nesse ponto que o custo por unidade se equipara ao da API.
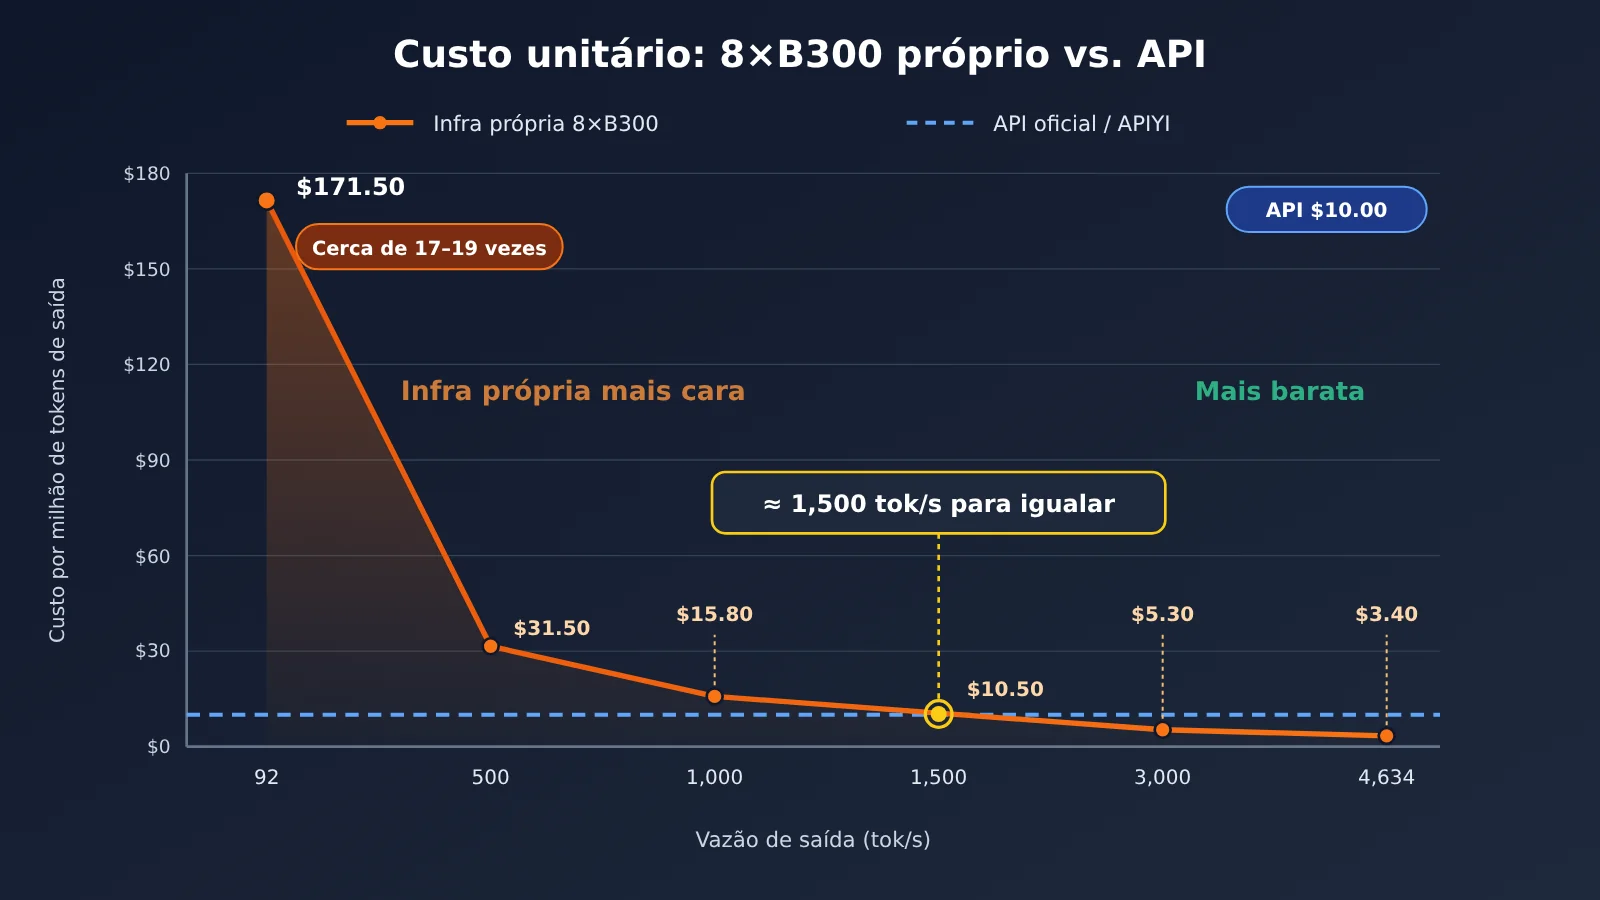
💡 Observação sobre a comparação: a linha de referência da API no gráfico usa o preço oficial de US$ 10,00 por milhão de tokens de saída. O preço de saída do kimi-k3.1-pro na APIYI apiyi.com é igual ao preço oficial, então serve como referência direta.
Ponto de equilíbrio da implantação local do Kimi K3.1 Pro: quantos tokens por mês são necessários?
Vendo por outro ângulo: quantos tokens por mês são necessários para que a implantação própria empate com o custo da API? Esta estimativa considera as seguintes premissas: comparação com a API oficial, a US$ 2,00 por milhão de tokens de entrada e US$ 10,00 por milhão de tokens de saída; proporção de 5:1 entre entrada e saída, comum em cenários com Agent; e nenhuma contabilização de acertos de cache.
| Opção de implantação própria | Custo mensal | Tokens de entrada necessários por mês | Tokens de saída necessários por mês |
|---|---|---|---|
| Uso sob demanda no exterior, 24/7 | US$ 41.457,00 | cerca de 10,4 bilhões | cerca de 2,07 bilhões |
| Sistema completo no mercado interno, com contrato de cinco anos | ¥ 190 mil | cerca de 6,55 bilhões | cerca de 1,31 bilhão |
| Compra à vista (depreciação + energia) | ¥ 203 mil | cerca de 6,98 bilhões | cerca de 1,4 bilhão |
O que significa gerar mais de um bilhão de tokens de saída por mês? Segundo estimativas da OpenZeka, um sistema com 8×B300 consegue atender 50 usuários de Agent simultaneamente. Uma equipe pequena, com menos de dez pessoas, está muito longe de usar esse volume.
Há ainda uma variável fácil de ignorar: o cache. O preço oficial para tokens atendidos pelo cache é de apenas US$ 0,20 por milhão de tokens, e a taxa de acertos costuma ser alta em cenários com Agent e documentos longos. Quanto maior a proporção de tokens atendidos pelo cache, menor o custo da API — e mais alto fica o ponto de equilíbrio para a implantação própria.
Em quais situações vale a pena hospedar o Kimi K3.1 Pro por conta própria
Hospedar por conta própria não é uma opção ruim, mas é preciso ter um motivo claro. Nas situações abaixo, essa escolha faz sentido:
- Conformidade ou operação offline são indispensáveis: os dados não podem sair da rede interna e é necessário isolamento físico. Nesse caso, mesmo uma API barata não serve. A API oficial já oferece retenção zero de dados (ZDR), então vale confirmar primeiro se isso atende aos seus requisitos de conformidade.
- Você precisa fazer ajuste fino e destilação: quer usar o K3.1 Pro para pós-treinamento em um domínio específico ou destilá-lo em um modelo menor, na faixa de 30B a 120B. Nesse caso, é indispensável ter acesso aos pesos completos.
- Você tem GPUs ociosas e uma equipe dedicada à operação: já conta com 8×B300, 8×MI355X ou dois H200 sem uso, além de engenheiros com experiência em vLLM ou SGLang para cuidar da operação. Só assim o custo marginal tende a ser baixo.
- O volume de uso realmente justifica: é possível manter, de forma estável e por um longo período, mais de 1.500 tok/s, com uma geração mensal na casa de bilhões de tokens.
Também é importante verificar os termos da licença com antecedência. O K3 usa a Kimi K3 License. Segundo resumos de terceiros, é necessária uma autorização específica para oferecer serviços do modelo a terceiros quando a receita anual ultrapassa US$ 20 milhões. Os termos do K3.1 Pro só poderão ser confirmados após a publicação dos pesos, consultando o arquivo LICENSE no repositório do Hugging Face. Por enquanto, não dá para afirmar oficialmente quais serão as condições.
Em que situações você não deve, de jeito nenhum, hospedar o Kimi K3.1 Pro por conta própria
Com as motivações abaixo, é bem provável que hospedar o modelo por conta própria dê prejuízo:
- Para economizar: a menos que o throughput fique acima de 1.500 tok/s por longos períodos, o custo por unidade será maior do que o da API. Para uso próprio, pode chegar a cerca de 19 vezes mais.
- Para executar tarefas longas e ligar ou desligar conforme a necessidade: a inicialização a frio leva cerca de 27 minutos, o que torna praticamente inviável ligar e desligar o serviço sob demanda.
- Para uso próprio ou de uma equipe pequena: a concorrência não aproveita toda a capacidade. Na prática, você paga US$ 56,79 por hora para ter uma velocidade de 92 tok/s.
- Na expectativa de usar quantização para colocar o modelo em uma única máquina: as soluções da comunidade não são adequadas para produção. O Unsloth de 1 bit (UD-IQ1_S, 594 GB), executado em 8×A100, chega a cerca de 9 tok/s. O custo estimado por milhão de tokens de saída é de US$ 620,00 — 3,3 vezes mais do que o da solução com o modelo completo. A taxa de concordância top-1 entre a versão de 1 bit e o modelo completo é de aproximadamente 79%. O
kimi-k3-in-cexecuta com os pesos completos usando 8,24 GB de memória, mas leva de 10 a 32 segundos por token: é apenas uma demonstração técnica.
O formato que realmente faz sentido para executar o modelo localmente é uma versão destilada que a comunidade venha a lançar. Até lá, para pessoas e equipes pequenas, usar a API é a opção mais prática.
Primeiros passos com o Kimi K3.1 Pro: valide seu negócio pela API
Antes de decidir hospedar o modelo por conta própria, recomendamos fortemente usar a API por um mês em operações reais. Assim, você terá dados concretos sobre as proporções de tokens de entrada, saída e cache utilizados e poderá voltar à tabela de custos acima para fazer as contas. O APIYI apiyi.com já oferece o kimi-k3.1-pro pelo mesmo preço da API oficial: US$ 2,00 por entrada / US$ 10,00 por saída / US$ 0,20 por leitura do cache (valores em dólares por milhão de tokens). Confira a lista de modelos da plataforma para ver os modelos e preços disponíveis.
Pontos importantes para a integração (interface compatível com OpenAI):
- Cadastre-se no APIYI apiyi.com e crie uma chave API. Novos usuários recebem créditos gratuitos para testes.
- Defina
base_urlno SDK comohttps://api.apiyi.com/v1. - Use
kimi-k3.1-procomo ID do modelo. Se precisar de mais velocidade, você pode usarkimi-k3.1-pro-highspeed(US$ 4,00 por entrada / US$ 20,00 por saída). - O parâmetro de intensidade de raciocínio,
reasoning_effort, aceitalow,highoumax; o padrão oficial émax. As configurações usadas nas avaliações oficiais sãotemperature = 1.0etop_p = 0.95. - Em conversas com várias rodadas e chamadas de ferramentas, é obrigatório reenviar sem alterações as mensagens do assistant que contenham
reasoning_content. Caso contrário, o contexto poderá apresentar erros. - Crie um script de monitoramento para registrar diariamente
prompt_tokens,completion_tokense o volume de cache utilizado. Esses dados ajudarão você a decidir se vale a pena hospedar o modelo por conta própria.
| Modelo | Entrada | Saída | Leitura do cache | Plataformas disponíveis |
|---|---|---|---|---|
| kimi-k3.1-pro | US$ 2,00 | US$ 10,00 | US$ 0,20 | APIYI apiyi.com, API oficial da Kimi |
| kimi-k3.1-pro-highspeed | US$ 4,00 | US$ 20,00 | US$ 0,20 | APIYI, API oficial da Kimi |
| kimi-k3 | US$ 3,00 | US$ 15,00 | US$ 0,30 | APIYI |
🚀 Comece agora: se o seu projeto ainda está em fase de validação, recomendamos usar o APIYI apiyi.com para testar o kimi-k3.1-pro e outros modelos populares com a mesma chave. Primeiro, confirme se o K3.1 Pro realmente funciona melhor nas suas tarefas; depois, avalie se vale a pena hospedar o modelo por conta própria.
Perguntas frequentes sobre a implantação local do Kimi K3.1 Pro
Q1: Já é possível baixar os pesos do Kimi K3.1 Pro?
Ainda não. O texto oficial diz: “The full model weights will be released by Nov 4”, ou seja, o lançamento está previsto para antes de 4 de novembro de 2026. Todos os números de hardware deste artigo são estimativas baseadas no K3, cujos pesos já foram disponibilizados. Quando os pesos forem lançados, confira novamente os valores com base no tamanho real dos arquivos.
Q2: Por que 8 H200 não dão conta de executar o Kimi K3.1 Pro?
As 8 H200 somam 1,13 TB de memória de vídeo, enquanto os pesos do K3 ocupam 1.560,9 GB em testes reais — uma diferença de cerca de 400 GB. Além disso, a arquitetura Hopper não oferece suporte nativo a MXFP4. Mesmo com duas máquinas com 16 H200 cada, seria necessário desquantizar os pesos em tempo de execução, o que prejudica o desempenho.
Q3: Como foi calculado o valor de “19 vezes mais caro”?
O número vem de testes de terceiros: a Modal cobra US$ 56,79 por hora por uma configuração com 8 B300, que alcança cerca de 92 tokens/s em regime estável por solicitação. Isso equivale a aproximadamente US$ 190 por milhão de tokens de saída — 19 vezes o preço de saída da API oficial, de US$ 10,00. No cálculo estrito, com 92 tokens/s, o valor seria US$ 171,50. A estimativa do autor original também considera as perdas observadas durante a operação real.
Q4: Há alguma forma econômica de uma equipe pequena hospedar o Kimi K3.1 Pro por conta própria?
Basicamente, não. A compra do hardware custa cerca de 200 mil yuans por mês, sem contar a equipe. Tentar colocar o modelo em uma única máquina com quantização acaba saindo ainda mais caro e entregando resultados piores. Para equipes pequenas, é mais realista usar uma API com cobrança por uso, por exemplo, chamar o kimi-k3.1-pro pela APIYI, em apiyi.com. Você paga pelo que usar e, nos casos em que o cache é utilizado, o custo é de apenas US$ 0,20 por milhão de tokens.
Q5: Como chamar o Kimi K3.1 Pro rapidamente pela API?
Cadastre-se em apiyi.com, na APIYI, e obtenha uma chave. Defina `base_url` como `https://api.apiyi.com/v1` e o modelo como `kimi-k3.1-pro`. Em geral, não é preciso alterar o código que já usa o SDK da OpenAI. Em conversas com várias rodadas, lembre-se de enviar `reasoning_content` de volta.
Q6: Quais são as limitações conhecidas da implantação local do Kimi K3.1 Pro?
Há três limitações principais. Primeiro, a inicialização a frio leva cerca de 27 minutos, o que não é adequado para escalabilidade elástica. Segundo, a imagem do vLLM só está disponível para CUDA 13, então o driver precisa ser da versão r580 ou superior; clusters mais antigos precisam ser atualizados. Terceiro, o cache KV distribuído não é compatível com nenhum dos hardwares listados, o que limita a expansão para várias máquinas.
Q7: Quando a implantação local se tornará viável?
Quando a comunidade lançar versões destiladas na faixa de 30B a 120B, aí sim pessoas e equipes pequenas poderão executá-las localmente. No curto prazo, modelos completos na escala de 3T ainda exigirão infraestrutura de data center.
Principais conclusões sobre a implantação local do Kimi K3.1 Pro
- Pesos ainda não publicados: a empresa prometeu publicá-los até 4 de novembro; todos os números disponíveis são estimativas baseadas no K3
- Requisitos mínimos de hardware: os pesos ocupam 1.560,9 GB; uma única máquina precisa de pelo menos 8×B300, GB300 ou MI355X
- Custo mensal estimado: manter uma máquina em funcionamento 24/7 custa cerca de ¥160 mil a ¥340 mil por mês, dependendo da opção escolhida
- Custo por unidade: para uso próprio, cerca de US$ 190,00 por milhão de tokens de saída — 19 vezes o preço da API oficial
- Condições para atingir o ponto de equilíbrio: throughput sustentado acima de 1.500 tok/s e volume mensal de saída na casa de 1 bilhão de tokens
- Como começar: primeiro, use a APIYI apiyi.com para invocar o kimi-k3.1-pro em um caso real de negócio; use os dados para decidir se vale a pena hospedar o modelo por conta própria
Checklist para avaliar as opções de implantação do Kimi K3.1 Pro
Responda às cinco perguntas abaixo para descobrir se vale mais a pena alugar máquinas, comprá-las ou usar a API:
- Alguma exigência de conformidade impede que os dados saiam da rede interna, e nem mesmo o ZDR oficial atende a essa necessidade? — Se não, use a API.
- Você precisa dos pesos para fazer ajuste fino ou destilação? — Se sim, considere alugar máquinas por um período curto e desligá-las assim que terminar.
- O volume mensal de tokens de saída ultrapassa de forma consistente 1,3 bilhão? — Se não, a hospedagem própria será mais cara que a API.
- Você já tem máquinas ociosas com capacidade equivalente a 8×B300 ou MI355X e uma equipe dedicada de operações? — Se sim, vale considerar a hospedagem própria; caso contrário, não compre máquinas só para isso.
- Seu negócio precisa poder iniciar e parar a qualquer momento, com escalabilidade elástica? — Se sim, uma inicialização a frio de 27 minutos não vai dar conta; escolha a API.
Resumo
As principais conclusões sobre a implantação local do Kimi K3.1 Pro:
- Exige muito hardware: com base nas estimativas do K3, os pesos ocupam cerca de 1,56 TB; 8×B300 dão conta, mas no limite.
- Sai caro para uso próprio: em uma única máquina, o custo é de cerca de US$ 190,00 por milhão de tokens de saída — 19 vezes o preço da API.
- Só compensa em grande escala: a implantação própria começa a fazer sentido quando o throughput se mantém acima de 1.500 tok/s e a saída mensal chega à casa dos bilhões de tokens.
Para a maioria dos desenvolvedores e pequenas equipes no Brasil, o melhor caminho é primeiro colocar o negócio para funcionar com a API e reunir dados de uso. Depois, dá para avaliar se vale a pena implantar o modelo por conta própria. Recomendamos usar a APIYI, em apiyi.com, para acessar o kimi-k3.1-pro: os preços são iguais aos oficiais, novos usuários recebem créditos gratuitos e, com uma única chave, também dá para comparar outros modelos populares.
📚 Referências
- Blog oficial de lançamento do Kimi K3.1 Pro: data de lançamento dos pesos e posicionamento do modelo
- Link:
kimi.ai/blog/kimi-k3-1-pro -
Observação: publicação oficial que confirma que os pesos serão lançados antes de 4 de novembro
-
Tabela oficial de preços da API da Kimi: preços de entrada, saída e cache do K3.1 Pro
- Link:
platform.kimi.ai/docs/pricing/chat -
Observação: fonte dos preços da API usados como referência neste artigo
-
Cartão do modelo Kimi K3: arquitetura, quantização e licença
- Link:
huggingface.co/moonshotai/Kimi-K3 -
Observação: 2,8 trilhões de parâmetros no total, quantização MXFP4 e licença Kimi K3
-
Receita do vLLM para o Kimi K3: requisitos mínimos de memória e implantação
- Link:
recipes.vllm.ai/moonshotai/Kimi-K3 -
Observação: requer pelo menos 8×GB300 e 1.680 GB de memória no mínimo
-
Teste de inferência da AWS com 8×B300: dados de throughput
- Link:
github.com/aws-samples/sample-llm-inference-on-eks -
Observação: throughput total de 4.634 tok/s com alta concorrência
-
Teste do GPUStack com 8×B300: comparação entre vLLM e SGLang com contexto longo
- Link:
cnblogs.com/gpustack/p/22073008 - Observação: tempo total de processamento para entradas de 64K e 200K
Autor: equipe técnica da APIYI
Contato técnico: fale com a gente pela página inicial do site da APIYI. Para mais materiais sobre integração de modelos, acesse a central de documentação em docs.apiyi.com.