作者注:按已開源的 Kimi K3 實測數據推算 K3.1 Pro 本地部署的硬件門檻、月成本、單位 token 成本與盈虧平衡點,幫你判斷什麼情況下該租、該買還是直接用 API。
先說結論:Kimi K3.1 Pro 開源在即,但本地部署不是給個人準備的。 官方表示完整權重將在 11 月 4 日前發佈,定位是 3T 級開源權重模型。截至 2026 年 10 月 26 日,K3.1 Pro 的權重還沒有發佈。本文所有硬件和顯存數字,都按已經開源的 Kimi K3 實測值推算,權重發布後需要複覈。
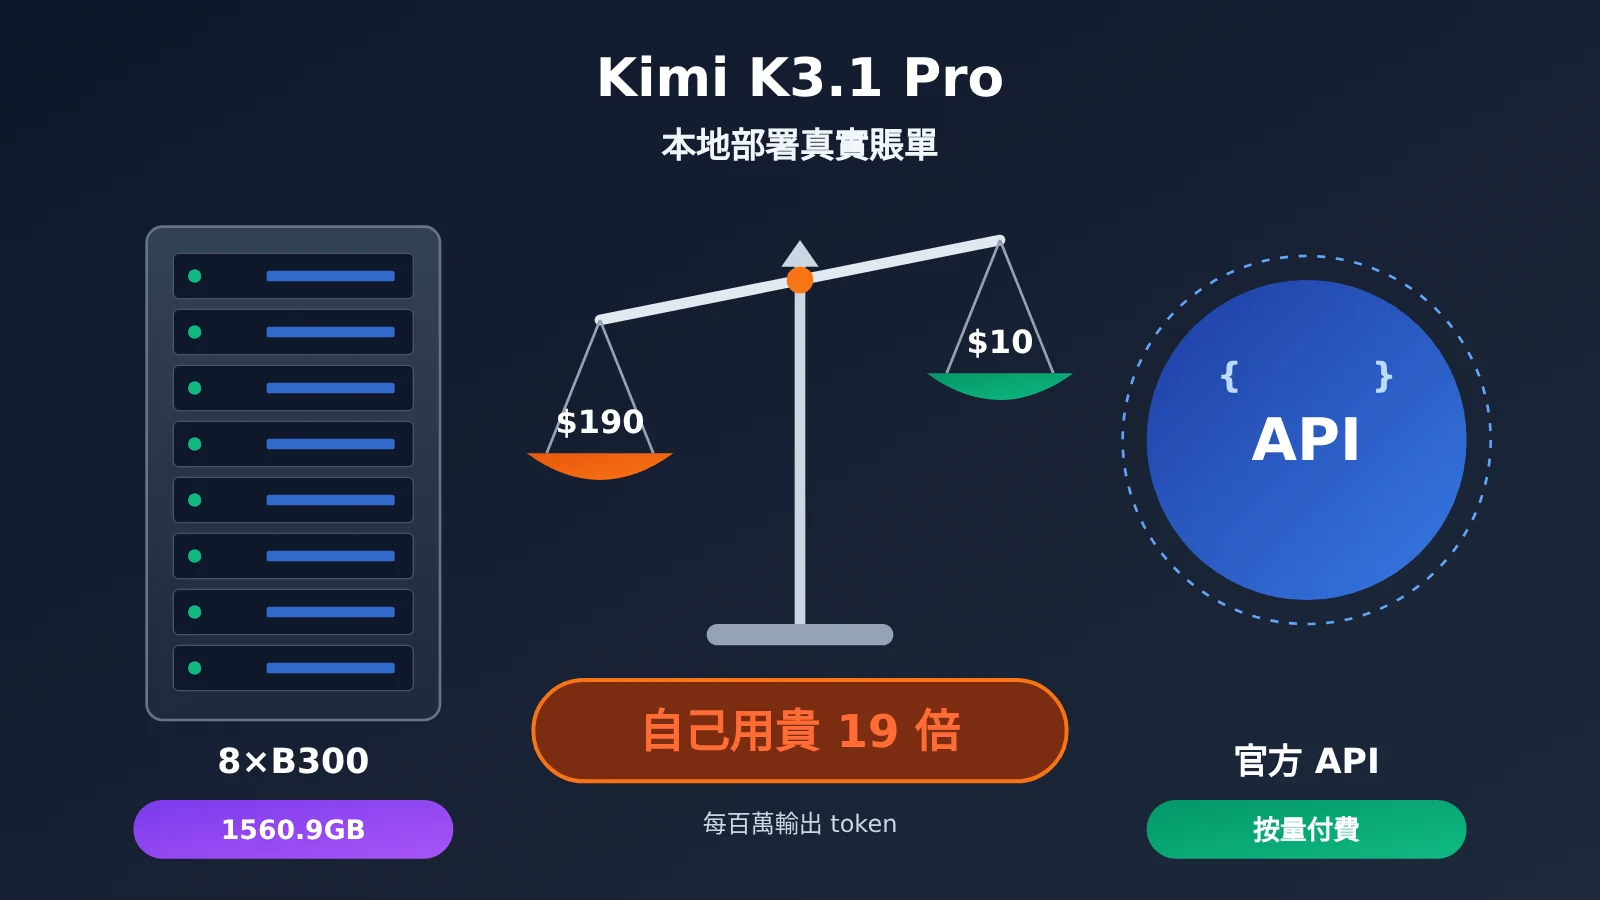
按 K3 實測,光權重就有 1560.9GB,8 張 B300 剛好裝下,8 張 H200 還差約 400GB。一臺 8×B300 只給自己用,每百萬輸出 token 約 $190.00,是官方 API($10.00)的 19 倍。
這不是勸退文,而是一份「要不要自建」的決策稿。每個數字都標明來自官方原文、第三方實測還是本文估算,你可以拿自己的業務量直接套用。
核心價值:讀完本文,你能算清自建 Kimi K3.1 Pro 的真實賬單,並按自查清單判斷自己該租機器、買機器,還是直接調用 API。
Kimi K3.1 Pro 本地部署核心要點
| 要點 | 結論 | 事實層級 |
|---|---|---|
| 權重狀態 | 尚未發佈,官方稱 11 月 4 日前發佈 | 官方原文 |
| 權重體積 | K3 權重 1560.9GB,K3.1 Pro 架構沿用 | 第三方實測(K3) |
| 最低單機 | 8×B300 / 8×GB300 / 8×MI355X | 推理框架配方 + 實測 |
| 自用單位成本 | 約 $190.00 / 百萬輸出 token | 第三方實測賬單 |
| 追平 API 條件 | 長期穩定輸出 1,500 tok/s 以上 | 本文估算 |
Kimi K3.1 Pro 本地部署的事實分層說明
本文把事實分爲三層,讀的時候請注意區分。官方原文指 Moonshot 在 kimi.ai 博客、platform.kimi.ai 文檔和 Hugging Face 模型卡上的表述。第三方實測指 AWS、GPUStack、OpenZeka、Modal 用戶等公開的測試數據,文中會寫明來源和日期。本文估算是我們用公開價格和吞吐算出來的結果,會寫明公式和假設,不代表官方數據。
推算的依據也來自官方:K3.1 Pro 是 Kimi K3 的後訓練版本(post-trained version of Kimi K3),架構沿用,只是加大了 RL 後訓練算力。所以 K3 的參數量、量化格式和權重體積,可以作爲 K3.1 Pro 部署下限的合理參照。
Kimi K3.1 Pro 本地部署硬件門檻:爲什麼 8 張 B300 才起步
【官方原文】K3 模型卡顯示:總參數 2.8T,激活參數 104B,共 93 層;896 個路由專家,每個 token 選 16 個,另有 2 個共享專家;上下文 1,048,576。權重採用 MXFP4、激活採用 MXFP8,從 SFT 階段就做了量化感知訓練。
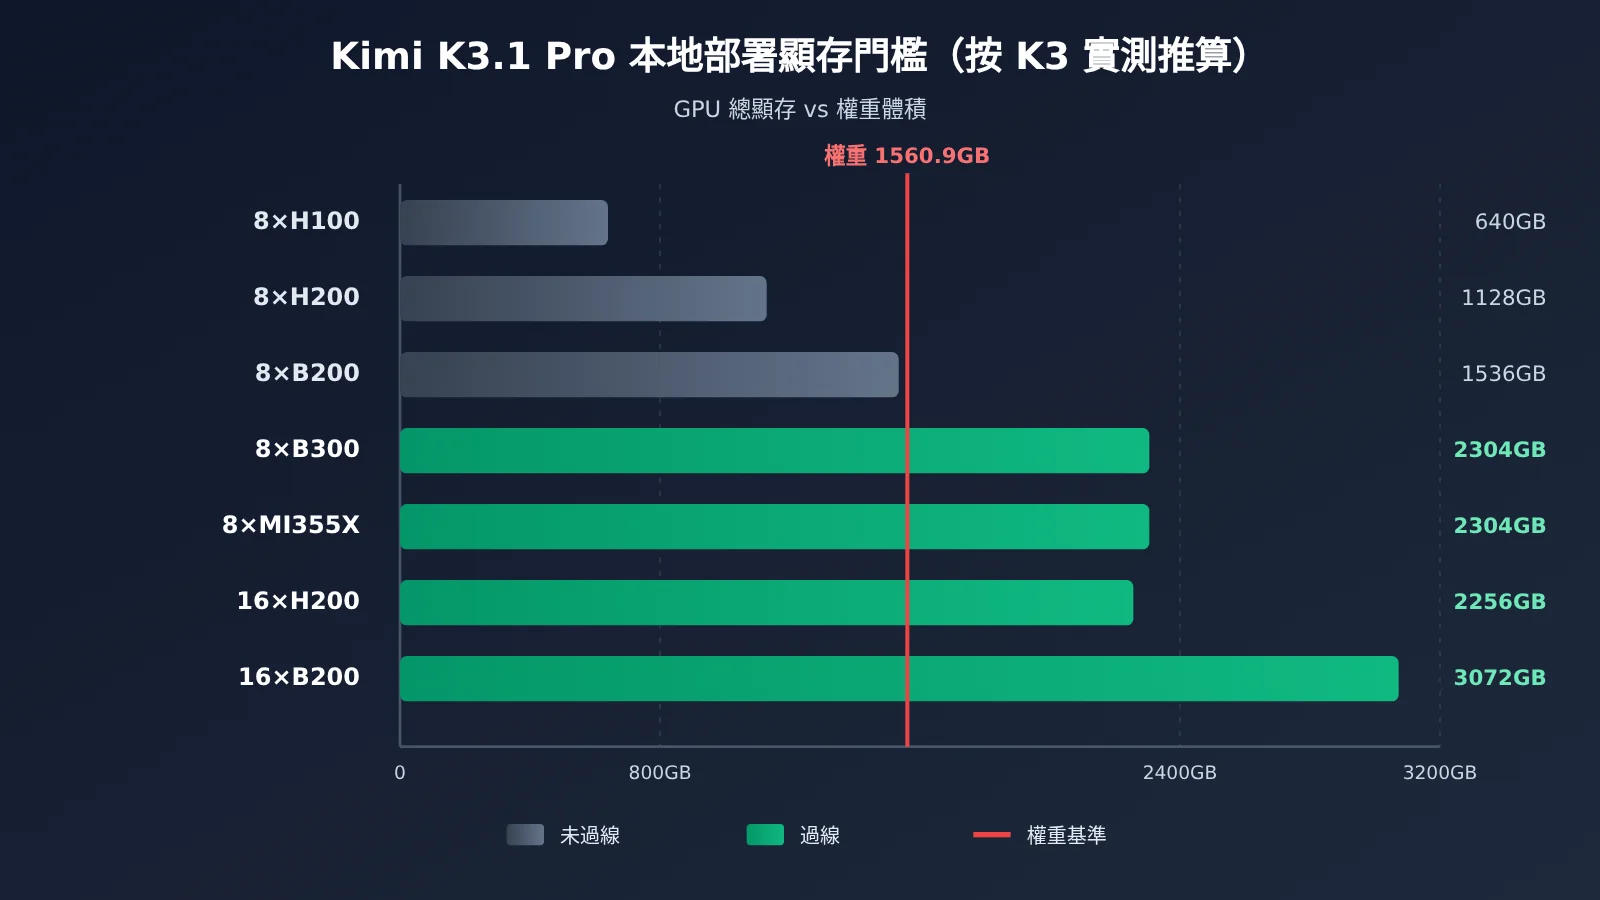
【第三方實測】有人逐個統計了 Hugging Face 倉庫文件:96 個 safetensors 分片合計 1,560,936,091,448 字節,約 1560.9GB。實測體積比「2.8T × 0.5 byte = 1400GB」的理論值大,是因爲 config 中注意力層、共享專家、lm_head、視覺塔等部分被列入白名單,保持高精度。vLLM recipe 給出的最小顯存是 1680GB,並寫明至少需要 8×GB300,真實生產流量要多節點。
| 配置 | 總顯存 | 能否跑 | 說明 |
|---|---|---|---|
| 8×H100 80GB | 640GB | 否 | 權重是顯存的 2.4 倍 |
| 32×H100 | 2.56TB | 勉強 | SGLang 有配方,但 Hopper 不原生支持 MXFP4,需運行時反量化 |
| 8×H200 141GB | 1.13TB | 否 | 差約 400GB,最可惜的一檔 |
| 16×H200(兩臺) | 2.26TB | 可以 | 同樣要反量化 |
| 8×B200 180GB | 1.44TB | 否 | 差約 120GB |
| 16×B200 / GB200 | 2.88TB | 可以 | Blackwell 參考配置 |
| 8×B300 / GB300 | 2.30TB | 可以 | 官方默認路徑,單機剛好裝下 |
| 8×MI355X | 2.30TB | 可以 | AMD day-0 驗證 |
| 單卡 / RTX 4090 / 512GB Mac | — | 否 | 4090 要 75 張才裝得下權重 |
KV cache 反而不是瓶頸。K3 只有 24 層是 Gated MLA,約 27 KiB/token,其餘 69 層 KDA 每條序列只需固定狀態。第三方計算顯示,1M 上下文單用戶 KV 約 29.5GB,8K 上下文約 0.7GB。真正卡住你的是 1.56TB 的權重本身。
如果你仍要部署,以下是框架側的硬性條件(來自 vLLM recipe 與 SGLang cookbook,針對 K3):
- vLLM 鏡像:
vllm/vllm-openai:kimi-k3,只有 CUDA 13 版本,需要 r580+ 驅動,vLLM ≥ 0.27.0 - 並行策略:TP / TEP 最低 8 卡,DEP 最低 16 卡;分佈式 KV cache 在所有已列硬件上都標爲不支持
- SGLang 節點規劃:B300 用 1 節點 8 卡,B200 和 H200 都要 2 節點 8 卡
- Moonshot 2026 年 8 月口徑(第三方轉述):生產環境建議使用 64 張以上加速器的 supernode
Kimi K3.1 Pro 本地部署真實賬單:四條路線月成本
下面按單機 8×B300 全天候運行估算月成本,匯率統一按 1 美元 = 7.25 元折算。價格來源有三類:ComputeUnion 2026 年 10 月 24–25 日採集的按量報價、Modal 用戶實測賬單、《算力租賃行業調研》紀要(2026 年 5 月 20 日新浪財經轉載)。
⚠️ 國內整機租賃和採購價格(如 H200 約 8 萬元/月/臺、B300 五年期 16–19 萬元/月/臺、B300 現貨 680–700 萬元/臺)屬於行業調研口徑,非廠商公開報價,只作量級參考。主流以八卡整機爲標的,最低簽約 1 年。
| 路線 | 計算口徑 | 月成本 | 備註 |
|---|---|---|---|
| 海外按量租(24/7) | B300 整機每小時 342–464 元 × 730 小時 | 約 24.98–33.87 萬元(3.45–4.67 萬美元) | 第三方報價 + 本文估算 |
| Modal 實測(24/7) | $56.79/小時 × 730 小時 | $41,457.00,約 30.06 萬元 | 第三方實測賬單 |
| 國內五年期整機租 | 行業調研口徑 | 16–19 萬元 | 非公開報價,最低籤 1 年 |
| 買斷 + 電費 | 680–700 萬元按 3 年直線折舊,加電費約 0.88 萬元 | 約 19.8–20.3 萬元 | 不含運維人力、備件、機位、帶寬 |
| 每天只跑 4 小時就關機 | 海外按量 | 約 2.6–3.0 萬元 | 每次重啓冷啓動約 27 分鐘 |
電費按本文假設估算:負載 13.2kW、PUE 1.3、電價 0.7 元/kWh,每小時約 12 元。買斷路線看起來最便宜,但表裏沒算運維工程師的人力成本,而這恰恰是小團隊最大的隱性開銷。
「每天跑 4 小時就關機」看似省錢,實際很難落地。Modal 實測冷啓動約 27 分鐘,要加載 1.56TB 權重、做 JIT 編譯和 51 個 CUDA graph 捕獲。短任務一啓動,等待時間可能比推理時間還長。
Kimi K3.1 Pro 單位成本:吞吐決定你比 API 貴多少倍
月租只是表面賬單,真正決定劃不划算的是每百萬 token 的單位成本。本文估算公式爲:每百萬輸出 token 成本 = 每小時機器成本 ÷ 每小時輸出 token 數(百萬),分子統一取 Modal 實測的 $56.79/小時。
【第三方實測】幾組 8×B300 吞吐數據如下:
- Modal 單機(TP8,原生 MXFP4):穩態 92 tok/s,TTFT 0.92–1.02 秒
- OpenZeka(DGX B300,TP8,vLLM):併發 1 時 105.7 tok/s,併發 64 時每人 32.45 tok/s,估算可支撐聊天 150 人或 Agent 50 人
- AWS 官方樣例(2026 年 7 月 29 日,p6-b300.48xlarge):併發 8 時 516 tok/s,高併發總吞吐 4,634 tok/s
- GPUStack(2026 年 7 月 30 日):64K 輸入 10 併發,vLLM 端到端 100.5 秒;prefill 聚合吞吐約 19K–23K tok/s
| 穩定輸出吞吐 | 每小時輸出 | 每百萬輸出 token 成本 | 對比官方 API $10.00 |
|---|---|---|---|
| 92 tok/s(單請求跑滿) | 0.33M | $171.50(原作者口徑 $190.00) | 約 17–19 倍 |
| 500 tok/s | 1.80M | $31.50 | 約 3 倍 |
| 1,000 tok/s | 3.60M | $15.80 | 約 1.6 倍 |
| 1,500 tok/s | 5.40M | $10.50 | 基本持平 |
| 3,000 tok/s | 10.80M | $5.30 | 約一半 |
| 4,634 tok/s(AWS 實測峯值) | 16.68M | $3.40 | 約三分之一 |
一個人或幾個人用,實際就落在第一行。併發上不去,機器大部分時間在空轉,每百萬輸出 token 約 $190.00,這就是標題裏「貴 19 倍」的來源。只有業務能長期把吞吐壓到 1,500 tok/s 以上,自建的單位成本才能追平 API。
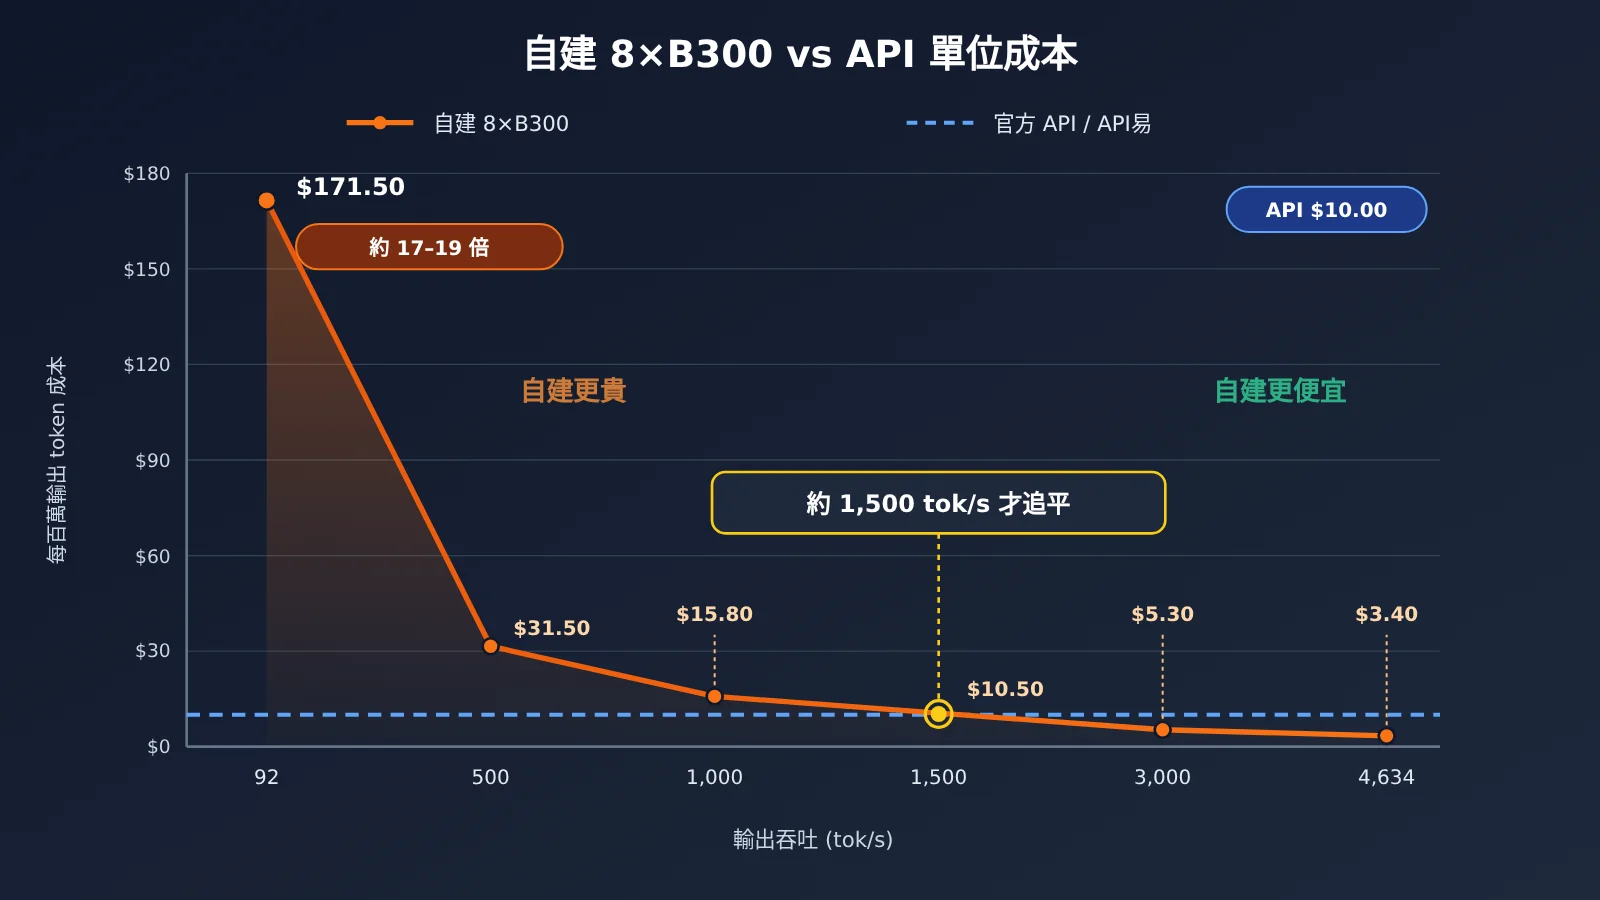
💡 對比說明:上圖的 API 基準線取官方價 $10.00/百萬輸出 token,API易 apiyi.com 上 kimi-k3.1-pro 的輸出價與官方一致,可以直接作爲對照。
Kimi K3.1 Pro 本地部署盈虧平衡:每月要用多少 token
換個角度:每月用多少 token,自建才能和 API 打平?本文估算假設如下:對照官方 API $2.00 輸入 / $10.00 輸出,輸入與輸出按 5:1 計算(常見 Agent 場景比例),不計緩存命中。
| 自建路線 | 月成本 | 月需輸入 token | 月需輸出 token |
|---|---|---|---|
| 海外按量 24/7 | $41,457.00 | 約 104 億 | 約 20.7 億 |
| 國內五年期整機 | 19 萬元 | 約 65.5 億 | 約 13.1 億 |
| 買斷(折舊 + 電費) | 20.3 萬元 | 約 69.8 億 | 約 14 億 |
每月十幾億輸出 token 是什麼概念?OpenZeka 估算一臺 8×B300 能撐 50 個 Agent 併發用戶。一個十人以內的小團隊,遠遠用不到這個量級。
還有一個容易忽略的變量:緩存。官方緩存命中價只有 $0.20/百萬 token,而 Agent 和長文檔場景的緩存命中率通常不低。緩存佔比越高,API 側越便宜,自建的臨界點還會繼續上移。
什麼情況才該自建 Kimi K3.1 Pro
自建不是不能做,而是要有明確的理由。以下幾種情況,自建是合理選擇:
- 合規或離線是剛需:數據不能出內網、必須物理隔離,API 再便宜也用不了。不過官方 API 已支持零數據保留(ZDR),建議先確認它能否滿足你的合規要求
- 要做微調和蒸餾:你要基於 K3.1 Pro 做領域後訓練,或把它蒸餾成 30B–120B 級別的小模型,這時必須拿到完整權重
- 手上有閒置卡且有專人運維:已有 8×B300、8×MI355X 或兩臺 H200 在閒置,同時有懂 vLLM / SGLang 的工程師負責運維,邊際成本纔會低
- 業務量確實撐得起:能長期穩定在 1,500 tok/s 以上,月輸出達到十億 token 級別
協議也要提前看清。K3 採用 Kimi K3 License,第三方摘要顯示,對外提供模型服務年收入超過 2,000 萬美元需要單獨授權。K3.1 Pro 的協議要等權重發布後,以 Hugging Face 倉庫中的 LICENSE 爲準,目前不能替官方下結論。
什麼情況千萬別自建 Kimi K3.1 Pro
以下幾種動機,自建大概率會虧:
- 想省錢:除非吞吐長期過 1,500 tok/s,否則單位成本只會比 API 高,自用場景約高 19 倍
- 想跑長任務又想按需開關:冷啓動約 27 分鐘,按需開關機的方案基本不可行
- 只給自己或小團隊用:併發打不滿,等於每小時花 $56.79 買 92 tok/s 的速度
- 指望量化塞進單機:社區路線都不能當生產用。Unsloth 1-bit(UD-IQ1_S,594GB)在 8×A100 上約 9 tok/s,折算每百萬輸出 token $620.00,比全量方案還貴 3.3 倍;1-bit 與全量模型的 top-1 一致率約 79%。
kimi-k3-in-c用 8.24GB 內存跑完整權重,但速度是 10–32 秒/token,只能算技術演示
真正適合「本地能跑」的形態,是社區後續推出的蒸餾版本。在此之前,個人和小團隊用 API 是最省事的方案。
Kimi K3.1 Pro 快速上手:先用 API 跑通業務
在決定自建之前,強烈建議先用 API 跑一個月真實業務,拿到輸入、輸出和緩存命中的實際比例,再回到上面的盈虧表算賬。API易 apiyi.com 已上架 kimi-k3.1-pro,價格與官方一致:$2.00 輸入 / $10.00 輸出 / 緩存讀 $0.20(單位:美元 / 百萬 tokens),型號與價格以平臺型號列表爲準。
接入要點(OpenAI 兼容接口):
- 在 API易 apiyi.com 註冊並創建 API Key,新用戶有免費測試額度
- 把 SDK 的 base_url 設爲
https://api.apiyi.com/v1 - 模型 ID 填
kimi-k3.1-pro;對速度要求高可換成kimi-k3.1-pro-highspeed($4.00 輸入 / $20.00 輸出) - 推理強度參數:
reasoning_effort可選low/high/max,官方默認max;官方評測設置爲temperature = 1.0、top_p = 0.95 - 多輪對話和工具調用時,必須把帶
reasoning_content的 assistant 消息原樣回傳,否則上下文會出錯 - 寫好統計腳本,按天記錄
prompt_tokens、completion_tokens和緩存命中量,作爲日後自建決策的依據
| 模型 | 輸入 | 輸出 | 緩存讀 | 可用平臺 |
|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | API易 apiyi.com、Kimi 官方 API |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | API易、Kimi 官方 API |
| kimi-k3 | $3.00 | $15.00 | $0.30 | API易 |
🚀 快速開始:如果你的項目還在驗證階段,推薦通過 API易 apiyi.com 用同一個 Key 同時測試 kimi-k3.1-pro 和其他主流模型,先確認 K3.1 Pro 在你的任務上確實最優,再討論要不要自建。
Kimi K3.1 Pro 本地部署常見問題
Q1:Kimi K3.1 Pro 的權重現在能下載嗎?
還不能。官方原文是「The full model weights will be released by Nov 4」,即 2026 年 11 月 4 日前發佈。本文的硬件數字全部按已開源的 K3 推算,權重發布後請以實際文件體積爲準再覈對一遍。
Q2:8 張 H200 爲什麼跑不起來 Kimi K3.1 Pro?
8×H200 總顯存 1.13TB,而 K3 權重實測 1560.9GB,差約 400GB。而且 Hopper 不原生支持 MXFP4,即便用兩臺 16×H200 也需要運行時反量化,速度上不去。
Q3:「貴 19 倍」是怎麼算出來的?
這個數字來自第三方實測:Modal 8×B300 每小時 $56.79,單請求穩態約 92 tok/s,折算每百萬輸出 token 約 $190.00,除以官方 API 輸出價 $10.00 得 19 倍。按 92 tok/s 嚴格計算是 $171.50,原作者的口徑還包含了實際運行中的損耗。
Q4:小團隊自建 Kimi K3.1 Pro 有沒有省錢的辦法?
基本沒有。買斷路線每月約 20 萬元還不含人力;量化塞單機反而更貴、效果更差。小團隊更現實的做法是走按量 API,例如通過 API易 apiyi.com 調用 kimi-k3.1-pro,用多少付多少,緩存命中部分只需 $0.20/百萬 token。
Q5:如何通過 API 快速調用 Kimi K3.1 Pro?
在 API易 apiyi.com 註冊獲取 Key,將 base_url 設爲 `https://api.apiyi.com/v1`,模型填 `kimi-k3.1-pro` 即可。現有 OpenAI SDK 代碼基本不用改,注意多輪對話時要回傳 `reasoning_content`。
Q6:Kimi K3.1 Pro 本地部署有哪些已知限制?
主要有三點。第一,冷啓動約 27 分鐘,不適合彈性擴縮。第二,vLLM 鏡像只有 CUDA 13 版本,驅動要 r580+,老集羣需要先升級。第三,分佈式 KV cache 在已列出的硬件上都不支持,多機擴展受限。
Q7:什麼時候本地部署會變得現實?
等社區推出 30B–120B 級別的蒸餾版本,纔是個人和小團隊能在本地跑的形態。全量 3T 級模型短期內仍然是數據中心級別的負載。
Kimi K3.1 Pro 本地部署 Key Takeaways
- 權重未發佈:官方承諾 11 月 4 日前發佈,現有數字均爲按 K3 推算
- 硬件下限:權重 1560.9GB,單機至少需要 8×B300、GB300 或 MI355X
- 月成本量級:單機 24/7 運行約 16–34 萬元/月,具體取決於路線
- 單位成本:自用約 $190.00/百萬輸出 token,是官方 API 的 19 倍
- 追平條件:長期吞吐 1,500 tok/s 以上,月輸出十億 token 級別
- 上手方式:先通過 API易 apiyi.com 調用 kimi-k3.1-pro 跑真實業務,用數據決定是否自建
Kimi K3.1 Pro 部署方式自查清單
逐條回答下面 5 個問題,就能判斷自己該租、該買還是用 API:
- 數據是否被合規要求禁止出內網,且官方 ZDR 也無法滿足?——否,直接用 API
- 是否需要拿權重做微調或蒸餾?——是,考慮短期按量租機器,用完即停
- 每月輸出 token 是否穩定超過 13 億?——否,自建一定比 API 貴
- 是否已有閒置的 8×B300 / MI355X 級別機器和專職運維?——是,可以考慮自建;否則不要爲此專門買機器
- 業務是否需要隨時啓停、彈性擴縮?——是,自建冷啓動 27 分鐘扛不住,選 API
總結
Kimi K3.1 Pro 本地部署的核心結論:
- 門檻高:按 K3 推算權重約 1.56TB,8×B300 纔剛好裝下
- 自用貴:單機自用約 $190.00/百萬輸出 token,是 API 的 19 倍
- 規模才划算:吞吐長期過 1,500 tok/s、月輸出十億 token 級別,才輪得到自建
對國內大多數開發者和小團隊來說,正確順序是先用 API 跑通業務、積累用量數據,再判斷是否值得自建。推薦通過 API易 apiyi.com 調用 kimi-k3.1-pro,價格與官方一致,新用戶有免費額度,一個 Key 還能順手對比其他主流模型。
📚 參考資料
- Kimi K3.1 Pro 官方發佈博客:權重發布時間與模型定位
- 鏈接:
kimi.ai/blog/kimi-k3-1-pro -
說明: 官方原文,確認權重將於 11 月 4 日前發佈
-
Kimi 官方 API 價目:K3.1 Pro 輸入、輸出、緩存價格
- 鏈接:
platform.kimi.ai/docs/pricing/chat -
說明: 本文 API 對照價的來源
-
Kimi K3 模型卡:架構、量化與協議
- 鏈接:
huggingface.co/moonshotai/Kimi-K3 -
說明: 2.8T 總參數、MXFP4 量化、Kimi K3 License
-
vLLM Kimi K3 Recipe:最小顯存與部署要求
- 鏈接:
recipes.vllm.ai/moonshotai/Kimi-K3 -
說明: 至少 8×GB300,最小顯存 1680GB
-
AWS 8×B300 推理實測:吞吐數據
- 鏈接:
github.com/aws-samples/sample-llm-inference-on-eks -
說明: 高併發總吞吐 4,634 tok/s
-
GPUStack 8×B300 實測:vLLM 與 SGLang 長上下文對比
- 鏈接:
cnblogs.com/gpustack/p/22073008 - 說明: 64K / 200K 輸入的端到端耗時
作者:APIYI 技術團隊
技術交流:歡迎在 API易 官網首頁聯繫我們,更多模型接入資料可訪問 docs.apiyi.com 文檔中心