作者注:按已开源的 Kimi K3 实测数据推算 K3.1 Pro 本地部署的硬件门槛、月成本、单位 token 成本与盈亏平衡点,帮你判断什么情况下该租、该买还是直接用 API。
先说结论:Kimi K3.1 Pro 开源在即,但本地部署不是给个人准备的。 官方表示完整权重将在 11 月 4 日前发布,定位是 3T 级开源权重模型。截至 2026 年 10 月 26 日,K3.1 Pro 的权重还没有发布。本文所有硬件和显存数字,都按已经开源的 Kimi K3 实测值推算,权重发布后需要复核。
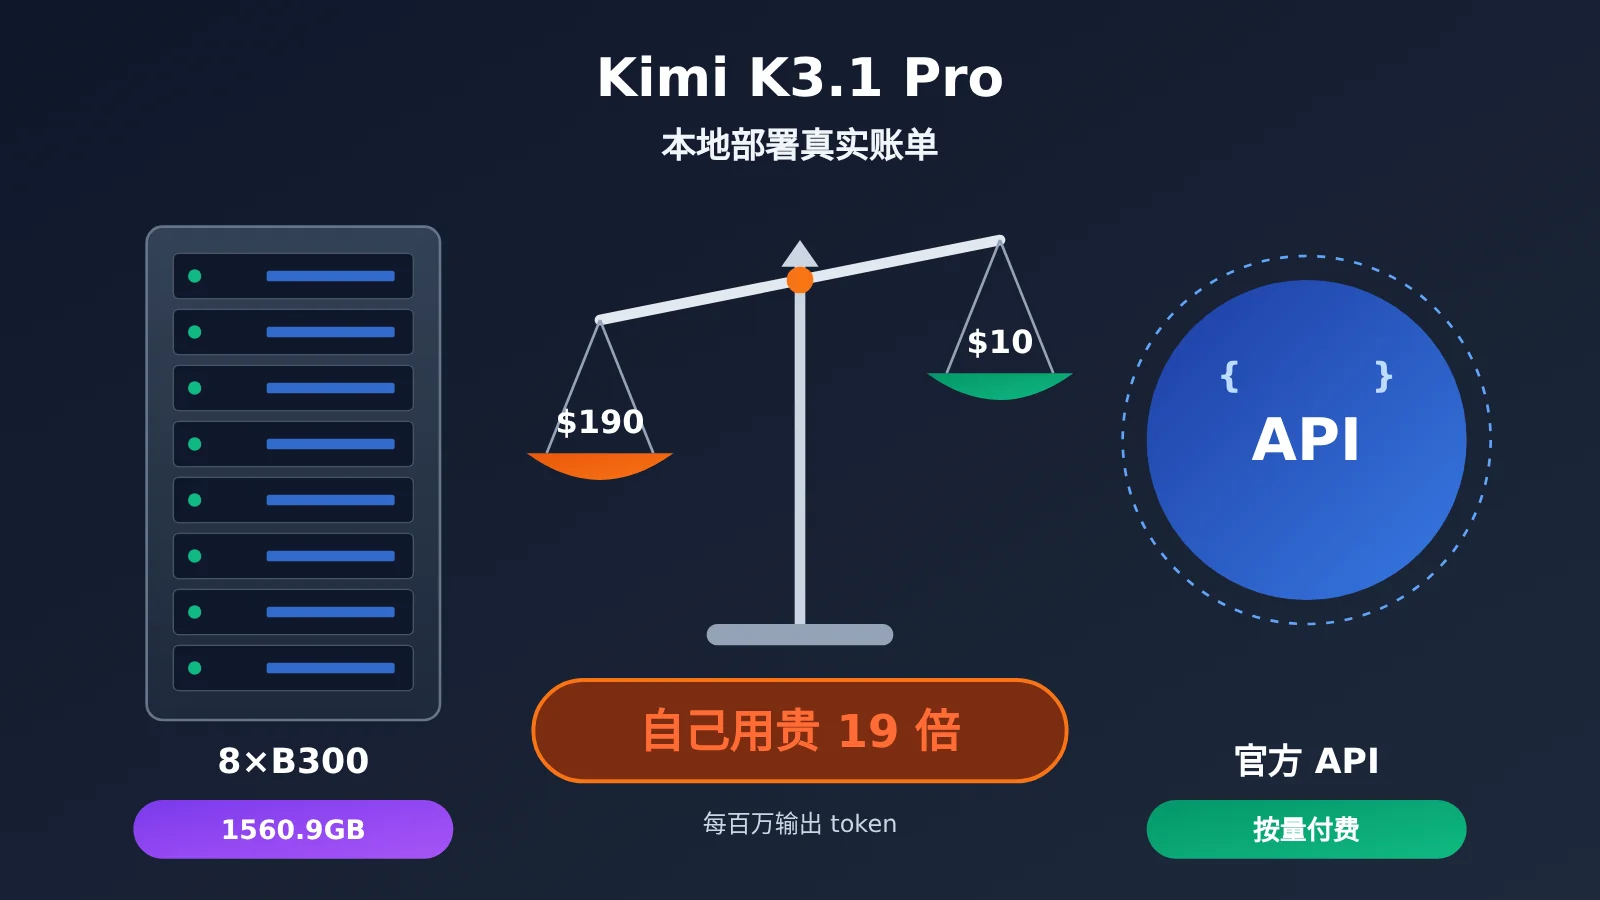
按 K3 实测,光权重就有 1560.9GB,8 张 B300 刚好装下,8 张 H200 还差约 400GB。一台 8×B300 只给自己用,每百万输出 token 约 $190.00,是官方 API($10.00)的 19 倍。
这不是劝退文,而是一份「要不要自建」的决策稿。每个数字都标明来自官方原文、第三方实测还是本文估算,你可以拿自己的业务量直接套用。
核心价值:读完本文,你能算清自建 Kimi K3.1 Pro 的真实账单,并按自查清单判断自己该租机器、买机器,还是直接调用 API。
Kimi K3.1 Pro 本地部署核心要点
| 要点 | 结论 | 事实层级 |
|---|---|---|
| 权重状态 | 尚未发布,官方称 11 月 4 日前发布 | 官方原文 |
| 权重体积 | K3 权重 1560.9GB,K3.1 Pro 架构沿用 | 第三方实测(K3) |
| 最低单机 | 8×B300 / 8×GB300 / 8×MI355X | 推理框架配方 + 实测 |
| 自用单位成本 | 约 $190.00 / 百万输出 token | 第三方实测账单 |
| 追平 API 条件 | 长期稳定输出 1,500 tok/s 以上 | 本文估算 |
Kimi K3.1 Pro 本地部署的事实分层说明
本文把事实分为三层,读的时候请注意区分。官方原文指 Moonshot 在 kimi.ai 博客、platform.kimi.ai 文档和 Hugging Face 模型卡上的表述。第三方实测指 AWS、GPUStack、OpenZeka、Modal 用户等公开的测试数据,文中会写明来源和日期。本文估算是我们用公开价格和吞吐算出来的结果,会写明公式和假设,不代表官方数据。
推算的依据也来自官方:K3.1 Pro 是 Kimi K3 的后训练版本(post-trained version of Kimi K3),架构沿用,只是加大了 RL 后训练算力。所以 K3 的参数量、量化格式和权重体积,可以作为 K3.1 Pro 部署下限的合理参照。
Kimi K3.1 Pro 本地部署硬件门槛:为什么 8 张 B300 才起步
【官方原文】K3 模型卡显示:总参数 2.8T,激活参数 104B,共 93 层;896 个路由专家,每个 token 选 16 个,另有 2 个共享专家;上下文 1,048,576。权重采用 MXFP4、激活采用 MXFP8,从 SFT 阶段就做了量化感知训练。
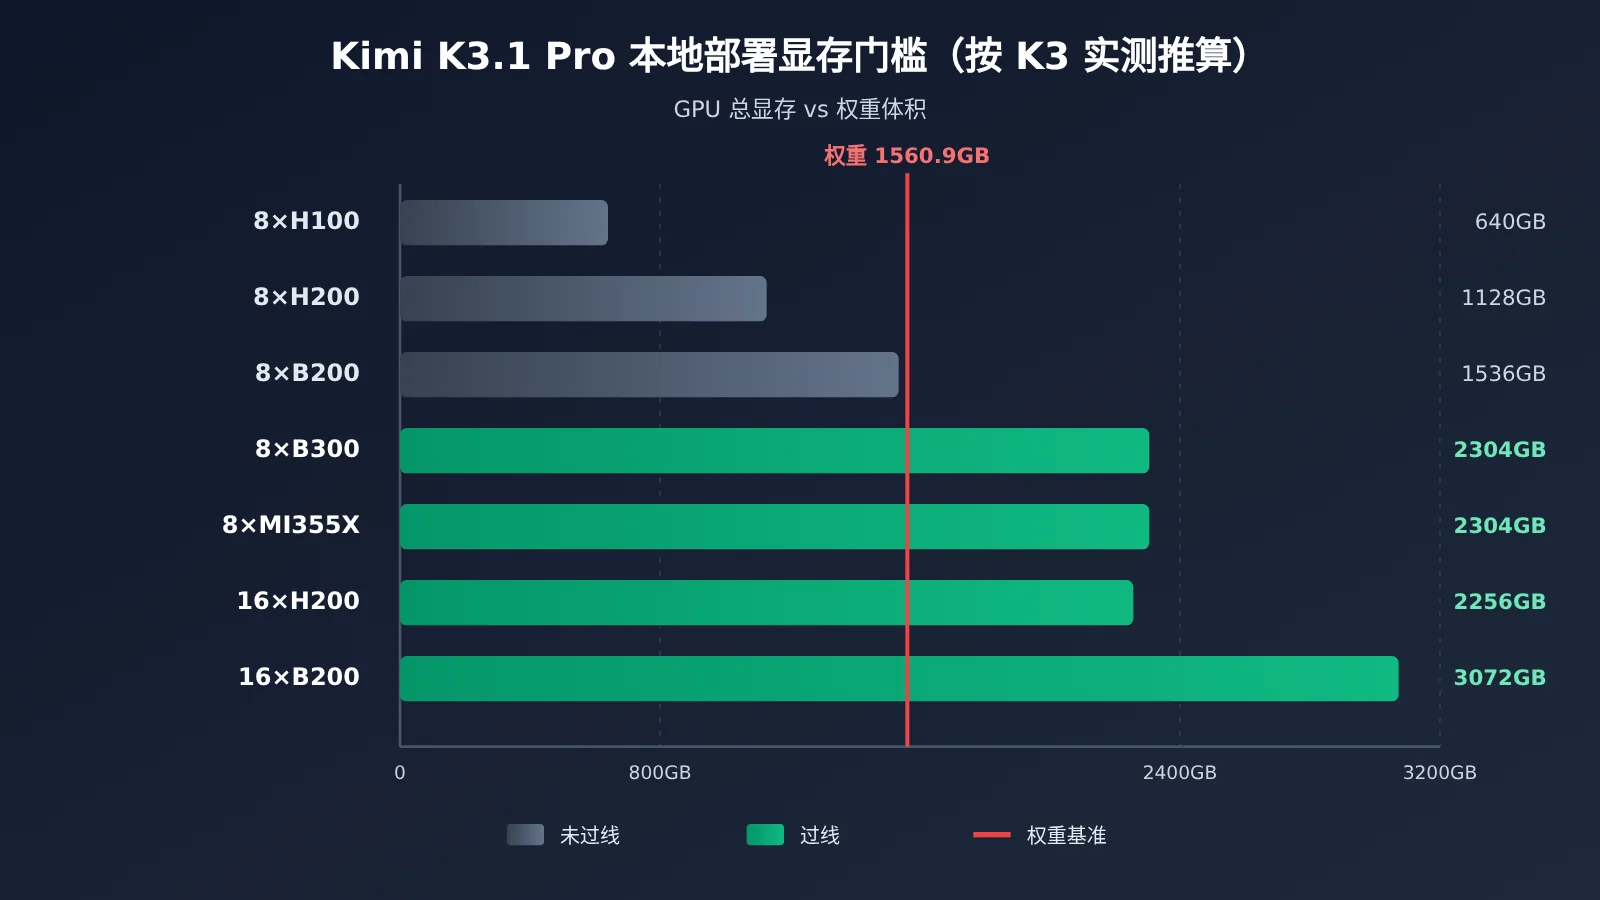
【第三方实测】有人逐个统计了 Hugging Face 仓库文件:96 个 safetensors 分片合计 1,560,936,091,448 字节,约 1560.9GB。实测体积比「2.8T × 0.5 byte = 1400GB」的理论值大,是因为 config 中注意力层、共享专家、lm_head、视觉塔等部分被列入白名单,保持高精度。vLLM recipe 给出的最小显存是 1680GB,并写明至少需要 8×GB300,真实生产流量要多节点。
| 配置 | 总显存 | 能否跑 | 说明 |
|---|---|---|---|
| 8×H100 80GB | 640GB | 否 | 权重是显存的 2.4 倍 |
| 32×H100 | 2.56TB | 勉强 | SGLang 有配方,但 Hopper 不原生支持 MXFP4,需运行时反量化 |
| 8×H200 141GB | 1.13TB | 否 | 差约 400GB,最可惜的一档 |
| 16×H200(两台) | 2.26TB | 可以 | 同样要反量化 |
| 8×B200 180GB | 1.44TB | 否 | 差约 120GB |
| 16×B200 / GB200 | 2.88TB | 可以 | Blackwell 参考配置 |
| 8×B300 / GB300 | 2.30TB | 可以 | 官方默认路径,单机刚好装下 |
| 8×MI355X | 2.30TB | 可以 | AMD day-0 验证 |
| 单卡 / RTX 4090 / 512GB Mac | — | 否 | 4090 要 75 张才装得下权重 |
KV cache 反而不是瓶颈。K3 只有 24 层是 Gated MLA,约 27 KiB/token,其余 69 层 KDA 每条序列只需固定状态。第三方计算显示,1M 上下文单用户 KV 约 29.5GB,8K 上下文约 0.7GB。真正卡住你的是 1.56TB 的权重本身。
如果你仍要部署,以下是框架侧的硬性条件(来自 vLLM recipe 与 SGLang cookbook,针对 K3):
- vLLM 镜像:
vllm/vllm-openai:kimi-k3,只有 CUDA 13 版本,需要 r580+ 驱动,vLLM ≥ 0.27.0 - 并行策略:TP / TEP 最低 8 卡,DEP 最低 16 卡;分布式 KV cache 在所有已列硬件上都标为不支持
- SGLang 节点规划:B300 用 1 节点 8 卡,B200 和 H200 都要 2 节点 8 卡
- Moonshot 2026 年 8 月口径(第三方转述):生产环境建议使用 64 张以上加速器的 supernode
Kimi K3.1 Pro 本地部署真实账单:四条路线月成本
下面按单机 8×B300 全天候运行估算月成本,汇率统一按 1 美元 = 7.25 元折算。价格来源有三类:ComputeUnion 2026 年 10 月 24–25 日采集的按量报价、Modal 用户实测账单、《算力租赁行业调研》纪要(2026 年 5 月 20 日新浪财经转载)。
⚠️ 国内整机租赁和采购价格(如 H200 约 8 万元/月/台、B300 五年期 16–19 万元/月/台、B300 现货 680–700 万元/台)属于行业调研口径,非厂商公开报价,只作量级参考。主流以八卡整机为标的,最低签约 1 年。
| 路线 | 计算口径 | 月成本 | 备注 |
|---|---|---|---|
| 海外按量租(24/7) | B300 整机每小时 342–464 元 × 730 小时 | 约 24.98–33.87 万元(3.45–4.67 万美元) | 第三方报价 + 本文估算 |
| Modal 实测(24/7) | $56.79/小时 × 730 小时 | $41,457.00,约 30.06 万元 | 第三方实测账单 |
| 国内五年期整机租 | 行业调研口径 | 16–19 万元 | 非公开报价,最低签 1 年 |
| 买断 + 电费 | 680–700 万元按 3 年直线折旧,加电费约 0.88 万元 | 约 19.8–20.3 万元 | 不含运维人力、备件、机位、带宽 |
| 每天只跑 4 小时就关机 | 海外按量 | 约 2.6–3.0 万元 | 每次重启冷启动约 27 分钟 |
电费按本文假设估算:负载 13.2kW、PUE 1.3、电价 0.7 元/kWh,每小时约 12 元。买断路线看起来最便宜,但表里没算运维工程师的人力成本,而这恰恰是小团队最大的隐性开销。
「每天跑 4 小时就关机」看似省钱,实际很难落地。Modal 实测冷启动约 27 分钟,要加载 1.56TB 权重、做 JIT 编译和 51 个 CUDA graph 捕获。短任务一启动,等待时间可能比推理时间还长。
Kimi K3.1 Pro 单位成本:吞吐决定你比 API 贵多少倍
月租只是表面账单,真正决定划不划算的是每百万 token 的单位成本。本文估算公式为:每百万输出 token 成本 = 每小时机器成本 ÷ 每小时输出 token 数(百万),分子统一取 Modal 实测的 $56.79/小时。
【第三方实测】几组 8×B300 吞吐数据如下:
- Modal 单机(TP8,原生 MXFP4):稳态 92 tok/s,TTFT 0.92–1.02 秒
- OpenZeka(DGX B300,TP8,vLLM):并发 1 时 105.7 tok/s,并发 64 时每人 32.45 tok/s,估算可支撑聊天 150 人或 Agent 50 人
- AWS 官方样例(2026 年 7 月 29 日,p6-b300.48xlarge):并发 8 时 516 tok/s,高并发总吞吐 4,634 tok/s
- GPUStack(2026 年 7 月 30 日):64K 输入 10 并发,vLLM 端到端 100.5 秒;prefill 聚合吞吐约 19K–23K tok/s
| 稳定输出吞吐 | 每小时输出 | 每百万输出 token 成本 | 对比官方 API $10.00 |
|---|---|---|---|
| 92 tok/s(单请求跑满) | 0.33M | $171.50(原作者口径 $190.00) | 约 17–19 倍 |
| 500 tok/s | 1.80M | $31.50 | 约 3 倍 |
| 1,000 tok/s | 3.60M | $15.80 | 约 1.6 倍 |
| 1,500 tok/s | 5.40M | $10.50 | 基本持平 |
| 3,000 tok/s | 10.80M | $5.30 | 约一半 |
| 4,634 tok/s(AWS 实测峰值) | 16.68M | $3.40 | 约三分之一 |
一个人或几个人用,实际就落在第一行。并发上不去,机器大部分时间在空转,每百万输出 token 约 $190.00,这就是标题里「贵 19 倍」的来源。只有业务能长期把吞吐压到 1,500 tok/s 以上,自建的单位成本才能追平 API。
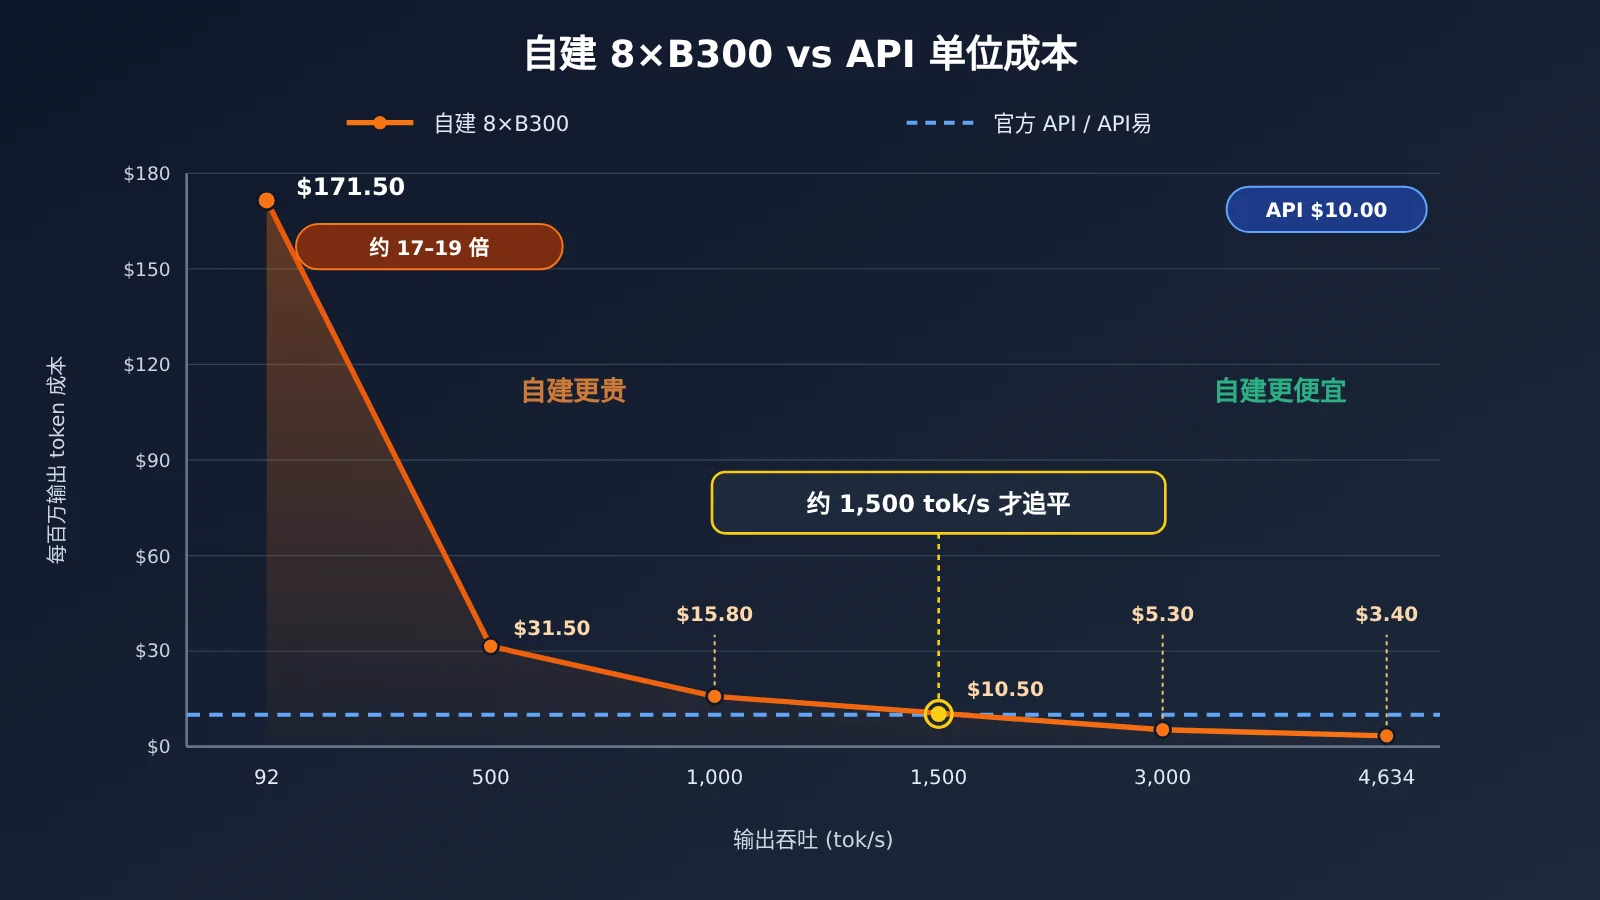
💡 对比说明:上图的 API 基准线取官方价 $10.00/百万输出 token,API易 apiyi.com 上 kimi-k3.1-pro 的输出价与官方一致,可以直接作为对照。
Kimi K3.1 Pro 本地部署盈亏平衡:每月要用多少 token
换个角度:每月用多少 token,自建才能和 API 打平?本文估算假设如下:对照官方 API $2.00 输入 / $10.00 输出,输入与输出按 5:1 计算(常见 Agent 场景比例),不计缓存命中。
| 自建路线 | 月成本 | 月需输入 token | 月需输出 token |
|---|---|---|---|
| 海外按量 24/7 | $41,457.00 | 约 104 亿 | 约 20.7 亿 |
| 国内五年期整机 | 19 万元 | 约 65.5 亿 | 约 13.1 亿 |
| 买断(折旧 + 电费) | 20.3 万元 | 约 69.8 亿 | 约 14 亿 |
每月十几亿输出 token 是什么概念?OpenZeka 估算一台 8×B300 能撑 50 个 Agent 并发用户。一个十人以内的小团队,远远用不到这个量级。
还有一个容易忽略的变量:缓存。官方缓存命中价只有 $0.20/百万 token,而 Agent 和长文档场景的缓存命中率通常不低。缓存占比越高,API 侧越便宜,自建的临界点还会继续上移。
什么情况才该自建 Kimi K3.1 Pro
自建不是不能做,而是要有明确的理由。以下几种情况,自建是合理选择:
- 合规或离线是刚需:数据不能出内网、必须物理隔离,API 再便宜也用不了。不过官方 API 已支持零数据保留(ZDR),建议先确认它能否满足你的合规要求
- 要做微调和蒸馏:你要基于 K3.1 Pro 做领域后训练,或把它蒸馏成 30B–120B 级别的小模型,这时必须拿到完整权重
- 手上有闲置卡且有专人运维:已有 8×B300、8×MI355X 或两台 H200 在闲置,同时有懂 vLLM / SGLang 的工程师负责运维,边际成本才会低
- 业务量确实撑得起:能长期稳定在 1,500 tok/s 以上,月输出达到十亿 token 级别
协议也要提前看清。K3 采用 Kimi K3 License,第三方摘要显示,对外提供模型服务年收入超过 2,000 万美元需要单独授权。K3.1 Pro 的协议要等权重发布后,以 Hugging Face 仓库中的 LICENSE 为准,目前不能替官方下结论。
什么情况千万别自建 Kimi K3.1 Pro
以下几种动机,自建大概率会亏:
- 想省钱:除非吞吐长期过 1,500 tok/s,否则单位成本只会比 API 高,自用场景约高 19 倍
- 想跑长任务又想按需开关:冷启动约 27 分钟,按需开关机的方案基本不可行
- 只给自己或小团队用:并发打不满,等于每小时花 $56.79 买 92 tok/s 的速度
- 指望量化塞进单机:社区路线都不能当生产用。Unsloth 1-bit(UD-IQ1_S,594GB)在 8×A100 上约 9 tok/s,折算每百万输出 token $620.00,比全量方案还贵 3.3 倍;1-bit 与全量模型的 top-1 一致率约 79%。
kimi-k3-in-c用 8.24GB 内存跑完整权重,但速度是 10–32 秒/token,只能算技术演示
真正适合「本地能跑」的形态,是社区后续推出的蒸馏版本。在此之前,个人和小团队用 API 是最省事的方案。
Kimi K3.1 Pro 快速上手:先用 API 跑通业务
在决定自建之前,强烈建议先用 API 跑一个月真实业务,拿到输入、输出和缓存命中的实际比例,再回到上面的盈亏表算账。API易 apiyi.com 已上架 kimi-k3.1-pro,价格与官方一致:$2.00 输入 / $10.00 输出 / 缓存读 $0.20(单位:美元 / 百万 tokens),型号与价格以平台型号列表为准。
接入要点(OpenAI 兼容接口):
- 在 API易 apiyi.com 注册并创建 API Key,新用户有免费测试额度
- 把 SDK 的 base_url 设为
https://api.apiyi.com/v1 - 模型 ID 填
kimi-k3.1-pro;对速度要求高可换成kimi-k3.1-pro-highspeed($4.00 输入 / $20.00 输出) - 推理强度参数:
reasoning_effort可选low/high/max,官方默认max;官方评测设置为temperature = 1.0、top_p = 0.95 - 多轮对话和工具调用时,必须把带
reasoning_content的 assistant 消息原样回传,否则上下文会出错 - 写好统计脚本,按天记录
prompt_tokens、completion_tokens和缓存命中量,作为日后自建决策的依据
| 模型 | 输入 | 输出 | 缓存读 | 可用平台 |
|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | API易 apiyi.com、Kimi 官方 API |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | API易、Kimi 官方 API |
| kimi-k3 | $3.00 | $15.00 | $0.30 | API易 |
🚀 快速开始:如果你的项目还在验证阶段,推荐通过 API易 apiyi.com 用同一个 Key 同时测试 kimi-k3.1-pro 和其他主流模型,先确认 K3.1 Pro 在你的任务上确实最优,再讨论要不要自建。
Kimi K3.1 Pro 本地部署常见问题
Q1:Kimi K3.1 Pro 的权重现在能下载吗?
还不能。官方原文是「The full model weights will be released by Nov 4」,即 2026 年 11 月 4 日前发布。本文的硬件数字全部按已开源的 K3 推算,权重发布后请以实际文件体积为准再核对一遍。
Q2:8 张 H200 为什么跑不起来 Kimi K3.1 Pro?
8×H200 总显存 1.13TB,而 K3 权重实测 1560.9GB,差约 400GB。而且 Hopper 不原生支持 MXFP4,即便用两台 16×H200 也需要运行时反量化,速度上不去。
Q3:「贵 19 倍」是怎么算出来的?
这个数字来自第三方实测:Modal 8×B300 每小时 $56.79,单请求稳态约 92 tok/s,折算每百万输出 token 约 $190.00,除以官方 API 输出价 $10.00 得 19 倍。按 92 tok/s 严格计算是 $171.50,原作者的口径还包含了实际运行中的损耗。
Q4:小团队自建 Kimi K3.1 Pro 有没有省钱的办法?
基本没有。买断路线每月约 20 万元还不含人力;量化塞单机反而更贵、效果更差。小团队更现实的做法是走按量 API,例如通过 API易 apiyi.com 调用 kimi-k3.1-pro,用多少付多少,缓存命中部分只需 $0.20/百万 token。
Q5:如何通过 API 快速调用 Kimi K3.1 Pro?
在 API易 apiyi.com 注册获取 Key,将 base_url 设为 `https://api.apiyi.com/v1`,模型填 `kimi-k3.1-pro` 即可。现有 OpenAI SDK 代码基本不用改,注意多轮对话时要回传 `reasoning_content`。
Q6:Kimi K3.1 Pro 本地部署有哪些已知限制?
主要有三点。第一,冷启动约 27 分钟,不适合弹性扩缩。第二,vLLM 镜像只有 CUDA 13 版本,驱动要 r580+,老集群需要先升级。第三,分布式 KV cache 在已列出的硬件上都不支持,多机扩展受限。
Q7:什么时候本地部署会变得现实?
等社区推出 30B–120B 级别的蒸馏版本,才是个人和小团队能在本地跑的形态。全量 3T 级模型短期内仍然是数据中心级别的负载。
Kimi K3.1 Pro 本地部署 Key Takeaways
- 权重未发布:官方承诺 11 月 4 日前发布,现有数字均为按 K3 推算
- 硬件下限:权重 1560.9GB,单机至少需要 8×B300、GB300 或 MI355X
- 月成本量级:单机 24/7 运行约 16–34 万元/月,具体取决于路线
- 单位成本:自用约 $190.00/百万输出 token,是官方 API 的 19 倍
- 追平条件:长期吞吐 1,500 tok/s 以上,月输出十亿 token 级别
- 上手方式:先通过 API易 apiyi.com 调用 kimi-k3.1-pro 跑真实业务,用数据决定是否自建
Kimi K3.1 Pro 部署方式自查清单
逐条回答下面 5 个问题,就能判断自己该租、该买还是用 API:
- 数据是否被合规要求禁止出内网,且官方 ZDR 也无法满足?——否,直接用 API
- 是否需要拿权重做微调或蒸馏?——是,考虑短期按量租机器,用完即停
- 每月输出 token 是否稳定超过 13 亿?——否,自建一定比 API 贵
- 是否已有闲置的 8×B300 / MI355X 级别机器和专职运维?——是,可以考虑自建;否则不要为此专门买机器
- 业务是否需要随时启停、弹性扩缩?——是,自建冷启动 27 分钟扛不住,选 API
总结
Kimi K3.1 Pro 本地部署的核心结论:
- 门槛高:按 K3 推算权重约 1.56TB,8×B300 才刚好装下
- 自用贵:单机自用约 $190.00/百万输出 token,是 API 的 19 倍
- 规模才划算:吞吐长期过 1,500 tok/s、月输出十亿 token 级别,才轮得到自建
对国内大多数开发者和小团队来说,正确顺序是先用 API 跑通业务、积累用量数据,再判断是否值得自建。推荐通过 API易 apiyi.com 调用 kimi-k3.1-pro,价格与官方一致,新用户有免费额度,一个 Key 还能顺手对比其他主流模型。
📚 参考资料
- Kimi K3.1 Pro 官方发布博客:权重发布时间与模型定位
- 链接:
kimi.ai/blog/kimi-k3-1-pro -
说明: 官方原文,确认权重将于 11 月 4 日前发布
-
Kimi 官方 API 价目:K3.1 Pro 输入、输出、缓存价格
- 链接:
platform.kimi.ai/docs/pricing/chat -
说明: 本文 API 对照价的来源
-
Kimi K3 模型卡:架构、量化与协议
- 链接:
huggingface.co/moonshotai/Kimi-K3 -
说明: 2.8T 总参数、MXFP4 量化、Kimi K3 License
-
vLLM Kimi K3 Recipe:最小显存与部署要求
- 链接:
recipes.vllm.ai/moonshotai/Kimi-K3 -
说明: 至少 8×GB300,最小显存 1680GB
-
AWS 8×B300 推理实测:吞吐数据
- 链接:
github.com/aws-samples/sample-llm-inference-on-eks -
说明: 高并发总吞吐 4,634 tok/s
-
GPUStack 8×B300 实测:vLLM 与 SGLang 长上下文对比
- 链接:
cnblogs.com/gpustack/p/22073008 - 说明: 64K / 200K 输入的端到端耗时
作者:APIYI 技术团队
技术交流:欢迎在 API易 官网首页联系我们,更多模型接入资料可访问 docs.apiyi.com 文档中心