Catatan penulis: Berdasarkan data pengujian Kimi K3 yang sudah dirilis sebagai open source, artikel ini memperkirakan kebutuhan perangkat keras, biaya bulanan, biaya per token, dan titik impas untuk deployment lokal K3.1 Pro. Tujuannya membantu Anda menentukan kapan sebaiknya menyewa, membeli, atau langsung menggunakan API.
Kesimpulannya: Kimi K3.1 Pro akan segera dirilis sebagai open source, tetapi deployment lokal bukan untuk pengguna perorangan. Pihak resmi menyatakan bahwa bobot model lengkap akan dirilis sebelum 4 November, dengan skala model berbobot terbuka kelas 3T. Per 26 Oktober 2026, bobot K3.1 Pro belum dirilis. Semua angka kebutuhan perangkat keras dan VRAM dalam artikel ini dihitung berdasarkan hasil pengujian Kimi K3 yang sudah dirilis sebagai open source. Angka-angka tersebut perlu ditinjau ulang setelah bobot model dirilis.
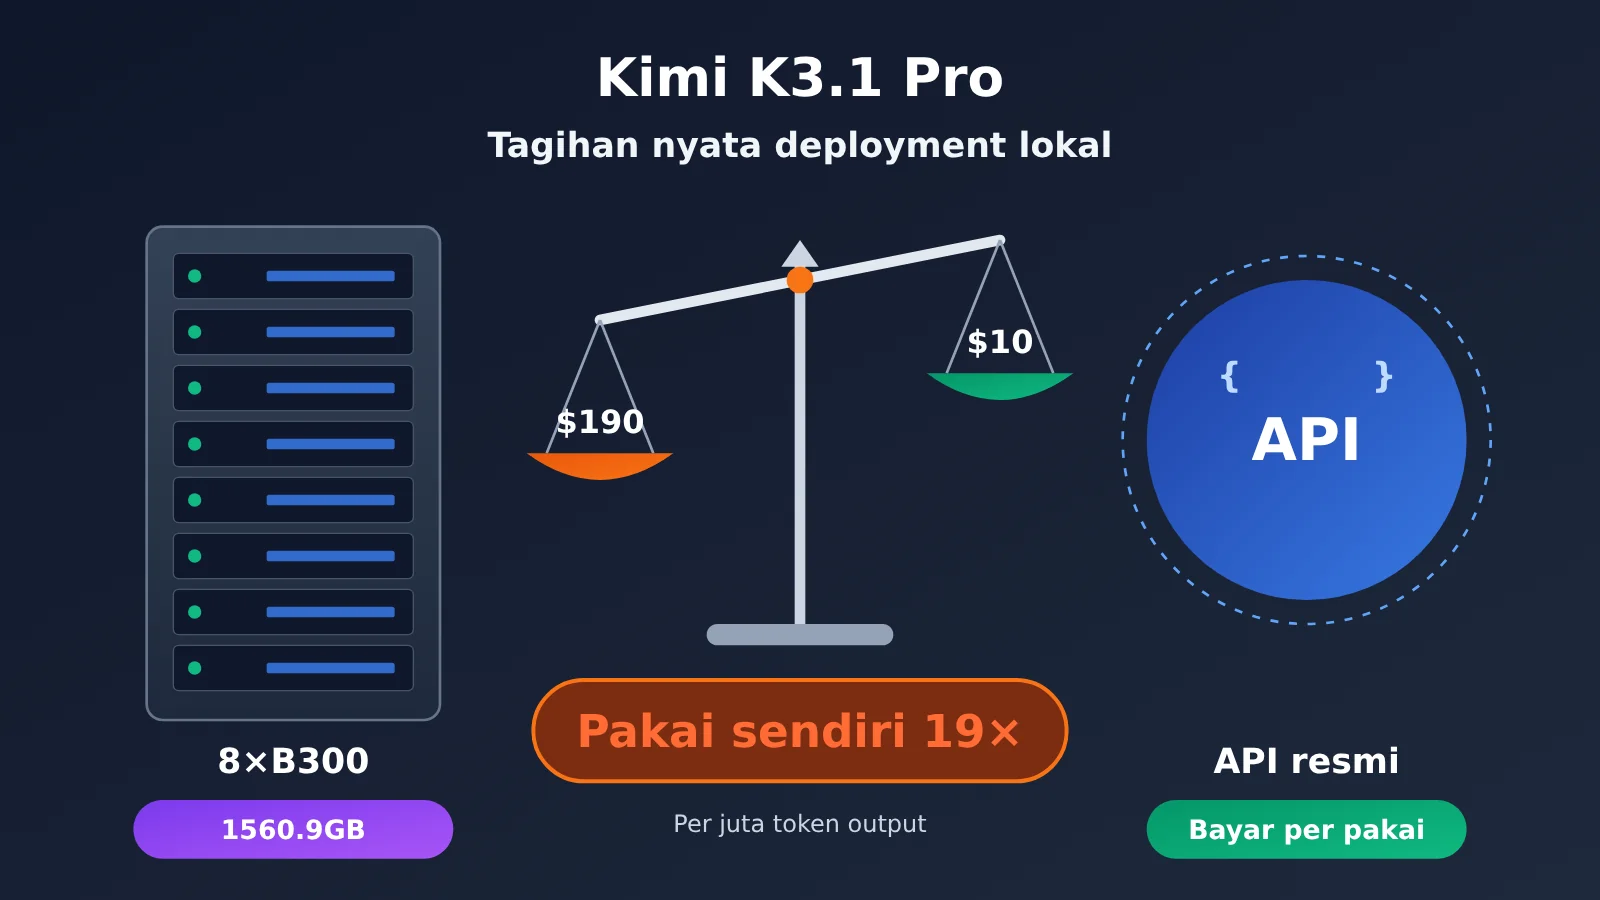
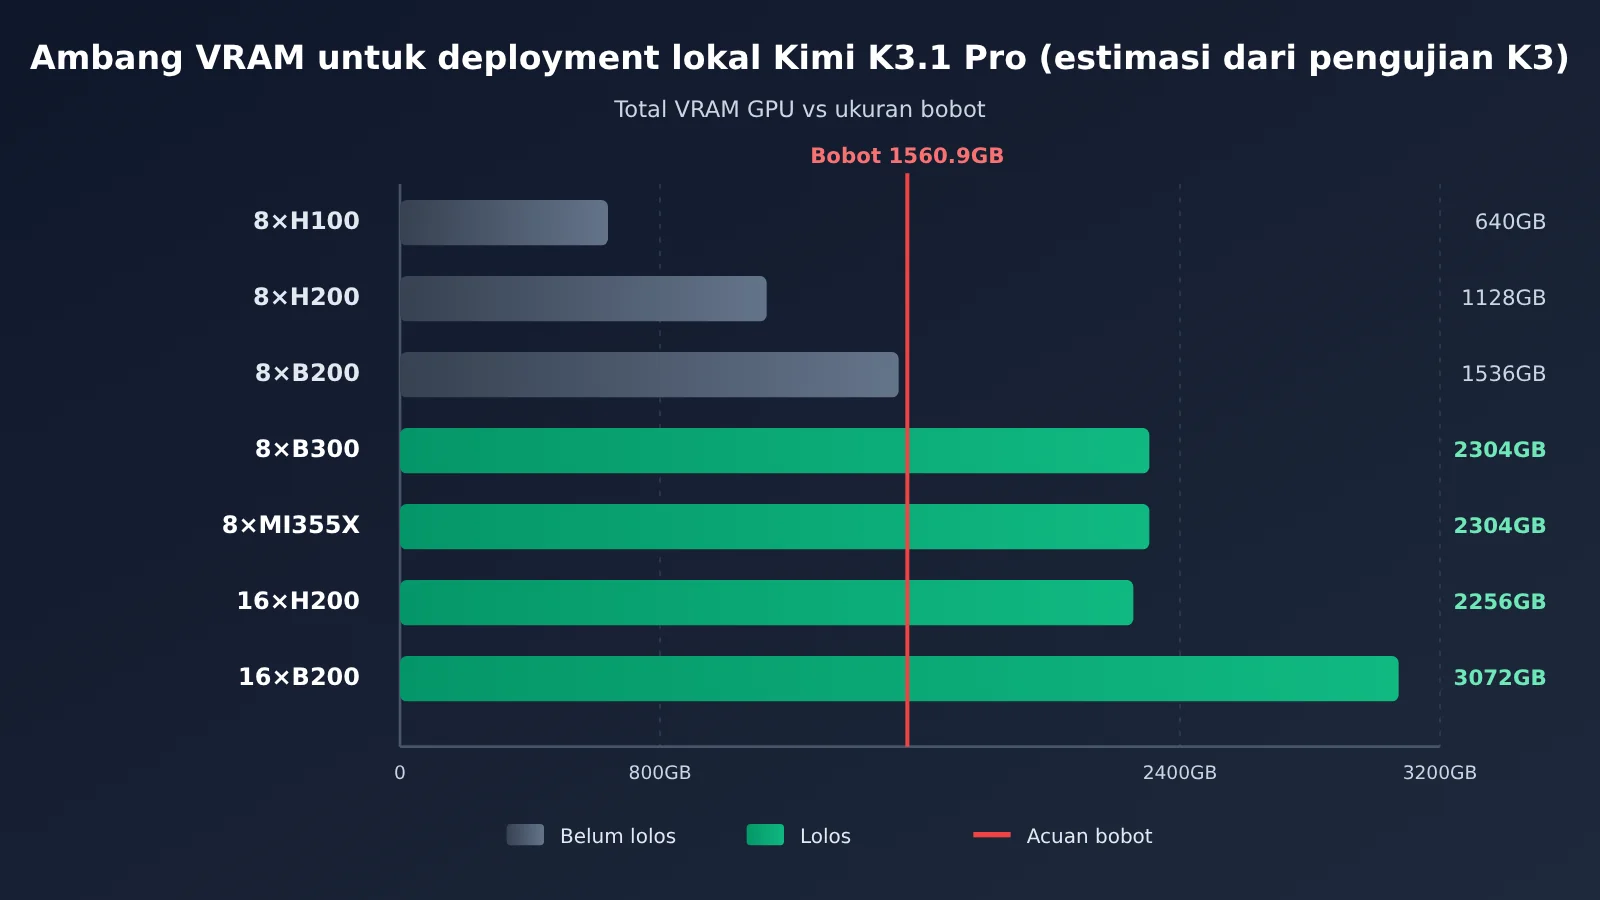
Berdasarkan pengujian K3, bobot model saja mencapai 1560,9 GB. Delapan kartu B300 pas-pasan untuk menampungnya, sedangkan delapan kartu H200 masih kurang sekitar 400 GB. Jika satu mesin 8×B300 hanya digunakan untuk Anda sendiri, biayanya sekitar $190,00 per satu juta token output—19 kali harga API resmi ($10,00).
Artikel ini bukan untuk membuat Anda mengurungkan niat, melainkan panduan untuk memutuskan apakah Anda perlu membangun infrastruktur sendiri. Setiap angka dilabeli dengan sumbernya: dokumen resmi, pengujian pihak ketiga, atau estimasi dalam artikel ini. Anda bisa langsung mencocokkan angka-angkanya dengan volume penggunaan bisnis Anda.
Manfaat utama: Setelah membaca artikel ini, Anda bisa menghitung biaya sebenarnya untuk menjalankan Kimi K3.1 Pro sendiri dan menggunakan daftar periksa untuk menentukan apakah sebaiknya menyewa mesin, membeli mesin, atau langsung memanggil API.
Poin Utama Deploy Lokal Kimi K3.1 Pro
| Poin | Kesimpulan | Tingkat bukti |
|---|---|---|
| Status bobot | Belum dirilis; menurut pernyataan resmi, bobot akan dirilis sebelum 4 November | Sumber resmi |
| Ukuran bobot | Bobot K3 berukuran 1.560,9 GB; K3.1 Pro menggunakan arsitektur yang sama | Pengujian pihak ketiga (K3) |
| Konfigurasi minimum satu mesin | 8×B300 / 8×GB300 / 8×MI355X | Konfigurasi kerangka kerja inferensi + pengujian langsung |
| Biaya per unit untuk penggunaan sendiri | Sekitar $190,00 per satu juta token output | Tagihan pengujian pihak ketiga |
| Syarat untuk menyamai API | Output stabil jangka panjang di atas 1.500 tok/s | Estimasi artikel ini |
Penjelasan Tingkatan Bukti untuk Deploy Lokal Kimi K3.1 Pro
Artikel ini membagi bukti menjadi tiga tingkatan. Perhatikan perbedaannya saat membaca. Sumber resmi merujuk pada pernyataan Moonshot di blog kimi.ai, dokumentasi platform.kimi.ai, dan kartu model Hugging Face. Pengujian pihak ketiga merujuk pada data pengujian yang dipublikasikan oleh pengguna AWS, GPUStack, OpenZeka, Modal, dan lainnya. Sumber dan tanggalnya akan dicantumkan di artikel. Estimasi artikel ini adalah hasil perhitungan kami berdasarkan harga dan throughput yang tersedia untuk umum. Rumus dan asumsinya akan dijelaskan, dan angka ini bukan data resmi.
Dasar perhitungannya juga bersumber dari informasi resmi: K3.1 Pro adalah versi Kimi K3 yang telah menjalani pascapelatihan (post-trained version of Kimi K3) dengan arsitektur yang sama, tetapi menggunakan komputasi pascapelatihan RL yang lebih besar. Karena itu, jumlah parameter, format kuantisasi, dan ukuran bobot K3 dapat dijadikan acuan yang wajar untuk memperkirakan kebutuhan minimum deploy K3.1 Pro.
Ambang perangkat keras untuk deployment lokal Kimi K3.1 Pro: Mengapa harus mulai dari 8 B300
【Dokumen resmi】Kartu model K3 menunjukkan: total 2,8T parameter, 104B parameter aktif, dan 93 lapisan; 896 pakar routing, dengan 16 pakar dipilih untuk setiap token, serta 2 pakar bersama. Jendela konteksnya 1.048.576 token. Bobot menggunakan MXFP4 dan aktivasi menggunakan MXFP8. Pelatihan sadar kuantisasi sudah diterapkan sejak tahap SFT.
【Pengujian pihak ketiga】Seseorang menghitung satu per satu berkas di repositori Hugging Face: total 96 shard safetensors berukuran 1.560.936.091.448 byte, atau sekitar 1.560,9 GB. Ukuran hasil pengujian lebih besar daripada nilai teoretis «2,8T × 0,5 byte = 1.400 GB» karena beberapa bagian dalam config—seperti lapisan atensi, pakar bersama, lm_head, dan menara visual—masuk daftar putih sehingga tetap menggunakan presisi tinggi. Resep vLLM menetapkan kebutuhan VRAM minimum 1.680 GB dan menyatakan bahwa setidaknya diperlukan 8×GB300. Untuk lalu lintas produksi, dibutuhkan beberapa node.
| Konfigurasi | Total VRAM | Bisa dijalankan? | Keterangan |
|---|---|---|---|
| 8×H100 80GB | 640GB | Tidak | Ukuran bobot 2,4 kali kapasitas VRAM |
| 32×H100 | 2,56TB | Nyaris | SGLang menyediakan resep, tetapi Hopper tidak mendukung MXFP4 secara native sehingga perlu dekuantisasi saat runtime |
| 8×H200 141GB | 1,13TB | Tidak | Kurang sekitar 400GB, konfigurasi yang paling disayangkan |
| 16×H200 (dua mesin) | 2,26TB | Bisa | Tetap perlu dekuantisasi |
| 8×B200 180GB | 1,44TB | Tidak | Kurang sekitar 120GB |
| 16×B200 / GB200 | 2,88TB | Bisa | Konfigurasi acuan Blackwell |
| 8×B300 / GB300 | 2,30TB | Bisa | Jalur bawaan resmi, pas untuk satu mesin |
| 8×MI355X | 2,30TB | Bisa | Validasi AMD sejak hari pertama |
| Satu kartu / RTX 4090 / Mac 512GB | — | Tidak | Perlu 75 RTX 4090 untuk menampung bobot |
KV cache bukanlah hambatan utama. K3 hanya memiliki 24 lapisan Gated MLA, dengan kebutuhan sekitar 27 KiB/token. Sementara itu, 69 lapisan KDA lainnya hanya memerlukan status tetap untuk setiap urutan. Perhitungan pihak ketiga menunjukkan bahwa KV cache untuk satu pengguna dengan konteks 1M sekitar 29,5GB, sedangkan untuk konteks 8K sekitar 0,7GB. Yang benar-benar menjadi kendala adalah bobotnya sendiri yang berukuran 1,56TB.
Jika Anda tetap ingin melakukan deployment, berikut persyaratan wajib dari sisi framework (berdasarkan resep vLLM dan cookbook SGLang untuk K3):
- Image vLLM:
vllm/vllm-openai:kimi-k3, hanya tersedia dalam versi CUDA 13, memerlukan driver r580+ dan vLLM ≥ 0.27.0 - Strategi paralelisme: minimal 8 kartu untuk TP / TEP dan minimal 16 kartu untuk DEP; KV cache terdistribusi tercatat tidak didukung pada semua perangkat keras yang tercantum
- Perencanaan node SGLang: B300 menggunakan 1 node dengan 8 kartu; B200 dan H200 masing-masing memerlukan 2 node dengan 8 kartu
- Menurut keterangan Moonshot pada Agustus 2026 (dikutip oleh pihak ketiga), lingkungan produksi disarankan menggunakan supernode dengan lebih dari 64 akselerator
Tagihan nyata deployment lokal Kimi K3.1 Pro: biaya bulanan untuk empat opsi
Perkiraan berikut menggunakan konfigurasi satu server dengan 8×B300 yang beroperasi 24 jam sehari, 7 hari seminggu. Kurs yang digunakan adalah 1 dolar AS = 7,25 yuan. Sumber harga berasal dari tiga jenis data: penawaran harga bayar sesuai pemakaian yang dihimpun ComputeUnion pada 24–25 Oktober 2026, tagihan aktual pengguna Modal, dan notulen Riset Industri Penyewaan Komputasi (dimuat ulang oleh Sina Finance pada 20 Mei 2026).
⚠️ Harga sewa server lengkap dan pembelian di Tiongkok—misalnya H200 sekitar 80.000 yuan/bulan/unit, B300 dengan kontrak lima tahun sekitar 160.000–190.000 yuan/bulan/unit, dan B300 harga spot 6,8–7 juta yuan/unit—merupakan angka berdasarkan riset industri, bukan harga resmi yang dipublikasikan vendor. Angka ini hanya sebagai gambaran kisaran biaya. Umumnya, objek yang disewakan adalah server lengkap dengan delapan kartu, dengan masa kontrak minimum satu tahun.
| Opsi | Dasar perhitungan | Biaya bulanan | Catatan |
|---|---|---|---|
| Sewa bayar sesuai pemakaian di luar negeri (24/7) | Server B300 lengkap seharga 342–464 yuan per jam × 730 jam | Sekitar 249.800–338.700 yuan (US$34.500–46.700) | Penawaran pihak ketiga + estimasi artikel ini |
| Tagihan aktual Modal (24/7) | US$56,79/jam × 730 jam | US$41.457,00, sekitar 300.600 yuan | Tagihan aktual pihak ketiga |
| Sewa server lengkap di Tiongkok dengan kontrak lima tahun | Berdasarkan riset industri | 160.000–190.000 yuan | Harga tidak dipublikasikan; kontrak minimum satu tahun |
| Beli putus + listrik | Harga 6,8–7 juta yuan disusutkan secara garis lurus selama 3 tahun, ditambah biaya listrik sekitar 8.800 yuan | Sekitar 198.000–203.000 yuan | Belum termasuk tenaga operasional, suku cadang, ruang server, dan bandwidth |
| Hanya beroperasi 4 jam sehari, lalu dimatikan | Sewa bayar sesuai pemakaian di luar negeri | Sekitar 26.000–30.000 yuan | Setiap kali dinyalakan kembali, cold start memerlukan sekitar 27 menit |
Biaya listrik dihitung berdasarkan asumsi dalam artikel ini: beban 13,2 kW, PUE 1,3, dan tarif listrik 0,7 yuan/kWh. Biayanya sekitar 12 yuan per jam. Opsi beli putus sekilas tampak paling murah, tetapi tabel ini belum memasukkan biaya tenaga kerja teknisi operasional—padahal bagi tim kecil, inilah salah satu pengeluaran tersembunyi terbesar.
Opsi “beroperasi 4 jam sehari, lalu dimatikan” tampak hemat, tetapi sulit diterapkan dalam praktik. Berdasarkan pengujian Modal, cold start memerlukan sekitar 27 menit untuk memuat bobot model sebesar 1,56 TB, menjalankan kompilasi JIT, dan merekam 51 CUDA graph. Untuk tugas singkat, waktu tunggu saat model dinyalakan bisa lebih lama daripada waktu inferensinya.
Biaya per Unit Kimi K3.1 Pro: Throughput Menentukan Berapa Kali Lebih Mahal Dibanding API
Biaya langganan bulanan hanya gambaran di permukaan. Yang benar-benar menentukan apakah biayanya sepadan adalah biaya per satu juta token. Rumus estimasi dalam artikel ini: biaya per satu juta token output = biaya mesin per jam ÷ jumlah token output per jam (dalam jutaan). Biaya mesin yang digunakan dalam semua perhitungan adalah $56.79/jam, berdasarkan pengukuran langsung Modal.
Hasil pengukuran pihak ketiga: Berikut beberapa data throughput untuk 8×B300:
- Modal, satu mesin (TP8, MXFP4 native): throughput stabil 92 tok/s, TTFT 0,92–1,02 detik
- OpenZeka (DGX B300, TP8, vLLM): 105,7 tok/s pada konkurensi 1; 32,45 tok/s per pengguna pada konkurensi 64. Diperkirakan mampu mendukung 150 pengguna untuk chat atau 50 pengguna untuk Agent
- Contoh resmi AWS (29 Juli 2026, p6-b300.48xlarge): 516 tok/s pada konkurensi 8, throughput total 4.634 tok/s pada konkurensi tinggi
- GPUStack (30 Juli 2026): input 64K dengan konkurensi 10, waktu end-to-end vLLM 100,5 detik; throughput agregat prefill sekitar 19K–23K tok/s
| Throughput output stabil | Output per jam | Biaya per satu juta token output | Dibandingkan API resmi $10.00 |
|---|---|---|---|
| 92 tok/s (satu permintaan berjalan penuh) | 0,33M | $171.50 (perhitungan penulis asli: $190.00) | sekitar 17–19 kali |
| 500 tok/s | 1,80M | $31.50 | sekitar 3 kali |
| 1.000 tok/s | 3,60M | $15.80 | sekitar 1,6 kali |
| 1.500 tok/s | 5,40M | $10.50 | kurang lebih setara |
| 3.000 tok/s | 10,80M | $5.30 | sekitar setengahnya |
| 4.634 tok/s (puncak hasil pengukuran AWS) | 16,68M | $3.40 | sekitar sepertiganya |
Jika hanya digunakan oleh satu atau beberapa orang, hasilnya pada praktiknya ada di baris pertama. Kalau konkurensinya tidak cukup tinggi, sebagian besar waktu mesin menganggur. Biayanya sekitar $190.00 per satu juta token output—dari sinilah klaim “19 kali lebih mahal” pada judul berasal. Biaya per unit dari infrastruktur yang dikelola sendiri baru bisa menyamai API jika bisnis mampu mempertahankan throughput di atas 1.500 tok/s dalam jangka panjang.
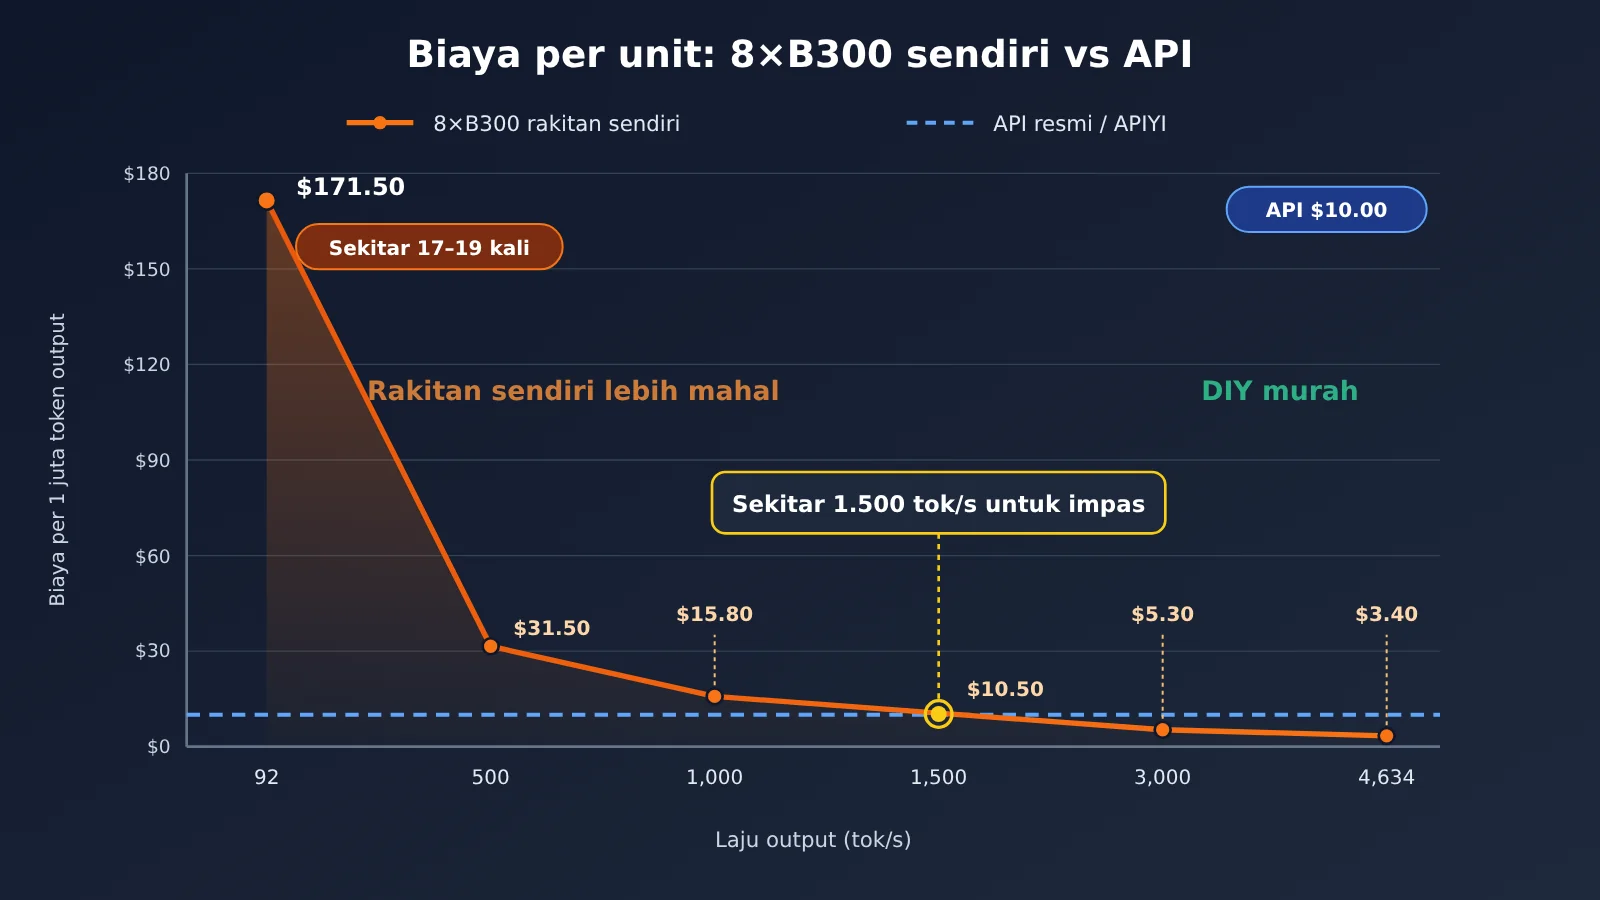
💡 Catatan perbandingan: Tolok ukur API pada grafik di atas menggunakan harga resmi $10.00 per satu juta token output. Harga output kimi-k3.1-pro di APIYI apiyi.com sama dengan harga resmi, jadi bisa langsung digunakan sebagai pembanding.
Titik Impas Deployment Lokal Kimi K3.1 Pro: Berapa Banyak Token yang Perlu Digunakan per Bulan?
Mari lihat dari sudut pandang lain: berapa banyak token yang perlu digunakan per bulan agar membangun infrastruktur sendiri biayanya setara dengan API? Estimasi dalam artikel ini menggunakan asumsi berikut: dibandingkan dengan harga API resmi sebesar $2,00 untuk input dan $10,00 untuk output, rasio input dan output 5:1 (rasio yang umum dalam skenario Agent), tanpa memperhitungkan cache hit.
| Opsi infrastruktur sendiri | Biaya bulanan | Token input yang dibutuhkan per bulan | Token output yang dibutuhkan per bulan |
|---|---|---|---|
| Pembayaran sesuai pemakaian di luar negeri, 24/7 | $41,457.00 | sekitar 10,4 miliar | sekitar 2,07 miliar |
| Server utuh dengan kontrak lima tahun di dalam negeri | 190.000 yuan | sekitar 6,55 miliar | sekitar 1,31 miliar |
| Pembelian putus (depresiasi + listrik) | 203.000 yuan | sekitar 6,98 miliar | sekitar 1,4 miliar |
Seberapa besar penggunaan 1–2 miliar token output per bulan? Menurut estimasi OpenZeka, satu mesin 8×B300 mampu mendukung 50 pengguna Agent secara bersamaan. Tim kecil dengan anggota kurang dari sepuluh orang akan jauh dari kebutuhan sebesar itu.
Ada satu faktor lain yang mudah terlewat: cache. Harga resmi untuk cache hit hanya $0,20 per juta token, sementara tingkat cache hit dalam skenario Agent dan dokumen panjang biasanya cukup tinggi. Semakin besar proporsi cache, semakin murah biaya API, sehingga titik impas untuk membangun infrastruktur sendiri akan semakin tinggi.
Dalam Situasi Apa Sebaiknya Menjalankan Kimi K3.1 Pro Sendiri?
Menjalankan model sendiri bukan berarti tidak boleh, tetapi harus ada alasan yang jelas. Dalam beberapa situasi berikut, pilihan ini masuk akal:
- Kepatuhan atau operasi offline merupakan kebutuhan utama: Data tidak boleh keluar dari jaringan internal dan harus dipisahkan secara fisik. Semurah apa pun API, tetap tidak bisa digunakan. Namun, API resmi sudah mendukung penyimpanan data nol (ZDR). Sebaiknya pastikan dulu apakah fitur ini memenuhi persyaratan kepatuhan Anda.
- Ingin melakukan fine-tuning dan distilasi: Anda ingin melakukan pascapelatihan untuk domain tertentu berdasarkan K3.1 Pro, atau mendistilasinya menjadi model kecil berukuran 30B–120B. Dalam situasi ini, Anda harus memiliki bobot model lengkap.
- Memiliki GPU yang tidak terpakai dan staf khusus untuk operasional: Anda sudah memiliki 8×B300, 8×MI355X, atau dua H200 yang menganggur, serta memiliki engineer yang memahami vLLM / SGLang untuk menangani operasional. Barulah biaya marginalnya bisa rendah.
- Volume bisnis memang cukup besar: Anda mampu mempertahankan throughput di atas 1.500 tok/s dalam jangka panjang, dengan output bulanan mencapai skala satu miliar token.
Periksa juga ketentuan lisensinya sejak awal. K3 menggunakan Kimi K3 License. Menurut ringkasan pihak ketiga, layanan model yang menghasilkan pendapatan tahunan lebih dari 20 juta dolar AS dari penyediaan layanan model kepada pihak luar memerlukan lisensi terpisah. Ketentuan untuk K3.1 Pro perlu merujuk pada LICENSE di repositori Hugging Face setelah bobot model dirilis. Untuk saat ini, kita belum bisa menyimpulkan apa pun atas nama pihak resmi.
Dalam Kondisi Apa Sebaiknya Jangan Membangun Kimi K3.1 Pro Sendiri
Membangun sendiri kemungkinan besar akan merugikan jika alasannya seperti berikut:
- Ingin menghemat biaya: kecuali throughput secara konsisten melebihi 1.500 tok/s, biaya per unit justru lebih tinggi daripada API. Untuk penggunaan pribadi, biayanya sekitar 19 kali lipat.
- Ingin menjalankan tugas jangka panjang, tetapi juga ingin menyalakan dan mematikan sesuai kebutuhan: cold start memakan waktu sekitar 27 menit, sehingga skema menyalakan dan mematikan server sesuai kebutuhan pada dasarnya tidak praktis.
- Hanya untuk diri sendiri atau tim kecil: kapasitas pemrosesan paralel tidak akan terpakai penuh. Artinya, Anda membayar $56.79 per jam hanya untuk kecepatan 92 tok/s.
- Berharap model terkuantisasi bisa muat di satu mesin: semua pendekatan komunitas belum layak dipakai untuk produksi. Unsloth 1-bit (UD-IQ1_S, 594GB) berjalan sekitar 9 tok/s di 8×A100. Biayanya setara $620.00 per satu juta token output—3,3 kali lebih mahal daripada solusi model penuh. Tingkat kesamaan top-1 antara model 1-bit dan model penuh sekitar 79%.
kimi-k3-in-cdapat menjalankan bobot lengkap dengan memori 8,24GB, tetapi kecepatannya hanya 10–32 detik per token, sehingga lebih tepat disebut demonstrasi teknis.
Bentuk yang benar-benar cocok untuk dijalankan secara lokal adalah versi distilasi yang mungkin dirilis komunitas nantinya. Sebelum itu tersedia, API adalah pilihan paling praktis untuk individu dan tim kecil.
Panduan Singkat Kimi K3.1 Pro: Jalankan Bisnis Terlebih Dahulu dengan API
Sebelum memutuskan untuk membangun sendiri, sangat disarankan untuk menjalankan bisnis sungguhan melalui API selama sebulan. Catat proporsi aktual input, output, dan cache hit, lalu gunakan data tersebut untuk menghitung biaya pada tabel untung-rugi di atas. APIYI apiyi.com kini menyediakan kimi-k3.1-pro dengan harga yang sama seperti harga resmi: $2.00 untuk input / $10.00 untuk output / $0.20 untuk pembacaan cache (dalam dolar AS per satu juta token). Model dan harganya mengikuti daftar model di platform.
Hal-hal penting untuk integrasi (API kompatibel dengan OpenAI):
- Daftar di APIYI apiyi.com dan buat kunci API. Pengguna baru mendapat kuota gratis untuk pengujian.
- Atur
base_urlSDK kehttps://api.apiyi.com/v1. - Isi ID model dengan
kimi-k3.1-pro. Jika membutuhkan kecepatan lebih tinggi, gunakankimi-k3.1-pro-highspeed($4.00 untuk input / $20.00 untuk output). - Parameter kekuatan penalaran:
reasoning_effortdapat diatur kelow/high/max; nilai default resmi adalahmax. Pengaturan evaluasi resmi menggunakantemperature = 1.0dantop_p = 0.95. - Dalam percakapan multi-giliran dan pemanggilan alat, pesan assistant yang berisi
reasoning_contentharus dikirim kembali tanpa perubahan. Jika tidak, konteks bisa menjadi tidak sesuai. - Siapkan skrip pencatatan untuk merekam
prompt_tokens,completion_tokens, dan jumlah cache hit setiap hari. Gunakan data ini sebagai dasar untuk memutuskan apakah perlu membangun sendiri di kemudian hari.
| Model | Input | Output | Pembacaan cache | Platform yang tersedia |
|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | APIYI apiyi.com, API resmi Kimi |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | APIYI, API resmi Kimi |
| kimi-k3 | $3.00 | $15.00 | $0.30 | APIYI |
🚀 Mulai cepat: Jika proyek Anda masih dalam tahap validasi, disarankan untuk menggunakan APIYI apiyi.com dengan kunci yang sama guna menguji kimi-k3.1-pro dan model-model populer lainnya. Pastikan terlebih dahulu bahwa K3.1 Pro memang paling cocok untuk tugas Anda, baru pertimbangkan apakah perlu membangun sendiri.
FAQ Deployment Lokal Kimi K3.1 Pro
Q1: Apakah bobot Kimi K3.1 Pro sudah bisa diunduh?
Belum. Pengumuman resmi menyebutkan, “The full model weights will be released by Nov 4”, artinya bobot akan dirilis sebelum 4 November 2026. Semua angka kebutuhan perangkat keras dalam artikel ini merupakan perkiraan berdasarkan K3 yang sudah dirilis sebagai open source. Setelah bobotnya dirilis, periksa kembali berdasarkan ukuran file sebenarnya.
Q2: Mengapa Kimi K3.1 Pro tidak bisa dijalankan dengan 8 GPU H200?
Total VRAM 8×H200 adalah 1,13 TB, sedangkan bobot K3 yang diukur mencapai 1560,9 GB, selisih sekitar 400 GB. Selain itu, Hopper tidak mendukung MXFP4 secara native. Bahkan dengan dua mesin yang masing-masing memiliki 16×H200, model tetap perlu menjalankan dekuantisasi saat runtime sehingga kecepatannya tidak bisa optimal.
Q3: Bagaimana perhitungan angka “19 kali lebih mahal”?
Angka ini berasal dari pengujian pihak ketiga: Modal 8×B300 dikenai biaya $56.79 per jam, dengan kecepatan stabil sekitar 92 tok/s untuk satu permintaan. Biayanya setara dengan sekitar $190.00 per sejuta token output. Dibagi harga output API resmi sebesar $10.00, hasilnya 19 kali lebih mahal. Jika dihitung tepat berdasarkan 92 tok/s, biayanya adalah $171.50. Perhitungan penulis aslinya juga memperhitungkan overhead saat pengoperasian.
Q4: Apakah ada cara bagi tim kecil untuk menghemat biaya saat membangun Kimi K3.1 Pro sendiri?
Pada dasarnya tidak ada. Opsi membeli perangkat keras membutuhkan biaya sekitar 200 ribu yuan per bulan, belum termasuk tenaga kerja. Menjalankan model terkuantisasi di satu mesin justru lebih mahal dengan hasil yang lebih buruk. Bagi tim kecil, pilihan yang lebih realistis adalah menggunakan API berbayar sesuai pemakaian, misalnya memanggil kimi-k3.1-pro melalui APIYI apiyi.com. Bayar sesuai pemakaian, dan token yang terkena cache hanya dikenai biaya $0.20 per sejuta token.
Q5: Bagaimana cara memanggil Kimi K3.1 Pro dengan cepat melalui API?
Daftar di APIYI apiyi.com untuk mendapatkan kunci API, lalu atur `base_url` ke `https://api.apiyi.com/v1` dan isi model dengan `kimi-k3.1-pro`. Kode yang menggunakan OpenAI SDK umumnya tidak perlu banyak diubah. Untuk percakapan multi-turn, pastikan Anda mengirim kembali `reasoning_content`.
Q6: Apa saja keterbatasan yang diketahui dalam deployment lokal Kimi K3.1 Pro?
Ada tiga keterbatasan utama. Pertama, cold start memerlukan sekitar 27 menit sehingga tidak cocok untuk penskalaan elastis. Kedua, image vLLM hanya tersedia untuk CUDA 13, jadi driver harus versi r580 atau lebih baru. Cluster lama perlu diperbarui terlebih dahulu. Ketiga, cache KV terdistribusi tidak didukung pada perangkat keras yang tercantum, sehingga opsi penskalaan ke beberapa mesin terbatas.
Q7: Kapan deployment lokal akan menjadi pilihan yang realistis?
Deployment lokal baru akan terjangkau bagi individu dan tim kecil setelah komunitas merilis versi distilasi berskala 30B–120B. Dalam waktu dekat, model penuh berskala 3T masih membutuhkan infrastruktur tingkat pusat data.
Poin Penting tentang Deployment Lokal Kimi K3.1 Pro
- Bobot model belum dirilis: pihak resmi berkomitmen merilisnya sebelum 4 November. Semua angka yang tersedia saat ini merupakan perkiraan berdasarkan K3.
- Kebutuhan hardware minimum: bobot model sebesar 1.560,9 GB. Satu mesin setidaknya memerlukan 8×B300, GB300, atau MI355X.
- Kisaran biaya bulanan: menjalankan satu mesin 24/7 membutuhkan sekitar 160.000–340.000 yuan per bulan, tergantung opsi yang dipilih.
- Biaya per unit: penggunaan sendiri sekitar $190,00 per sejuta token output, atau 19 kali biaya API resmi.
- Syarat agar biayanya sebanding: throughput jangka panjang di atas 1.500 tok/s dan output bulanan mencapai miliaran token.
- Cara memulai: coba dulu menjalankan bisnis nyata dengan memanggil kimi-k3.1-pro melalui APIYI apiyi.com. Gunakan data untuk menentukan apakah perlu membangun infrastruktur sendiri.
Daftar Periksa untuk Menentukan Cara Deployment Kimi K3.1 Pro
Jawab lima pertanyaan berikut untuk mengetahui apakah sebaiknya menyewa mesin, membeli mesin, atau menggunakan API:
- Apakah persyaratan kepatuhan melarang data keluar dari jaringan internal, dan ZDR resmi pun tidak memenuhi kebutuhan? — Jika tidak, langsung gunakan API.
- Apakah bobot model perlu digunakan untuk fine-tuning atau distilasi? — Jika ya, pertimbangkan menyewa mesin dalam jangka pendek dengan skema bayar sesuai pemakaian, lalu hentikan setelah selesai.
- Apakah output token bulanan stabil di atas 1,3 miliar? — Jika tidak, membangun sendiri pasti lebih mahal daripada menggunakan API.
- Apakah sudah tersedia mesin 8×B300 / MI355X atau kelas setara yang tidak terpakai, serta staf operasional khusus? — Jika ya, membangun sendiri bisa dipertimbangkan. Jika tidak, jangan membeli mesin khusus untuk kebutuhan ini.
- Apakah bisnis perlu bisa dimulai dan dihentikan kapan saja, serta kapasitasnya diskalakan secara fleksibel? — Jika ya, API lebih cocok karena cold start selama 27 menit pada sistem yang dibangun sendiri tidak dapat memenuhi kebutuhan tersebut.
Ringkasan
Kesimpulan utama tentang deployment lokal Kimi K3.1 Pro:
- Persyaratannya tinggi: Berdasarkan perkiraan K3, bobot modelnya sekitar 1,56 TB. Bahkan 8×B300 hanya cukup untuk menampungnya.
- Mahal untuk penggunaan pribadi: Biaya penggunaan pribadi di satu mesin sekitar $190,00 per juta token output, atau 19 kali lipat biaya API.
- Baru sepadan jika skalanya besar: Deployment mandiri baru layak dipertimbangkan jika throughput terus-menerus melampaui 1.500 tok/s dan output bulanan mencapai miliaran token.
Bagi sebagian besar developer dan tim kecil di Tiongkok, langkah yang tepat adalah menjalankan bisnis menggunakan API terlebih dahulu dan mengumpulkan data pemakaian, lalu menilai apakah deployment mandiri memang layak. Kami merekomendasikan penggunaan APIYI apiyi.com untuk memanggil kimi-k3.1-pro. Harganya sama dengan harga resmi, pengguna baru mendapat kuota gratis, dan satu Key juga bisa digunakan untuk membandingkan model-model utama lainnya.
📚 Referensi
- Blog pengumuman resmi Kimi K3.1 Pro: Waktu rilis bobot dan posisi model
- Tautan:
kimi.ai/blog/kimi-k3-1-pro -
Keterangan: Artikel resmi yang mengonfirmasi bobot model akan dirilis sebelum 4 November
-
Daftar harga API resmi Kimi: Harga input, output, dan cache K3.1 Pro
- Tautan:
platform.kimi.ai/docs/pricing/chat -
Keterangan: Sumber harga API sebagai pembanding dalam artikel ini
-
Model Card Kimi K3: Arsitektur, kuantisasi, dan lisensi
- Tautan:
huggingface.co/moonshotai/Kimi-K3 -
Keterangan: Total 2,8T parameter, kuantisasi MXFP4, dan Kimi K3 License
-
Resep vLLM Kimi K3: Persyaratan minimum VRAM dan deployment
- Tautan:
recipes.vllm.ai/moonshotai/Kimi-K3 -
Keterangan: Minimal 8×GB300, dengan kebutuhan VRAM minimum 1.680 GB
-
Pengujian inferensi AWS dengan 8×B300: Data throughput
- Tautan:
github.com/aws-samples/sample-llm-inference-on-eks -
Keterangan: Throughput total mencapai 4.634 tok/s pada konkurensi tinggi
-
Pengujian GPUStack dengan 8×B300: Perbandingan vLLM dan SGLang untuk konteks panjang
- Tautan:
cnblogs.com/gpustack/p/22073008 - Keterangan: Waktu pemrosesan end-to-end untuk input 64K / 200K
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda situs resmi APIYI. Untuk informasi lebih lanjut tentang integrasi model, kunjungi pusat dokumentasi di docs.apiyi.com