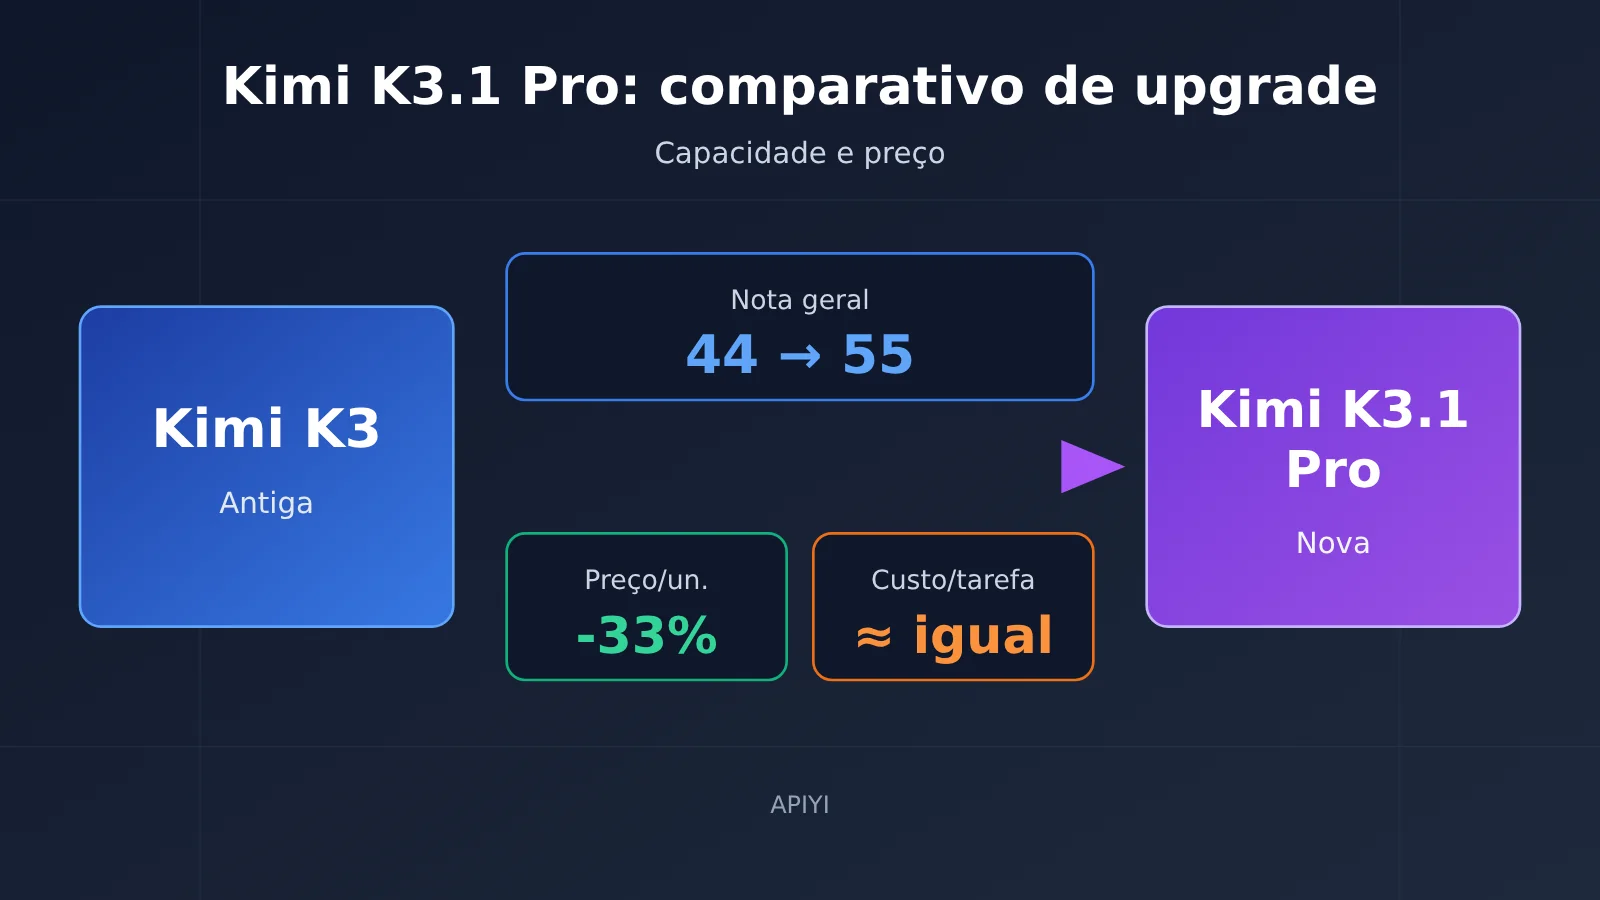
Em termos de capacidade, o Kimi K3.1 Pro representa um avanço significativo em relação ao K3: a pontuação geral da Artificial Analysis, uma organização independente, subiu de 44 para 55, e o resultado do K3 no Terminal-Bench 4.0, um benchmark de terminal para agentes de programação, passou de 13% para 67%. Já o preço caiu 33%: os valores por token de entrada, saída e cache são todos menores que os do K3. Ainda assim, como o K3.1 Pro gera respostas mais longas e está sempre em modo de raciocínio, o custo real de executar uma tarefa fica praticamente igual ao do K3.
A seguir, apresento as evidências e classifico a fonte de cada informação em três categorias: «declarada oficialmente», «terceira parte» e «não verificada». Este artigo não é uma simples recapitulação do anúncio, nem tenta convencer todo mundo a migrar imediatamente. A ideia é ajudar desenvolvedores que já usam o K3 a decidir se vale a pena migrar no seu caso, quando fazer isso e a que pontos prestar atenção durante a migração.
1. Cinco diferenças fundamentais entre o Kimi K3.1 Pro e a geração anterior
O K3.1 Pro não é um modelo novo treinado do zero. Ele foi desenvolvido a partir do K3, com um amplo processo de «pós-treinamento». Pós-treinamento é o ajuste da forma como o modelo trabalha, feito com mais dados e feedback depois que o modelo-base já foi treinado. Segundo a empresa, ele é o «primeiro modelo da série K3.1» e o «modelo de pesos abertos mais poderoso na categoria de 3T». Pesos abertos significa que os arquivos de parâmetros do modelo serão disponibilizados publicamente para download e implantação própria. A Artificial Analysis registra 2,8T de parâmetros no total, dos quais 104B de parâmetros ativos participam dos cálculos a cada execução.
| Dimensão | Kimi K3 | Kimi K3.1 Pro | Fonte |
|---|---|---|---|
| Método de treinamento | Versão-base | Pós-treinamento baseado no K3, com um grande aumento no poder computacional dedicado a essa etapa | Declarado oficialmente |
| Capacidade geral | Intelligence Index 44 | 55, 4º lugar no ranking geral | Terceira parte (AA, 2026-10-23) |
| Preço por token | Entrada: US$ 3 / saída: US$ 15 | Entrada: US$ 2 / saída: US$ 10, redução de 33% | Preços oficiais |
| Saída por tarefa | Média de 48K tokens | Média de 55K tokens, aumento de 14% | Terceira parte (AA) |
| Contexto / modalidades | 1M / texto + imagem | 1M / texto + imagem, sem mudanças | Declarado oficialmente |
Tokens são a unidade básica usada para medir e cobrar o uso do modelo. Dá para entendê-los, de forma aproximada, como «fragmentos de palavras»: um caractere chinês costuma corresponder a um ou dois tokens. Ao ler a tabela, vale prestar atenção primeiro a duas mudanças: a pontuação de capacidade subiu e o preço por token caiu. A coluna «Saída por tarefa» indica quanto dessa redução de preço se traduz em economia real. A seção 4 detalha esse ponto.
Quanto aos pesos, a empresa se comprometeu a disponibilizar o modelo completo antes de 2026-11-04. Na data atual (2026-10-24), isso ainda é uma promessa, não foi cumprida e, portanto, permanece «não verificado». A avaliação da Artificial Analysis é que, quando os pesos forem disponibilizados, o K3.1 Pro será o modelo de pesos abertos com a maior pontuação no ranking da organização. A diferença entre a pontuação mais alta de um modelo de pesos abertos e a de um modelo fechado cairá de 12 para 3 pontos.
2. Comparação de benchmarks do Kimi K3.1 Pro: métricas oficiais e de terceiros
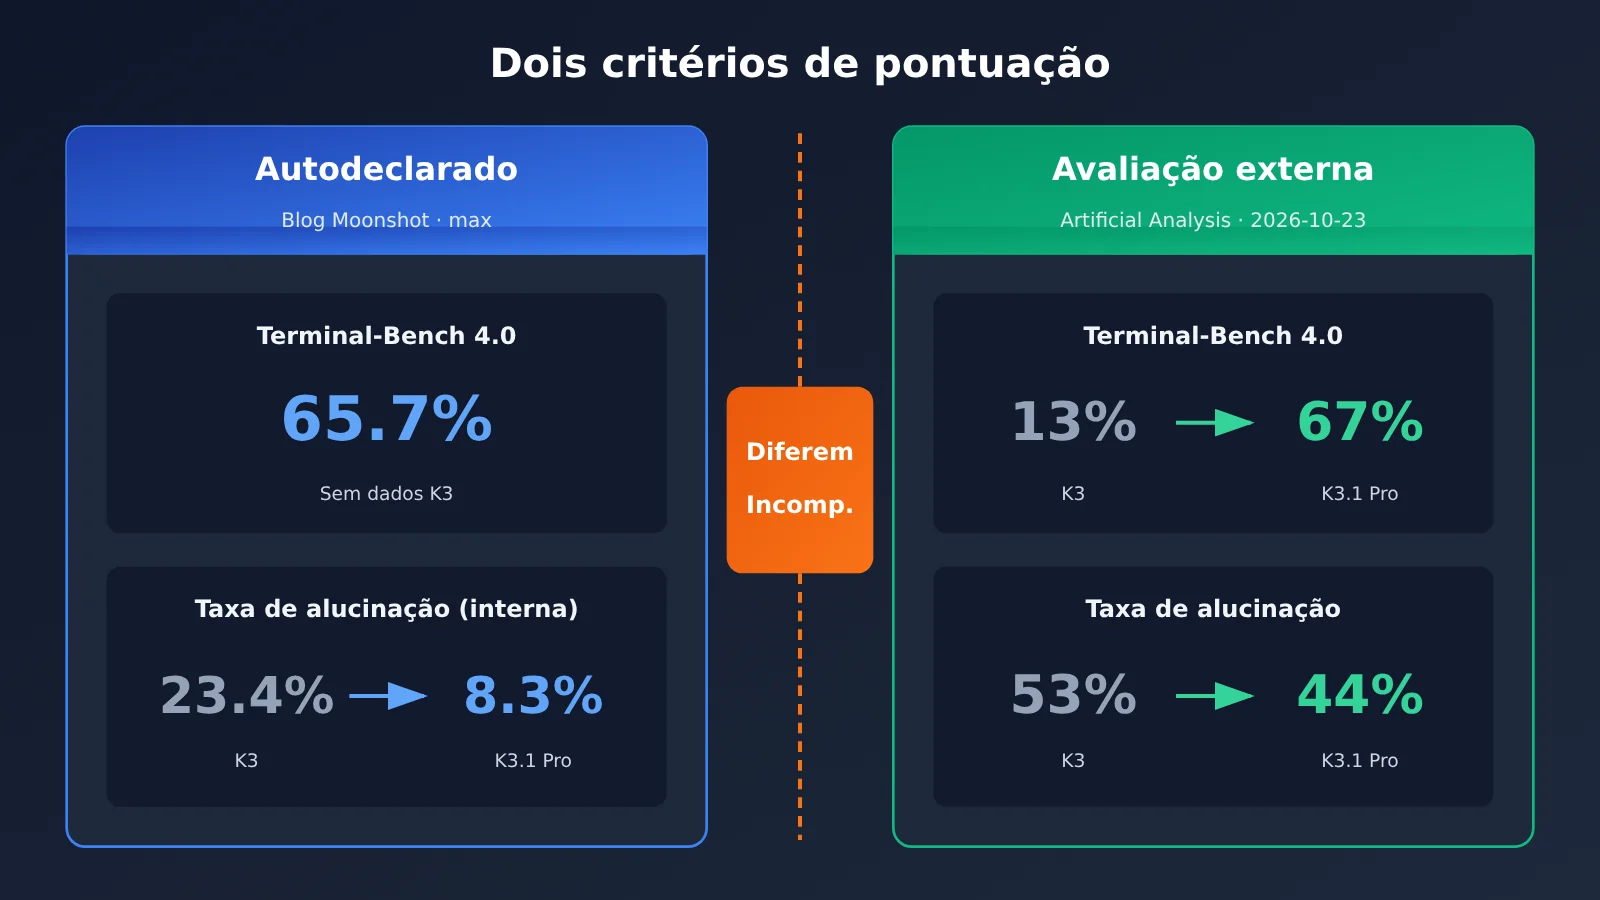
Antes de tudo, vale destacar: as duas tabelas abaixo vêm de instituições diferentes e foram feitas em ambientes de teste distintos. Por isso, não dá para comparar os resultados diretamente. O exemplo mais claro é o Terminal-Bench 4.0: a Moonshot informou 65,7%, enquanto a Artificial Analysis mediu 67% em um teste independente. São resultados de dois testes diferentes, não uma divergência em torno de uma mesma pontuação. A Moonshot também não divulgou resultados do K3 no Terminal-Bench 4.0; os 13% do K3 vêm apenas da Artificial Analysis.
2.1 Resultados oficiais do Kimi K3.1 Pro
Fonte: blog oficial da Moonshot. Condições de teste: salvo indicação em contrário, todos os testes foram feitos com reasoning_effort=max (intensidade de raciocínio no máximo), temperature=1.0 e top_p=0.95. Os testes identificados como “internos” usam conjuntos de dados criados pela própria Moonshot e não podem ser reproduzidos externamente.
| Item | K3.1 Pro | Comparação | Observações |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | GPT-6 Astra: 58,2%; Claude Opus 5.5: 66,4% | Opus 5.5 testado com o harness Claude Code |
| Kimi Code Bench 3.0 Long-horizon | 61,2% | K3: 55,95% | Interno; tarefas de programação com várias etapas |
| BenchCAD | 92,7% (com ferramentas) | Opus 5.5: 96,2%; GPT-6 Astra: 95,9% | Conversão de desenhos técnicos com múltiplas vistas em código CAD |
| OfficeQA Pro v2 | 64,4 | Acima do K3 | Análise de documentos financeiros reais; a Moonshot afirma ser SOTA |
| Financial Modeling / Research | 7,2 / 11,6 pontos acima do K3 | K3 | Interno |
| Business Operation | Cerca de 4,2 vezes o resultado do K3 | K3 | Simulação interna de operações comerciais |
| Kimi Hallu Bench Hard | Taxa de alucinação no nível de afirmações: 8,3% | K3: 23,4% | Teste interno de estresse de factualidade |
| xdev-bench-hard (pass@3) | 81,0% | Versão de comparação sem filtros de segurança: 90,5% | Busca por vulnerabilidades |
Alguns termos: harness é a estrutura de controle que envolve o modelo durante o teste e se encarrega de chamar ferramentas e executar comandos. Como a pontuação pode mudar de acordo com a estrutura usada, o resultado do Opus 5.5 deve ser analisado separadamente. pass@3 significa que o modelo tem três tentativas para responder à mesma questão; basta acertar uma vez para passar. A última linha indica que, por segurança, a Moonshot reduziu deliberadamente a capacidade do modelo de encontrar vulnerabilidades. A versão pública ficou cerca de 9,5 pontos percentuais abaixo da versão interna sem essas restrições.
2.2 Avaliação de terceiros do Kimi K3.1 Pro (Artificial Analysis)
Fonte: Artificial Analysis. Dados de 23/10/2026. Os testes foram executados de forma padronizada pela instituição, e o K3 e o K3.1 Pro foram avaliados com a mesma metodologia.
| Indicador | K3.1 Pro | K3 | Variação |
|---|---|---|---|
| Intelligence Index | 55 (4º lugar) | 44 | +11 |
| GDPval-AA (Elo em tarefas de trabalho reais) | 1846 (3º lugar) | 1534 | +312 |
| Terminal-Bench 4.0 | 67% | 13% | +54 pontos percentuais |
| AutomationBench-AA (fluxos de trabalho SaaS) | 73% | 58% | +15 |
| Humanity’s Last Exam | 52% | 47% | +5 |
| CritPt / SciCode | 25% / 61% | 23% / 59% | +2 / +2 |
| AA-Omniscience Index | 30 | 20 | +10 |
| Taxa de alucinação / precisão | 44% / 51% | 53% / 48% | alucinações: -9 |
| Tokens gerados em média por tarefa | 55K | 48K | +14% |
No ranking da Artificial Analysis, o K3.1 Pro está em 4º lugar, atrás do Claude Opus 5.5 (58), do Claude Sonnet 5.5 (56) e do Muse Wonder Full (56). Os 67% no Terminal-Bench 4.0 são a maior pontuação entre todos os modelos testados pela instituição; o Sonnet 5.5 ficou com 64%.
As duas metodologias apontam na mesma direção em relação às alucinações, mas os valores específicos são bem diferentes: o teste de estresse interno da empresa indica uma queda de 23,4% para 8,3%, enquanto o resultado da AA cai de 53% para 44%. Os testes usam conjuntos de questões diferentes, e tanto o nível de dificuldade quanto os métodos de cálculo também variam. Ao citar esses dados, indique a fonte e não junte os resultados em uma frase como “a taxa de alucinação caiu para 8%”.
3. 5 áreas em que o Kimi K3.1 Pro ficou claramente melhor
Esta seção destaca apenas as áreas em que os dois conjuntos de dados apontam para uma melhora ou em que o avanço foi grande o suficiente.
- Agentes de programação e tarefas de terminal. Um agente é um assistente de IA capaz de dividir tarefas por conta própria, usar ferramentas e executar várias etapas. Nos testes da AA, o Terminal-Bench 4.0 subiu de 13% para 67%, e o teste interno oficial de programação com fluxos longos passou de 55,95% para 61,2%. Se, ao usar o K3 como agente de programação, você costuma enfrentar problemas na execução de comandos, nas operações com arquivos ou na depuração em várias etapas, este é o avanço mais evidente.
- Tarefas de trabalho do mundo real. O GDPval-AA usa a pontuação Elo para medir o desempenho do modelo em tarefas profissionais reais. Elo é um sistema de classificação usado em competições — como no xadrez — em que uma diferença maior de pontuação indica uma diferença maior nas chances de vitória. O K3.1 Pro ficou 312 pontos acima do K3 e alcançou a 3ª posição, indicando uma melhora expressiva em tarefas cotidianas, como elaborar propostas, criar planilhas e organizar materiais.
- Automação de fluxos de trabalho em SaaS. O AutomationBench-AA avalia a capacidade do modelo de automatizar processos em diferentes softwares online, como ler e-mails, atualizar chamados e sincronizar planilhas. A pontuação subiu de 58% para 73%. No teste interno oficial de simulação de operações empresariais (Business Operation), o resultado foi cerca de 4,2 vezes maior que o do K3. Isso também aponta para uma melhora na execução de processos longos, mas esses dados são internos e devem ser considerados apenas como referência.
- Factualidade e alucinações. Alucinação é quando o modelo inventa fatos inexistentes com toda a confiança. Nos testes internos oficiais, a taxa de alucinações por afirmação factual individual caiu de 23,4% para 8,3%, e o número de respostas com pelo menos um erro factual passou a ser apenas 42,4% do registrado para o K3. Nos testes da AA, a taxa de alucinação caiu de 53% para 44%, enquanto a precisão subiu de 48% para 51%.
- Modelagem financeira e relatórios de pesquisa. Segundo a empresa, a pontuação de 64,4 no OfficeQA Pro v2 é SOTA (o melhor resultado atual). Nos testes internos, o Financial Modeling e o Financial Research superaram o K3 em 7,2 e 11,6 pontos, respectivamente. Esses resultados ainda não foram verificados de forma independente por terceiros e, por isso, entram na categoria de «dados divulgados oficialmente».
Os indicadores de raciocínio científico — Humanity’s Last Exam, CritPt e SciCode — também melhoraram, mas apenas de 2 a 5 pontos percentuais. Se o seu trabalho se concentra em perguntas acadêmicas ou código de pesquisa científica, o avanço do K3.1 Pro não é tão grande quanto nas tarefas com agentes. Nesse caso, não é preciso correr para migrar por causa desses resultados.
4. O que mudou pouco no Kimi K3.1 Pro e o custo real
4.1 Três coisas que não mudaram no Kimi K3.1 Pro
- O contexto continua com 1M: 1.048.576 tokens, o mesmo valor do K3. Contexto é o volume total de conteúdo que o modelo consegue “ver” de uma só vez.
- As modalidades continuam sendo texto + imagem: não foram adicionadas novas formas de entrada, como áudio ou vídeo.
- A velocidade não tem benchmark oficial divulgado: a AA mediu uma velocidade de saída de 80,7 tokens por segundo, o que coloca o modelo na faixa 2 de 4 na classificação de velocidade da instituição. Segundo a empresa, a versão highspeed é 2 a 3 vezes mais rápida, mas não foram informadas condições de teste que permitam reproduzir esse resultado. Por isso, a afirmação ainda está “não verificada”.
4.2 Comparação de preços do Kimi K3.1 Pro em cinco categorias
A seguir, os preços oficiais, coletados em 2026-10-24, em dólares por milhão de tokens, sem impostos.
| Modelo | Entrada | Saída | Acerto de cache | Gravação por 5 minutos | Gravação por 1 hora |
|---|---|---|---|---|---|
kimi-k3.1-pro |
$2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
kimi-k3 |
$3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
O acerto de cache se aplica a conteúdos de prefixo idênticos enviados novamente — por exemplo, um comando de sistema fixo ou o mesmo documento longo. A partir da segunda vez, eles são cobrados por um preço menor. A gravação por 5 minutos e por 1 hora corresponde à cobrança para armazenar o conteúdo no cache; quanto mais tempo ele fica armazenado, maior o custo. O cache faz bastante diferença em tarefas com agentes ou perguntas e respostas sobre documentos longos. Se a estrutura do comando for estável, é possível reduzir bastante o custo da parte de entrada.
4.3 O custo do Kimi K3.1 Pro: preço menor não significa economia
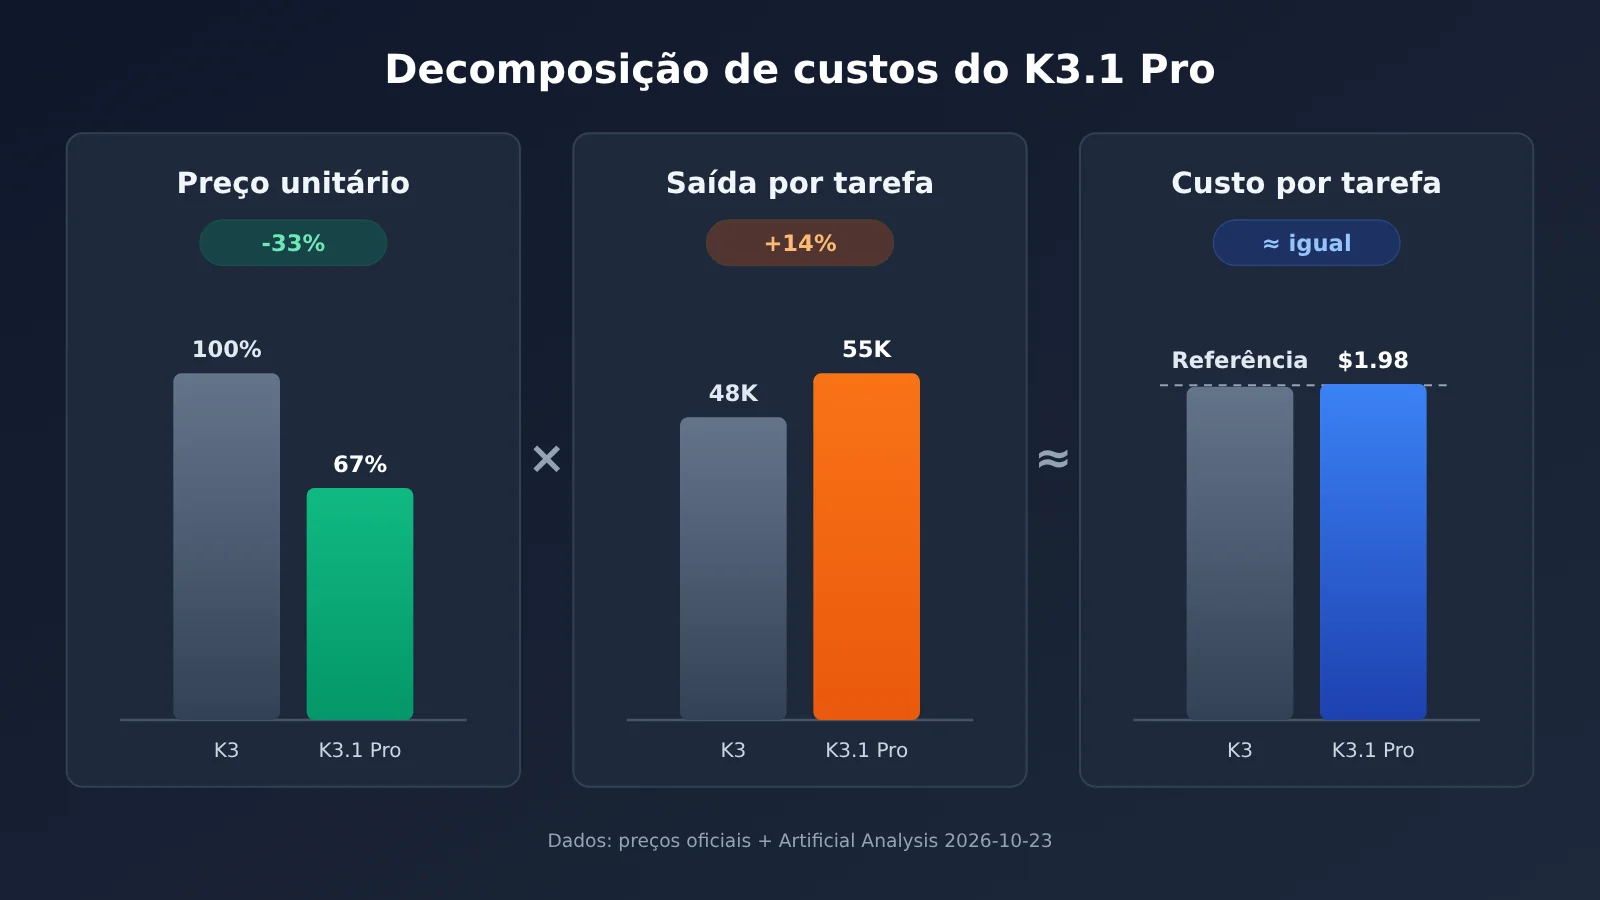
O K3.1 Pro sempre pensa — ou seja, antes de cada resposta, faz uma etapa de raciocínio interno, cobrada como tokens de saída. A AA mediu uma média de 55 mil tokens de saída por tarefa, 14% a mais que os 48 mil do K3.
Pelo preço unitário, a redução de 33% deveria gerar uma boa economia, mas a AA mediu um custo médio de cerca de $1.98 por tarefa (a página de detalhes do modelo informa $2.11), praticamente o mesmo valor do K3. A instituição não divulgou uma análise detalhada dos custos, então ainda não há uma explicação oficial para o fato de a economia não aparecer. Uma possibilidade é que, em tarefas com agentes e várias chamadas, o volume de tokens de entrada também aumente. Isso é apenas uma hipótese e continua “não verificada”.
Além disso, a versão highspeed custa o dobro da versão padrão. Para equipes sensíveis a custos, vale testar uma amostra de tarefas reais antes de migrar e comparar o gasto total, em vez de olhar apenas o preço unitário.
Se quiser comparar o gasto real do K3 e do K3.1 Pro usando a mesma base de código, você pode começar conectando a interface compatível com OpenAI da APIYI apiyi.com e usar kimi-k3 como referência. O modelo e os preços do K3.1 Pro na plataforma devem ser consultados na lista de modelos. Vamos disponibilizar esse modelo o quanto antes.
5. Recomendações de uso do Kimi K3.1 Pro: quando trocar e quando não há pressa
Veja as conclusões por tipo de tarefa, pensadas para quem já usa o K3.
| Tipo de tarefa | Conclusão | Motivo |
|---|---|---|
| Agentes de programação e automação de terminal | Recomendamos trocar o quanto antes | No Terminal-Bench 4.0, o resultado de terceiros subiu de 13% para 67%; em programação com cadeias longas de etapas, a avaliação oficial melhorou mais de 5 pontos |
| Análise de documentos, relatórios de pesquisa e modelagem financeira | Recomendamos trocar | O Elo no GDPval aumentou 312 pontos. Nos testes oficiais com demonstrações financeiras e relatórios de pesquisa, o modelo superou o K3 em todos os aspectos, com uma queda significativa nas alucinações |
| Fluxos de trabalho SaaS e processos de negócios com várias etapas | Recomendamos trocar | No AutomationBench-AA, o resultado subiu de 58% para 73% |
| Tarefas simples em lote (classificação, extração e reformulação) | Não há pressa | O custo por tarefa é semelhante ao do K3. O modo de raciocínio contínuo aumenta a quantidade de tokens gerados, e os ganhos de capacidade fazem pouca diferença em tarefas simples |
| Cenários sensíveis à latência (conversas em tempo real e atendimento online) | Teste antes de decidir | A documentação oficial não traz dados de velocidade. O modo de raciocínio contínuo pode aumentar o tempo até o primeiro token, e o preço do modo highspeed é o dobro |
“Não há pressa” não significa que o K3 seja ruim. Ele já dá conta de tarefas simples, e sua latência e seus custos são mais previsíveis. Não é necessário reescrever todo o pipeline de processamento em lote só para obter uma pontuação geral mais alta. Você pode esperar a liberação dos pesos do K3.1 Pro e dados de velocidade mais completos de terceiros antes de reavaliar. Ainda haverá tempo.
5.1 Cenários típicos para escolher o Kimi K3.1 Pro
- Corrigir bugs, refatorar e escrever testes em repositórios de código, quando o modelo precisa executar comandos, analisar erros e fazer ajustes por conta própria.
- Responder a perguntas e resumir relatórios financeiros, contratos e relatórios de pesquisa extensos, quando a precisão dos fatos é essencial.
- Automatizar fluxos que envolvem várias ferramentas online e exigem mais de dez etapas por tarefa.
5.2 Cenários típicos para continuar usando o Kimi K3 por enquanto
- Classificar dezenas de milhares de tags ou extrair campos todos os dias, com custos calculados por item.
- Manter interações em tempo real com baixa latência estável, usando parâmetros de timeout e novas tentativas já ajustados para o K3.
Recomendação: a forma mais confiável de decidir é pegar de 50 a 100 amostras reais do seu negócio e executá-las nos dois modelos, comparando a taxa de conclusão e o custo total. Com um único chave API, a APIYI apiyi.com permite alternar entre diferentes modelos, o que facilita esse tipo de teste comparativo. Antes do lançamento do K3.1 Pro, você pode usar
kimi-k3para estabelecer uma linha de base. Consulte a lista de modelos da plataforma para confirmar o identificador e o preço do K3.1 Pro. Vamos disponibilizar esse modelo o quanto antes.
6. Recomendações e cuidados para migrar para o Kimi K3.1 Pro
6.1 Cronograma de descontinuação da série Kimi K2
Se você ainda usa algum modelo da série K2, priorize essa migração. A documentação oficial informa que, a partir de 31/10/2026, a série K2 não estará mais disponível para novos usuários. Todos os modelos serão descontinuados até o fim de 2026. Embora os usuários antigos ainda possam usá-los por enquanto, recomendamos concluir a migração nos próximos dois meses, passando diretamente para o K3 ou o K3.1 Pro. Não espere até perto da descontinuação para fazer isso.
6.2 Três recomendações para mudar para o Kimi K3.1 Pro
- Comece uma nova conversa; não troque de modelo no meio dela. A recomendação oficial é usar o K3.1 Pro em uma nova conversa. Continuar uma conversa do K3 com o K3.1 Pro pode causar problemas de compatibilidade com o formato do contexto ou com o conteúdo de raciocínio.
- Priorize as interfaces nativas. Segundo a recomendação oficial, as interfaces nativas Responses, Chat Completions e Messages são as mais estáveis.
- Confira se o nome do modelo está correto. Se você digitar
kimi-k3.1-proincorretamente em uma ferramenta de terceiros, a solicitação será direcionada para o K2.8 Preview, que não realiza raciocínio. O problema não gera um erro: apenas piora os resultados, o que dificulta bastante a investigação. Antes de colocar em produção, confira o campo do modelo na resposta.
6.3 Diferenças entre os planos do Kimi Code
Para usar os novos modelos no Kimi Code, é preciso ter um plano que atenda aos requisitos:
k3.1-proexige o plano Plus ou superior.- O contexto de 1M exige o plano Pro ou superior.
- A versão highspeed exige o plano Pro ou superior e consome cerca de 2 vezes mais cota.
Com o plano Plus, você pode usar o K3.1 Pro, mas não tem acesso ao contexto completo de 1M. Se você depende principalmente de um contexto muito longo para ler um repositório inteiro, confira seu plano antes de decidir se vale a pena fazer upgrade.
6.4 Lista de verificação para integração via API
- Defina
base_urlcomohttps://api.apiyi.com/v1, o endereço compatível com OpenAI da APIYI (apiyi.com). No código que já usa o SDK da OpenAI, basta alterar esse valor e a chave API. - Para começar, use
kimi-k3e valide o fluxo. Depois, preencha o nome exato do K3.1 Pro conforme a lista de modelos da plataforma. O nome e o preço do K3.1 Pro devem ser conferidos nessa lista. Vamos disponibilizar esse modelo o mais rápido possível. - Aumente um pouco o tempo limite: o raciocínio contínuo pode deixar cada resposta mais lenta.
- Não defina um limite muito baixo para
max_tokens; caso contrário, o conteúdo de raciocínio pode ocupar espaço e impedir a saída do texto principal.
Perguntas frequentes (FAQ)
Q1: O que é o Kimi K3.1 Pro e qual é a relação dele com o K3?
O K3.1 Pro é uma nova versão da Moonshot, desenvolvida com mais poder computacional no pós-treinamento do K3. Segundo a empresa, é o primeiro modelo da série K3.1. A janela de contexto e as modalidades de entrada são as mesmas do K3. Os principais avanços estão nos agentes de programação, em tarefas reais de trabalho e na precisão factual.
Q2: A pontuação do Kimi K3.1 Pro no Terminal-Bench é 65,7% ou 67%?
As duas estão corretas, mas vêm de fontes diferentes. Os 65,7% foram informados pela própria empresa, enquanto os 67% foram medidos de forma independente pela Artificial Analysis. Os ambientes de teste e os harnesses são diferentes, então não dá para considerar as pontuações equivalentes. Ao citá-las, indique a fonte.
Q3: Se o preço do Kimi K3.1 Pro caiu 33%, por que ele não é mais barato?
O modelo está sempre pensando, e a saída média por tarefa é 14% maior que a do K3. Nos testes da AA, o custo por tarefa ficou em torno de US$ 1,98 (a página do modelo informa US$ 2,11), praticamente o mesmo do K3. A instituição não detalhou o motivo; por isso, recomendamos testar com as suas próprias tarefas.
Q4: Quando os pesos do Kimi K3.1 Pro serão disponibilizados?
A empresa prometeu liberar os pesos completos até 04/11/2026. Em 24/10/2026, isso ainda era apenas uma promessa e não havia sido cumprida. Se você planeja fazer a implantação por conta própria, consulte o anúncio oficial quando a liberação acontecer.
Q5: Como comparar rapidamente o Kimi K3.1 Pro e o K3 pela API?
Você pode se cadastrar na APIYI, em apiyi.com, para obter uma chave API e créditos gratuitos de teste. Use primeiro a interface compatível com OpenAI para testar o `kimi-k3` como referência. O nome e o preço do K3.1 Pro na plataforma serão os indicados na lista de modelos. Vamos disponibilizar esse modelo em breve; quando ele estiver disponível, basta alterar o parâmetro `model` para fazer a comparação.
Q6: Quais são as limitações conhecidas do Kimi K3.1 Pro?
– A empresa não publicou benchmarks de velocidade, e a versão highspeed custa o dobro.
– O modelo está sempre pensando, então não é indicado para cenários que exigem latência muito baixa.
– Alguns resultados expressivos vêm de conjuntos de teste internos e não podem ser reproduzidos externamente.
– A capacidade de encontrar vulnerabilidades está sujeita a restrições de segurança e é inferior à da versão sem esse tipo de filtragem.
Q7: Ainda uso o K2. Devo migrar direto para o K3.1 Pro?
A partir de 31/10/2026, a série K2 deixará de aceitar novos usuários e será desativada até o fim do ano, então a migração é necessária. Para agentes de programação e tarefas com documentos, você pode migrar direto para o K3.1 Pro. Para tarefas pequenas em lote, o K3 é uma opção mais simples. Na APIYI, em apiyi.com, você pode começar a migração usando o `kimi-k3`. O nome e o preço do K3.1 Pro serão os indicados na lista de modelos da plataforma. Vamos disponibilizar esse modelo em breve.
Principais pontos sobre o Kimi K3.1 Pro
- Capacidade significativamente maior: a pontuação geral AA subiu de 44 para 55, levando o modelo ao 4º lugar, atrás apenas de três modelos fechados.
- Maior avanço em agentes de programação: em testes independentes do Terminal-Bench 4.0, o resultado subiu de 13% para 67%.
- Compare os dois conjuntos de dados separadamente: os dados divulgados pela empresa e os critérios da AA são diferentes. Ao citar os resultados, indique a fonte.
- Preço menor não significa custo menor: o preço unitário caiu 33%, mas o custo por tarefa ficou praticamente igual ao do K3.
- Especificações básicas inalteradas: janela de contexto de 1M, suporte a texto e imagens; a empresa não divulgou dados de velocidade.
- Informe o nome correto do modelo na migração: se estiver incorreto, o sistema voltará para o K2.8 Preview, sem modo de pensamento.
- Como começar: você pode usar primeiro a APIYI, em apiyi.com, para estabelecer uma linha de base com o K3. O modelo e o preço do K3.1 Pro na plataforma devem ser conferidos na lista de modelos. Vamos disponibilizar esse modelo em breve.
Conclusão: vale a pena migrar do K3 para o Kimi K3.1 Pro?
As mudanças do Kimi K3.1 Pro em relação à geração anterior podem ser resumidas em três pontos:
- Capacidade: houve avanços significativos em agentes de programação, tarefas de terminal, tarefas reais de trabalho, automação de SaaS e factualidade. Os dados de terceiros e os dados oficiais apontam na mesma direção.
- Preço: o preço unitário das cinco faixas caiu 33% em relação ao K3. No entanto, o modo de pensamento sempre ativado gera respostas mais longas, então o custo por tarefa praticamente não diminuiu.
- Migração: recomendamos migrar logo para o K3.1 Pro em aplicações com agentes de programação e documentos ou relatórios de pesquisa. Para tarefas pequenas em lote e cenários sensíveis à latência, vale testar antes de decidir. Quem usa o K2 deve concluir a migração até o fim do ano.
A APIYI, em apiyi.com, já oferece modelos Kimi como o kimi-k3 (US$ 3 por entrada e US$ 15 por saída). Você pode usar a mesma chave API e uma interface compatível com OpenAI para estabelecer uma linha de base de custo e desempenho. O modelo e o preço do Kimi K3.1 Pro na plataforma devem ser conferidos na lista de modelos. Vamos disponibilizar esse modelo em breve; quando estiver no ar, basta substituir o nome do modelo para fazer a comparação.
Referências
- Blog oficial da Moonshot: anúncio de lançamento do Kimi K3.1 Pro e resultados de benchmark divulgados pela própria empresa
- Observação: fonte dos dados da categoria “divulgados oficialmente” neste artigo. As condições de teste foram
reasoning_effort=max,temperature=1.0etop_p=0.95. - Documentação oficial da Moonshot: preços, cronograma de descontinuação do K2, recomendações para trocar de modelo e informações sobre a assinatura do Kimi Code
- Observação: preços consultados em 24/10/2026, em dólares por milhão de tokens e sem impostos.
- Artificial Analysis: avaliação independente de modelos por terceiros
- Link:
artificialanalysis.ai - Observação: fonte dos dados da categoria “terceiros” neste artigo, com data de 23/10/2026.
Autor: equipe técnica da APIYI
Contato técnico: entre em contato conosco pela página inicial do site da APIYI. Para consultar mais materiais de integração, acesse a central de documentação em docs.apiyi.com. O modelo e o preço do Kimi K3.1 Pro dependem da lista de modelos da plataforma. Vamos disponibilizá-lo o quanto antes.