Nota do autor: usando resultados oficiais e limitações oficiais, vamos explicar em que o Claude Fable 5.2 se destaca, até onde ele vai e quando não vale a pena trocar o Opus 5.5 por ele.
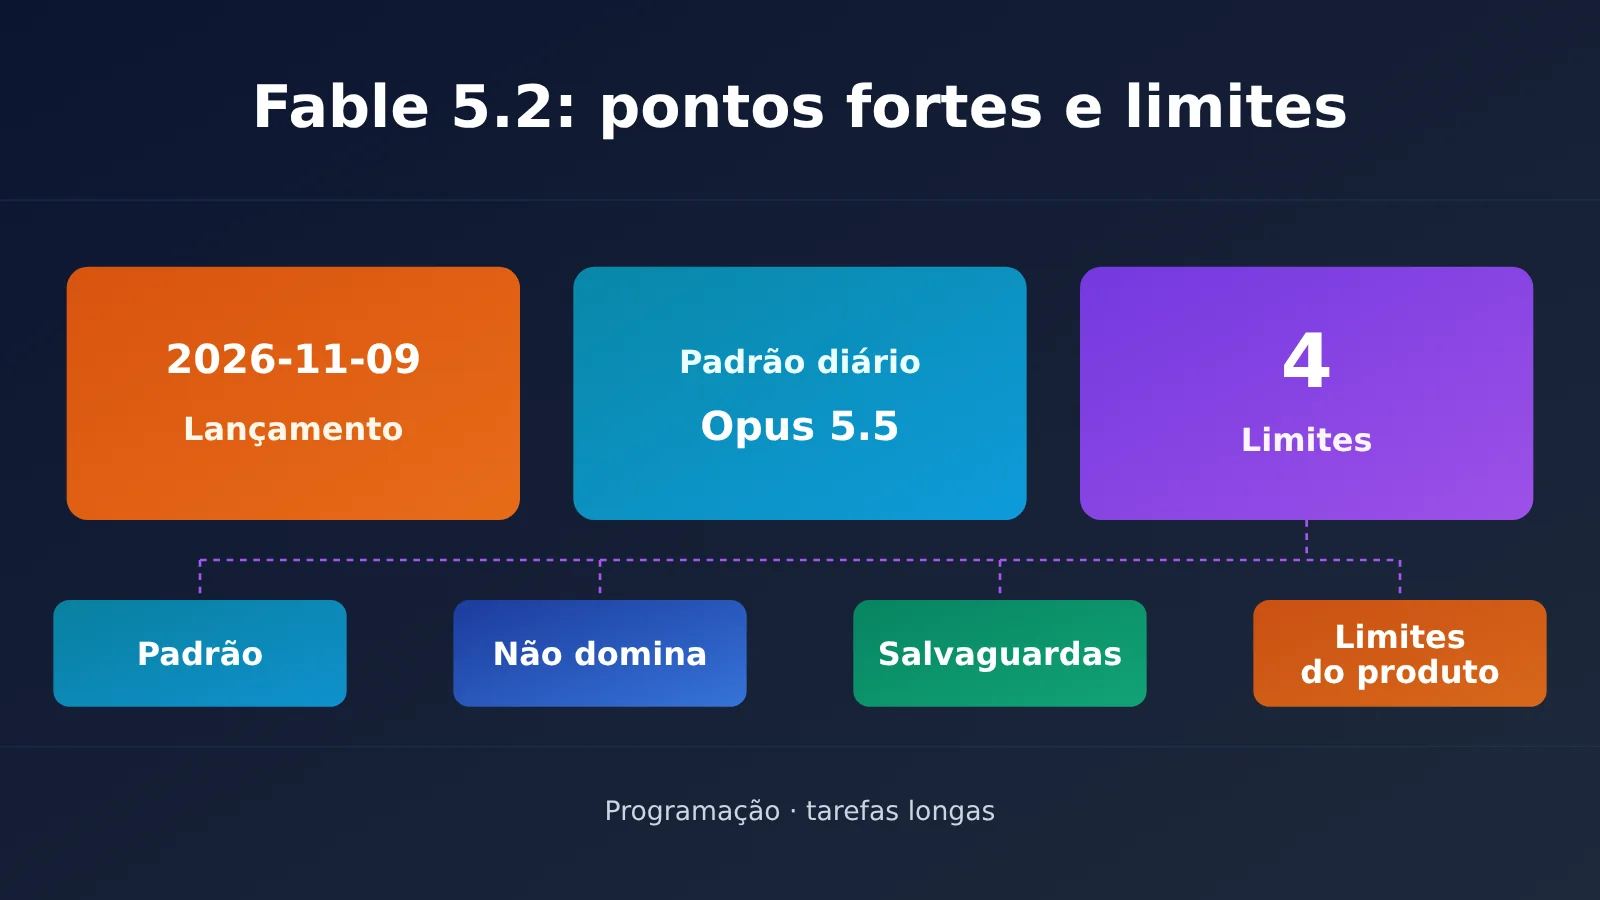
O Claude Fable 5.2 é o modelo técnico de ponta lançado pela Anthropic em 2026-11-09. A recomendação da própria Anthropic é começar pelo Opus 5.5 para a maioria das tarefas de programação e trabalho com conhecimento. O Fable 5.2 é indicado para tarefas técnicas mais complexas, abertas e de longa duração.
Este artigo não é apenas uma recapitulação de um ranking. Todos os resultados apresentados vêm do anúncio da Anthropic de 2026-11-09, e as limitações são baseadas na página oficial do modelo e nas notas de atualização. Ao terminar a leitura, você terá clareza sobre quatro limites: em que ele é claramente superior, em que não vence em tudo, em que as salvaguardas podem impedi-lo e em que os mecanismos do produto podem restringi-lo.
Principal benefício: se você já usa a API do Claude, este artigo ajuda a decidir se vale a pena trocar o Opus 5.5 pelo Fable 5.2 e quais ajustes fazer na cobrança e nos parâmetros de invocação depois da troca.
Principais pontos sobre o Claude Fable 5.2
Reunimos em uma tabela as dúvidas mais comuns. Todos os números vêm da página oficial do modelo e do anúncio de lançamento; as informações foram verificadas em 10/11/2026.
| Ponto | Informação oficial | O que isso significa para você |
|---|---|---|
| Posicionamento | Modelo topo de linha voltado para tarefas técnicas, ideal para os trabalhos mais complexos e abertos | Não é a opção padrão para o dia a dia; para isso, continua sendo o Opus 5.5 |
| Relação com o Mythos | É o mesmo modelo base, mas o Fable tem proteções mais fortes e está disponível para todos os usuários | O Mythos não é outro modelo mais poderoso |
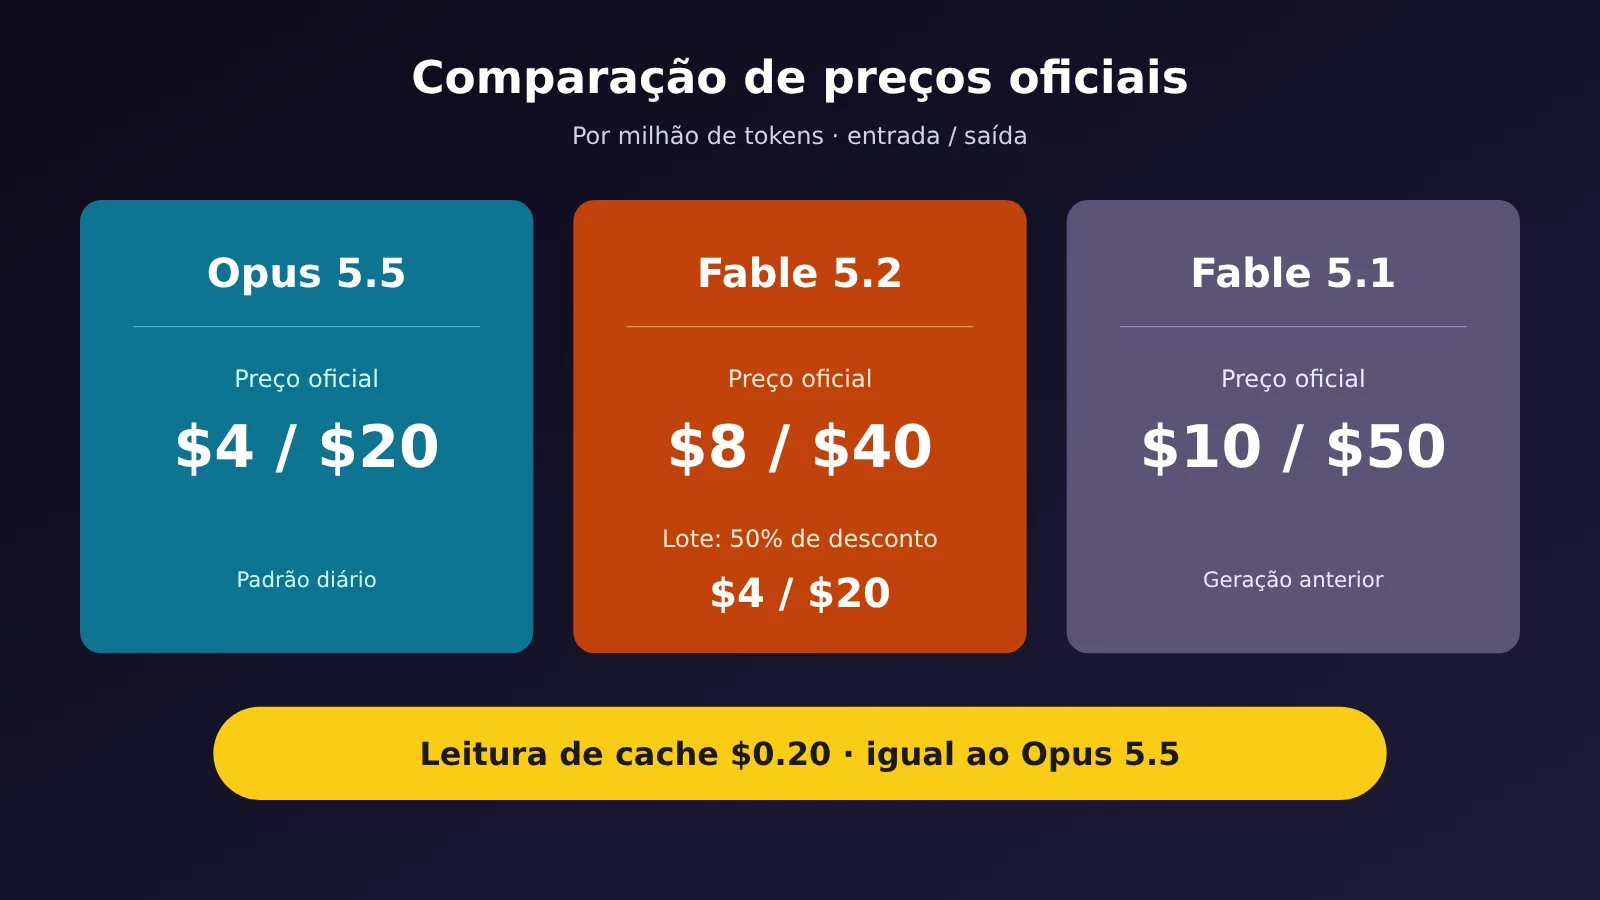
| Preço padrão | US$ 8 para entrada e US$ 40 para saída (por milhão de tokens) | Custa o dobro do Opus 5.5 e 20% menos que o Fable 5.1 |
| Pensamento | O pensamento adaptativo fica sempre ativado e não pode ser desativado | Para que o modelo pense menos, só dá para ajustar o effort |
| Retenção de dados | Por padrão, é necessário manter os dados por 30 dias | Se você precisa de retenção zero, confirme primeiro se tem autorização |
Qual é a relação entre Claude Fable 5.2 e Mythos 5.2?
O anúncio de lançamento é bem direto: Claude Fable e Claude Mythos são o mesmo modelo base. A diferença é que o Fable tem proteções mais fortes para cibersegurança e biossegurança e, por isso, está disponível para todos os usuários. O Mythos é oferecido apenas a organizações aprovadas em programas de verificação nas áreas de ciências da vida ou cibersegurança. Os dois têm o mesmo preço.
Por isso, dizer que “o Mythos é mais poderoso” é uma interpretação equivocada. No anúncio, alguns resultados de cibersegurança e biossegurança são atribuídos ao Mythos 5.2, como os 76,3% no CyScenarioBench. Esses resultados são do Mythos, que não conta com proteções equivalentes, e não devem ser atribuídos ao Fable. Para usuários comuns da API, a opção disponível é o Fable 5.2.
Especificações e preços oficiais do Claude Fable 5.2
A tabela abaixo compara os três modelos na página oficial. Não foi possível obter as especificações completas do Fable 5.1 desta vez; por isso, as informações de preço desse modelo aparecem mais adiante.
| Especificação | Claude Fable 5.2 | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Contexto | 1M token | 1M token | 1M token |
| Saída máxima (Messages API síncrona) | 128K | 128K | 128K |
| Preço padrão (entrada / saída) | $8 / $40 | $4 / $20 | $2 / $10 |
| Nível de latência | Moderate | Moderate | Fast |
| Esforço padrão na Claude API | high | medium | high |
| Limite de conhecimento | junho de 2026 | junho de 2026 | junho de 2026 |
O Fable 5.2 recebe texto e imagens e gera texto. A página do modelo converte 1M de tokens em aproximadamente 555 mil palavras ou 2,5 milhões de caracteres Unicode. Essa conversão se baseia no tokenizador atual e não significa que seja possível incluir essa quantidade de conteúdo em chinês.
Vale observar que, na Message Batches API, alguns modelos podem chegar a 300K de saída usando um cabeçalho beta. O Opus 5.5 está na lista, mas o Fable 5.2 não. Até que haja uma confirmação oficial, considere o limite de 128K ao planejar saídas longas.
Os demais preços oficiais são cobrados por milhão de tokens:
- Cache: a gravação em cache custa $10 para 5 minutos e $16 para 1 hora; a leitura do cache custa $0.20. O preço de leitura equivale a 0,025 vez o preço padrão de entrada.
- Lote: tanto a entrada quanto a saída custam metade do preço padrão. Para o Fable 5.2, o preço em lote é de $4 para entrada e $20 para saída.
- Modo rápido: usa o mesmo modelo, sem alterar a inteligência, e pode atingir até 2,5 vezes a velocidade de saída padrão. O preço é de $16 para entrada e $80 para saída. No modo rápido, o Opus 5.5 custa $8 / $40.
- Cache no modo rápido: a documentação não apresenta uma tabela de preços separada; informa apenas que os multiplicadores de cache são aplicados sobre os preços do modo rápido. Com base nesses multiplicadores, a leitura do cache fica em cerca de $0.40, a gravação por 5 minutos em $20 e a gravação por 1 hora em $32.
- Campo do modo rápido: na Claude API, o campo é
speed, com o valorfast. No Microsoft Foundry, é usado outro ID de modelo, terminado em-fast; não incluaspeedna solicitação.
Outro detalhe que pode causar problemas: as velocidades diferentes não compartilham o cache de comandos. Ao voltar do modo rápido para o padrão, o cache não será encontrado. A publicação que anunciou o modo rápido não inclui o Amazon Bedrock entre os canais disponíveis, mas o modelo padrão está disponível no Bedrock com o ID anthropic.claude-fable-5-2.
Dados oficiais de desempenho do Claude Fable 5.2
Os quatro números abaixo mostram melhor em que o Fable 5.2 se destaca. Todos foram divulgados pela Anthropic em 2026-11-09. Salvo indicação em contrário, as pontuações do Fable 5.2, do Fable 5.1 e do Opus 5.5 foram obtidas com as salvaguardas ativadas. Quanto ao critério da tabela: exceto nos casos em que outro nível é indicado, cada modelo foi avaliado no nível de esforço mais alto disponível na época, e não no nível padrão.
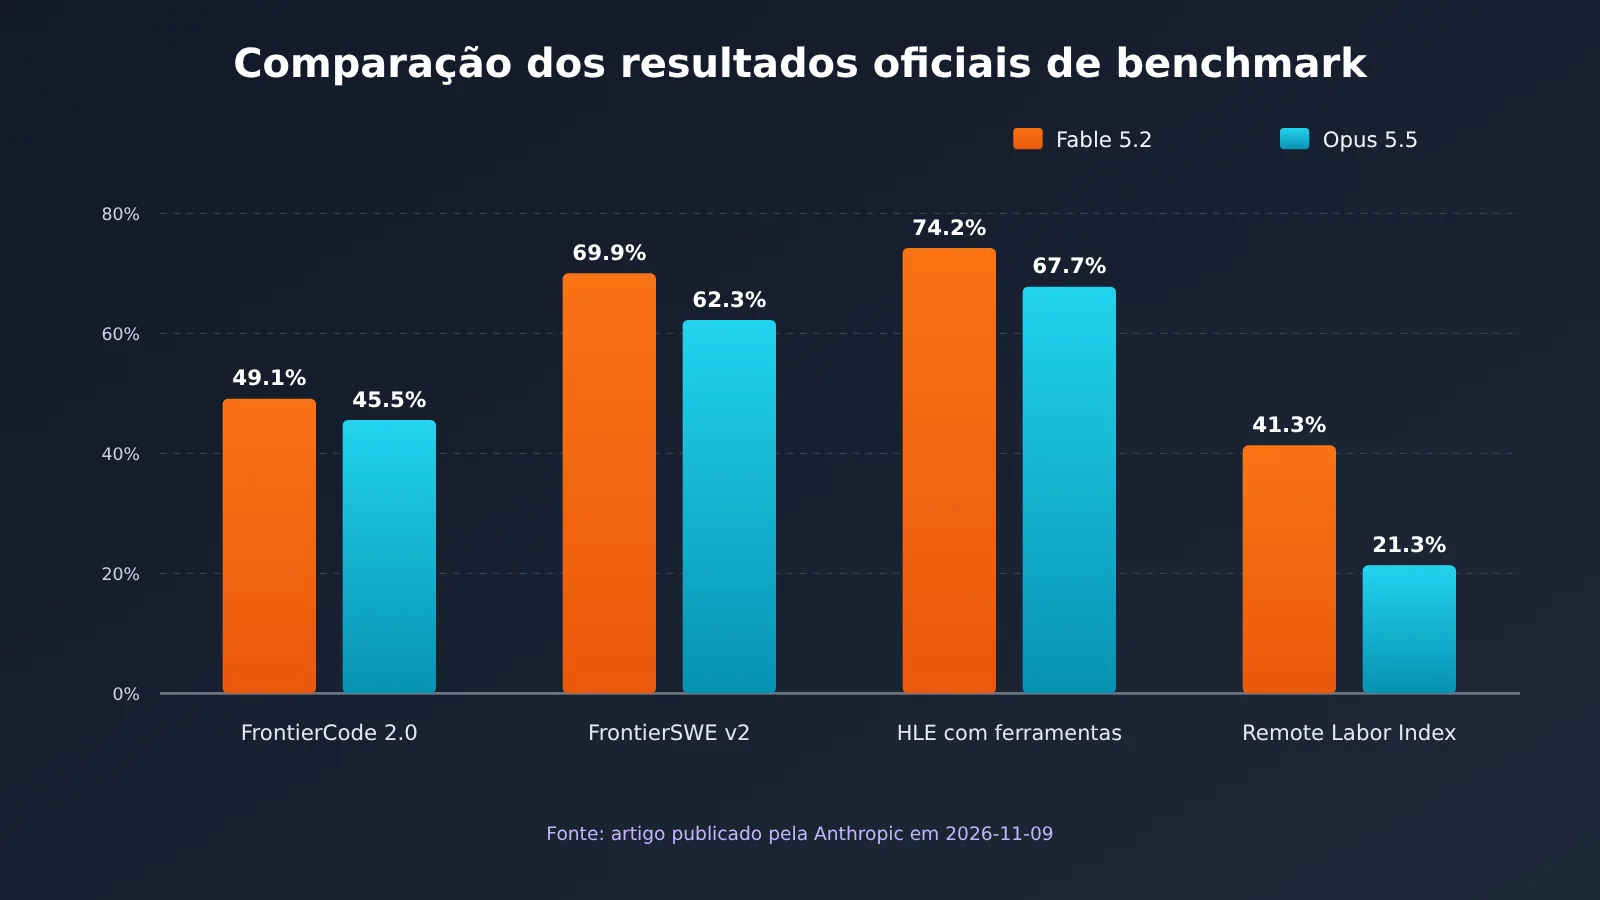
| Benchmark | Fable 5.2 | Observações sobre o nível | Comparação com Opus 5.5 |
|---|---|---|---|
| FrontierCode 2.0 | 49.1% | O nível Xhigh é indicado separadamente na tabela | 45.5% (critério padrão da tabela; corresponde ao nível de esforço mais alto do modelo) |
| FrontierSWE v2 | 69.9% | Sem indicação separada; corresponde ao nível de esforço mais alto | 62.3% (nível de esforço mais alto) |
| Humanity’s Last Exam (com ferramentas) | 74.2% | Sem indicação separada; corresponde ao nível de esforço mais alto | 67.7% (nível de esforço mais alto) |
| Remote Labor Index | 41.3% | O nível High é indicado separadamente na tabela; não é o nível mais alto | 21.3% (nível de esforço mais alto) |
Como interpretar os resultados de codificação do Claude Fable 5.2
O FrontierCode mede se as alterações seriam aceitas pelos mantenedores de repositórios de código aberto, o que se aproxima mais da engenharia do mundo real do que simplesmente passar nos testes. Com 49,1%, a configuração Xhigh teve o melhor resultado entre os modelos lançados que a Anthropic avaliou. O anúncio também apresentou um número mais prático: na configuração High, o Fable 5.2 fica em torno de 45,3%, quase igual aos 45,5% do melhor resultado do Opus 5.5, mas com cerca de metade do custo por tarefa.
Esse dado é importante para quem faz as contas. Ele indica que o valor do Fable 5.2 não está apenas em alcançar um resultado mais alto na configuração máxima: na configuração High, ele também pode concluir o mesmo trabalho usando menos tokens. Ainda assim, essa é uma afirmação oficial baseada nesse benchmark. Para saber como o modelo se sai no seu repositório, você precisa testar por conta própria.
A maior diferença aparece no Remote Labor Index: 41,3% contra 21,3%. Além disso, o resultado do Fable 5.2 foi obtido na configuração High, não na configuração máxima. Esse tipo de tarefa prioriza a entrega completa de trabalho remoto, o que combina com a proposta de realizar trabalhos técnicos abertos e de longa duração.
Os casos de tarefas longas do Claude Fable 5.2 devem ser vistos como experimentos isolados
O anúncio traz algumas histórias impressionantes, mas, ao lê-las, vale prestar atenção em quem realizou cada tarefa e quantas vezes o experimento foi feito:
- Sistema operacional de protótipo: um engenheiro pediu ao Fable 5.2 que começasse do zero, a partir de uma pasta vazia. O modelo coordenou mais de 1.000 subagentes durante cerca de oito dias e criou um sistema que iniciava em um laptop. Como o anúncio não diz que o experimento foi repetido, ele deve ser considerado um teste oficial isolado.
- Formalização do Último Teorema de Fermat: 1.000 agentes do Fable 5.2 trabalharam por 30 horas, com pouca intervenção humana. Nas mesmas condições, o Opus 5.5 concluiu cerca de 26% do trabalho em 18 horas e quase não avançou depois de 30 horas. A legenda da figura informa que cada modelo foi executado apenas uma vez.
- Migração de Python para Rust: a migração de um serviço de produção essencial para Rust, que resultou em uma inicialização cerca de 26 vezes mais rápida, foi feita por um grupo de agentes que usava uma versão anterior do Fable 5.2, não a versão lançada.
- 90% das alterações aceitas: o anúncio afirma que Claude escreveu mais de 90% das alterações aceitas no código central, com orientação humana. O sujeito é Claude, não especificamente o Fable 5.2.
Esses casos mostram o potencial do modelo, mas não devem ser tratados como resultados consistentes. Se sua operação depende de executar tarefas por vários dias, considere isso uma hipótese que você precisa reproduzir por conta própria.
4 limites do Claude Fable 5.2
Os resultados mostram em que ele se destaca; os quatro pontos a seguir mostram até onde vale a pena usá-lo. A ordem é: seleção → capacidade → segurança → mecanismos do produto.
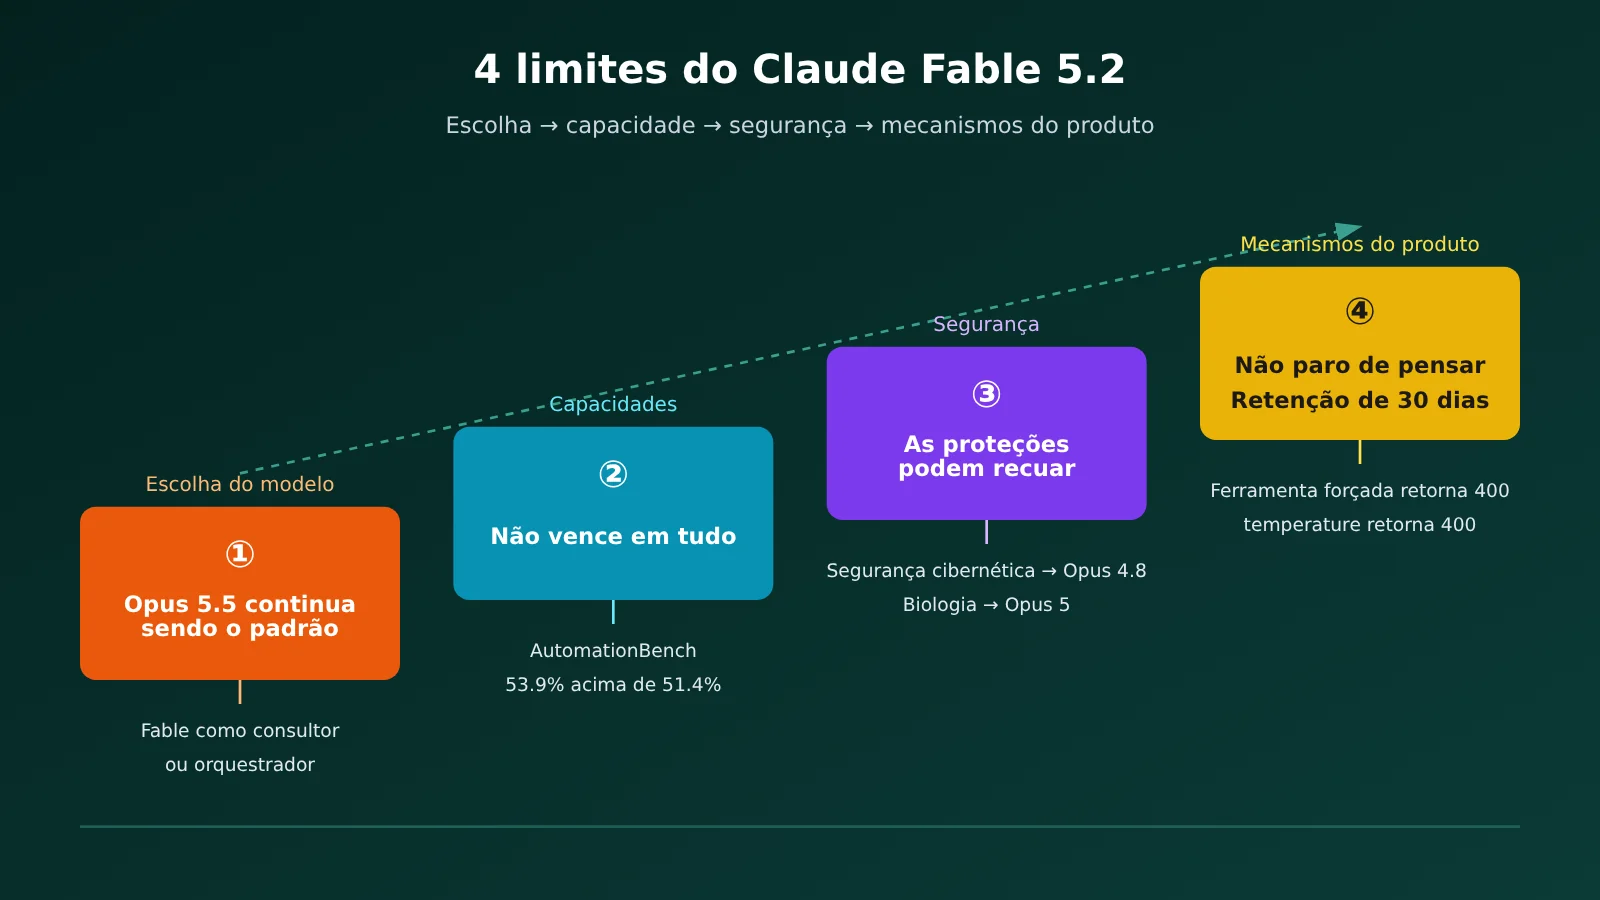
Limite 1: Claude Fable 5.2 não é a opção padrão para o dia a dia
A recomendação no anúncio é começar pelo Opus 5.5 para a maioria das tarefas de programação e trabalho com conhecimento. Depois, conforme a dificuldade, subir para Fable ou Mythos, ou descer para Sonnet 5.5 ou Haiku 5.5. Fable 5.2 é mais indicado para os trabalhos técnicos mais complexos e abertos.
Também há duas formas de economizar. Na primeira, ele atua como consultor: modelos menores recorrem a ele quando encontram dificuldades. Na segunda, ele funciona como orquestrador: divide as tarefas e delega as partes mais simples a modelos menores. Assim, os tokens mais caros ficam reservados para a etapa mais difícil.
Limite 2: o placar do Claude Fable 5.2 não é uma vitória em todas as categorias
Os modelos usados como comparação no anúncio são GPT-6 Astra e Gemini 4 Carbon. O benchmark foi executado pela Anthropic, não é um ranking publicado pela OpenAI ou pelo Google. Mesmo nesse placar, o Fable 5.2 perde em algumas categorias.
| Benchmark | Fable 5.2 | Líder | Observação |
|---|---|---|---|
| AutomationBench | 51.4% | Gemini 4 Carbon 53.9% | O Carbon teve um resultado melhor |
| AA-Briefcase v1.1 Elo | 1785 | Opus 5.5 1800 | O Opus lidera em Elo |
| AA-Briefcase v1.1 — pontuação por regras | 66.1% | Fable 5.2 | O Opus 5.5 ficou com 61.2% |
| Chartography (sem ferramentas) | 73.4% | Fable 5.2 | Carbon: 72.5%; Astra: 71.0%. A diferença é pequena |
Vale olhar com mais atenção para a linha do AA-Briefcase. O Fable lidera na pontuação por regras, mas o Opus fica à frente em Elo. Isso mostra que, em avaliações baseadas em preferências mais subjetivas, o modelo mais caro nem sempre é o mais popular. Se sua tarefa é escrever briefings ou trabalhar com documentos e conhecimento, o Opus 5.5 não é uma opção inferior.
Limite 3: as proteções de segurança do Claude Fable 5.2 mudam quem responde
Quando um classificador de segurança bloqueia uma solicitação, o Fable 5.2 não simplesmente deixa de responder: solicitações de cibersegurança são encaminhadas ao Opus 4.8, e as de biologia, ao Opus 5. As solicitações recusadas retornam HTTP 200, com stop_reason definido como refusal. Seu código deve verificar esse campo, em vez de olhar apenas o código de status. A cobrança por recusas antes da geração da resposta depende da categoria, mas todas consomem o limite de taxa.
Há outra restrição menos evidente: capacidades diretamente relacionadas à pesquisa e ao desenvolvimento de IA são limitadas de propósito. Tarefas de otimização de kernels para aceleradores e de melhoria da arquitetura de Modelos de Linguagem Grandes ficam, em geral, no nível do Opus 5.5. Em alguns temas — incluindo o desenvolvimento de kernels para certos aceleradores não convencionais —, o sistema recorre de forma transparente ao Opus 5 durante a inferência. Isso não significa que a chamada falhou. Codificação com agentes, desenvolvimento de hardware e pesquisa em aprendizado de máquina tradicional não estão sujeitos a essa restrição.
Testes iniciais oficiais indicaram que o Fable 5.2 é bloqueado cerca de 55% menos que o Fable 5.1 no claude.ai, no Claude Code e no Cowork. A redução foi de cerca de 60% em cibersegurança e 40% em biologia. Esses resultados vêm de testes iniciais oficiais, não de uma avaliação independente.
Limite 4: há restrições rígidas no funcionamento do Claude Fable 5.2
Estes pontos afetam diretamente o código de invocação que você já tem. Confira cada um antes de migrar:
- Não dá para desativar o raciocínio: o raciocínio adaptativo fica sempre ativado. Com
mediumou acima, escrever no comando algo como “não pense, responda diretamente” não impede o raciocínio. Para reduzir o raciocínio, só ajustando oeffortpara um nível mais baixo. - Forçar o retorno de uma ferramenta gera erro 400: usar
tool_choicecom o valoranyoutoolcausa erro. - Parâmetros de amostragem geram erro 400: não envie
temperature,top_pnemtop_k. - Retenção de dados por 30 dias: não é possível usar retenção zero de dados, a menos que a Anthropic autorize explicitamente. Empresas qualificadas ainda podem usar retenção zero antes de aderir ao Enterprise Frontier Safeguards; para os demais clientes, os dados são mantidos por 30 dias para monitoramento de segurança.
- Tarefas longas podem ser interrompidas: às vezes, o modelo para depois de uma única rodada, deixa uma lista de pendências, diz espontaneamente que pode continuar ou para diante de um obstáculo comum. Isso é mais frequente no nível
low. Em longas sequências de chamadas de ferramentas, pode haver poucas mensagens voltadas ao usuário. - Os blocos de raciocínio não são compatíveis com todos os modelos: só Fable 5.2 e Mythos 5.2 conseguem ler os blocos de raciocínio do Fable 5.2. Quando o Fable 5.2 atua como executor, o consultor também precisa ser Fable 5.2 ou Mythos 5.2.
O anúncio de lançamento também alerta que especificar no comando “quem é o dono do código” influencia se o modelo vai alterar a estrutura existente ou começar do zero. Ele segue as regras de estilo à risca; se você limitar demais o tamanho das frases, pode acabar fragmentando a resposta.
Quem já pode ser chamado com Claude Fable 5.2 e quais modelos ainda não estão disponíveis
Em 10/11/2026, consultamos a lista completa de modelos e a interface pública de preços da APIYI (apiyi.com). Nenhuma das duas inclui claude-fable-5-2 nem qualquer modelo Mythos. Vamos disponibilizar esse modelo em breve. Consulte a lista de modelos da plataforma para ver os modelos e preços atualizados.
Enquanto ele não estiver disponível, você pode usar o Opus 5.5, que já está na plataforma, para as tarefas do dia a dia e deixar as etapas mais difíceis para quando o Fable 5.2 chegar. Se você precisa agora de recursos dessa categoria, a lista inclui o Fable 5.1 — mas ele não é o 5.2, e há diferenças de desempenho e comportamento.
| ID do modelo | Status na APIYI (apiyi.com) | Preço de lista (entrada / saída / leitura do cache, por milhão de tokens) | Endpoints |
|---|---|---|---|
claude-opus-5-5 |
Disponível (também há uma versão -thinking) |
$4 / $20 / $0.2 | chat, messages |
claude-fable-5-1 |
Disponível (também há uma versão -thinking) |
$10 / $50 / $0.25 | chat, messages |
claude-fable-5-2 |
Indisponível | Ainda não há preço; consulte a lista de modelos da plataforma | — |
claude-mythos-5-2 |
Indisponível | Ainda não há preço | — |
Os valores em dólar da tabela são preços de lista. O valor efetivamente cobrado também depende do multiplicador do grupo de tokens; consulte a fatura. Como o Fable 5.2 não está na lista, ainda não há um preço para aplicar o multiplicador. Não tente estimar a cobrança da APIYI com base no preço oficial. Para integrar, a APIYI oferece uma interface compatível com OpenAI e usa https://api.apiyi.com/v1 como base_url. Com uma única chave, você pode alternar entre o Opus 5.5 e o Fable 5.1. Novos usuários têm uma cota gratuita de teste, então você pode comparar o desempenho dos dois no seu próprio repositório.
Resumo dos pontos fortes e limitações do Claude Fable 5.2
Pontos fortes
- Muito melhor em tarefas longas e abertas: no nível High, o Remote Labor Index é quase o dobro do resultado do Opus 5.5.
- Boa relação custo-benefício no nível High: no FrontierCode, o nível High chega a cerca de 45,3%, igualando o melhor resultado do Opus 5.5, com aproximadamente metade do custo por tarefa, segundo a empresa.
- Mais barato e rápido que o 5.1: o preço padrão caiu 20%, e o anúncio de lançamento diz que a geração de saída pode ser até 30% mais rápida que no 5.1.
- Leitura de cache acessível: custa US$ 0,20, o mesmo que no Opus 5.5.
Limitações
- O preço padrão é o dobro do Opus 5.5: migrar tarefas do dia a dia para ele pode dobrar a conta.
- Não vence em tudo: perde para o Gemini 4 Carbon no AutomationBench e fica atrás do Opus 5.5 no Elo do AA-Briefcase.
- Limites de segurança e de capacidade: perguntas sobre cibersegurança e biologia podem ser respondidas por modelos anteriores; em otimização de kernel e melhorias na arquitetura do modelo, o avanço parece ter parado no Opus 5.5.
- Várias restrições de invocação: não dá para desativar o pensamento; ferramentas obrigatórias e parâmetros de amostragem geram erro 400; a retenção padrão é de 30 dias; tarefas longas podem ser interrompidas pelo próprio modelo.
Perguntas frequentes
P1: Qual é a diferença entre Claude Fable 5.2 e Fable 5.1?
Em termos de preço, o preço padrão do 5.2 é de US$ 8 para entrada e US$ 40 para saída, 20% abaixo dos US$ 10 / US$ 50 do 5.1. A leitura de cache caiu de US$ 0,25 para US$ 0,20. Nos benchmarks, o FrontierSWE v2 passou de 56,3% para 69,9%, e o Remote Labor Index, de 17,9% para 41,3%. Quanto ao comportamento, o 5.1 normalmente segue o comando “não pense”, mas o 5.2 não faz isso nos níveis medium ou superiores. No momento, a APIYI apiyi.com oferece o `claude-fable-5-1`; o 5.2 ainda não está disponível.
P2: O Claude Mythos 5.2 é um modelo mais poderoso?
Não. O anúncio de lançamento informa que Fable e Mythos usam o mesmo modelo-base. O Mythos tem menos proteções para cibersegurança e biologia, por isso só é disponibilizado a organizações cujos projetos foram aprovados. O preço é o mesmo do Fable 5.2. Alguns resultados de cibersegurança e biologia do anúncio estão atribuídos ao Mythos e não devem ser citados como resultados do Fable 5.2.
P3: Dá para desativar o pensamento no Claude Fable 5.2?
Não. O pensamento adaptativo fica sempre ativo, e nem mesmo um comando consegue interrompê-lo. Para controlar a quantidade de pensamento e os custos, só dá para reduzir o nível de effort. Na Claude API, o padrão é high; no aplicativo Claude e no Claude Code, é Medium. Vale lembrar que, no nível low, é mais comum o modelo parar depois de uma única rodada e deixar uma lista de tarefas pendentes. Por isso, não é recomendável usar low em tarefas longas.
Principais pontos do Claude Fable 5.2
- Posicionamento: lançado em 09/11/2026 como modelo técnico de ponta. Para o uso diário, a recomendação padrão continua sendo o Opus 5.5.
- Pontos fortes: alcançou 69,9% no FrontierSWE v2 e 41,3% na faixa High do Remote Labor Index.
- Não vence em tudo: perdeu para o Carbon no AutomationBench e para o Opus no Elo do AA-Briefcase.
- Proteções: questões de cibersegurança são respondidas pelo Opus 4.8, e questões de biologia, pelo Opus 5. A resposta não informa o
stop_reason. - Limitações do produto: o modo de pensamento fica sempre ativado; forçar ferramentas ou definir parâmetros de amostragem resulta em erro 400. Os dados são mantidos por 30 dias por padrão.
- Exemplos de tarefas longas: os casos do sistema operacional, com duração de 8 dias, e de Fermat, com duração de 30 horas, são experimentos oficiais isolados.
- Disponibilidade: em 10/11/2026, a APIYI ainda não oferecia o 5.2. Enquanto isso, você pode usar o Opus 5.5 e o Fable 5.1.
Resumo: quando não vale a pena migrar para o Claude Fable 5.2
O Fable 5.2 é realmente forte, mas seu diferencial está concentrado em tarefas técnicas abertas e de longa duração. Nas quatro situações a seguir, recomendamos continuar com o Opus 5.5 ou usar o Fable apenas como consultor ou orquestrador:
- Orçamento apertado: o preço padrão é o dobro do Opus 5.5, e o modo rápido custa o dobro disso.
- Exigência de retenção zero de dados: por padrão, os dados são mantidos por 30 dias. Sem autorização, não é possível desativar a retenção.
- Trabalho de cibersegurança ou biologia que pode ser barrado pelas proteções: quando isso acontece, quem responde é o Opus 4.8 ou o Opus 5. Com essa troca, você deixa de ter acesso aos recursos do Fable.
- Tarefa de programação do dia a dia: a própria recomendação oficial é começar pelo Opus 5.5.
Se a sua tarefa realmente se encaixa na categoria de trabalho «mais complexo e aberto», primeiro valide o fluxo com o Opus 5.5 e depois deixe a etapa mais difícil para o Fable. Quando o 5.2 estiver disponível, consulte a lista de modelos da plataforma para confirmar a versão e o preço.
Autor: equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI. Para mais informações, acesse a central de documentação em docs.apiyi.com.