Nota do autor: uma análise do lançamento do LongCat 2.5. Este artigo reúne parâmetros e arquitetura, oito demonstrações oficiais, resultados em 25 testes feitos pela própria equipe, custos com desconto por tempo limitado e formas de integração com Claude Code e Cline.
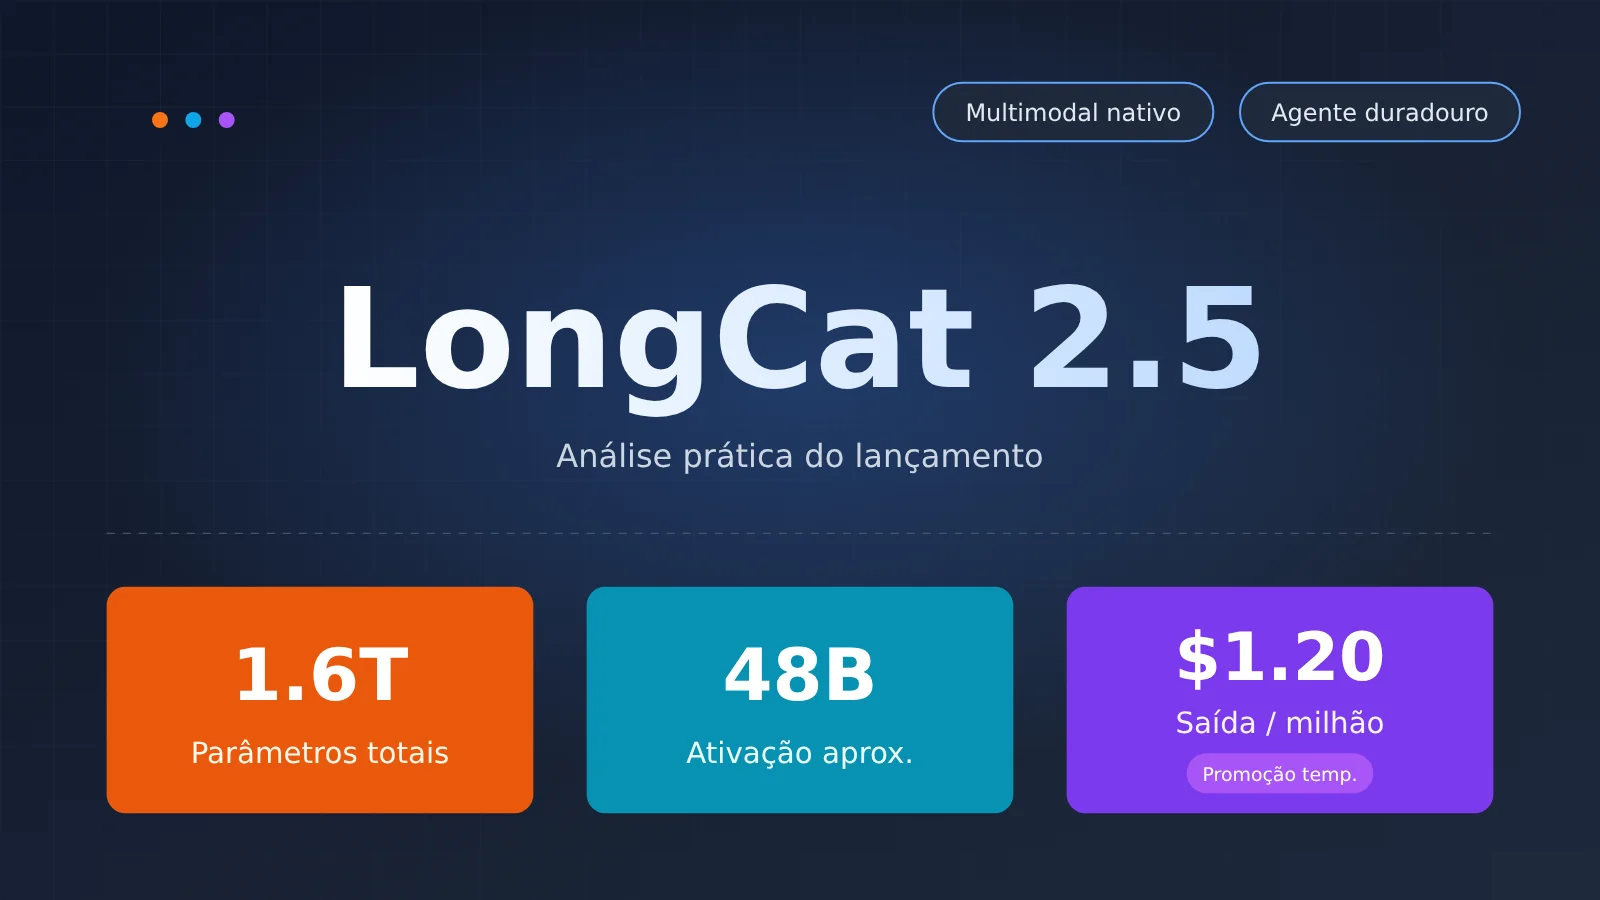
A equipe LongCat da Meituan, como é conhecida na comunidade, lançou o LongCat-2.5 em 1º de novembro. O modelo tem 1,6 trilhão de parâmetros no total e ativa cerca de 48 bilhões por token. É um modelo multimodal nativo voltado a tarefas de agentes de longa duração. Em relação à versão 2.0, as principais melhorias estão na compreensão visual nativa e na programação com agentes. Os preços promocionais são válidos por tempo limitado: US$ 1,20 por milhão de tokens de saída, US$ 0,30 por milhão de tokens de entrada sem acerto de cache e US$ 0,006 por milhão de tokens de entrada com acerto de cache.
Esta não é uma disputa para decidir qual modelo escolher. Vamos falar de apenas três coisas: o que é o LongCat 2.5, em quais tarefas ele se destaca e quanto custa usá-lo. Os resultados dos testes servem apenas como referência comparativa, sem concluir que um modelo substitui outro.
O que você leva daqui: um mapa de capacidades, uma conta clara dos custos e o caminho mais curto para começar a usar o modelo.
LongCat 2.5: informações principais
| Item | Detalhes |
|---|---|
| Data de lançamento | 01/11/2026 (blog oficial) |
| Proposta | Modelo multimodal nativo para tarefas de agentes de longa duração |
| Escala | 1,6T de parâmetros no total, com cerca de 48B ativados por token |
| Melhorias em relação ao 2.0 | Compreensão visual nativa e programação com agentes |
| Contexto / saída máxima | 1M de tokens / 128K de tokens |
| Interface | Dois protocolos: formatos OpenAI e Anthropic |
| Preço (desconto por tempo limitado) | Entrada: US$ 0,30 (sem cache) / US$ 0,006 (com cache); saída: US$ 1,20, por milhão de tokens |
| Pesos | Ainda não foram disponibilizados; GitHub e HuggingFace exibem “em breve” |
Há um detalhe sobre os parâmetros ativados que pode gerar confusão. No dia do lançamento, uma publicação da comunidade informou 440B, mas o blog oficial diz que cerca de 48 bilhões de parâmetros são ativados por token, ou seja, 48B. Neste artigo, usamos 48B em todos os casos.
O que é o LongCat 2.5: parâmetros, arquitetura e multimodalidade nativa
Escala e estratégia de treinamento do LongCat 2.5
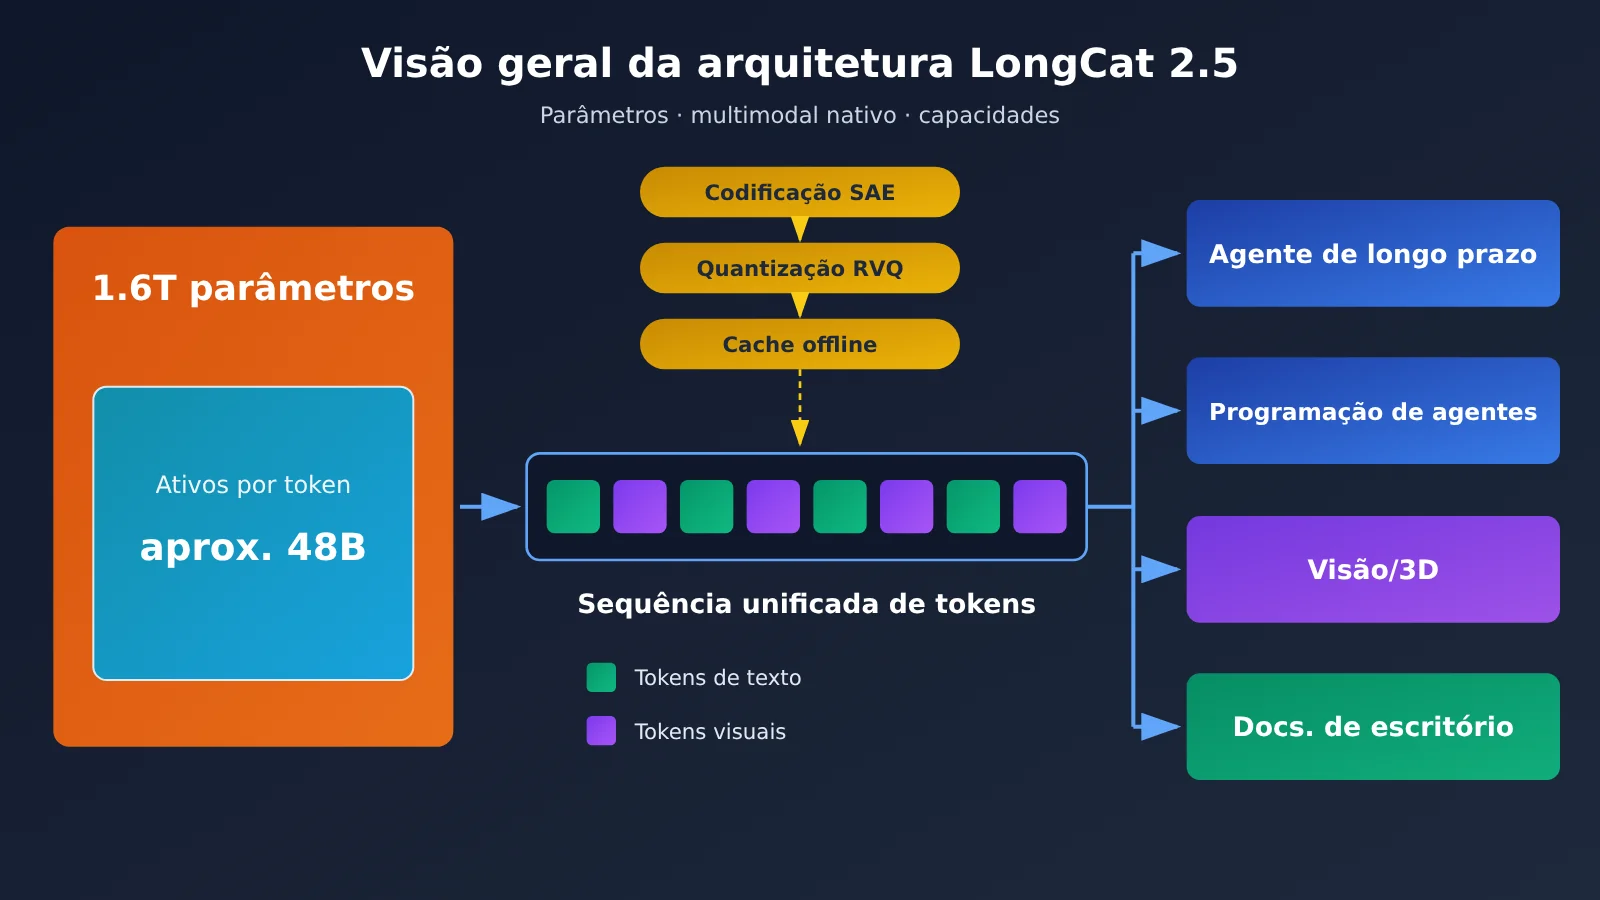
Com 1,6 trilhão de parâmetros no total e cerca de 48 bilhões ativados por vez, o LongCat 2.5 é um Modelo de Linguagem Grande com ativação esparsa: sua capacidade total é grande, mas cada inferência usa apenas uma pequena parte dela. Essa estrutura ajuda a equilibrar capacidade de conhecimento e custo de inferência, além de ser um dos fatores que permitem preços mais baixos.
Na estratégia de treinamento, a equipe do modelo destacou algumas práticas diretamente relacionadas a tarefas de longa duração:
- Mais dados de trajetórias longas: o treinamento com sequências longas inclui mais trajetórias de longa duração, seguido de aprendizado por reforço em larga escala. O objetivo é desenvolver a capacidade de realizar tarefas completas de engenharia, como trabalhar em bases de código complexas e construir projetos inteiros.
- Transformar falhas reais em tarefas de treinamento: síntese de dados, construção de ambientes e treinamento misto entre diferentes harnesses são ampliados em conjunto para transformar trajetórias de falha de agentes reais em tarefas reproduzíveis e verificáveis.
- Reduzir o excesso de raciocínio e as chamadas repetidas: raciocínios e chamadas de ferramentas repetidos recebem penalidades adicionais. Em casos de raciocínio excessivo ou crescimento rápido demais do comprimento das respostas, a recompensa dos exemplos positivos é redistribuída.
O terceiro ponto é especialmente relevante para cenários com agentes. Em tarefas longas, o que mais pesa no custo muitas vezes é o modelo ficar dando voltas na mesma ferramenta. Reduzir esse comportamento durante o treinamento significa economizar tokens diretamente.
Como funciona o multimodal nativo do LongCat 2.5
Aqui, «multimodal nativo» tem um significado específico. Os sinais visuais são representados como tokens discretos em vários níveis, e o modelo principal processa visão e texto em um formato unificado de tokens. Ou seja, ele não usa um codificador visual externo para depois incorporar suas características ao modelo.
A documentação oficial divide o processo em três etapas:
- Discretização visual em resolução nativa: um codificador alinhado semanticamente (SAE) e a quantização vetorial residual (RVQ) transformam a imagem em tokens discretos.
- Pré-processamento offline dos tokens visuais: depois que o tokenizador é fixado, os IDs dos tokens visuais podem ser calculados antecipadamente e armazenados em cache.
- Aprendizado conjunto: os embeddings visuais são treinados junto com o modelo principal.
Segundo a documentação oficial, essa arquitetura dá ao modelo um desempenho de destaque em programação visual e permite que ele execute tarefas de design criativo, 3D e outras áreas. Os benchmarks 3DCodeBench e Vision2Web, na tabela de resultados mais adiante, medem justamente esse tipo de capacidade.
Por que o LongCat 2.5 consegue ter esse preço
O blog oficial dedica bastante espaço à eficiência de engenharia, e isso ajuda a explicar o preço. O treinamento foi realizado em hardware de computação produzido na China, com menos de 80 GB de memória por GPU. Para reduzir o uso de memória, a equipe recorreu a técnicas como FSDP com fragmentação dupla, paralelismo híbrido de vocabulário e replicação dinâmica de especialistas. Em tarefas de SFT com sequências longas, essa configuração de FSDP teve throughput por GPU 86% maior que a referência com DDP.
Na inferência, o modelo usa W4A4: tanto os pesos dos especialistas quanto as ativações são quantizados em 4 bits. Nos testes de carga online oficiais, em comparação com a referência W8A8 INT8, o throughput de prefill aumentou 43,3% e o de decode, 42,77%. A latência até o primeiro token (TTFT) caiu 15,91%, e a latência por token (TPOT), 19,72%. Com um throughput mais de 40% maior, o custo por token naturalmente diminui.
Onde o LongCat 2.5 se destaca: agentes para tarefas longas e 8 casos oficiais
O salto do LongCat 2.0 para o 2.5
Primeiro, vale comparar o modelo com sua versão anterior. Os números abaixo vêm de testes realizados pela própria equipe do LongCat. Os itens de comparação marcados com asterisco vêm de rankings públicos; nesta seção, citamos apenas as pontuações das duas gerações do LongCat.
- Terminal Bench v4.0: 3,0 no 2.0 e 38,5 no 2.5.
- DeepSWE v1.1: 9,7 no 2.0 e 64,6 no 2.5.
- Program Bench Almost Resolved: 2,5 no 2.0 e 25,5 no 2.5.
- AutomationBench v1.0.6: 15,8 no 2.0 e 51,8 no 2.5.
Todos esses testes envolvem tarefas de várias etapas, como operações em terminal, correções em repositórios inteiros e fluxos de automação. O 2.0 tinha resultados próximos de zero nesses itens; o 2.5 chegou a uma faixa em que já pode ser comparado com outros modelos. Isso mostra que a evolução em programação com agentes é significativa. A equipe também informa que todos os resultados do LongCat-2.5 foram obtidos com thinking ativado, temperature=1.0 e top_p=0.95.
Os 8 casos de demonstração oficiais do LongCat 2.5
A equipe publicou 8 casos gerados de ponta a ponta, divididos em dois grupos. Vale lembrar que são demonstrações oficiais: este artigo não reproduziu cada uma delas.
| Categoria | Caso | O que esse tipo de tarefa avalia |
|---|---|---|
| Desenvolvimento de software | Simulação de fluidos em tempo real | Cálculos físicos + renderização em tempo real no front-end |
| Desenvolvimento de software | Exibição interativa de artefatos históricos em 3D | Criação de cenas 3D e lógica de interação |
| Desenvolvimento de software | Maquete urbana | Disposição e organização de muitos objetos |
| Desenvolvimento de software | Assets para cenas em miniatura | Controle de detalhes na geração de assets 3D |
| Trabalho profissional | Análise de desempenho comercial | Leitura de dados, análise de indicadores e redação de conclusões |
| Trabalho profissional | Relatório de análise de feedback dos clientes | Classificação e consolidação de textos não estruturados |
| Trabalho profissional | Página sobre estética de cores chinesas | Estética visual e diagramação de página web |
| Trabalho profissional | Gerador de convites para eventos | Interação com formulários + design de layout |
Dos quatro casos de desenvolvimento de software, três estão diretamente ligados a 3D, em linha com o foco em visão nativa e Visual Coding. Já o grupo de trabalho profissional se concentra mais em “ler materiais e entregar um produto final”, seguindo a mesma direção de tarefas avaliadas por benchmarks como JobBench e GDPVal.
Qual é a posição do LongCat 2.5 nos benchmarks
A tabela oficial de avaliação reúne mais de 25 testes, divididos em três categorias: Code Agent, General Agent e Visual. Abaixo, selecionamos nove deles para comparar cinco modelos.
| Benchmark | LongCat-2.5 | Claude Opus 5 | GPT-5.6-Sol | GLM-5.3 | Kimi K3 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 89.1* | 88.8* | 88.2* | 88.3* |
| Terminal Bench v4.0 | 38.5 | 53.9* | 37.3* | 41.8* | 12.6* |
| DeepSWE v1.1 | 64.6 | 68.8* | 72.7* | 66.9* | 67.5* |
| BrowseComp | 91.9 | 90.8* | 90.4* | 81.0 | 91.2* |
| HLE w/tools | 63.1 | 64.7* | 58.0* | 62.5* | 56.0* |
| JobBench | 65.4 | 66.7* | 45.4* | 61.4* | 52.9* |
| MCP Atlas | 83.1 | 85.8* | 81.8* | 84.2* | 84.2* |
| 3DCodeBench Text to 3D | 55.4 | 54.3 | 52.3 | 53.4 | 49.3 |
| Vision2Web | 78.6 | 80.2* | 73.5* | 77.8* | 79.0* |
Os resultados com * vêm de rankings públicos ou relatórios técnicos citados pela equipe oficial. Os demais são testes próprios do LongCat e servem apenas como referência comparativa.
Olhando apenas para os números, dá para destacar alguns pontos:
- Busca: o LongCat marcou 91,9 no BrowseComp, a maior pontuação entre os cinco modelos. A equipe usou um harness leve desenvolvido internamente, com apenas as ferramentas search e browse_with_goal ativadas e um limite de 1.024 rodadas.
- Geração 3D: os 55,4 pontos no 3DCodeBench Text to 3D também são a maior pontuação entre os cinco. Mas nenhuma das notas nessa linha tem asterisco: todas foram medidas nos testes próprios do LongCat.
- Tarefas no terminal: no Terminal Bench v2.1, os cinco modelos ficam entre 88,2 e 89,1. Na versão v4.0, mais difícil, o LongCat-2.5 marca 38,5, contra 53,9 do Claude Opus 5 — uma diferença de 15,4 pontos.
- Correções em repositórios: no DeepSWE v1.1, o LongCat marcou 64,6, a menor pontuação entre os cinco. O GPT-5.6-Sol chegou a 72,7.
- Uso de ferramentas e tarefas de escritório: com 83,1 no MCP Atlas e 65,4 no JobBench, o LongCat ficou, respectivamente, 2,7 e 1,3 ponto atrás do Opus 5.
Também vale prestar atenção ao harness. As duas versões do Terminal Bench usam o Claude Code harness, com max_seq_length de 512K; o DeepSWE usa o mini-swe-agent, com comprimento de sequência de 1M. Não é recomendável comparar diretamente pontuações de testes diferentes que usam harnesses distintos.
Quanto custa o LongCat 2.5: comparação de preços e conta para 1 milhão de tokens
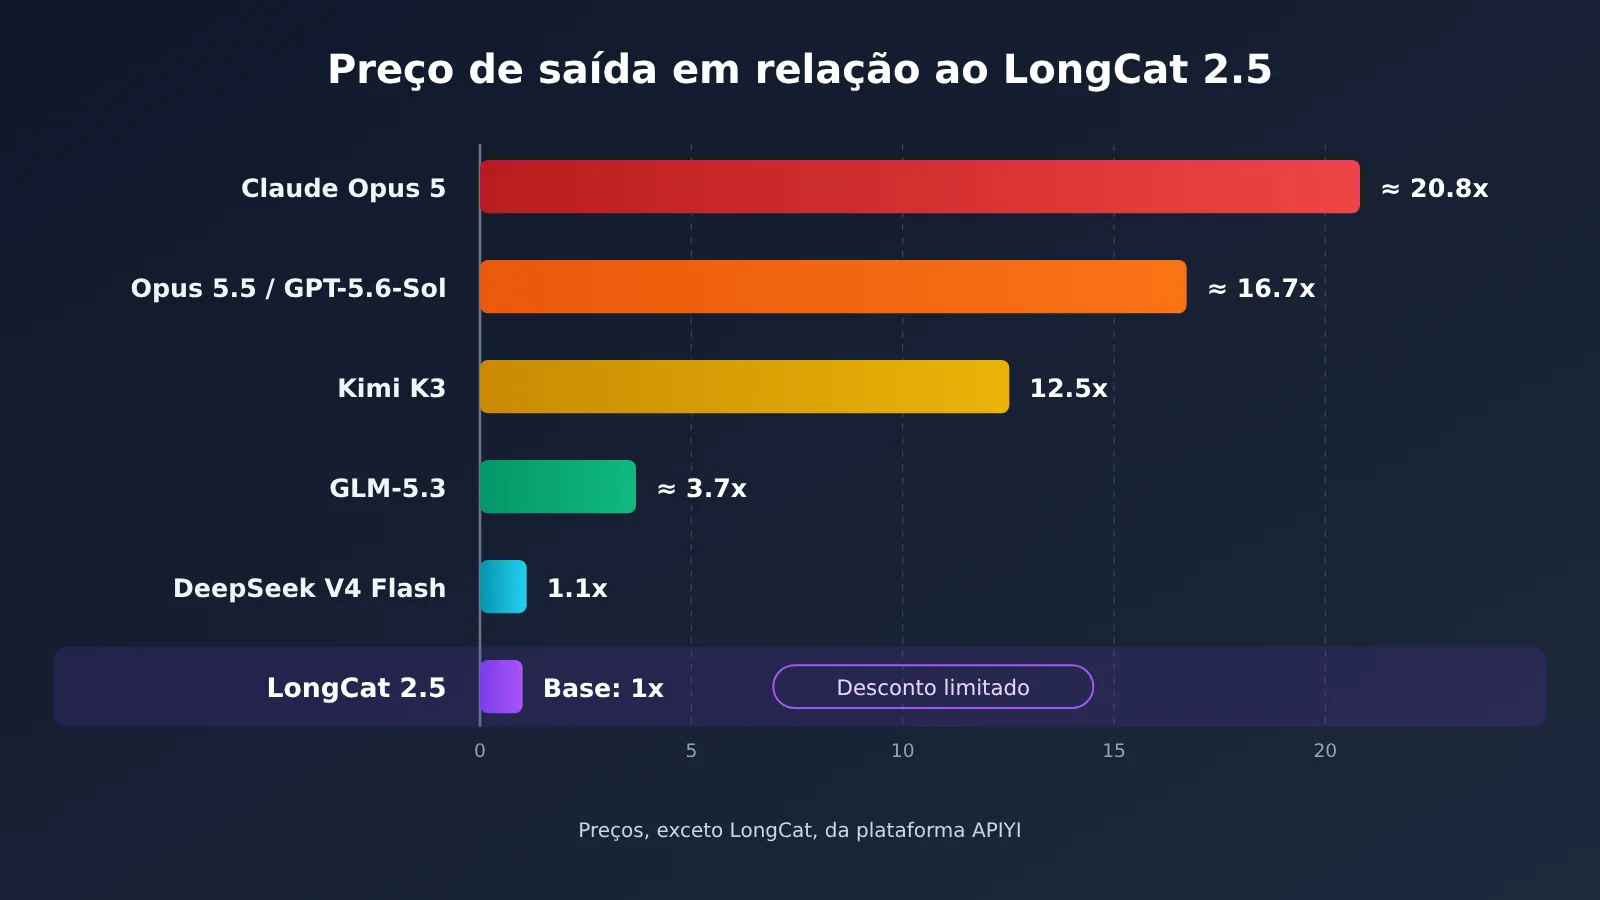
Legenda: o preço do LongCat-2.5 é uma oferta por tempo limitado na plataforma oficial de API. Os preços dos demais modelos foram consultados na lista de modelos da plataforma APIYI apiyi.com.
| Modelo | Entrada (por 1 milhão de tokens) | Saída (por 1 milhão de tokens) | Preço de saída em relação ao LongCat |
|---|---|---|---|
| LongCat-2.5 (desconto por tempo limitado, plataforma oficial) | $0.30 (com cache: $0.006) | $1.20 | 1 vez |
| Claude Opus 5 | $5 | $25 | Cerca de 20,8 vezes |
| Claude Opus 5.5 | $4 | $20 | Cerca de 16,7 vezes |
| GPT-5.6-Sol | $4 | $20 | Cerca de 16,7 vezes |
| Kimi K3 | $3 | $15 | 12,5 vezes |
| GLM-5.3 | $1.4 | $4.396 | Cerca de 3,7 vezes |
| DeepSeek V4 Flash | $0.44 | $1.32 | Cerca de 1,1 vez |
Os preços da APIYI apiyi.com foram consultados em 02/11/2026 e correspondem aos valores exibidos na lista de modelos da plataforma naquela data. O preço do LongCat-2.5 vem da plataforma LongCat API, que informa que ele pode sofrer alterações.
A conta de uma tarefa com 1 milhão de tokens
Imagine uma tarefa em lote com 1 milhão de tokens no total: 800 mil de entrada e 200 mil de saída, sem considerar o cache.
- LongCat-2.5 (desconto por tempo limitado): 0.8 × $0.30 + 0.2 × $1.20 = $0.48
- DeepSeek V4 Flash: $0.352 + $0.264 = $0.616
- GLM-5.3: $1.12 + $0.879 ≈ $2.00
- Kimi K3: $2.40 + $3.00 = $5.40
- GPT-5.6-Sol ou Claude Opus 5.5: $3.20 + $4.00 = $7.20
- Claude Opus 5: $4.00 + $5.00 = $9.00
Para a mesma tarefa, o Opus 5 custa cerca de 18,75 vezes mais que o LongCat-2.5. Se parte da entrada estiver em cache, a diferença será ainda maior. No exemplo oficial, são 1 milhão de tokens de entrada (400 mil em cache e 600 mil fora do cache) e 500 mil de saída, resultando em uma conta de $0.18 + $0.0024 + $0.6 = $0.7824. A entrada em cache custa apenas $0.006, ou 1/50 do preço da entrada fora do cache.
Há mais dois detalhes de cobrança que vale lembrar: só há cobrança quando a resposta retorna HTTP 200; requisições malsucedidas com códigos como 401, 403, 429 e 500 não são cobradas. O saldo é pré-pago e não expira; quando há créditos gratuitos, eles são usados primeiro.
Como facilitar a comparação entre vários modelos
Na prática, projetos com agentes raramente usam um único modelo. Você pode querer testar o mesmo conjunto de comandos e comparar as respostas de LongCat-2.5, Claude, GPT e GLM. Na APIYI apiyi.com, dá para alternar entre modelos com uma única conta e uma só chave API, sem criar contas e adicionar créditos em cada provedor separadamente.
📌 Observação: consulte a lista de modelos da APIYI apiyi.com para conferir os modelos e preços disponíveis. O LongCat-2.5 ainda não está disponível na APIYI, mas será lançado em breve.
Como começar a usar o LongCat 2.5: teste no site e integração via API
Primeiro passo: teste pela web
O acesso ao teste online oficial é longcat.ai/chat. Segundo a publicação de lançamento na comunidade, durante o período de lançamento, novos usuários recebem 10M de tokens e usuários antigos recebem 5M de tokens automaticamente. Acertos de cache não consomem os créditos recebidos. A publicação também menciona um pacote promocional por tempo limitado de 9,9 yuans, com lançamento previsto para breve. Vale começar testando tarefas de busca e análise de imagens, duas áreas em que o modelo ficou bem posicionado nos benchmarks.
Segundo passo: use a API e lembre-se de quatro parâmetros
- Endpoint no formato OpenAI:
https://api.longcat.ai/openai - Endpoint no formato Anthropic:
https://api.longcat.ai/anthropic - Campo model:
LongCat-2.5 - Contexto e saída: janela de contexto de 1M, saída máxima de 128K tokens
Sobre os limites de requisição, a documentação oficial informa apenas que, quando o limite é excedido, a API retorna HTTP 429, o código de erro rate_limit_exceeded e retry_after igual a 60. Também recomenda que o cliente tente novamente com recuo exponencial. Os limites específicos de RPM e TPM não foram divulgados.
Se seu código já usa o SDK da OpenAI para invocar outros modelos, basta alterar base_url, api_key e model para fazer a troca. Por exemplo, se você usa a APIYI no dia a dia, o base_url é https://api.apiyi.com/v1. Para mudar para a API oficial do LongCat, troque-o por https://api.longcat.ai/openai e altere o model para LongCat-2.5.
Terceiro passo: integre ao Claude Code
- Claude Code, seção env de
~/.claude/settings.json: preenchaANTHROPIC_AUTH_TOKENcom a chave API do LongCat - Seção env do mesmo arquivo: preencha
ANTHROPIC_BASE_URLcomhttps://api.longcat.ai/anthropic - Seção env do mesmo arquivo: preencha
ANTHROPIC_MODELcomLongCat-2.5 - Seção env do mesmo arquivo: preencha
CLAUDE_CODE_MAX_OUTPUT_TOKENScom131072 - Seção env do mesmo arquivo (recomendado alterar também): configure
ANTHROPIC_SMALL_FAST_MODEL,ANTHROPIC_DEFAULT_SONNET_MODELeANTHROPIC_DEFAULT_OPUS_MODELpara apontar paraLongCat-2.5
Se você não alterar essas três últimas variáveis, as subtarefas internas do Claude Code ainda podem enviar requisições aos modelos padrão, causando erros ou cobranças indesejadas.
Quarto passo: integre ao Cline
- Cline, painel de configurações na barra lateral do VS Code: em API Provider, selecione uma opção compatível com OpenAI
- No mesmo painel: preencha Base URL com
https://api.longcat.ai/openai - No mesmo painel: preencha API Key com a chave do LongCat e Model ID com
LongCat-2.5
A documentação oficial do LongCat tem uma página específica para a integração com o Cline. Consulte a página oficial para confirmar os nomes dos campos. Há também páginas de integração para mais de dez ferramentas, incluindo Codex, OpenCode, Kilo Code, Cherry Studio, Chatbox e CC Switch.
🚀 Dica para começar: use primeiro os créditos oferecidos pelo LongCat para testar suas tarefas e depois decida se vale a pena manter a integração. Se também precisar invocar Claude, GPT e Gemini para comparar os resultados, você pode gerenciá-los pela APIYI apiyi.com usando uma única interface compatível com OpenAI. Quando o LongCat-2.5 estiver disponível, também será possível alternar para ele na mesma conta.
Para que serve o LongCat 2.5
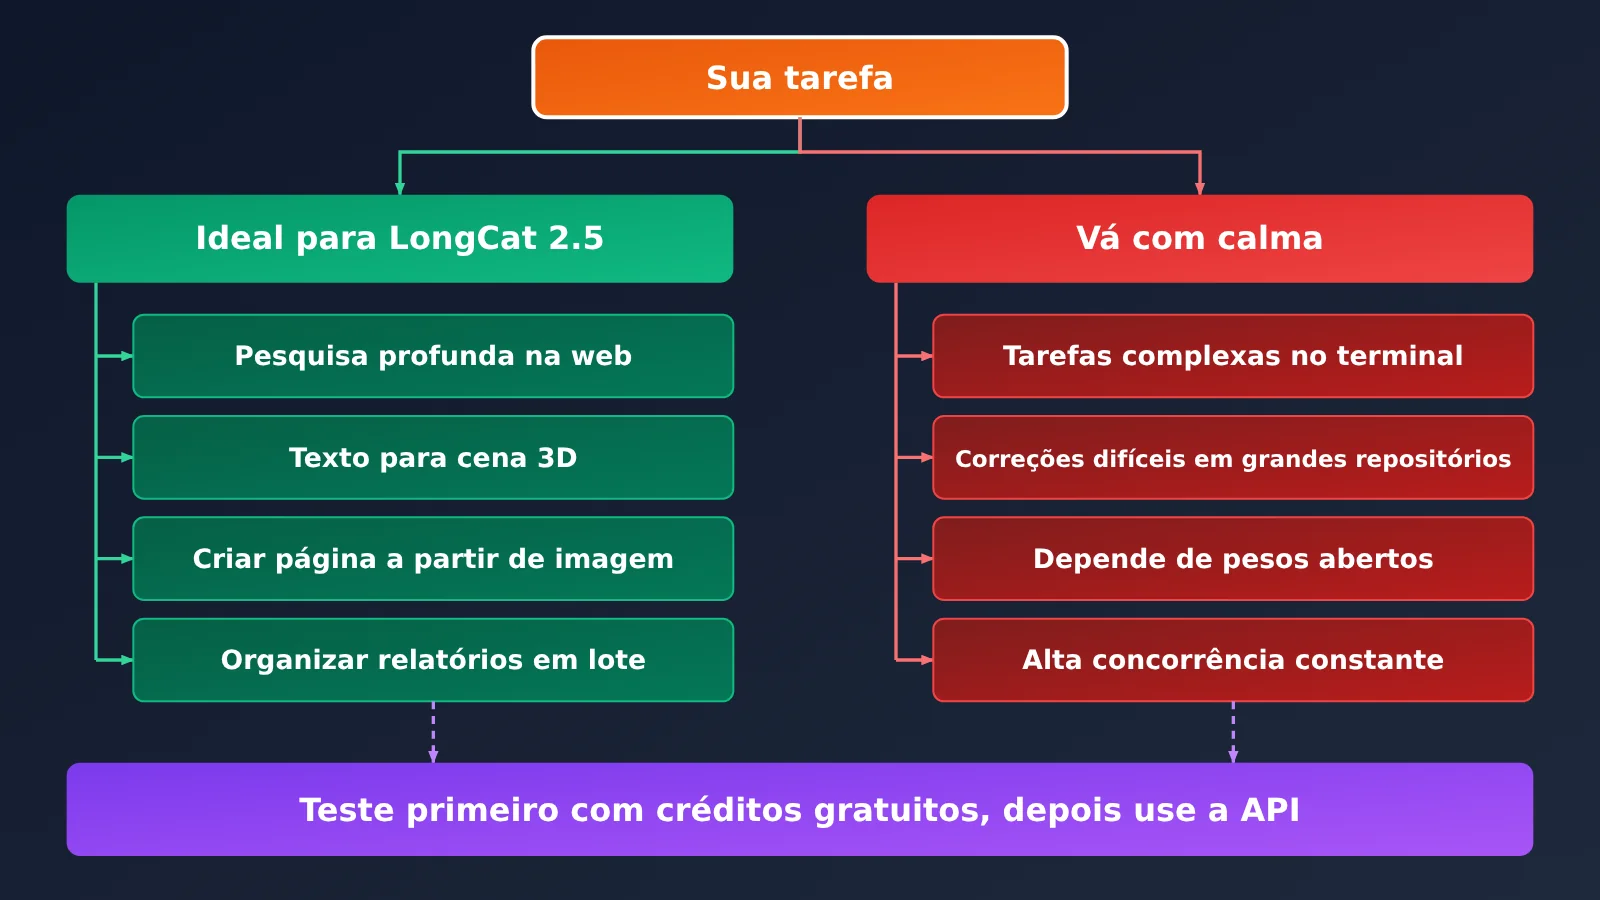
| Tarefas ideais para o LongCat 2.5 | Tarefas em que é melhor esperar |
|---|---|
| Pesquisar na web em várias etapas e reunir informações (BrowseComp 91.9) | Tarefas complexas de operações e manutenção no terminal, com várias etapas (38.5 no Terminal Bench v4.0, contra 53.9 do Opus 5) |
| Gerar cenários 3D, por exemplo em Three.js, a partir de descrições em texto (3DCodeBench 55.4) | Corrigir bugs difíceis em grandes repositórios (64.6 no DeepSWE v1.1, a menor pontuação entre os cinco modelos) |
| Criar páginas web a partir de layouts ou capturas de tela (Vision2Web 78.6) | Projetos que exigem implantação privada e pesos locais (os pesos ainda não foram disponibilizados) |
| Organizar feedback de clientes e dados de negócios em lote e transformá-los em textos (JobBench 65.4; saída por US$ 1,20/milhão, em promoção por tempo limitado) | Serviços em produção que precisam de uma cota fixa para alta concorrência (os limites de RPM/TPM não foram divulgados oficialmente) |
As tarefas da coluna da esquerda têm algo em comum: são longas, consomem muitos tokens e são sensíveis ao preço unitário. Nelas, tanto as pontuações quanto o preço do LongCat-2.5 são competitivos. A coluna da direita não significa que ele seja incapaz de fazer essas tarefas, mas que ainda há uma diferença visível nas pontuações ou que as condições de implantação e as cotas não estão claras. Nesses casos, vale começar com um teste em pequena escala.
Perguntas frequentes sobre o LongCat 2.5
Q1: As pontuações do LongCat 2.5 foram medidas por terceiros?
Não. Todas as pontuações do LongCat-2.5 na tabela vêm de testes realizados pela própria equipe do LongCat. Entre os modelos usados para comparação, as pontuações com asterisco vêm de relatórios públicos ou rankings oficiais; as demais também foram medidas pelo LongCat. Vale usá-las como referência para comparação.
Q2: O preço de US$ 1,20 por milhão de tokens é permanente?
Não. A equipe oficial informa que esse é um preço promocional por tempo limitado e que ele pode mudar. Consulte a página da plataforma LongCat API e sua fatura para confirmar o valor. Ao planejar o orçamento de longo prazo, vale ter um modelo alternativo e usar uma plataforma agregadora como a APIYI, apiyi.com, para manter a flexibilidade de trocar de modelo.
Q3: O LongCat 2.5 é de código aberto?
Ainda não. Os botões do GitHub e do HuggingFace no blog oficial estão marcados como “em breve”. Por enquanto, só estão disponíveis o teste online e o acesso via API. A equipe oficial não divulgou um cronograma para a abertura do código.
Q4: Posso usar o LongCat 2.5 pela APIYI?
Ainda não, mas a APIYI disponibilizará esse modelo em breve. Por enquanto, você pode usar diretamente a API oficial do LongCat. Se quiser comparar Claude, GPT e GLM, pode usar uma única chave na APIYI, apiyi.com, para testar esses modelos. Consulte a lista da plataforma para conferir os modelos e preços disponíveis.
Q5: O que fazer ao receber um erro 429?
Isso significa que o limite de requisições foi atingido. O corpo da resposta trará `retry_after` com valor 60. A equipe oficial recomenda implementar novas tentativas com espera exponencial no cliente. Requisições que retornam 429 não são cobradas.
Resumo: vale a pena integrar o LongCat 2.5?
Os principais pontos do LongCat 2.5:
- Posicionamento: modelo multimodal nativo com 1,6 trilhão de parâmetros no total e cerca de 48 bilhões ativados por token, focado em tarefas de agentes de longa duração.
- Evolução: em comparação com a versão 2.0, passou de 3,0 para 38,5 no Terminal Bench v4.0 e de 9,7 para 64,6 no DeepSWE v1.1.
- Pontos fortes: 91,9 no BrowseComp e 55,4 no 3DCodeBench, as maiores pontuações entre os cinco modelos comparados neste artigo, segundo dados oficiais.
- Limitações: ainda há uma diferença considerável no Terminal Bench v4.0 e no DeepSWE v1.1.
- Preço: saída a US$ 1,20 por milhão de tokens na promoção por tempo limitado; uma conta com 800 mil tokens de entrada e 200 mil de saída fica em torno de US$ 0,48.
- Integração: compatível com os protocolos OpenAI e Anthropic; no Claude Code, basta alterar quatro variáveis.
Em resumo: experimente primeiro as tarefas de pesquisa e análise de imagens em longcat.ai/chat, usando os 10 milhões de tokens gratuitos. Depois que tudo estiver funcionando, passe para a API. Se precisar alternar entre vários modelos no longo prazo, gerencie todos pela APIYI, em apiyi.com.
📚 Referências
- Blog oficial do LongCat: artigo de lançamento do LongCat-2.5, com arquitetura, treinamento e tabela de avaliações
- Link:
longcat.ai/blog/longcat-2.5 -
Detalhes: fonte primária para a escala de parâmetros, os 8 exemplos de demonstração e a metodologia das pontuações
-
Documentação da plataforma LongCat API: interfaces, cobrança e integração com ferramentas
- Link:
longcat.ai/platform/docs -
Detalhes: endpoints dos dois protocolos, preços promocionais por tempo limitado e páginas de integração com Claude Code e Cline
-
Lista de modelos da APIYI: preços nas plataformas de cada modelo
- Link:
docs.apiyi.com/models - Detalhes: fonte dos preços comparados neste artigo; consulte os valores exibidos no dia
Autor: equipe técnica da APIYI
Contato técnico: entre em contato pela página inicial do site da APIYI. Para mais informações, acesse a central de documentação em docs.apiyi.com