Nota do autor: usando a controvérsia sobre a reescrita dos pesos do Qwen3.5-0.8B pelo GPT-6 Astra como exemplo, este artigo apresenta 6 passos para analisar alegações sobre capacidades de modelos, examinando baselines, permissões de ferramentas, configurações de avaliação e evidências de reprodução.
Uma notícia como “um modelo de fronteira entendeu e reescreveu os pesos de outro modelo, fazendo sua pontuação em matemática saltar de 7,9% para 48,1%” é suficiente para tomar conta do debate sobre IA. Mas, em menos de um dia, desenvolvedores publicaram contestações, e a imprensa chinesa também repercutiu o caso com manchetes como “Obra-prima do MIT é demolida”. Com base nessa controvérsia sobre a alteração dos pesos do Qwen pelo Astra, vamos construir um método reutilizável para analisar alegações sobre capacidades de modelos.
Este não é um artigo para tomar partido. Em vez de julgar quem está certo ou errado, vamos comparar, passo a passo, os logs originais do experimento, as declarações dos autores e as críticas, transformando um assunto do momento em uma lista de verificação que pode ser usada outras vezes.
O que você vai aprender: ao final do artigo, você terá 6 perguntas para examinar qualquer alegação de “avanço nas capacidades de um modelo” e evitar erros ao escolher soluções, apresentar resultados e tomar decisões técnicas.
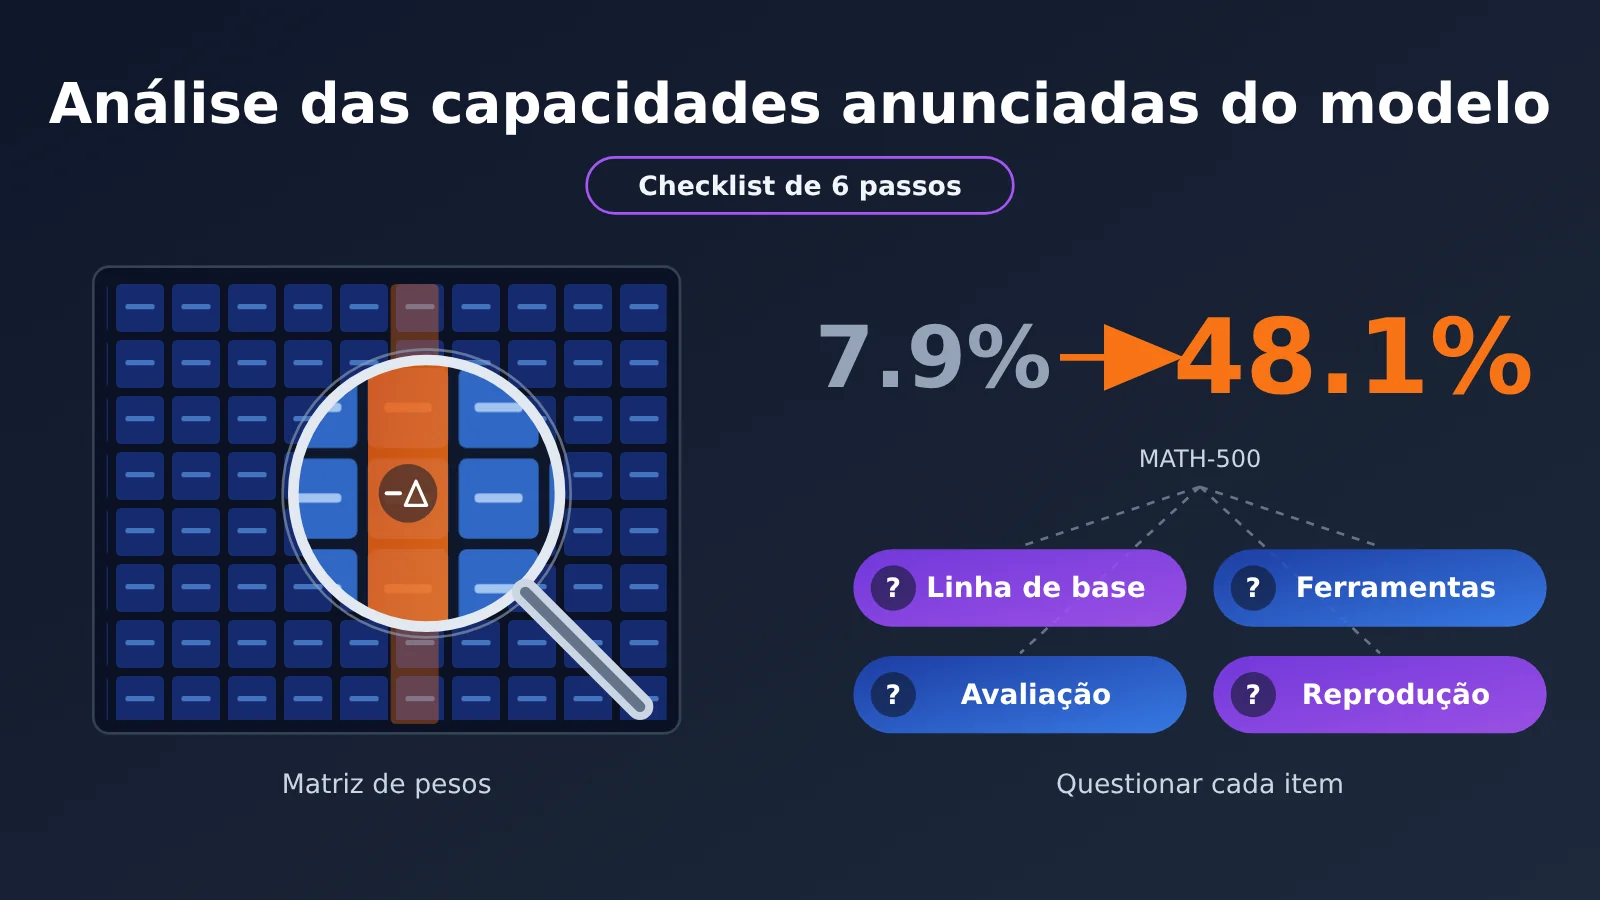
Pontos principais da controvérsia sobre a alteração dos pesos do Qwen pelo Astra
A tabela abaixo resume os fatos e os pontos controversos do caso. Eles servem de base para a análise que vem a seguir.
| Ponto | Explicação | O que observar ao analisar a divulgação |
|---|---|---|
| Origem da pesquisa | Rikiya Takehi, Jayden Teoh, Alex Zhang e Omar Khattab, do MIT CSAIL, publicaram o artigo Sparks of Weight-Space Programming em 2 de novembro de 2026, junto com os registros dos experimentos e os modelos modificados | A existência de registros públicos é o primeiro critério para avaliar a credibilidade |
| Resultado de destaque | O GPT-6 Astra modificou 131.072 dos cerca de 800 milhões de pesos do Qwen3.5-0.8B (aproximadamente 0,016%), e o resultado no MATH-500 subiu de 7,9% para 48,1% | Quanto mais impressionante a porcentagem, mais importante é perguntar por que o resultado inicial era tão baixo |
| Condições e ferramentas | No experimento, o Astra trabalhou em um ambiente Python com os pesos carregados e pôde executar até 50 lotes de avaliações de prática | “Entender os pesos” e “escrever código para analisar os pesos” são coisas diferentes |
| Principais críticas | Matthew Honnibal considera que a divulgação reuniu experimentos com diferentes níveis de acesso a ferramentas em uma única grande conclusão; Sean Goedecke argumenta que a correção do Qwen é, na essência, uma técnica de steering já conhecida | Para avaliar se um método é novo, é preciso compará-lo com as técnicas existentes |
| Contraexemplo | Quando o mesmo processo foi aplicado ao Gemma 3 270M, o resultado no MATH-500 passou de 6,8% para, no máximo, 7,7%. Os próprios autores consideraram que a melhora não se sustentou | Funcionar em um modelo não significa que a capacidade possa ser generalizada |
Como o Astra modificou os pesos do Qwen
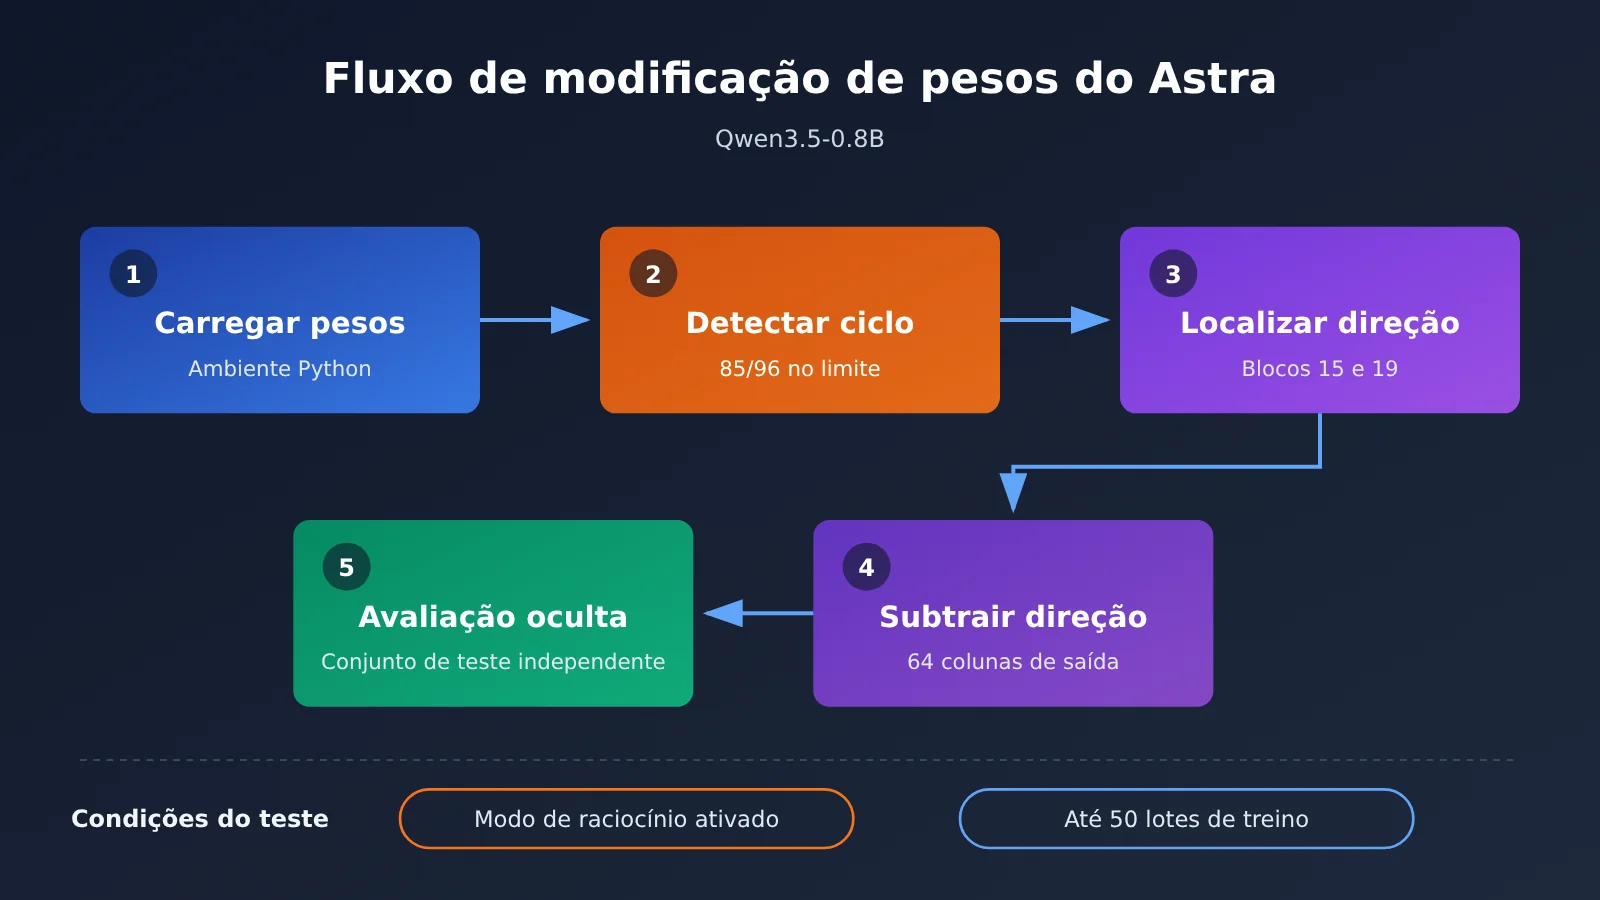
Ao examinar os detalhes do experimento, fica claro que o processo foi bem mais complexo do que simplesmente “ler os pesos e melhorar a pontuação”. O Qwen3.5-0.8B apresentava um problema grave de repetição quando o modo de raciocínio estava ativado: das primeiras 96 respostas de prática examinadas pelo Astra, 85 continuaram gerando texto até o limite de 32.768 tokens sem chegar a uma resposta. Essa fraqueza já era mencionada no cartão oficial do modelo Qwen. Vale notar que o modo de raciocínio vem desativado por padrão nesse modelo, mas foi ativado especificamente para o experimento.
O Astra então rastreou o comportamento repetitivo até uma direção específica produzida pelas camadas feedforward dos blocos 15 e 19 e subtraiu essa direção de 64 colunas de saída de cada bloco. Segundo o README do experimento, o plano era modificar 131.072 pesos; após o arredondamento de acordo com a precisão da avaliação, 130.188 foram efetivamente alterados. Na execução bem-sucedida, o código Python foi executado 80 vezes ao longo de 20,3 horas, incluindo uma interrupção do serviço de 4,7 horas.
Como analisar alegações sobre a capacidade de um modelo: checklist de 6 passos
Este checklist foi elaborado com base na controvérsia sobre a alteração dos pesos do Qwen pela Astra. Cada passo aborda uma pergunta específica e pode ser aplicado a artigos científicos, apresentações de lançamento, materiais de benchmarks e até descrições de produtos dos fabricantes.
Passo 1: Comece pela linha de base e pelos modos de falha
Diante de qualquer alegação de “aumento de X pontos percentuais”, pergunte primeiro: por que o resultado inicial era tão baixo? A linha de base do Qwen3.5-0.8B era de apenas 7,9%, enquanto 93,0% das respostas no MATH-500 atingiam o limite de tokens. Ou seja, muitas vezes o modelo não deixava de acertar por não saber resolver o problema, mas porque simplesmente não terminava a resposta.
Compare a última coluna da tabela abaixo com a primeira, e a conclusão fica clara: o grande aumento nas pontuações ocorreu quase ao mesmo tempo que a queda acentuada na taxa de respostas que atingiram o limite.
| Versão do Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Proporção que atingiu o limite no MATH-500 |
|---|---|---|---|---|
| Modelo base | 7,9% | 13,8% | 21,0% | 93,0% |
| Versão editada, 10 lotes de prática | 12,3% | 25,7% | 49,0% | 87,2% |
| Versão editada, 25 lotes de prática | 14,1% | 25,1% | 39,9% | 86,4% |
| Versão editada, 50 lotes de prática | 48,1% | 67,1% | 62,3% | 33,1% |
Fonte dos dados: Takehi e colaboradores, MIT CSAIL, 2 de novembro de 2026, com o modo de pensamento ativado. O texto original explica que cada versão editada foi executada de forma independente, com alterações diferentes, e que a edição de 131.072 pesos destacada na manchete corresponde à linha de 50 lotes.
Etapa 2: veja quais ferramentas o modelo tem à disposição
Esse é o ponto central da crítica de Honnibal. O estudo apresenta 8 experimentos e um experimento posterior com o Gemma, mas as condições oferecidas ao modelo variam bastante: em alguns casos, ele recebe apenas os pesos brutos em texto, sem nenhuma ferramenta; em outros, tem um ambiente Python completo e várias rodadas de prática e avaliação. Ao reunir tudo sob a conclusão de que o modelo “consegue ler e escrever pesos”, é fácil superestimar sua capacidade de simplesmente “entendê-los”.
| Experimento | Tamanho da rede | Condições oferecidas ao Astra | Resultado |
|---|---|---|---|
| Identificar qual jogo a rede está jogando | 17.253 pesos | Pesos brutos em texto | 4/4 corretos |
| Identificar as formas desenhadas por um modelo de difusão | 23.824 | Pesos brutos em texto | 3/3 corretos |
| Identificar o texto de treinamento de um pequeno modelo de linguagem | 7,2 milhões | Camadas intermediárias + Python | 3/3 corretos |
| Corrigir uma política de direção que ficou travada | 171.664 | Pesos brutos, descrição do cenário e 1 registro de falha | Taxa de sucesso de 0% a 100% |
| Criar do zero uma rede para Go 9×9 | 1,48 milhão | Python, até 50 tentativas de prática | Superou uma rede PPO do mesmo tamanho |
| Identificar o modelo bajulador | 270 milhões | Primeiro Python, depois padrões de atenção | Falhou inicialmente, depois acertou 3/3 |
| Corrigir o desempenho do Qwen em matemática | 800 milhões | Python, até 50 lotes de prática | MATH-500 de 7,9% a 48,1% |
| Melhorar o desempenho do Gemma em matemática | 270 milhões | Python, até 50 lotes de prática | Sem melhora conclusiva (no máximo 0,9 ponto percentual) |
A tabela foi organizada com base no resumo do estudo original publicado pela R&D World, e a classificação das condições segue a divisão de Honnibal. Dá para perceber de cara: os experimentos de leitura de pesos em texto ocorreram em redes pequenas, com dezenas de milhares de parâmetros. Já ao trabalhar com um modelo de linguagem de 800 milhões de parâmetros, o modelo tinha à disposição um ambiente Python como o que um engenheiro humano de aprendizado de máquina também usaria.
Etapa 3: Compare com técnicas existentes para avaliar a novidade
Goedecke aponta que encontrar uma direção de ativação e subtraí-la dos pesos é, essencialmente, uma aplicação de steering (direcionamento de ativações), uma técnica já consolidada. Isso não diminui o valor do resultado, mas muda o que podemos concluir dele: o ponto relevante é que “o modelo consegue executar autonomamente um processo padrão de engenharia de interpretabilidade”, e não que “o modelo adquiriu uma capacidade sobre-humana de ler pesos”.
Etapa 4: Verifique se a configuração da avaliação foi escolhida a dedo
Vale conferir cada detalhe: se o modo de inferência padrão foi alterado, qual foi o limite de tokens, quantas questões podiam ser geradas em cada exercício (nesse experimento, cada chamada podia gerar no máximo 512 questões ou inspecionar as ativações internas de até 1.024 trechos de texto) e se as questões de avaliação foram mantidas isoladas do processo de edição. O texto original informa que as questões de avaliação e os resultados não estavam visíveis para o modelo durante a edição, o que é um ponto positivo. Mas o modo de raciocínio ativado acabou ampliando a tendência do Qwen a entrar em ciclos — e isso também precisa entrar na sua conclusão.
Etapa 5: buscar contraexemplos e limites
O Gemma 3 270M é um dos conjuntos de dados mais valiosos deste estudo. Ele raramente entra em ciclos por conta própria: apenas 8,5% das respostas atingem o limite, contra 93% no Qwen. O mesmo procedimento não trouxe uma melhora conclusiva para o Gemma. A interpretação dos próprios autores é que a edição de pesos pode eliminar obstáculos que encobrem capacidades, mas não pode criar do nada capacidades que o modelo não possui. Quando uma divulgação mostra apenas casos de sucesso e omite os fracassos, sua credibilidade merece ser questionada.
Etapa 6: verificar se houve reprodução independente
O cartão do modelo modificado registra uma execução independente feita por akhaliq, da Hugging Face, usando o ML Intern: foram incluídas as 500 questões do MATH-500, com 2.000 gerações no total, pontuação de 51,0% e 31,6% de respostas atingindo o limite. A reprodução independente ficou basicamente alinhada com o resultado original, o que indica que “a pontuação realmente aumentou” é uma conclusão confiável. A discussão se concentra em “como interpretar essa pontuação”, não em “se ela foi fabricada”.
🎯 Dica prática: depois de ler a divulgação, vale comparar por conta própria o desempenho de alguns modelos no mesmo conjunto de questões. A APIYI apiyi.com oferece acesso via API a modelos como Claude Opus 5.5, Kimi K3.1 Pro e a série Qwen3.8, com suporte aos formatos de interface da OpenAI e da Anthropic. Assim, fica fácil alternar entre modelos no mesmo script para fazer uma validação cruzada. As instruções de integração estão em docs.apiyi.com.
Usando o checklist para comparar as alegações e críticas sobre o Astra
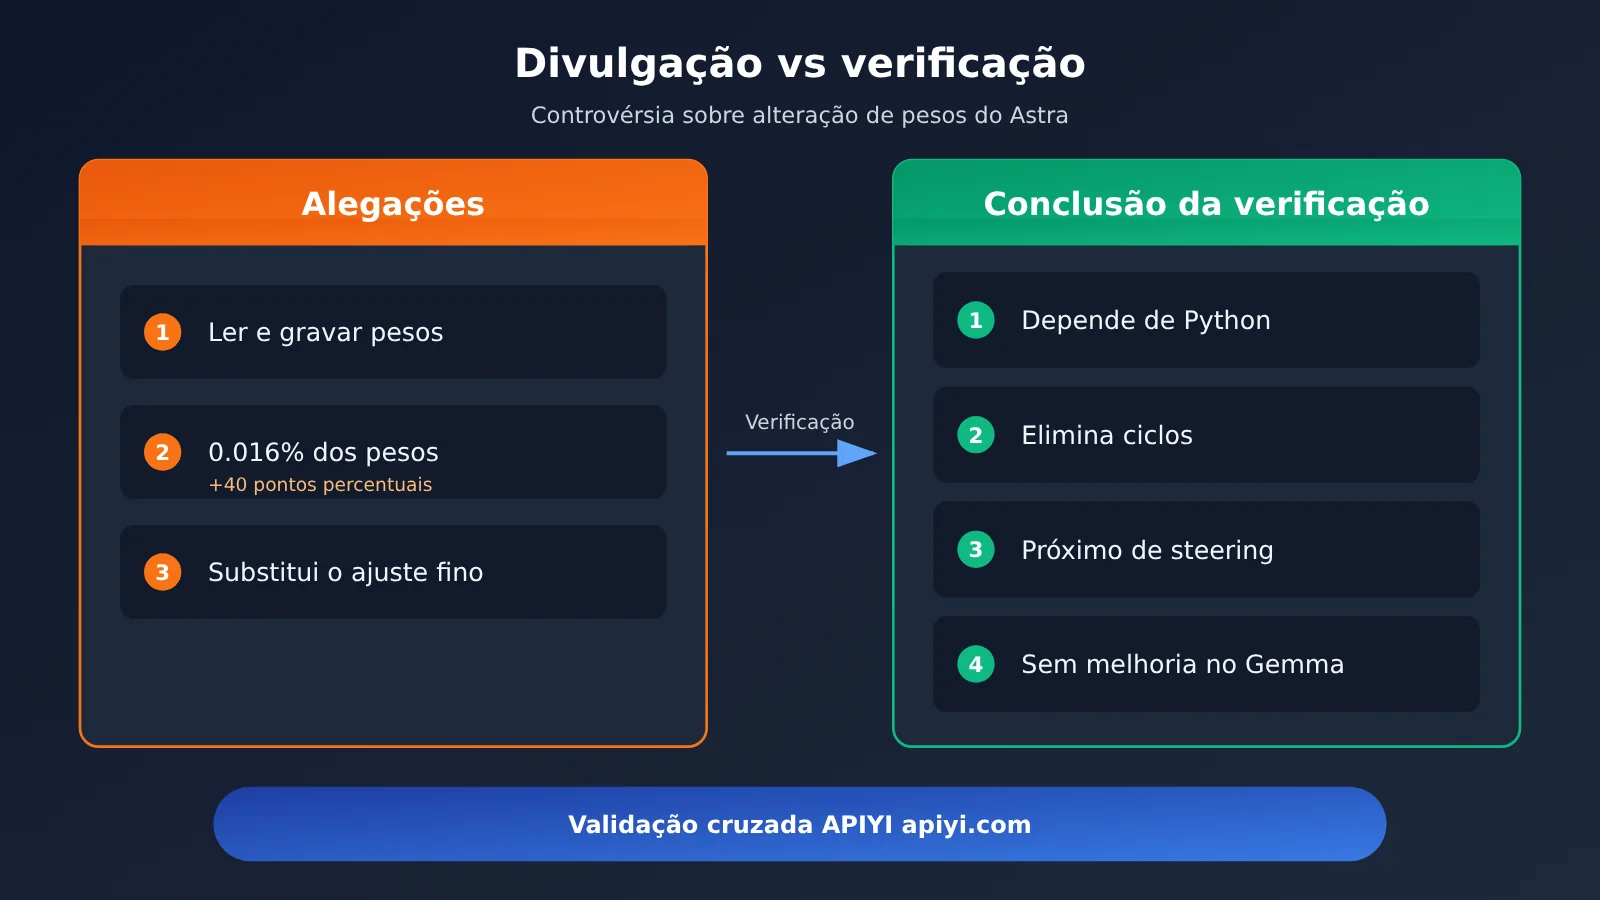
Ao aplicar o checklist de 6 passos a essa controvérsia, chegamos a uma tabela que compara as “alegações de divulgação” com as conclusões da verificação. Você pode usar esse mesmo formato em futuras avaliações técnicas.
| Alegações de divulgação | Dimensão verificada | Conclusões da verificação |
|---|---|---|
| O Astra consegue interpretar os pesos de redes neurais | Permissões de ferramentas | Funciona apenas com texto em redes pequenas; o modelo de 800 milhões de parâmetros depende de análise em Python |
| Alterar 0,016% dos pesos gera uma melhoria de 40 pontos percentuais | Linha de base e modos de falha | A melhoria vem principalmente da redução de loops; a taxa de atingimento do limite caiu de 93,0% para 33,1% |
| Inaugura a programação no espaço de pesos | Novidade do método | A operação central é semelhante às técnicas de steering já existentes |
| Pode substituir parte do ajuste fino | Capacidade de generalização | Não houve melhoria conclusiva no Gemma; o método só consegue remover obstáculos, não adicionar capacidades |
| Os resultados são reais e confiáveis | Reprodução independente | Uma reprodução por terceiros obteve 51,0%, dando credibilidade aos números |
Comparação com concorrentes: como avaliar alegações de capacidades semelhantes
O GPT-6 Astra já chamou atenção várias vezes por seus resultados em benchmarks. Em setembro, a fundação ARC Prize registrou uma pontuação de 62,7% no ARC-AGI-3 usando uma estrutura de avaliação compartilhada. A OpenAI também afirmou que o Astra atingiu seu limite de capacidade de segurança cibernética de nível Critical. A lista de verificação deste artigo também se aplica a esses números: primeiro, pergunte se a estrutura de avaliação é compartilhada ou personalizada; depois, verifique as permissões de ferramentas e o número de execuções.
O Claude Opus 5.5 e o Kimi K3.1 Pro foram colocados lado a lado com o Astra em uma comparação publicada pela R&D World em 23 de outubro. Modelos de diferentes fabricantes podem liderar nas tarefas em que se destacam, mas as divulgações costumam usar as configurações mais favoráveis a cada um. Em comparação, executar seus próprios testes com as mesmas questões e os mesmos parâmetros é mais convincente do que qualquer material promocional.
💡 Dica para escolher: se você quiser comparar esses modelos com tarefas do seu próprio negócio, pode começar com testes em pequena escala pela interface unificada da APIYI, em apiyi.com. Vale esclarecer que o GPT-6 Astra ainda não está disponível na APIYI, mas será disponibilizado o mais rápido possível. Claude Opus 5.5 e Kimi K3.1 Pro já podem ser usados diretamente.
Disponibilidade e preços dos modelos na APIYI
Todos os preços da tabela vêm da página de preços da APIYI, em docs.apiyi.com/models. Consulte a página para verificar as unidades de cobrança; este artigo não usa preços de terceiros.
| Modelo | Nome do modelo na APIYI | Preço de entrada | Preço de saída | Preço de cache | Disponibilidade |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 | $4 | $20 | $0.2 | Disponível na APIYI |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | $2 | $10 | $0.1 | Disponível na APIYI |
| Kimi K3.1 Pro | kimi-k3.1-pro | $2 | $10 | $0.2 | Disponível na APIYI |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Disponível na APIYI |
| Série Qwen3.8 | Série qwen3.8 | Consulte a página de preços | Consulte a página de preços | Consulte a página de preços | Disponível na APIYI |
| GPT-6 Astra | Nenhum | Nenhum | Nenhum | Nenhum | Ainda não disponível na APIYI; será disponibilizado em breve |
| Qwen3.5-0.8B | Nenhum | Nenhum | Nenhum | Nenhum | Ainda não disponível na APIYI; será disponibilizado em breve |
| Gemma 3 270M | Nenhum | Nenhum | Nenhum | Nenhum | Ainda não disponível na APIYI; será disponibilizado em breve |
Qwen3.5-0.8B e Gemma 3 270M são modelos pequenos com pesos abertos. O checkpoint modificado do Qwen usado na pesquisa também está disponível no Hugging Face. Para reproduzir a edição dos pesos, é necessário carregá-los localmente; para comparar as capacidades entre modelos, uma API na nuvem é mais adequada.
Perguntas frequentes FAQ
Q1: O que é a pesquisa em que o Astra modifica os pesos do Qwen?
A equipe do MIT CSAIL testou se o GPT-6 Astra consegue entender e reescrever os pesos de outras redes neurais. No experimento de destaque, o Astra alterou cerca de 0,016% dos pesos do Qwen3.5-0.8B, elevando o resultado no MATH-500 de 7,9% para 48,1%. Os logs e os modelos relacionados foram disponibilizados publicamente.
Q2: Qual é o ponto de divergência entre os críticos e os autores?
A divergência não está na veracidade dos dados, mas na interpretação. Os autores destacam a capacidade do modelo de ler e escrever pesos. Honnibal argumenta que experimentos com diferentes níveis de acesso a ferramentas foram reunidos em uma única conclusão abrangente. Já Goedecke considera que a correção do Qwen faz parte das técnicas de steering já existentes e que o trabalho principal consiste em uma análise em Python que engenheiros humanos também poderiam escrever.
Q3: Quando a pesquisa foi publicada? Houve avanços depois disso?
A pesquisa foi publicada em um blog em 2 de novembro de 2026. Em um dia, surgiram críticas públicas e uma longa discussão no Hacker News. Os autores afirmam estar criando um benchmark e uma estrutura de avaliação para medir essa capacidade. Vale acompanhar os próximos dados.
Q4: Em quais situações o checklist de verificação em 6 etapas é útil?
– **Escolha de tecnologia**: analisar os resultados e as alegações promocionais dos fornecedores antes de contratar ou integrar um modelo
– **Leitura de pesquisas**: avaliar rapidamente o peso real dos números destacados em um artigo
– **Apresentações internas**: explicar uma suposta “descoberta” à equipe, deixando claros os limites da conclusão
– **Produção de conteúdo**: evitar tirar conclusões com base em um único número ao escrever avaliações de modelos
Q5: Como verificar por conta própria as alegações sobre a capacidade de um modelo usando uma API?
A maneira mais direta é preparar um conjunto de questões próximas à realidade do seu negócio, fixar o modo de inferência e o tamanho das respostas e executar os mesmos testes em vários modelos. Com a APIYI, em apiyi.com, você pode invocar modelos como Claude Opus 5.5, Kimi K3.1 Pro e a série Qwen3.8 por uma interface unificada, compatível com os formatos da OpenAI e da Anthropic. As instruções de integração estão em docs.apiyi.com, e os preços podem ser consultados em docs.apiyi.com/models.
Q6: Quais são as limitações conhecidas da pesquisa?
Primeiro, os experimentos com Modelos de Linguagem Grande dependem de ferramentas Python e de várias rodadas de prática: não se trata simplesmente de “entender” os pesos. Segundo, a melhora veio principalmente da redução de loops e depende da ativação do modo de raciocínio. Terceiro, não houve uma melhora conclusiva no Gemma, o que indica que não é possível adicionar capacidades do nada. Quarto, aplicações como o autoaprimoramento ainda são hipóteses dos autores e não foram comprovadas.
Q7: Os riscos de colaboração entre agentes mencionados na pesquisa têm relação com o Astra?
O incidente no Hugging Face divulgado pela OpenAI em 26 de agosto foi conduzido principalmente pelo IM1, um modelo interno de pesquisa. A OpenAI excluiu explicitamente o Astra desse incidente. Por enquanto, a combinação de “colaboração entre múltiplos agentes + edição de pesos” é apenas uma hipótese e não foi demonstrada por esta pesquisa.
Pontos essenciais para analisar alegações sobre a capacidade dos modelos
- Comece pela linha de base: a pontuação inicial do Qwen era baixa principalmente porque 93% das respostas atingiam o limite de tokens; a maior parte do ganho veio da correção de loops
- Pergunte sobre as ferramentas: ler pesos em texto simples só funciona em redes pequenas; os experimentos com Modelos de Linguagem Grande dependem de um ambiente Python
- Compare com técnicas anteriores: a correção do Qwen se aproxima de steering; seu valor está em concluir o processo de engenharia de forma autônoma
- Examine a configuração da avaliação: modo de raciocínio, limite de tokens e lotes de prática influenciam a pontuação final
- Busque contraexemplos: o Gemma não apresentou melhora conclusiva, o que indica que a edição só remove obstáculos, sem adicionar capacidades
- Reconheça a reprodução independente: uma nova execução por terceiros alcançou 51,0%; o número é confiável, mas sua interpretação exige cautela
- Teste por conta própria: use a interface unificada da APIYI apiyi.com para comparar modelos com seus próprios problemas
Conclusão
A controvérsia sobre a modificação dos pesos do Qwen pelo Astra nos ensina algo mais importante do que dizer se um modelo é forte ou fraco: até um resultado real e reproduzível pode ser apresentado com conclusões que vão além das evidências. Os pontos essenciais para analisar alegações sobre a capacidade dos modelos são:
- Associe os números aos modos de falha: sem a linha de base e a taxa de respostas que atingem o limite, 48,1% por si só não diz muita coisa
- Associe as conclusões às condições: acesso a ferramentas, modo de raciocínio e número de tentativas de prática definem os limites das conclusões
- Associe o sucesso a contraexemplos e reproduções: o contraexemplo do Gemma e a nova execução por terceiros, juntos, ajudam a delimitar o verdadeiro significado do resultado
Da próxima vez que vir uma manchete dizendo que “um modelo alcançou um avanço”, vale passar por essas 6 perguntas e fazer um teste com seus próprios dados. Recomendamos comparar vários modelos pela mesma interface na APIYI apiyi.com. A documentação está em docs.apiyi.com, e os preços podem ser consultados em docs.apiyi.com/models.
📚 Referências
- Reportagem do 36氪: Aclamado trabalho do MIT é duramente criticado: Astra modificou os pesos do Qwen? Conta outra
- Link:
36kr.com/p/4056481264866438 -
Descrição: cobertura da controvérsia pela mídia chinesa
-
Blog original da pesquisa: Sparks of Weight-Space Programming
- Link:
rikiyat.github.io/blog/weight-space-programming -
Descrição: descrição original dos experimentos pela equipe do MIT CSAIL
-
Repositório de logs dos experimentos: lm_understand-logs
- Link:
github.com/RikiyaT/lm_understand-logs -
Descrição: contém o README do experimento com Qwen e os logs completos de cada experimento
-
Artigo crítico de Matthew Honnibal
- Link:
honnibal.dev/blog/astra-read-write-misleading -
Descrição: analisa a divulgação da pesquisa sob a perspectiva das permissões das ferramentas
-
Artigo crítico de Sean Goedecke
- Link:
seangoedecke.com/llms-are-not-superhuman-at-reading-and-writing-neural-network-weights -
Descrição: compara a correção do Qwen com técnicas de steering
-
Ficha do modelo Qwen modificado
- Link:
huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming - Descrição: inclui resultados de uma reprodução independente por terceiros
Autor: Equipe técnica da APIYI
Contato técnico: Fale com a gente pela página inicial da APIYI em apiyi.com. Para mais informações sobre integração, acesse a documentação em docs.apiyi.com.