Em 9 de novembro de 2026, a Anthropic anunciou em seu blog oficial de engenharia um experimento com múltiplos agentes: 1.000 agentes Claude Fable 5.2 colaboraram para formalizar computacionalmente o Último Teorema de Fermat em 28,7 horas, e a prova final passou pela verificação do núcleo oficial do Lean. Dois meses antes, o primeiro experimento de formalização havia sido concluído por dezenas de agentes e levou 11 dias.
Isso não significa que a “IA provou o Último Teorema de Fermat em 30 horas”. O teorema já havia sido provado nos anos 1990 por Andrew Wiles e Richard Taylor. O que esse experimento fez foi traduzir uma linha de prova já existente para uma prova formal que um computador pudesse verificar passo a passo. Portanto, a pergunta que este artigo busca responder é: como 1.000 agentes de IA colaboraram para concluir um projeto tão complexo em menos de 30 horas?
O que você vai encontrar neste artigo: os principais dados do experimento de formalização do Último Teorema de Fermat, como os 1.000 agentes foram organizados e como funcionou o mecanismo de verificação, além do que o experimento pode ensinar sobre sistemas corporativos de agentes — e quais são seus limites.
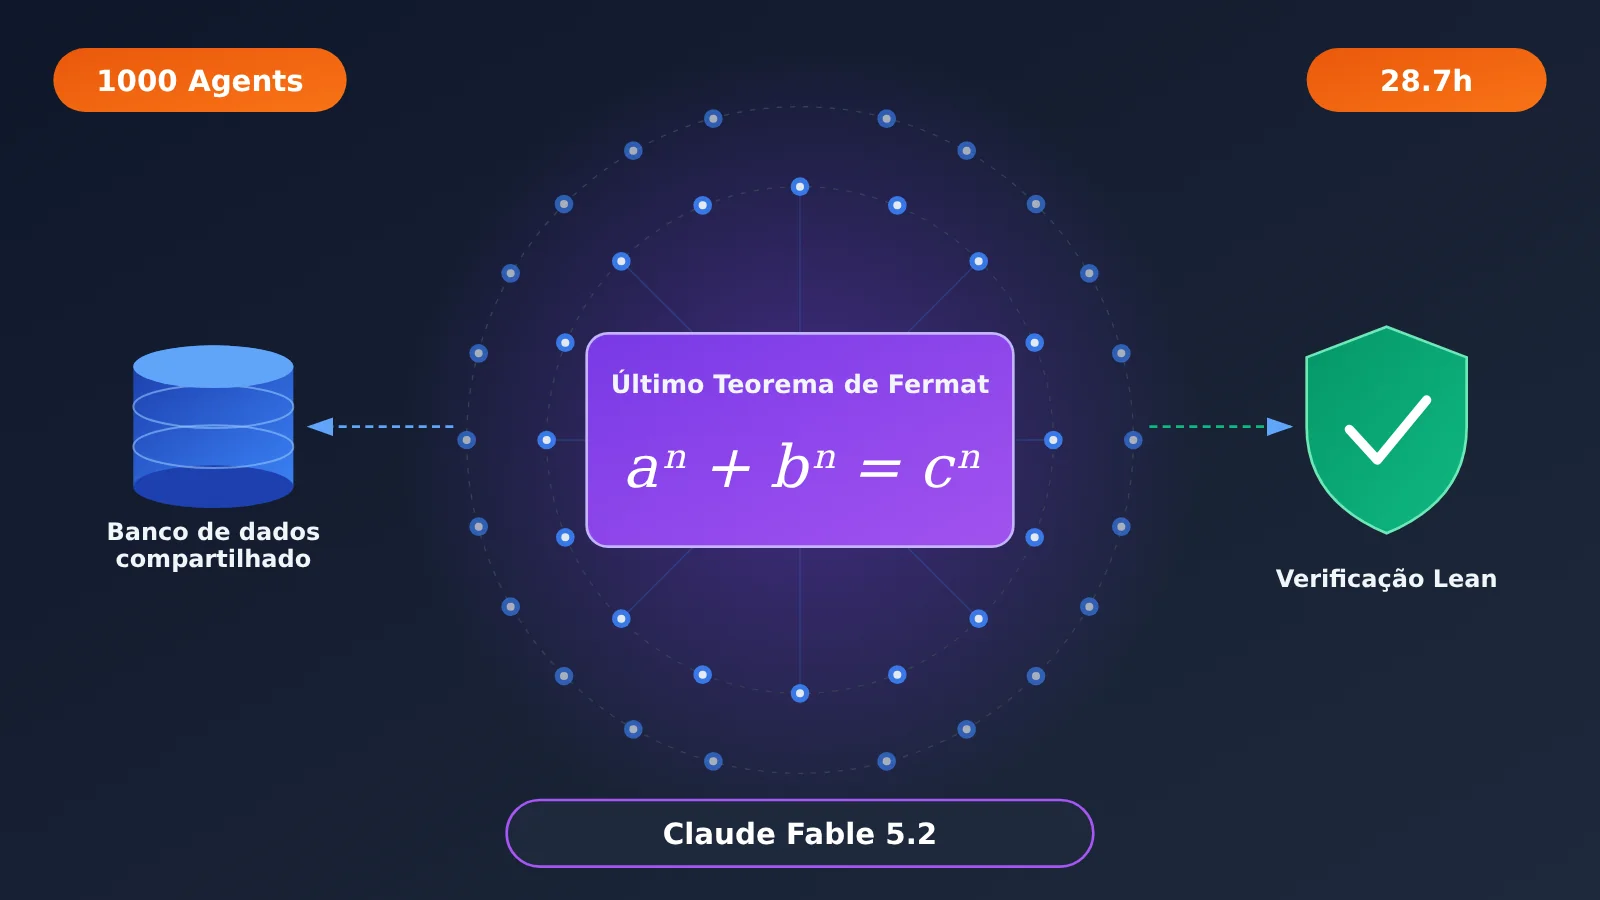
Visão geral das informações essenciais sobre o experimento de formalização do Último Teorema de Fermat
Veja primeiro uma tabela com os fatos básicos do experimento com o Claude Fable 5.2. Vale prestar atenção a alguns detalhes que podem gerar confusão: o modelo era uma versão inicial, o experimento tinha entradas predefinidas e a própria Anthropic o classificou como um toy experiment (uma demonstração experimental).
| Item | Detalhes |
|---|---|
| Data de publicação | 9 de novembro de 2026, no blog oficial de engenharia da Anthropic |
| Modelo usado | Uma versão inicial do Claude Fable 5.2 (ainda sem a avaliação de alinhamento anterior ao lançamento oficial) |
| Tamanho da equipe | 1 agente líder + 999 agentes auxiliares |
| Tempo para concluir | 28,7 horas; o teorema final passou pela verificação do núcleo oficial do Lean (o anúncio oficial arredondou para 30 horas) |
| Entradas predefinidas | 60 proposições, um resumo em uma frase da abordagem clássica da prova, definições relacionadas e 47 lemas já demonstrados na formalização anterior |
| Ambiente de ferramentas | Toolchain do Lean, Mathlib, Git, banco de dados PostgreSQL compartilhado e sandboxes independentes em máquinas virtuais |
| Classificação oficial | Toy experiment, não a primeira prova do Último Teorema de Fermat |
Formalização do Último Teorema de Fermat: é importante deixar claras as premissas do experimento
Os pesquisadores não se limitaram a dizer “prove o Último Teorema de Fermat” e deixar o sistema por conta própria. Os agentes receberam 60 proposições (incluindo o teorema final e 59 marcos intermediários), um resumo da abordagem, as definições e 47 lemas que já tinham sido demonstrados no experimento anterior. Além disso, os papéis do agente líder e dos auxiliares foram definidos previamente pelos pesquisadores.
Por isso, o experimento avaliou outro tipo de capacidade: dadas as bases matemáticas e as ferramentas, uma equipe numerosa de agentes consegue se organizar e transformar uma abordagem conhecida em uma prova completa, verificável por máquina? Essa questão está mais próxima de um problema de engenharia do que de “será que a IA consegue fazer matemática?”.
Por que é tão difícil formalizar o Último Teorema de Fermat
O enunciado do Último Teorema de Fermat é simples: para qualquer inteiro (n > 2), não existem inteiros positivos (a), (b) e (c) que satisfaçam (a^n + b^n = c^n). Pierre de Fermat propôs o teorema no século XVII, e ele permaneceu sem solução por mais de 350 anos. Wiles anunciou uma prova em 1993 e, em 1994, corrigiu uma falha importante junto com Taylor. A prova foi publicada oficialmente em 1995. O texto original tem cerca de 129 páginas e se apoia bastante em resultados já conhecidos de teoria dos números moderna e geometria algébrica.
Ao escrever uma prova, um matemático pode dizer “isso decorre claramente do resultado anterior”, e o leitor completa os passos que ficaram implícitos. O computador não tem esse tipo de entendimento compartilhado: precisa saber qual definição, teorema ou regra de inferência foi usado em cada etapa. Essa é a raiz da dificuldade de formalizar uma prova: algo que parece “óbvio” para uma pessoa pode exigir centenas ou milhares de linhas de código.
Lean, Mathlib e formalização matemática
Para entender esse experimento, primeiro é preciso distinguir três conceitos:
- Lean: um assistente interativo de provas que verifica se uma demonstração segue rigorosamente as regras da lógica formal.
- Mathlib: a biblioteca matemática do Lean, que reúne muitas definições e teoremas já formalizados — como uma “biblioteca padrão” que pode ser consultada diretamente.
- Formalização matemática: a conversão de uma prova matemática escrita para pessoas em uma estrutura lógica que um computador consegue verificar por completo.
O ponto mais importante é: a IA constrói a prova, e o núcleo do Lean verifica se ela está correta. O modelo dizer “provei” e o Lean aceitar a demonstração são coisas bem diferentes. Este experimento merece ser levado a sério justamente porque o resultado final não depende da avaliação do próprio modelo: ele foi aprovado por uma verificação independente feita por máquina.
Como 1000 agentes de IA colaboram: um sistema de gerenciamento de projetos operado por IA
Esta é a parte mais interessante de estudar no experimento Claude Fable 5.2. Os 1000 agentes não trabalham isoladamente para resolver problemas: eles formam um sistema de colaboração com gerenciamento de tarefas, alocação de recursos e ajustes dinâmicos.
Estrutura organizacional da equipe Claude Fable 5.2
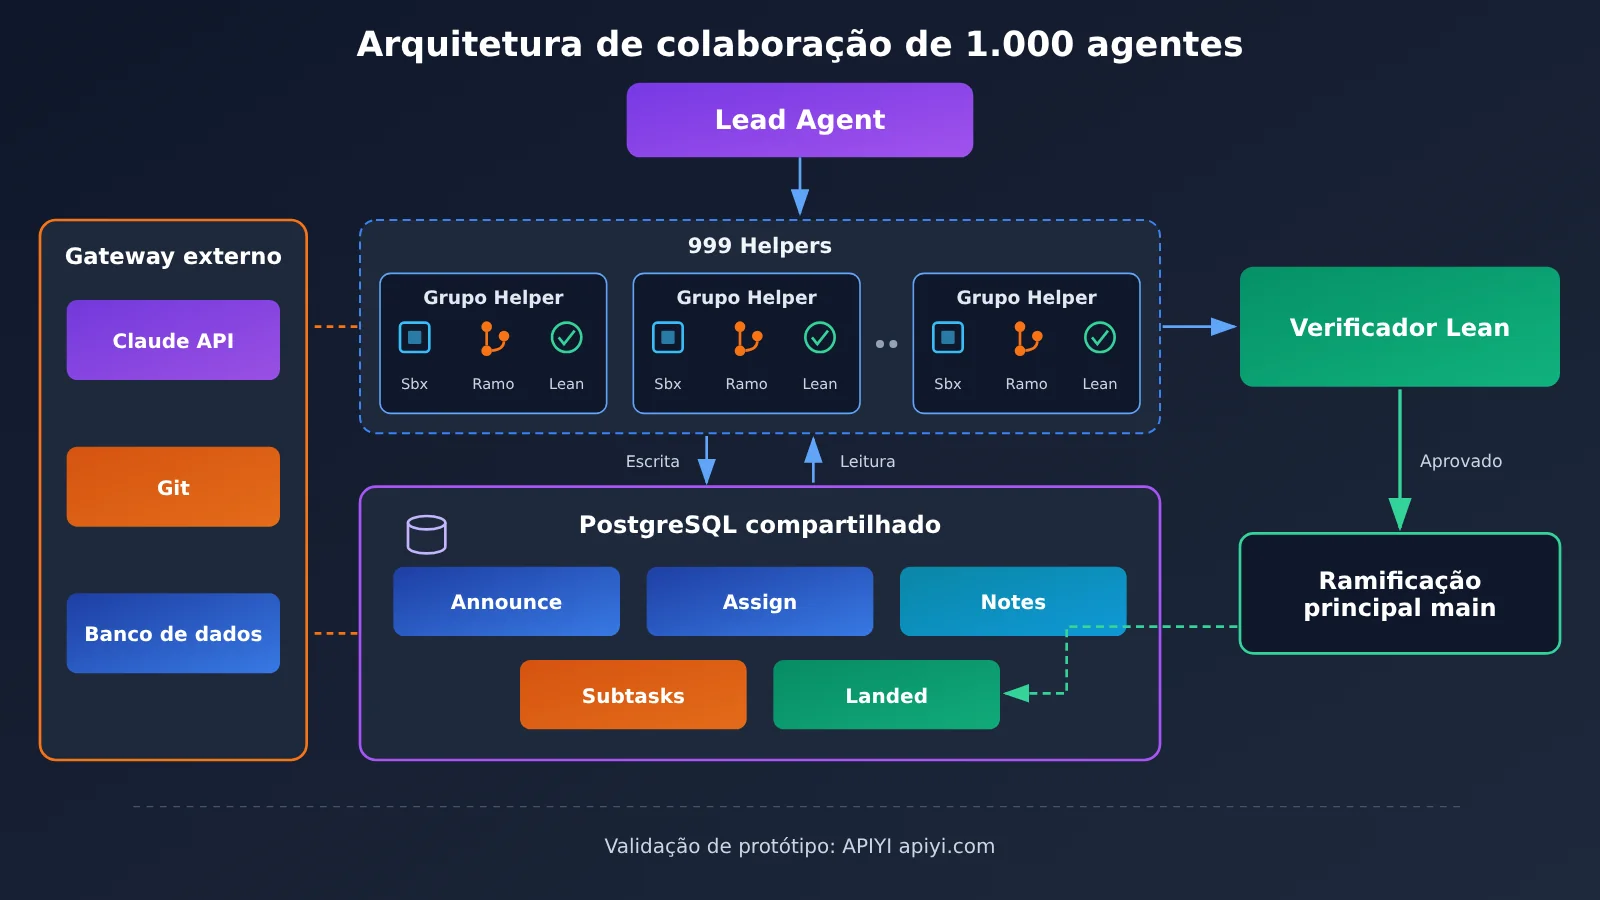
A equipe adota uma hierarquia simples: 1 Lead Agent cuida do planejamento geral, da divisão das tarefas e do acompanhamento do progresso; os 999 Helper Agents ficam responsáveis por provas específicas. Cada agente tem seu próprio sandbox leve de máquina virtual, pode usar o Shell, um editor de arquivos, a cadeia de ferramentas Lean e a Mathlib, e conta com uma ramificação Git própria, da qual pode enviar Merge Requests para a ramificação principal.
Nenhum agente tem acesso direto à internet. Toda comunicação com a Claude API, o Git e o banco de dados passa por um Gateway externo. Com sandboxes e ramificações independentes, os 1000 agentes podem editar o código ao mesmo tempo sem sobrescrever os arquivos uns dos outros.
PostgreSQL compartilhado: o centro de colaboração dos AI Agents
Se 1.000 Agents colaborarem trocando mensagens entre si, o volume de comunicação ficará rapidamente fora de controle. A abordagem do Lead Agent é criar cinco tabelas compartilhadas no banco de dados nos primeiros 10 minutos do experimento e transformar a comunicação em “ler e escrever no mesmo quadro”.
| Nome da tabela | Função | Papel na colaboração |
|---|---|---|
| Announce | Publicar instruções para a equipe | Comunicado para todos, como um mural de avisos do projeto |
| Assign | Distribuir tarefas e designar responsáveis | Deixa claro “quem está fazendo o quê” e evita trabalho duplicado |
| Notes | Registrar o progresso, os problemas e os planos de trabalho | Compartilha o contexto e reduz o isolamento das informações |
| Subtasks | Gerenciar tarefas menores para que os Agents possam assumi-las | Pool de tarefas que permite a atribuição autônoma |
| Landed | Registrar trabalhos concluídos e aprovados na revisão | Lista confiável de resultados, que inclui apenas conteúdo verificado |
O valor desse mecanismo está em evitar que cada Agent precise entrar em contato com os outros 999. Basta consultar o banco de dados para saber quais tarefas existem, quais já foram concluídas e quais têm dependências. Os resultados são incorporados à branch principal por meio de merges no Git. Segundo os dados divulgados oficialmente, durante todo o processo foram feitas cerca de 36.612 gravações e 311.734 leituras no banco de dados. Aproximadamente 20.600 gravações foram em Notes e 14.800 em Subtasks (as estatísticas não incluem a maioria das chamadas de scripts). O número de leituras muito superior ao de gravações também mostra que os Agents passam a maior parte do tempo “consultando o estado geral”.
Alocação dinâmica de tarefas: da distribuição fixa à iniciativa de assumir tarefas
O processo de escalonamento deste experimento não ficou parado no mesmo formato. A linha do tempo abaixo mostra como a organização foi evoluindo:
| Momento | Evento principal |
|---|---|
| 10º minuto | Lead cria cinco tabelas em um banco de dados compartilhado |
| Por volta do 27º minuto | 3 proposições já foram provadas |
| Em seguida | Lead deixa temporariamente de lado 47 proposições consideradas difíceis de concluir dentro do orçamento e concentra os recursos em outras 10 |
| Por volta do 70º minuto | As 10 proposições são concluídas, e Lead redistribui os Agents para trabalhar em proposições mais difíceis |
| Por volta da 3ª hora | Lead permite que os Agents ociosos assumam tarefas por conta própria, sem esperar por uma atribuição |
| 5,6 horas | 73 Helpers já criaram 756 tarefas |
| Por volta da 18ª hora | A execução é retomada a partir do último estado salvo e continua por mais 12 horas |
| 28,4 horas | Proposições relacionadas a Langlands–Tunnell são concluídas |
| 28,7 horas | O último teorema de Fermat é concluído e aprovado na verificação oficial do kernel |
Dois detalhes merecem atenção. Primeiro, a mudança da distribuição de tarefas por Lead para a iniciativa dos próprios Agents equivale à transição de uma equipe com escalonamento centralizado para um modelo de fila de tarefas, reduzindo o risco de Lead se tornar um gargalo. Segundo, o experimento foi retomado a partir de um estado salvo por volta da 18ª hora. Portanto, as 28,7 horas não significam que todos os Agents trabalharam sem interrupção do início ao fim.
Além disso, as 47 proposições deixadas temporariamente de lado não são as mesmas 47 lemas da entrada predefinida. Ao consultar o material oficial, não confunda as duas coisas.
Langlands–Tunnell: 750 agentes concentrados no maior desafio da formalização do Último Teorema de Fermat
Perto da reta final, a equipe encontrou o trecho mais difícil: uma proposição relacionada a Langlands–Tunnell, um resultado matemático importante na estratégia de demonstração de Wiles. No início, os agentes responsáveis por essa parte estimaram que ela poderia exigir de 700 mil a 1 milhão de linhas de código Lean e consideraram que a chance de concluí-la no tempo restante era inferior a 1%.
Em seguida, o agente líder concentrou cerca de 750 agentes auxiliares nessa tarefa. Os próprios agentes criaram uma árvore de tarefas com vários níveis:
- divisão em 10 áreas principais;
- criação de 2.418 subtarefas;
- árvore de tarefas com até 10 níveis;
- centenas de agentes trabalhando simultaneamente em subtarefas diferentes.
Langlands–Tunnell foi concluído na 28,4ª hora; 0,3 hora depois, o Último Teorema de Fermat também foi concluído. O caso mostra que o valor do paralelismo em grande escala não está apenas em “mais gente calculando mais rápido”. O mais importante é decompor um problema grande demais para ser atacado diretamente em muitas tarefas pequenas, que possam avançar de forma independente, ser verificadas separadamente e, por fim, ser integradas. Sem uma boa decomposição, os 750 agentes só ficariam esperando uns pelos outros ou repetindo trabalho.
Por que a formalização do Último Teorema de Fermat deu certo: verificação do Lean e mecanismos de segurança
Do ponto de vista da confiabilidade de engenharia, o experimento se apoiou em três camadas de proteção.
A primeira camada é a verificação dos resultados. Cada proposição secundária precisava passar pela verificação do Lean antes de ser enviada à branch principal. A tabela Landed registrava apenas o trabalho aprovado. A demonstração final foi verificada pelo verificador oficial do kernel. O agente líder registrou: “Fermat’s Last Theorem is on main, kernel-checked by the official checker.”
A segunda camada é o isolamento da colaboração. Sandboxes e branches do Git independentes reduziram bastante os conflitos entre arquivos e as interferências entre agentes.
A terceira camada são os limites de segurança. O experimento usou um modelo inicial que ainda não havia passado pela avaliação de alinhamento anterior ao lançamento oficial. Por isso, a Anthropic estabeleceu várias restrições:
- acesso à internet proibido, assim como o acesso direto às sandboxes de outros agentes;
- comandos executados com contas sem privilégios;
- comunicação com APIs, Git e bancos de dados gerenciada por um gateway externo;
- classificador em tempo real para verificar comandos do Shell e alterações em arquivos, além de um monitor offline para revisar os registros das operações.
O experimento gerou mais de 1 milhão de chamadas de ferramentas, e nenhuma chegou a um nível que exigisse bloqueio. A Anthropic também informou que, depois do experimento, adicionou um monitoramento paralelo da cadeia de pensamento. A conclusão é que, para avaliar um sistema de agentes confiável, não basta saber se o modelo consegue concluir a tarefa: também são necessários verificação independente, limites de permissão e um ambiente de execução rastreável.
De 11 dias a 28,7 horas: comparação entre dois experimentos com Claude Fable 5.2
Os dois experimentos de formalização do Último Teorema de Fermat usaram critérios diferentes e precisam ser analisados separadamente:
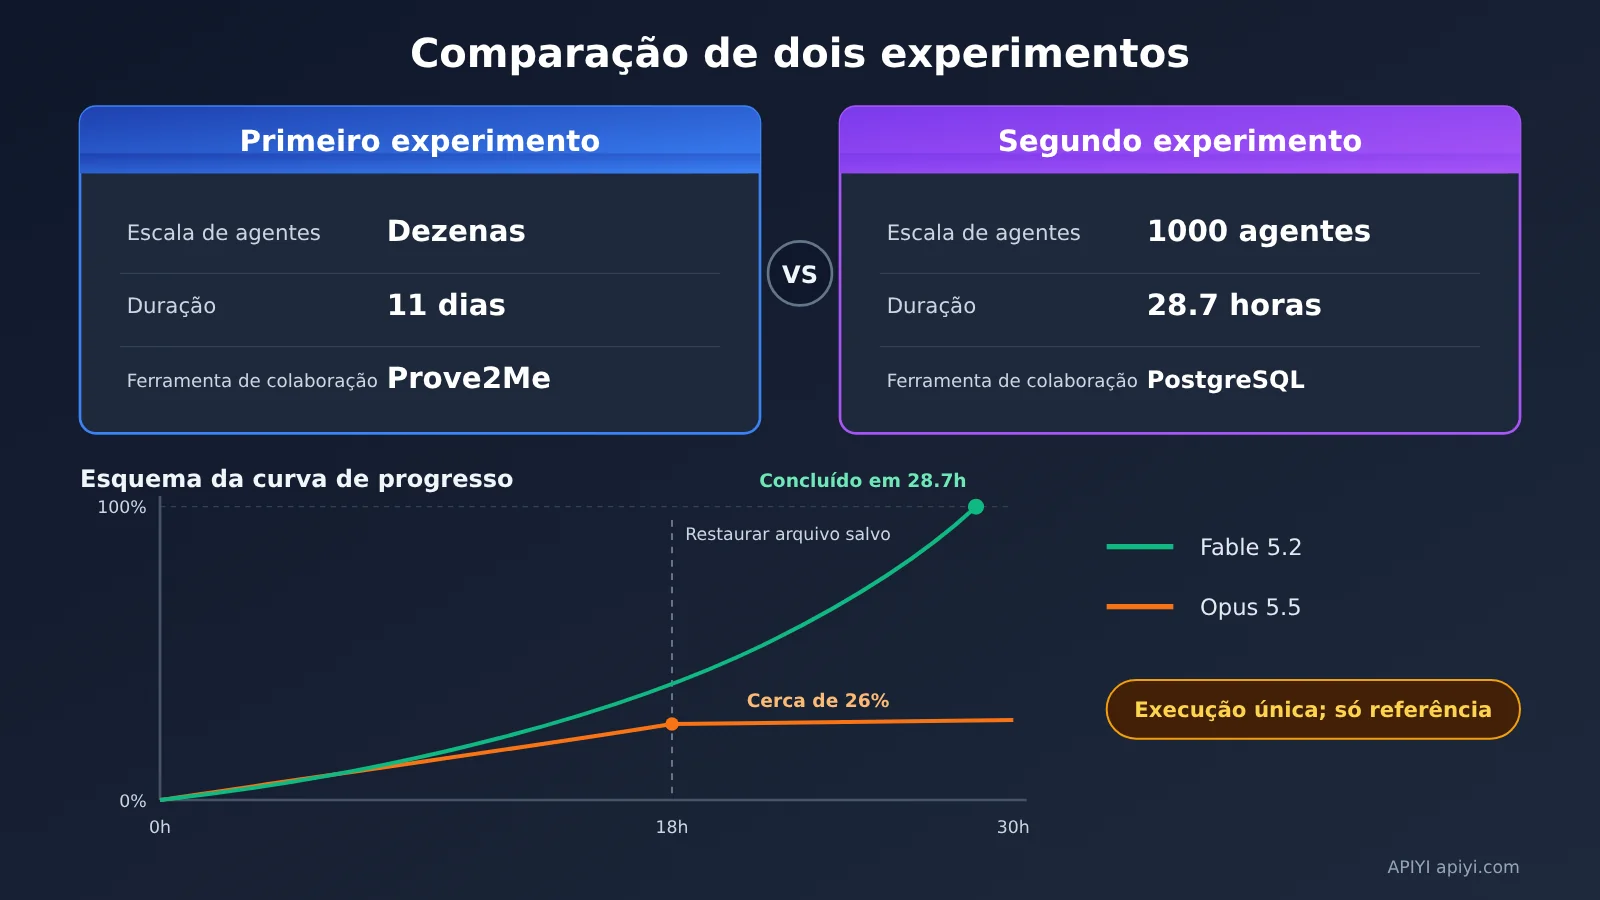
| Métrica | Primeiro experimento (anunciado em setembro de 2026) | Segundo experimento (anunciado em 9 de novembro de 2026) |
|---|---|---|
| Modelo | Modelo de pesquisa interno (aproximadamente no nível do Fable 5.1) | Versão inicial do Fable 5.2 |
| Número de agentes | Dezenas | 1000 |
| Tempo de execução | 11 dias | 28,7 horas |
| Tokens de saída | Cerca de 6 bilhões | Segundo a empresa, cerca de um terço do total do primeiro experimento |
| Tamanho da prova | Referência (cerca de 13 milhões de linhas de código Lean) | Cerca de 1/7 do tamanho da primeira |
| Plataforma de colaboração | Prove2Me + Claude Code Multi-Agent Harness | Ferramentas genéricas + PostgreSQL |
| Orientação humana | O pesquisador Tianyi Peng deu algumas orientações gerais | Sem orientação contínua sobre o processo matemático |
Vale destacar que os números de 6 bilhões de tokens, 13 milhões de linhas de código e cerca de 30.300 teoremas se referem todos ao primeiro experimento. A empresa não divulgou o número absoluto de tokens, o custo total nem a contagem exata de linhas de código do segundo experimento.
O primeiro experimento também teve alguns tropeços no início: os agentes tinham dificuldade para acompanhar o estado geral, não sabiam o que os outros já haviam concluído e acabavam repetindo trabalho. Depois, a plataforma Prove2Me foi introduzida para gerenciar as dependências entre teoremas em um DAG, além de oferecer acompanhamento do status das tarefas, busca de teoremas e aceleração da compilação. A mudança no segundo experimento foi deixar de usar essa plataforma especializada e permitir que os agentes criassem seu próprio mecanismo de colaboração com ferramentas genéricas, um banco de dados e Git. Cinco tabelas cumpriam funções semelhantes.
A Anthropic também fez um teste comparativo com a mesma configuração de 1000 agentes: o Opus 5.5 concluiu cerca de 26% em 18 horas e, até completar 30 horas, quase não avançou. Já o Fable 5.2 concluiu o teorema final em 28,7 horas. Os dois grupos retomaram a execução a partir do estado salvo por volta da marca de 18 horas. Mas cada modelo foi testado apenas uma vez, então não dá para concluir que exista uma diferença geral entre eles em todos os tipos de tarefas complexas.
Análise do impacto de 1.000 experimentos com agentes de IA nas empresas
Para desenvolvedores: quatro capacidades essenciais de sistemas multiagentes
Deixando de lado o contexto matemático, as capacidades identificadas neste experimento se relacionam a cenários comuns nas empresas:
| Capacidade | Como aparece no experimento | Aplicação em empresas |
|---|---|---|
| Decomposição de tarefas complexas | 2.418 subtarefas e uma árvore de tarefas com até 10 níveis | Grandes refatorações de código, relatórios de pesquisa complexos |
| Alocação dinâmica de recursos | Adiar problemas difíceis e reunir 750 Helpers para resolvê-los | Redistribuir Agents e capacidade computacional conforme as prioridades |
| Gerenciamento de estado compartilhado | Cinco tabelas PostgreSQL + mesclagem com Git | Painel unificado de tarefas para reduzir trabalho duplicado |
| Verificação independente dos resultados | O kernel do Lean verifica cada submissão | Testes unitários, validação de dados, revisão humana |
A principal lição para desenvolvedores é que não é preciso começar montando uma plataforma especializada e complexa. Um banco de dados compartilhado bem projetado, combinado com controle de versão, já dá conta de uma colaboração em escala considerável. Veja um exemplo mínimo de invocação do modelo:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI
)

response = client.chat.completions.create(
    model="claude-fable-5-2",  # Confira a lista de modelos disponíveis na plataforma
    messages=[{"role": "user", "content": "把这个任务拆成可独立验证的子任务"}]
)
print(response.choices[0].message.content)
Ver um exemplo de código do pool de tarefas Lead / Helper
import sqlite3
import openai

# Use o SQLite local para simular as tabelas Subtasks / Landed do experimento (que usou PostgreSQL)
db = sqlite3.connect("board.db")
db.execute("CREATE TABLE IF NOT EXISTS subtasks (id INTEGER PRIMARY KEY, goal TEXT, status TEXT, owner TEXT)")
db.execute("CREATE TABLE IF NOT EXISTS landed (task_id INTEGER, result TEXT)")

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def lead_plan(goal: str):
    """Lead: decompõe a tarefa e a registra no pool de tarefas"""
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": f"将目标拆为3-5个子任务,每行一个:{goal}"}]
    )
    for line in resp.choices[0].message.content.splitlines():
        if line.strip():
            db.execute("INSERT INTO subtasks (goal, status) VALUES (?, 'open')", (line.strip(),))
    db.commit()

def verify(result: str) -> bool:
    """Verificador independente: em um cenário real, substitua por testes, scripts de validação ou verificações do Lean"""
    return len(result) > 0

def helper_claim(name: str):
    """Helper: assume uma tarefa e só registra o resultado em landed se ele passar pela verificação"""
    row = db.execute("SELECT id, goal FROM subtasks WHERE status='open' LIMIT 1").fetchone()
    if not row:
        return
    task_id, goal = row
    db.execute("UPDATE subtasks SET status='doing', owner=? WHERE id=?", (name, task_id))
    db.commit()
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": goal}]
    )
    result = resp.choices[0].message.content
    if verify(result):
        db.execute("INSERT INTO landed VALUES (?, ?)", (task_id, result))
        db.execute("UPDATE subtasks SET status='done' WHERE id=?", (task_id,))
    else:
        db.execute("UPDATE subtasks SET status='open', owner=NULL WHERE id=?", (task_id,))
    db.commit()

lead_plan("为一个开源库补全单元测试")
for i in range(3):
    helper_claim(f"helper-{i}")
🚀 Dica para começar: para reproduzir um protótipo em pequena escala com “decomposição pelo Lead + tarefas assumidas por Helpers + verificação independente”, você pode começar usando a APIYI em apiyi.com e obter créditos de teste gratuitos. A plataforma oferece uma interface compatível com OpenAI. Com uma única chave, você pode alternar entre modelos como Claude, GPT e Gemini, facilitando a comparação da qualidade da decomposição feita por diferentes modelos no papel de Lead.
Para o setor: os limites importam mais do que os números
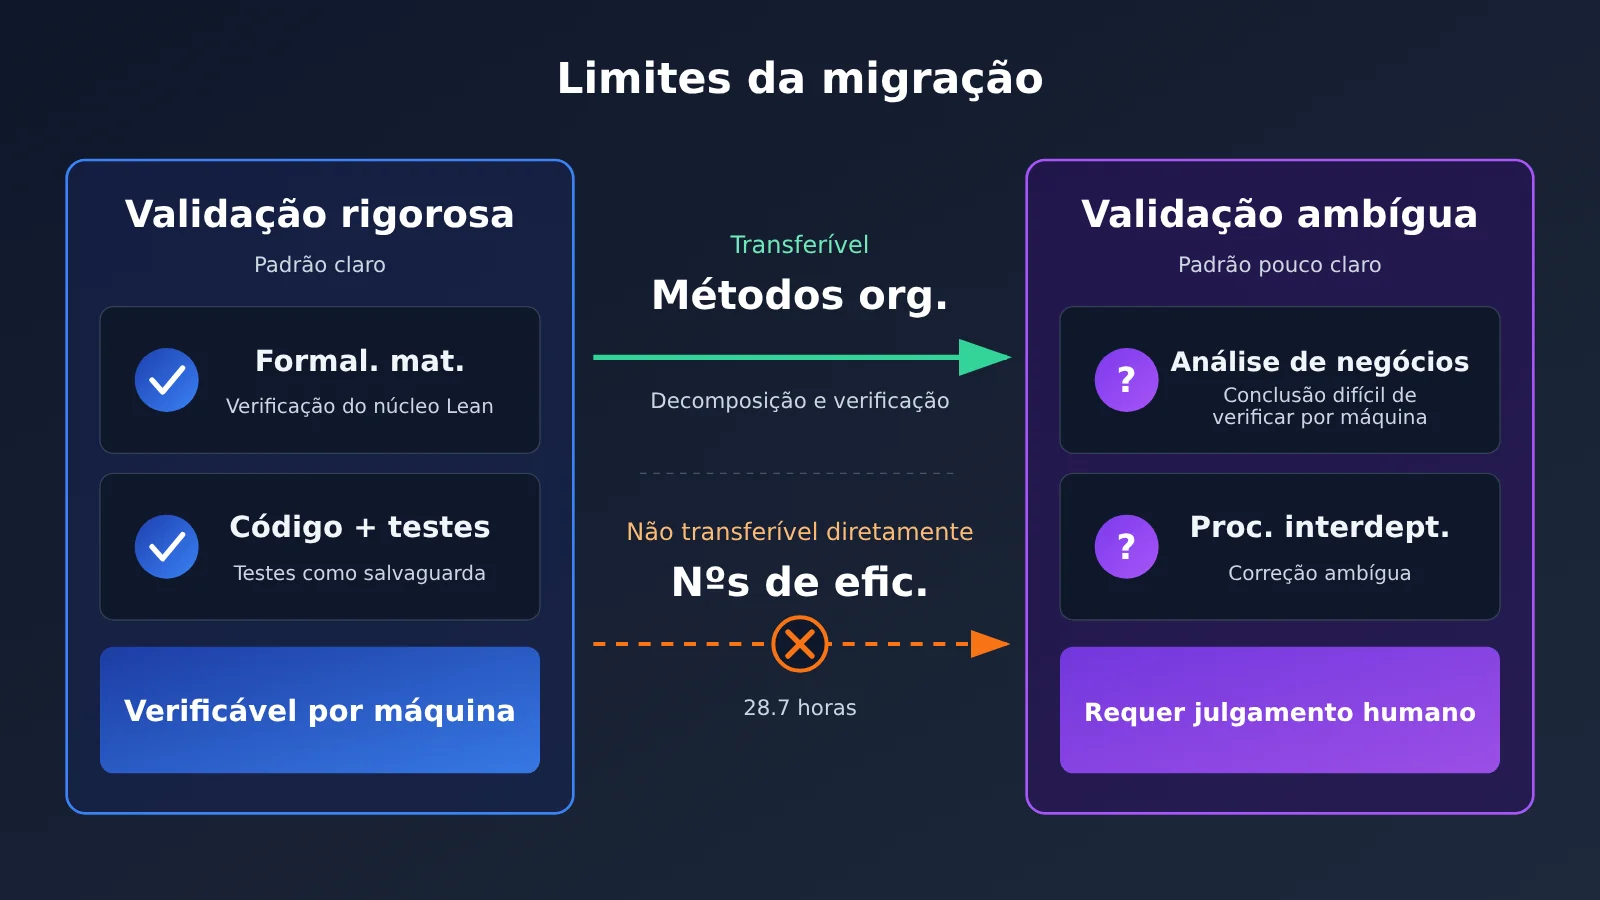
Um ponto que merece uma análise cuidadosa: a formalização matemática conta com verificadores rigorosos e objetivos, como o Lean, enquanto a maioria das tarefas empresariais não tem critérios de correção tão claros. Os testes podem servir de garantia para o código, mas é difícil determinar automaticamente o que é “correto” em uma análise de mercado ou em um processo que envolve vários departamentos. Por isso, os 28,7 horas e a taxa de sucesso deste experimento não podem ser aplicados diretamente a sistemas de Agent empresariais.
A própria Anthropic também apontou algumas limitações: os Agents podem concluir cedo demais que uma tarefa é impossível — a maioria das 47 proposições deixadas de lado no início acabou sendo concluída; a orientação humana continua sendo valiosa em etapas difíceis; e ferramentas especializadas, como o Prove2Me, ainda podem aumentar a eficiência de compilação, recuperação de informações e colaboração. O experimento não mostra que quanto mais Agents, melhor, nem que especialistas humanos e Harnesses especializados já não são necessários.
💡 Recomendação de engenharia: ao testar uma solução com vários Agents em uma empresa, comece por tarefas com critérios de validação claros, como refatorações de código guiadas por testes, e amplie o escopo aos poucos. Com a cobrança por uso da APIYI (apiyi.com), você pode começar com um número pequeno de Agents para avaliar as etapas de decomposição e validação antes de decidir se vale a pena investir mais.
Perguntas frequentes (FAQ)
Q1: Este experimento provou o Último Teorema de Fermat com IA?
Não. O Último Teorema de Fermat foi formalmente provado por Wiles em 1995, com a colaboração de Taylor para corrigir um problema importante. Neste experimento, partindo de 60 proposições, um esboço da estratégia, definições e 47 lemas já provados, a equipe converteu uma estratégia de prova existente em uma prova formal verificável pelo Lean.
Q2: Por que apenas 54 das 60 proposições foram marcadas como provadas?
No levantamento feito após 30 horas, cinco proposições alternativas deixaram de ser necessárias, e uma foi abandonada. O teorema final já havia passado pela verificação após 28,7 horas, então não era necessário concluir todas as 60 proposições da lista inicial.
Q3: Quanto custa a API do Claude Fable 5.2?
O preço oficial é de US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída. No Fast Mode, os valores são US$ 16 e US$ 80, respectivamente. A leitura em cache custa US$ 0,20 por milhão de tokens, e a Batch API oferece 50% de desconto. A janela de contexto é de 1 milhão de tokens, e o limite máximo de saída é de 128 mil tokens. O custo total do segundo experimento não foi divulgado oficialmente; por isso, não dá para estimá-lo multiplicando os 6 bilhões de tokens do primeiro experimento pelo preço unitário.
Q4: Como testar rapidamente o Claude Fable 5.2 pela API?
Cadastre-se na APIYI, em apiyi.com, e obtenha uma chave API. Depois, defina `base_url` como `https://api.apiyi.com/v1` para executar diretamente o código de exemplo deste artigo. Novos usuários recebem créditos de teste gratuitos, ideais para começar com um protótipo pequeno usando vários agentes.
Q5: Um sistema multiagente sempre precisa de PostgreSQL?
Não. O essencial é ter uma fonte de estado compartilhada, que todos os agentes possam ler e atualizar, além de controle de versão e validação independente. Para protótipos pequenos, SQLite ou Redis já são suficientes. Ao invocar modelos pela APIYI, em apiyi.com, o armazenamento de estado fica sob responsabilidade do seu próprio sistema; você pode combinar os dois como preferir.
Q6: Quais são as limitações conhecidas deste experimento?
A equipe o classificou explicitamente como um experimento de brinquedo. A comparação entre Fable e Opus foi executada apenas uma vez para cada modelo. Foram usados modelos iniciais, que exigem várias camadas de proteção. Os agentes chegaram a abandonar a tarefa por engano e antes da hora, e a orientação humana e as ferramentas especializadas no domínio continuam sendo valiosas.
1000 agentes de IA formalizam o Último Teorema de Fermat: principais conclusões
- Essência do experimento: formalizar uma prova existente em código verificável pelo Lean, e não provar o Último Teorema de Fermat pela primeira vez.
- Números-chave: 1000 agentes Fable 5.2 em estágio inicial concluíram a tarefa em 28.7 horas, com verificação pelo kernel oficial do Lean.
- Organização central: 1 Lead + 999 Helpers, trabalhando com cinco tabelas de banco de dados compartilhadas e colaboração via Git.
- Como enfrentaram o desafio: cerca de 750 agentes dividiram Langlands–Tunnell em 2,418 subtarefas, com até 10 níveis de profundidade.
- Origem da confiabilidade: verificação independente pelo Lean e isolamento em sandbox; mais de 1 milhão de chamadas de ferramentas sem necessidade de intervenção.
- Limites de aplicação: tarefas empresariais muitas vezes não contam com um verificador como o Lean, então os números de eficiência não podem ser extrapolados diretamente.
- Como começar: dá para reproduzir em pequena escala um protótipo de colaboração Lead/Helper usando a interface unificada da APIYI em apiyi.com.
Resumo
Os principais aprendizados do experimento com mil agentes do Claude Fable 5.2:
- O sistema supera o agente isolado: a combinação de capacidade do modelo, decomposição de tarefas, estado compartilhado, execução paralela e verificação por máquina levou ao resultado em 28.7 horas.
- A verificação é a base da confiança: a checagem pelo kernel do Lean distingue rigorosamente entre “o modelo diz que terminou” e “a tarefa foi realmente concluída”.
- É importante deixar claros os limites: dados de entrada predefinidos, o modelo em estágio inicial, a comparação feita uma única vez e o caráter de experimento de brinquedo impedem que o resultado seja interpretado além do que ele demonstra.
O experimento deixa uma pergunta importante para o setor: será que a competição entre sistemas de IA está migrando da capacidade de um único modelo para a capacidade de organizar e coordenar muitos agentes na execução de tarefas complexas? Para quem desenvolve, já é possível começar com um pequeno protótipo multiagente que conte com verificação independente. Vale testar os resultados rapidamente pela APIYI em apiyi.com, que oferece créditos gratuitos para testes e uma interface unificada para vários modelos.
📚 Referências
- Blog de engenharia da Anthropic: Safely scaling multi-agent teams with Claude Fable 5.2
- Link:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2 -
Descrição: arquitetura da equipe, colaboração com o banco de dados, mecanismos de segurança e comparação com o Opus no segundo experimento
-
Artigo de pesquisa da Anthropic: Formalizing Fermat’s Last Theorem
- Link:
anthropic.com/research/formalizing-fermats-last-theorem -
Descrição: dados do primeiro experimento de formalização e abordagem de colaboração com o Prove2Me
-
Repositório oficial de provas Lean da Anthropic: primeira versão da prova formal
- Link:
github.com/anthropics/fermats-last-theorem -
Descrição: código público da prova da versão de setembro; os dados do README não correspondem às estatísticas do experimento de novembro
-
Exemplo oficial do Lean: Formalizing Fermat’s Last Theorem
- Link:
lean-lang.org/use-cases/flt -
Descrição: introdução ao Lean e ao contexto da matemática formalizada
-
Documentação do modelo Fable 5.2: especificações do modelo e migração da API
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Descrição: janela de contexto, limite de saída e informações sobre preços
Autor: equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI. Para mais materiais, acesse a central de documentação em docs.apiyi.com.