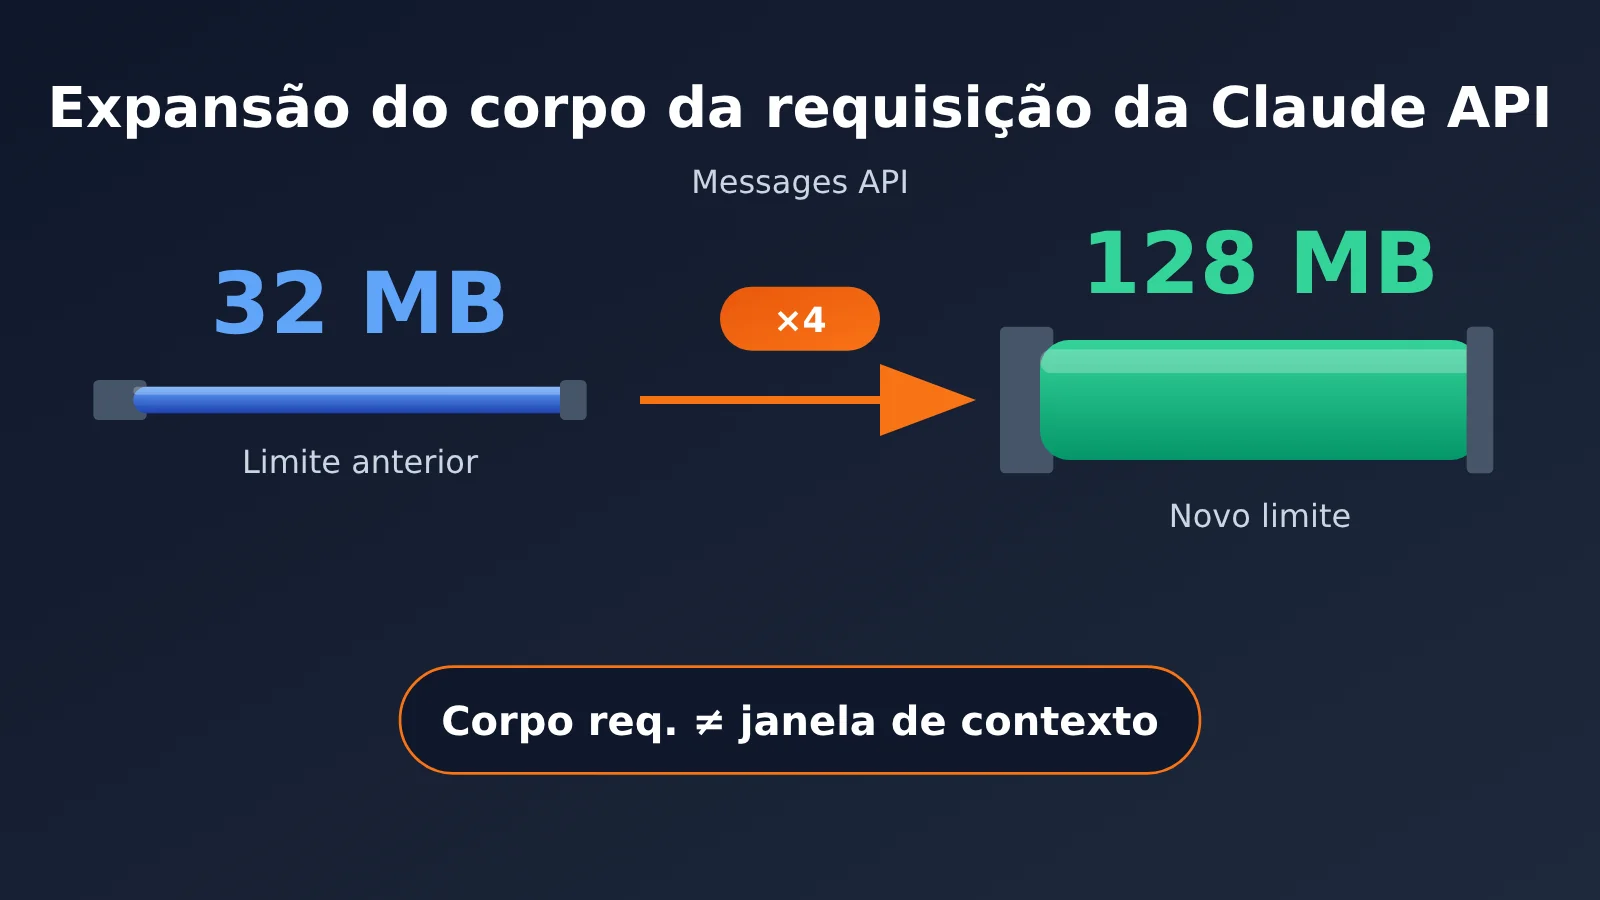
Em 28 de outubro de 2026, a Anthropic anunciou uma atualização em seu registro oficial de lançamentos: o tamanho máximo do corpo das requisições à Messages API e à Token Counting API da Claude API oficial aumentou de 32 MB para 128 MB, quatro vezes o limite anterior. Com a notícia, muitos responsáveis técnicos em empresas começaram a se perguntar: será que agora vale a pena refazer os fluxos de divisão, upload e pré-processamento de arquivos grandes criados para contornar o limite de 32 MB?
Esta não é uma atualização que “tornou o modelo mais poderoso”. O que mudou foi o limite de tamanho do corpo da requisição na camada HTTP, sem relação com a janela de contexto do modelo ou com o tamanho da saída. Muitas interpretações equivocadas surgem justamente da confusão entre 128 MB, 128 mil tokens e 1 milhão de tokens.
O que você vai encontrar aqui: primeiro, vamos esclarecer qual limite mudou com a expansão da Claude API. Em seguida, apresentaremos três classificações, A/B/C, conforme o cenário de uso. Por fim, você encontrará um plano de validação de baixo custo e uma lista de verificação. As recomendações de arquitetura são análises técnicas baseadas em informações oficiais, não instruções oficiais de migração publicadas pela Anthropic.
Resumo da ampliação do corpo das requisições da Claude API
Esta tabela reúne os fatos sobre a atualização do corpo das requisições da Claude API. Eles servem de base para a análise a seguir.
| Item | Detalhes | Fonte |
|---|---|---|
| Data de publicação | 28 de outubro de 2026 | Registro oficial de lançamentos (S1) |
| Empresa responsável | Anthropic | Registro oficial de lançamentos (S1) |
| Endpoints afetados | Messages API e Token Counting API da Claude API oficial | S1, S2 |
| Principal mudança | O tamanho máximo do corpo da requisição aumentou de 32 MB para 128 MB | S1, S2 |
| O que não mudou | A janela de contexto do modelo e o limite de saída não aumentaram | S2, S5 |
| Ao ultrapassar o limite | Retorna o erro HTTP 413 request_too_large |
S2 |
| Cobrança | Continua baseada no uso de tokens; um corpo de requisição maior não significa que o processamento de arquivos seja gratuito | S6 |
Os limites de tamanho das requisições variam entre os endpoints da Claude API
Vale lembrar que os endpoints da Claude API oficial não compartilham um único limite de tamanho de requisição. A atualização afetou apenas os endpoints Messages e Token Counting; os demais mantêm seus próprios limites. Por isso, ao tomar decisões de arquitetura, as empresas não devem se basear em um único número.
| Endpoint | Limite atual de tamanho da requisição | Observações |
|---|---|---|
| Messages API | 128 MB | Aumentou de 32 MB nesta atualização |
| Token Counting API | 128 MB | Aumentou de 32 MB nesta atualização, igualando o limite do Messages |
| Batch API | 256 MB | Para processamento assíncrono em lote |
| Files API | 500 MB | Limite de armazenamento de 500 MB por arquivo |
| Sessions / Agents / Environments | 32 MB | Mantém o limite anterior |
Os dados vêm da documentação oficial de visão geral da API (S2). Se sua aplicação usa endpoints Messages e Agents, é preciso planejar os limites de tamanho separadamente, em vez de aplicar os 128 MB aos dois.
Qual limite mudou com o aumento do tamanho do corpo de requisição da Claude API
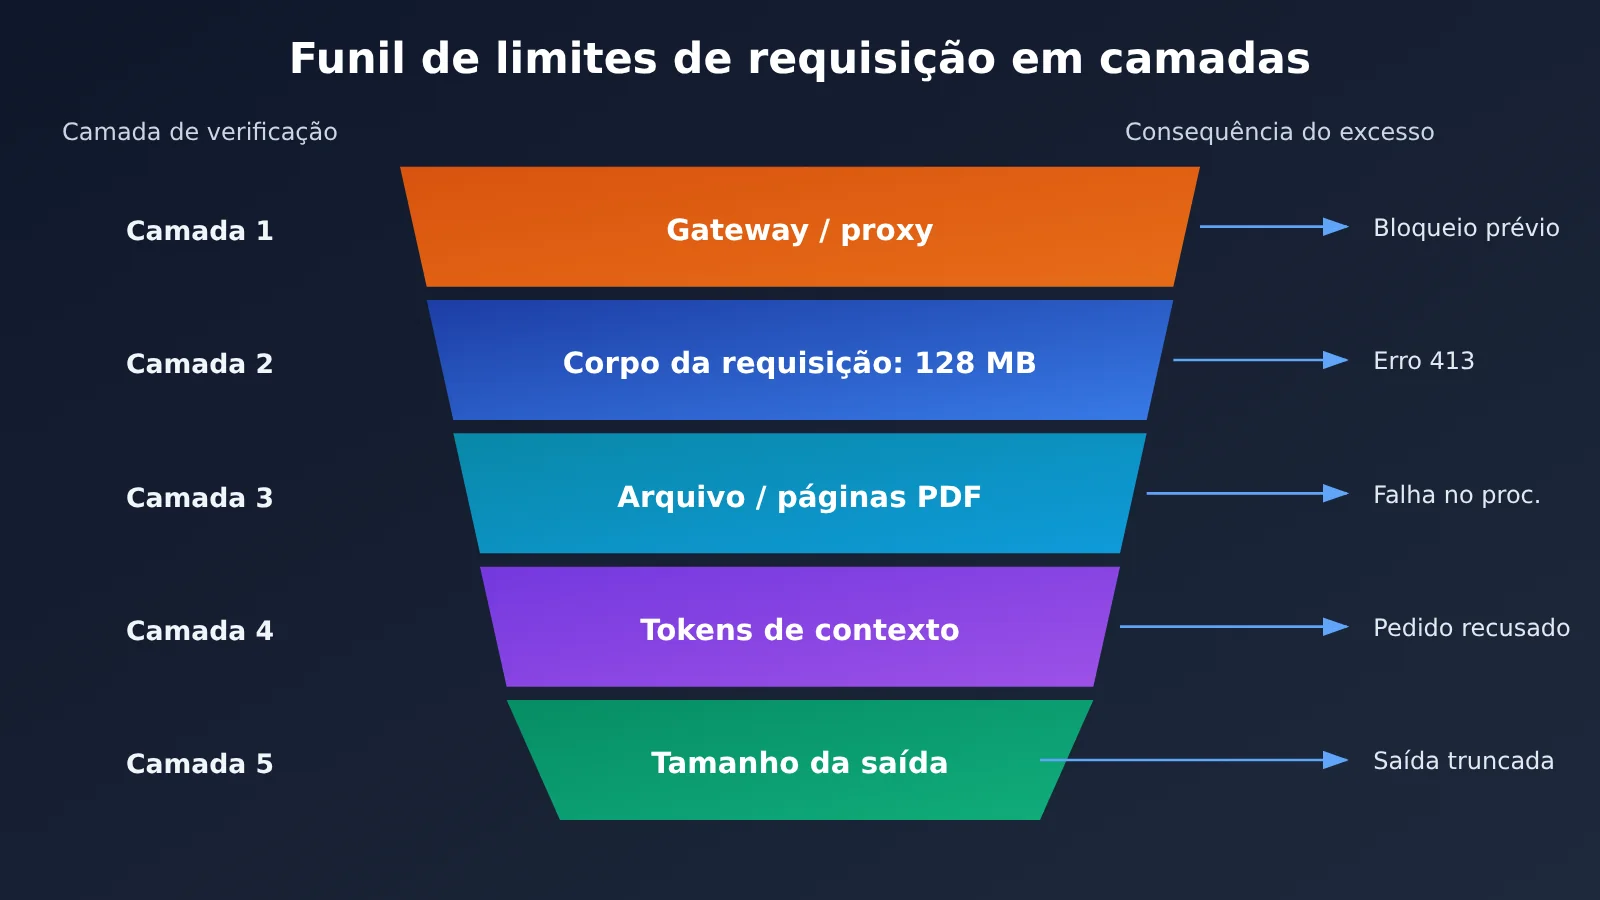
Uma chamada à Claude API precisa passar por várias “barreiras”, e o tamanho do corpo da requisição é apenas a primeira delas. Entender cada limite é o primeiro passo para decidir se você precisa mudar sua arquitetura.
| Tipo de limite | Unidade de medida | Houve mudança? | Consequência ao exceder |
|---|---|---|---|
| Tamanho do corpo da requisição HTTP | Bytes (MB) | Sim, Messages / Token Counting passaram para 128 MB | HTTP 413 request_too_large |
| Janela de contexto do modelo | Tokens | Não | A requisição é rejeitada ou precisa ser truncada |
| Limites de arquivos e PDFs | Tamanho do arquivo, número de páginas | O limite do corpo da requisição para PDFs é de 128 MB; há um limite separado de páginas | O arquivo não pode ser processado por completo |
| Tamanho da saída | Tokens | Não | A saída é truncada |
Um corpo de requisição de 128 MB não significa que o modelo consiga “entender” 128 MB
O tamanho do corpo da requisição mede os bytes transmitidos pela rede, enquanto a janela de contexto mede quantos tokens o modelo consegue processar de uma vez. Uma imagem de alta resolução pode ocupar vários MB e, ainda assim, não corresponder a tantos tokens. Já um texto de algumas centenas de KB pode ter tokens suficientes para se aproximar do limite de contexto. Portanto, “enviar mais bytes” e “o modelo entender mais conteúdo” são coisas diferentes.
Além disso, conteúdos binários, como imagens e PDFs, normalmente precisam ser codificados em base64 nas requisições JSON. Essa codificação aumenta o tamanho para cerca de 4/3 do original. Isso significa que um corpo de requisição de 128 MB comporta arquivos binários originais bem menores que 128 MB. Leve essa sobrecarga em conta ao estimar o espaço necessário.
A relação entre o corpo da requisição da Claude API e o limite de páginas de PDF
A documentação oficial sobre PDFs (S3) informa que, ao processar PDFs pela interface direta, o limite do corpo da requisição é de 128 MB. O número de páginas tem um limite separado, que depende da janela de contexto do modelo usado. Ou seja, mesmo que um contrato digitalizado de 100 MB passe pela camada HTTP sem problemas, ele ainda pode não ser processado por completo se o número de páginas ou de tokens exceder o limite de contexto.
Quais aplicações empresariais podem se beneficiar do aumento do limite do corpo de requisições da API Claude
A análise a seguir é uma projeção e parte do princípio de que a aplicação era, de fato, limitada pelos 32 MB permitidos no corpo das requisições. Mesmo nesses casos, isso não significa que a divisão em partes deixará de ser necessária.
- Análise de PDFs grandes e contratos: equipes jurídicas e de auditoria costumam enviar contratos digitalizados ou relatórios com vários anexos. Arquivos digitalizados ocupam bastante espaço, mas têm pouco texto em relação ao tamanho. Se o principal obstáculo era ultrapassar os 32 MB, o novo limite pode permitir o envio em uma única requisição. Se o problema era o número de páginas ou de tokens de contexto, a melhora será limitada.
- Envio de várias imagens ou documentos de várias páginas: em processos de sinistros de seguros ou inspeções de qualidade, uma única requisição pode incluir muitas fotos do local. Juntas, elas podem facilmente ultrapassar o limite anterior. O aumento pode reduzir a ocorrência do erro 413, mas a quantidade de imagens ainda está sujeita às restrições do modelo e da janela de contexto.
- Aplicações de IA com grandes volumes de dados estruturados: alguns sistemas incluem longos trechos de JSON, logs ou tabelas diretamente na requisição. Embora agora haja mais espaço em bytes, esses dados costumam ter uma alta densidade de tokens e podem atingir o limite da janela de contexto antes dos 128 MB.
- Aplicações que dividiam a entrada apenas por causa dos 32 MB: essas são as beneficiárias mais diretas. Se a única razão para dividir os dados era contornar o limite do corpo da requisição, vale reavaliar se a divisão ainda é necessária.
🎯 Recomendação técnica: ao avaliar esses cenários, use amostras reais para medir tanto o tamanho em bytes quanto a quantidade de tokens. Assim, fica mais fácil identificar onde está o gargalo. Com a APIYI apiyi.com, é possível usar a mesma chave API para invocar o Claude e outros modelos populares em testes comparativos. Porém, o limite do corpo de requisição de plataformas terceirizadas pode ser diferente do limite da API oficial. Antes de colocar a aplicação em produção, confirme o limite atualmente aceito pela plataforma.
Com a ampliação do limite do corpo de requisição da Claude API, é preciso mudar a arquitetura? Três cenários: A, B e C
Este é o principal critério de decisão do artigo. A necessidade de ajustar a arquitetura não depende do aumento do limite oficial, mas sim do problema que o projeto original buscava resolver.
| Cenário | Características típicas | Ação recomendada | Prioridade |
|---|---|---|---|
| A. Nunca chegou perto de 32 MB | O corpo das requisições costuma ter apenas alguns MB, sem erros 413 nos logs | Manter a arquitetura atual e registrar a mudança | Baixa |
| B. Erros 413 frequentes por causa do tamanho da requisição | A proporção de erros 413 request_too_large no monitoramento é significativa |
Testar e otimizar o fluxo de envio; avaliar a redução da divisão em blocos | Alta |
| C. Divisão em blocos por contexto, precisão, desempenho ou custo | A divisão busca melhorar a precisão da recuperação, controlar custos ou reduzir a latência | Manter a divisão em blocos, a recuperação e o cache | Inalterada |
Cenário A: sistemas que nunca chegaram perto de 32 MB
Na maioria das aplicações de conversa apenas por texto, atendimento ao cliente e assistência à programação, o corpo de cada requisição fica bem abaixo de 32 MB. Em geral, não há motivo para fazer ajustes nesses sistemas: uma mudança forçada só traria novos riscos. Basta atualizar as informações sobre os limites dos endpoints na documentação técnica para facilitar a investigação de problemas no futuro.
Cenário B: sistemas com erros 413 frequentes por causa do limite da requisição
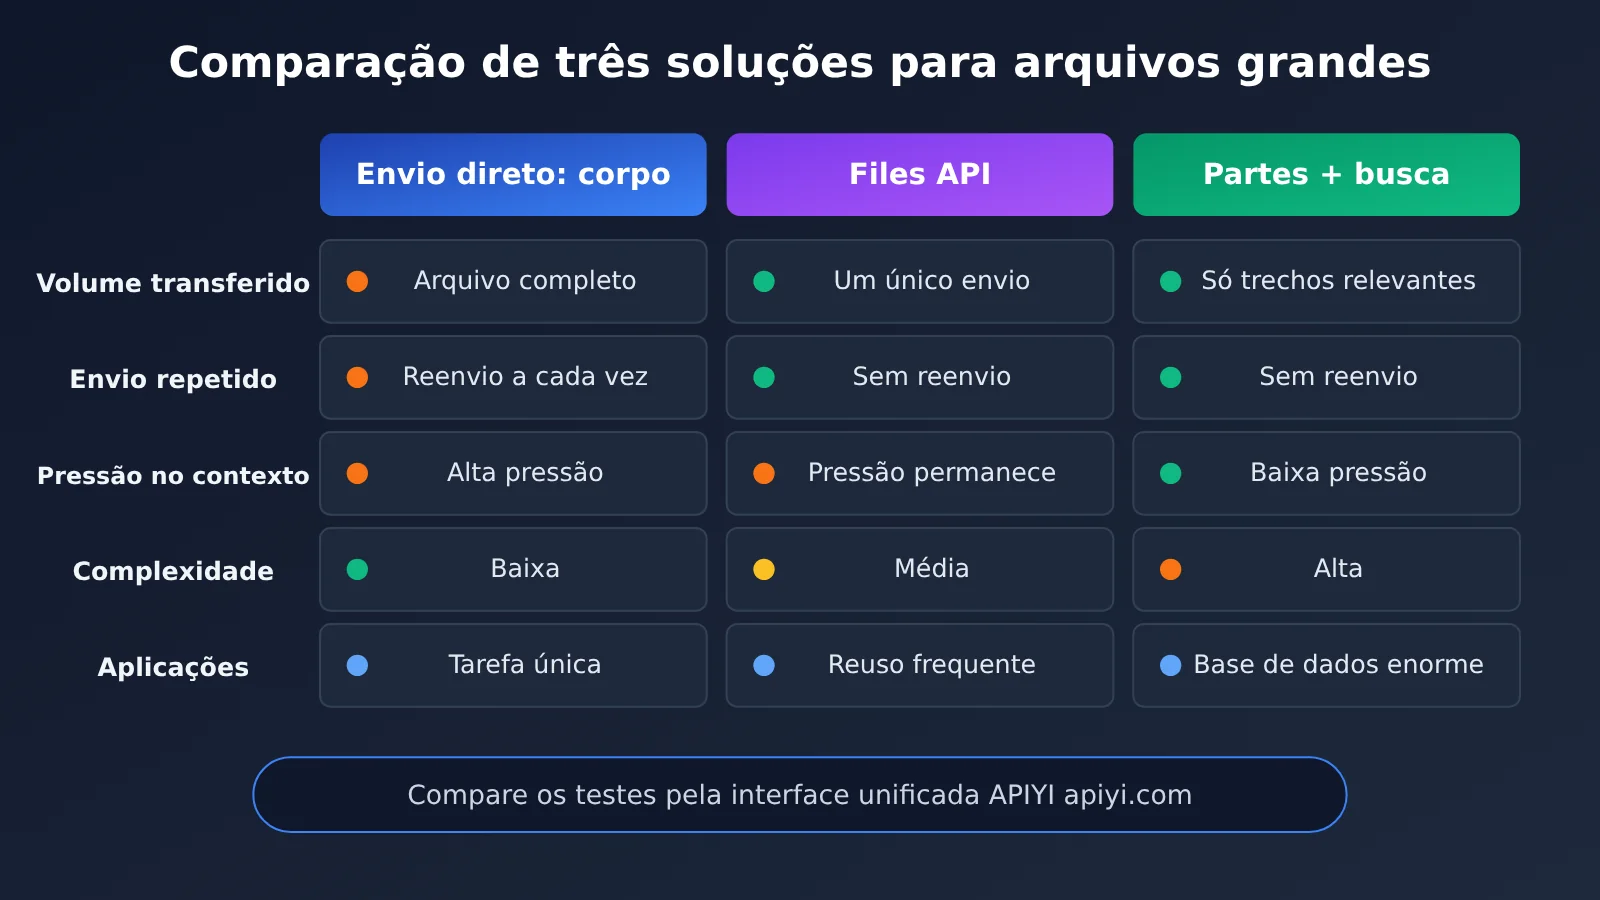
Se o monitoramento mostrar uma concentração de erros 413 e você confirmar que eles são causados pelo corpo da requisição excedendo o limite do endpoint Messages, vale a pena testar a atualização. Você pode avaliar a substituição de parte da lógica de divisão por um único envio ou usar referências file_id da Files API para reduzir transferências repetidas.
Cenário C: divisão em blocos por qualidade, custo ou desempenho
Muitos sistemas RAG dividem dados em blocos não porque a requisição seria grande demais para ser enviada, mas para tornar a recuperação mais precisa, reduzir o número de tokens em cada chamada e acelerar as respostas. A ampliação do limite do corpo da requisição não muda essas razões. Nesse caso, eliminar a divisão em blocos pode até aumentar os custos e reduzir a qualidade das respostas. Esses sistemas devem manter a divisão em blocos, a recuperação e o cache necessários.
5 verificações de arquitetura antes de ampliar o corpo das requisições à Claude API
Mesmo no cenário B, vale verificar cada camada na ordem abaixo. Muitas equipes ainda encontram erros depois que o limite oficial aumenta, e o problema costuma estar em algum ponto intermediário da infraestrutura.
- Confirme o limite oficial do endpoint da Anthropic: o limite de Messages é de 128 MB, mas Sessions / Agents / Environments continuam em 32 MB, Batch em 256 MB e Files em 500 MB (S2).
- Verifique os limites de requisição do gateway de API e do proxy reverso: gateways internos, Nginx, balanceadores de carga e WAFs costumam ter seus próprios limites padrão, que podem ser bem menores que 128 MB. Confira cada um deles.
- Verifique o cliente, o SDK e a forma de transmissão: o timeout do cliente HTTP, o armazenamento em buffer na memória e o método de upload afetam o envio de requisições grandes. Considere também o aumento de tamanho causado pela codificação em base64.
- Confira as restrições independentes de tokens, contexto e arquivos: use a Token Counting API para estimar o número de tokens e confirme se a quantidade de páginas do PDF e a janela de contexto estão dentro dos limites (S3, S5).
- Avalie latência, timeouts, custos e tratamento de erros: requisições grandes demoram mais para ser enviadas, e novas tentativas após uma falha custam mais. A cobrança continua sendo por token (S6), então é preciso rever as estratégias de timeout e de novas tentativas.
Alternativas ao envio pelo corpo da requisição à Claude API
Além de enviar arquivos grandes diretamente no corpo da requisição, vale avaliar algumas alternativas:
- Files API e referências por
file_id: faça o upload do arquivo primeiro e depois use ofile_idpara referenciá-lo nas mensagens. Assim, o mesmo arquivo não precisa ser transmitido repetidamente em várias requisições (S4). O limite de armazenamento é de 500 MB por arquivo, mas o processamento pelo modelo ainda está sujeito a restrições como a capacidade de contexto. - Cache de comandos: ativar o cache para o prefixo de documentos longos usados várias vezes pode ajudar a controlar o custo de entradas repetidas. Consulte as regras de cobrança na página oficial de preços (S6).
- Manter a divisão em blocos + busca: para bases de dados muito extensas, buscar e enviar apenas os trechos relevantes geralmente continua sendo uma forma de equilibrar qualidade e custo.
O risco de isolamento de arquivos entre tenants também merece atenção. Na Files API, os arquivos ficam armazenados no nível da conta de API. Se vários clientes compartilham a mesma conta, é necessário isolar rigorosamente as permissões de acesso aos file_id na camada da aplicação, evitando que uma requisição do tenant A referencie arquivos do tenant B.
Como avaliar, com baixo custo, os benefícios reais do aumento do limite do corpo de requisição da Claude API
Ainda não há dados de testes publicamente citáveis que comprovem que o aumento do limite tornou o processamento mais rápido ou reduziu os custos. Por isso, a maneira mais confiável de avaliar o impacto é testar com amostras do seu próprio fluxo de trabalho. O plano abaixo é uma proposta de teste, não um conjunto de resultados.
| Nível de teste | Tamanho do corpo da requisição | O que observar |
|---|---|---|
| Nível 1 | Bem abaixo de 32 MB | Usar como referência e registrar o tempo e o número de tokens em condições normais |
| Nível 2 | Próximo de 32 MB | Observar se a comunicação permanece estável perto do limite anterior |
| Nível 3 | Acima de 32 MB | Verificar se o gateway e o SDK aceitam a requisição e se ocorre o erro 413 |
| Nível 4 | Próximo de 128 MB | Avaliar tempos limite, uso de memória e custo de novas tentativas após falhas |
Cada nível deve respeitar os limites aplicáveis ao modelo e aos arquivos. Registre também seis métricas: tamanho do corpo da requisição HTTP, número de tokens, código de status, tempo, custo e qualidade do resultado. Em seguida, execute três abordagens com o mesmo conjunto de amostras: “envio direto”, “referência via Files API” e “processamento em blocos”. Por fim, use os dados para decidir se vale a pena ajustar o fluxo atual.
Exemplo simples de medição do corpo de requisições à API Claude
O código abaixo mede o tamanho do corpo da requisição em bytes antes do envio e captura erros 413, facilitando o registro dos dados durante os testes:
import json, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "user", "content": "请总结这份长文档的要点:" + open("doc.txt").read()}]
body_mb = len(json.dumps({"messages": messages}).encode("utf-8")) / 1024 / 1024
print(f"请求体约 {body_mb:.2f} MB")

resp = client.chat.completions.create(model="YOUR_CLAUDE_MODEL", messages=messages)
print(resp.usage)  # 记录 Token 用量
Ver o script completo de registro dos testes
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通过 APIYI 统一接口调用
)

MODEL = "YOUR_CLAUDE_MODEL"  # 替换为平台模型列表中的 Claude 模型名

def run_case(case_name: str, messages: list) -> dict:
    """记录单次请求的体积、Token、状态、耗时,用于方案对比"""
    body = json.dumps({"model": MODEL, "messages": messages}).encode("utf-8")
    record = {
        "case": case_name,
        "body_mb": round(len(body) / 1024 / 1024, 2),
        "status": None,
        "latency_s": None,
        "prompt_tokens": None,
        "completion_tokens": None,
    }
    start = time.time()
    try:
        resp = client.chat.completions.create(model=MODEL, messages=messages)
        record["status"] = 200
        record["prompt_tokens"] = resp.usage.prompt_tokens
        record["completion_tokens"] = resp.usage.completion_tokens
    except openai.APIStatusError as e:
        record["status"] = e.status_code  # 413 即请求体超限
    except Exception as e:
        record["status"] = f"error: {e}"
    record["latency_s"] = round(time.time() - start, 2)
    return record

if __name__ == "__main__":
    text = open("doc.txt", encoding="utf-8").read()
    cases = {
        "baseline": [{"role": "user", "content": "总结要点:" + text[:20000]}],
        "full_direct": [{"role": "user", "content": "总结要点:" + text}],
    }
    results = [run_case(name, msgs) for name, msgs in cases.items()]
    for r in results:
        print(r)
🚀 Comece agora: se a equipe quiser colocar o fluxo de testes para rodar, pode se cadastrar na APIYI em apiyi.com, obter créditos de teste e usar o script acima para registrar os dados de cada faixa de tamanho. Ao encaminhar requisições por uma plataforma de terceiros, o limite do corpo de requisição do gateway pode ser menor que os 128 MB da API oficial. Consulte a documentação da plataforma antes de testar requisições maiores.
Perguntas frequentes (FAQ)
Q1: O que significa o aumento do limite do corpo de requisição da Claude API para 128 MB?
O limite máximo de bytes por requisição HTTP na Messages API e na Token Counting API oficiais da Claude passou de 32 MB para 128 MB (S1, S2). Esse limite não é a janela de contexto nem o comprimento da resposta.
Q2: Qual é a diferença entre um corpo de requisição de 128 MB e uma janela de contexto de 128 mil ou 1 milhão de tokens?
O primeiro mede, em bytes, o volume de dados transferidos pela rede; a segunda mede, em tokens, a capacidade de processamento do modelo. São unidades completamente diferentes. Conseguir enviar o corpo da requisição não significa que todo o conteúdo caiba na janela de contexto. O orçamento de tokens ainda precisa ser estimado separadamente com a Token Counting API.
Q3: Com o novo limite, o processamento fica mais rápido e o custo diminui?
Não há dados oficiais nem testes públicos que comprovem isso. A cobrança continua baseada no uso de tokens (S6), e um corpo de requisição maior também pode levar mais tempo para ser enviado. Para saber se há algum benefício, é preciso testar com amostras do seu próprio caso de uso.
Q4: Como verificar rapidamente, pela API, o impacto dessa mudança no meu caso de uso?
Você pode seguir o plano de testes em quatro níveis apresentado neste artigo. Depois de se cadastrar na APIYI apiyi.com e obter uma chave API, configure `base_url` como `https://api.apiyi.com/v1` e use o script de teste para registrar o tamanho, os tokens, o código de status e o tempo gasto. Como os limites da plataforma podem ser diferentes dos oficiais, confirme primeiro o tamanho máximo aceito antes de testar os níveis com maior volume.
Q5: É preciso desfazer um sistema de divisão em blocos para RAG que já está pronto?
Normalmente, não. Se a divisão em blocos foi adotada para melhorar a precisão da recuperação, controlar o custo de tokens ou reduzir a latência, esses motivos continuam válidos. Só vale reavaliar se o único motivo para dividir o conteúdo era contornar o limite de 32 MB.
Q6: Quais são as limitações conhecidas do novo limite de corpo de requisição da Claude API?
São três pontos principais: os endpoints Sessions / Agents / Environments continuam com limite de 32 MB; o número de páginas de PDF e a janela de contexto têm restrições próprias; e gateways corporativos, proxies e plataformas de terceiros podem impor limites menores. Se quiser comparar o desempenho de vários modelos com documentos grandes, você pode usar a interface unificada da APIYI apiyi.com, respeitando o limite efetivamente aceito pela plataforma.
Principais pontos sobre o aumento do limite do corpo de requisição da Claude API
- O que mudou: o limite do corpo das requisições Messages e Token Counting passou de 32 MB para 128 MB. É uma mudança na camada HTTP.
- O que não mudou: a janela de contexto, o tamanho máximo da resposta e a cobrança por tokens continuam iguais.
- Diferenças entre endpoints: Batch tem limite de 256 MB, Files de 500 MB e os endpoints de Agents continuam em 32 MB.
- Como decidir: avalie se a divisão original existia para contornar o limite de tamanho ou por motivos de qualidade, custo e desempenho.
- Verificação da infraestrutura: limites em gateways, proxies e SDKs costumam ser atingidos antes do limite oficial.
- Como testar: compare envio direto, referência a arquivos e divisão em blocos em quatro faixas de tamanho. A interface unificada da APIYI apiyi.com pode ajudar nesses testes.
Resumo: o aumento do corpo de requisição da Claude API não exige desmontar o sistema existente
O impacto dessa ampliação pode ser resumido em três pontos:
- A capacidade de entrada aumentou: é possível enviar mais bytes em uma única requisição ao endpoint Messages oficial, dando mais margem a aplicações que enfrentavam erros 413.
- Os outros limites continuam iguais: a janela de contexto, o número de páginas em PDFs, a cobrança por tokens e os limites dos outros endpoints precisam ser avaliados separadamente.
- A decisão depende do gargalo: mudanças na arquitetura devem levar em conta os gargalos reais da aplicação, a qualidade dos resultados, os custos e os requisitos de segurança, não apenas a novidade.
Para a maioria das empresas, o caminho mais seguro é consultar os logs, testar amostras e só então decidir o alcance das mudanças. Confira esta lista prática:
- [ ] Levantar a frequência dos erros 413
request_too_largerecentes e os endpoints de origem - [ ] Confirmar os endpoints usados pela aplicação e seus limites oficiais (Messages / Batch / Files / Agents)
- [ ] Verificar os limites do corpo de requisição em gateways próprios, proxies reversos, WAFs e balanceadores de carga
- [ ] Verificar as configurações de timeout e buffer dos SDKs e clientes HTTP, considerando o aumento de tamanho causado pela codificação base64
- [ ] Usar a Token Counting API para estimar o número de tokens das requisições grandes e a margem disponível na janela de contexto
- [ ] Comparar envio direto, referência pela Files API e divisão em blocos em quatro faixas de tamanho
- [ ] Avaliar o isolamento de
file_identre clientes e as políticas de segurança de dados - [ ] Decidir com base nos dados se alguma mudança é necessária e atualizar a documentação técnica interna
Uma opção é usar a APIYI apiyi.com para montar rapidamente um ambiente de testes comparativos. Com uma única chave API, é possível acessar vários modelos populares e avaliar as opções com amostras reais.
📚 Referências
- Notas de lançamento oficiais da Anthropic: anúncio do ajuste no limite do corpo da requisição em 28 de outubro de 2026
- Link:
platform.claude.com/docs/en/release-notes/overview -
Descrição: fonte original do aumento de 32 MB para 128 MB (S1)
-
Visão geral e limites dos endpoints da API Claude: limites de tamanho das requisições por endpoint e explicação do erro 413
- Link:
platform.claude.com/docs/en/api/overview -
Descrição: comparação dos limites dos endpoints Messages, Batch, Files e Agents (S2)
-
Documentação de suporte a PDF: limites do corpo da requisição e do número de páginas em PDFs
- Link:
platform.claude.com/docs/en/build-with-claude/pdf-support -
Descrição: leitura essencial antes de processar PDFs grandes (S3)
-
Documentação da Files API: upload de arquivos, referências por
file_id, armazenamento e permissões - Link:
platform.claude.com/docs/en/build-with-claude/files -
Descrição: avaliação do uso de referências a arquivos e do isolamento entre múltiplos locatários (S4)
-
Documentação sobre janela de contexto: capacidade de tokens do modelo
- Link:
platform.claude.com/docs/en/build-with-claude/context-windows -
Descrição: como distinguir o limite de bytes do limite de tokens (S5)
-
Preços e cache oficiais: cobrança por tokens e cache de comandos
- Link:
platform.claude.com/docs/en/about-claude/pricing - Descrição: base para avaliar o impacto nos custos (S6)
Autor: Equipe técnica da APIYI
Contato técnico: entre em contato pela página inicial do site APIYI apiyi.com. Para mais informações sobre integração, acesse a central de documentação em docs.apiyi.com