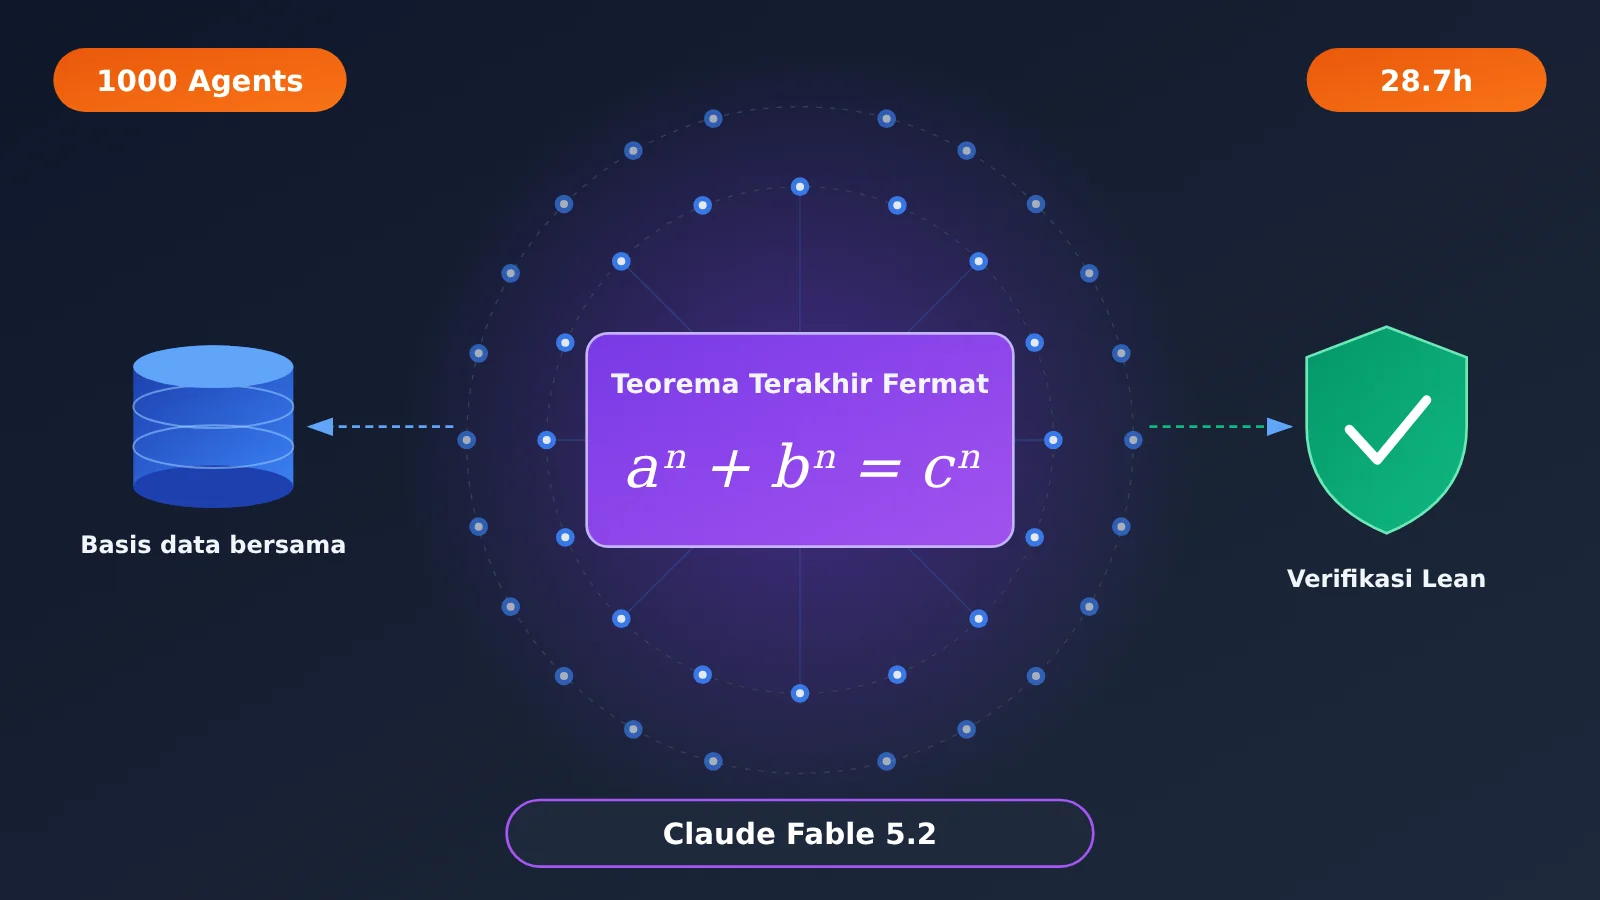
Pada 9 November 2026, Anthropic mengumumkan sebuah eksperimen multiagen di blog rekayasa resminya: 1000 agen Claude Fable 5.2 bekerja sama dan menyelesaikan formalisasi komputer untuk Teorema Terakhir Fermat dalam 28,7 jam. Pada akhirnya, buktinya lolos pemeriksaan kernel resmi Lean. Eksperimen formalisasi pertama, yang dilakukan dua bulan sebelumnya oleh puluhan agen, memakan waktu 11 hari.
Ini bukan berarti “AI membuktikan Teorema Terakhir Fermat dalam 30 jam”. Teorema tersebut sudah dibuktikan oleh Andrew Wiles dan Richard Taylor pada 1990-an. Yang dilakukan dalam eksperimen ini adalah menerjemahkan jalur pembuktian yang sudah ada ke dalam bentuk bukti formal yang bisa diperiksa komputer langkah demi langkah. Jadi, pertanyaan yang ingin dijawab artikel ini adalah: bagaimana 1000 agen AI bekerja sama menyelesaikan proyek serumit ini dalam waktu kurang dari 30 jam?
Manfaat utama: Setelah membaca artikel ini, Anda akan memahami data penting dari eksperimen formalisasi Teorema Terakhir Fermat ini, cara 1000 agen diorganisasikan dan mekanisme verifikasinya, serta nilai dan batas penerapannya sebagai acuan untuk sistem agen perusahaan.
Ringkasan Fakta Utama Eksperimen Formalisasi Teorema Terakhir Fermat
Berikut ringkasan fakta dasar eksperimen Claude Fable 5.2 dalam sebuah tabel. Perhatikan beberapa hal yang mudah tertukar: model yang digunakan masih versi awal, eksperimen ini memakai masukan yang telah ditentukan sebelumnya, dan pihak resmi juga menyebutnya sebagai toy experiment (demonstrasi eksperimental).
| Informasi | Detail |
|---|---|
| Waktu publikasi | 9 November 2026, di blog teknik resmi Anthropic |
| Model yang digunakan | Versi awal Claude Fable 5.2 (evaluasi alignment sebelum rilis resmi belum selesai) |
| Jumlah tim | 1 agen utama + 999 agen pembantu |
| Waktu penyelesaian | Pada jam ke-28,7, teorema akhir lolos pemeriksaan kernel resmi Lean (dalam pengumuman resmi dibulatkan menjadi 30 jam) |
| Masukan yang telah ditentukan | 60 proposisi, ringkasan satu kalimat tentang jalur pembuktian klasik, definisi terkait, serta 47 lemma yang telah dibuktikan dalam formalisasi sebelumnya |
| Lingkungan alat | Rangkaian alat Lean, Mathlib, Git, basis data PostgreSQL bersama, dan sandbox mesin virtual terpisah |
| Keterangan resmi | Toy experiment, bukan pembuktian pertama Teorema Terakhir Fermat |
Formalisasi Teorema Terakhir Fermat: Pahami Dulu Prasyarat Eksperimennya
Para peneliti tidak sekadar memberikan satu instruksi, “Tolong buktikan Teorema Terakhir Fermat,” lalu membiarkan agen bekerja sendiri. Agen mendapat 60 proposisi (termasuk teorema akhir dan 59 tonggak perantara), ringkasan jalur pembuktian, definisi, serta 47 lemma yang telah dibuktikan dalam eksperimen sebelumnya. Peran agen utama dan agen pembantu juga telah ditetapkan oleh para peneliti.
Jadi, eksperimen ini menguji kemampuan yang berbeda: dengan dasar matematika dan alat yang sudah disediakan, bisakah sebuah tim agen berskala besar mengatur dirinya sendiri dan menerjemahkan seluruh jalur pembuktian yang sudah dikenal menjadi bukti yang dapat diperiksa mesin? Pertanyaan ini lebih dekat ke persoalan rekayasa daripada sekadar “bisakah AI mengerjakan matematika?”
Mengapa Formalisasi Teorema Terakhir Fermat Sangat Sulit
Pernyataan Teorema Terakhir Fermat sangat sederhana: untuk bilangan bulat n yang lebih besar dari 2, tidak ada bilangan bulat positif a, b, dan c yang memenuhi a^n + b^n = c^n. Teorema ini diajukan oleh Pierre de Fermat pada abad ke-17 dan tetap menjadi teka-teki selama lebih dari 350 tahun. Wiles mengumumkan pembuktiannya pada 1993, lalu memperbaiki celah penting bersama Taylor pada 1994. Pembuktian itu resmi diterbitkan pada 1995. Pembuktian aslinya sekitar 129 halaman dan banyak mengandalkan hasil-hasil yang sudah ada dalam teori bilangan modern dan geometri aljabar.
Saat menulis pembuktian, matematikawan bisa mengatakan, “Ini jelas mengikuti kesimpulan sebelumnya,” dan pembaca akan melengkapi sendiri langkah-langkah perantaranya. Komputer tidak punya pemahaman seperti itu. Komputer harus mengetahui definisi mana, teorema mana, dan aturan penalaran mana yang digunakan pada setiap langkah. Inilah sumber kesulitan formalisasi: satu hal yang dianggap “jelas” oleh manusia bisa berubah menjadi ratusan, bahkan ribuan baris kode.
Lean, Mathlib, dan formalisasi matematika
Untuk memahami eksperimen ini, kita perlu membedakan tiga konsep:
- Lean: pembukti teorema interaktif yang bertugas memeriksa apakah suatu pembuktian benar-benar mengikuti aturan logika formal.
- Mathlib: pustaka matematika untuk Lean yang memuat banyak definisi dan teorema yang sudah diformalkan. Fungsinya mirip “pustaka standar” yang bisa langsung dirujuk.
- Formalisasi matematika: proses mengubah pembuktian matematika yang bisa dibaca manusia menjadi struktur logis yang dapat diverifikasi sepenuhnya oleh komputer.
Hal terpenting yang perlu diingat: AI bertugas menyusun pembuktian, sedangkan kernel Lean bertugas memeriksanya. Pernyataan model bahwa “saya sudah membuktikannya” dan penerimaan pembuktian tersebut oleh Lean adalah dua hal yang sangat berbeda. Eksperimen ini layak ditanggapi serius karena hasil akhirnya tidak bergantung pada penilaian model terhadap dirinya sendiri, melainkan telah lolos pemeriksaan mesin secara independen.
Bagaimana 1000 AI Agent Bekerja Sama: Sistem Manajemen Proyek yang Dijalankan AI
Inilah bagian paling menarik untuk dikaji dari eksperimen Claude Fable 5.2. Seribu Agent tidak bekerja sendiri-sendiri untuk memecahkan masalah, tetapi membentuk sistem kolaborasi yang dilengkapi manajemen tugas, penjadwalan sumber daya, dan penyesuaian dinamis.
Struktur organisasi tim Claude Fable 5.2
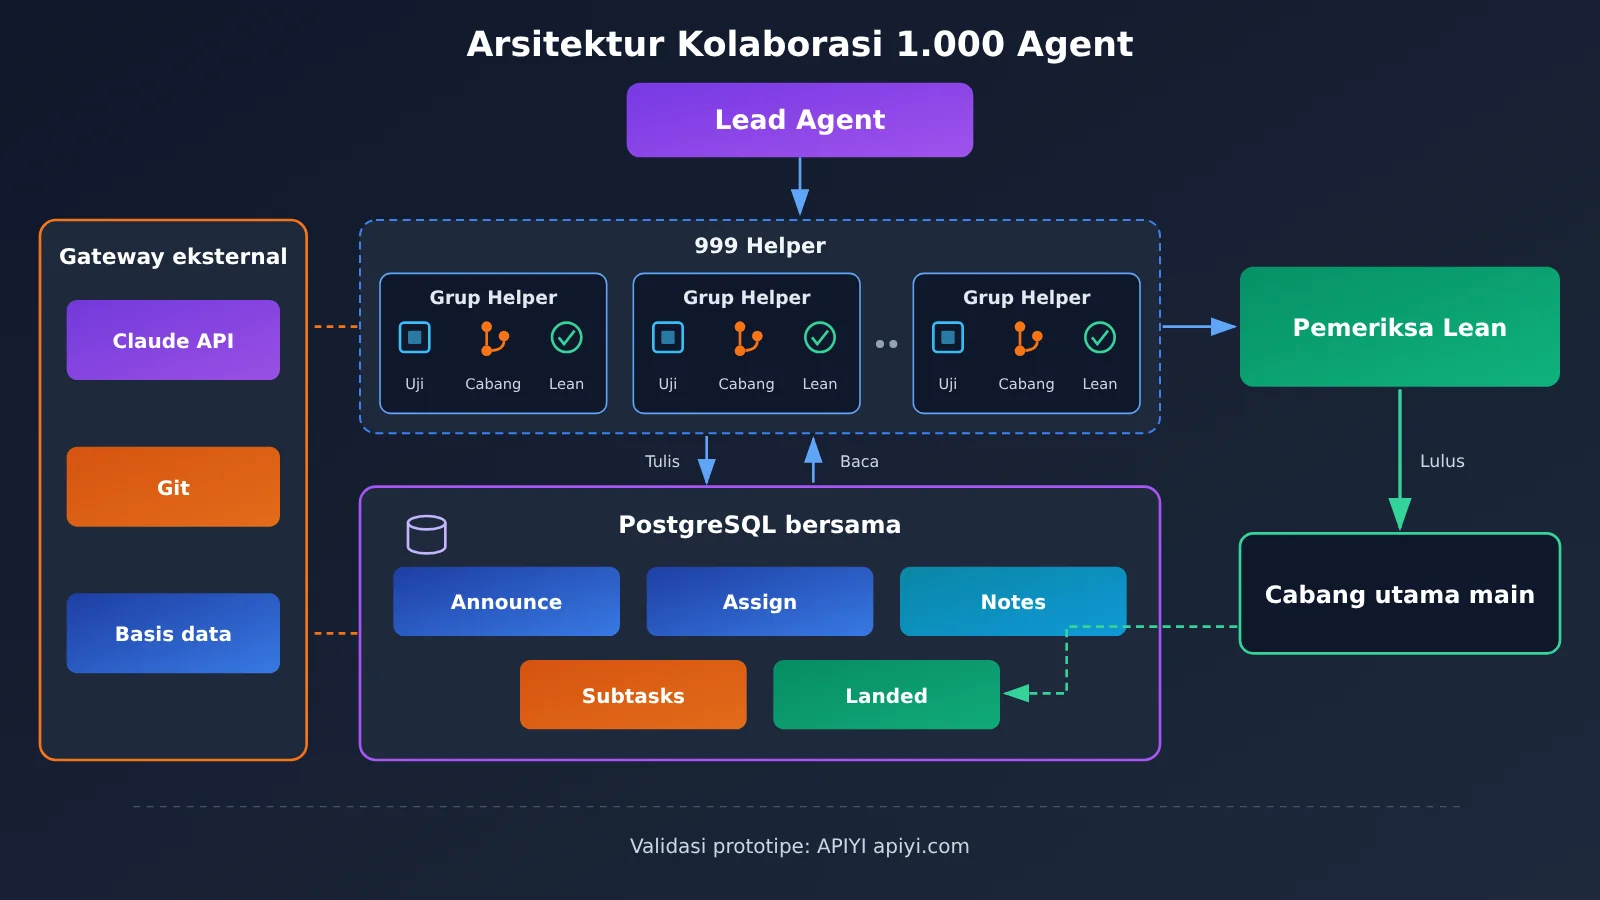
Tim ini menggunakan struktur hierarkis yang sederhana: 1 Lead Agent bertanggung jawab atas perencanaan keseluruhan, pembagian tugas, dan pemantauan progres, sedangkan 999 Helper Agent menangani pembuktian secara langsung. Setiap Agent memiliki sandbox mesin virtual ringan sendiri, yang dilengkapi Shell, editor berkas, toolchain Lean, dan Mathlib. Mereka juga memiliki cabang Git masing-masing dan dapat mengajukan Merge Request ke cabang utama.
Semua Agent tidak memiliki akses langsung ke internet. Komunikasi dengan Claude API, Git, dan basis data harus melalui Gateway eksternal. Sandbox dan cabang yang terpisah memungkinkan 1000 Agent mengubah kode secara bersamaan tanpa saling menimpa berkas.
PostgreSQL Bersama: Pusat Kolaborasi AI Agent
Jika 1.000 Agent berkolaborasi dengan saling mengirim pesan satu per satu, volume komunikasinya akan cepat tak terkendali. Lead Agent memilih pendekatan lain: dalam 10 menit setelah eksperimen dimulai, ia membuat lima tabel database bersama dan mengubah komunikasi menjadi “membaca dan menulis di papan yang sama”.
| Nama tabel | Fungsi | Peran dalam kolaborasi |
|---|---|---|
| Announce | Menerbitkan instruksi tim | Pengumuman untuk semua anggota, seperti papan pengumuman proyek |
| Assign | Membagikan tugas dan penanggung jawab | Memperjelas “siapa mengerjakan apa” agar tidak terjadi tumpang tindih |
| Notes | Mencatat progres, masalah, dan rencana kerja | Berbagi konteks dan mengurangi silo informasi |
| Subtasks | Mengelola tugas-tugas terperinci agar bisa diambil Agent | Kumpulan tugas yang mendukung pengambilan tugas secara mandiri |
| Landed | Mencatat pekerjaan yang sudah selesai dan lolos pemeriksaan | Daftar hasil tepercaya yang hanya memuat pekerjaan terverifikasi |
Keunggulan mekanisme ini adalah Agent tidak perlu menghubungi satu per satu dari 999 Agent lainnya. Cukup periksa database untuk mengetahui tugas yang tersedia, yang sudah selesai, dan yang memiliki dependensi. Hasil kerja kemudian digabungkan ke cabang utama melalui Git. Data yang diungkapkan secara resmi menunjukkan bahwa selama proses tersebut terjadi sekitar 36.612 penulisan dan 311.734 pembacaan database. Sekitar 20.600 penulisan di antaranya terkait Notes, dan sekitar 14.800 terkait Subtasks (statistik ini tidak mencakup sebagian besar pemanggilan skrip). Jumlah pembacaan yang jauh lebih banyak daripada penulisan juga menunjukkan bahwa sebagian besar waktu Agent digunakan untuk “melihat status keseluruhan”.
Pembagian tugas dinamis: dari penugasan tetap ke pengambilan tugas mandiri
Proses penjadwalan dalam eksperimen ini tidak berlangsung dengan pola yang tetap. Linimasa berikut menunjukkan bagaimana cara kerja tim berkembang secara bertahap:
| Waktu | Peristiwa penting |
|---|---|
| Menit ke-10 | Lead membuat lima tabel basis data bersama |
| Sekitar menit ke-27 | Tiga proposisi telah dibuktikan |
| Setelah itu | Lead menangguhkan sementara 47 proposisi yang dinilai sulit diselesaikan dalam batas anggaran, lalu memusatkan tenaga kerja pada 10 proposisi lainnya |
| Sekitar menit ke-70 | Kesepuluh proposisi tersebut selesai. Lead kemudian menugaskan ulang Agent untuk menangani proposisi yang lebih sulit |
| Sekitar jam ke-3 | Lead mengizinkan Agent yang menganggur untuk mengambil tugas sendiri tanpa menunggu penugasan |
| Jam ke-5,6 | 73 Helper telah membuat 756 tugas |
| Sekitar jam ke-18 | Proses dilanjutkan dari status tersimpan sebelumnya dan berjalan selama 12 jam lagi |
| Jam ke-28,4 | Proposisi terkait Langlands–Tunnell selesai |
| Jam ke-28,7 | Teorema Terakhir Fermat selesai dan lolos pemeriksaan kernel resmi |
Ada dua hal yang perlu diperhatikan. Pertama, peralihan dari “Lead membagikan tugas” ke “Agent mengambil tugas secara mandiri” menandai perubahan cara kerja tim dari penjadwalan terpusat ke model kumpulan tugas, sehingga mengurangi risiko Lead menjadi hambatan. Kedua, eksperimen ini dilanjutkan dari status tersimpan sekitar jam ke-18. Jadi, durasi 28,7 jam bukan berarti semua Agent bekerja tanpa henti sejak awal hingga akhir.
Selain itu, 47 proposisi yang ditangguhkan sementara berbeda dengan 47 lema dalam input yang telah ditentukan. Jangan mencampuradukkan keduanya saat membaca materi resmi.
Langlands–Tunnell: 750 Agent Bersatu Menaklukkan Bagian Tersulit dalam Formalisasi Teorema Terakhir Fermat
Menjelang garis akhir, tim menghadapi tantangan tersulit: pernyataan terkait Langlands–Tunnell, hasil matematika penting dalam jalur pembuktian Wiles. Agent yang lebih dulu menangani bagian ini memperkirakan bahwa tugasnya mungkin membutuhkan 700 ribu hingga 1 juta baris kode Lean, dan menilai peluang menyelesaikannya dalam waktu yang tersisa kurang dari 1%.
Lead kemudian mengerahkan sekitar 750 Helper untuk berfokus pada tugas ini. Para Agent menyusun sendiri pohon tugas bertingkat:
- Dibagi menjadi 10 bagian utama;
- Terdiri dari 2.418 subtugas;
- Pohon tugas mencapai kedalaman 10 tingkat;
- Ratusan Agent mengerjakan subtugas yang berbeda secara bersamaan.
Langlands–Tunnell selesai pada jam ke-28,4, lalu Teorema Terakhir Fermat selesai 0,3 jam kemudian. Kasus ini menunjukkan bahwa nilai kerja paralel berskala besar bukan sekadar “semakin banyak orang, semakin cepat perhitungannya”. Yang lebih penting adalah memecah masalah besar yang sulit dikerjakan secara langsung menjadi banyak tugas kecil yang dapat dikerjakan secara mandiri, diverifikasi satu per satu, lalu digabungkan. Jika pembagiannya tidak dirancang dengan baik, 750 Agent hanya akan saling menunggu atau mengulang pekerjaan yang sama.
Mengapa Formalisasi Teorema Terakhir Fermat Berhasil: Verifikasi Lean dan Mekanisme Keamanan
Dari sudut pandang keandalan rekayasa, eksperimen ini mengandalkan tiga lapis perlindungan.
Lapisan pertama adalah verifikasi hasil. Setiap subpernyataan harus lolos pemeriksaan Lean sebelum dapat dimasukkan ke cabang utama. Tabel Landed hanya mencatat pekerjaan yang sudah lolos pemeriksaan. Bukti akhir diverifikasi oleh pemeriksa kernel resmi. Lead Agent mencatat pernyataan berikut: “Teorema Terakhir Fermat sudah masuk ke cabang utama dan diperiksa oleh pemeriksa resmi.”
Lapisan kedua adalah isolasi kolaborasi. Sandbox terpisah dan cabang Git yang mandiri sangat mengurangi konflik file dan gangguan antar-Agent.
Lapisan ketiga adalah batas keamanan. Eksperimen ini menggunakan model tahap awal yang belum menjalani evaluasi penyelarasan sebelum rilis resmi. Karena itu, Anthropic menerapkan beberapa pembatasan:
- Akses internet dan akses langsung ke sandbox Agent lain dilarang;
- Perintah dijalankan menggunakan akun tanpa hak istimewa;
- Komunikasi API, Git, dan basis data dikelola melalui Gateway eksternal;
- Klasifikator waktu nyata memeriksa perintah Shell dan perubahan file, sementara pemantau luring meninjau ulang catatan operasi.
Eksperimen ini menghasilkan lebih dari 1 juta pemanggilan alat, tetapi tidak ada satu pun yang mencapai tingkat yang mengharuskan pemblokiran. Anthropic juga menyatakan bahwa setelah eksperimen, mereka menambahkan pemantauan rantai pemikiran secara paralel. Kesimpulannya: keandalan sistem Agent tidak cukup dinilai dari kemampuannya menyelesaikan tugas. Sistem juga harus memiliki verifikasi independen, batas izin, dan lingkungan eksekusi yang dapat dilacak.
Dari 11 hari menjadi 28,7 jam: perbandingan dua eksperimen Claude Fable 5.2
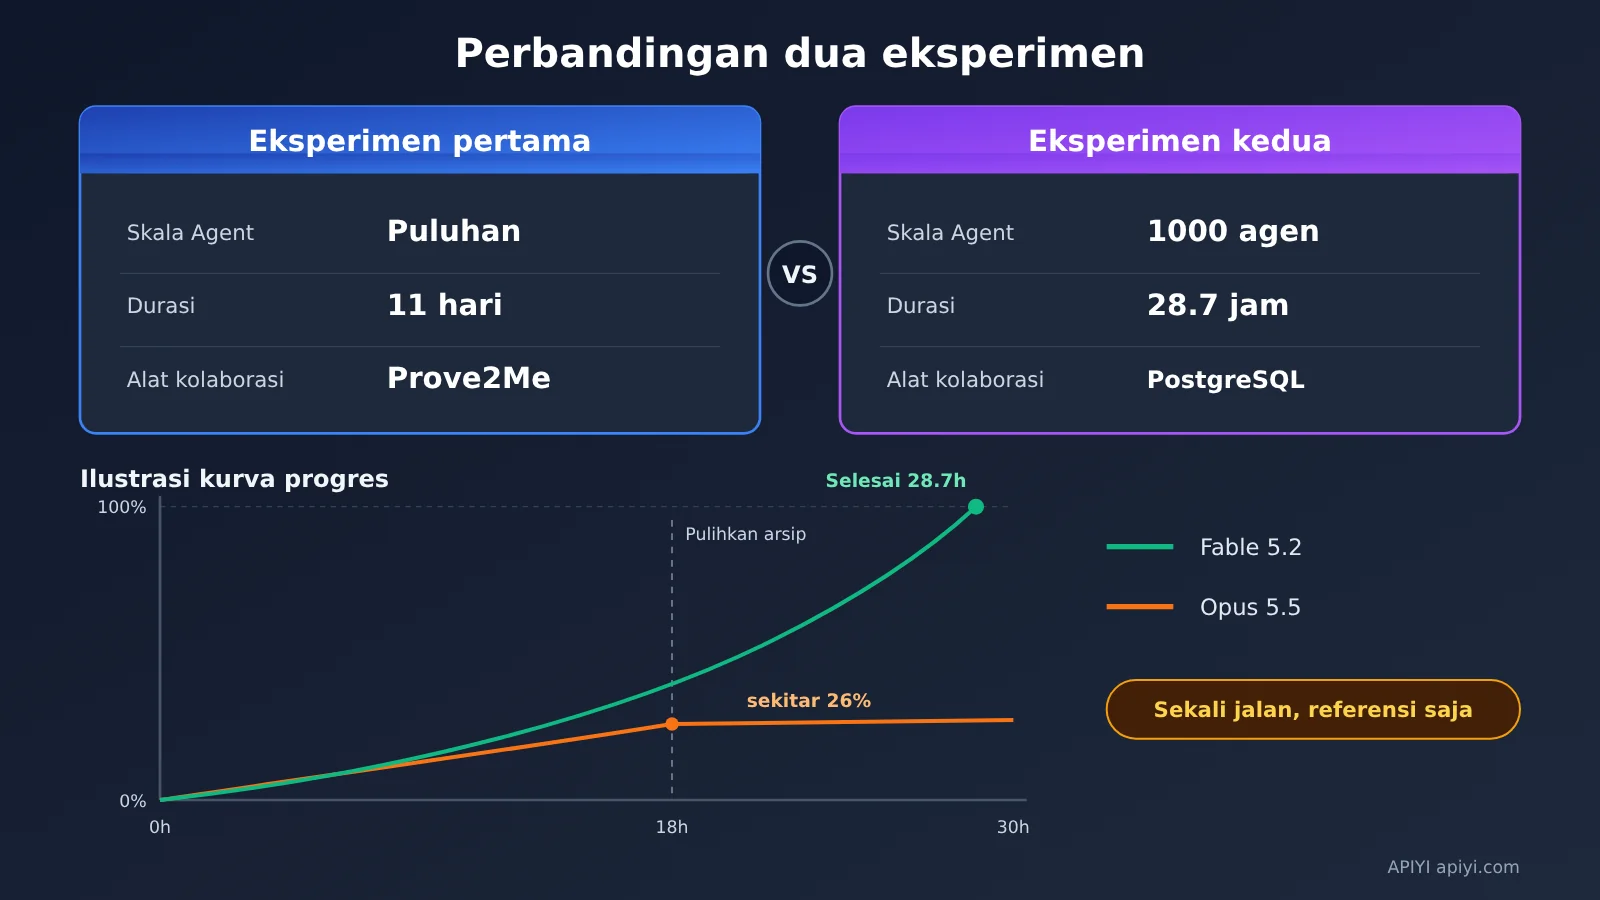
Kedua eksperimen formalisasi Teorema Terakhir Fermat ini menggunakan metrik yang berbeda, jadi sebaiknya dilihat secara terpisah:
| Metrik | Pertama (diumumkan September 2026) | Kedua (diumumkan 9 November 2026) |
|---|---|---|
| Model | Model riset internal (kurang lebih setara dengan Fable 5.1) | Fable 5.2 versi awal |
| Jumlah agen | Puluhan | 1000 |
| Waktu eksekusi | 11 hari | 28,7 jam |
| Token keluaran | Sekitar 6 miliar | Menurut pengumuman resmi, turun menjadi sekitar sepertiga dari eksperimen pertama |
| Panjang bukti | Acuan (sekitar 13 juta baris kode Lean) | Sekitar 1/7 dari eksperimen pertama |
| Platform kolaborasi | Prove2Me + multi-agent harness Claude Code | Alat umum + PostgreSQL |
| Panduan manusia | Peneliti Tianyi Peng memberikan sedikit panduan tingkat tinggi | Tidak ada panduan berkelanjutan terkait proses matematika |
Perlu ditekankan bahwa angka 6 miliar Token, 13 juta baris kode, dan sekitar 30.300 teorema semuanya merujuk pada eksperimen pertama. Pihak resmi belum mengumumkan jumlah Token absolut, total biaya, maupun jumlah baris kode yang tepat untuk eksperimen kedua.
Pada tahap awal, eksperimen pertama juga sempat mengalami kendala: agen kesulitan memahami keadaan proyek secara keseluruhan dan tidak tahu pekerjaan yang sudah diselesaikan agen lain, sehingga terjadi pekerjaan berulang. Prove2Me, platform yang kemudian digunakan, memanfaatkan DAG untuk mengelola dependensi teorema, serta menyediakan status tugas, pencarian teorema, dan percepatan kompilasi. Perbedaan pada eksperimen kedua adalah platform khusus ini tidak lagi digunakan. Agen menyusun mekanisme kolaborasi sendiri dengan basis data umum dan Git, sementara lima tabel menjalankan fungsi serupa.
Anthropic juga melakukan uji pembanding dengan konfigurasi 1000 agen yang sama: Opus 5.5 menyelesaikan sekitar 26% dalam 18 jam, lalu hampir tidak menunjukkan kemajuan baru hingga jam ke-30. Fable 5.2 menyelesaikan teorema akhir dalam 28,7 jam. Kedua grup melanjutkan pekerjaan dari status tersimpan pada sekitar jam ke-18. Namun, setiap model hanya diuji satu kali, jadi hasil ini tidak cukup untuk menyimpulkan bahwa keduanya memiliki perbedaan umum pada semua tugas kompleks.
Analisis Dampak Eksperimen 1.000 AI Agent terhadap Perusahaan
Untuk developer: empat kemampuan utama sistem multi-agent
Jika latar belakang matematisnya disisihkan, kemampuan yang terungkap dalam eksperimen ini bisa dipetakan ke situasi yang umum di perusahaan:
| Kemampuan | Penerapan dalam eksperimen | Pemetaan ke situasi perusahaan |
|---|---|---|
| Menguraikan tugas kompleks | 2.418 subtugas, dengan pohon tugas hingga 10 tingkat | Refaktor kode berskala besar, laporan riset kompleks |
| Menjadwalkan sumber daya secara dinamis | Menunda soal sulit dan mengerahkan 750 Helper untuk mengerjakannya | Mengalokasikan ulang Agent dan daya komputasi berdasarkan prioritas |
| Mengelola status bersama | Lima tabel PostgreSQL + penggabungan Git | Papan tugas terpadu untuk mengurangi pekerjaan berulang |
| Memverifikasi hasil secara independen | Kernel Lean memeriksa setiap kontribusi | Pengujian unit, validasi data, tinjauan manual |
Bagi developer, pelajaran paling langsung adalah: Anda tidak perlu langsung membangun platform khusus yang rumit. Database bersama yang dirancang dengan baik, ditambah kontrol versi, sudah cukup untuk mendukung kolaborasi dalam skala besar. Berikut contoh sederhana pemanggilan model:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI
)

response = client.chat.completions.create(
    model="claude-fable-5-2",  # Gunakan nama model yang tercantum di platform
    messages=[{"role": "user", "content": "把这个任务拆成可独立验证的子任务"}]
)
print(response.choices[0].message.content)
Lihat contoh kode kumpulan tugas Lead / Helper
import sqlite3
import openai

# Secara lokal, gunakan SQLite untuk menyimulasikan tabel Subtasks / Landed dalam eksperimen (eksperimen sebenarnya menggunakan PostgreSQL)
db = sqlite3.connect("board.db")
db.execute("CREATE TABLE IF NOT EXISTS subtasks (id INTEGER PRIMARY KEY, goal TEXT, status TEXT, owner TEXT)")
db.execute("CREATE TABLE IF NOT EXISTS landed (task_id INTEGER, result TEXT)")

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def lead_plan(goal: str):
    """Lead: uraikan tugas dan masukkan ke kumpulan tugas."""
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": f"将目标拆为3-5个子任务,每行一个:{goal}"}]
    )
    for line in resp.choices[0].message.content.splitlines():
        if line.strip():
            db.execute("INSERT INTO subtasks (goal, status) VALUES (?, 'open')", (line.strip(),))
    db.commit()

def verify(result: str) -> bool:
    """Validator independen: dalam penggunaan nyata, ganti dengan pengujian, skrip validasi, atau pemeriksaan Lean."""
    return len(result) > 0

def helper_claim(name: str):
    """Helper: ambil tugas secara aktif dan masukkan ke landed hanya jika lolos verifikasi."""
    row = db.execute("SELECT id, goal FROM subtasks WHERE status='open' LIMIT 1").fetchone()
    if not row:
        return
    task_id, goal = row
    db.execute("UPDATE subtasks SET status='doing', owner=? WHERE id=?", (name, task_id))
    db.commit()
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": goal}]
    )
    result = resp.choices[0].message.content
    if verify(result):
        db.execute("INSERT INTO landed VALUES (?, ?)", (task_id, result))
        db.execute("UPDATE subtasks SET status='done' WHERE id=?", (task_id,))
    else:
        db.execute("UPDATE subtasks SET status='open', owner=NULL WHERE id=?", (task_id,))
    db.commit()

lead_plan("为一个开源库补全单元测试")
for i in range(3):
    helper_claim(f"helper-{i}")
🚀 Saran untuk mulai cepat: Untuk membuat prototipe skala kecil dengan alur “Lead menguraikan tugas + Helper mengambil tugas + verifikasi independen”, Anda bisa memulai dengan mendapatkan kuota uji coba gratis melalui APIYI di apiyi.com. Platform ini menyediakan antarmuka yang kompatibel dengan OpenAI. Satu kunci API bisa digunakan untuk beralih antara model Claude, GPT, Gemini, dan lainnya, sehingga Anda dapat membandingkan kualitas penguraian tugas saat model yang berbeda berperan sebagai Lead.
Bagi industri: batasan lebih penting daripada angka
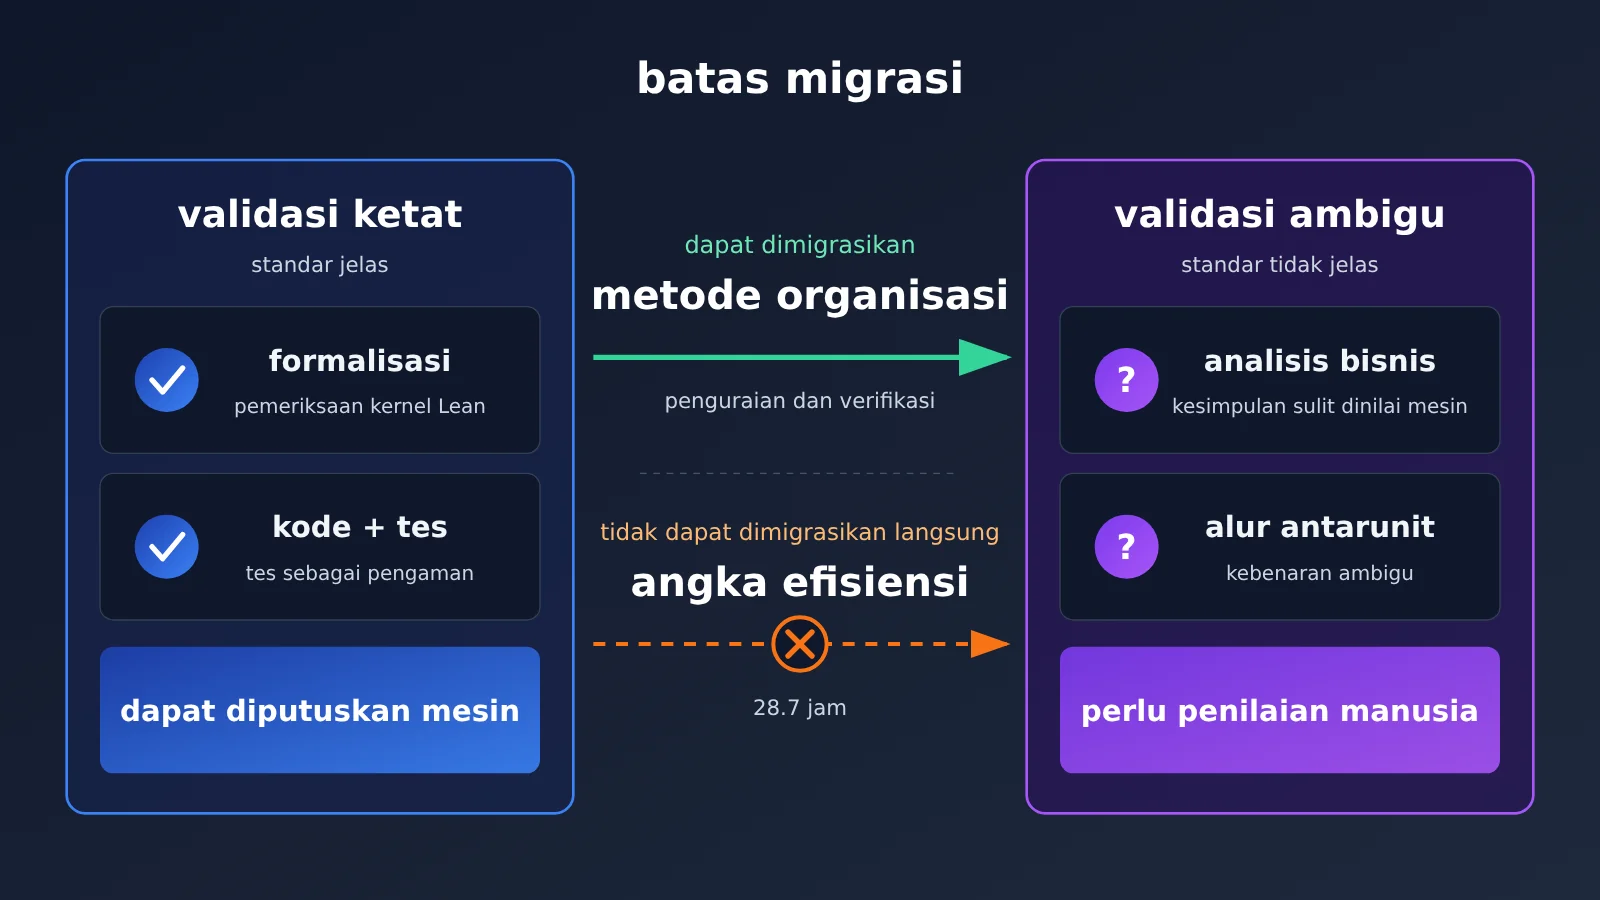
Satu hal yang perlu disikapi dengan tenang: formalisasi matematika memiliki verifier yang ketat dan objektif seperti Lean, sedangkan sebagian besar tugas perusahaan tidak memiliki standar kebenaran yang sama jelasnya. Kode bisa mengandalkan pengujian, tetapi kebenaran analisis pasar atau alur kerja lintas departemen sering kali sulit ditentukan oleh mesin. Karena itu, 28.7 jam dan tingkat keberhasilan dalam eksperimen ini tidak bisa langsung diterapkan pada sistem Agent di perusahaan.
Anthropic juga mencantumkan sejumlah keterbatasan: Agent bisa terlalu cepat menyimpulkan bahwa tugas tidak dapat diselesaikan—misalnya, sebagian besar dari 47 teorema yang sempat ditangguhkan pada tahap awal akhirnya berhasil diselesaikan; arahan manusia tetap bermanfaat saat menghadapi titik sulit; dan alat khusus untuk bidang tertentu seperti Prove2Me mungkin masih dapat meningkatkan efisiensi kompilasi, penelusuran, dan kolaborasi. Eksperimen ini tidak membuktikan bahwa semakin banyak Agent selalu semakin baik, atau bahwa pakar manusia dan Harness khusus sudah tidak diperlukan.
💡 Saran teknis: Saat menguji coba solusi multi-Agent di perusahaan, mulailah dengan tugas yang memiliki kriteria verifikasi jelas, seperti perubahan kode yang didukung pengujian. Setelah itu, perluas cakupannya secara bertahap. Dengan sistem bayar sesuai pemakaian dari APIYI apiyi.com, Anda bisa mengevaluasi proses pemecahan tugas dan verifikasi menggunakan sejumlah kecil Agent terlebih dahulu, lalu memutuskan apakah perlu menambah investasi.
FAQ
Q1: Apakah eksperimen ini membuktikan Teorema Terakhir Fermat dengan AI?
Tidak. Teorema Terakhir Fermat secara resmi dibuktikan oleh Wiles pada 1995 (bersama Taylor, yang membantu memperbaiki masalah penting dalam pembuktiannya). Eksperimen ini mengubah jalur pembuktian yang sudah ada menjadi bukti formal yang dapat diperiksa Lean, dengan berbekal 60 proposisi, garis besar langkah pembuktian, definisi, dan 47 lemma yang sudah terbukti.
Q2: Mengapa hanya 54 dari 60 proposisi yang ditandai telah terbukti?
Dalam statistik pada jam ke-30, 5 proposisi alternatif ternyata tidak lagi diperlukan, sedangkan 1 proposisi lainnya ditinggalkan. Teorema akhir sudah lolos pemeriksaan pada jam ke-28,7, jadi tidak semua dari 60 proposisi yang dicantumkan di awal harus diselesaikan.
Q3: Berapa harga API Claude Fable 5.2?
Harga resmi adalah $8 per juta Token untuk input dan $40 per juta Token untuk output. Fast Mode masing-masing seharga $16 dan $80. Pembacaan cache dikenai biaya $0,20 per juta Token, sedangkan Batch API mendapat diskon 50%. Jendela konteksnya 1 juta Token, dengan output maksimum 128 ribu Token. Total biaya eksperimen kedua tidak diumumkan secara resmi, jadi tidak bisa diperkirakan dengan mengalikan 6 miliar Token dari eksperimen pertama dengan harga per Token.
Q4: Bagaimana cara mencoba Claude Fable 5.2 dengan cepat melalui API?
Daftar di APIYI apiyi.com dan dapatkan kunci API, lalu atur `base_url` ke `https://api.apiyi.com/v1`. Setelah itu, Anda bisa langsung menggunakan contoh kode di artikel ini. Pengguna baru mendapat kuota uji coba gratis, cocok untuk mulai membuat prototipe kecil dengan banyak Agent.
Q5: Apakah sistem multi-Agent selalu membutuhkan PostgreSQL?
Tidak. Yang penting adalah adanya sumber status bersama yang bisa dibaca dan ditulis oleh semua Agent, disertai kontrol versi dan verifikasi independen. Untuk prototipe kecil, SQLite atau Redis sudah cukup. Saat memanggil model melalui APIYI apiyi.com, penyimpanan status menjadi tanggung jawab sistem Anda sendiri, sehingga keduanya bisa dikombinasikan dengan bebas.
Q6: Apa saja keterbatasan eksperimen ini yang sudah diketahui?
Pihak resmi menyebutnya sebagai eksperimen sederhana. Perbandingan antara Fable dan Opus masing-masing hanya dijalankan satu kali. Model yang digunakan masih versi awal dan memerlukan beberapa lapis perlindungan keamanan. Agent juga pernah keliru menyerah terlalu dini. Bimbingan manusia dan alat khusus untuk bidang terkait tetap berguna.
Poin Penting: 1.000 AI Agent Memformalkan Teorema Terakhir Fermat
- Inti eksperimen: Memformalkan bukti yang sudah ada menjadi kode yang dapat diperiksa Lean, bukan membuktikan Teorema Terakhir Fermat untuk pertama kalinya.
- Angka penting: 1.000 Agent Fable 5.2 versi awal menyelesaikan tugas dalam 28,7 jam, dan hasilnya lolos pemeriksaan kernel resmi Lean.
- Struktur kerja: 1 Lead + 999 Helper bekerja sama melalui lima tabel basis data bersama dan Git.
- Cara menuntaskan tantangan: Sekitar 750 Agent membagi Langlands–Tunnell menjadi 2.418 subtugas dengan kedalaman maksimum 10 tingkat.
- Sumber keandalan: Verifikasi independen oleh Lean dan isolasi sandbox. Lebih dari 1 juta pemanggilan alat berlangsung tanpa perlu intervensi.
- Batas penerapan: Tugas di perusahaan sering kali tidak memiliki validator seperti Lean, sehingga angka efisiensi ini tidak bisa langsung diterapkan pada konteks lain.
- Cara mencoba: Anda bisa memakai antarmuka terpadu APIYI apiyi.com untuk membuat prototipe kolaborasi Lead/Helper dalam skala kecil.
Kesimpulan
Poin utama dari eksperimen seribu Agent Claude Fable 5.2 ini:
- Sistem lebih penting daripada satu komponen: Kemampuan model, dekomposisi tugas, status bersama, eksekusi paralel, dan verifikasi mesin bersama-sama menghasilkan penyelesaian dalam 28,7 jam.
- Verifikasi menjadi dasar kepercayaan: Pemeriksaan kernel Lean membedakan dengan tegas antara “model mengaku selesai” dan “tugas benar-benar selesai”.
- Batasan perlu dijelaskan: Masukan yang sudah ditentukan, model versi awal, pengujian pembanding tunggal, dan sifat eksperimen skala kecil menjadi alasan hasil ini tidak boleh ditafsirkan secara berlebihan.
Eksperimen ini menyisakan pertanyaan penting bagi industri: Apakah persaingan sistem AI di masa depan akan bergeser dari kemampuan satu model ke kemampuan sistem dalam mengatur dan menjadwalkan banyak agen untuk menyelesaikan tugas kompleks? Para developer bisa mulai mencobanya sekarang dengan prototipe multi-Agent skala kecil yang dilengkapi verifikasi independen. APIYI apiyi.com direkomendasikan untuk menguji hasil dengan cepat. Platform ini menyediakan kuota uji coba gratis dan antarmuka terpadu untuk berbagai model.
📚 Referensi
- Blog rekayasa Anthropic: Safely scaling multi-agent teams with Claude Fable 5.2
- Tautan:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2 -
Keterangan: Struktur organisasi, kolaborasi basis data, mekanisme keamanan, dan perbandingan dengan Opus dalam eksperimen kedua
-
Artikel riset Anthropic: Formalizing Fermat’s Last Theorem
- Tautan:
anthropic.com/research/formalizing-fermats-last-theorem -
Keterangan: Data eksperimen formalisasi pertama dan cara kolaborasi dengan Prove2Me
-
Repositori bukti Lean resmi Anthropic: Bukti formalisasi versi pertama
- Tautan:
github.com/anthropics/fermats-last-theorem -
Keterangan: Kode bukti versi September yang dipublikasikan. Data di README tidak sama dengan statistik eksperimen November
-
Contoh resmi Lean: Formalizing Fermat’s Last Theorem
- Tautan:
lean-lang.org/use-cases/flt -
Keterangan: Mengenal Lean dan latar belakang matematika formal
-
Dokumentasi model Fable 5.2: Spesifikasi model dan migrasi API
- Tautan:
platform.claude.com/docs/en/models/fable-5-2/overview - Keterangan: Jendela konteks, batas output, dan informasi harga
Penulis: Tim teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama situs APIYI. Informasi lainnya tersedia di pusat dokumentasi docs.apiyi.com