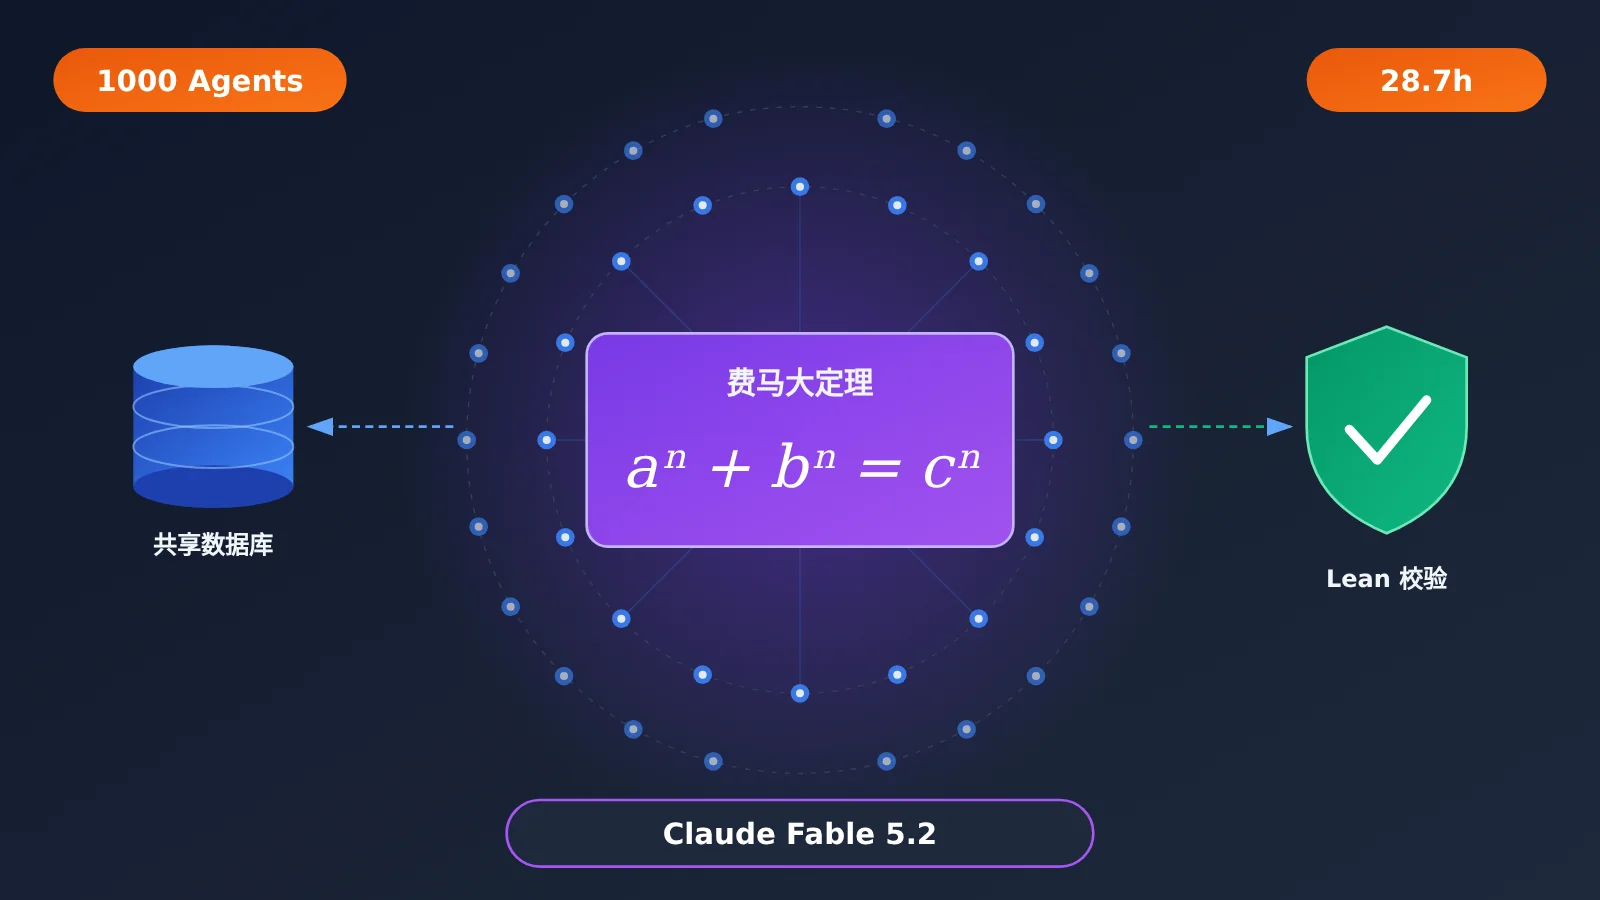
2026年11月9日,Anthropic 在官方工程博客公布了一项多智能体实验:1000个 Claude Fable 5.2 Agent 协作,用28.7小时完成了费马大定理的计算机形式化,最终证明通过了 Lean 官方内核检查。两个月前的第一次形式化实验由数十个 Agent 完成,用了11天。
这不是“AI 在30小时内证明了费马大定理”。 该定理早在20世纪90年代就由 Andrew Wiles 与 Richard Taylor 证明。这次实验做的事情,是把已有的证明路线翻译成计算机可以逐步检查的形式化证明。因此,本文真正要回答的问题是:1000个 AI Agent 怎样在不到30小时里,协作完成这样一项复杂工程?
核心价值:读完本文,你会了解这次费马大定理形式化实验的关键数据、1000个 Agent 的组织方式和验证机制,以及它对企业 Agent 系统的参考价值和边界。
费马大定理形式化实验核心信息速览
先用一张表交代这次 Claude Fable 5.2 实验的基本事实。注意几个容易混淆的口径:模型是早期版本,实验有预设输入,官方也明确把它定位为 toy experiment(实验性质的演示)。
| 信息项 | 详情 |
|---|---|
| 发布时间 | 2026年11月9日,Anthropic 官方工程博客 |
| 使用模型 | Claude Fable 5.2 的早期版本(尚未完成正式发布前的对齐评估) |
| 团队规模 | 1名 Lead Agent + 999名 Helper Agents |
| 完成时间 | 第28.7小时,最终定理通过 Lean 官方内核检查(官方公告四舍五入为30小时) |
| 预设输入 | 60个命题、经典证明路线的一句话梗概、相关定义、前次形式化中已证明的47条引理 |
| 工具环境 | Lean 工具链、Mathlib、Git、共享 PostgreSQL 数据库、独立虚拟机沙箱 |
| 官方定位 | toy experiment,不是对费马大定理的首次证明 |
费马大定理形式化:实验前提要先讲清
研究人员并不是只给出一句“请证明费马大定理”就放手不管。Agent 拿到了60个命题(包括最终定理和59个中间里程碑)、路线梗概、定义,以及上一次实验已经证明的47条引理,lead 与 helper 的角色也是研究人员预先设定的。
所以这次实验检验的是另一种能力:在给定数学基础和工具的前提下,一个大规模 Agent 团队能否自己组织起来,把已知路线完整落成机器可检查的证明。这比“AI 会不会做数学”更接近工程问题。
为什么费马大定理形式化如此困难
费马大定理的表述很简单:当整数 n 大于2时,不存在正整数 a、b、c 满足 a^n + b^n = c^n。它由 Pierre de Fermat 在17世纪提出,悬而未决350多年。Wiles 在1993年宣布证明,1994年与 Taylor 修正了关键漏洞,1995年正式发表。原始证明约129页,大量依赖现代数论和代数几何的已有成果。
人类数学家写证明时,可以说“由前述结论显然可得”,读者会自动补上中间步骤。计算机没有这种默契,它必须知道每一步用了哪个定义、哪条定理、哪条推理规则。这就是形式化困难的根源:一条人类眼中的“显然”,落到代码里可能是成百上千行。
Lean、Mathlib 与数学形式化
理解这次实验,需要先分清三个概念:
- Lean:交互式定理证明器,负责检查一份证明是否严格符合形式逻辑规则。
- Mathlib:Lean 的数学库,收录了大量已经形式化的定义和定理,相当于可以直接引用的“标准库”。
- 数学形式化:把人类可读的数学证明,转换成计算机能完整验证的逻辑结构。
最关键的一点是:AI 负责构造证明,Lean 内核负责检查证明。模型说“我证明了”,和 Lean 实际接受这份证明,是两件完全不同的事。这次实验能被认真对待,正是因为最终结果不依赖模型的自我判断,而是通过了独立的机器检查。
1000个 AI Agent 如何协作:一套由 AI 运行的项目管理系统
这是 Claude Fable 5.2 实验里最值得研究的部分。1000个 Agent 并不是各自埋头解题,而是形成了一套带任务管理、资源调度和动态调整能力的协作系统。
Claude Fable 5.2 团队的组织架构
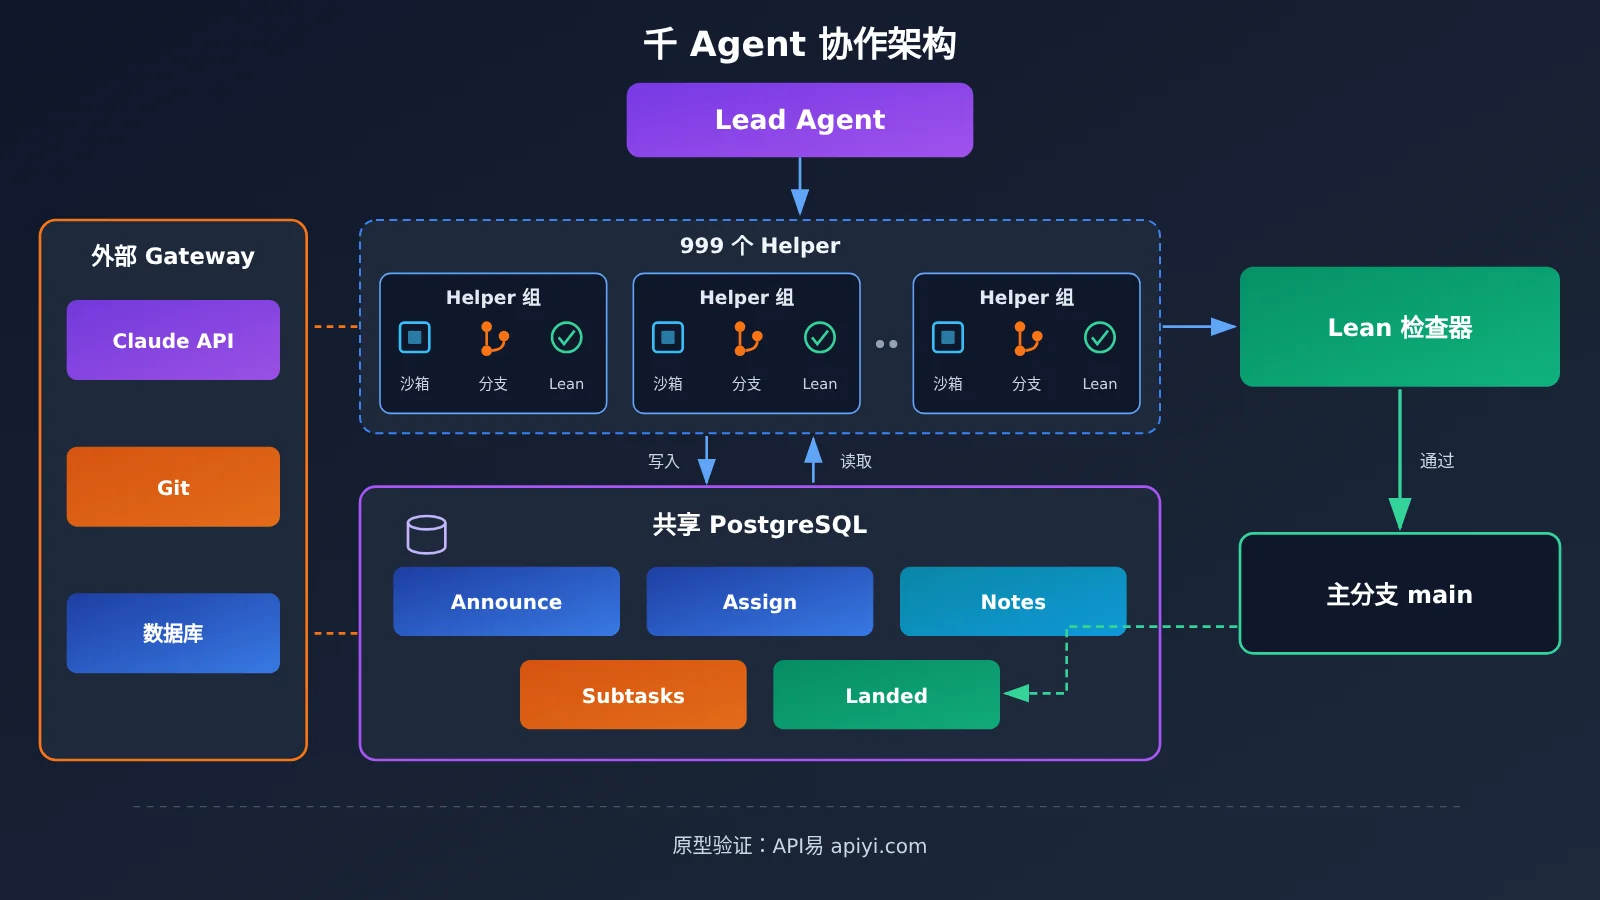
团队采用简单的层级结构:1个 Lead Agent 负责总体规划、任务拆解和进度管理,999个 Helper Agents 负责具体证明。每个 Agent 都有自己的轻量级虚拟机沙箱,可以使用 Shell、文件编辑器、Lean 工具链、Mathlib,拥有自己的 Git 分支,并能向主分支提交 Merge Request。
所有 Agent 都没有直接的互联网访问权限,与 Claude API、Git 和数据库的通信都要经过外部 Gateway。独立沙箱加独立分支,让1000个 Agent 同时改代码时不会互相覆盖文件。
共享 PostgreSQL:AI Agent 的协作中枢
1000个 Agent 如果靠两两发消息协作,通信量会迅速失控。Lead Agent 的做法是在实验开始后10分钟内建立五张共享数据库表,把沟通变成“读写同一块看板”。
| 表名 | 作用 | 在协作中的角色 |
|---|---|---|
| Announce | 发布团队指令 | 全员广播,类似项目公告栏 |
| Assign | 分配任务和负责人 | 明确“谁在做什么”,避免撞车 |
| Notes | 记录进度、问题和工作计划 | 共享上下文,降低信息孤岛 |
| Subtasks | 管理细分任务,供 Agent 领取 | 任务池,支撑自主认领 |
| Landed | 记录已完成并通过检查的工作 | 可信成果清单,只收录验证过的内容 |
这套机制的价值在于:Agent 不需要逐一联系其他999个 Agent,只要查数据库就能知道有哪些任务、哪些已经完成、哪些存在依赖。成果则通过 Git 合并进主分支。官方披露的数据显示,整个过程约有36,612次数据库写入和311,734次读取,其中约20,600次写入属于 Notes,约14,800次属于 Subtasks(统计不含大部分脚本调用)。读远多于写,也说明 Agent 大部分时间都在“查看全局状态”。
动态任务分配:从固定派工到主动领活
这次实验的调度过程并不是一成不变的。下面这张时间线可以看出组织方式是怎样逐步演化的:
| 时间点 | 关键事件 |
|---|---|
| 第10分钟 | Lead 建立五张共享数据库表 |
| 约第27分钟 | 已证明3个命题 |
| 随后 | Lead 将47个判断为预算内难以完成的命题暂时搁置,把人力集中到另外10个命题 |
| 约第70分钟 | 这10个命题全部完成,Lead 重新分配 Agent 处理更难的命题 |
| 约第3小时 | Lead 允许空闲 Agent 不必等待分配,自行认领任务 |
| 第5.6小时 | 73个 Helper 已创建756个任务 |
| 约第18小时 | 从上一次保存状态恢复运行,继续执行12小时 |
| 第28.4小时 | Langlands–Tunnell 相关命题完成 |
| 第28.7小时 | 费马大定理完成并通过官方内核检查 |
两个细节值得注意。第一,从“Lead 派工”到“Agent 自主领取”的转变,相当于团队从集中调度切换到任务池模式,减少了 Lead 成为瓶颈的风险。第二,实验在第18小时左右从保存状态恢复过,所以28.7小时并不代表所有 Agent 从头到尾从未中断。
另外,被暂时搁置的47个命题,与预设输入里的47条引理是两回事,读官方材料时不要混在一起。
Langlands–Tunnell:750个 Agent 集中攻克费马大定理形式化最难关卡
临近终点时,团队遇到了最难的一块:Langlands–Tunnell 相关命题,这是 Wiles 证明路线中的重要数学结果。早期负责这部分的 Agent 估计,它可能需要70万到100万行 Lean 代码,并认为在剩余时间内完成的概率低于1%。
Lead 随后把约750个 Helper 集中到这项任务上。Agent 自行搭建了一棵多层任务树:
- 划分为10个主要区域;
- 共建立2,418个子任务;
- 任务树最深达到10层;
- 数百个 Agent 同时处理不同子任务。
结果是 Langlands–Tunnell 在第28.4小时完成,0.3小时后费马大定理完成。这个案例说明,大规模并行的价值不只是“人多算得快”。更关键的是把一个无法直接下手的大问题,拆成大量可以独立推进、单独验证、最后合并的小任务。如果拆分做不好,750个 Agent 只会互相等待或重复劳动。
费马大定理形式化为何成功:Lean 验证与安全机制
从工程可靠性看,这次实验靠的是三层保障。
第一层是结果验证。 每个子命题都必须通过 Lean 检查才能提交到主分支,Landed 表只记录通过检查的工作。最终定理由官方内核检查器验证,Lead Agent 记录的原话是:“Fermat’s Last Theorem is on main, kernel-checked by the official checker.”
第二层是协作隔离。 独立沙箱和独立 Git 分支,让 Agent 之间的文件冲突和相互干扰降到很低。
第三层是安全边界。 实验运行的是尚未完成正式发布前对齐评估的早期模型,因此 Anthropic 设置了多层限制:
- 禁止互联网访问,禁止直接访问其他 Agent 的沙箱;
- 使用非特权账户执行命令;
- 通过外部 Gateway 管理 API、Git 和数据库通信;
- 实时分类器检查 Shell 命令和文件修改,离线监控器复核操作记录。
实验共产生超过100万次工具调用,没有任何一次达到必须拦截的程度。Anthropic 还表示,实验后又增加了并行的思维链监控。这里的结论是:一个可靠的 Agent 系统,不能只看模型能不能完成任务,还必须有独立验证、权限边界和可追踪的执行环境。
从11天到28.7小时:Claude Fable 5.2 两次实验对比
两次费马大定理形式化实验的口径不同,需要分开看:
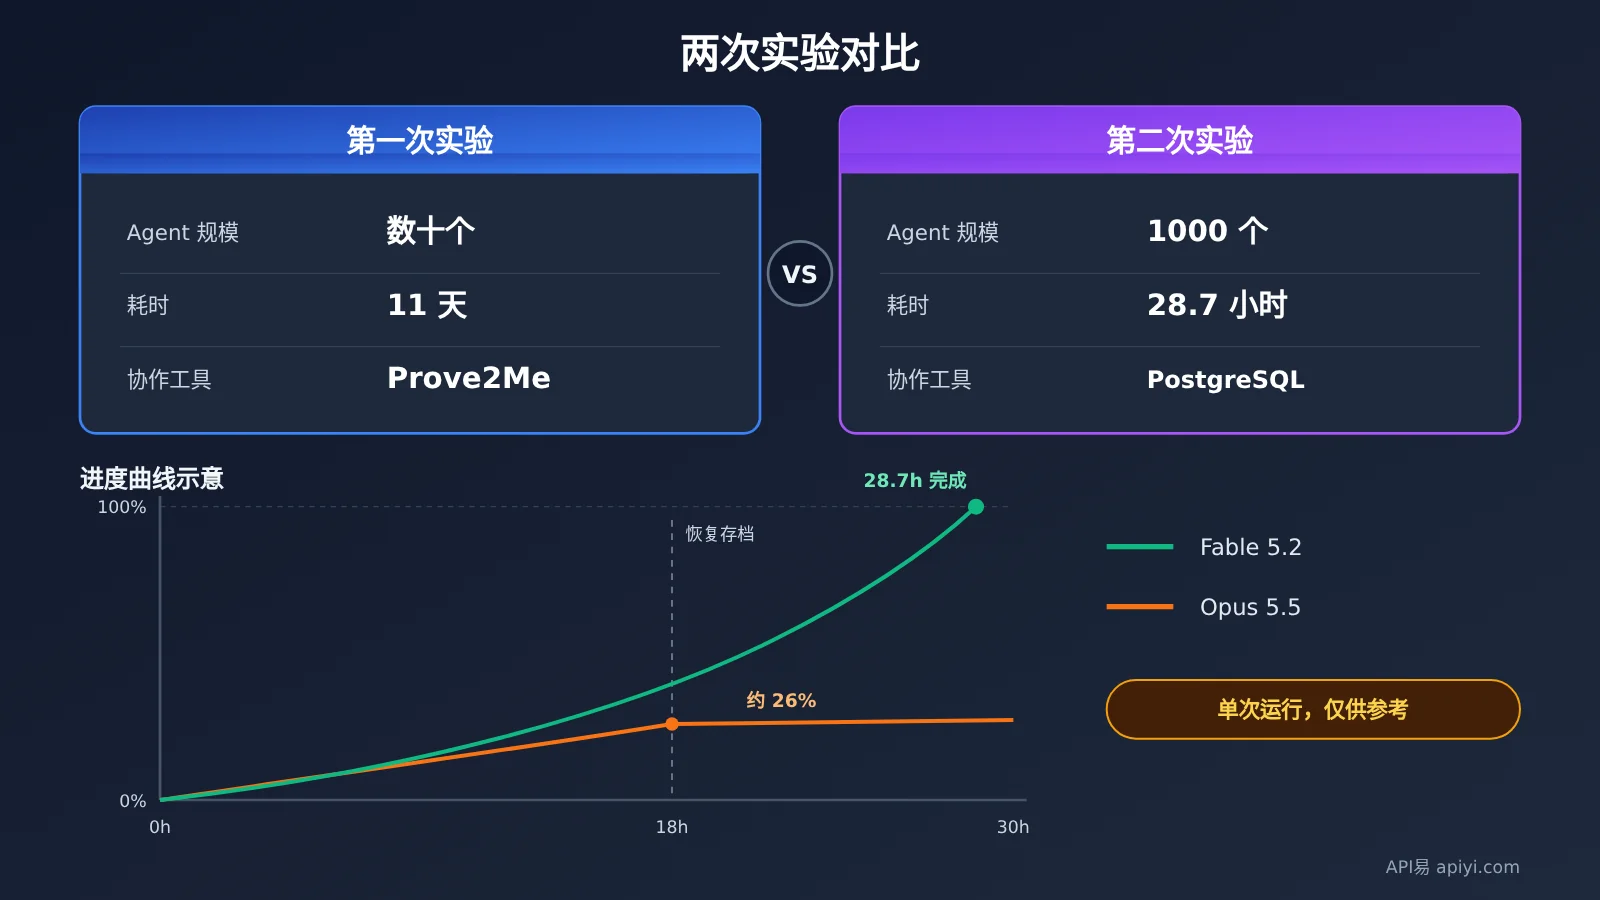
| 指标 | 第一次(2026年9月公布) | 第二次(2026年11月9日公布) |
|---|---|---|
| 模型 | 内部研究模型(与 Fable 5.1 大致同级) | 早期 Fable 5.2 |
| Agent 数量 | 数十个 | 1000个 |
| 执行时间 | 11天 | 28.7小时 |
| 输出 Token | 约60亿 | 官方称约降至第一次的三分之一 |
| 证明长度 | 基准(约1300万行 Lean 代码) | 约为第一次的1/7 |
| 协作平台 | Prove2Me + Claude Code 多 Agent Harness | 通用工具 + PostgreSQL |
| 人类指导 | 研究人员 Tianyi Peng 提供少量高层级指导 | 无持续的数学过程指导 |
需要强调,60亿 Token、1300万行代码、约30,300个定理这些数字都属于第一次实验。官方没有公布第二次实验的绝对 Token 数、总费用和精确代码行数。
第一次实验初期也走过弯路:Agent 难以掌握全局状态,不知道别人做完了什么,出现了重复劳动。后来引入的 Prove2Me 平台用 DAG 维护定理依赖,并提供任务状态、定理检索和编译加速。第二次实验的变化在于不再使用这个专用平台,而是让 Agent 用通用的数据库和 Git 自己搭出协作机制,五张表承担了类似的职能。
Anthropic 还在相同的1000 Agent 设置下做了对照:Opus 5.5 在18小时完成约26%,之后到30小时几乎没有新进展;Fable 5.2 在28.7小时完成最终定理。两组都在18小时左右从保存状态恢复。不过每个模型只跑了一次,不能据此推断两者在所有复杂任务上的普遍差距。
1000个 AI Agent 实验对企业的影响分析
对开发者:多智能体系统的四项关键能力
把数学背景剥掉,这次实验提炼出的能力可以对应到常见的企业场景:
| 能力 | 实验中的体现 | 企业场景映射 |
|---|---|---|
| 复杂任务拆解 | 2,418个子任务、最深10层的任务树 | 大型代码重构、复杂调研报告 |
| 动态资源调度 | 搁置难题、集中750个 Helper 攻关 | 按优先级重新分配 Agent 与算力 |
| 共享状态管理 | 五张 PostgreSQL 表 + Git 合并 | 统一任务看板,减少重复劳动 |
| 结果独立验证 | Lean 内核检查每个提交 | 单元测试、数据校验、人工审核 |
对开发者来说,最直接的启发是:不必一上来就搭复杂的专用平台,一个设计好的共享数据库加版本控制,就能撑起相当规模的协作。下面是调用模型的极简示例:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口
)

response = client.chat.completions.create(
    model="claude-fable-5-2",  # 模型名以平台模型列表为准
    messages=[{"role": "user", "content": "把这个任务拆成可独立验证的子任务"}]
)
print(response.choices[0].message.content)
查看 Lead / Helper 任务池示意代码
import sqlite3
import openai

# 本地用 SQLite 模拟实验中的 Subtasks / Landed 表(实验实际使用 PostgreSQL)
db = sqlite3.connect("board.db")
db.execute("CREATE TABLE IF NOT EXISTS subtasks (id INTEGER PRIMARY KEY, goal TEXT, status TEXT, owner TEXT)")
db.execute("CREATE TABLE IF NOT EXISTS landed (task_id INTEGER, result TEXT)")

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def lead_plan(goal: str):
    """Lead:拆解任务并写入任务池"""
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": f"将目标拆为3-5个子任务,每行一个:{goal}"}]
    )
    for line in resp.choices[0].message.content.splitlines():
        if line.strip():
            db.execute("INSERT INTO subtasks (goal, status) VALUES (?, 'open')", (line.strip(),))
    db.commit()

def verify(result: str) -> bool:
    """独立验证器:真实场景中应替换为测试、校验脚本或 Lean 检查"""
    return len(result) > 0

def helper_claim(name: str):
    """Helper:主动认领任务,验证通过才写入 landed"""
    row = db.execute("SELECT id, goal FROM subtasks WHERE status='open' LIMIT 1").fetchone()
    if not row:
        return
    task_id, goal = row
    db.execute("UPDATE subtasks SET status='doing', owner=? WHERE id=?", (name, task_id))
    db.commit()
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": goal}]
    )
    result = resp.choices[0].message.content
    if verify(result):
        db.execute("INSERT INTO landed VALUES (?, ?)", (task_id, result))
        db.execute("UPDATE subtasks SET status='done' WHERE id=?", (task_id,))
    else:
        db.execute("UPDATE subtasks SET status='open', owner=NULL WHERE id=?", (task_id,))
    db.commit()

lead_plan("为一个开源库补全单元测试")
for i in range(3):
    helper_claim(f"helper-{i}")
🚀 快速上手建议:想复现“Lead 拆解 + Helper 认领 + 独立验证”的小规模原型,可以先通过 API易 apiyi.com 获取免费测试额度。平台提供 OpenAI 兼容接口,一个 Key 即可切换 Claude、GPT、Gemini 等模型,方便比较不同模型担任 Lead 时的拆解质量。
对行业:边界比数字更重要
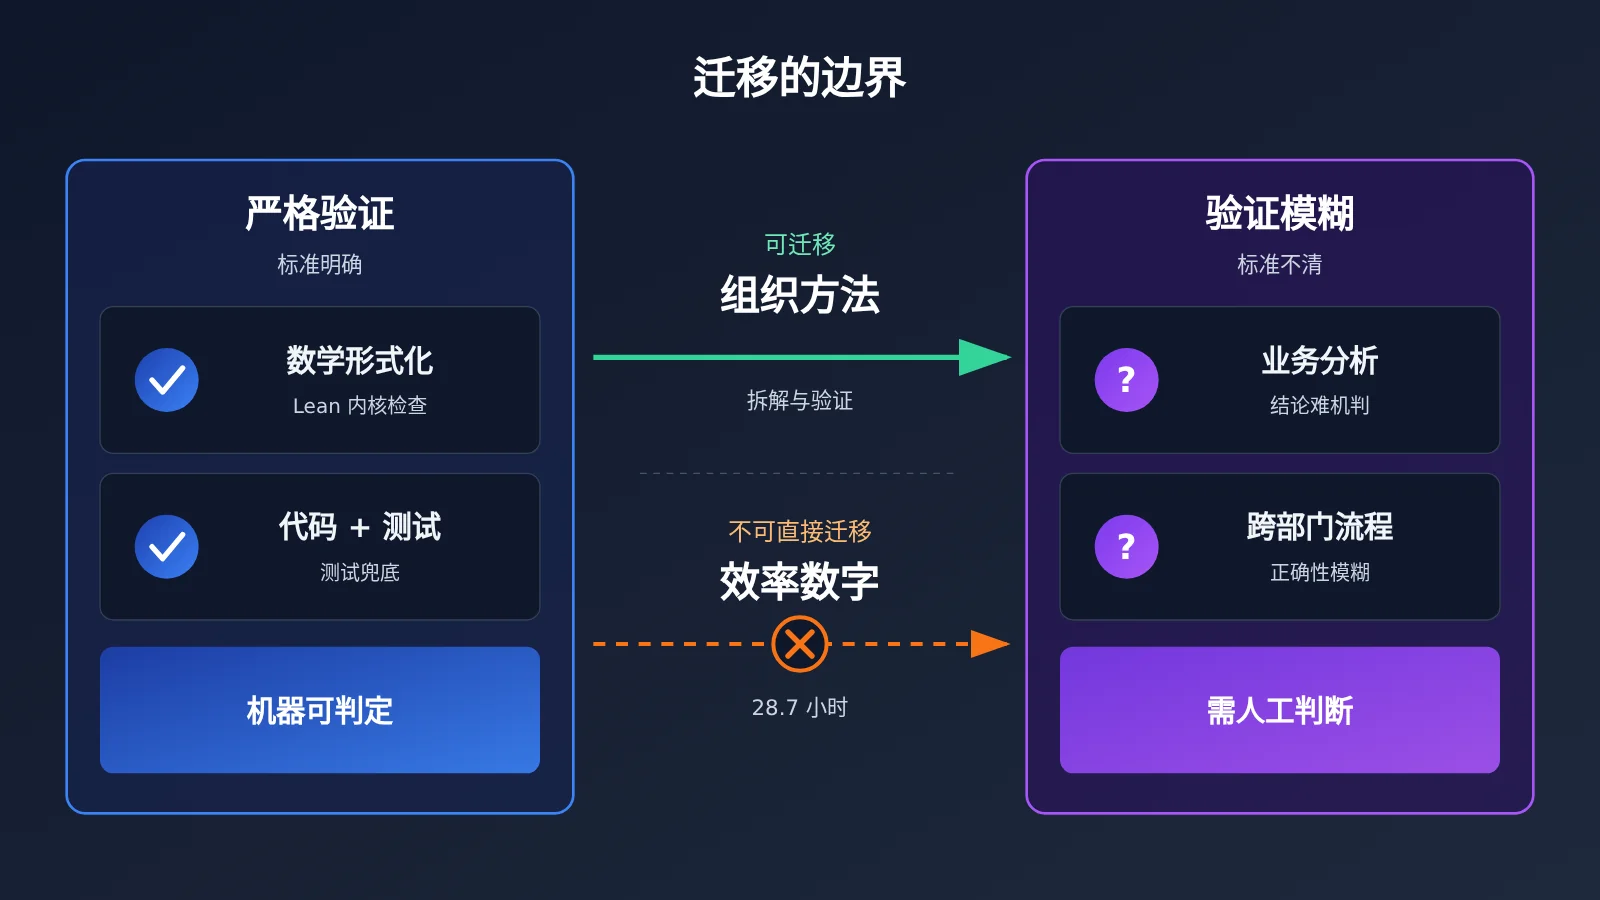
需要冷静看待的一点是:数学形式化有 Lean 这样严格、客观的验证器,而大多数企业任务没有同样明确的正确性标准。代码有测试可以兜底,但市场分析、跨部门流程的“正确”往往难以机器判定。因此,28.7小时和这次的成功率不能直接套用到企业 Agent 系统上。
Anthropic 自己也列出了局限:Agent 容易过早判断任务不可完成,比如早期被搁置的47个命题,后来大部分仍被完成;人类的方向性指导在困难节点依然有价值;Prove2Me 这类领域专用工具也可能继续提升编译、检索和协作效率。实验不能说明 Agent 越多越好,也不能说明人类专家和专用 Harness 已经不再需要。
💡 工程建议:在企业里试点多 Agent 方案时,建议先选择有明确验证标准的任务(如测试驱动的代码改造),再逐步扩大规模。借助 API易 apiyi.com 的按量计费,可以先用小规模 Agent 数量评估拆解和验证环节,再决定是否加大投入。
常见问题 FAQ
Q1:这次实验是 AI 证明了费马大定理吗?
不是。费马大定理在1995年由 Wiles 正式发表证明(与 Taylor 合作修正关键问题)。这次实验是在给定60个命题、路线梗概、定义和47条已证引理的前提下,把已有证明路线转化为 Lean 可检查的形式化证明。
Q2:为什么60个命题里只有54个被标记为已证明?
在第30小时的统计中,有5个替代命题后来不再需要,另有1个命题被放弃。最终定理在第28.7小时已经通过检查,并不需要把最初列出的60个命题全部完成。
Q3:Claude Fable 5.2 的 API 价格是多少?
官方标价为输入$8/百万Token、输出$40/百万Token;Fast Mode 分别为$16和$80,缓存读取$0.20/百万Token,Batch API 享50%折扣,上下文窗口1M Token,最大输出128K Token。第二次实验的总成本官方没有公布,不能用第一次的60亿 Token 乘以单价来估算。
Q4:如何通过 API 快速体验 Claude Fable 5.2?
在 API易 apiyi.com 注册并获取 API Key 后,把 base_url 设为 `https://api.apiyi.com/v1`,就可以直接使用本文的示例代码。新用户有免费测试额度,适合先做小规模多 Agent 原型。
Q5:多 Agent 系统一定需要 PostgreSQL 吗?
不一定。关键是要有一个所有 Agent 都能读写的共享状态源,加上版本控制和独立验证。小规模原型用 SQLite 或 Redis 就够了。通过 API易 apiyi.com 调用模型时,状态存储由你自己的系统负责,两者可以自由组合。
Q6:这次实验有哪些已知局限?
官方明确称之为 toy experiment。Fable 与 Opus 的对照各只运行了一次;使用的是早期模型,需要多层安全防护;Agent 曾错误地过早放弃任务;人类指导和领域专用工具仍有价值。
1000个 AI Agent 完成费马大定理形式化 Key Takeaways
- 实验本质:把已有证明形式化为 Lean 可检查的代码,不是首次证明费马大定理。
- 关键数字:1000个早期 Fable 5.2 Agent,28.7小时完成,并通过 Lean 官方内核检查。
- 组织核心:1个 Lead + 999个 Helper,靠五张共享数据库表和 Git 协作。
- 攻坚方式:约750个 Agent 将 Langlands–Tunnell 拆成2,418个子任务、最深10层。
- 可靠性来源:Lean 独立验证、沙箱隔离,超过100万次工具调用无需拦截。
- 适用边界:企业任务往往缺少 Lean 这样的验证器,效率数字不能直接外推。
- 上手方式:可通过 API易 apiyi.com 的统一接口,小规模复现 Lead/Helper 协作原型。
总结
Claude Fable 5.2 这次千 Agent 实验的核心要点:
- 系统大于单点:模型能力、任务分解、共享状态、并行执行和机器验证共同促成了28.7小时的结果。
- 验证是信任基础:Lean 内核检查让“模型声称完成”和“真正完成”被严格区分开。
- 边界要说清:预设输入、早期模型、单次对照和 toy experiment 的定位,都决定了这项结果不能被过度解读。
这项实验留给行业一个值得思考的问题:未来 AI 系统的竞争,是否正在从单一模型能力,转向组织和调度大量智能体完成复杂任务的系统能力?对开发者来说,现在就可以从一个带独立验证的小型多 Agent 原型开始尝试。推荐通过 API易 apiyi.com 快速验证效果,平台提供免费测试额度和多模型统一接口。
📚 参考资料
- Anthropic 工程博客:Safely scaling multi-agent teams with Claude Fable 5.2
- 链接:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2 -
说明:第二次实验的组织架构、数据库协作、安全机制与 Opus 对照
-
Anthropic 研究文章:Formalizing Fermat’s Last Theorem
- 链接:
anthropic.com/research/formalizing-fermats-last-theorem -
说明:第一次形式化实验的数据与 Prove2Me 协作方式
-
Anthropic 官方 Lean 证明仓库:第一版形式化证明
- 链接:
github.com/anthropics/fermats-last-theorem -
说明:公开的9月版本证明代码,README 数据不等同于11月实验统计
-
Lean 官方案例:Formalizing Fermat’s Last Theorem
- 链接:
lean-lang.org/use-cases/flt -
说明:了解 Lean 与形式化数学背景
-
Fable 5.2 模型文档:模型规格与 API 迁移
- 链接:
platform.claude.com/docs/en/models/fable-5-2/overview - 说明:上下文窗口、输出上限与定价信息
作者:APIYI 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心