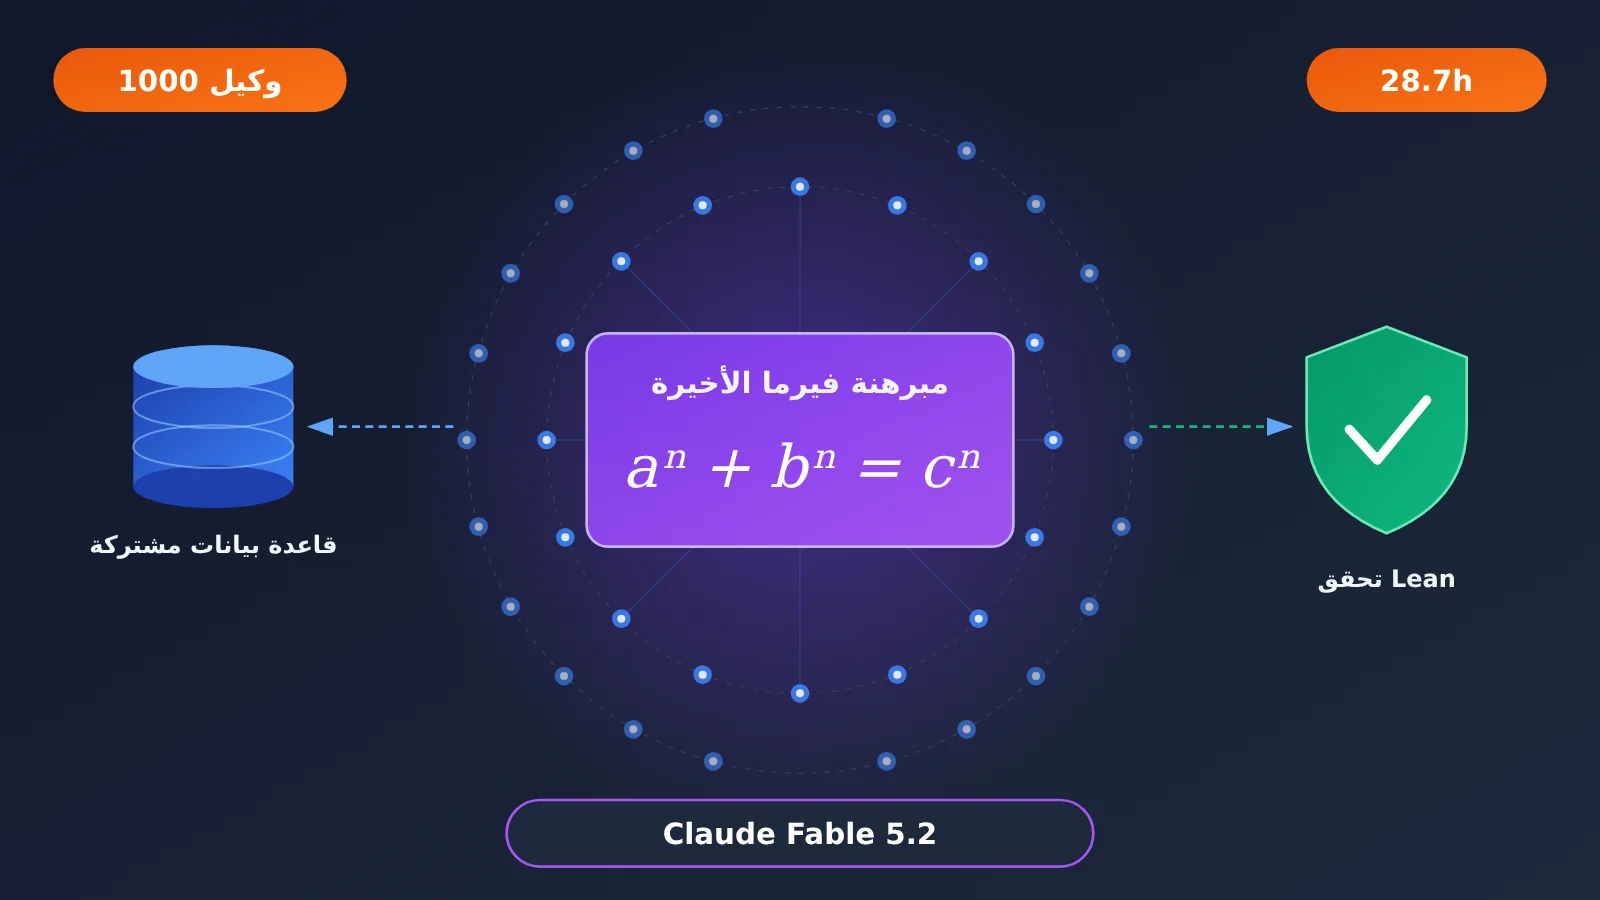
في 9 نوفمبر 2026، أعلنت Anthropic في مدونتها الهندسية الرسمية عن تجربة متعددة الوكلاء: تعاون 1000 وكيل Claude Fable 5.2 على الصياغة الصورية لمبرهنة فيرما الأخيرة حاسوبيًا في 28.7 ساعة، واجتاز البرهان في النهاية فحص نواة Lean الرسمية. أما التجربة الأولى للصياغة الصورية، التي أُجريت قبل شهرين، فقد أنجزها عشرات الوكلاء واستغرقت 11 يومًا.
هذا لا يعني أن «الذكاء الاصطناعي أثبت مبرهنة فيرما الأخيرة في 30 ساعة». فقد أثبت Andrew Wiles وRichard Taylor هذه المبرهنة في تسعينيات القرن العشرين. وما أنجزته التجربة هو تحويل مسار البرهان المعروف إلى برهان صوري يستطيع الحاسوب التحقق منه خطوة بخطوة. لذلك، السؤال الحقيقي الذي يجيب عنه هذا المقال هو: كيف تعاون 1000 وكيل ذكاء اصطناعي لإنجاز مشروع معقد كهذا في أقل من 30 ساعة؟
القيمة الأساسية: بعد قراءة هذا المقال، ستتعرّف إلى أبرز بيانات تجربة الصياغة الصورية لمبرهنة فيرما الأخيرة، وكيفية تنظيم 1000 وكيل وآليات التحقق، فضلًا عن القيمة المرجعية لهذه التجربة لأنظمة الوكلاء في المؤسسات وحدودها.
لمحة سريعة عن التجربة الأساسية لإضفاء الطابع الرسمي على مبرهنة فيرما الأخيرة
لنبدأ بجدول يلخّص الحقائق الأساسية لتجربة Claude Fable 5.2. انتبه إلى بعض التفاصيل التي يسهل الخلط بينها: استُخدمت نسخة مبكرة من النموذج، وكانت مدخلات التجربة محددة مسبقًا، كما أوضحت الشركة رسميًا أنها تجربة توضيحية (toy experiment).
| البند | التفاصيل |
|---|---|
| تاريخ النشر | 9 نوفمبر 2026، في مدونة Anthropic الهندسية الرسمية |
| النموذج المستخدم | نسخة مبكرة من Claude Fable 5.2، لم تستكمل بعد تقييمات المواءمة السابقة للإصدار الرسمي |
| حجم الفريق | وكيل رئيسي واحد (Lead Agent) + 999 وكيلًا مساعدًا (Helper Agents) |
| وقت الإنجاز | الساعة 28.7، اجتازت المبرهنة النهائية فحص نواة Lean الرسمية (قرّب الإعلان الرسمي المدة إلى 30 ساعة) |
| المدخلات المحددة مسبقًا | 60 قضية، وملخص موجز لمسار البرهان الكلاسيكي، والتعريفات ذات الصلة، و47 لمّة أُثبتت في عملية الإضفاء الرسمي السابقة |
| بيئة الأدوات | سلسلة أدوات Lean، وMathlib، وGit، وقاعدة بيانات PostgreSQL مشتركة، وبيئات افتراضية معزولة |
| التوصيف الرسمي | تجربة توضيحية، وليست أول برهان على مبرهنة فيرما الأخيرة |
إضفاء الطابع الرسمي على مبرهنة فيرما الأخيرة: توضيح الفرضيات أولًا
لم يكتفِ الباحثون بقول: «أثبت مبرهنة فيرما الأخيرة»، ثم تركوا الوكلاء يعملون من دون تدخل. فقد زُوّد الوكيل بـ60 قضية، تشمل المبرهنة النهائية و59 محطة وسيطة، إلى جانب ملخص لمسار البرهان والتعريفات و47 لمّة أُثبتت في التجربة السابقة. كما حدّد الباحثون مسبقًا أدوار الوكيل الرئيسي والوكلاء المساعدين.
لذلك، تختبر هذه التجربة قدرة مختلفة: هل يستطيع فريق كبير من الوكلاء تنظيم عمله بنفسه، وتحويل مسار رياضي معروف بالكامل إلى برهان يمكن للآلة التحقق منه، عند تزويده بالأساس الرياضي والأدوات اللازمة؟ هذا السؤال أقرب إلى مسألة هندسية من سؤال «هل يستطيع الذكاء الاصطناعي ممارسة الرياضيات؟».
لماذا يصعب إضفاء الطابع الصوري على مبرهنة فيرما الأخيرة؟
تنص مبرهنة فيرما الأخيرة ببساطة على أنه عندما يكون العدد الصحيح n أكبر من 2، لا توجد أعداد صحيحة موجبة a وb وc تحقق المعادلة a^n + b^n = c^n. طرح بيير دي فيرما هذه المسألة في القرن السابع عشر، وظلت بلا حل لأكثر من 350 عامًا. أعلن وايلز برهانها عام 1993، ثم أصلح مع تايلور ثغرةً جوهرية عام 1994، ونشر البرهان رسميًا عام 1995. بلغ طول البرهان الأصلي نحو 129 صفحة، واستند بدرجة كبيرة إلى نتائج راسخة في نظرية الأعداد الحديثة والهندسة الجبرية.
عندما يكتب علماء الرياضيات برهانًا، يمكنهم أن يقولوا: «يُستنتج بوضوح من النتيجة السابقة»، ويتولى القارئ تلقائيًا استكمال الخطوات الوسيطة. أما الحاسوب فلا يملك هذا الفهم الضمني؛ إذ يجب أن يعرف في كل خطوة التعريف الذي استُخدم، والنظرية التي استند إليها، وقاعدة الاستدلال التي طُبّقت. وهنا يكمن أصل صعوبة إضفاء الطابع الصوري: فما يبدو «واضحًا» للبشر قد يتطلب مئات الأسطر أو آلافها عند كتابته على هيئة شيفرة.
Lean وMathlib وإضفاء الطابع الصوري على الرياضيات
لفهم هذه التجربة، من المفيد أولًا التمييز بين ثلاثة مفاهيم:
- Lean: مساعد تفاعلي لإثبات النظريات، يتحقق من مطابقة البرهان بدقة لقواعد المنطق الصوري.
- Mathlib: مكتبة الرياضيات الخاصة بـLean، تضم عددًا كبيرًا من التعريفات والنظريات التي أُضفي عليها الطابع الصوري مسبقًا، وتشبه «مكتبة قياسية» يمكن الاستشهاد بمحتوياتها مباشرة.
- إضفاء الطابع الصوري على الرياضيات: تحويل البراهين الرياضية المقروءة للبشر إلى بنية منطقية يستطيع الحاسوب التحقق منها بالكامل.
والنقطة الأهم هي أن الذكاء الاصطناعي يتولى بناء البرهان، بينما تتولى نواة Lean التحقق منه. قول النموذج «لقد أثبتُّ ذلك» وقبول Lean الفعلي للبرهان أمران مختلفان تمامًا. والسبب في أن هذه التجربة تستحق الاهتمام هو أن نتيجتها النهائية لا تعتمد على حكم النموذج على نفسه، بل اجتازت تحققًا آليًا مستقلًا.
كيف يتعاون 1000 وكيل ذكاء اصطناعي؟ نظام لإدارة المشاريع تديره أنظمة الذكاء الاصطناعي
هذا هو الجانب الأجدر بالدراسة في تجربة Claude Fable 5.2. لم يعمل الوكلاء الألف كلٌّ منهم على حل المسألة بمفرده، بل شكّلوا نظام تعاون يضم إدارة للمهام، وجدولة للموارد، وقدرة على التكيّف ديناميكيًا.
الهيكل التنظيمي لفريق Claude Fable 5.2
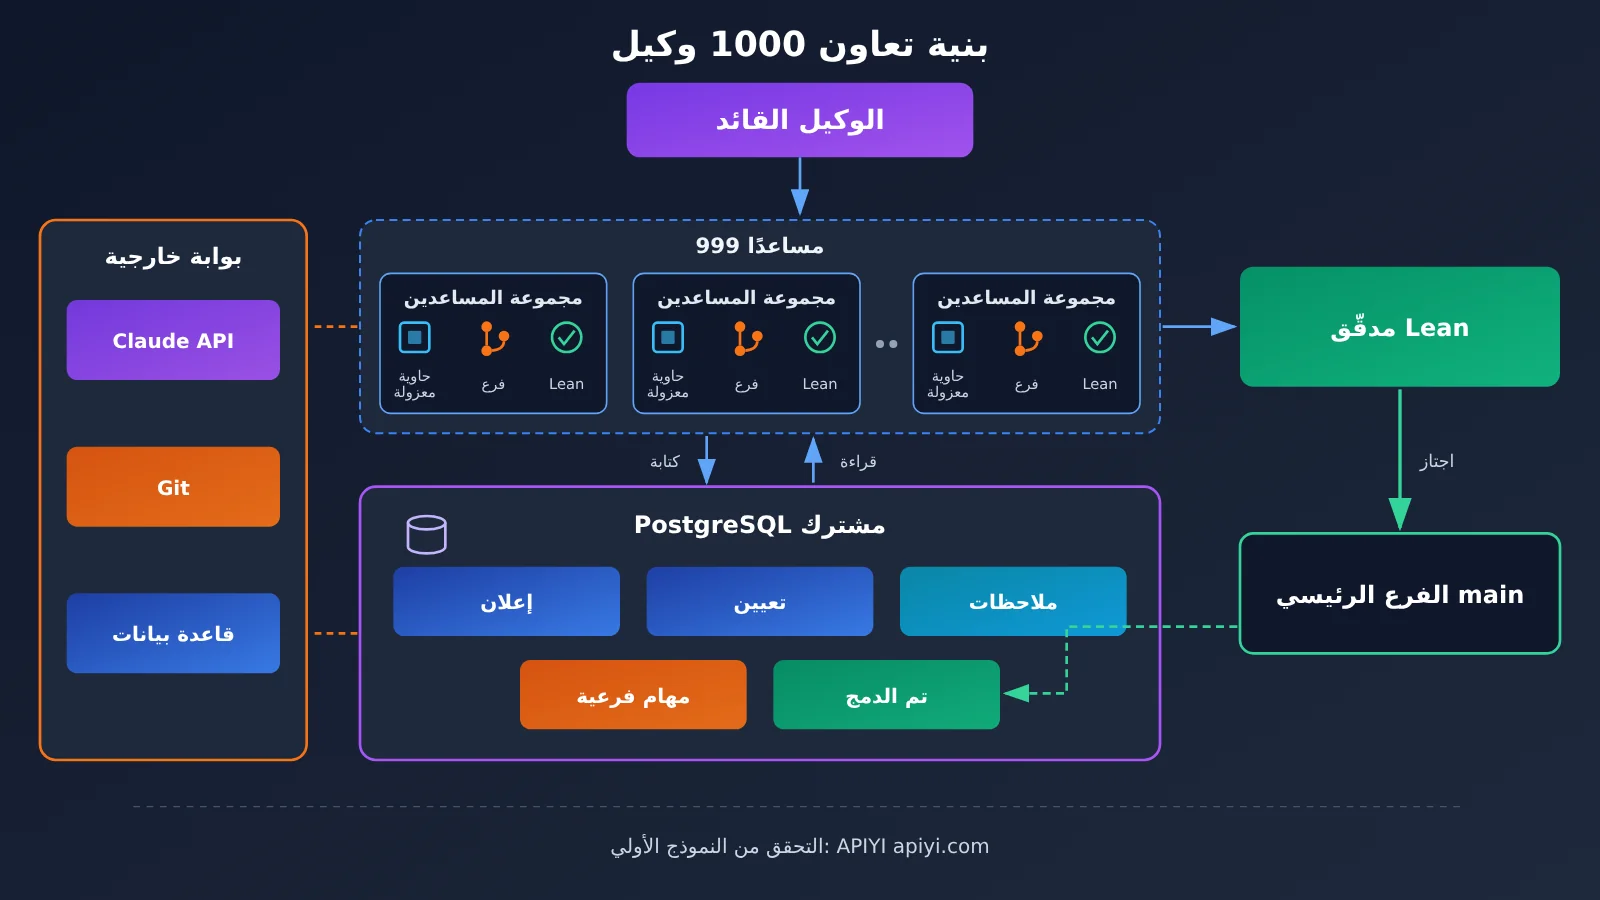
اعتمد الفريق هيكلًا هرميًا بسيطًا: يتولى وكيل قائد واحد (Lead Agent) التخطيط العام، وتقسيم المهام، ومتابعة التقدم، بينما يتولى 999 وكيلًا مساعدًا (Helper Agents) تنفيذ البراهين المحددة. لدى كل وكيل بيئة افتراضية معزولة وخفيفة، ويمكنه استخدام Shell ومحرر الملفات وسلسلة أدوات Lean وMathlib. كما يمتلك فرع Git خاصًا به، ويمكنه إرسال طلب دمج إلى الفرع الرئيسي.
لم يكن لدى أي من الوكلاء اتصال مباشر بالإنترنت؛ إذ كانت جميع الاتصالات مع Claude API وGit وقواعد البيانات تمر عبر بوابة خارجية. وبفضل البيئات المعزولة والفروع المستقلة، لم تتعارض تعديلات الوكلاء الألف على الملفات أثناء عملهم المتزامن.
PostgreSQL مشترك: مركز التعاون بين وكلاء الذكاء الاصطناعي
إذا حاول 1000 وكيل التعاون عبر تبادل الرسائل فيما بينهم، فسرعان ما يخرج حجم الاتصالات عن السيطرة. لذلك أنشأ الوكيل القائد خمسة جداول مشتركة في قاعدة البيانات خلال الدقائق العشر الأولى من التجربة، وحوّل التواصل إلى «العمل على لوحة واحدة مشتركة».
| اسم الجدول | الوظيفة | دوره في التعاون |
|---|---|---|
| Announce | نشر توجيهات الفريق | بثّ الرسائل إلى الجميع، أشبه بلوحة إعلانات المشروع |
| Assign | توزيع المهام وتحديد المسؤولين عنها | توضيح «من يعمل على ماذا» لتجنب تداخل الجهود |
| Notes | تسجيل التقدم والمشكلات وخطط العمل | مشاركة السياق والحد من عزل المعلومات |
| Subtasks | إدارة المهام الفرعية ليتمكن الوكلاء من تولّيها | مجموعة مهام تدعم تولّي المهام بشكل مستقل |
| Landed | تسجيل الأعمال المكتملة التي اجتازت الفحص | قائمة موثوقة بالإنجازات، لا تضم إلا المحتوى الذي جرى التحقق منه |
تكمن قيمة هذه الآلية في أن الوكيل لا يحتاج إلى التواصل مع كل واحد من الوكلاء الـ999 الآخرين؛ فبمجرد الرجوع إلى قاعدة البيانات، يمكنه معرفة المهام المتاحة، وما أُنجز منها، وما يعتمد على مهام أخرى. أما الإنجازات، فتُدمج في الفرع الرئيسي عبر Git. وتشير البيانات الرسمية إلى أن العملية شهدت نحو 36,612 عملية كتابة في قاعدة البيانات و311,734 عملية قراءة، منها نحو 20,600 عملية كتابة في Notes ونحو 14,800 في Subtasks (ولا تشمل الإحصاءات معظم استدعاءات البرامج النصية). ويُظهر ارتفاع عدد القراءات كثيرًا عن عدد الكتابات أن الوكلاء يقضون معظم وقتهم في «الاطلاع على الحالة العامة».
توزيع المهام ديناميكيًا: من الإسناد الثابت إلى تولّي المهام بمبادرة ذاتية
لم تكن آلية الجدولة في هذه التجربة ثابتة. يوضح الخط الزمني التالي كيف تطور أسلوب تنظيم العمل تدريجيًا:
| الوقت | الحدث الرئيسي |
|---|---|
| الدقيقة 10 | أنشأ Lead خمسة جداول مشتركة في قاعدة البيانات |
| نحو الدقيقة 27 | أُثبتت 3 قضايا |
| بعد ذلك | أوقف Lead مؤقتًا 47 قضية رأى أن إنجازها ضمن الميزانية المتاحة صعب، وركّز الموارد البشرية على 10 قضايا أخرى |
| نحو الدقيقة 70 | اكتمل إنجاز القضايا العشر، ثم أعاد Lead توزيع المهام على الوكلاء للتعامل مع قضايا أصعب |
| نحو الساعة 3 | سمح Lead للوكلاء المتفرغين بتولّي المهام بأنفسهم من دون انتظار توزيعها |
| الساعة 5.6 | أنشأ 73 Helper ما مجموعه 756 مهمة |
| نحو الساعة 18 | استؤنف التشغيل من آخر حالة محفوظة، واستمر 12 ساعة |
| الساعة 28.4 | اكتملت القضايا المرتبطة بحدسية لانغلاندز–تونيل |
| الساعة 28.7 | اكتملت مبرهنة فيرما الأخيرة واجتازت فحص النواة الرسمي |
ثمة تفصيلان جديران بالانتباه. أولًا، يعادل الانتقال من «إسناد Lead للمهام» إلى «تولّي الوكلاء المهام بأنفسهم» تحول الفريق من الجدولة المركزية إلى العمل وفق مجموعة مهام، ما يقلل خطر أن يصبح Lead عنق زجاجة. ثانيًا، استؤنفت التجربة من حالة محفوظة عند نحو الساعة 18، لذا لا تعني مدة 28.7 ساعة أن جميع الوكلاء عملوا بلا انقطاع منذ البداية.
كذلك، فإن القضايا الـ47 التي أُوقفت مؤقتًا تختلف عن اللمّات الـ47 الواردة في المدخلات المحددة مسبقًا. انتبه إلى عدم الخلط بينهما عند قراءة المواد الرسمية.
Langlands–Tunnell: 750 وكيلًا يتعاونون لإنجاز أصعب مرحلة في الصياغة الشكلية لمبرهنة فيرما الأخيرة
قرب خط النهاية، واجه الفريق أصعب مرحلة: قضايا مرتبطة بـ Langlands–Tunnell، وهي نتيجة رياضية مهمة في مسار برهان وايلز. وقدّر الوكيل الذي تولّى هذا الجزء في البداية أنه قد يتطلب ما بين 700 ألف ومليون سطر من شيفرة Lean، ورأى أن احتمال إنجازه ضمن الوقت المتبقي أقل من 1%.
بعد ذلك، حشد القائد نحو 750 وكيلًا مساعدًا للعمل على هذه المهمة. وأنشأ الوكلاء من تلقاء أنفسهم شجرة مهام متعددة المستويات:
- قُسّمت المهمة إلى 10 أقسام رئيسية؛
- أُنشئت 2,418 مهمة فرعية؛
- بلغ عمق شجرة المهام 10 مستويات؛
- عمل مئات الوكلاء بالتوازي على مهام فرعية مختلفة.
وبهذه الطريقة، اكتمل عمل Langlands–Tunnell عند الساعة 28.4، ثم اكتملت مبرهنة فيرما الأخيرة بعد 0.3 ساعة. يوضح هذا المثال أن قيمة العمل المتوازي واسع النطاق لا تقتصر على أن «العدد الأكبر يُنجز الحساب أسرع». الأهم هو تقسيم مشكلة كبيرة يتعذر التعامل معها مباشرةً إلى مهام صغيرة يمكن إنجازها والتحقق منها كلٌّ على حدة، ثم دمج نتائجها في النهاية. أما إذا لم يُحسن تقسيم العمل، فلن يفعل 750 وكيلًا سوى انتظار بعضهم بعضًا أو تكرار الجهد نفسه.
لماذا نجحت الصياغة الرسمية لنظرية فيرما الأخيرة: التحقق باستخدام Lean وآليات الأمان
من منظور الموثوقية الهندسية، استندت هذه التجربة إلى ثلاث طبقات من الضمانات.
الطبقة الأولى هي التحقق من النتائج. يجب أن يجتاز كل ادعاء فرعي فحص Lean قبل دمجه في الفرع الرئيسي، ولا يسجل جدول Landed إلا الأعمال التي اجتازت الفحص. أما البرهان النهائي، فيتحقق منه مدقق النواة الرسمي. وقد دوّن الوكيل الرئيسي العبارة التالية: “Fermat’s Last Theorem is on main، kernel-checked by the official checker.”
الطبقة الثانية هي عزل التعاون. خفّضت بيئات الاختبار المعزولة وفروع Git المستقلة إلى حد كبير تعارض الملفات والتداخل بين الوكلاء.
الطبقة الثالثة هي حدود الأمان. استخدمت التجربة نموذجًا مبكرًا لم يكن قد استكمل بعد تقييمات مواءمة ما قبل الإصدار الرسمي؛ لذا فرضت Anthropic قيودًا متعددة الطبقات:
- حُظر الاتصال بالإنترنت والوصول المباشر إلى بيئات الاختبار المعزولة الخاصة بالوكلاء الآخرين؛
- نُفذت الأوامر باستخدام حسابات غير مميّزة؛
- أُديرت اتصالات API وGit وقواعد البيانات عبر بوابة خارجية؛
- راقب مصنّف آني أوامر Shell وتعديلات الملفات، بينما راجع مراقب غير متصل سجلات العمليات.
نفّذت التجربة أكثر من مليون استدعاء للأدوات، ولم يبلغ أيٌّ منها مستوى يستدعي الحظر. كما ذكرت Anthropic أنها أضافت بعد التجربة مراقبة متوازية لسلاسل التفكير. والخلاصة هنا أن موثوقية نظام الوكلاء لا تعتمد على قدرة النموذج على إنجاز المهمة فحسب، بل تتطلب أيضًا تحققًا مستقلًا، وحدودًا للصلاحيات، وبيئة تنفيذ قابلة للتتبع.
من 11 يومًا إلى 28.7 ساعة: مقارنة بين تجربتَي Claude Fable 5.2
اختلفت منهجية تجربتَي إضفاء الصيغة الرسمية على مبرهنة فيرما الأخيرة، لذا ينبغي النظر إليهما كلٌّ على حدة:
| المؤشر | التجربة الأولى (أُعلن عنها في سبتمبر 2026) | التجربة الثانية (أُعلن عنها في 9 نوفمبر 2026) |
|---|---|---|
| النموذج | نموذج بحثي داخلي (يقارب Fable 5.1 في المستوى) | إصدار مبكر من Fable 5.2 |
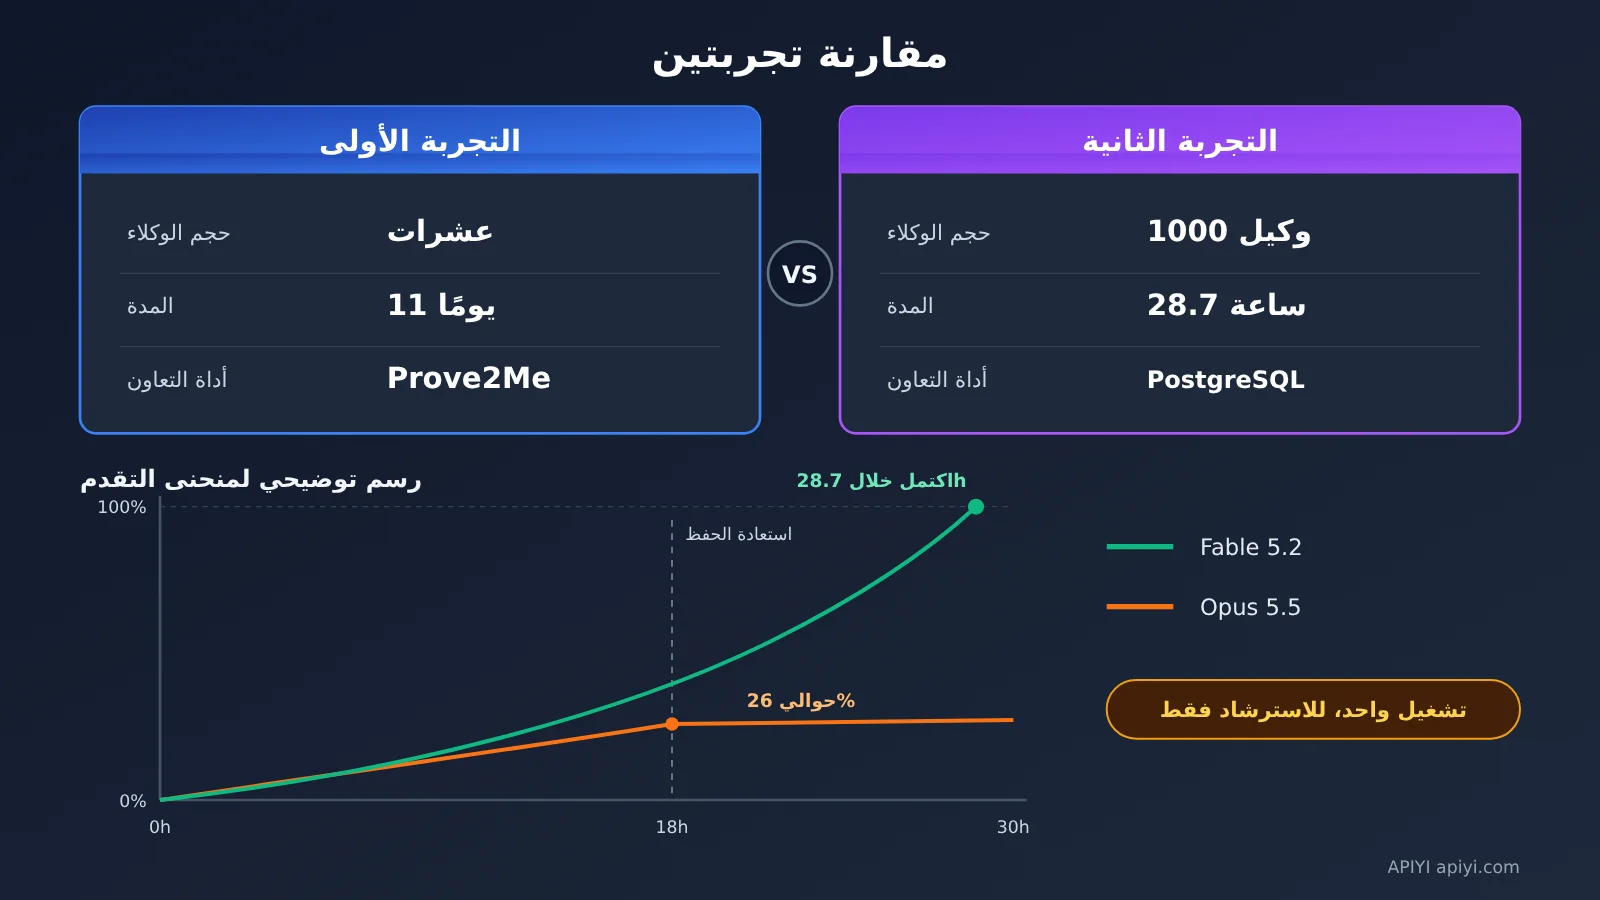
| عدد الوكلاء | عشرات | 1000 |
| مدة التنفيذ | 11 يومًا | 28.7 ساعة |
| الرموز الناتجة | نحو 6 مليارات | ذكرت الشركة رسميًا أنها انخفضت إلى نحو الثلث مقارنةً بالتجربة الأولى |
| طول البرهان | خط الأساس (نحو 13 مليون سطر من شيفرة Lean) | نحو 1/7 من طول التجربة الأولى |
| منصة التعاون | Prove2Me + Claude Code Multi-Agent Harness | أدوات عامة + PostgreSQL |
| التوجيه البشري | قدّم الباحث Tianyi Peng قدرًا قليلًا من التوجيه عالي المستوى | لم يكن هناك توجيه مستمر للعملية الرياضية |
من المهم التنبيه إلى أن أرقام 6 مليارات رمز، و13 مليون سطر من الشيفرة، ونحو 30,300 مبرهنة، كلها تخص التجربة الأولى. ولم تعلن الشركة رسميًا عن العدد الإجمالي للرموز أو التكلفة الكلية أو العدد الدقيق لأسطر الشيفرة في التجربة الثانية.
واجهت التجربة الأولى بعض التعثرات في بدايتها أيضًا؛ إذ صعب على الوكلاء تتبّع الحالة العامة ومعرفة ما أنجزه الآخرون، ما أدى إلى تكرار العمل. لاحقًا، أُدخلت منصة Prove2Me لاستخدام رسم بياني موجّه لا دوري (DAG) لإدارة تبعيات المبرهنات، إلى جانب تتبّع حالة المهام والبحث عن المبرهنات وتسريع التجميع. أما التجربة الثانية، فتمثّل اختلافها في الاستغناء عن هذه المنصة المتخصصة، وترك الوكلاء ينشئون آلية تعاون بأنفسهم باستخدام قواعد بيانات وأدوات Git عامة؛ إذ أدّت خمسة جداول وظائف مشابهة.
وأجرت Anthropic أيضًا اختبارًا مقارنًا بالإعداد نفسه الذي يضم 1000 وكيل: أنجز Opus 5.5 نحو 26% خلال 18 ساعة، ثم لم يحرز تقدمًا يُذكر حتى بلوغ 30 ساعة؛ بينما أكمل Fable 5.2 المبرهنة النهائية خلال 28.7 ساعة. استأنفت المجموعتان العمل من حالة محفوظة بعد نحو 18 ساعة. لكن كل نموذج خضع لتشغيل واحد فقط، لذا لا يمكن الاستدلال من ذلك على وجود فرق عام بينهما في جميع المهام المعقدة.
تحليل أثر تجربة 1000 وكيل ذكاء اصطناعي على المؤسسات
للمطورين: أربع قدرات أساسية للأنظمة متعددة الوكلاء
إذا تجاوزنا الخلفية الرياضية، نجد أن القدرات التي أظهرتها هذه التجربة ترتبط بسيناريوهات مؤسسية مألوفة:
| القدرة | تجسيدها في التجربة | تطبيقها في المؤسسات |
|---|---|---|
| تقسيم المهام المعقدة | 2,418 مهمة فرعية، وشجرة مهام يصل عمقها إلى 10 مستويات | إعادة هيكلة قواعد برمجية كبيرة، وإعداد تقارير بحثية معقدة |
| التوزيع الديناميكي للموارد | تأجيل المسائل الصعبة وحشد 750 من المساعدين لحلها | إعادة توزيع الوكلاء والقدرة الحاسوبية حسب الأولوية |
| إدارة الحالة المشتركة | خمسة جداول في PostgreSQL، إلى جانب دمج Git | لوحة موحدة للمهام تحدّ من تكرار العمل |
| التحقق المستقل من النتائج | فحص نواة Lean لكل عملية إرسال | اختبارات الوحدات، والتحقق من البيانات، والمراجعة البشرية |
أبرز ما يمكن أن يستفيده المطورون مباشرة هو أنهم ليسوا بحاجة إلى بناء منصة متخصصة ومعقدة منذ البداية؛ فقاعدة بيانات مشتركة مصممة جيدًا، إلى جانب التحكم في الإصدارات، تكفي لدعم تعاون على نطاق واسع نسبيًا. إليك مثالًا مبسطًا جدًا على استدعاء النموذج:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة موحدة لـ APIYI
)

response = client.chat.completions.create(
    model="claude-fable-5-2",  # يُرجى الرجوع إلى قائمة النماذج على المنصة لمعرفة اسم النموذج
    messages=[{"role": "user", "content": "把这个任务拆成可独立验证的子任务"}]
)
print(response.choices[0].message.content)
عرض مثال توضيحي لرمز مجموعة مهام Lead / Helper
import sqlite3
import openai

# استخدام SQLite محليًا لمحاكاة جدولي Subtasks وLanded في التجربة (استخدمت التجربة الفعلية PostgreSQL)
db = sqlite3.connect("board.db")
db.execute("CREATE TABLE IF NOT EXISTS subtasks (id INTEGER PRIMARY KEY, goal TEXT, status TEXT, owner TEXT)")
db.execute("CREATE TABLE IF NOT EXISTS landed (task_id INTEGER, result TEXT)")

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def lead_plan(goal: str):
    """القائد: يجزّئ المهمة ويضيفها إلى قائمة المهام"""
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": f"将目标拆为3-5个子任务,每行一个:{goal}"}]
    )
    for line in resp.choices[0].message.content.splitlines():
        if line.strip():
            db.execute("INSERT INTO subtasks (goal, status) VALUES (?, 'open')", (line.strip(),))
    db.commit()

def verify(result: str) -> bool:
    """مدقّق مستقل: في الاستخدام الفعلي، ينبغي استبداله باختبارات أو نصوص تحقق أو فحوص Lean"""
    return len(result) > 0

def helper_claim(name: str):
    """المساعد: يتولى مهمة من تلقاء نفسه، ولا يضيفها إلى landed إلا بعد اجتياز التحقق"""
    row = db.execute("SELECT id, goal FROM subtasks WHERE status='open' LIMIT 1").fetchone()
    if not row:
        return
    task_id, goal = row
    db.execute("UPDATE subtasks SET status='doing', owner=? WHERE id=?", (name, task_id))
    db.commit()
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": goal}]
    )
    result = resp.choices[0].message.content
    if verify(result):
        db.execute("INSERT INTO landed VALUES (?, ?)", (task_id, result))
        db.execute("UPDATE subtasks SET status='done' WHERE id=?", (task_id,))
    else:
        db.execute("UPDATE subtasks SET status='open', owner=NULL WHERE id=?", (task_id,))
    db.commit()

lead_plan("为一个开源库补全单元测试")
for i in range(3):
    helper_claim(f"helper-{i}")
🚀 اقتراح للبدء السريع: إذا أردت تجربة نموذج أولي صغير يجمع بين «تقسيم القائد للمهمة + تولّي المساعد لها + التحقق المستقل»، يمكنك البدء بالحصول على رصيد تجريبي مجاني من APIYI عبر apiyi.com. توفر المنصة واجهة متوافقة مع OpenAI، ويتيح مفتاح واحد التبديل بين نماذج Claude وGPT وGemini وغيرها، ما يسهل مقارنة جودة تقسيم المهام عند تولّي نماذج مختلفة دور القائد.
في القطاع: الحدود أهم من الأرقام
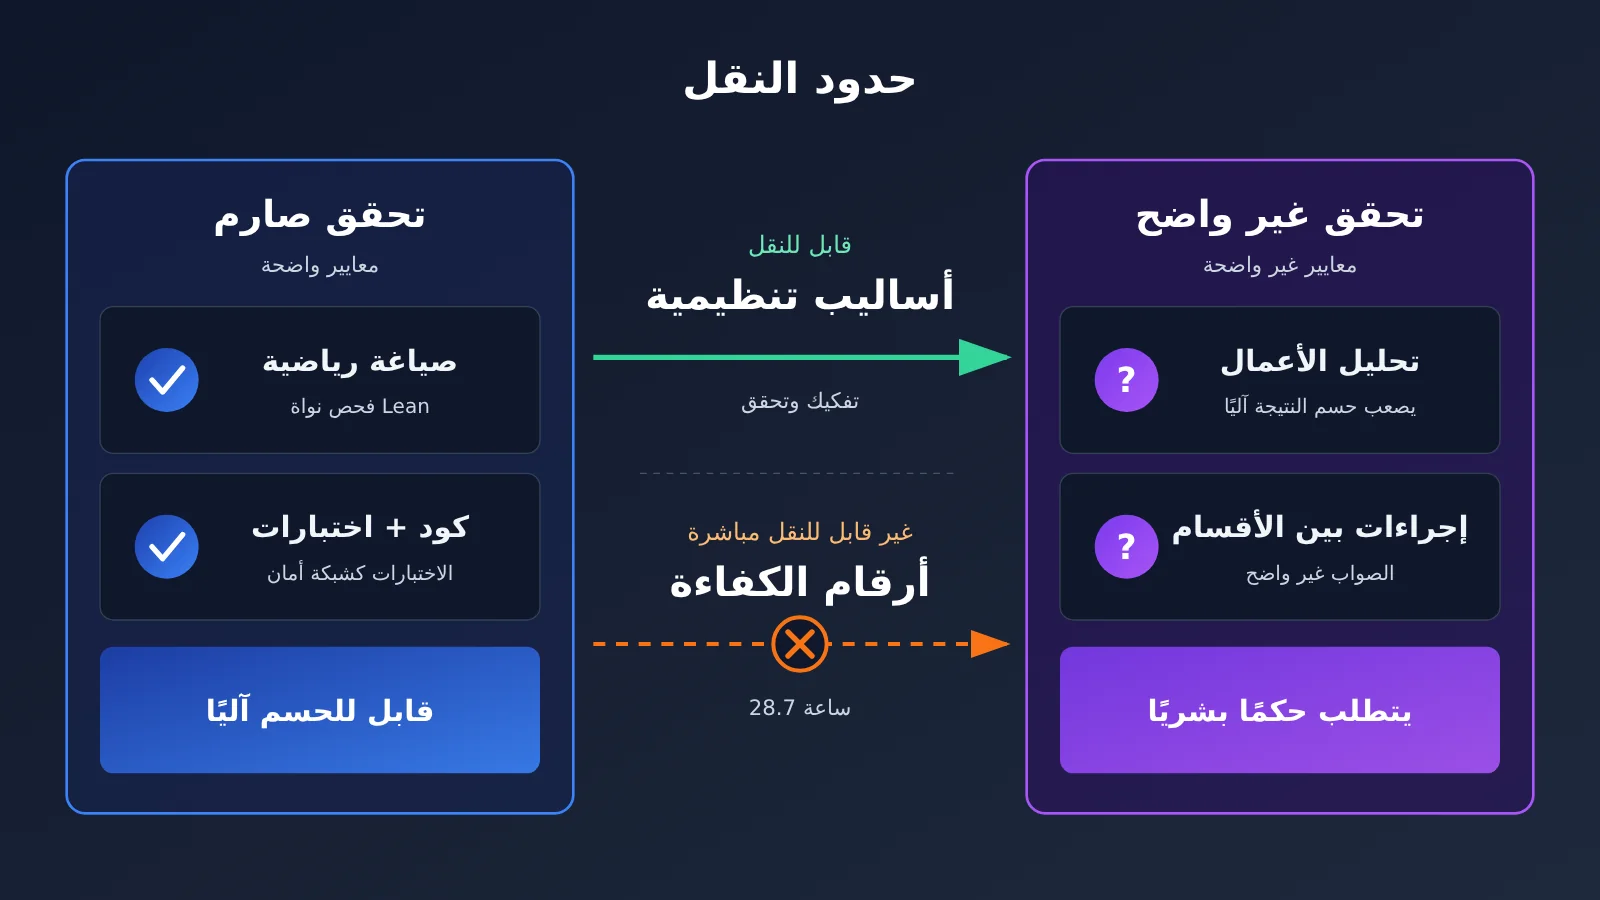
من المهم التعامل بواقعية مع نقطة أساسية: للتحقق الرياضي الصوري أدوات تحقق صارمة وموضوعية مثل Lean، لكن معظم مهام الشركات لا تملك معيارًا واضحًا للصواب بالقدر نفسه. يمكن للاختبارات أن توفر ضمانًا إضافيًا للكود، لكن يصعب غالبًا على الآلات تحديد ما إذا كان «الصحيح» في تحليل السوق أو العمليات المشتركة بين الأقسام. لذلك، لا يمكن تطبيق نتيجة 28.7 ساعة ومعدل النجاح في هذه التجربة مباشرةً على أنظمة الوكلاء الذكية في الشركات.
وقد أشار Anthropic نفسه إلى بعض القيود: قد يحكم الوكلاء مبكرًا على أن المهمة غير قابلة للإنجاز؛ فمعظم القضايا الـ47 التي أُرجئت في البداية أُنجزت لاحقًا. كما تظل توجيهات البشر مفيدة عند مواجهة نقاط صعبة، وقد تواصل أدوات متخصصة في المجال، مثل Prove2Me، تحسين كفاءة التجميع والاسترجاع والتعاون. لا تثبت التجربة أن زيادة عدد الوكلاء تؤدي دائمًا إلى نتائج أفضل، ولا أن الخبراء البشر وبيئات العمل المتخصصة لم يعودوا ضروريين.
💡 نصيحة هندسية: عند تجربة نهج متعدد الوكلاء في الشركات، ابدأ بمهام لها معايير تحقق واضحة، مثل تعديل الكود الموجّه بالاختبارات، ثم وسّع نطاق التجربة تدريجيًا. ويمكنك الاستفادة من نظام الدفع حسب الاستخدام لدى APIYI عبر apiyi.com لتقييم مراحل تقسيم المهام والتحقق منها باستخدام عدد قليل من الوكلاء، قبل اتخاذ قرار بزيادة الاستثمار.
الأسئلة الشائعة
س1: هل أثبت الذكاء الاصطناعي مبرهنة فيرما الأخيرة في هذه التجربة؟
لا. نشر Wiles برهانًا رسميًا لمبرهنة فيرما الأخيرة عام 1995، بالتعاون مع Taylor لتصحيح مشكلة جوهرية. في هذه التجربة، جرى تحويل مسار برهان معروف إلى برهان صوري يمكن لـ Lean التحقق منه، اعتمادًا على 60 قضية، ومخطط عام لمسار البرهان، وتعريفات، و47 لمّة مثبتة.
س2: لماذا وُسِمت 54 قضية فقط من أصل 60 على أنها مثبتة؟
بحسب إحصاءات الساعة الثلاثين، لم تعد هناك حاجة لاحقًا إلى 5 قضايا بديلة، كما جرى التخلي عن قضية واحدة. اجتاز المبرهن النهائي التحقق عند الساعة 28.7، لذلك لم يكن من الضروري إنجاز القضايا الستين التي أُدرجت في البداية.
س3: ما أسعار API لنموذج Claude Fable 5.2؟
السعر الرسمي هو 8 دولارات لكل مليون Token للإدخال، و40 دولارًا لكل مليون Token للإخراج. أما Fast Mode فسعره 16 دولارًا للإدخال و80 دولارًا للإخراج. وتبلغ تكلفة قراءة البيانات المخزنة مؤقتًا 0.20 دولار لكل مليون Token، مع خصم 50% على Batch API. تبلغ نافذة السياق مليون Token، والحد الأقصى للإخراج 128 ألف Token. لم تُعلن التكلفة الإجمالية للتجربة الثانية رسميًا، ولا يمكن تقديرها بضرب 6 مليارات Token من التجربة الأولى في سعر الوحدة.
س4: كيف يمكن تجربة Claude Fable 5.2 بسرعة عبر API؟
سجّل في APIYI على apiyi.com واحصل على مفتاح API، ثم اضبط `base_url` على `https://api.apiyi.com/v1`، لتتمكن من استخدام الشيفرة النموذجية في هذه المقالة مباشرةً. يحصل المستخدمون الجدد على رصيد مجاني للاختبار، ما يجعله مناسبًا للبدء بنموذج أولي صغير متعدد الوكلاء.
س5: هل يحتاج نظام الوكلاء المتعددين دائمًا إلى PostgreSQL؟
ليس بالضرورة. المهم هو توفير مصدر حالة مشترك يمكن لجميع الوكلاء القراءة منه والكتابة إليه، إلى جانب التحكم في الإصدارات والتحقق المستقل. ويكفي SQLite أو Redis لنموذج أولي صغير. عند استدعاء النماذج عبر APIYI على apiyi.com، يتولى نظامك الخاص تخزين الحالة، ويمكنك استخدام الخيارين معًا بالطريقة التي تناسبك.
س6: ما القيود المعروفة لهذه التجربة؟
وصفتها الجهة الرسمية صراحةً بأنها تجربة أولية بسيطة. أُجريت مقارنة Fable وOpus مرة واحدة فقط لكل منهما، واستخدمت التجربة نماذج مبكرة تتطلب طبقات متعددة من إجراءات الحماية. كما أن الوكلاء تخلّوا عن المهمة مبكرًا عن طريق الخطأ، ولا تزال للإرشادات البشرية والأدوات المتخصصة في المجال قيمة مهمة.
أبرز النقاط: 1000 وكيل ذكاء اصطناعي ينجزون الصياغة الرسمية لمبرهنة فيرما الأخيرة
- جوهر التجربة: تحويل برهان موجود إلى شيفرة قابلة للتحقق باستخدام Lean، وليس إثبات مبرهنة فيرما الأخيرة للمرة الأولى.
- الأرقام الرئيسية: أنجز 1000 وكيل من الإصدار المبكر Fable 5.2 المهمة في 28.7 ساعة، واجتاز الناتج فحص نواة Lean الرسمية.
- جوهر التنظيم: قائد واحد و999 مساعدًا، تعاونوا عبر خمسة جداول قواعد بيانات مشتركة ومستودع Git.
- طريقة التعامل مع التحديات: قسّم نحو 750 وكيلًا مبرهنة لانغلاندز–تونيل إلى 2,418 مهمة فرعية، بعمق يصل إلى 10 مستويات.
- مصدر الموثوقية: تحقق مستقل بواسطة Lean، وعزل في بيئة آمنة؛ ولم تتطلب أكثر من مليون عملية استدعاء للأدوات أي تدخل.
- حدود قابلية التطبيق: غالبًا ما تفتقر مهام المؤسسات إلى مدقّق مثل Lean، لذا لا يمكن تعميم أرقام الكفاءة مباشرةً.
- طريقة البدء: يمكن استخدام الواجهة الموحدة من APIYI عبر apiyi.com لإعادة تنفيذ نموذج أولي صغير لتعاون القائد والمساعدين.
الخلاصة
أهم ما تكشفه تجربة Claude Fable 5.2، التي استعانت بألف وكيل:
- النظام أهم من أي عنصر منفرد: أسهمت قدرات النموذج، وتقسيم المهام، والحالة المشتركة، والتنفيذ المتوازي، والتحقق الآلي جميعًا في إنجاز المهمة خلال 28.7 ساعة.
- التحقق أساس الثقة: يتيح فحص نواة Lean التمييز بدقة بين ادعاء النموذج أنه أنجز المهمة وإنجازها فعليًا.
- من المهم توضيح الحدود: إن المدخلات المحددة مسبقًا، واستخدام نموذج من إصدار مبكر، والاعتماد على مقارنة واحدة، وكونها تجربة مصغّرة، كلها عوامل تمنع المبالغة في تفسير النتيجة.
تطرح هذه التجربة سؤالًا يستحق التأمل في هذا القطاع: هل ينتقل التنافس في أنظمة الذكاء الاصطناعي من قدرات النموذج الواحد إلى قدرة الأنظمة على تنظيم أعداد كبيرة من الوكلاء وتنسيقهم لإنجاز مهام معقدة؟ يمكن للمطورين البدء الآن بتجربة نموذج أولي صغير متعدد الوكلاء، مزوّد بآلية تحقق مستقلة. ونوصي باستخدام APIYI عبر apiyi.com لاختبار النتائج بسرعة؛ إذ توفر المنصة رصيدًا مجانيًا للاختبار وواجهة موحدة لعدة نماذج.
📚 مراجع
- مدونة Anthropic الهندسية: توسيع نطاق فرق متعددة الوكلاء بأمان باستخدام Claude Fable 5.2
- الرابط:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2 -
الوصف: الهيكل التنظيمي، والتعاون عبر قواعد البيانات، وآليات الأمان، والمقارنة مع Opus في التجربة الثانية
-
مقال بحثي من Anthropic: إضفاء الطابع الرسمي على مبرهنة فيرما الأخيرة
- الرابط:
anthropic.com/research/formalizing-fermats-last-theorem -
الوصف: بيانات التجربة الأولى لإضفاء الطابع الرسمي، وأسلوب التعاون مع Prove2Me
-
مستودع براهين Lean الرسمي: الإصدار الأول من البرهان الرسمي
- الرابط:
github.com/anthropics/fermats-last-theorem -
الوصف: الشفرة البرمجية المنشورة لبرهان إصدار سبتمبر؛ ولا تتطابق البيانات الواردة في README مع إحصاءات تجربة نوفمبر
-
حالة استخدام رسمية لـ Lean: إضفاء الطابع الرسمي على مبرهنة فيرما الأخيرة
- الرابط:
lean-lang.org/use-cases/flt -
الوصف: للتعرّف على Lean وخلفية الرياضيات الرسمية
-
وثائق نموذج Fable 5.2: مواصفات النموذج وترحيل واجهة API
- الرابط:
platform.claude.com/docs/en/models/fable-5-2/overview - الوصف: نافذة السياق، والحد الأقصى للمخرجات، ومعلومات الأسعار
المؤلف: فريق APIYI التقني
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI. ويمكنكم الاطلاع على مزيد من المواد في مركز التوثيق docs.apiyi.com