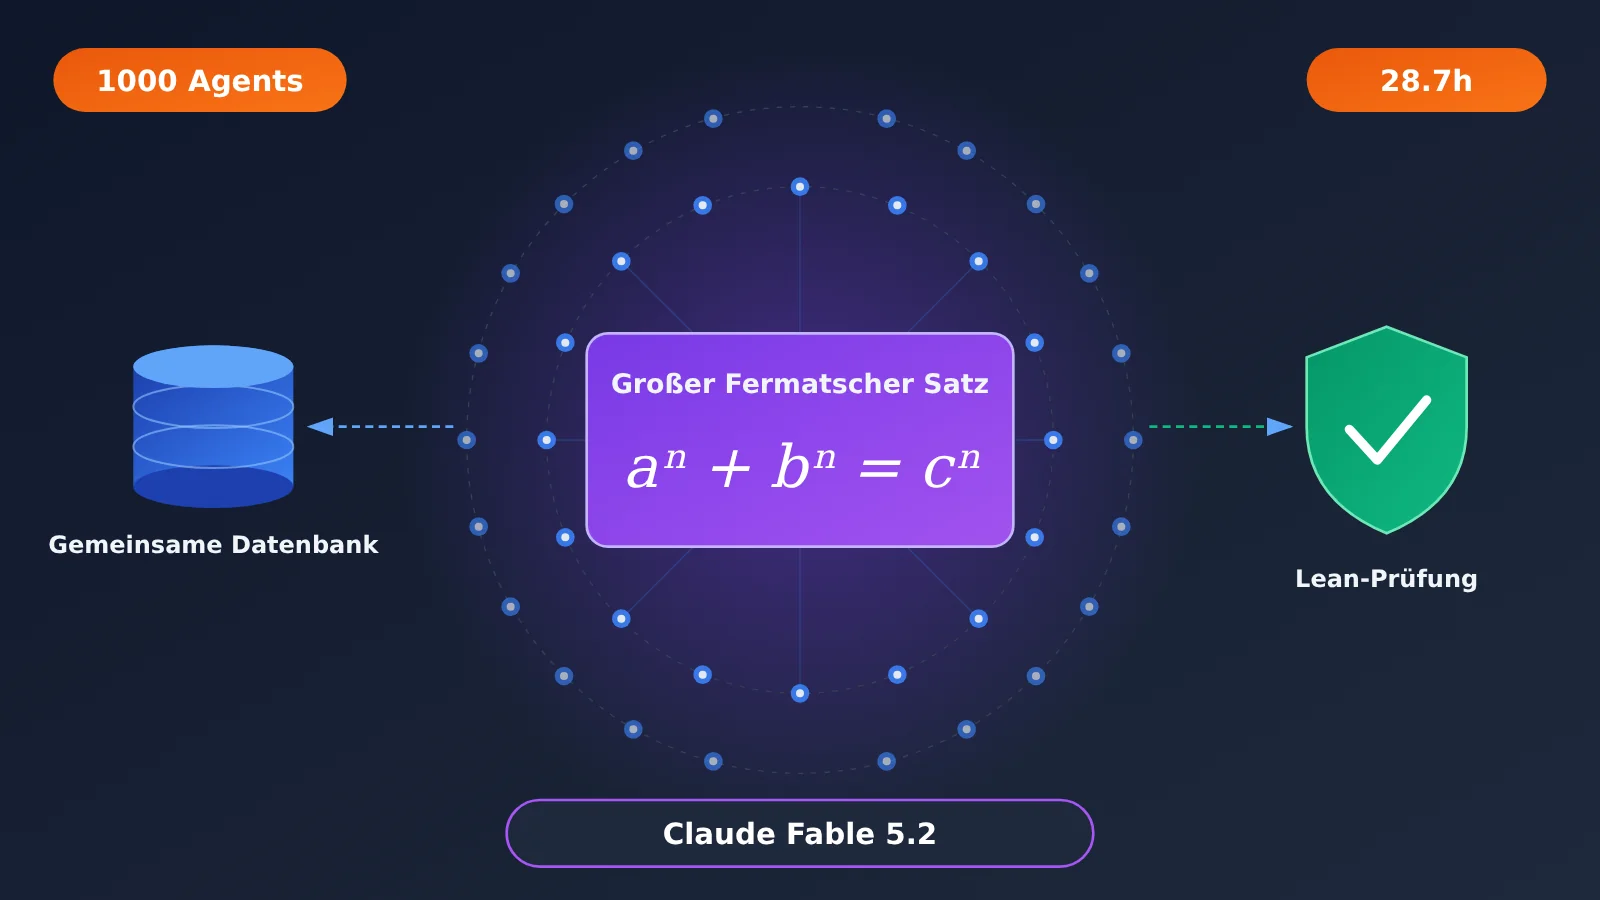
Am 9. November 2026 veröffentlichte Anthropic in seinem offiziellen Engineering-Blog ein Multi-Agenten-Experiment: 1000 Claude-Fable-5.2-Agenten arbeiteten zusammen und formalisierten den Großen Fermatschen Satz in 28,7 Stunden am Computer. Am Ende bestand der Beweis die Prüfung durch den offiziellen Lean-Kern. Das erste Formalisierungsexperiment, das zwei Monate zuvor stattfand, wurde von mehreren Dutzend Agenten durchgeführt und dauerte elf Tage.
Das bedeutet nicht, dass „KI den Großen Fermatschen Satz in 30 Stunden bewiesen hat“. Der Satz wurde bereits in den 1990er-Jahren von Andrew Wiles und Richard Taylor bewiesen. Bei diesem Experiment ging es darum, den bestehenden Beweisweg in einen formalisierten Beweis zu übertragen, den ein Computer Schritt für Schritt überprüfen kann. Die eigentliche Frage dieses Artikels lautet also: Wie konnten 1000 KI-Agenten in weniger als 30 Stunden gemeinsam ein so komplexes Vorhaben abschließen?
Der zentrale Mehrwert: Nach der Lektüre kennen Sie die wichtigsten Daten des Formalisierungsexperiments zum Großen Fermatschen Satz, die Organisation und den Verifizierungsmechanismus der 1000 Agenten sowie die Bedeutung und die Grenzen des Experiments für Agentensysteme in Unternehmen.
Zentrale Fakten zum Formalisierungsexperiment zum Satz von Fermat
Die folgende Tabelle fasst die wichtigsten Fakten zum Experiment mit Claude Fable 5.2 zusammen. Dabei sind einige leicht zu verwechselnde Details wichtig: Verwendet wurde eine frühe Modellversion, das Experiment arbeitete mit vorgegebenen Eingaben, und Anthropic ordnete es ausdrücklich als Toy-Experiment – also als experimentelle Demonstration – ein.
| Information | Details |
|---|---|
| Veröffentlichungsdatum | 9. November 2026, offizieller Engineering-Blog von Anthropic |
| Verwendetes Modell | Frühe Version von Claude Fable 5.2 (die Ausrichtung wurde vor der offiziellen Veröffentlichung noch nicht abschließend bewertet) |
| Teamgröße | 1 Leitagent + 999 Hilfsagenten |
| Dauer | 28,7 Stunden; anschließend prüfte der offizielle Lean-Kernel den endgültigen Beweis (in der offiziellen Ankündigung auf 30 Stunden gerundet) |
| Vorgegebene Eingaben | 60 Aussagen, eine knappe Zusammenfassung des klassischen Beweiswegs, relevante Definitionen und 47 Lemmata, die bereits in einer früheren Formalisierung bewiesen worden waren |
| Werkzeugumgebung | Lean-Toolchain, Mathlib, Git, gemeinsam genutzte PostgreSQL-Datenbank und voneinander getrennte virtuelle Maschinen als Sandbox |
| Offizielle Einordnung | Toy-Experiment, kein erstmaliger Beweis des Satzes von Fermat |
Formalisierung des Satzes von Fermat: Die Voraussetzungen des Experiments
Die Forschenden gaben den Agenten nicht einfach nur den Auftrag „Beweise den Satz von Fermat“ und überließen ihnen dann alles Weitere. Die Agenten erhielten 60 Aussagen – darunter den endgültigen Satz und 59 Zwischenziele –, eine Zusammenfassung des Beweiswegs, Definitionen sowie 47 Lemmata, die bereits im vorherigen Experiment bewiesen worden waren. Auch die Rollen von Leit- und Hilfsagenten hatten die Forschenden vorab festgelegt.
Das Experiment prüfte also eine andere Fähigkeit: Kann sich ein großes Agententeam mit vorgegebenen mathematischen Grundlagen und Werkzeugen selbst organisieren und einen bekannten Beweisweg vollständig in einen maschinell überprüfbaren Beweis überführen? Das ist eher eine ingenieurtechnische Frage als die Frage, ob „KI Mathematik kann“.
Warum ist es so schwierig, Fermats letzten Satz zu formalisieren?
Fermats letzter Satz lässt sich einfach formulieren: Für ganze Zahlen (n > 2) gibt es keine positiven ganzen Zahlen (a), (b) und (c), die (a^n + b^n = c^n) erfüllen. Pierre de Fermat stellte die Vermutung im 17. Jahrhundert auf. Sie blieb mehr als 350 Jahre ungelöst. Wiles verkündete 1993 einen Beweis und behob 1994 gemeinsam mit Taylor eine entscheidende Lücke. 1995 wurde der Beweis schließlich veröffentlicht. Das Original umfasst etwa 129 Seiten und stützt sich auf zahlreiche Ergebnisse der modernen Zahlentheorie und algebraischen Geometrie.
Wenn Mathematiker einen Beweis schreiben, können sie sagen: „Das folgt offensichtlich aus dem vorherigen Ergebnis.“ Die Leser ergänzen dann gedanklich die Zwischenschritte. Ein Computer hat dieses Verständnis nicht. Er muss genau wissen, welche Definition, welcher Satz und welche Schlussregel bei jedem Schritt zum Einsatz kommen. Darin liegt die Schwierigkeit der Formalisierung: Was für Menschen „offensichtlich“ ist, kann im Code Hunderte oder Tausende Zeilen erfordern.
Lean, Mathlib und die Formalisierung von Mathematik
Um dieses Experiment zu verstehen, sollte man zunächst drei Begriffe auseinanderhalten:
- Lean: ein interaktiver Theorembeweiser, der prüft, ob ein Beweis strikt den Regeln der formalen Logik entspricht.
- Mathlib: die Mathematikbibliothek für Lean. Sie enthält zahlreiche bereits formalisierte Definitionen und Sätze und funktioniert damit wie eine „Standardbibliothek“, auf die man direkt zurückgreifen kann.
- Formalisierung von Mathematik: die Übertragung eines für Menschen lesbaren mathematischen Beweises in eine logische Struktur, die ein Computer vollständig überprüfen kann.
Der entscheidende Punkt ist: Die KI konstruiert den Beweis, der Lean-Kern überprüft ihn. Wenn ein Modell sagt „Ich habe es bewiesen“, bedeutet das nicht automatisch, dass Lean den Beweis tatsächlich akzeptiert. Dieses Experiment ist gerade deshalb ernst zu nehmen, weil das Endergebnis nicht auf der Selbsteinschätzung des Modells beruht, sondern unabhängig maschinell überprüft wurde.
Wie 1000 KI-Agenten zusammenarbeiten: ein von KI betriebenes Projektmanagementsystem
Das ist der Teil des Claude-Fable-5.2-Experiments, der sich am meisten lohnt. Die 1000 Agenten arbeiteten nicht unabhängig voneinander an ihren Aufgaben, sondern bildeten ein koordiniertes System mit Aufgabenverwaltung, Ressourcenzuweisung und dynamischer Anpassung.
Die Organisationsstruktur des Claude-Fable-5.2-Teams
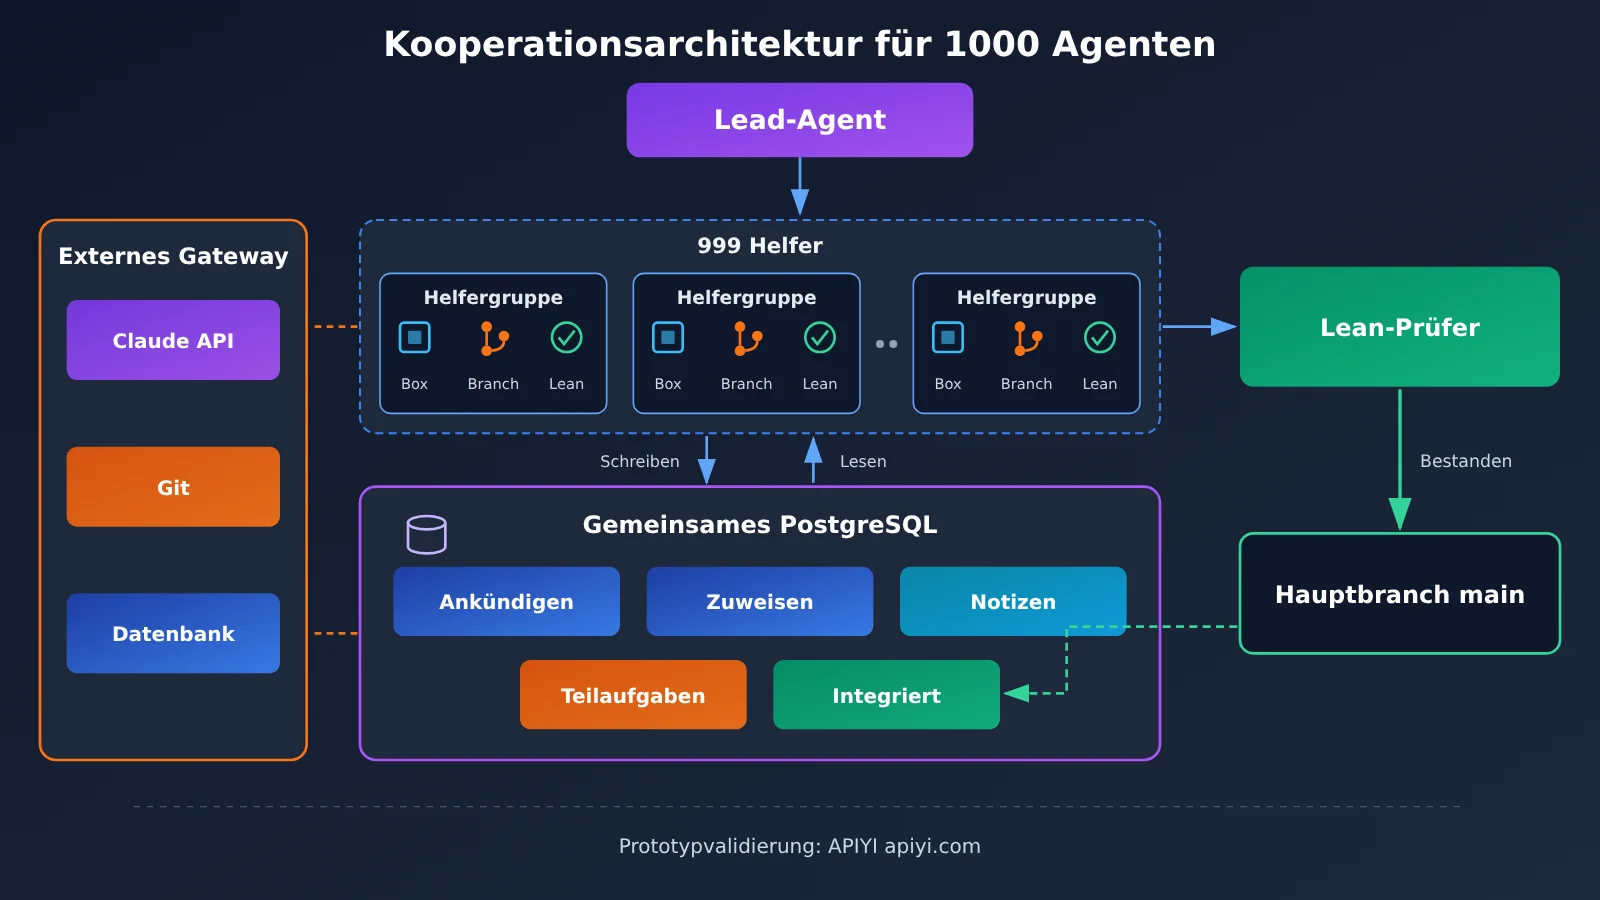
Das Team war einfach hierarchisch aufgebaut: Ein Lead Agent übernahm die Gesamtplanung, teilte die Aufgaben auf und behielt den Fortschritt im Blick. Die 999 Helper Agents kümmerten sich um die konkreten Beweise. Jeder Agent hatte eine eigene, schlanke virtuelle Sandbox mit Shell, Dateieditor, Lean-Toolchain und Mathlib. Außerdem arbeitete jeder in einem eigenen Git-Branch und konnte Merge Requests an den Haupt-Branch stellen.
Keiner der Agenten hatte direkten Internetzugang. Die Kommunikation mit der Claude-API, Git und der Datenbank lief über ein externes Gateway. Dank der getrennten Sandboxes und Branches konnten alle 1000 Agenten gleichzeitig Code ändern, ohne sich gegenseitig Dateien zu überschreiben.
Gemeinsame PostgreSQL-Datenbank: die Schaltzentrale für die Zusammenarbeit von AI Agents
Wenn 1.000 Agents bei der Zusammenarbeit Nachrichten untereinander austauschen, gerät das Kommunikationsvolumen schnell außer Kontrolle. Der Lead Agent geht anders vor: Innerhalb von zehn Minuten nach Beginn des Experiments richtet er fünf gemeinsam genutzte Datenbanktabellen ein. So wird die Kommunikation zu einem „gemeinsamen Whiteboard“, auf das alle zugreifen und in das alle schreiben können.
| Tabellenname | Zweck | Rolle bei der Zusammenarbeit |
|---|---|---|
| Announce | Teamweite Anweisungen veröffentlichen | Rundruf an alle, ähnlich einem Projekt-Schwarzen Brett |
| Assign | Aufgaben und Verantwortliche zuweisen | Klärt, „wer woran arbeitet“, und verhindert Überschneidungen |
| Notes | Fortschritte, Probleme und Arbeitspläne festhalten | Teilt Kontext und verringert Informationssilos |
| Subtasks | Teilaufgaben verwalten, die Agents übernehmen können | Aufgabenpool, der die eigenständige Übernahme von Aufgaben unterstützt |
| Landed | Abgeschlossene und geprüfte Arbeiten dokumentieren | Verlässliche Ergebnisliste, in die nur überprüfte Inhalte aufgenommen werden |
Der Vorteil dieses Systems: Ein Agent muss nicht alle anderen 999 Agents einzeln kontaktieren. Ein Blick in die Datenbank genügt, um zu sehen, welche Aufgaben anstehen, welche bereits erledigt sind und wo Abhängigkeiten bestehen. Die Ergebnisse werden anschließend per Git in den Hauptbranch übernommen. Den veröffentlichten Zahlen zufolge gab es während des gesamten Ablaufs etwa 36.612 Datenbankschreibvorgänge und 311.734 Lesevorgänge. Davon entfielen rund 20.600 Schreibvorgänge auf Notes und etwa 14.800 auf Subtasks. Die meisten Skriptaufrufe sind in dieser Statistik nicht enthalten. Dass deutlich häufiger gelesen als geschrieben wurde, zeigt auch, dass die Agents die meiste Zeit den „globalen Status“ abfragen.
Dynamische Aufgabenverteilung: von der festen Zuweisung zur eigenständigen Aufgabenübernahme
Der Ablauf der Aufgabenverteilung in diesem Experiment blieb nicht durchgehend gleich. Die folgende Zeitleiste zeigt, wie sich die Organisation schrittweise verändert hat:
| Zeitpunkt | Wichtiges Ereignis |
|---|---|
| Minute 10 | Lead legt fünf gemeinsam genutzte Datenbanktabellen an |
| etwa Minute 27 | 3 Sätze sind bewiesen |
| kurz danach | Lead stellt 47 Sätze, die innerhalb des Budgets voraussichtlich schwer zu beweisen sind, vorläufig zurück und konzentriert die Ressourcen auf 10 andere Sätze |
| etwa Minute 70 | Alle 10 Sätze sind bewiesen. Lead weist den Agents anschließend schwierigere Sätze zu |
| etwa Stunde 3 | Lead erlaubt untätigen Agents, Aufgaben eigenständig zu übernehmen, statt auf eine Zuweisung zu warten |
| Stunde 5,6 | 73 Helper haben 756 Aufgaben erstellt |
| etwa Stunde 18 | Der Lauf wird anhand des letzten gespeicherten Zustands wieder aufgenommen und 12 Stunden lang fortgesetzt |
| Stunde 28,4 | Die Sätze im Zusammenhang mit Langlands–Tunnell sind bewiesen |
| Stunde 28,7 | Fermats letzter Satz ist bewiesen und besteht die offizielle Kernel-Prüfung |
Zwei Details sind bemerkenswert. Erstens entspricht der Wechsel von der Aufgabenverteilung durch den Lead zur eigenständigen Aufgabenübernahme durch die Agents dem Übergang von zentraler Steuerung zu einem Aufgabenpool. Dadurch sinkt das Risiko, dass der Lead zum Engpass wird. Zweitens wurde das Experiment etwa zur 18. Stunde anhand eines gespeicherten Zustands wieder aufgenommen. Die 28,7 Stunden bedeuten also nicht, dass alle Agents von Anfang bis Ende ohne Unterbrechung gearbeitet haben.
Die 47 vorläufig zurückgestellten Sätze haben außerdem nichts mit den 47 Lemmata in der vorgegebenen Eingabe zu tun. Wer die offiziellen Unterlagen liest, sollte diese beiden Zahlen nicht verwechseln.
Langlands–Tunnell: 750 Agenten nehmen gemeinsam die schwierigste Hürde bei der Formalisierung von Fermats letztem Satz
Kurz vor dem Ziel stieß das Team auf den schwierigsten Brocken: eine mit Langlands–Tunnell verbundene Aussage, ein wichtiges mathematisches Ergebnis auf dem Weg zu Wiles’ Beweis. Die Agenten, die anfangs für diesen Teil zuständig waren, schätzten, dass dafür 700.000 bis eine Million Zeilen Lean-Code nötig sein könnten. Sie hielten es für weniger als ein Prozent wahrscheinlich, die Aufgabe in der verbleibenden Zeit abzuschließen.
Daraufhin bündelte Lead rund 750 Helper für diese Aufgabe. Die Agenten bauten selbstständig einen mehrstufigen Aufgabenbaum auf:
- Aufteilung in 10 Hauptbereiche;
- insgesamt 2.418 Teilaufgaben;
- eine maximale Tiefe des Aufgabenbaums von 10 Ebenen;
- Hunderte Agenten, die gleichzeitig an verschiedenen Teilaufgaben arbeiteten.
Langlands–Tunnell war nach 28,4 Stunden abgeschlossen; 0,3 Stunden später folgte Fermats letzter Satz. Das Beispiel zeigt, dass der Wert massiver Parallelisierung nicht einfach darin liegt, dass „mehr Leute schneller rechnen“. Entscheidend ist vielmehr, ein Problem, das sich nicht direkt angehen lässt, in viele kleine Aufgaben zu zerlegen, die unabhängig bearbeitet, einzeln geprüft und anschließend zusammengeführt werden können. Gelingt die Aufteilung nicht, warten 750 Agenten nur aufeinander oder erledigen dieselbe Arbeit mehrfach.
Warum die Formalisierung von Fermats letztem Satz gelang: Lean-Prüfung und Sicherheitsmechanismen
Für die Zuverlässigkeit des Experiments sorgten drei Sicherheitsebenen.
Die erste Ebene ist die Ergebnisprüfung. Jedes Teilresultat musste die Prüfung durch Lean bestehen, bevor es in den Hauptbranch übernommen werden konnte. Die Tabelle „Landed“ erfasste nur erfolgreich geprüfte Arbeit. Den abschließenden Beweis überprüfte der offizielle Kernel-Prüfer. Lead Agent hielt dazu wörtlich fest: „Fermat’s Last Theorem is on main, kernel-checked by the official checker.“
Die zweite Ebene ist die Trennung bei der Zusammenarbeit. Separate Sandboxes und Git-Branches hielten Dateikonflikte und gegenseitige Beeinflussung zwischen den Agenten auf einem sehr niedrigen Niveau.
Die dritte Ebene sind die Sicherheitsgrenzen. Im Experiment kam ein frühes Modell zum Einsatz, dessen Sicherheitsausrichtung noch nicht im Rahmen der offiziellen Veröffentlichung evaluiert worden war. Deshalb richtete Anthropic mehrere Schutzmaßnahmen ein:
- Kein Internetzugriff und kein direkter Zugriff auf die Sandboxes anderer Agenten;
- Befehle wurden mit nicht privilegierten Konten ausgeführt;
- Eine externe Gateway-Komponente verwaltete die Kommunikation mit APIs, Git und Datenbanken;
- Echtzeitklassifizierer prüften Shell-Befehle und Dateiänderungen, während Offline-Monitore die Aktionsprotokolle zusätzlich kontrollierten.
Im Experiment gab es insgesamt mehr als eine Million Tool-Aufrufe. Keiner davon erreichte die Schwelle, ab der ein Eingreifen erforderlich gewesen wäre. Anthropic erklärte außerdem, nach dem Experiment eine parallele Überwachung der Gedankengänge ergänzt zu haben. Die zentrale Erkenntnis lautet: Bei einem zuverlässigen Agentensystem reicht es nicht, nur darauf zu achten, ob das Modell eine Aufgabe erledigen kann. Es braucht auch unabhängige Prüfungen, klare Berechtigungsgrenzen und eine nachvollziehbare Ausführungsumgebung.
Von 11 Tagen auf 28,7 Stunden: Vergleich zweier Experimente mit Claude Fable 5.2
Die beiden Experimente zur Formalisierung des großen fermatschen Satzes basieren auf unterschiedlichen Rahmenbedingungen und sollten getrennt betrachtet werden:
| Kennzahl | Erstes Experiment (veröffentlicht im September 2026) | Zweites Experiment (veröffentlicht am 9. November 2026) |
|---|---|---|
| Modell | Internes Forschungsmodell (ungefähr auf dem Niveau von Fable 5.1) | Frühe Version von Fable 5.2 |
| Anzahl der Agenten | Mehrere Dutzend | 1000 |
| Ausführungszeit | 11 Tage | 28,7 Stunden |
| Ausgabetoken | Etwa 6 Milliarden | Laut offizieller Angabe etwa ein Drittel des Werts aus dem ersten Experiment |
| Länge des Beweises | Referenzwert (etwa 13 Millionen Zeilen Lean-Code) | Etwa ein Siebtel der Länge des ersten Beweises |
| Kollaborationsplattform | Prove2Me + Claude-Code-Multi-Agent-Harness | Allgemeine Tools + PostgreSQL |
| Anleitung durch Menschen | Der Forscher Tianyi Peng gab wenige allgemeine Hinweise | Keine fortlaufende Anleitung zum mathematischen Vorgehen |
Wichtig ist: Die Angaben von 6 Milliarden Token, 13 Millionen Codezeilen und etwa 30.300 Theoremen beziehen sich alle auf das erste Experiment. Für das zweite Experiment hat Anthropic weder die absolute Tokenzahl noch die Gesamtkosten oder die genaue Zahl der Codezeilen veröffentlicht.
Auch beim ersten Experiment lief es anfangs nicht reibungslos: Die Agenten hatten Schwierigkeiten, den Gesamtstatus im Blick zu behalten und zu erkennen, was andere bereits erledigt hatten. Dadurch kam es zu Doppelarbeit. Die später eingeführte Plattform Prove2Me verwaltete die Abhängigkeiten zwischen Theoremen in einem DAG und bot Funktionen für den Aufgabenstatus, die Theoremsuche und eine schnellere Kompilierung. Beim zweiten Experiment kam diese Spezialplattform nicht mehr zum Einsatz. Stattdessen bauten die Agenten mit einer allgemeinen Datenbank und Git selbst einen Kollaborationsmechanismus auf; fünf Tabellen übernahmen dabei ähnliche Aufgaben.
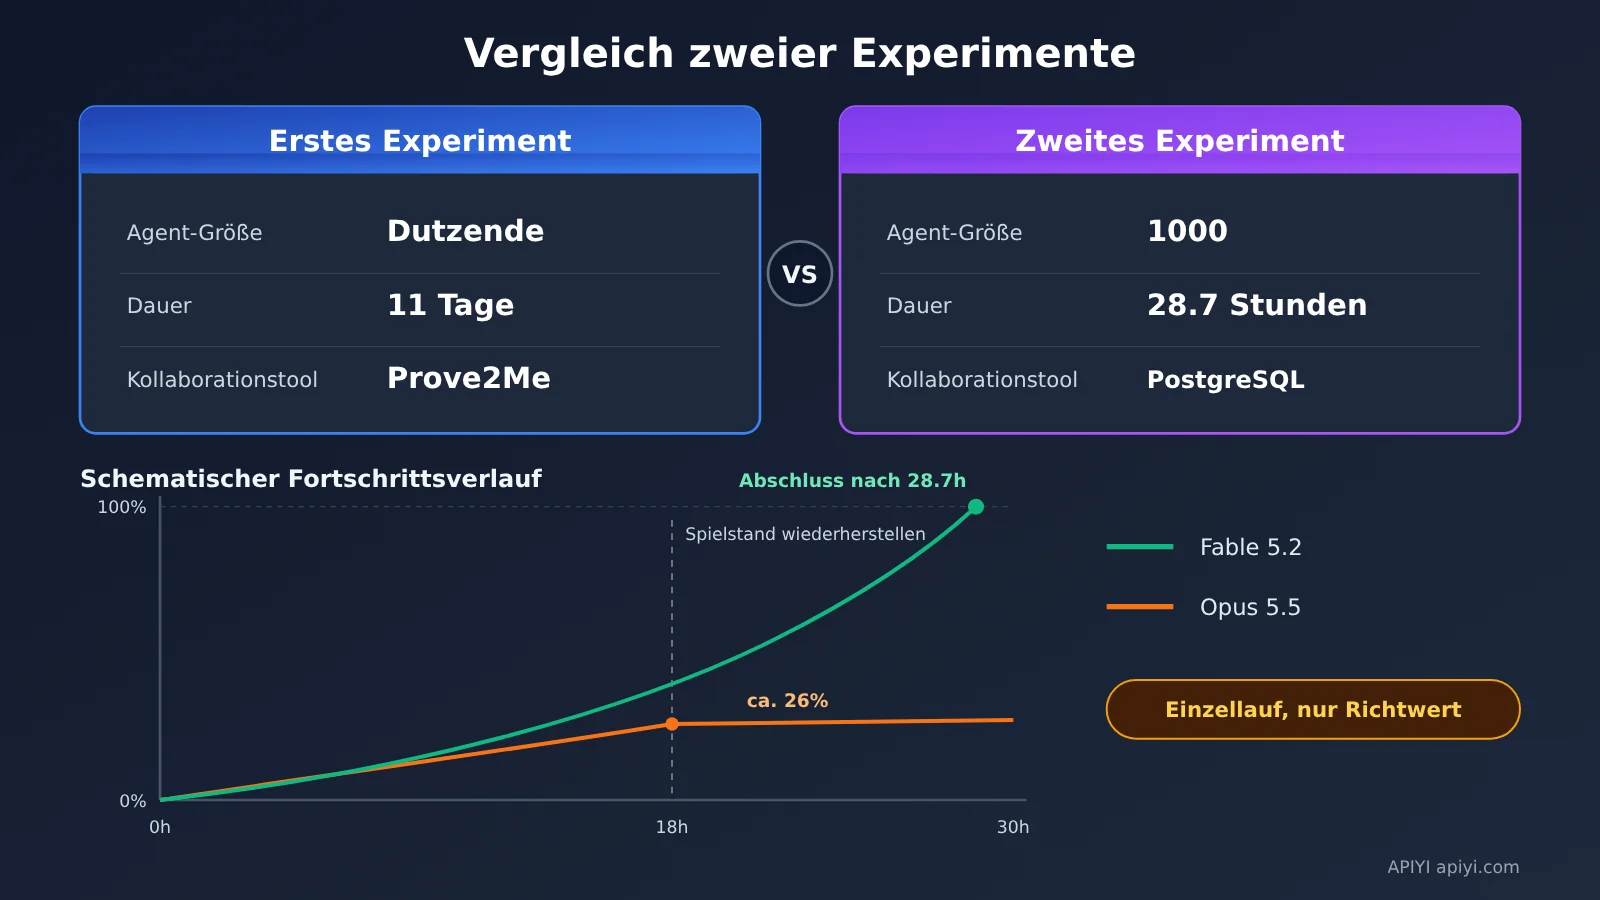
Anthropic führte mit derselben Konfiguration aus 1000 Agenten auch einen Vergleich durch: Opus 5.5 schloss innerhalb von 18 Stunden etwa 26 % ab, machte bis zur 30. Stunde aber kaum noch Fortschritte. Fable 5.2 bewies das letzte Theorem nach 28,7 Stunden. Beide Läufe wurden nach etwa 18 Stunden aus einem gespeicherten Zustand wieder aufgenommen. Da jedes Modell jedoch nur einmal ausgeführt wurde, lässt sich daraus kein allgemeiner Leistungsunterschied bei komplexen Aufgaben ableiten.
Auswirkungen von 1.000 AI-Agent-Experimenten auf Unternehmen
Für Entwickler: Vier zentrale Fähigkeiten Multi-Agenten-Systeme
Lässt man den mathematischen Hintergrund außer Acht, lassen sich die in diesem Experiment erprobten Fähigkeiten typischen Unternehmensszenarien zuordnen:
| Fähigkeit | Umsetzung im Experiment | Übertragung auf Unternehmensszenarien |
|---|---|---|
| Komplexe Aufgaben zerlegen | 2.418 Teilaufgaben, Aufgabenbaum mit bis zu 10 Ebenen | Groß angelegte Code-Refactorings, komplexe Rechercheberichte |
| Ressourcen dynamisch zuweisen | Schwierige Probleme zurückstellen und 750 Helper gezielt darauf ansetzen | Agents und Rechenleistung nach Priorität neu verteilen |
| Gemeinsamen Status verwalten | Fünf PostgreSQL-Tabellen und Git-Merges | Zentrales Aufgabenboard, weniger Doppelarbeit |
| Ergebnisse unabhängig überprüfen | Der Lean-Kernel prüft jeden Commit | Unit-Tests, Datenvalidierung, manuelle Prüfung |
Die wichtigste Erkenntnis für Entwickler: Sie müssen nicht gleich eine komplexe Spezialplattform aufbauen. Eine gut konzipierte gemeinsame Datenbank zusammen mit Versionskontrolle reicht aus, um die Zusammenarbeit einer beträchtlichen Anzahl von Agents zu ermöglichen. Hier ein stark vereinfachtes Beispiel für einen Modellaufruf:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche API von APIYI
)

response = client.chat.completions.create(
    model="claude-fable-5-2",  # Maßgeblich ist die Modellliste der Plattform
    messages=[{"role": "user", "content": "把这个任务拆成可独立验证的子任务"}]
)
print(response.choices[0].message.content)
Beispielcode für den Lead-/Helper-Aufgabenpool anzeigen
import sqlite3
import openai

# SQLite simuliert lokal die Tabellen Subtasks und Landed aus dem Experiment (dort kam tatsächlich PostgreSQL zum Einsatz)
db = sqlite3.connect("board.db")
db.execute("CREATE TABLE IF NOT EXISTS subtasks (id INTEGER PRIMARY KEY, goal TEXT, status TEXT, owner TEXT)")
db.execute("CREATE TABLE IF NOT EXISTS landed (task_id INTEGER, result TEXT)")

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def lead_plan(goal: str):
    """Lead: Aufgabe zerlegen und in den Aufgabenpool eintragen."""
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": f"将目标拆为3-5个子任务,每行一个:{goal}"}]
    )
    for line in resp.choices[0].message.content.splitlines():
        if line.strip():
            db.execute("INSERT INTO subtasks (goal, status) VALUES (?, 'open')", (line.strip(),))
    db.commit()

def verify(result: str) -> bool:
    """Unabhängige Prüfung: In der Praxis sollte dies durch Tests, Validierungsskripte oder eine Lean-Prüfung ersetzt werden."""
    return len(result) > 0

def helper_claim(name: str):
    """Helper: Aufgabe selbstständig übernehmen und erst nach erfolgreicher Prüfung in Landed eintragen."""
    row = db.execute("SELECT id, goal FROM subtasks WHERE status='open' LIMIT 1").fetchone()
    if not row:
        return
    task_id, goal = row
    db.execute("UPDATE subtasks SET status='doing', owner=? WHERE id=?", (name, task_id))
    db.commit()
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": goal}]
    )
    result = resp.choices[0].message.content
    if verify(result):
        db.execute("INSERT INTO landed VALUES (?, ?)", (task_id, result))
        db.execute("UPDATE subtasks SET status='done' WHERE id=?", (task_id,))
    else:
        db.execute("UPDATE subtasks SET status='open', owner=NULL WHERE id=?", (task_id,))
    db.commit()

lead_plan("为一个开源库补全单元测试")
for i in range(3):
    helper_claim(f"helper-{i}")
🚀 Empfehlung für den schnellen Einstieg: Wenn Sie einen kleinen Prototyp mit „Lead zerlegt die Aufgabe + Helper übernehmen Teilaufgaben + unabhängige Überprüfung“ nachbauen möchten, können Sie sich zunächst über APIYI (apiyi.com) kostenlose Testkontingente sichern. Die Plattform bietet eine OpenAI-kompatible Schnittstelle. Mit einem einzigen API-Schlüssel können Sie zwischen Modellen wie Claude, GPT und Gemini wechseln und so vergleichen, wie gut sich die verschiedenen Modelle als Lead eignen.
Für die Branche: Grenzen sind wichtiger als Zahlen
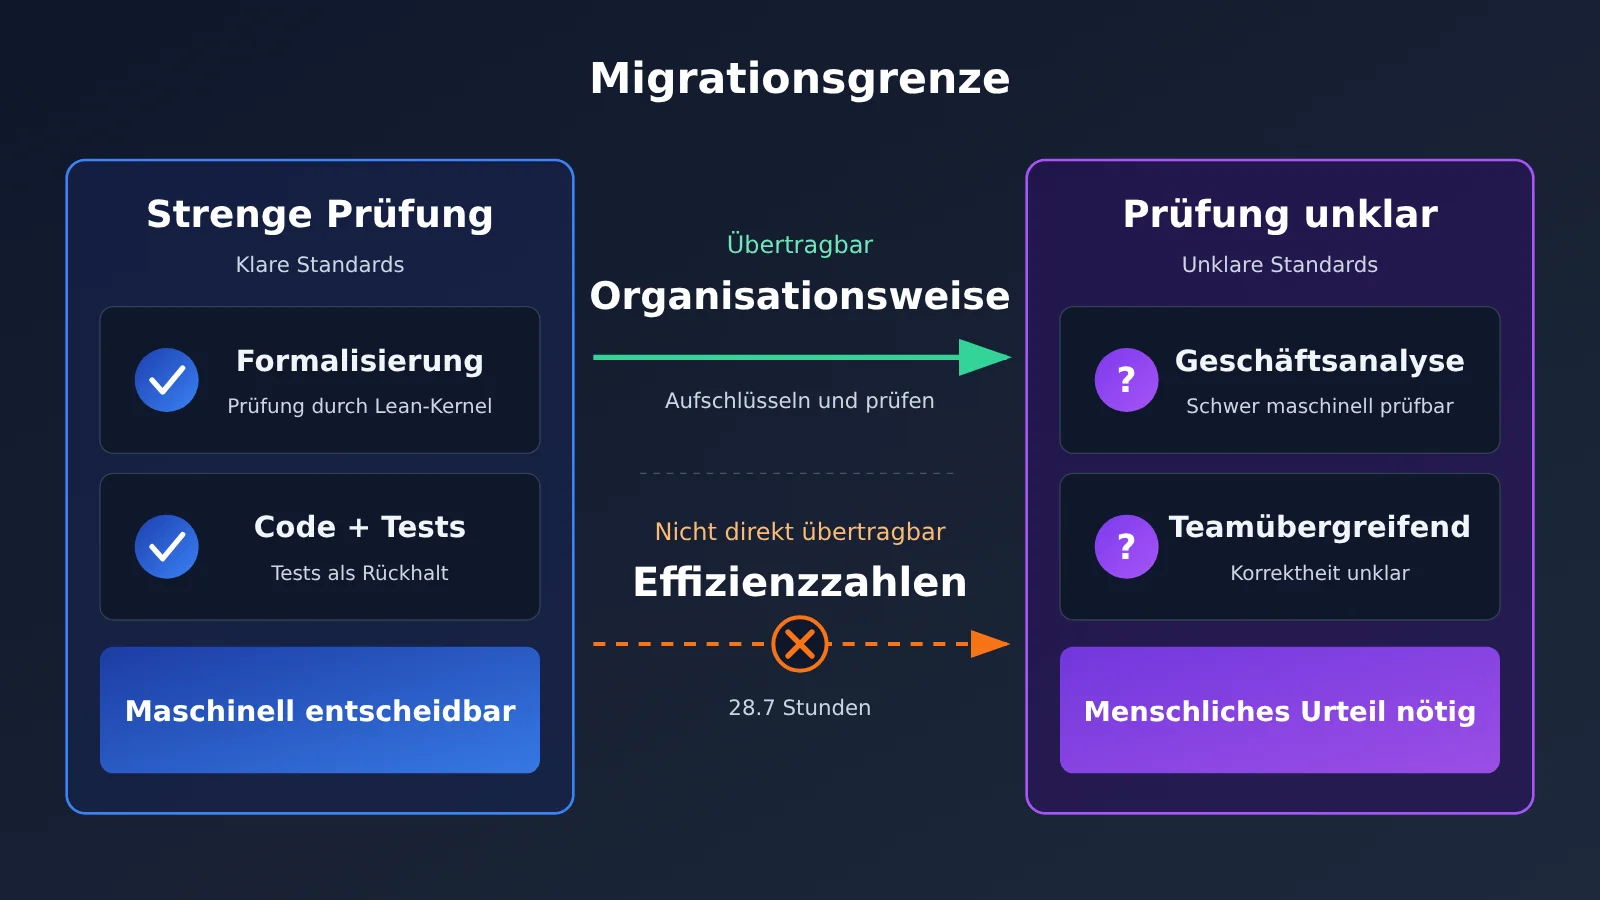
Ein Punkt sollte nüchtern betrachtet werden: Für mathematische Formalisierungen gibt es mit Lean einen strengen, objektiven Verifikator. Bei den meisten Unternehmensaufgaben fehlt ein ebenso eindeutiger Maßstab für Korrektheit. Für Code können Tests als Absicherung dienen, doch ob eine Marktanalyse oder ein abteilungsübergreifender Prozess „korrekt“ ist, lässt sich oft nur schwer maschinell beurteilen. Die 28,7 Stunden und die Erfolgsquote dieses Experiments lassen sich daher nicht einfach auf Agentensysteme in Unternehmen übertragen.
Auch Anthropic selbst weist auf Einschränkungen hin: Agents beurteilen mitunter zu früh, dass eine Aufgabe nicht lösbar sei. Von den 47 Thesen, die anfangs zurückgestellt wurden, konnten später die meisten doch bewiesen werden. An schwierigen Stellen ist die richtungsweisende Unterstützung durch Menschen weiterhin wertvoll. Spezialisierte Werkzeuge für bestimmte Fachgebiete wie Prove2Me könnten außerdem die Effizienz von Kompilierung, Suche und Zusammenarbeit weiter steigern. Das Experiment zeigt weder, dass mehr Agents grundsätzlich besser sind, noch, dass menschliche Fachleute und spezialisierte Harnesses überflüssig geworden sind.
💡 Praxistipp: Wenn Sie eine Multi-Agent-Lösung in einem Unternehmen erproben, beginnen Sie am besten mit Aufgaben, für die es klare Prüfkriterien gibt – etwa testgetriebenen Codeänderungen – und weiten Sie den Einsatz anschließend schrittweise aus. Dank der nutzungsbasierten Abrechnung von APIYI (apiyi.com) können Sie zunächst mit einer kleinen Anzahl von Agents die Aufgabenzerlegung und Überprüfung bewerten und erst danach über eine Ausweitung entscheiden.
Häufig gestellte Fragen (FAQ)
F1: Hat die KI in diesem Experiment den Großen Fermatschen Satz bewiesen?
Nein. Andrew Wiles veröffentlichte 1995 den formalen Beweis des Großen Fermatschen Satzes; gemeinsam mit Taylor korrigierte er ein zentrales Problem. In diesem Experiment wurde ein bereits bekannter Beweisweg unter vorgegebenen Bedingungen – 60 Aussagen, eine grobe Beweisstrategie, Definitionen und 47 bereits bewiesene Lemmata – in einen von Lean überprüfbaren formalen Beweis überführt.
F2: Warum wurden nur 54 der 60 Aussagen als bewiesen markiert?
Bei der Auswertung nach 30 Stunden wurden fünf alternative Aussagen nicht mehr benötigt, eine weitere wurde aufgegeben. Der endgültige Satz war bereits nach 28,7 Stunden erfolgreich überprüft worden. Es war also nicht nötig, alle ursprünglich aufgeführten 60 Aussagen abzuschließen.
F3: Was kostet die API von Claude Fable 5.2?
Der offizielle Preis beträgt 8 $ pro Million Token für Eingaben und 40 $ pro Million Token für Ausgaben. Im Fast Mode sind es 16 $ beziehungsweise 80 $. Das Lesen aus dem Cache kostet 0,20 $ pro Million Token. Für die Batch API gibt es 50 % Rabatt. Das Kontextfenster umfasst 1 Million Token, die maximale Ausgabe 128.000 Token. Die Gesamtkosten des zweiten Experiments wurden offiziell nicht veröffentlicht. Sie lassen sich daher nicht schätzen, indem man die 6 Milliarden Token des ersten Experiments mit dem Preis pro Token multipliziert.
F4: Wie kann ich Claude Fable 5.2 schnell über eine API ausprobieren?
Registrieren Sie sich bei APIYI unter apiyi.com und erstellen Sie einen API-Schlüssel. Legen Sie anschließend `https://api.apiyi.com/v1` als `base_url` fest. Danach können Sie den Beispielcode aus diesem Artikel direkt verwenden. Neue Nutzer erhalten ein kostenloses Testguthaben – ideal, um zunächst einen kleinen Prototyp mit mehreren Agents zu entwickeln.
F5: Braucht ein Multi-Agent-System unbedingt PostgreSQL?
Nein. Entscheidend ist eine gemeinsame Datenquelle, auf die alle Agents lesend und schreibend zugreifen können – ergänzt durch Versionskontrolle und eine unabhängige Überprüfung. Für einen kleinen Prototyp reichen SQLite oder Redis aus. Wenn Sie Modelle über APIYI unter apiyi.com aufrufen, ist Ihr eigenes System für die Speicherung des Zustands verantwortlich. Beides lässt sich unabhängig voneinander kombinieren.
F6: Welche bekannten Einschränkungen hat dieses Experiment?
Die Verantwortlichen bezeichneten es ausdrücklich als „Toy Experiment“. Der Vergleich zwischen Fable und Opus wurde jeweils nur einmal durchgeführt. Zum Einsatz kamen frühe Modellversionen, die mehrere Sicherheitsebenen benötigten. Außerdem gab ein Agent die Aufgabe fälschlicherweise zu früh auf. Menschliche Anleitung und domänenspezifische Werkzeuge sind nach wie vor wertvoll.
Wichtigste Erkenntnisse: 1.000 KI-Agenten formalisieren den Großen Fermatschen Satz
- Worum es bei dem Experiment ging: Ein bereits vorhandener Beweis wurde in Lean-Code formalisiert und damit überprüfbar gemacht. Der Große Fermatsche Satz wurde also nicht zum ersten Mal bewiesen.
- Die wichtigsten Zahlen: 1.000 frühe Fable-5.2-Agenten benötigten 28,7 Stunden. Anschließend wurde das Ergebnis vom offiziellen Lean-Kernel geprüft.
- Das Organisationsmodell: Ein Lead und 999 Helper arbeiteten mithilfe von fünf gemeinsam genutzten Datenbanktabellen und Git zusammen.
- Der Ansatz für die besonders anspruchsvolle Aufgabe: Rund 750 Agenten zerlegten den Langlands-Tunnell-Beweis in 2.418 Teilaufgaben mit bis zu zehn Verschachtelungsebenen.
- Die Grundlage für die Zuverlässigkeit: Lean überprüfte die Beweise unabhängig, die Ausführung fand in einer Sandbox statt. Mehr als eine Million Tool-Aufrufe waren möglich, ohne dass eingegriffen werden musste.
- Die Grenzen der Übertragbarkeit: Bei Aufgaben in Unternehmen fehlt oft ein Prüfer wie Lean. Die Effizienzwerte lassen sich daher nicht ohne Weiteres auf andere Bereiche übertragen.
- Der Einstieg: Über die einheitliche Schnittstelle von APIYI (apiyi.com) lässt sich ein kleiner Prototyp mit Lead- und Helper-Agenten nachbauen.
Zusammenfassung
Die wichtigsten Erkenntnisse aus dem Experiment mit 1.000 Claude-Fable-5.2-Agenten:
- Das System zählt mehr als einzelne Komponenten: Die Kombination aus Modellleistung, Aufgabenzerlegung, gemeinsam genutztem Zustand, paralleler Ausführung und maschineller Prüfung ermöglichte das Ergebnis in 28,7 Stunden.
- Verifizierung schafft Vertrauen: Die Prüfung durch den Lean-Kernel trennt klar zwischen „Das Modell behauptet, fertig zu sein“ und „Die Aufgabe ist tatsächlich abgeschlossen“.
- Die Grenzen müssen klar benannt werden: Vorgegebene Eingaben, frühe Modellversionen, ein einzelner Vergleich und der Charakter eines Toy-Experiments schränken die Aussagekraft des Ergebnisses ein.
Das Experiment wirft eine wichtige Frage für die Branche auf: Verlagert sich der Wettbewerb bei KI-Systemen künftig von der Leistungsfähigkeit einzelner Modelle hin zur Fähigkeit, zahlreiche Agenten zu organisieren und komplexe Aufgaben bewältigen zu lassen? Entwickler können schon heute mit einem kleinen Multi-Agenten-Prototyp starten, dessen Ergebnisse unabhängig überprüft werden. Für einen schnellen Praxistest empfiehlt sich APIYI (apiyi.com): Die Plattform bietet kostenloses Testguthaben und eine einheitliche Schnittstelle für mehrere Modelle.
📚 Weiterführende Quellen
- Anthropic Engineering-Blog: Safely scaling multi-agent teams with Claude Fable 5.2
- Link:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2 -
Hinweis: Organisationsstruktur, Datenbank-Zusammenarbeit und Sicherheitsmechanismen des zweiten Experiments sowie der Vergleich mit Opus
-
Anthropic-Forschungsartikel: Formalizing Fermat’s Last Theorem
- Link:
anthropic.com/research/formalizing-fermats-last-theorem -
Hinweis: Daten des ersten Formalisierungsexperiments und die Zusammenarbeit mit Prove2Me
-
Offizielles Lean-Beweis-Repository von Anthropic: Erste Version des formalisierten Beweises
- Link:
github.com/anthropics/fermats-last-theorem -
Hinweis: Der veröffentlichte Beweiscode aus dem September; die Daten in der README entsprechen nicht den Statistiken des November-Experiments
-
Offizielles Lean-Beispiel: Formalizing Fermat’s Last Theorem
- Link:
lean-lang.org/use-cases/flt -
Hinweis: Hintergrundwissen zu Lean und formalisierter Mathematik
-
Modelldokumentation zu Fable 5.2: Modellspezifikationen und API-Migration
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Hinweis: Kontextfenster, Ausgabelimits und Preisinformationen
Autor: Technisches Team von APIYI
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.