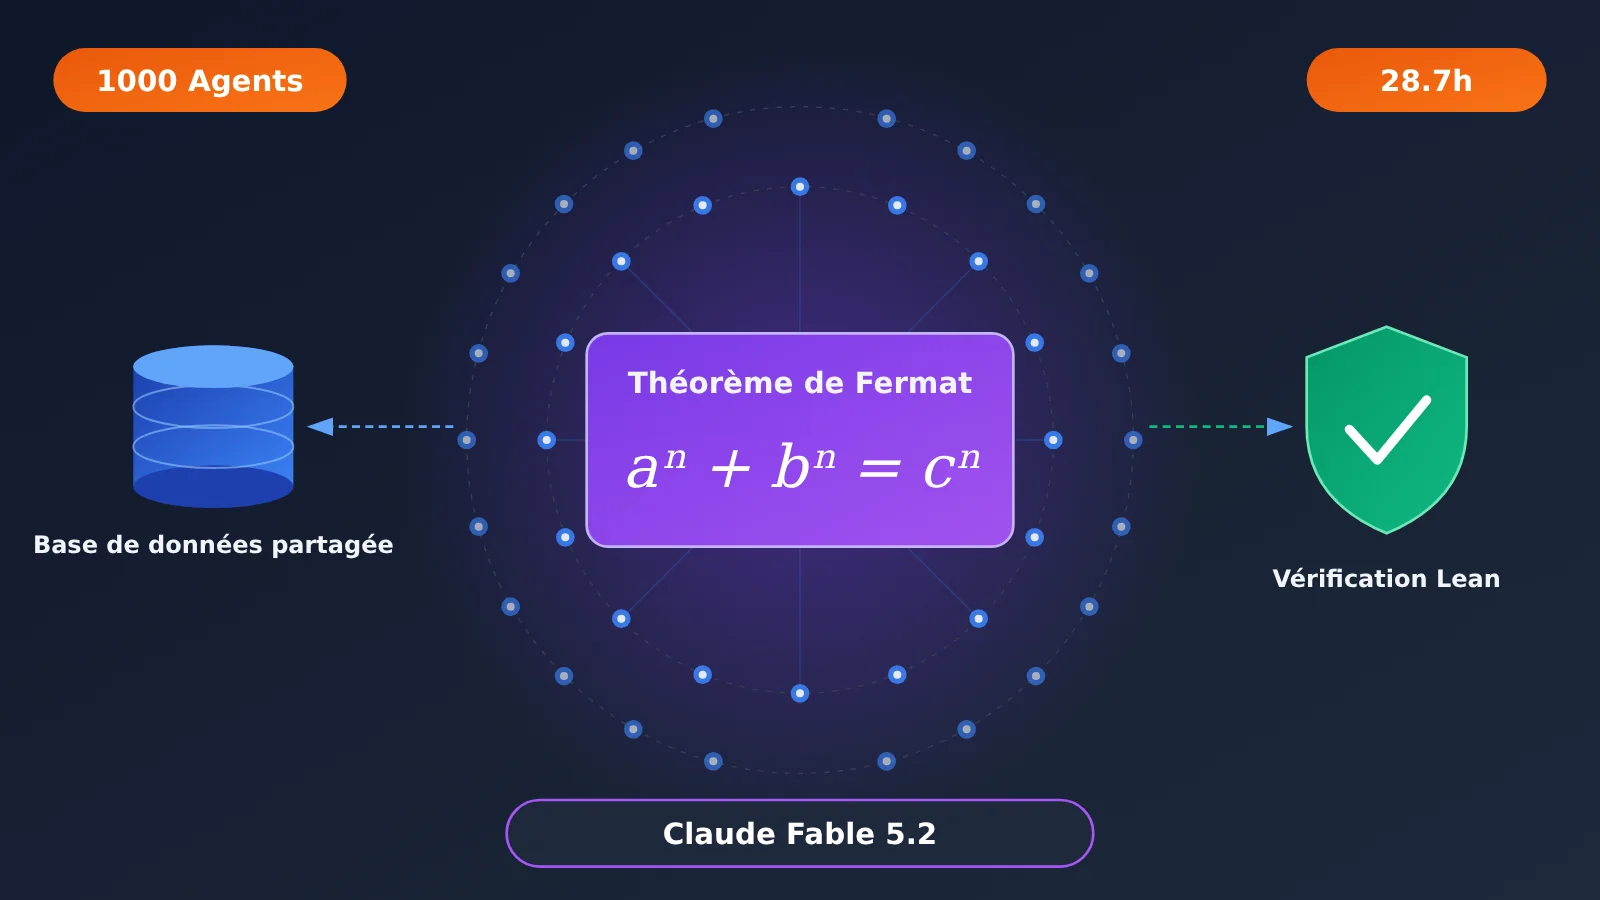
Le 9 novembre 2026, Anthropic a publié sur son blog officiel consacré à l’ingénierie une expérience multi-agents : 1 000 agents Claude Fable 5.2 ont collaboré pendant 28,7 heures pour formaliser le dernier théorème de Fermat, et la preuve obtenue a passé la vérification du noyau officiel de Lean. Deux mois plus tôt, la première expérience de formalisation avait mobilisé plusieurs dizaines d’agents pendant 11 jours.
Cela ne signifie pas que « l’IA a démontré le dernier théorème de Fermat en 30 heures ». Ce théorème avait déjà été démontré dans les années 1990 par Andrew Wiles et Richard Taylor. L’expérience a consisté à traduire une preuve existante en une preuve formalisée que l’ordinateur peut vérifier étape par étape. La vraie question est donc la suivante : comment 1 000 agents IA ont-ils pu mener à bien une tâche d’une telle complexité en moins de 30 heures ?
L’essentiel : vous découvrirez les chiffres clés de cette expérience de formalisation du dernier théorème de Fermat, l’organisation des 1 000 agents et leur mécanisme de vérification, ainsi que les enseignements et les limites de l’expérience pour les systèmes d’agents en entreprise.
Aperçu des informations clés sur l’expérience de formalisation du dernier théorème de Fermat
Commençons par un tableau qui résume les faits essentiels de cette expérience avec Claude Fable 5.2. Attention à ne pas confondre certains éléments : le modèle était une version préliminaire, l’expérience reposait sur des données d’entrée prédéfinies et l’équipe l’a clairement présentée comme une démonstration expérimentale (toy experiment).
| Élément | Détails |
|---|---|
| Date de publication | 9 novembre 2026, sur le blog d’ingénierie officiel d’Anthropic |
| Modèle utilisé | Version préliminaire de Claude Fable 5.2 (les évaluations d’alignement préalables à sa sortie officielle n’étaient pas terminées) |
| Taille de l’équipe | 1 agent principal + 999 agents auxiliaires |
| Durée | 28,7 heures ; le théorème final a passé la vérification du noyau officiel de Lean (arrondie à 30 heures dans l’annonce officielle) |
| Données d’entrée prédéfinies | 60 propositions, un résumé en une phrase de la démonstration classique, les définitions pertinentes et 47 lemmes déjà démontrés lors de la formalisation précédente |
| Environnement technique | Chaîne d’outils Lean, Mathlib, Git, base de données PostgreSQL partagée et environnements sandbox indépendants sur des machines virtuelles |
| Présentation officielle | Toy experiment : une démonstration expérimentale, et non une première preuve du dernier théorème de Fermat |
Formalisation du dernier théorème de Fermat : les conditions de l’expérience à préciser
Les chercheurs ne se sont pas contentés de dire : « Prouve le dernier théorème de Fermat », puis de laisser les agents se débrouiller. Ceux-ci ont reçu 60 propositions — dont le théorème final et 59 étapes intermédiaires —, un résumé de la démarche, les définitions ainsi que 47 lemmes déjà démontrés lors de l’expérience précédente. Les chercheurs avaient également défini à l’avance les rôles de l’agent principal et des agents auxiliaires.
L’expérience portait donc sur une autre capacité : à partir de bases mathématiques et d’outils fournis, une équipe d’agents à grande échelle peut-elle s’organiser de façon autonome pour traduire en entier une démarche connue en une preuve vérifiable par une machine ? Cette question relève davantage de l’ingénierie que de la question générale « l’IA sait-elle faire des mathématiques ? ».
Pourquoi formaliser le dernier théorème de Fermat est si difficile
Le dernier théorème de Fermat s’énonce simplement : pour tout entier (n > 2), il n’existe pas d’entiers positifs (a), (b) et (c) tels que (a^n + b^n = c^n). Pierre de Fermat l’a formulé au XVIIᵉ siècle. Il est resté sans démonstration pendant plus de 350 ans. Wiles a annoncé une preuve en 1993, puis a corrigé une faille importante avec Taylor en 1994. La preuve a été publiée officiellement en 1995. Elle faisait environ 129 pages et s’appuyait largement sur des résultats existants en théorie des nombres et en géométrie algébrique.
Quand les mathématiciens rédigent une preuve, ils peuvent écrire « le résultat précédent permet de conclure immédiatement » et laisser le lecteur reconstituer les étapes intermédiaires. Un ordinateur n’a pas cette capacité : il doit savoir quelle définition, quel théorème et quelle règle de raisonnement sont utilisés à chaque étape. C’est là toute la difficulté de la formalisation : ce qui semble « évident » à un humain peut nécessiter des centaines, voire des milliers de lignes de code.
Lean, Mathlib et la formalisation des mathématiques
Pour comprendre cette expérience, il faut d’abord distinguer trois notions :
- Lean : un assistant de preuve interactif qui vérifie qu’une démonstration respecte rigoureusement les règles de la logique formelle.
- Mathlib : la bibliothèque mathématique de Lean. Elle regroupe de nombreuses définitions et théorèmes déjà formalisés, comme une « bibliothèque standard » que l’on peut citer directement.
- Formalisation des mathématiques : la conversion d’une démonstration mathématique lisible par un humain en une structure logique que l’ordinateur peut vérifier intégralement.
Le point essentiel, c’est que l’IA construit la preuve, tandis que le noyau de Lean la vérifie. Le modèle peut affirmer « j’ai démontré le théorème », mais cela ne signifie pas que Lean accepte effectivement sa preuve. Si cette expérience mérite d’être prise au sérieux, c’est précisément parce que le résultat final ne repose pas sur l’auto-évaluation du modèle : il a passé une vérification indépendante par la machine.
Comment 1 000 agents IA collaborent : un système de gestion de projet piloté par l’IA
C’est l’un des aspects les plus intéressants à étudier dans l’expérience Claude Fable 5.2. Les 1 000 agents ne travaillent pas chacun de leur côté : ils forment un système collaboratif doté d’une gestion des tâches, d’une allocation des ressources et d’une capacité d’adaptation dynamique.
L’organisation de l’équipe Claude Fable 5.2
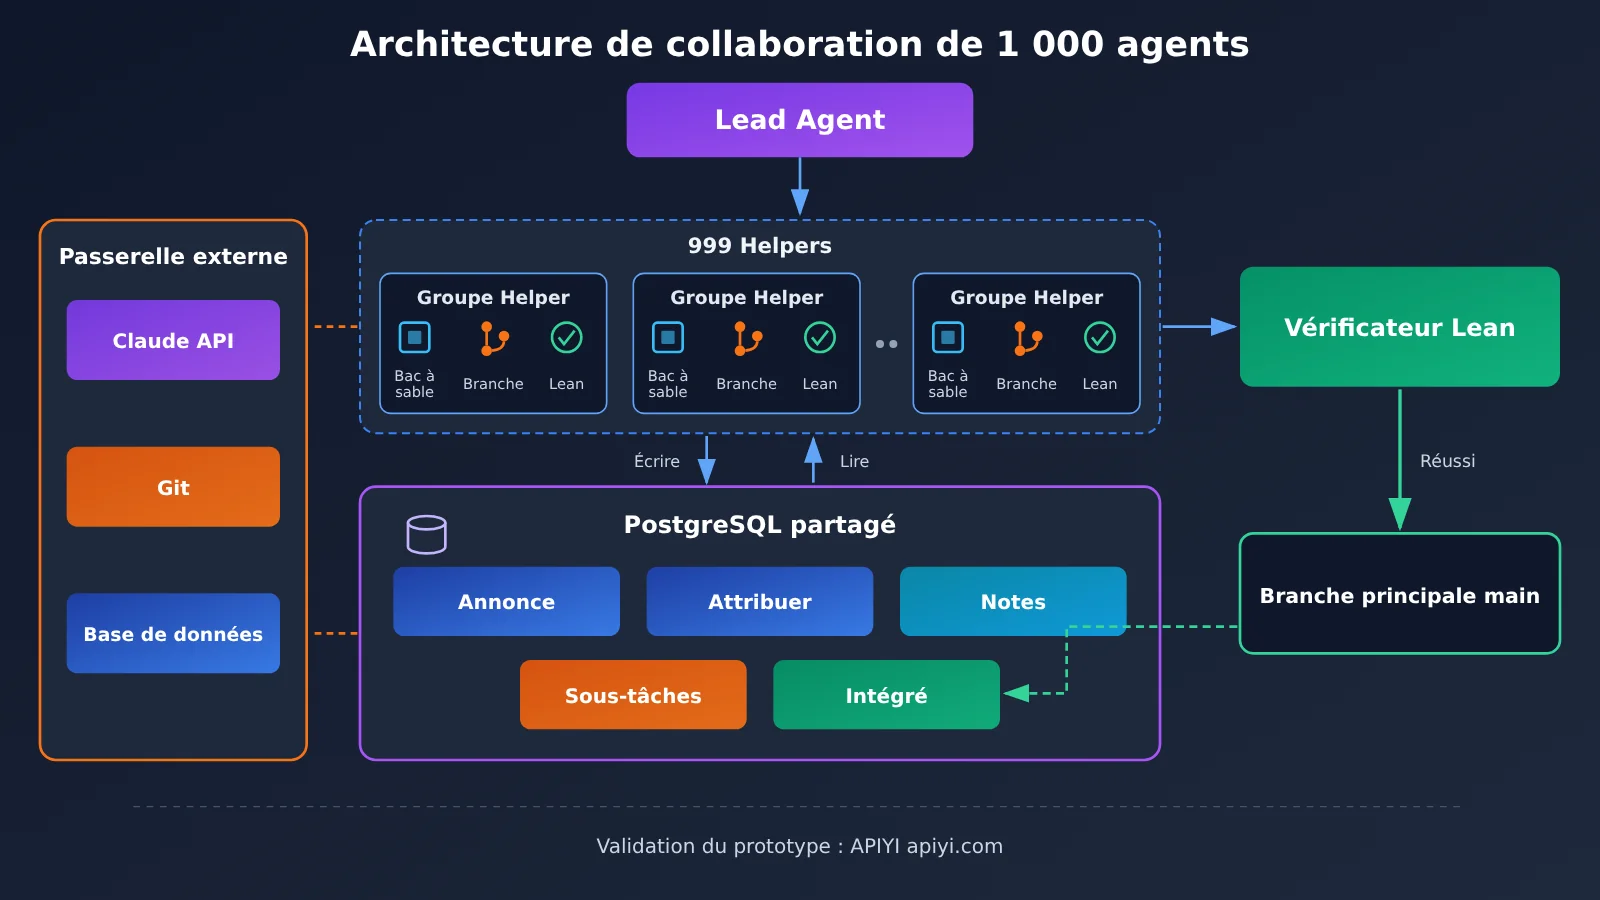
L’équipe repose sur une structure hiérarchique simple : un agent principal se charge de la planification générale, de la décomposition des tâches et du suivi de l’avancement, tandis que 999 agents assistants s’occupent des démonstrations concrètes. Chaque agent dispose de son propre environnement virtuel léger et isolé. Il peut utiliser un shell, un éditeur de fichiers, la chaîne d’outils Lean et Mathlib, et possède sa propre branche Git, sur laquelle il peut soumettre une demande de fusion vers la branche principale.
Aucun agent n’a d’accès direct à Internet. Toutes les communications avec Claude API, Git et la base de données passent par une passerelle externe. Grâce à leurs environnements isolés et à leurs branches distinctes, les 1 000 agents peuvent modifier du code simultanément sans écraser les fichiers des autres.
PostgreSQL partagé : le centre de coordination des agents IA
Si 1 000 agents collaborent en s’envoyant des messages deux à deux, le volume des communications devient vite incontrôlable. Le Lead Agent a plutôt choisi de créer cinq tables de base de données partagées dans les dix minutes suivant le début de l’expérience, transformant les échanges en une « interface commune » que tout le monde peut consulter et mettre à jour.
| Nom de la table | Fonction | Rôle dans la collaboration |
|---|---|---|
| Announce | Publier les consignes de l’équipe | Diffusion à toute l’équipe, comme un tableau d’annonces de projet |
| Assign | Attribuer les tâches et désigner les responsables | Préciser « qui fait quoi » pour éviter les doublons |
| Notes | Consigner l’avancement, les problèmes et les plans de travail | Partager le contexte et réduire les silos d’information |
| Subtasks | Gérer les tâches détaillées que les agents peuvent prendre en charge | Constituer un pool de tâches et permettre aux agents de les choisir de façon autonome |
| Landed | Répertorier les travaux terminés et validés | Dresser la liste des résultats fiables, après vérification uniquement |
L’intérêt de ce mécanisme, c’est que les agents n’ont pas besoin de contacter un par un les 999 autres agents : une consultation de la base de données leur suffit pour savoir quelles tâches sont disponibles, lesquelles sont terminées et lesquelles ont des dépendances. Les résultats sont ensuite intégrés à la branche principale avec Git. Selon les chiffres communiqués officiellement, l’ensemble du processus a entraîné environ 36 612 écritures et 311 734 lectures dans la base de données. Parmi les écritures, environ 20 600 concernaient Notes et 14 800 Subtasks (la plupart des appels de scripts ne sont pas comptabilisés). Le nombre de lectures, bien supérieur à celui des écritures, montre aussi que les agents passent l’essentiel de leur temps à « consulter l’état général ».
Attribution dynamique des tâches : de l’assignation fixe à la prise d’initiative
Le processus de planification de cette expérience n’est pas resté figé. La chronologie ci-dessous montre comment l’organisation a évolué :
| Moment | Événement clé |
|---|---|
| 10e minute | Lead crée cinq tables dans la base de données partagée |
| Vers la 27e minute | Trois propositions ont été démontrées |
| Ensuite | Lead met temporairement de côté les 47 propositions jugées difficiles à traiter dans le temps imparti et concentre les efforts sur 10 autres propositions |
| Vers la 70e minute | Ces 10 propositions sont toutes résolues ; Lead réattribue alors les agents à des propositions plus difficiles |
| Vers la 3e heure | Lead autorise les agents disponibles à prendre eux-mêmes des tâches, sans attendre qu’on les leur attribue |
| 5,6e heure | Les 73 agents auxiliaires ont créé 756 tâches |
| Vers la 18e heure | L’exécution reprend à partir du dernier état sauvegardé et se poursuit pendant 12 heures |
| 28,4e heure | Les propositions liées à Langlands–Tunnell sont résolues |
| 28,7e heure | Le dernier théorème de Fermat est démontré et passe la vérification officielle du noyau |
Deux détails méritent d’être relevés. D’abord, le passage de l’« attribution des tâches par Lead » à la « prise en charge autonome des tâches par les agents » revient à passer d’une planification centralisée à un système de pool de tâches, ce qui réduit le risque que Lead devienne un goulot d’étranglement. Ensuite, l’expérience a repris à partir d’un état sauvegardé vers la 18e heure : les 28,7 heures ne signifient donc pas que tous les agents ont travaillé sans interruption du début à la fin.
Enfin, les 47 propositions mises temporairement de côté n’ont rien à voir avec les 47 lemmes fournis en entrée. Veillez à ne pas confondre les deux en consultant la documentation officielle.
Langlands–Tunnell : 750 agents réunis pour venir à bout du plus gros obstacle à la formalisation du dernier théorème de Fermat
À l’approche de la ligne d’arrivée, l’équipe a rencontré son obstacle le plus difficile : les propositions liées à Langlands–Tunnell, un résultat mathématique important dans la démarche de démonstration de Wiles. Au début, les agents chargés de cette partie estimaient qu’elle pourrait nécessiter entre 700 000 et 1 million de lignes de code Lean, et que la probabilité de la terminer dans le temps restant était inférieure à 1 %.
Le Lead a alors mobilisé environ 750 agents Helper sur cette tâche. Les agents ont construit eux-mêmes un arbre de tâches à plusieurs niveaux :
- 10 grands domaines ;
- 2 418 sous-tâches au total ;
- jusqu’à 10 niveaux de profondeur ;
- des centaines d’agents travaillant simultanément sur des sous-tâches différentes.
Langlands–Tunnell a finalement été achevé à la 28,4e heure, puis le dernier théorème de Fermat, 0,3 heure plus tard. Cet exemple montre que l’intérêt du parallélisme à grande échelle ne se résume pas à « aller plus vite en étant plus nombreux ». L’essentiel est de décomposer un problème trop vaste pour être abordé directement en une multitude de tâches que l’on peut faire avancer séparément, vérifier individuellement, puis réunir. Si le découpage est mal fait, les 750 agents ne font qu’attendre les uns les autres ou répéter le même travail.
Pourquoi la formalisation du dernier théorème de Fermat a réussi : vérification Lean et mécanismes de sécurité
Du point de vue de la fiabilité technique, l’expérience reposait sur trois niveaux de protection.
Premier niveau : la vérification des résultats. Chaque sous-proposition devait passer les contrôles de Lean avant d’être intégrée à la branche principale. La table Landed ne recensait que les travaux ayant passé ces contrôles. Le vérificateur officiel du noyau a validé le raisonnement final. Le Lead Agent a consigné ces mots : « Le dernier théorème de Fermat est sur main, vérifié par le vérificateur officiel du noyau. »
Deuxième niveau : l’isolation de la collaboration. Des environnements d’exécution isolés et des branches Git distinctes ont fortement réduit les conflits de fichiers et les interférences entre agents.
Troisième niveau : les limites de sécurité. L’expérience utilisait des modèles précoces, qui n’avaient pas encore fait l’objet d’une évaluation d’alignement avant leur sortie officielle. Anthropic a donc mis en place plusieurs niveaux de restrictions :
- aucun accès à Internet ni accès direct aux environnements isolés des autres agents ;
- exécution des commandes avec des comptes sans privilèges ;
- gestion des communications avec l’API, Git et la base de données par une passerelle externe ;
- vérification des commandes Shell et des modifications de fichiers par des classificateurs en temps réel, puis examen des journaux d’opérations par des moniteurs hors ligne.
L’expérience a généré plus d’un million d’appels aux outils, sans qu’aucun ne nécessite d’être bloqué. Anthropic indique également avoir ajouté, après l’expérience, une surveillance parallèle de la chaîne de pensée. La leçon à en tirer est qu’on ne peut pas évaluer la fiabilité d’un système d’agents uniquement à sa capacité à accomplir une tâche : il faut aussi prévoir une vérification indépendante, des limites de permissions et un environnement d’exécution traçable.
De 11 jours à 28,7 heures : comparaison de deux expériences avec Claude Fable 5.2
Les deux expériences de formalisation du dernier théorème de Fermat reposent sur des modalités différentes. Il faut donc les examiner séparément :
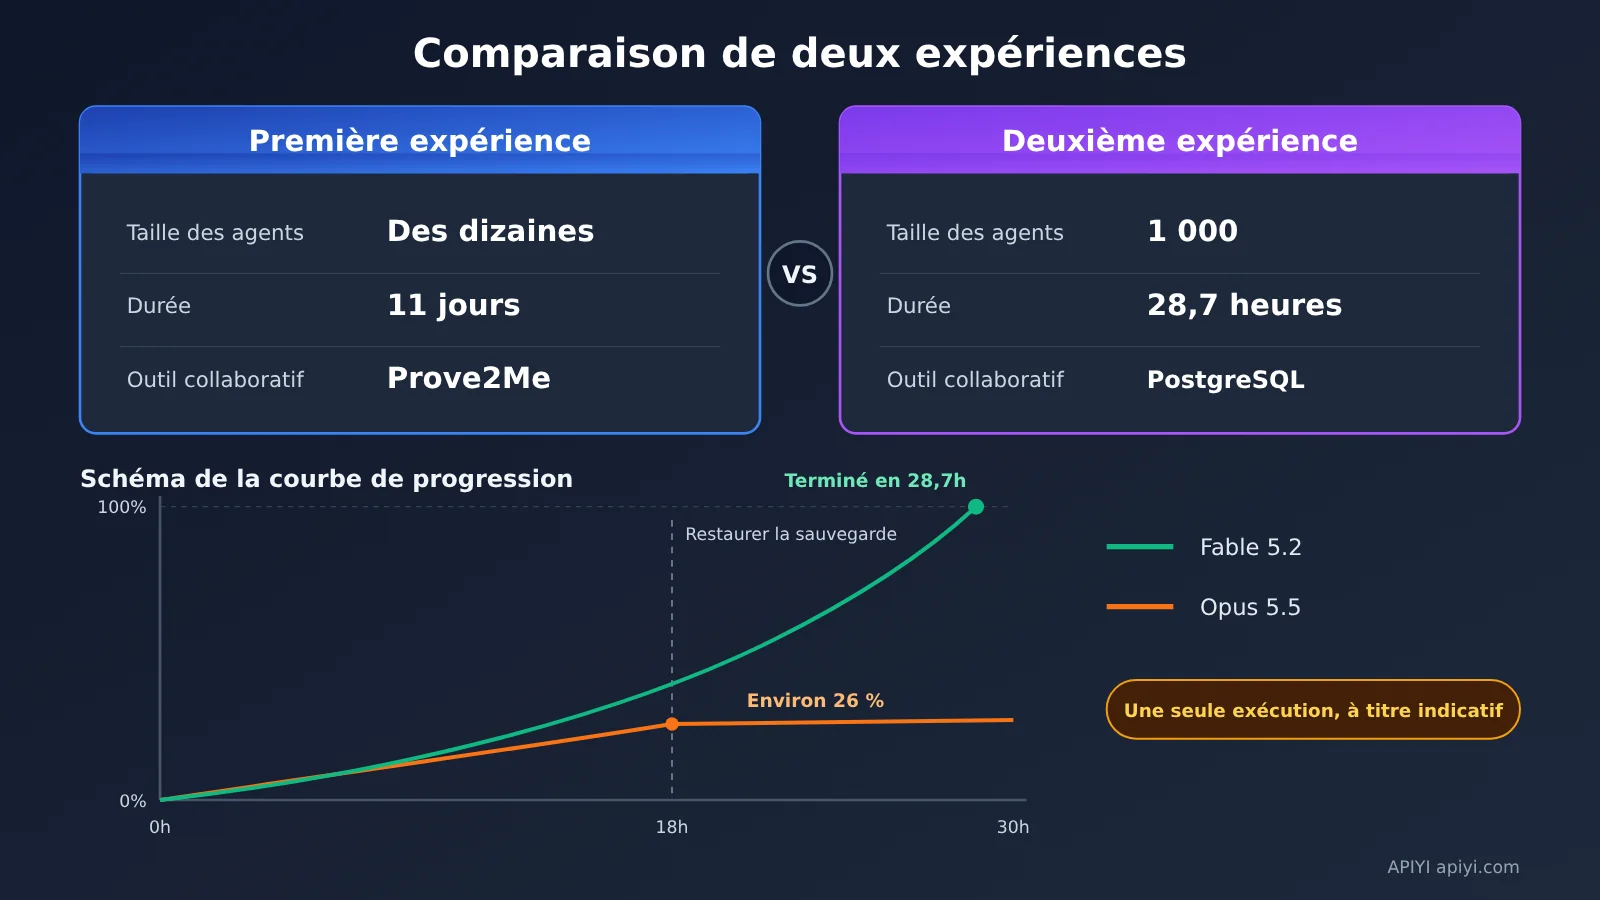
| Indicateur | Première expérience (annoncée en septembre 2026) | Deuxième expérience (annoncée le 9 novembre 2026) |
|---|---|---|
| Modèle | Modèle de recherche interne (à peu près du même niveau que Fable 5.1) | Version préliminaire de Fable 5.2 |
| Nombre d’agents | Plusieurs dizaines | 1 000 |
| Durée d’exécution | 11 jours | 28,7 heures |
| Tokens générés | Environ 6 milliards | Selon l’annonce officielle, environ un tiers du volume de la première expérience |
| Longueur de la preuve | Référence (environ 13 millions de lignes de code Lean) | Environ 1/7 de celle de la première expérience |
| Plateforme de collaboration | Prove2Me + Claude Code Multi-Agent Harness | Outils génériques + PostgreSQL |
| Accompagnement humain | Quelques indications générales fournies par le chercheur Tianyi Peng | Pas d’accompagnement continu sur le raisonnement mathématique |
À noter : les chiffres de 6 milliards de tokens, 13 millions de lignes de code et environ 30 300 théorèmes concernent tous la première expérience. L’annonce officielle ne précise ni le nombre absolu de tokens, ni le coût total, ni le nombre exact de lignes de code de la deuxième expérience.
La première expérience a connu des difficultés au départ : les agents peinaient à suivre l’état d’avancement global, ignoraient le travail déjà effectué par les autres et finissaient par faire des tâches en double. La plateforme Prove2Me, introduite par la suite, gérait les dépendances entre théorèmes sous forme de DAG et fournissait le suivi des tâches, la recherche de théorèmes et l’accélération de la compilation. Dans la deuxième expérience, le changement a consisté à abandonner cette plateforme spécialisée : les agents ont utilisé une base de données et Git, des outils génériques, pour mettre en place leur propre mécanisme de collaboration. Cinq tables en remplissaient des fonctions similaires.
Anthropic a aussi mené un test comparatif avec le même dispositif de 1 000 agents : Opus 5.5 a terminé environ 26 % du travail en 18 heures, puis n’a quasiment plus progressé jusqu’à la trentième heure. Fable 5.2 a terminé la preuve finale en 28,7 heures. Les deux groupes ont repris leur travail à partir d’un état sauvegardé après environ 18 heures. Toutefois, chaque modèle n’a été testé qu’une seule fois. On ne peut donc pas en déduire un écart général entre les deux modèles pour toutes les tâches complexes.
Analyse de l’impact de 1 000 expériences d’IA agentique sur les entreprises
Pour les développeurs : quatre capacités clés des systèmes multi-agents
Une fois le contexte mathématique mis de côté, les capacités mises en évidence par cette expérience correspondent à des cas d’usage courants en entreprise :
| Capacité | Manifestation dans l’expérience | Correspondance avec les cas d’usage en entreprise |
|---|---|---|
| Décomposition de tâches complexes | 2 418 sous-tâches, avec un arbre de tâches pouvant atteindre 10 niveaux de profondeur | Refactorisation de grandes bases de code, rapports de recherche complexes |
| Allocation dynamique des ressources | Mise en attente des problèmes difficiles et mobilisation de 750 Helpers pour les résoudre | Réaffectation des agents et de la puissance de calcul selon les priorités |
| Gestion d’un état partagé | Cinq tables PostgreSQL et fusion avec Git | Tableau de suivi centralisé pour réduire les doublons |
| Vérification indépendante des résultats | Le noyau Lean vérifie chaque contribution | Tests unitaires, validation des données, revue humaine |
Pour les développeurs, la leçon la plus directe est qu’il n’est pas nécessaire de commencer par mettre en place une plateforme spécialisée complexe : une base de données partagée bien conçue, associée à un système de contrôle de version, peut déjà prendre en charge une collaboration d’assez grande ampleur. Voici un exemple minimal d’invocation du modèle :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée d’APIYI
)

response = client.chat.completions.create(
    model="claude-fable-5-2",  # Le nom du modèle dépend de la liste des modèles disponibles sur la plateforme
    messages=[{"role": "user", "content": "把这个任务拆成可独立验证的子任务"}]
)
print(response.choices[0].message.content)
Voir un exemple de code pour la file de tâches Lead / Helper
import sqlite3
import openai

# SQLite est utilisé ici pour simuler localement les tables Subtasks / Landed de l’expérience (celle-ci utilisait en réalité PostgreSQL).
db = sqlite3.connect("board.db")
db.execute("CREATE TABLE IF NOT EXISTS subtasks (id INTEGER PRIMARY KEY, goal TEXT, status TEXT, owner TEXT)")
db.execute("CREATE TABLE IF NOT EXISTS landed (task_id INTEGER, result TEXT)")

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def lead_plan(goal: str):
    """Lead : décompose la tâche et l’ajoute à la file de tâches."""
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": f"将目标拆为3-5个子任务,每行一个:{goal}"}]
    )
    for line in resp.choices[0].message.content.splitlines():
        if line.strip():
            db.execute("INSERT INTO subtasks (goal, status) VALUES (?, 'open')", (line.strip(),))
    db.commit()

def verify(result: str) -> bool:
    """Vérificateur indépendant : dans un cas réel, il faudrait le remplacer par des tests, un script de validation ou une vérification Lean."""
    return len(result) > 0

def helper_claim(name: str):
    """Helper : prend une tâche en charge et ne l’ajoute à Landed qu’après validation."""
    row = db.execute("SELECT id, goal FROM subtasks WHERE status='open' LIMIT 1").fetchone()
    if not row:
        return
    task_id, goal = row
    db.execute("UPDATE subtasks SET status='doing', owner=? WHERE id=?", (name, task_id))
    db.commit()
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": goal}]
    )
    result = resp.choices[0].message.content
    if verify(result):
        db.execute("INSERT INTO landed VALUES (?, ?)", (task_id, result))
        db.execute("UPDATE subtasks SET status='done' WHERE id=?", (task_id,))
    else:
        db.execute("UPDATE subtasks SET status='open', owner=NULL WHERE id=?", (task_id,))
    db.commit()

lead_plan("为一个开源库补全单元测试")
for i in range(3):
    helper_claim(f"helper-{i}")
🚀 Conseil pour démarrer rapidement : pour reproduire un petit prototype « décomposition par un Lead + prise en charge par des Helpers + vérification indépendante », vous pouvez commencer par obtenir un crédit de test gratuit sur APIYI apiyi.com. La plateforme propose des interfaces compatibles avec OpenAI. Une seule clé permet de passer d’un modèle à l’autre — Claude, GPT, Gemini, etc. — pour comparer la qualité de la décomposition selon le modèle qui joue le rôle de Lead.
Pour le secteur : les limites comptent plus que les chiffres
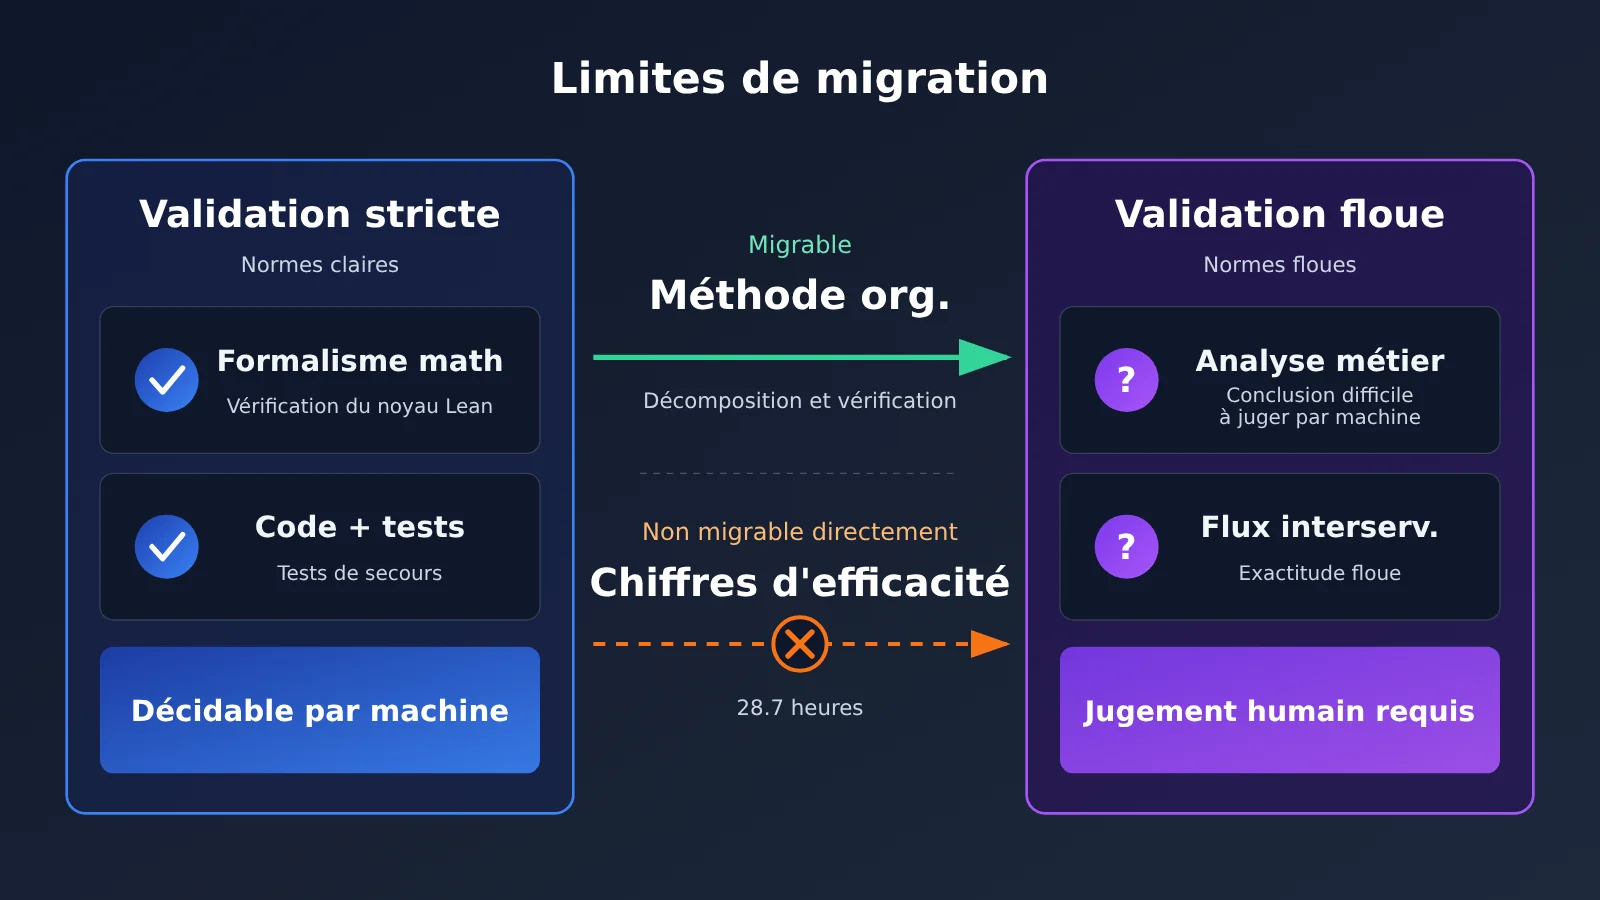
Il faut garder à l’esprit un point important : la formalisation mathématique dispose de vérificateurs stricts et objectifs comme Lean, alors que la plupart des tâches en entreprise ne reposent pas sur des critères de réussite aussi clairs. Les tests peuvent servir de garde-fou pour le code, mais il est souvent difficile de vérifier automatiquement si une analyse de marché ou un processus entre plusieurs services est « correct ». Les 28,7 heures et le taux de réussite de cette expérience ne peuvent donc pas être directement transposés aux systèmes d’agents en entreprise.
Anthropic a également recensé plusieurs limites : les agents peuvent conclure trop tôt qu’une tâche est irréalisable — par exemple, parmi les 47 propositions mises de côté au début, la plupart ont finalement été résolues ; les conseils d’orientation des humains restent utiles dans les moments difficiles ; et des outils spécialisés comme Prove2Me pourraient encore améliorer l’efficacité de la compilation, de la recherche et de la collaboration. L’expérience ne montre ni qu’un plus grand nombre d’agents est toujours préférable, ni que les experts humains et les outils spécialisés ne sont plus nécessaires.
💡 Conseil d’ingénierie : pour tester une approche multi-agents en entreprise, commencez par des tâches dont les critères de vérification sont clairs, comme une modification de code pilotée par des tests, puis élargissez progressivement le périmètre. La facturation à l’usage d’APIYI apiyi.com permet de commencer avec un petit nombre d’agents afin d’évaluer les étapes de décomposition et de vérification, avant de décider d’augmenter l’investissement.
FAQ : questions fréquentes
Q1 : Cette expérience prouve-t-elle que l’IA a démontré le dernier théorème de Fermat ?
Non. Wiles a publié une démonstration du dernier théorème de Fermat en 1995, avec Taylor, qui l’a aidé à corriger un problème crucial. Cette expérience consistait à convertir en une preuve formalisée vérifiable par Lean une démonstration existante, à partir de 60 propositions, d’un aperçu de la stratégie, de définitions et de 47 lemmes déjà démontrés.
Q2 : Pourquoi seulement 54 des 60 propositions sont-elles marquées comme démontrées ?
Dans le bilan établi après 30 heures, 5 propositions de remplacement n’étaient finalement plus nécessaires et 1 autre avait été abandonnée. Le théorème final avait déjà été vérifié au bout de 28,7 heures : il n’était donc pas nécessaire de démontrer les 60 propositions initialement répertoriées.
Q3 : Quel est le tarif de l’API Claude Fable 5.2 ?
Les tarifs officiels sont de 8 $ par million de tokens en entrée et de 40 $ par million de tokens en sortie. En mode Fast, ils passent respectivement à 16 $ et 80 $. La lecture du cache coûte 0,20 $ par million de tokens, l’API Batch bénéficie d’une remise de 50 %, la fenêtre de contexte est de 1 M de tokens et la sortie maximale est de 128 K tokens. Le coût total de la deuxième expérience n’a pas été communiqué officiellement : on ne peut donc pas l’estimer en multipliant les 6 milliards de tokens de la première expérience par le tarif unitaire.
Q4 : Comment tester rapidement Claude Fable 5.2 avec une API ?
Inscrivez-vous sur APIYI, à l’adresse apiyi.com, et récupérez une clé API. Définissez ensuite `base_url` sur `https://api.apiyi.com/v1` pour utiliser directement le code d’exemple de cet article. Les nouveaux utilisateurs disposent d’un crédit de test gratuit, idéal pour commencer avec un petit prototype multi-agent.
Q5 : Un système multi-agent a-t-il forcément besoin de PostgreSQL ?
Pas forcément. Il lui faut surtout une source d’état partagée, accessible en lecture et en écriture à tous les agents, ainsi qu’un contrôle de version et une validation indépendante. Pour un petit prototype, SQLite ou Redis suffit. Lorsque vous appelez un modèle via APIYI, le stockage de l’état reste à la charge de votre propre système : vous pouvez donc combiner les deux comme vous le souhaitez.
Q6 : Quelles sont les limites connues de cette expérience ?
Les responsables la qualifient explicitement d’« expérience jouet ». Fable et Opus n’ont été évalués qu’une seule fois chacun. Les modèles utilisés étaient des versions précoces qui nécessitent plusieurs niveaux de protection. Les agents ont parfois abandonné la tâche trop tôt, et l’accompagnement humain ainsi que les outils spécialisés dans le domaine restent utiles.
Points clés : 1 000 agents IA ont formalisé le dernier théorème de Fermat
- Nature de l’expérience : formaliser une preuve existante sous forme de code vérifiable par Lean, et non prouver le dernier théorème de Fermat pour la première fois.
- Chiffres clés : 1 000 agents Fable 5.2 en phase précoce ont terminé en 28,7 heures, avec une vérification par le noyau officiel de Lean.
- Organisation : 1 agent Lead et 999 agents Helper, coordonnés grâce à cinq tables de base de données partagées et à Git.
- Résolution des difficultés : environ 750 agents ont décomposé la preuve de Langlands–Tunnell en 2 418 sous-tâches, réparties sur 10 niveaux au maximum.
- Fiabilité : vérification indépendante par Lean et isolation en bac à sable ; plus d’un million d’appels aux outils sans intervention nécessaire.
- Limites d’application : les tâches en entreprise ne disposent souvent pas d’un vérificateur comme Lean ; les chiffres d’efficacité ne peuvent donc pas être extrapolés directement.
- Pour se lancer : il est possible de reproduire à petite échelle un prototype de collaboration Lead/Helper avec l’interface unifiée d’APIYI, sur apiyi.com.
En résumé
Voici les principaux enseignements de l’expérience menée avec un millier d’agents Claude Fable 5.2 :
- Le système compte plus que chaque agent pris isolément : les capacités du modèle, la décomposition des tâches, l’état partagé, l’exécution parallèle et la vérification automatisée ont contribué ensemble au résultat obtenu en 28,7 heures.
- La vérification fonde la confiance : le contrôle du noyau Lean distingue rigoureusement une tâche que le modèle prétend avoir terminée d’une tâche réellement achevée.
- Il faut bien préciser les limites : les entrées prédéfinies, le modèle en phase précoce, l’absence de comparaison répétée et le caractère expérimental de l’essai imposent de ne pas surestimer la portée de ce résultat.
Cette expérience soulève une question importante pour le secteur : la compétition entre systèmes d’IA est-elle en train de passer des capacités d’un modèle unique à la capacité d’organiser et de coordonner de nombreux agents pour accomplir des tâches complexes ? Les développeurs peuvent dès maintenant commencer par un petit prototype multi-agent doté d’un vérificateur indépendant. APIYI, sur apiyi.com, permet de tester rapidement cette approche grâce à des crédits d’essai gratuits et à une interface unifiée pour plusieurs modèles.
📚 Références
- Blog d’ingénierie d’Anthropic : Safely scaling multi-agent teams with Claude Fable 5.2
- Lien :
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2 -
À propos : l’organisation des équipes, la collaboration autour des bases de données et les mécanismes de sécurité de la deuxième expérience, avec une comparaison avec Opus
-
Article de recherche d’Anthropic : Formalizing Fermat’s Last Theorem
- Lien :
anthropic.com/research/formalizing-fermats-last-theorem -
À propos : les données de la première expérience de formalisation et la méthode de collaboration avec Prove2Me
-
Dépôt officiel de preuves Lean d’Anthropic : première version de la preuve formalisée
- Lien :
github.com/anthropics/fermats-last-theorem -
À propos : le code de preuve public de la version de septembre. Les données du README ne correspondent pas aux statistiques de l’expérience de novembre.
-
Exemple officiel de Lean : Formalizing Fermat’s Last Theorem
- Lien :
lean-lang.org/use-cases/flt -
À propos : pour en savoir plus sur Lean et le contexte des mathématiques formalisées
-
Documentation du modèle Fable 5.2 : spécifications du modèle et migration de l’API
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview - À propos : fenêtre de contexte, limite de sortie et tarifs
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Vous trouverez d’autres ressources dans le centre de documentation, à l’adresse docs.apiyi.com.