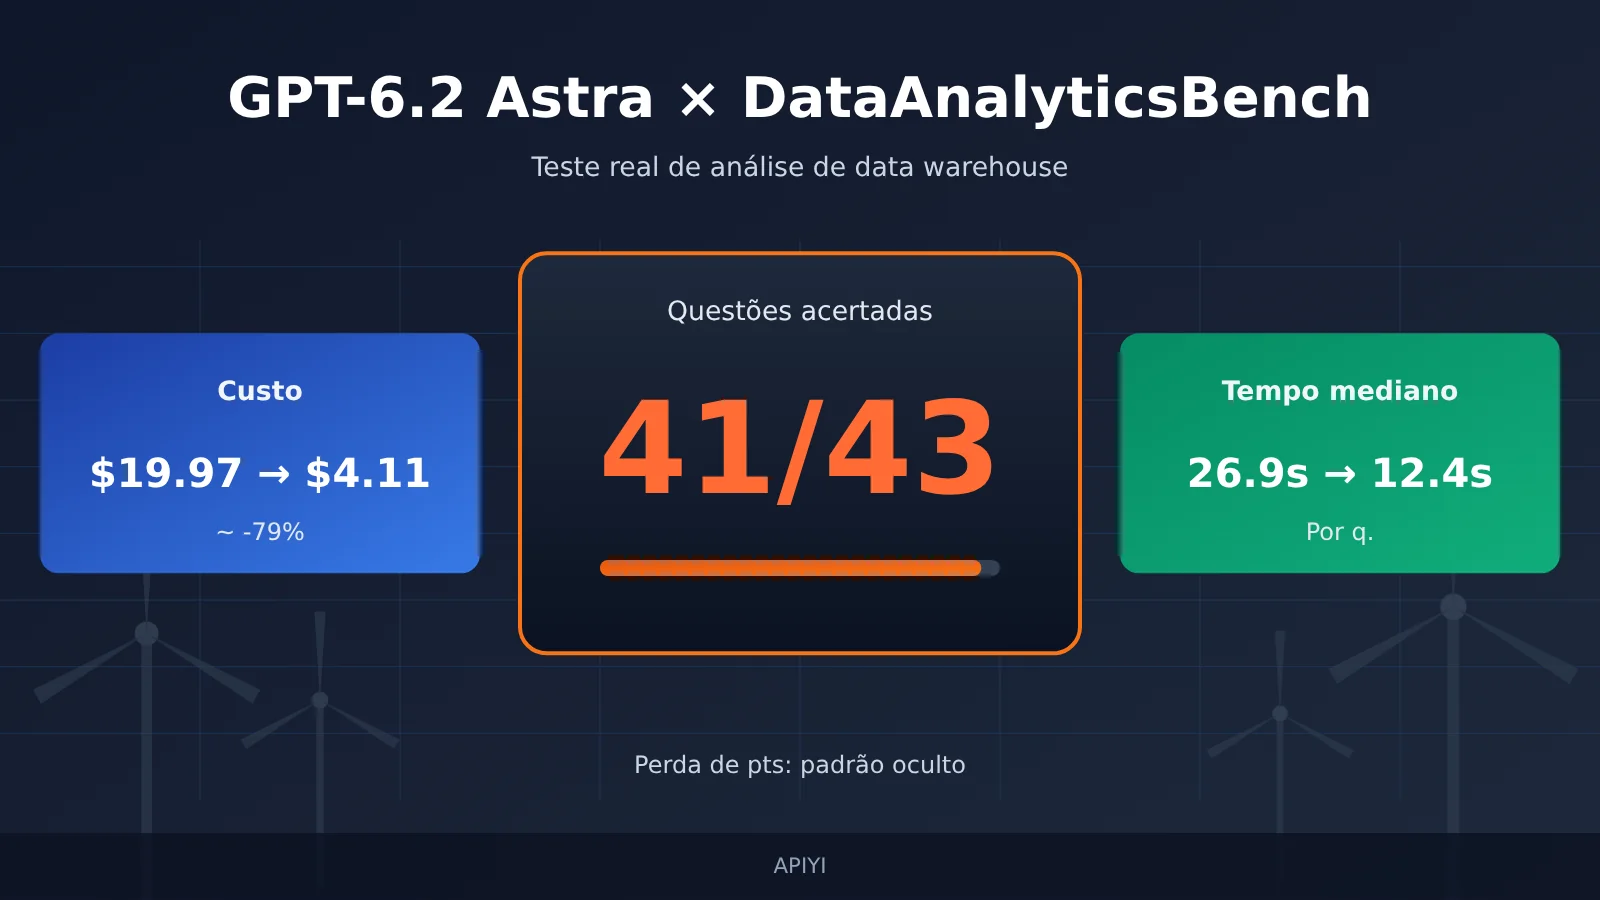
Conclusão principal: no teste real do DataAnalyticsBench da Plotly, o GPT-6.2 Astra acertou 41 de 43 questões de análise de dados. O modelo anterior, GPT-6 Astra, havia acertado 43/43. As duas perdas de pontos aconteceram justamente na categoria “padrões ocultos”; todas as outras cinco categorias foram aprovadas integralmente. Ao mesmo tempo, o custo da rodada completa caiu de $19.97 para $4.11, e a mediana de tempo por questão foi reduzida de 26.9 segundos para 12.4 segundos. A nova geração Astra trocou duas questões por um custo menor que um quarto do anterior e por menos da metade do tempo de espera — mas será que ela realmente regrediu na capacidade de investigar anomalias por conta própria? Por enquanto só temos uma rodada de dados, então ainda é preciso refazer o teste com seus próprios dados.
O que você vai encontrar neste artigo?
- O que o DataAnalyticsBench mede, como pontua, e onde ficam as fronteiras dessa nota 41/43.
- A pontuação item por item das seis categorias de questões, e como as duas questões perdidas falharam.
- As duas origens da queda de custo de cerca de 79% — redução de tarifa e redução de volume de trabalho — e quanto cada uma contribuiu.
- Os trade-offs entre GPT-6.2 Astra, GPT-6 Astra, GPT-6.1 Sol e GPT-6.2 Sol em pontuação, custo e latência.
- Um método de reteste pronto para adaptar, com código Python, para validar as conclusões no seu próprio data warehouse.
Índice: a tabela To Know explica os conceitos específicos da avaliação, e o resumo de impactos sintetiza o significado desta notícia por perfil de público. A seção “Fatos objetivos” apresenta, em ordem, o ambiente de teste e as regras de pontuação, a pontuação das seis categorias, os dados de custo e tempo, e a identidade oficial do modelo e os critérios de preço da OpenAI. A seção “Análise e julgamento” interpreta o significado de 41/43, propõe hipóteses para explicar as perdas nas questões de padrões ocultos, decompõe as origens da queda de custo, e oferece recomendações de escolha e o código de reteste.
GPT-6.2 Astra DataAnalyticsBench: conceitos que você precisa conhecer antes
| Conceito | Explicação breve |
|---|---|
| DataAnalyticsBench | Conjunto de 43 questões de análise de data warehouse criado por pesquisadores da Plotly e da Mila, que avalia a capacidade analítica do modelo sobre dados simulados de operação de energia eólica |
| Ambiente de execução do teste | Sistema de avaliação que fornece a cada modelo o mesmo data warehouse e ferramentas somente leitura, como consulta, criação de gráficos e exibição de tabelas |
| Regras de pontuação | Definem, para cada questão, que tipo de resposta conta como suficiente para atender ao enunciado; o resultado é apenas aprovado ou reprovado, sem pontuação parcial |
| Problemas de qualidade dos dados | Problemas na entrada, como registros ausentes, duplicados e anômalos, que podem afetar as conclusões da análise; são inseridos de propósito nas questões |
| Armadilhas estatísticas | Questões em que algoritmos intuitivos ou formas de agregação podem levar a conclusões erradas |
| Padrões ocultos | Padrões ou causas anômalas que não são explicitados no enunciado e que o modelo precisa investigar por conta própria |
| Mediana do tempo por questão | Valor central obtido após ordenar os tempos reais gastos nas 43 questões; este ranking inclui o tempo gasto nas consultas às ferramentas |
| Custo da rodada completa | Custo acumulado das invocações do mesmo modelo para concluir todas as 43 questões |
| Acertos de cache | Parte dos tokens de entrada de prefixos repetidos que, após serem armazenados em cache pelo servidor, é cobrada a um preço unitário menor |
Visão rápida do impacto das pontuações do DataAnalyticsBench do GPT-6.2 Astra em diferentes públicos
- Quem escolhe APIs: o custo unitário e a velocidade de resposta do GPT-6.2 Astra melhoraram bastante, então tarefas como relatórios de rotina e esclarecimento de critérios já podem ser priorizadas com ele. Para tarefas de investigação de anomalias, ainda não vale a pena aplicar diretamente as conclusões do ranking.
- Desenvolvedores de produtos de dados: ao criar produtos como “consulta de dados em linguagem natural” e assistentes de BI, cortar pela metade a mediana de latência faz uma diferença enorme na experiência de interação. Vale avaliar separadamente a “paciência” do modelo em exploração de múltiplas rodadas e, se necessário, forçar etapas extras de verificação no comando ou no fluxo de trabalho.
- Equipes de análise: dá para usar o modelo como um analista de primeiro rascunho mais rápido, mas conclusões de investigação de causa raiz ainda exigem revisão humana. Usando um serviço proxy de API agregador compatível com OpenAI como o APIYI apiyi.com, é possível alternar entre os quatro modelos no mesmo código para testes comparativos.
Fatos objetivos do DataAnalyticsBench do GPT-6.2 Astra
Cenários de teste e regras de pontuação do GPT-6.2 Astra
O DataAnalyticsBench foi projetado por pesquisadores da Plotly e da Mila e usa um data warehouse simulado de operações de energia eólica. O data warehouse contém 44 tabelas, cerca de 19,9 milhões de linhas e 554 colunas, abrangendo dados como telemetria de equipamentos, alarmes, ordens de serviço, inspeções e clima. Cada pergunta é executada no Plotly Studio Embedded, com o modelo sendo invocado via OpenRouter. As únicas ferramentas disponíveis para o modelo são quatro ferramentas somente leitura: listar conjuntos de dados, executar SQL, gerar gráficos e exibir tabelas.
O modelo decide por conta própria o caminho de consulta e quando responder; o avaliador não planeja as etapas por ele. Isso significa que a avaliação não testa apenas a escrita de SQL, mas também o julgamento de “até que ponto consultar já é suficiente”.
Em termos de pontuação, cada pergunta é julgada como aprovada ou não com base no gabarito e nas regras de pontuação, sem pontuação parcial. O modelo juiz é o Claude Sonnet 5, com temperatura definida como 0. Os organizadores geram as respostas de forma independente e as validam cruzadamente usando SQL, pandas e Polars; também revisam manualmente as trajetórias de falha e auditam os resultados com pontuação máxima. Dois tipos especiais de pergunta têm condições de aprovação bem definidas:
- Perguntas ambíguas: o modelo é aprovado se pedir esclarecimento, ou se declarar as premissas e oferecer uma solução alternativa.
- Perguntas não respondíveis com os dados disponíveis: o modelo é aprovado se apontar com precisão as limitações dos dados existentes.
O banco de perguntas também tem limites claros: domínio de negócio único (operações de energia eólica), inglês, mesmo ambiente de teste e uma única rodada por modelo. As perguntas, os dados e o gabarito são mantidos pelos organizadores e não são divulgados publicamente.
Fonte: Plotly, Introducing DataAnalyticsBench, publicado em 2026-10-14, atualizado em 2026-11-19, plotly.com/blog/introducing-dataanalyticsbench/
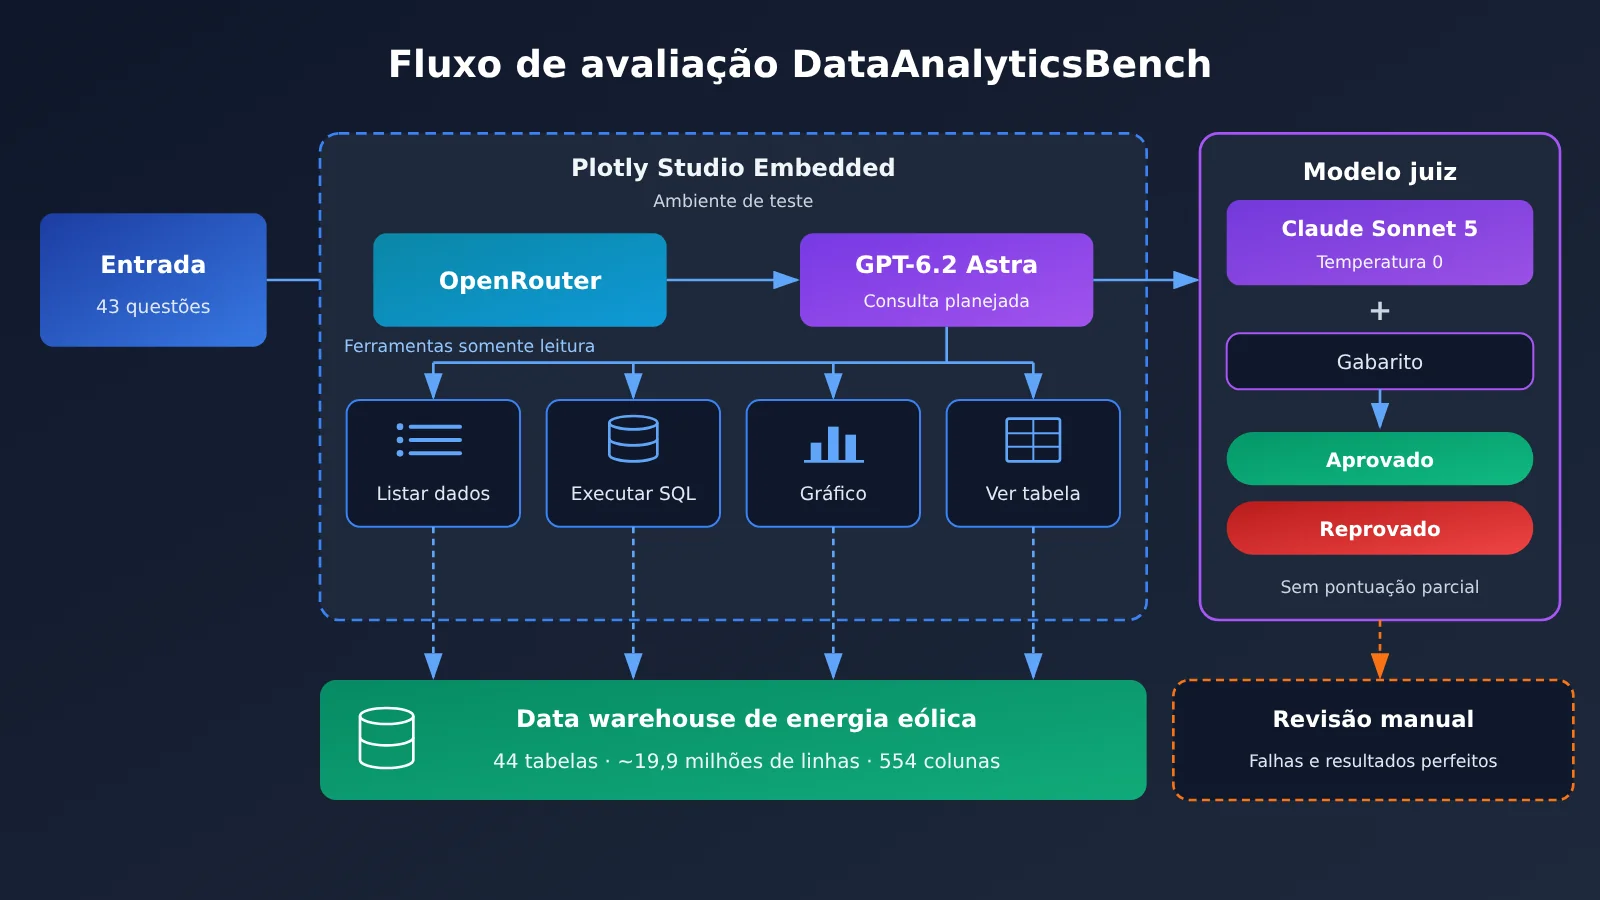
Nota de ilustração: esta estrutura de “modelo planeja consultas de forma autônoma + ferramentas somente leitura + aprovação por pergunta” pode ser aproximadamente reproduzida no seu próprio ambiente usando a interface compatível com OpenAI da APIYI apiyi.com, para testes comparativos internos.
Pontuações do GPT-6.2 Astra nas seis categorias de tarefas: as perdas se concentram nos padrões ocultos
O relatório dedicado ao Astra, publicado pela Plotly em 17 de novembro de 2026, traz as pontuações por categoria:
| Categoria de tarefa | GPT-6.2 Astra | GPT-6 Astra | Aspecto avaliado |
|---|---|---|---|
| Análise convencional | 20/20 | 20/20 | SQL com várias etapas, junções entre tabelas e intervalos de tempo |
| Julgamento de ambiguidade | 5/5 | 5/5 | Esclarecer o critério ou explicar premissas razoáveis |
| Perguntas não respondíveis | 5/5 | 5/5 | Identificar, com base nos dados disponíveis, perguntas que não podem ser respondidas |
| Qualidade dos dados | 3/3 | 3/3 | Identificar problemas de qualidade inseridos |
| Armadilhas estatísticas | 5/5 | 5/5 | Identificar possíveis induções a erro causadas por algoritmos intuitivos |
| Padrões ocultos | 3/5 | 5/5 | Investigar ativamente padrões anômalos não explicitados |
| Total | 41/43 | 43/43 | Todas as tarefas têm o mesmo peso; cada uma é julgada individualmente como aprovada ou reprovada |
Nas cinco primeiras categorias, o total foi 38/38, e as duas gerações tiveram desempenho idêntico. A diferença vem inteiramente das tarefas de padrões ocultos: a nova geração fez 3/5, e a anterior, 5/5.
As duas tarefas em que houve perda de pontos passaram por revisão manual da Plotly, e as falhas ocorreram de maneiras diferentes:
- Em uma tarefa, o modelo nunca localizou o padrão inserido.
- Na outra, o modelo encontrou o local que deveria investigar, mas descartou a causa real.
O relatório também apresenta um dado de processo: nas tarefas de padrões ocultos, o GPT-6.2 Astra executou, em média, cerca de 9 consultas ao banco de dados por tarefa, enquanto o GPT-6 Astra executou cerca de 15 consultas.
Fonte: Plotly, GPT-6.2 Astra Benchmark Results for Data Analysis, 2026-11-17, plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/
GPT-6.2 Astra: custo e tempo — comparação entre duas gerações e variantes do mesmo fabricante
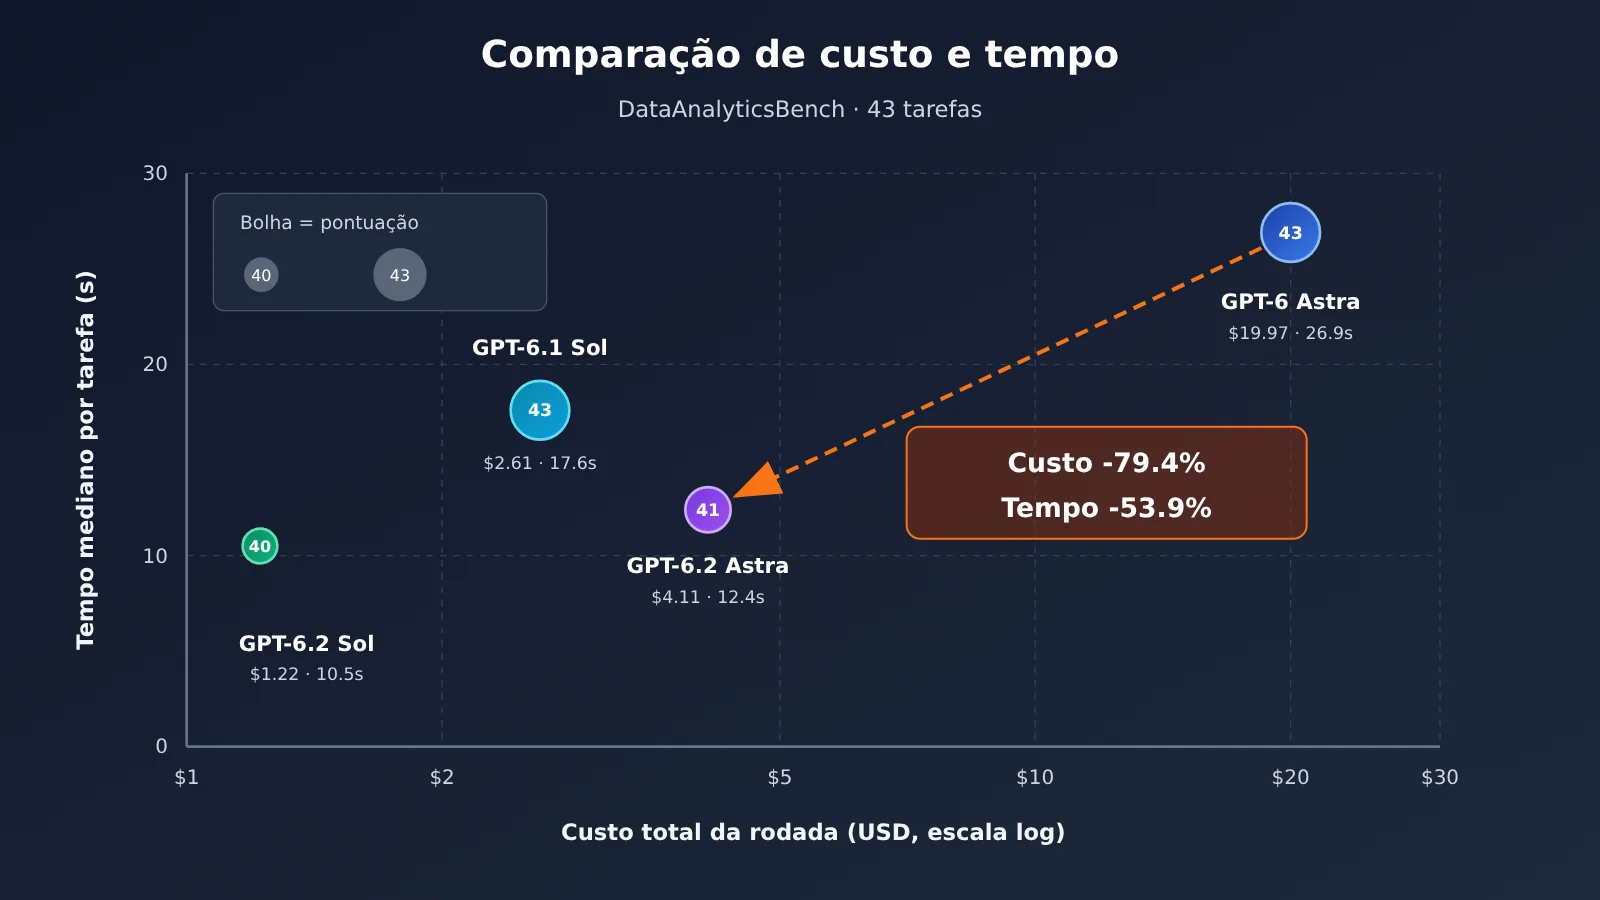
| Modelo | Pontuação | Custo por rodada completa | Tempo mediano por questão |
|---|---|---|---|
| GPT-6.2 Astra | 41/43 | $4.11 | 12.4 segundos |
| GPT-6 Astra | 43/43 | $19.97 | 26.9 segundos |
| GPT-6.1 Sol | 43/43 | $2.61 | 17.6 segundos |
| GPT-6.2 Sol | 40/43 | $1.22 | 10.5 segundos |
Conforme calculado a partir da tabela original, o GPT-6.2 Astra apresenta uma redução de cerca de 79.4% no custo por rodada completa em relação à geração anterior, e o tempo mediano por questão diminui cerca de 53.9%. Nos testes do autor, o 6.2 Astra levou cerca de 13 minutos por rodada completa, enquanto a geração anterior levou cerca de 32 minutos. O tempo aqui se refere ao tempo real decorrido, incluindo consultas a ferramentas, e não ao tempo puro de inferência do modelo.
Há duas formas de medir o custo por questão, e é preciso analisá-las separadamente: $4.11 ÷ 43 resulta em aproximadamente $0.096 de custo médio por questão; já o ranking geral atualizado marca $0.066 como a mediana do custo por questão nesta rodada. O valor médio é maior que a mediana, o que indica que algumas poucas questões custaram bem mais, puxando a média para cima.
O Plotly também disponibilizou o detalhamento da carga de trabalho das rodadas originais das duas gerações:
| Métrica de carga de trabalho | GPT-6 Astra (geração anterior) | GPT-6.2 Astra |
|---|---|---|
| Número de chamadas de ferramentas | 266 | 148 |
| Número de chamadas ao modelo | 249 | 171 |
| Tokens de entrada | cerca de 9.1 milhões | cerca de 4.4 milhões |
| Tokens de saída | cerca de 78 mil | cerca de 34 mil |
| Proporção de acertos de cache de entrada | 93% | 98% |
O Plotly recalculou o uso idêntico da geração anterior com as novas tarifas, estimando cerca de $11. Vale notar que esses custos vêm dos preços do OpenRouter vigentes na época dos testes do Plotly, e não de uma conversão direta da tabela de preços oficial da OpenAI.
Fonte: relatório especial do Plotly sobre o Astra plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/; ranking geral do Plotly plotly.com/blog/introducing-dataanalyticsbench/#full-results
Identidade do modelo GPT-6.2 Astra e política oficial de preços
A OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol em 17 de novembro de 2026. O Astra é voltado para raciocínio complexo, programação e trabalho profissional, e o ID do modelo na API é gpt-6.2-astra. As avaliações presentes no anúncio de lançamento da OpenAI seguem a metodologia do fornecedor; já o DataAnalyticsBench, da Plotly, é outro conjunto de avaliações de terceiros, e os dois não devem ser comparados entre si.
De acordo com a ficha do modelo, o Astra aceita entrada de texto e imagem e produz texto, com janela de contexto de 1,050,000 tokens, entrada máxima de 922,000 tokens e saída máxima de 128,000 tokens. Ele oferece suporte tanto à Responses API quanto à Chat Completions API; recursos como ferramentas integradas, Multi-agent e janela de conclusão em segundo plano seguem o que a Responses API define. A ficha do modelo também informa que solicitações com reasoning.effort definido como none serão rejeitadas.
Os preços padrão da OpenAI para texto puro em contexto curto (por milhão de tokens) são: entrada normal US$ 8, entrada com cache hit US$ 0.40 e saída US$ 40. Segundo a OpenAI, em comparação com a geração anterior, os preços unitários de entrada normal e saída caíram 20%, enquanto o de entrada com cache hit caiu 60%.
Fontes: anúncio de lançamento da OpenAI openai.com/index/introducing-gpt-6-2-astra-sol/; ficha do modelo developers.openai.com/api/docs/models/gpt-6.2-astra; changelog da API developers.openai.com/api/docs/changelog; tabela de preços developers.openai.com/api/docs/pricing
Análise dos resultados do GPT-6.2 Astra no DataAnalyticsBench
Como interpretar 41/43: não é um “declínio geral”
Olhando 41/43 em detalhe, o GPT-6.2 Astra não perdeu pontos nas cinco categorias de tarefas: análise convencional, ambiguidade, perguntas sem resposta, qualidade de dados e armadilhas estatísticas. Essas cinco categorias cobrem a maior parte dos cenários de relatórios do dia a dia e de verificação de critérios. Se o negócio envolve principalmente esse tipo de problema, pelos dados desta rodada, a qualidade da nova geração do Astra é equivalente à da geração anterior, enquanto custo e velocidade são claramente melhores.
A diferença de duas questões ainda precisa ser vista dentro da faixa de variação. O relatório da Plotly afirma que, ao repetir testes com outros modelos, houve variações de até três questões. Portanto, 41 contra 43 é mais adequado encarar como “o valor observado nesta rodada”, e não como uma diferença estável de capacidade. Uma formulação mais precisa seria: na categoria de padrões ocultos, surgiu um sinal que vale a pena acompanhar, mas os dados de uma única rodada ainda não bastam para confirmar uma regressão.
Por que vale repetir testes em perguntas de padrão oculto: hipótese explicativa sobre profundidade de exploração
A seguir está uma hipótese explicativa baseada nos dados do relatório, e não uma conclusão da Plotly. Nas perguntas de padrão oculto, a nova geração faz em média cerca de 9 consultas por pergunta, contra cerca de 15 da geração anterior; o desempenho nas duas questões em que houve perda de pontos mostra um caso de “não encontrou” e outro de “encontrou a posição, mas descartou a causa real”. Os dois parecem o mesmo comportamento de “parar antes de investigar o suficiente”: no primeiro, o escopo de exploração foi insuficiente; no segundo, uma conclusão negativa foi tirada cedo demais durante a fase de validação.
Isso pode vir da mesma mudança de comportamento por trás da queda de custo e latência: o modelo tende a responder depois de menos consultas. Em perguntas de rotina, essa tendência se traduz diretamente em eficiência; em perguntas de causa raiz que exigem hipóteses e validações repetidas, pode se tornar um risco. Para testar essa hipótese, é preciso comparar a relação entre número de consultas e taxa de aprovação nos seus próprios dados, em vez de olhar apenas a pontuação total.
Por que custo e velocidade do GPT-6.2 Astra caíram ao mesmo tempo
A queda de $19.97 para $4.11 pode ser dividida em duas partes, com base nos dados recalculados pela Plotly:
- Fator de preço: o uso da geração anterior, sem alterações, recalculado com o novo preço dá cerca de $11; ou seja, só com a redução de preço, o custo cairia de aproximadamente $19.97 para $11, uma queda de cerca de 45%. O preço oficial do token de entrada em cache caiu 60%, e esse efeito é especialmente relevante em cenários com taxa de acerto de cache entre 93% e 98%.
- Fator de volume de trabalho: a passagem de cerca de $11 para $4.11 se deve à redução do trabalho. As chamadas de ferramentas caíram de 266 para 148, os tokens de entrada diminuíram de cerca de 9,1 milhões para cerca de 4,4 milhões, os tokens de saída caíram mais da metade e a proporção de acertos no cache subiu de 93% para 98%.
Usando os preços oficiais para fazer uma estimativa aproximada do uso da nova geração, o resultado também fica na mesma ordem de grandeza de $4.11: cerca de 4,4 milhões de tokens de entrada, dos quais 98% pelo preço de cache e o restante pelo preço normal de entrada, mais cerca de 34 mil tokens de saída. Isso mostra que, em cenários como análise de dados, com contexto longo e várias rodadas de chamadas de ferramentas, a taxa de acerto do cache e o número de rodadas de chamada podem ter impacto maior no custo do que o preço unitário em si. O ganho de velocidade segue a mesma lógica: menos consultas, menos invocações do modelo e, naturalmente, menos tempo decorrido.
💰 Recomendação de custo: ao avaliar o custo de tarefas do tipo Agent, registre os tokens com acerto de cache e o número de rodadas de chamadas de ferramentas; não olhe apenas a tabela de preços unitários. Ao usar o serviço sob demanda via APIYI apiyi.com, compare a fatura com o campo
usagenos logs para verificar se o cache está funcionando.
A escolha entre GPT-6.2 Astra, GPT-6.1 Sol e GPT-6.2 Sol
Cada um dos quatro modelos ocupa uma posição diferente:
- GPT-6.1 Sol: nesta configuração, alcança 43/43 por $2.61 e é a opção “mais barata entre as notas máximas” desta rodada — o preço a pagar é um tempo mediano de 17.6 segundos, mais lento que o 6.2 Astra.
- GPT-6.2 Astra: 41/43, $4.11, 12.4 segundos — a vantagem aparece quando se comparam pontuação e velocidade em conjunto. Se olharmos só para custo e pontuação, ele não leva vantagem.
- GPT-6.2 Sol: $1.22, 10.5 segundos, o mais barato e o mais rápido, mas com a pontuação mais baixa: 40/43.
- GPT-6 Astra: nota máxima, mas custo e latência claramente mais altos; neste conjunto de comparações, já é difícil achar um motivo para colocá-lo em primeiro lugar.
A diferença entre eles fica dentro da margem de flutuação de no máximo três questões mencionada pela Plotly. Isso significa que olhar apenas para a pontuação total torna difícil estabelecer uma ordem confiável — as dimensões que realmente distinguem os modelos são custo e latência. Na hora de escolher, produtos interativos de consulta a dados são sensíveis à latência, então vale comparar primeiro o 6.2 Astra e o 6.2 Sol; já análises em lote offline não ligam para latência, e o custo-benefício do 6.1 Sol merece mais atenção.
Como retestar o GPT-6.2 Astra com seus próprios dados
O método de reteste a seguir é uma sugestão da equipe editorial. O DataAnalyticsBench cobre apenas operações de energia eólica, em inglês e em um único ambiente, o que está bem longe do data warehouse real da maioria dos times. A abordagem mais segura é montar um pequeno conjunto de questões com seus próprios dados, fixando dados, ferramentas e comandos, rodar várias vezes e estatificar o desempenho por tipo de tarefa.
| Subconjunto | Quantidade sugerida de questões | O que registrar | Para que serve a avaliação |
|---|---|---|---|
| Relatórios de rotina | 15-20 questões | Taxa de aprovação, latência mediana | Se dá para confiar ao modelo as perguntas do dia a dia |
| Definições ambíguas de métricas | cerca de 5 questões | Se ele esclarece ativamente ou explicita premissas | Evitar que ele “escolha uma definição em silêncio” |
| Viés estatístico | cerca de 5 questões | Se identifica armadilhas como o paradoxo de Simpson | Confiabilidade das conclusões |
| Causa raiz de anomalias | 5-8 questões | Taxa de aprovação, número de consultas, latência P90 | Verificar o sinal de perda de pontos nas questões com padrões ocultos |
| Todas as questões | — | Custo total por rodada, taxa de acerto de cache | Orçamento de custo |
Recomenda-se rodar cada modelo pelo menos 3 vezes, registrando média e variação. A latência de cauda (P90) precisa ser registrada separadamente: um valor mediano bonito não significa que as questões mais lentas sejam aceitáveis.
Abaixo está o exemplo mais simples de invocação. O ID do modelo segue o gpt-6.2-astra publicado pela OpenAI; os modelos disponíveis devem ser conferidos na lista da plataforma:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.2-astra",
    reasoning_effort="medium",  # O model card indica que requisições com effort "none" serão rejeitadas
    messages=[{"role": "user", "content": "上月各风场故障工单数环比变化最大的是哪个?请说明计算口径。"}],
)
print(resp.choices[0].message.content)
Ver o script completo de reteste: taxa de aprovação, custo e latência P50/P90 por subconjunto
import time
import statistics
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODELS = ["gpt-6.2-astra", "gpt-6-astra", "gpt-6.1-sol", "gpt-6.2-sol"]

# Conjunto de tarefas próprio: category corresponde ao subconjunto da tabela de reteste;
# o checker você implementa conforme a chave de respostas
TASKS = [
    {"id": "r01", "category": "常规报表", "prompt": "...", "checker": lambda a: "..." in a},
    {"id": "h01", "category": "异常根因", "prompt": "...", "checker": lambda a: "..." in a},
]

# Preço unitário da conexão oficial direta (USD por milhão de tokens), só para estimativa grosseira;
# o valor real prevalece conforme a cobrança da plataforma
PRICE = {"input": 8.0, "cached": 0.40, "output": 40.0}

def estimate_cost(usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * PRICE["input"] + cached * PRICE["cached"]
            + usage.completion_tokens * PRICE["output"]) / 1_000_000

def p90(values):
    values = sorted(values)
    return values[max(0, int(len(values) * 0.9) - 1)]

def run(model, rounds=3):
    stats = {}
    for _ in range(rounds):
        for t in TASKS:
            start = time.perf_counter()
            resp = client.chat.completions.create(
                model=model,
                reasoning_effort="medium",
                messages=[{"role": "user", "content": t["prompt"]}],
            )
            elapsed = time.perf_counter() - start
            answer = resp.choices[0].message.content or ""
            s = stats.setdefault(t["category"], {"pass": 0, "n": 0, "lat": [], "cost": 0.0})
            s["n"] += 1
            s["pass"] += int(t["checker"](answer))
            s["lat"].append(elapsed)
            s["cost"] += estimate_cost(resp.usage)
    for cat, s in stats.items():
        print(f"{model} | {cat} | 通过率 {s['pass']}/{s['n']} | "
              f"P50 {statistics.median(s['lat']):.1f}s | P90 {p90(s['lat']):.1f}s | "
              f"估算费用 ${s['cost']:.3f}")

for m in MODELS:
    run(m)
Este script faz apenas perguntas e respostas de turno único. Se você quiser se aproximar da configuração do DataAnalyticsBench, ainda precisa integrar uma ferramenta SQL somente leitura, deixar o modelo consultar de forma autônoma em vários turnos e registrar à parte o número de chamadas de ferramenta por questão — assim dá para testar a hipótese discutida anteriormente sobre “número de consultas e perda de pontos”.
🎯 Sugestão de reteste: os quatro modelos seguem o protocolo compatível com OpenAI; dá para alternar entre eles usando a mesma chave API via APIYI apiyi.com. A cota gratuita de testes para novos usuários já é suficiente para rodar primeiro uma rodada com um conjunto pequeno de tarefas e só depois decidir se vale ampliar a escala.
O ranking mostra a direção. Mas, quando o assunto é o seu próprio data warehouse e os seus próprios tipos de anomalia, a resposta só sai rodando você mesmo. Lu You escreveu em “Lendo livros em uma noite de inverno para mostrar a Ziyu”: “O que se aprende no papel é sempre superficial; para saber de verdade, é preciso praticar.”
Autor: Equipe técnica da APIYI
Contato técnico: Fale conosco pela página inicial do APIYI apiyi.com; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com