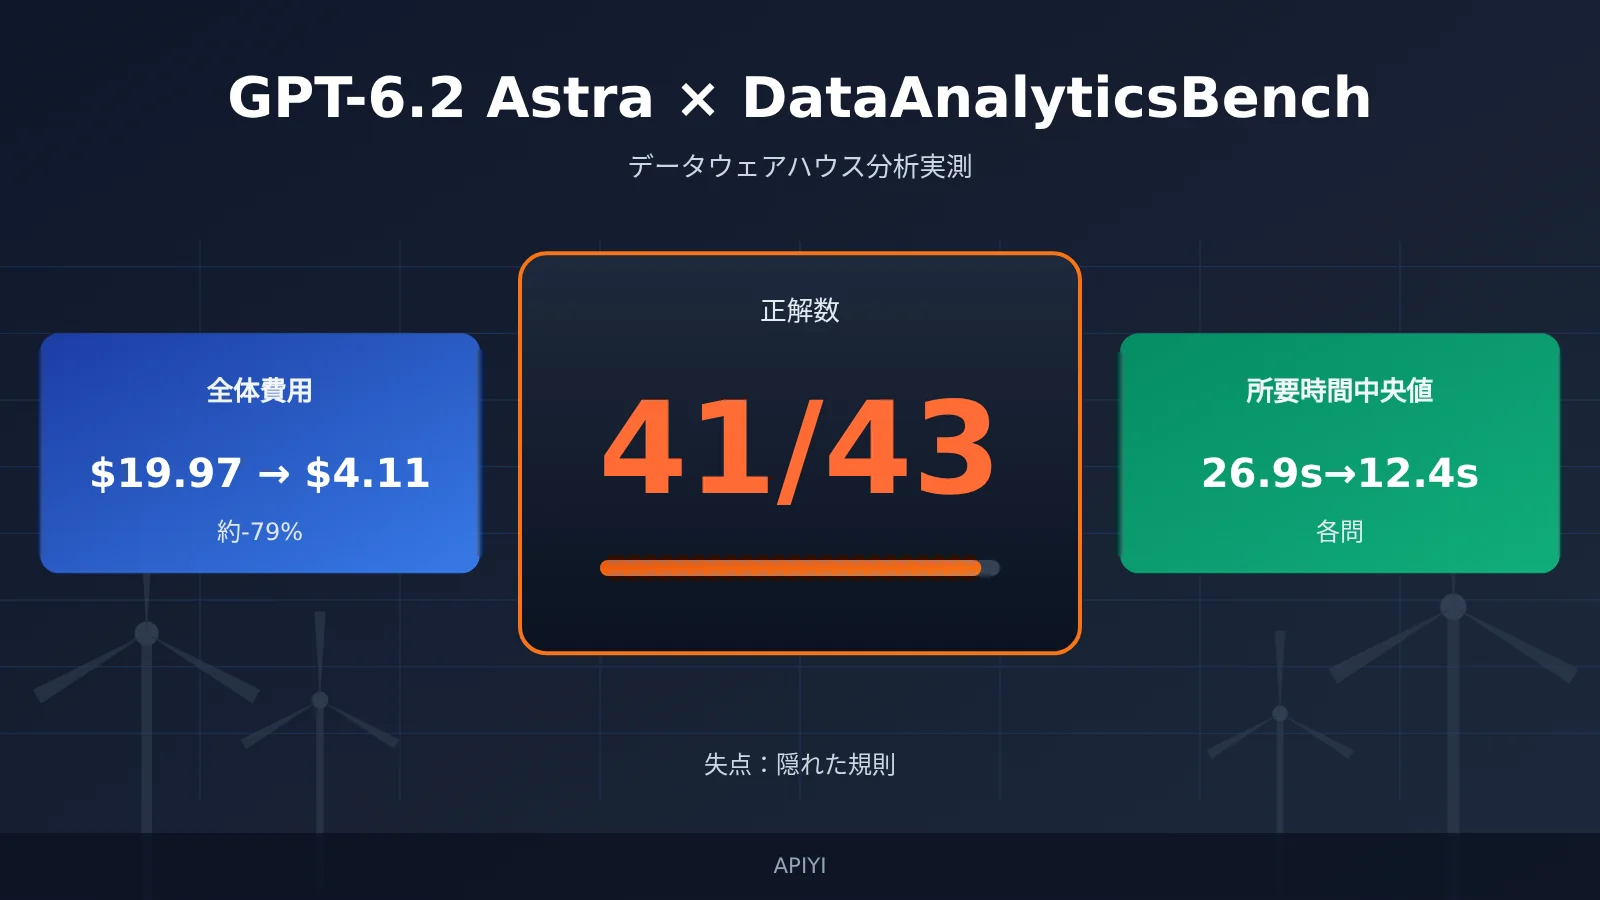
核心となる結論:Plotly の DataAnalyticsBench 実測では、GPT-6.2 Astra は 43 問のデータ分析問題のうち 41 問 を通過しました。前世代の GPT-6 Astra は 43/43 でした。失点した2問はいずれも「隠れた規則」カテゴリで、残り5カテゴリはすべて通過しています。一方、全ラウンド費用は $19.97 から $4.11 に下がり、1問あたりの所要時間中央値は 26.9 秒から 12.4 秒に短縮されました。新しい Astra は2問分の代償と引き換えに、前世代の4分の1未満の費用と半分未満の待ち時間を手に入れました。ただし、異常を自ら追跡する能力が本当に後退したのかは、現時点では1回分のデータしかなく、自分のデータで再検証する必要があります。
この記事を読むと何が分かる?
- DataAnalyticsBench が何を測り、どう採点するのか、41/43 というスコアの境界はどこにあるのか。
- 6カテゴリの項目別スコアと、失点した2問がそれぞれどのように失敗したのか。
- 費用が約79%下がった2つの要因、すなわち料率の引き下げと作業量の減少が、それぞれどれだけ寄与したのか。
- GPT-6.2 Astra と GPT-6 Astra、GPT-6.1 Sol、GPT-6.2 Sol の間で、スコア・費用・レイテンシをどうトレードオフするのか。
- そのまま改造して使える再検証方法と Python コードで、自分のデータウェアハウス上で結論を確かめる方法。
索引:To Know の表では評価で使われる固有の概念を説明し、影響の早見では読者層別にこのニュースの意味を要約します。「客観的事実」パートでは、テスト環境と採点ルール、6カテゴリのスコア、費用と所要時間のデータ、そして OpenAI 公式のモデル識別情報と価格の基準を順に説明します。「分析と判断」パートでは、41/43 の意味を読み解き、「隠れた規則」問題での失点を説明する仮説を提示し、費用低下の要因を分解し、モデル選定のアドバイスと再検証コードを示します。
GPT-6.2 Astra DataAnalyticsBench の前提知識
| 概念 | 簡単な説明 |
|---|---|
| DataAnalyticsBench | Plotly と Mila の研究者が設計した 43 問のデータウェアハウス分析問題で、模擬的な風力発電運用データ上でモデルの分析能力を評価します |
| テスト実行環境 | 各モデルに同一のデータウェアハウスと、クエリ、グラフ描画、表表示などの読み取り専用ツールを提供する評価システム |
| 採点ルール | 問題ごとにどのような回答が問題の趣旨を十分に満たすかを定め、合格か不合格かのみで判定し、部分点は与えません |
| データ品質問題 | 欠損、重複、異常レコードなど、分析結論に影響を与える入力の問題で、問題中に意図的に埋め込まれています |
| 統計的罠 | 直感的なアルゴリズムや集計方法が誤った結論に導く可能性がある問題 |
| 隠れた規則性 | 問題文では明示されておらず、モデルが自ら追跡調査する必要がある異常パターンや原因 |
| 問題ごとの所要時間中央値 | 43 問の実際の経過時間を並べ替えて中央値を取ったもので、このランキングにはツールクエリの所要時間も含まれます |
| 全体の費用 | 同一モデルで全 43 問を完了するまでの累積呼び出し費用 |
| キャッシュヒット | 重複する入力プレフィックスがサーバー側でキャッシュされ、より低い単価で課金される入力トークンの部分 |
GPT-6.2 Astra DataAnalyticsBench スコアが異なるユーザー層に与える影響の概要
- API選定者:GPT-6.2 Astra は単価コストと応答速度が明らかに改善しているため、定型的なレポート作成や指標定義の確認といったタスクでは優先的に検討できます。ただし、異常調査系のタスクについては、現時点ではランキングの結論をそのまま当てはめるのは避けたほうがよいでしょう。
- データプロダクト開発者:「自然言語によるデータ質問」や BI アシスタントといったプロダクトを開発する場合、レイテンシ中央値が半減することはインタラクション体験に大きく影響します。ただし、モデルのマルチターン探索における「忍耐力」は別途評価する必要があり、必要に応じてプロンプトやワークフローの中で検査ステップの追加を強制することをおすすめします。
- 分析チーム:モデルをより高速な初稿アナリストとして活用できますが、根本原因調査系の結論については依然として人手による再確認が必要です。APIYI apiyi.com のような OpenAI 互換の集約インターフェースを利用すれば、同じコード内で4つのモデルを切り替えて比較テストを実施できます。
GPT-6.2 Astra DataAnalyticsBench の客観的事実
GPT-6.2 Astra のテストシナリオと採点ルール
DataAnalyticsBench は Plotly と Mila の研究者によって設計され、風力発電運用の模擬データウェアハウスを使用します。データウェアハウスは 44 テーブル、約 1,990 万行、554 列で構成され、設備テレメトリ、アラーム、作業指示、点検、気象などのデータをカバーしています。各問題は Plotly Studio Embedded 上で実行され、OpenRouter 経由でモデルを呼び出します。モデルが使用できるツールは 4 種類の読み取り専用ツールのみです。データセット一覧、SQL 実行、グラフ描画、テーブル表示です。
モデルはクエリの経路と回答のタイミングを自分で決定し、テスト側が手順を代わりに計画することはありません。これは、評価で試されるのが SQL を書くことだけではなく、「どこまで調べれば十分か」という判断も含まれることを意味します。
採点面では、各問題を解答キーと採点ルールに従って合格・不合格で判定し、部分点はありません。判定モデルは Claude Sonnet 5 で、温度は 0 に設定されています。主催者は SQL、pandas、Polars の 3 通りで独立に解答を生成して相互検証し、失敗した軌跡を人手でレビューし、満点の結果も審査します。2 種類の特殊な問題には、明確な合格条件があります。
- 曖昧な問題:モデルが確認を行って明確化する、あるいは仮定を明示して代替解法を示せば合格です。
- データから回答できない問題:既存データの制約を正確に指摘できれば合格です。
問題バンクにも明確な境界があります。単一の業務領域(風力発電運用)、英語、同一のテスト環境で、各モデルは 1 回だけ実行します。問題、データ、解答キーは主催者が保持し、外部には公開しません。
出典:Plotly、Introducing DataAnalyticsBench、2026-10-14 公開、2026-11-19 更新、plotly.com/blog/introducing-dataanalyticsbench/
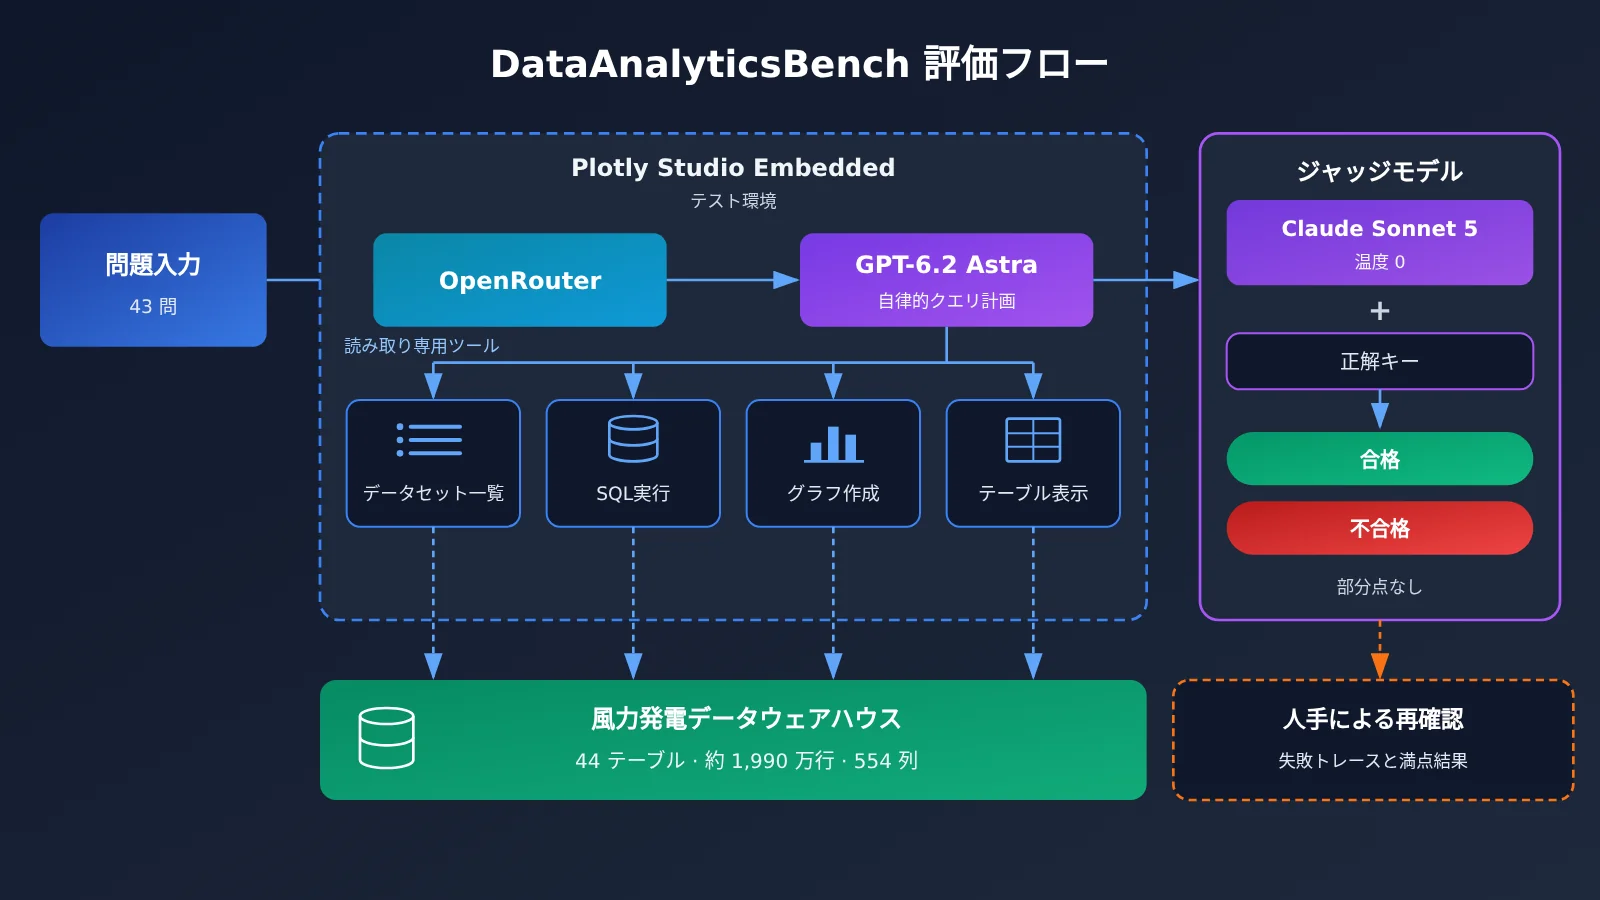
図の説明:この「モデルがクエリを自律的に計画 + 読み取り専用ツール + 問題ごとの合否判定」という構造は、自社の環境で APIYI apiyi.com の OpenAI 互換インターフェースを使って近似的に再現し、社内の対照テストに活用できます。
GPT-6.2 Astra の6分類スコア:失点は「隠れた規則性」に集中
Plotly が2026年11月17日に公開した Astra 特化レポートでは、分類別のスコアが示されています。
| 問題カテゴリ | GPT-6.2 Astra | GPT-6 Astra | 評価ポイント |
|---|---|---|---|
| 通常の分析 | 20/20 | 20/20 | 多段 SQL、テーブル結合、期間条件 |
| 曖昧さの判断 | 5/5 | 5/5 | 集計基準を確認する、または妥当な仮定を明示する |
| データで答えられない質問 | 5/5 | 5/5 | 既存データに基づいて答えられない質問を特定する |
| データ品質 | 3/3 | 3/3 | 埋め込まれた品質問題を検出する |
| 統計トラップ | 5/5 | 5/5 | 直感的なアルゴリズムが招きうる誤解を識別する |
| 隠れた規則性 | 3/5 | 5/5 | 明示されていない異常な規則性を自ら追跡する |
| 合計 | 41/43 | 43/43 | 各問等重み、1問ずつ合否判定 |
最初の5カテゴリは合計 38/38 で、両世代の結果は完全に一致しています。差はすべて「隠れた規則性」の問題によるもので、新世代は 3/5、前世代は 5/5 でした。
失点した2問はいずれも Plotly による人手の再確認を受けており、失敗の仕方はそれぞれ異なります。
- 一方の問題では、モデルは埋め込まれた規則性を最後まで特定できませんでした。
- もう一方の問題では、モデルは調査すべき箇所を突き止めたものの、本当の原因を排除してしまいました。
レポートにはプロセスに関するデータも示されています。「隠れた規則性」の問題において、GPT-6.2 Astra は1問あたり平均約9回のデータベースクエリを実行したのに対し、GPT-6 Astra は約15回でした。
出典:Plotly「GPT-6.2 Astra Benchmark Results for Data Analysis」、2026-11-17、plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/
GPT-6.2 Astra の費用と所要時間:2世代と同一メーカー内の比較
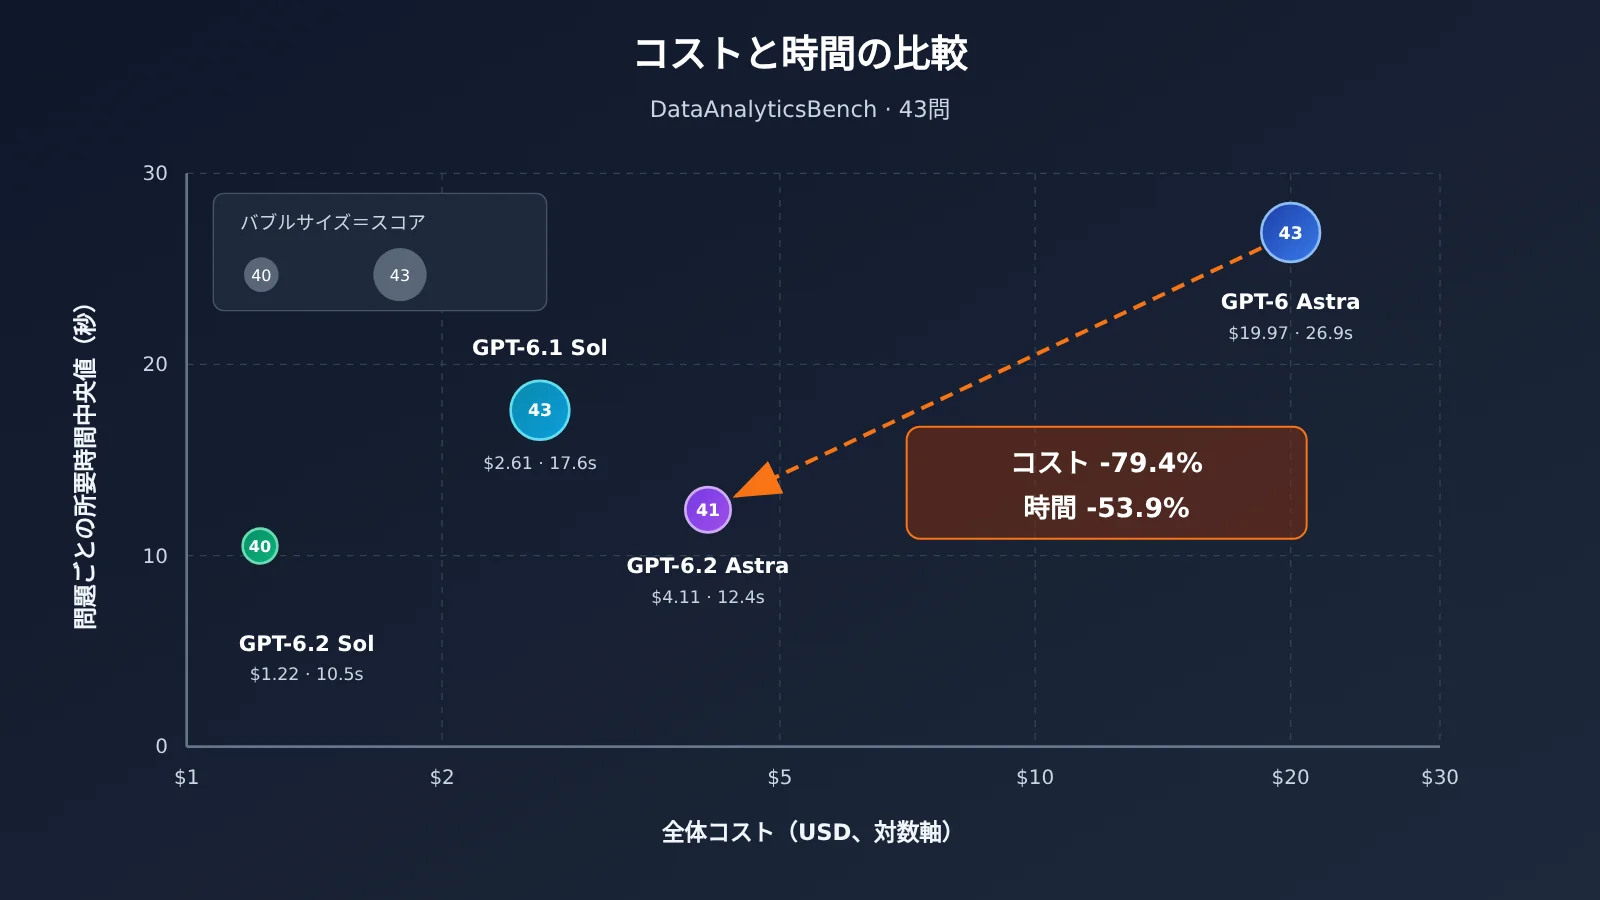
| モデル | スコア | ラウンド全体の費用 | 問題あたりの所要時間中央値 |
|---|---|---|---|
| GPT-6.2 Astra | 41/43 | $4.11 | 12.4 秒 |
| GPT-6 Astra | 43/43 | $19.97 | 26.9 秒 |
| GPT-6.1 Sol | 43/43 | $2.61 | 17.6 秒 |
| GPT-6.2 Sol | 40/43 | $1.22 | 10.5 秒 |
元の表に基づいて計算すると、GPT-6.2 Astra は前世代と比べてラウンド全体の費用が約 79.4% 低下し、問題あたりの所要時間中央値が約 53.9% 短縮されています。筆者の実測では、6.2 Astra のラウンド全体は約 13 分、前世代は約 32 分でした。ここでの所要時間はツール呼び出しを含む実際の経過時間であり、純粋なモデル推論時間ではありません。
1問あたりの費用には2つの計算基準があり、分けて見る必要があります。$4.11 ÷ 43 で1問あたりの均等割りは約 $0.096 になります。一方、更新後の総合ランキングでは $0.066 を今回の1問あたり費用の中央値として示しています。均等割りの値が中央値より高いのは、一部の問題で費用が明らかに高く、平均値を押し上げていることを意味します。
Plotly はさらに、2世代の元ラウンドの作業量の内訳も提供しています。
| 作業量指標 | GPT-6 Astra(前世代) | GPT-6.2 Astra |
|---|---|---|
| ツール呼び出し回数 | 266 回 | 148 回 |
| モデル呼び出し回数 | 249 回 | 171 回 |
| 入力 token | 約 910 万 | 約 440 万 |
| 出力 token | 約 7.8 万 | 約 3.4 万 |
| 入力キャッシュヒット比率 | 93% | 98% |
Plotly は新料金で前世代の同じ使用量を再計算し、約 $11 と見積もっています。注意すべきは、これらの費用が Plotly のテスト当時の OpenRouter 価格に基づくものであり、OpenAI 公式価格表からの直接換算ではないという点です。
出典:Plotly の Astra 専門レポート plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/;Plotly 総合ランキング plotly.com/blog/introducing-dataanalyticsbench/#full-results
GPT-6.2 Astra モデルの位置づけと公式価格の基準
OpenAI は 2026年11月17日、GPT-6.2 Astra と GPT-6.2 Sol を発表しました。Astra は複雑な推論、コーディング、専門業務向けで、API モデル ID は gpt-6.2-astra です。OpenAI の発表記事に掲載された評価はベンダー側の基準によるもので、Plotly の DataAnalyticsBench は別のサードパーティ評価です。両者を混在させて比較することはできません。
モデルカードによると、Astra はテキストと画像を入力として受け取り、テキストを出力します。コンテキスト長は 1,050,000 トークン、最大入力は 922,000 トークン、最大出力は 128,000 トークンです。Responses API と Chat Completions API の両方をサポートしており、組み込みツール、マルチエージェント、バックグラウンド完了ウィンドウなどの機能は Responses API が基準となります。モデルカードでは、reasoning.effort を none に設定したリクエストは拒否されることも説明されています。
OpenAI の標準的な短コンテキスト・テキストのみの価格(100万トークンあたり)は、通常入力 $8、キャッシュヒット入力 $0.40、出力 $40 です。公式によると、前世代と比較して通常入力と出力の単価が 20% 低下し、キャッシュヒット入力の単価が 60% 低下しています。
出典:OpenAI 発表記事 openai.com/index/introducing-gpt-6-2-astra-sol/、モデルカード developers.openai.com/api/docs/models/gpt-6.2-astra、API 更新ログ developers.openai.com/api/docs/changelog、価格表 developers.openai.com/api/docs/pricing
GPT-6.2 Astra DataAnalyticsBench の分析評価
41/43 の読み方:「全体が弱くなった」わけではない
41/43 を内訳で見ると、GPT-6.2 Astra は通常分析、曖昧さ、回答不能、データ品質、統計の落とし穴という5カテゴリで失点がありません。これら5カテゴリは、日常的なレポートや集計基準の照合における大部分のシナリオをカバーしています。業務が主にこうした問題であれば、今回のデータから見て、新世代 Astra の品質は前世代と同等であり、コストと速度は明らかに優れています。
2問の差は、ばらつきの範囲内で捉える必要があります。Plotly の報告によると、他のモデルで再実行した際に最大3問の変動が生じたことがあるとのことです。したがって、41 対 43 は「今回の観測値」として扱うほうが適切であり、安定した能力差と見なすべきではありません。より正確に言えば、隠れた規則性のカテゴリには追跡する価値のあるシグナルが現れていますが、単一ラウンドのデータだけでは性能低下が存在すると確認するには不十分だ、ということです。
隠れた規則性の問題を再検証すべき理由:探索深度に関する仮説
以下はレポートデータに基づく解釈上の仮説であり、Plotly の結論ではありません。隠れた規則性の問題では、新世代は1問あたり平均約9回のクエリ、前世代は約15回でした。失点した2問の挙動は、一方が「見つからなかった」、もう一方が「位置は見つけたものの真因を除外してしまった」というものです。どちらも「十分に深く調べずに打ち切った」ように見えます。前者は探索範囲が不足し、後者は検証段階で早まって否定的な結論を下しました。
これは、コストとレイテンシの低下が同じ行動変化に由来する可能性を示しています。つまり、モデルが数回調べただけで回答する傾向を強めたということです。通常の問題では、この傾向はそのまま効率に変わりますが、仮説と検証を繰り返す必要がある根本原因分析の問題では、リスクになり得ます。この仮説を検証するには、合計スコアだけを見るのではなく、自身のデータでクエリ回数と通過率の関係を照らし合わせる必要があります。
GPT-6.2 Astra のコストと速度が同時に低下した理由
$19.97 から $4.11 への低下は、Plotly の再計算データに基づくと2つの段階に分解できます。
- 料金要因:前世代と同じ使用量を新料金で再計算すると約 $11、つまり値下げだけでコストは約 $19.97 から $11 へ、約45%低下します。公式のキャッシュ入力単価が60%下がっており、キャッシュヒット率が93%から98%に達するシナリオでは、この部分の効果が特に顕著です。
- 作業量要因:約 $11 から $4.11 へは、作業量の削減によるものです。ツール呼び出しは266回から148回に減り、入力トークンは約910万から約440万に減少、出力トークンは半分以上減少し、キャッシュヒットの割合は93%から98%に上がりました。
公式単価で新世代の使用量をざっくり計算しても、結果は $4.11 と同じオーダーになります。約440万の入力のうち98%がキャッシュ価格、残りが通常の入力価格で、さらに約3.4万の出力トークンを加えたものです。これは、データ分析のような長いコンテキストと多ターンのツール呼び出しを伴うシナリオでは、キャッシュヒット率と呼び出しターン数がコストに与える影響は、単価そのものより大きい可能性があることを示しています。速度向上も同様です。クエリが減り、モデル呼び出しが減れば、経過時間は自然に短縮されます。
💰 コストのヒント:こうしたエージェント型タスクの費用を評価する際は、キャッシュヒットしたトークンとツール呼び出しのターン数を記録すべきで、単価表だけを見てはいけません。APIYI apiyi.com で従量課金の呼び出しを行う場合、請求書とログの usage フィールドを照合して、キャッシュが有効になっているか確認できます。
GPT-6.2 Astra と GPT-6.1 Sol、GPT-6.2 Sol の使い分け
4つのモデルの位置付けはそれぞれ異なります。
- GPT-6.1 Sol:この設定では $2.61 で 43/43 を達成し、今回の「満点の中では最も安い」選択肢です。代わりに所要時間の中央値は 17.6 秒で、6.2 Astra より遅いです。
- GPT-6.2 Astra:41/43、$4.11、12.4 秒。強みはスコアと速度を一緒に比較したときに現れます。コストとスコアだけを見ると、優位ではありません。
- GPT-6.2 Sol:$1.22、10.5 秒。最も安く最も速い一方、スコアは 40/43 で最も低いです。
- GPT-6 Astra:満点ですが、費用とレイテンシがどちらも明らかに高く、この比較グループでは優先する理由を見つけにくいです。
これらの間のスコア差は、Plotly が言及した最大3問の変動範囲内にあります。つまり、総合得点だけでは信頼できる順位付けは難しく、本当に信頼できる区別軸は費用とレイテンシです。実際の選択では、インタラクティブなデータ問い合わせプロダクトはレイテンシに敏感なので、6.2 Astra と 6.2 Sol を優先的に比較できます。オフラインのバッチ分析はレイテンシに敏感でないため、6.1 Sol のコストパフォーマンスにより注目する価値があります。
自前のデータで GPT-6.2 Astra を再検証する方法
以下の再検証方法は編集部からの提案です。DataAnalyticsBench は風力発電の運用、英語、単一環境しかカバーしておらず、多くのチームが使う実際のデータウェアハウスとは大きく異なります。より確実なのは、自前のデータで小規模な問題セットを作り、データ・ツール・プロンプトを固定したうえで複数回実行し、タスク種別ごとに性能を集計する方法です。
| サブセット | 推奨問題数 | 重点的に記録する項目 | 判断したいこと |
|---|---|---|---|
| 定例レポート | 15〜20問 | 通過率、レイテンシ中央値 | 日常のデータ質問を安心してモデルに任せられるか |
| 曖昧な集計定義 | 5問程度 | 自発的に確認するか、仮定を説明するか | 「黙って一つの定義を選ぶ」ことの防止 |
| 統計バイアス | 5問程度 | シンプソンのパラドックスなどの罠を識別できるか | 結論の信頼性 |
| 異常の根本原因 | 5〜8問 | 通過率、クエリ回数、P90レイテンシ | 隠れた規則性を問う問題での失点シグナルの検証 |
| 全問題 | — | 各ラウンドの総コスト、キャッシュヒット率 | コスト予算 |
各モデルは最低3ラウンド実行し、平均値とばらつきを記録することをおすすめします。テールレイテンシ(P90)は別途記録してください。中央値が良くても、最も遅い問題が許容できるとは限りません。
以下は最小限の呼び出し例です。モデルIDには OpenAI が公開している gpt-6.2-astra を使用しており、実際に利用できるモデルはプラットフォームの一覧を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.2-astra",
    reasoning_effort="medium",  # モデルカードによると、effort が none のリクエストは拒否されます
    messages=[{"role": "user", "content": "上月各风场故障工单数环比变化最大的是哪个?请说明计算口径。"}],
)
print(resp.choices[0].message.content)
完全版の再検証スクリプトを見る:サブセット別に通過率・コスト・P50/P90 レイテンシを集計
import time
import statistics
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODELS = ["gpt-6.2-astra", "gpt-6-astra", "gpt-6.1-sol", "gpt-6.2-sol"]

# 自作のテストセット:category は再テスト表のサブセットに対応、checker は解答キーに沿って実装
TASKS = [
    {"id": "r01", "category": "常规报表", "prompt": "...", "checker": lambda a: "..." in a},
    {"id": "h01", "category": "异常根因", "prompt": "...", "checker": lambda a: "..." in a},
]

# 公式直結の単価(USD/100万トークン)、粗い見積もりのみに使用;実際はプラットフォームの請求書に基づく
PRICE = {"input": 8.0, "cached": 0.40, "output": 40.0}

def estimate_cost(usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * PRICE["input"] + cached * PRICE["cached"]
            + usage.completion_tokens * PRICE["output"]) / 1_000_000

def p90(values):
    values = sorted(values)
    return values[max(0, int(len(values) * 0.9) - 1)]

def run(model, rounds=3):
    stats = {}
    for _ in range(rounds):
        for t in TASKS:
            start = time.perf_counter()
            resp = client.chat.completions.create(
                model=model,
                reasoning_effort="medium",
                messages=[{"role": "user", "content": t["prompt"]}],
            )
            elapsed = time.perf_counter() - start
            answer = resp.choices[0].message.content or ""
            s = stats.setdefault(t["category"], {"pass": 0, "n": 0, "lat": [], "cost": 0.0})
            s["n"] += 1
            s["pass"] += int(t["checker"](answer))
            s["lat"].append(elapsed)
            s["cost"] += estimate_cost(resp.usage)
    for cat, s in stats.items():
        print(f"{model} | {cat} | 通过率 {s['pass']}/{s['n']} | "
              f"P50 {statistics.median(s['lat']):.1f}s | P90 {p90(s['lat']):.1f}s | "
              f"估算费用 ${s['cost']:.3f}")

for m in MODELS:
    run(m)
このスクリプトは単一ラウンドの質疑応答のみを実行します。DataAnalyticsBench の設定に近づけるには、読み取り専用の SQL ツールを接続し、モデルが自律的に複数ラウンドのクエリを実行できるようにする必要があります。さらに、各問題のツール呼び出し回数を記録して、前述の「クエリ回数と失点」の仮説を検証します。
🎯 再テストの提案:4つのモデルはいずれも OpenAI 互換プロトコルに対応しているため、APIYI apiyi.com 経由で同じ APIキーを使えば切り替えられます。新規ユーザーの無料テスト枠は、まず小さめのテストセットを1ラウンド回してから、規模を拡大するかどうかを判断するのに十分です。
ランキングが示すのは方向性にすぎません。自分のデータウェアハウス、自分の異常タイプとなれば、答えは自分で走らせて確かめるしかありません。陸游は『冬夜読書示子聿』の中でこう記しています。「紙の上で得た知識はどこか浅く、このことを真に極めるには自ら実践するに如かず。」
作者:APIYI 技術チーム
技術交流:APIYI apiyi.com のトップページからお気軽にお問い合わせください。導入に関する詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください。