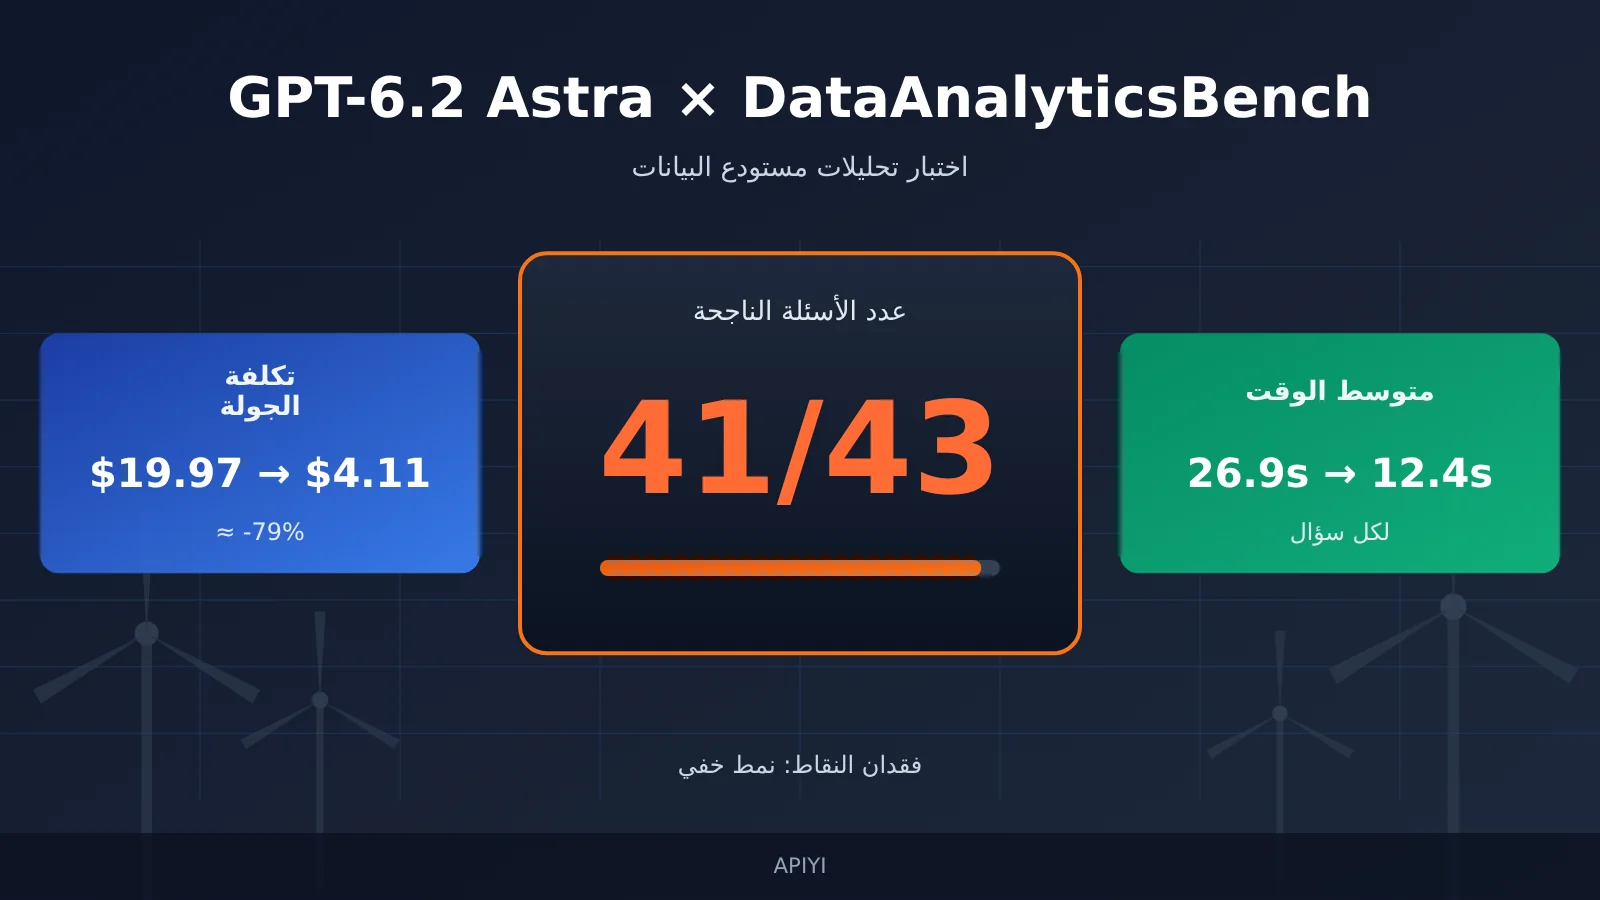
الخلاصة الأساسية: في اختبار DataAnalyticsBench من Plotly، نجح GPT-6.2 Astra في 41 سؤالاً من أصل 43 سؤالاً في تحليل البيانات. أما الجيل السابق GPT-6 Astra فقد حقق 43/43. جاءت خسارة السؤالين في فئة “الأنماط الخفية”، بينما نجح في الفئات الخمس الأخرى جميعها. في الوقت نفسه، انخفضت تكلفة الجولة الكاملة من $19.97 إلى $4.11، وقلّ الوسيط الزمني لكل سؤال من 26.9 ثانية إلى 12.4 ثانية. حصل الجيل الجديد Astra على هذه المكاسب مقابل خسارة سؤالين فقط، بتكلفة أقل من ربع تكلفة الجيل السابق وزمن انتظار أقل من النصف، لكن هل تراجع فعلاً في قدرته على تعقّب الشذوذات بمبادرته الذاتية؟ لدينا جولة بيانات واحدة فقط حتى الآن، والأمر يحتاج إلى إعادة اختبار على بياناتك الخاصة.
ماذا ستتعلم من قراءة هذا المقال؟
- ما الذي يقيسه DataAnalyticsBench وكيف يحتسب الدرجات، وأين تقع حدود نتيجة 41/43.
- الدرجات التفصيلية للفئات الست، وكيف فشل السؤالان الخاسران تحديداً.
- مصدرا انخفاض التكلفة بنحو 79%: تخفيض الأسعار وانخفاض حجم العمل، وكم يساهم كل منهما.
- المقايضات بين GPT-6.2 Astra وGPT-6 Astra وGPT-6.1 Sol وGPT-6.2 Sol في الدرجات والتكلفة وزمن الاستجابة.
- منهجية إعادة اختبار قابلة للتعديل المباشر مع شفرة Python، للتحقق من النتائج على مستودع البيانات الخاص بك.
الفهرس: يشرح جدول To Know المفاهيم الخاصة الواردة في التقييم، ويلخّص قسم “لمحة سريعة عن التأثير” معنى هذا الخبر بحسب كل فئة من القراء. أما قسم “الوقائع الموضوعية” فيعرض بالترتيب بيئة الاختبار وقواعد احتساب الدرجات، ودرجات الفئات الست، وبيانات التكلفة والزمن، وهوية النموذج وأسعاره الرسمية من OpenAI. ويعالج قسم “التحليل والحكم” معنى 41/43، ويقدّم فرضيات لتفسير خسارة أسئلة الأنماط الخفية، ويفكّك مصادر انخفاض التكلفة، ويعطي توصيات لاختيار النموذج مع شفرة إعادة الاختبار.
| المفهوم | شرح موجز |
|---|---|
| DataAnalyticsBench | 43 سؤالاً في تحليل مستودعات البيانات صمّمها باحثون من Plotly وMila، لاختبار قدرة النماذج التحليلية على بيانات محاكاة لتشغيل مزارع طاقة الرياح |
| بيئة تشغيل الاختبار | نظام تقييم يمنح كل نموذج مستودع البيانات نفسه، مع أدوات للقراءة فقط مثل الاستعلام والرسم وعرض الجداول |
| قواعد التقييم | تحدد لكل سؤال ما يُعد إجابة كافية ووافية، ثم تحكم بالنجاح أو الفشل فقط، دون منح درجات جزئية |
| مشكلات جودة البيانات | مشكلات في المدخلات مثل السجلات الناقصة والمكررة والشاذة التي تؤثر على استنتاجات التحليل، وقد زُرعت عمداً داخل الأسئلة |
| مزالق إحصائية | أسئلة قد تقود فيها الخوارزميات البديهية أو أساليب التجميع إلى استنتاجات خاطئة |
| أنماط خفية | أنماط أو أسباب شاذة لا يذكرها نص السؤال، ويحتاج النموذج إلى تتبّعها بنفسه |
| الوسيط الزمني لكل سؤال | القيمة الوسطى بعد ترتيب الأزمنة الفعلية للأسئلة الـ43، وتشمل هذه القائمة زمن استعلامات الأدوات |
| تكلفة الدورة الكاملة | التكلفة التراكمية لاستدعاءات النموذج نفسه عند إكمال جميع الأسئلة الـ43 |
| إصابة ذاكرة التخزين المؤقت | الجزء من رموز الإدخال الذي يخزنه الخادم عند تكرار بادئة الإدخال نفسها، ويُحتسب بسعر أقل |
نظرة سريعة على تأثير تقييمات GPT-6.2 Astra في DataAnalyticsBench على مختلف الفئات
- من يختارون API: تحسّنت تكلفة الوحدة وسرعة الاستجابة في GPT-6.2 Astra بشكل ملحوظ، لذا يمكن إعطاؤه الأولوية في مهام مثل التقارير الروتينية وتوضيح المقاييس. أما مهام تشخيص الحالات الشاذة فلا يُنصح حاليًا بتطبيق استنتاجات لوحة الترتيب عليها مباشرة.
- مطوّرو منتجات البيانات: عند بناء منتجات مثل “الاستعلام عن البيانات باللغة الطبيعية” ومساعدي BI، فإن خفض وسيط زمن الاستجابة إلى النصف له أثر كبير في تجربة التفاعل. لكن ينبغي تقييم “صبر” النموذج في الاستكشاف متعدد الجولات بشكل منفصل، وعند الحاجة أضف خطوات تحقق إلزامية في الموجه أو في سير العمل.
- فرق التحليل: يمكن اعتبار النموذج محللاً أسرع للمسودة الأولى، لكن الاستنتاجات المتعلقة بالتحقيق في الأسباب الجذرية لا تزال بحاجة إلى مراجعة بشرية. وباستخدام واجهة تجميع متوافقة مع OpenAI مثل APIYI على apiyi.com، يمكن التبديل بين النماذج الأربعة ضمن الشيفرة نفسها لإجراء اختبارات مقارنة.
حقائق موضوعية حول GPT-6.2 Astra DataAnalyticsBench
سيناريوهات اختبار GPT-6.2 Astra وقواعد التقييم
صمّم باحثون من Plotly وMila منصة DataAnalyticsBench، وتعتمد على مستودع بيانات محاكى لتشغيل طاقة الرياح. يضم المستودع 44 جدولًا ونحو 19.9 مليون صف و554 عمودًا، تغطي بيانات القياسات عن بُعد للمعدات والإنذارات وأوامر العمل والفحوصات والطقس. تُشغَّل كل مسألة داخل Plotly Studio Embedded، ويُستدعى النموذج عبرها عبر OpenRouter. والأدوات المتاحة للنموذج أربع فقط، وكلها للقراءة فقط: سرد مجموعات البيانات، وتنفيذ SQL، والرسم البياني، وعرض الجداول.
يقرر النموذج بنفسه مسار الاستعلام وتوقيت الإجابة، ولا يخطط له فريق الاختبار الخطوات نيابةً عنه. وهذا يعني أن التقييم لا يختبر كتابة SQL فحسب، بل يختبر أيضًا الحكم على «إلى أي مرحلة يكفي أن يستعلم».
أما التقييم فيُحكم فيه على كل مسألة على حدة وفق مفتاح الإجابة وقواعد التقييم، ولا توجد درجات جزئية. نموذج التحكيم هو Claude Sonnet 5 بدرجة حرارة 0. أنتج المنظمون الإجابات بثلاث طرق مستقلة — SQL وpandas وPolars — وتقاطعوها للتحقق، وراجعوا بشريًا مسارات الفشل، وفحصوا كذلك النتائج الكاملة. وهناك نوعان من المسائل الخاصة لهما شروط نجاح واضحة:
- المسائل الغامضة: ينجح النموذج إذا طلب التوضيح، أو أعلن افتراضاته وقدّم حلًا بديلًا.
- المسائل التي لا يمكن الإجابة عنها بالبيانات: يكفي أن يحدد بدقة القيود المفروضة على البيانات المتاحة لينجح.
ولمجموعة الأسئلة حدود واضحة أيضًا: نطاق أعمال واحد (تشغيل طاقة الرياح)، واللغة الإنجليزية، وبيئة اختبار واحدة، ويُجرى كل نموذج جولة واحدة فقط. ويحتفظ المنظمون بالأسئلة والبيانات ومفتاح الإجابة، ولا ينشرونها للعموم.
المصدر: Plotly، Introducing DataAnalyticsBench، نُشر في 2026-10-14، وحُدّث في 2026-11-19، plotly.com/blog/introducing-dataanalyticsbench/
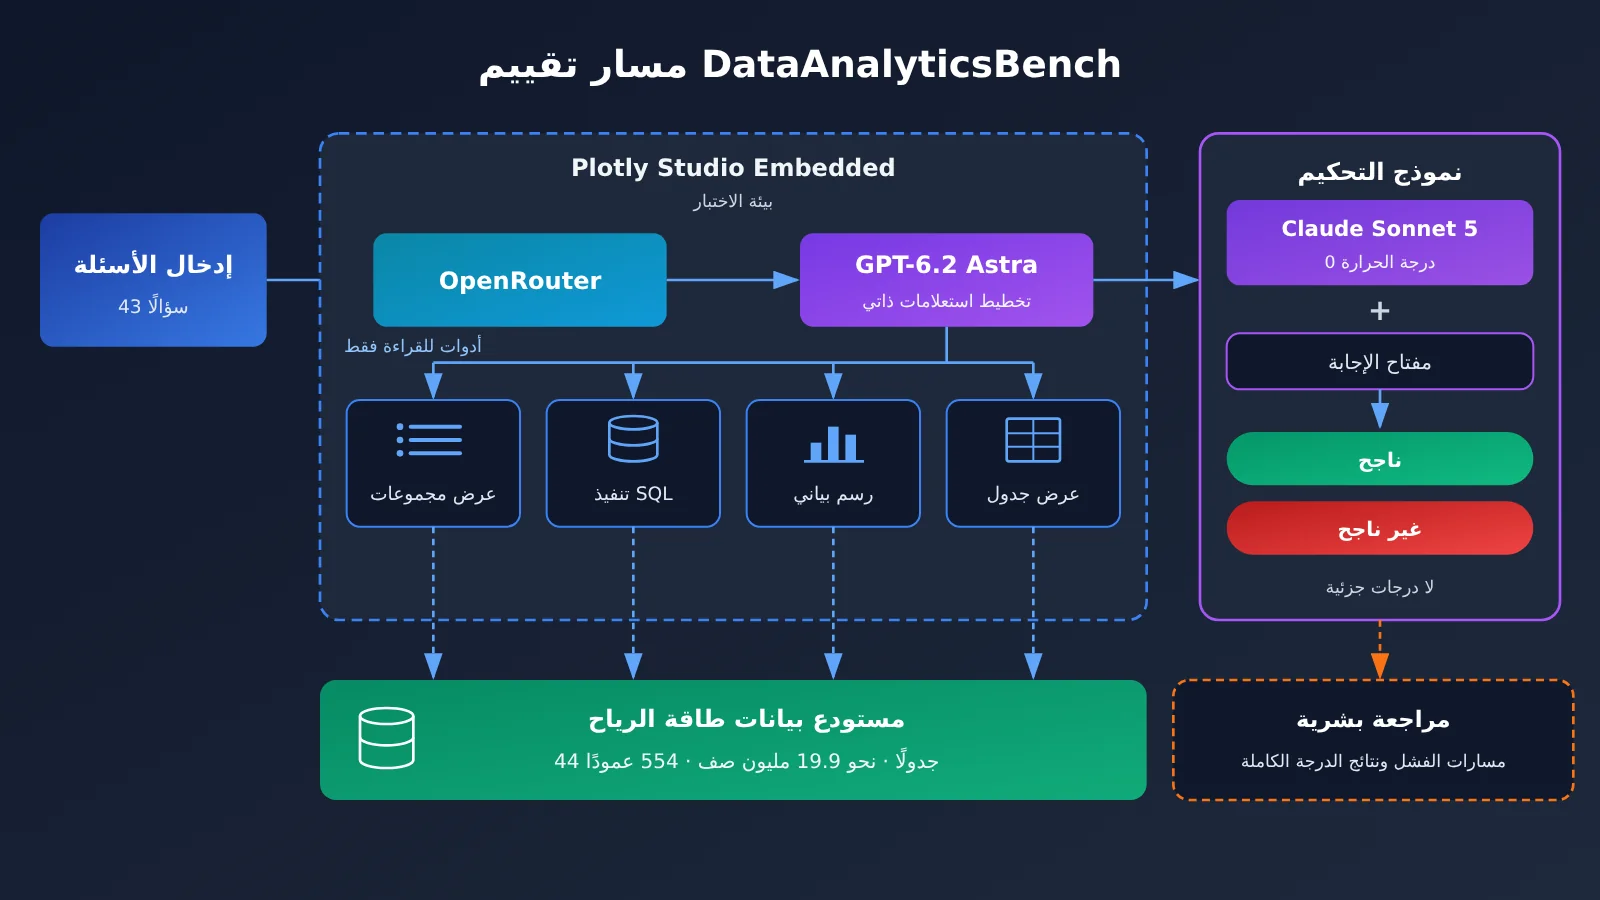
شرح المخطط: يمكنك تقريب هذه البنية — «تخطيط النموذج للاستعلام بنفسه + أدوات للقراءة فقط + الحكم بالنجاح لكل مسألة على حدة» — في بيئتك الخاصة باستخدام الواجهة المتوافقة مع OpenAI من APIYI على apiyi.com، لإجراء اختبارات مقارنة داخلية.
درجات GPT-6.2 Astra في الفئات الست: تركز فقدان النقاط في الأنماط الخفية
قدّم التقرير المتخصص عن Astra الذي نشره Plotly في 17 نوفمبر 2026 الدرجات حسب الفئة:
| فئة السؤال | GPT-6.2 Astra | GPT-6 Astra | ما تقيسه |
|---|---|---|---|
| التحليل العادي | 20/20 | 20/20 | SQL متعدد الخطوات، وربط الجداول، والفترات الزمنية |
| تحديد الغموض | 5/5 | 5/5 | توضيح المعايير أو بيان افتراضات معقولة |
| أسئلة لا يمكن الإجابة عنها بالبيانات | 5/5 | 5/5 | تحديد الأسئلة التي لا يمكن الإجابة عنها بناءً على البيانات المتاحة |
| جودة البيانات | 3/3 | 3/3 | اكتشاف مشكلات الجودة المزروعة |
| المزالق الإحصائية | 5/5 | 5/5 | اكتشاف التضليل المحتمل الناتج عن خوارزميات بديهية |
| الأنماط الخفية | 3/5 | 5/5 | البحث الاستباقي عن أنماط شاذة غير معلنة |
| الإجمالي | 41/43 | 43/43 | كل سؤال متساوي الوزن، ويُقيّم كل سؤال بالنجاح أو الفشل |
بلغ إجمالي الفئات الخمس الأولى 38/38، وكان أداء الجيلين متطابقًا تمامًا. وجاء الفرق كله من أسئلة الأنماط الخفية: 3/5 للجيل الجديد مقابل 5/5 للجيل السابق.
خضع السؤالان اللذان خسر فيهما النموذج النقاط لمراجعة بشرية من Plotly، واختلفت طريقة الفشل بينهما:
- في أحد السؤالين، لم يتمكن النموذج أبدًا من تحديد النمط المزروع.
- وفي السؤال الآخر، حدد النموذج الموضع الذي ينبغي فحصه، لكنه استبعد السبب الحقيقي.
ويقدّم التقرير أيضًا مؤشرًا على العملية: في أسئلة الأنماط الخفية، نفّذ GPT-6.2 Astra نحو 9 استعلامات قاعدة بيانات لكل سؤال في المتوسط، مقابل نحو 15 استعلامًا لدى GPT-6 Astra.
المصدر: Plotly، نتائج معيار GPT-6.2 Astra لتحليل البيانات، 2026-11-17، plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/
تكاليف GPT-6.2 Astra والزمن المستغرق: مقارنة بين جيلين ونموذجين من الشركة نفسها
| النموذج | النتيجة | تكلفة الجولة الكاملة | الوسيط الزمني لكل سؤال |
|---|---|---|---|
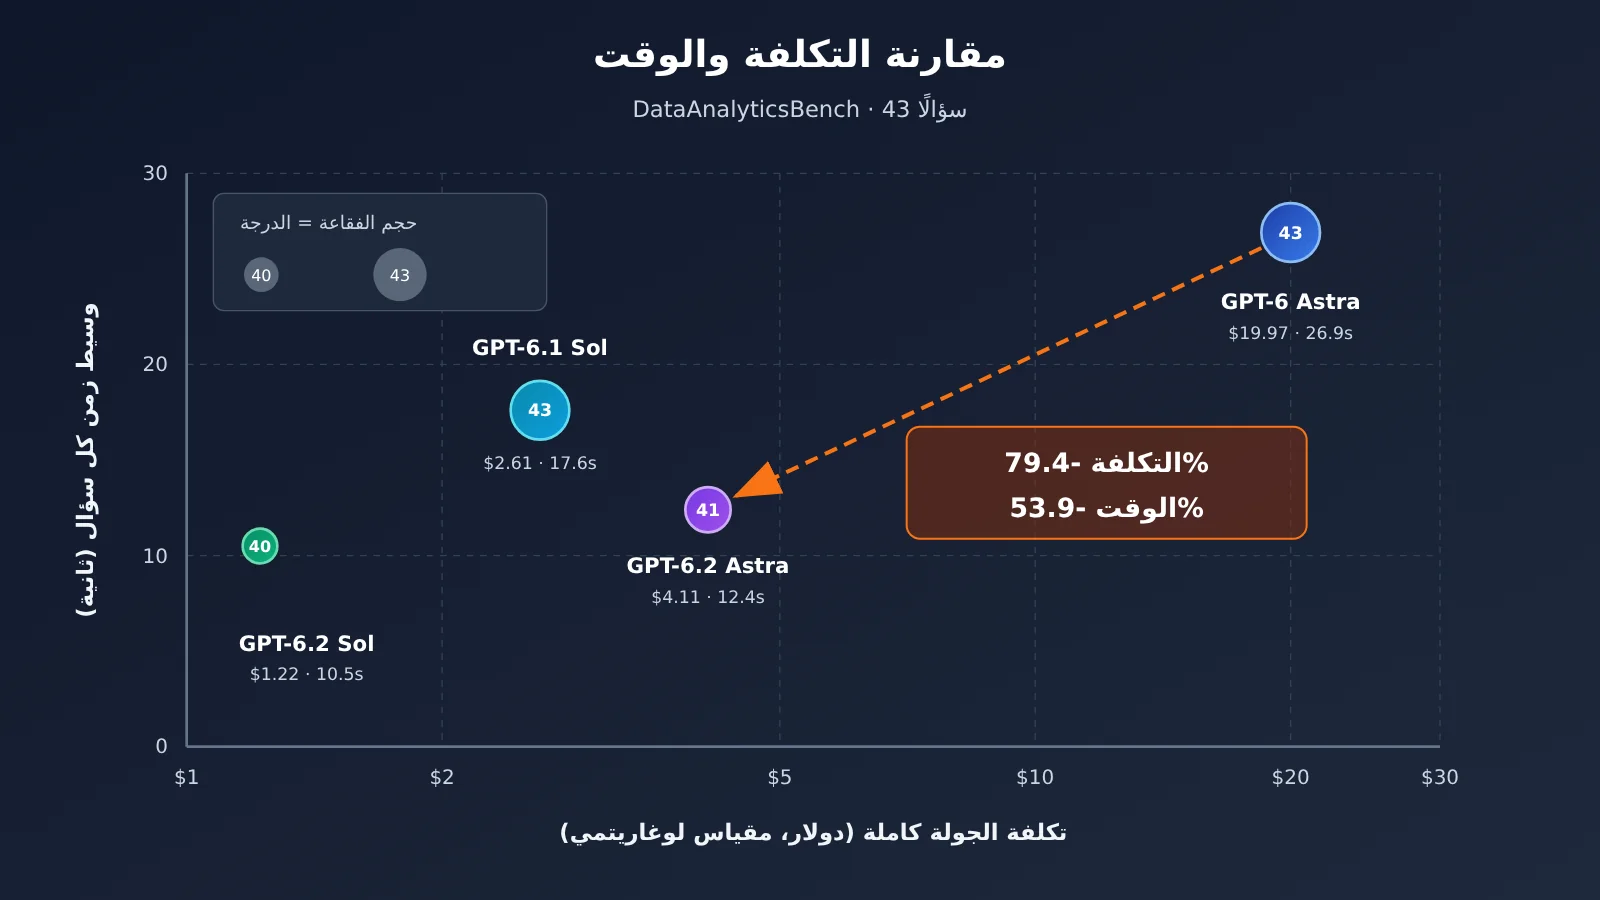
| GPT-6.2 Astra | 41/43 | $4.11 | 12.4 ثانية |
| GPT-6 Astra | 43/43 | $19.97 | 26.9 ثانية |
| GPT-6.1 Sol | 43/43 | $2.61 | 17.6 ثانية |
| GPT-6.2 Sol | 40/43 | $1.22 | 10.5 ثانية |
بحسب الجدول الأصلي، تنخفض تكلفة الجولة الكاملة لـ GPT-6.2 Astra مقارنةً بالجيل السابق بنحو 79.4%، ويقصر الوسيط الزمني لكل سؤال بنحو 53.9%. وفي تجارب المؤلف الفعلية استغرقت جولة 6.2 Astra نحو 13 دقيقة، مقابل نحو 32 دقيقة للجيل السابق. والزمن المقصود هنا هو الزمن الفعلي المنقضي بما يشمل استعلامات الأدوات، لا زمن الاستدلال الصافي للنموذج.
هناك طريقتان لحساب تكلفة السؤال الواحد، ويجب النظر إلى كلٍّ منهما على حدة: قسمة $4.11 على 43 تعطي نحو $0.096 لكل سؤال بالمُعدّل؛ أما القائمة الإجمالية المحدّثة فتضع $0.066 على أنه الوسيط لتكلفة السؤال الواحد في هذه الجولة. والقيمة المُعدّلة أعلى من الوسيط، وهذا يعني أن عددًا قليلًا من الأسئلة كان مكلفًا بشكل واضح، فرفع متوسط التكلفة.
كذلك وفّر Plotly تفصيلًا لحجم العمل في الجولات الأصلية للجيلين:
| مؤشر حجم العمل | GPT-6 Astra (الجيل السابق) | GPT-6.2 Astra |
|---|---|---|
| عدد استدعاءات الأدوات | 266 مرة | 148 مرة |
| عدد استدعاءات النموذج | 249 مرة | 171 مرة |
| رموز الإدخال | نحو 9.1 مليون | نحو 4.4 مليون |
| رموز الإخراج | نحو 78 ألفًا | نحو 34 ألفًا |
| نسبة إصابة ذاكرة التخزين المؤقت للإدخال | 93% | 98% |
أعاد Plotly حساب استخدام الجيل السابق نفسه بالأسعار الجديدة، وقدّر التكلفة بنحو $11. ويجدر بالذكر أن هذه التكاليف مأخوذة من أسعار OpenRouter في وقت اختبار Plotly، وليست تحويلًا مباشرًا من قائمة أسعار OpenAI الرسمية.
المصدر: تقرير Plotly المتخصص عن Astra plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/؛ والقائمة الإجمالية من Plotly plotly.com/blog/introducing-dataanalyticsbench/#full-results
هوية نموذج GPT-6.2 Astra وإطار التسعير الرسمي
أطلقت OpenAI في 17 نوفمبر 2026 نموذجَي GPT-6.2 Astra وGPT-6.2 Sol. صُمم Astra للمهام المعقدة من استدلال وبرمجة وعمل احترافي، ومعرّف النموذج في API هو gpt-6.2-astra. التقييمات الواردة في إعلان OpenAI تأتي من منظور الشركة المطوّرة، بينما DataAnalyticsBench من Plotly مجموعة تقييمات مستقلة من طرف ثالث؛ لذلك لا يصح مقارنة النتيجتين معًا.
وفقًا لبطاقة النموذج، يقبل Astra النص والصور كمدخلات وينتج نصًا، ولديه نافذة سياق تبلغ 1,050,000 توكن، بحد أقصى للإدخال يبلغ 922,000 توكن وحد أقصى للإخراج يبلغ 128,000 توكن. يدعم Astra أيضًا Responses API وChat Completions API، وتُعد Responses API المرجع للأدوات المدمجة وقدرات Multi-agent ونافذة الإكمال في الخلفية. توضح بطاقة النموذج كذلك أن الطلبات التي يكون فيها reasoning.effort مضبوطًا على none سيتم رفضها.
السعر القياسي لدى OpenAI للسياق القصير للنص فقط (لكل مليون توكن) هو: الإدخال العادي $8، والإدخال عند إصابة ذاكرة التخزين المؤقت $0.40، والإخراج $40. وتقول الشركة إنه مقارنة بالجيل السابق، انخفض سعر الإدخال العادي والإخراج بنسبة 20%، وانخفض سعر الإدخال عند إصابة ذاكرة التخزين المؤقت بنسبة 60%.
المصادر: إعلان OpenAI openai.com/index/introducing-gpt-6-2-astra-sol/؛ بطاقة النموذج developers.openai.com/api/docs/models/gpt-6.2-astra؛ سجل تحديثات API developers.openai.com/api/docs/changelog؛ جدول الأسعار developers.openai.com/api/docs/pricing
تحليل وتقييم GPT-6.2 Astra DataAnalyticsBench
كيف نقرأ نتيجة 41/43: ليست «ضعفًا عامًا»
إذا فكّكنا نتيجة 41/43، نجد أن GPT-6.2 Astra لم يخسر أي درجة في خمس فئات من الأسئلة: التحليل العادي، والغموض، والأسئلة غير القابلة للإجابة، وجودة البيانات، والفخاخ الإحصائية. وتغطي هذه الفئات الخمس معظم سيناريوهات التقارير اليومية والتحقق من تعريفات المقاييس. وإذا كانت طبيعة الأعمال تعتمد أساسًا على هذا النوع من الأسئلة، فبالنظر إلى بيانات هذه الجولة، تبدو جودة الجيل الجديد Astra مكافئة للجيل السابق، بينما التكلفة والسرعة أفضل بوضوح.
لكن الفارق البالغ درجتين يجب أن يُنظر إليه ضمن نطاق التذبذب. فقد ذكر تقرير Plotly أن إعادة تشغيل النماذج الأخرى أظهرت تذبذبًا يصل إلى ثلاث درجات. لذلك، فإن 41 مقابل 43 أنسب للتعامل معه باعتباره «قيمة مرصودة في هذه الجولة»، وليس فرقًا مستقرًا في القدرات. والوصف الأدق هو: ظهرت إشارة جديرة بالتتبع في فئة الأنماط الخفية، لكن بيانات جولة واحدة لا تكفي لتأكيد وجود تدهور.
لماذا تستحق أسئلة الأنماط المخفية إعادة الاختبار: فرضية تفسيرية حول عمق الاستكشاف
ما يلي هو فرضية تفسيرية مبنية على بيانات التقرير، وليست استنتاجات Plotly. في أسئلة الأنماط المخفية، يبلغ متوسط عدد الاستعلامات لكل سؤال في الجيل الجديد نحو 9 استعلامات، مقابل نحو 15 في الجيل السابق. أما السؤالان اللذان خسرا الدرجة، فقد كان أحدهما “لم يجد”، والآخر “وجد الموقع لكنه استبعد السبب الحقيقي”. وكلاهما يبدو وكأنه “توقف قبل أن يتعمق بما يكفي”: فالأول لم يوسّع نطاق الاستكشاف بما يكفي، والثاني وصل إلى استنتاج سلبي في مرحلة التحقق في وقت مبكر جدًا.
وهذا يتماشى مع احتمال أن انخفاض التكلفة وزمن الاستجابة ينبع من التغير نفسه في السلوك، أي أن النموذج أصبح يميل إلى الإجابة بعد عدد أقل من الاستعلامات. في الأسئلة الاعتيادية يتحول هذا الميل مباشرة إلى كفاءة، أما في أسئلة السبب الجذري التي تتطلب افتراضات وتحققًا متكررًا فقد يتحول إلى مخاطرة. وللتحقق من هذه الفرضية، عليك أن تقارن على بياناتك الخاصة العلاقة بين عدد الاستعلامات ومعدل النجاح، بدل الاكتفاء بالنظر إلى الدرجة الإجمالية.
لماذا انخفضت تكلفة GPT-6.2 Astra وسرعته في الوقت نفسه
يمكن تقسيم الانخفاض من $19.97 إلى $4.11 إلى مرحلتين، استنادًا إلى بيانات إعادة الحساب من Plotly:
- عامل التسعيرة: إعادة حساب الاستخدام نفسه للجيل السابق بالأسعار الجديدة تعطي نحو $11، أي أن خفض السعر وحده ينزل بالتكلفة من $19.97 إلى $11 تقريبًا، أي بانخفاض نحو 45%. وقد انخفض سعر الوحدة الرسمي للإدخال من ذاكرة التخزين المؤقت بنسبة 60%، وهذا الأثر يكون أوضح ما يكون في السيناريوهات التي يبلغ فيها معدل إصابة ذاكرة التخزين المؤقت 93% إلى 98%.
- عامل حجم العمل: الانتقال من نحو $11 إلى $4.11 يعود إلى انخفاض حجم العمل. فقد هبطت استدعاءات الأدوات من 266 إلى 148، وانخفضت رموز الإدخال من نحو 9.1 مليون إلى نحو 4.4 مليون، وانخفضت رموز الإخراج بأكثر من النصف، وارتفعت حصة إصابة ذاكرة التخزين المؤقت من 93% إلى 98%.
وإذا حاسبنا استخدام الجيل الجديد تقريبًا بأسعار الوحدة الرسمية، فإن النتيجة تقع في نطاق المقدار نفسه مع $4.11: فمن نحو 4.4 مليون رمز إدخال يذهب 98% بسعر ذاكرة التخزين المؤقت، والباقي بالسعر العادي للإدخال، إضافة إلى نحو 34 ألف رمز إخراج. وهذا يشير إلى أن معدل إصابة ذاكرة التخزين المؤقت وعدد جولات الاستدعاء قد يكون تأثيرهما على التكلفة أكبر من تأثير سعر الوحدة نفسه في سيناريوهات مثل تحليل البيانات ذات السياق الطويل واستدعاءات الأدوات متعددة الجولات. والأمر نفسه ينطبق على تحسن السرعة: استعلامات أقل واستدعاءات نموذج أقل، فيقصر الزمن المنقضي بشكل طبيعي.
💰 نصيحة بشأن التكلفة: عند تقييم تكلفة مهام من نوع Agent كهذه، سجّل رموز إصابة ذاكرة التخزين المؤقت وعدد جولات استدعاء الأدوات، ولا تكتفِ بجدول أسعار الوحدة. وعند الاستدعاء حسب الاستخدام عبر APIYI apiyi.com، يمكنك مطابقة الفاتورة مع حقل usage في السجلات للتأكد من أن ذاكرة التخزين المؤقت تعمل فعليًا.
الاختيار بين GPT-6.2 Astra وGPT-6.1 Sol وGPT-6.2 Sol
لكل من النماذج الأربعة موقع مختلف:
- GPT-6.1 Sol: في هذه الإعدادات حقّق 43/43 مقابل $2.61، وهو الخيار “الأرخص بين الحاصلين على الدرجة الكاملة” في هذه الجولة، إلا أن التكلفة تتمثل في زمن استجابة وسيطي يبلغ 17.6 ثانية، أي أبطأ من 6.2 Astra.
- GPT-6.2 Astra: حقّق 41/43 بتكلفة $4.11 وزمن 12.4 ثانية، وتظهر ميزته عندما تُقارن الدرجة والسرعة معًا. أما إذا نظرنا إلى التكلفة والدرجة فقط، فهو ليس الأفضل.
- GPT-6.2 Sol: تكلفة $1.22 وزمن 10.5 ثانية، فهو الأرخص والأسرع، لكن درجته 40/43 وهي الأدنى.
- GPT-6 Astra: حصل على الدرجة الكاملة، لكن التكلفة وزمن الاستجابة مرتفعان بوضوح، ولم يعد من السهل إيجاد سبب لتفضيله في هذه المجموعة من المقارنات.
الفروق بين الدرجات كلها تقع ضمن نطاق التذبذب الذي أشار إليه Plotly، وهو ثلاثة أسئلة كحد أقصى. هذا يعني أن الاعتماد على الدرجة الإجمالية وحدها يصعّب ترتيبًا موثوقًا للأفضلية، بينما البُعد الذي يقدّم تمييزًا فعلاً موثوقًا هو التكلفة وزمن الاستجابة. عند الاختيار العملي، تكون المنتجات التفاعلية لطرح الأسئلة على البيانات حساسة لزمن الاستجابة، لذا يمكن مقارنة 6.2 Astra و6.2 Sol أولاً؛ أما التحليل الدفعي دون اتصال فهو غير حساس لزمن الاستجابة، وتستحق القيمة مقابل السعر التي يقدمها 6.1 Sol مزيدًا من الاهتمام.
كيفية إعادة اختبار GPT-6.2 Astra باستخدام بياناتك الخاصة
طريقة إعادة الاختبار التالية هي اقتراح من المحرر. لا يغطي DataAnalyticsBench سوى عمليات مزارع الرياح، وباللغة الإنجليزية، وفي بيئة واحدة، وهو يختلف كثيرًا عن مستودعات البيانات الحقيقية لمعظم الفرق. الطريقة الأكثر أمانًا هي إعداد مجموعة أسئلة صغيرة باستخدام بياناتك الخاصة، مع تثبيت البيانات والأدوات والموجهات، وتشغيلها لعدة جولات، ثم إحصاء أداء أنواع المهام المختلفة بشكل منفصل.
| المجموعة الفرعية | عدد الأسئلة المقترح | النقاط الرئيسية للتسجيل | الغرض من التقييم |
|---|---|---|---|
| التقارير العادية | 15-20 سؤالاً | معدل النجاح، وزمن التأخير الوسيط | هل يمكن الاعتماد على النموذج في الاستعلامات اليومية عن البيانات؟ |
| المعايير الغامضة | حوالي 5 أسئلة | هل يوضح بنشاط أو يشرح الافتراضات | منع “اختيار معيار واحد بصمت” |
| التحيز الإحصائي | حوالي 5 أسئلة | هل يحدد مفارقة سيمبسون وغيرها من الفخاخ | موثوقية الاستنتاج |
| الأسباب الجذرية للحالات الشاذة | 5-8 أسئلة | معدل النجاح، وعدد الاستعلامات، وزمن التأخير P90 | التحقق من إشارات فقدان النقاط في أسئلة الأنماط الخفية |
| جميع الأسئلة | — | التكلفة الإجمالية لكل جولة، ومعدل إصابة الذاكرة المؤقتة | ميزانية التكلفة |
يُنصح بتشغيل كل نموذج 3 جولات على الأقل، مع تسجيل المتوسط والتقلب. يجب تسجيل زمن التأخير الطرفي (P90) بشكل منفصل: فوسيط الأداء الجيد لا يعني أن أبطأ الأسئلة مقبولة.
فيما يلي أبسط مثال للاستدعاء، باستخدام معرف النموذج gpt-6.2-astra الذي أعلنت عنه OpenAI. يخضع اختيار النماذج المتاحة لقائمة المنصة:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.2-astra",
    reasoning_effort="medium",  # تشير بطاقة النموذج إلى أن الطلبات التي يكون فيها effort مساويًا لـ none سيتم رفضها
    messages=[{"role": "user", "content": "上月各风场故障工单数环比变化最大的是哪个?请说明计算口径。"}],
)
print(resp.choices[0].message.content)
عرض نص إعادة الاختبار الكامل: إحصاء معدل النجاح والتكلفة وزمن التأخير P50/P90 حسب المجموعة الفرعية
import time
import statistics
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODELS = ["gpt-6.2-astra", "gpt-6-astra", "gpt-6.1-sol", "gpt-6.2-sol"]

# مجموعة أسئلة مبنية ذاتيًا: category يقابل مجموعة فرعية في جدول إعادة الاختبار، وchecker تنفّذه أنت وفقًا لمفتاح الإجابة
TASKS = [
    {"id": "r01", "category": "常规报表", "prompt": "...", "checker": lambda a: "..." in a},
    {"id": "h01", "category": "异常根因", "prompt": "...", "checker": lambda a: "..." in a},
]

# سعر الوحدة للاتصال المباشر الرسمي (دولار/مليون توكن)، يُستخدم فقط للتقدير التقريبي؛ والفعلي يعتمد على فاتورة المنصة
PRICE = {"input": 8.0, "cached": 0.40, "output": 40.0}

def estimate_cost(usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * PRICE["input"] + cached * PRICE["cached"]
            + usage.completion_tokens * PRICE["output"]) / 1_000_000

def p90(values):
    values = sorted(values)
    return values[max(0, int(len(values) * 0.9) - 1)]

def run(model, rounds=3):
    stats = {}
    for _ in range(rounds):
        for t in TASKS:
            start = time.perf_counter()
            resp = client.chat.completions.create(
                model=model,
                reasoning_effort="medium",
                messages=[{"role": "user", "content": t["prompt"]}],
            )
            elapsed = time.perf_counter() - start
            answer = resp.choices[0].message.content or ""
            s = stats.setdefault(t["category"], {"pass": 0, "n": 0, "lat": [], "cost": 0.0})
            s["n"] += 1
            s["pass"] += int(t["checker"](answer))
            s["lat"].append(elapsed)
            s["cost"] += estimate_cost(resp.usage)
    for cat, s in stats.items():
        print(f"{model} | {cat} | 通过率 {s['pass']}/{s['n']} | "
              f"P50 {statistics.median(s['lat']):.1f}s | P90 {p90(s['lat']):.1f}s | "
              f"估算费用 ${s['cost']:.3f}")

for m in MODELS:
    run(m)
هذا السكربت يقوم فقط بجولة واحدة من الأسئلة والأجوبة. وإذا أردنا الاقتراب من إعدادات DataAnalyticsBench، فسنحتاج أيضًا إلى ربط أداة SQL للقراءة فقط، بحيث يستعلم النموذج بنفسه على عدة جولات، مع تسجيل إضافي لعدد استدعاءات الأدوات لكل سؤال، وذلك لاختبار فرضية «عدد الاستعلامات وفقدان الدرجات» التي وردت سابقًا.
🎯 توصية إعادة الاختبار: النماذج الأربعة جميعها تعتمد بروتوكول OpenAI المتوافق، ويمكن التبديل بينها عبر APIYI apiyi.com باستخدام مفتاح API نفسه. وحصة الاختبار المجانية للمستخدمين الجدد تكفي لتشغيل جولة أولى على مجموعة أسئلة صغيرة، ثم تقرر ما إذا كنت تريد توسيع النطاق.
تمنحك قائمة التصنيف الاتجاه العام، أما فيما يتعلق بمستودع البيانات الخاص بك ونوع الشذوذ لديك، فلا يمكنك الحصول على الإجابة إلا بتشغيلها بنفسك. كتب لو يو في «القراءة في ليلة شتوية لإرشاد زي يو»: «ما تحصل عليه من الورق يبقى سطحيًا دائمًا، ومعرفة هذا الأمر حقًا تتطلب الممارسة الشخصية.»
المؤلف: فريق APIYI التقني
التواصل التقني: يسعدنا تواصلك معنا عبر الصفحة الرئيسية لـ APIYI apiyi.com، ولمزيد من مواد التكامل يمكنك زيارة مركز وثائق docs.apiyi.com