Nota do autor: neste artigo, analisamos como o Flint-interactive usa “eventos semânticos + operações de atualização” para reduzir o custo e a taxa de erros na geração de gráficos interativos por agentes, além de apresentar três formas de integração.
Se você desenvolve agentes de IA para análise de dados ou relatórios, talvez já tenha passado por isso: o agente cria um gráfico estático rapidamente, mas basta pedir um filtro por clique ou uma seleção por área que afeta outros gráficos para começar uma sequência de ajustes. Às vezes, o layout fica desalinhado; em outras, o destaque deixa de funcionar. Você corrige uma coisa e outra quebra, gastando tokens e tempo na depuração.
A Microsoft Research lançou o Flint-interactive em 22 de outubro de 2026. Trata-se de uma linguagem de visualização interativa de dados construída sobre o Flint. Este artigo não recomenda uma nova biblioteca de gráficos: usamos o Flint-interactive como estudo de caso para discutir como criar especificações de alto nível para a saída dos agentes, reduzindo a necessidade de escrever código de renderização de baixo nível.
O que você vai aprender: ao fim da leitura, você entenderá os gargalos de custo e confiabilidade na geração de gráficos interativos por agentes, conhecerá a ideia de “deixar a lógica visual com o compilador e descrever a lógica de interação com eventos semânticos” e saberá em quais cenários usar cada uma das três formas de integração: na conversa, na aplicação ou com interações personalizadas.
Por que é caro deixar o agente escrever código de interação sem o Flint-interactive
Deixar o agente escrever diretamente o código de gráficos interativos parece a opção mais flexível. Mas o blog da pesquisa aponta que, mesmo com modelos de ponta muito capazes, ainda existem dois gargalos evidentes na prática.
O primeiro é o alto custo de geração. É raro que o agente entregue um gráfico interativo satisfatório em uma única rodada. Normalmente, são necessárias várias rodadas de raciocínio, programação e depuração, e cada uma consome tokens e tempo. O segundo é a baixa confiabilidade. Visualizações interativas já são complexas por natureza: gráficos com interações expressivas podem apresentar problemas de layout ou interações que não funcionam. Além disso, corrigir esses problemas pode introduzir novos bugs.
Então, será que basta usar as interações nativas das bibliotecas de gráficos? Segundo o blog, os recursos integrados de algumas bibliotecas de visualização não são expressivos o suficiente, o que dificulta a criação de gráficos interativos personalizados. No fundo, o que falta é uma linguagem para descrever interações que seja “expressiva e, ao mesmo tempo, suficientemente de alto nível”.
| Abordagem | O que o agente precisa gerar | Principal problema | Adequação |
|---|---|---|---|
| Escrever código de renderização de baixo nível diretamente | Escuta de eventos, detecção de acertos e lógica de redesenho | Várias rodadas de depuração, alto consumo de tokens e risco de introduzir novos bugs | Máxima expressividade, baixa estabilidade |
| Usar apenas as interações nativas da biblioteca de gráficos | Ativar ou desativar algumas opções de configuração | Tipos de interação limitados e difícil personalização | Estável, mas pouco expressiva |
| Especificação Flint-interactive | Mapeamento de eventos semânticos para operações de atualização | Exige aprender um novo sistema de especificação | Equilibra expressividade e confiabilidade |
Se você precisa alternar frequentemente os modelos por trás do seu agente para executar tarefas de geração com várias rodadas, pode acessar diversos modelos populares pela interface unificada da APIYI apiyi.com. Com o mesmo código de invocação, você consegue comparar o número de rodadas e o consumo de diferentes modelos e entender quanto custa, no seu cenário, seguir pelo caminho de “escrever código de baixo nível”.
Pontos principais do Flint-interactive
| Ponto | Descrição | Valor para desenvolvedores |
|---|---|---|
| Eventos semânticos | O compilador interpreta ações brutas, como cliques, arrastes e teclas pressionadas, para determinar quais elementos e dados do gráfico foram selecionados | O agent não precisa lidar com coordenadas de pixels nem com detecção de acertos |
| Operações de atualização | Operações de alto nível, como set-style, set-annotation e set-viewport, descrevem as mudanças na tela | Não é necessário manipular marcações gráficas específicas do renderizador |
| Máquina de estados do Flint Canvas | Acompanha as interações do usuário na tela e gerencia o estado de renderização | O framework gerencia a execução, reduzindo inconsistências de estado |
| Composição | Tanto a geração de eventos quanto as atualizações visuais são combináveis e podem ser conectadas a tabelas, textos e componentes | Permite criar narrativas de dados e dashboards interativos |
Eventos semânticos: o Flint-interactive só se importa com “quais dados o usuário selecionou”
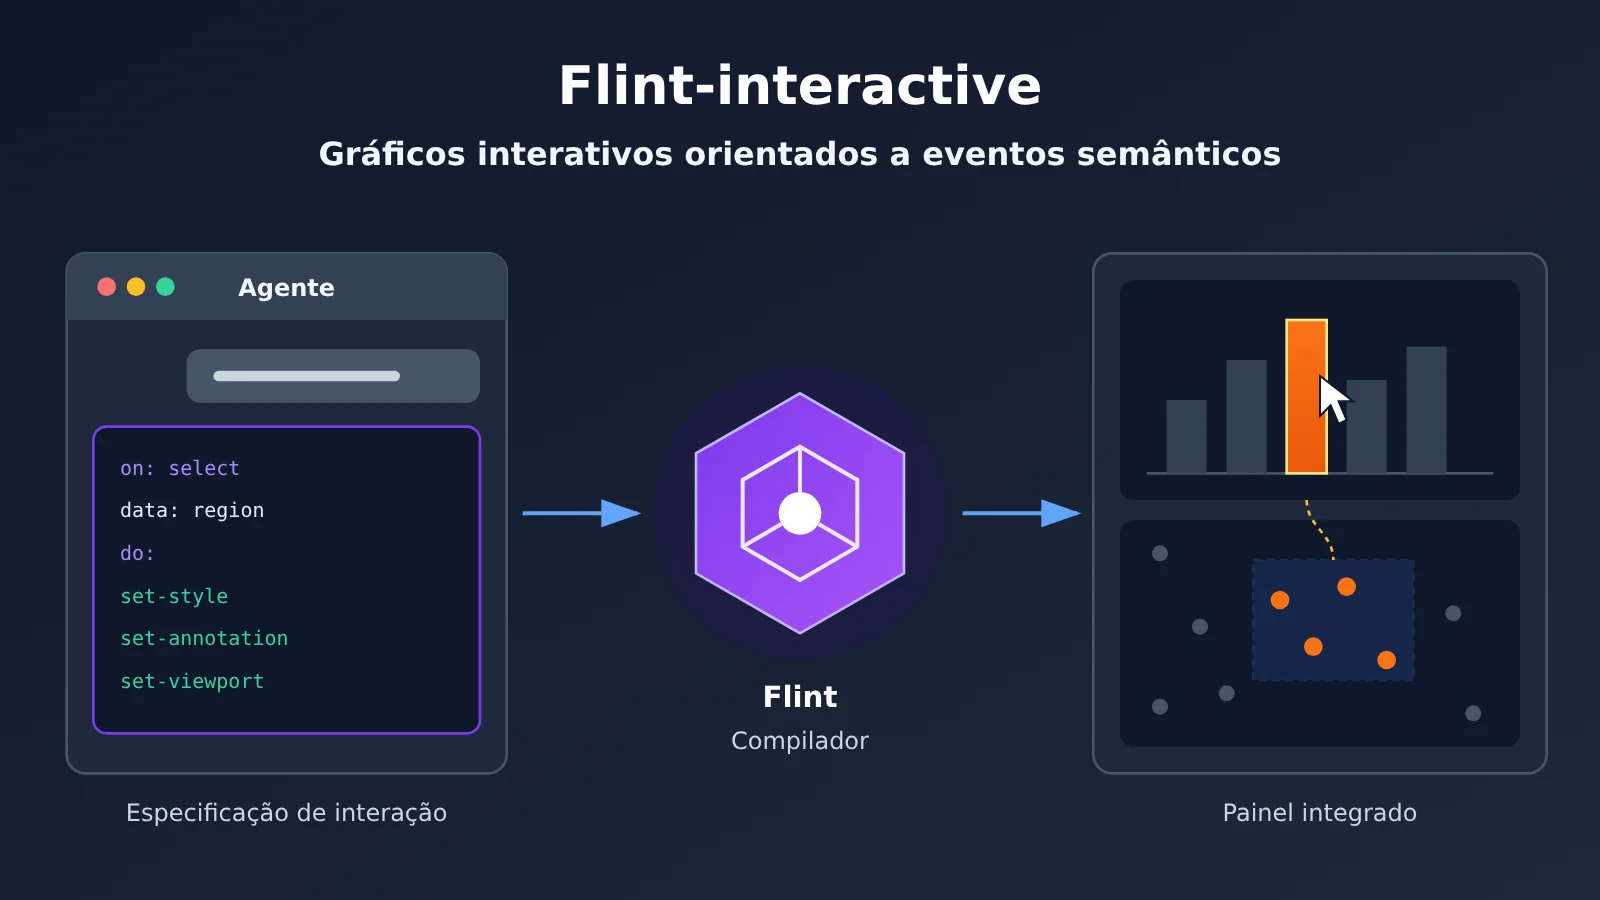
Eventos semânticos são o conceito central do Flint-interactive. Na abordagem tradicional, o agent precisa lidar com informações como “o mouse foi pressionado na coordenada (x, y) e arrastado até outro ponto” e calcular quais pontos de dados estão naquela área. No Flint, o compilador faz isso e produz diretamente um evento com significado, como “o usuário selecionou estes grupos de países com uma caixa”.
É parecido com a diferença entre “eventos nativos do DOM” e “eventos de negócio” no desenvolvimento frontend. Ao escrever a lógica de negócio, você não precisa se preocupar com as coordenadas de um mousedown, mas sim com algo como “o usuário selecionou o pedido A”. Os eventos semânticos fazem a mesma abstração para visualizações, com a correção dessa camada garantida pelo compilador.
Operações de atualização: o Flint-interactive troca o redesenho imperativo por resultados declarativos
Depois de receber um evento semântico, a lógica de interação só precisa responder a uma pergunta: como a tela deve ficar? Entre as operações de atualização listadas no blog estão set style para destacar dados, set annotation para adicionar um rótulo a um ponto e set viewport para deslocar ou ampliar a visualização.
É uma relação parecida com a de SQL e loops escritos à mão. Em SQL, você descreve “qual resultado quer” e o banco de dados decide como executá-lo. Nas interações do Flint, você descreve “quais dados devem ser destacados” e o compilador transforma isso em mudanças concretas na tela, incluindo a detecção de acertos e as atualizações visuais de baixo nível.
Máquina de estados: o Flint Canvas gerencia a execução das interações
O Flint Canvas é, essencialmente, uma máquina de estados que acompanha continuamente as interações do usuário na tela e gerencia o estado de renderização. Para o agent, isso significa que ele não precisa manter por conta própria estados intermediários propensos a erros, como “o que está selecionado agora” ou “se o destaque anterior já foi removido”.
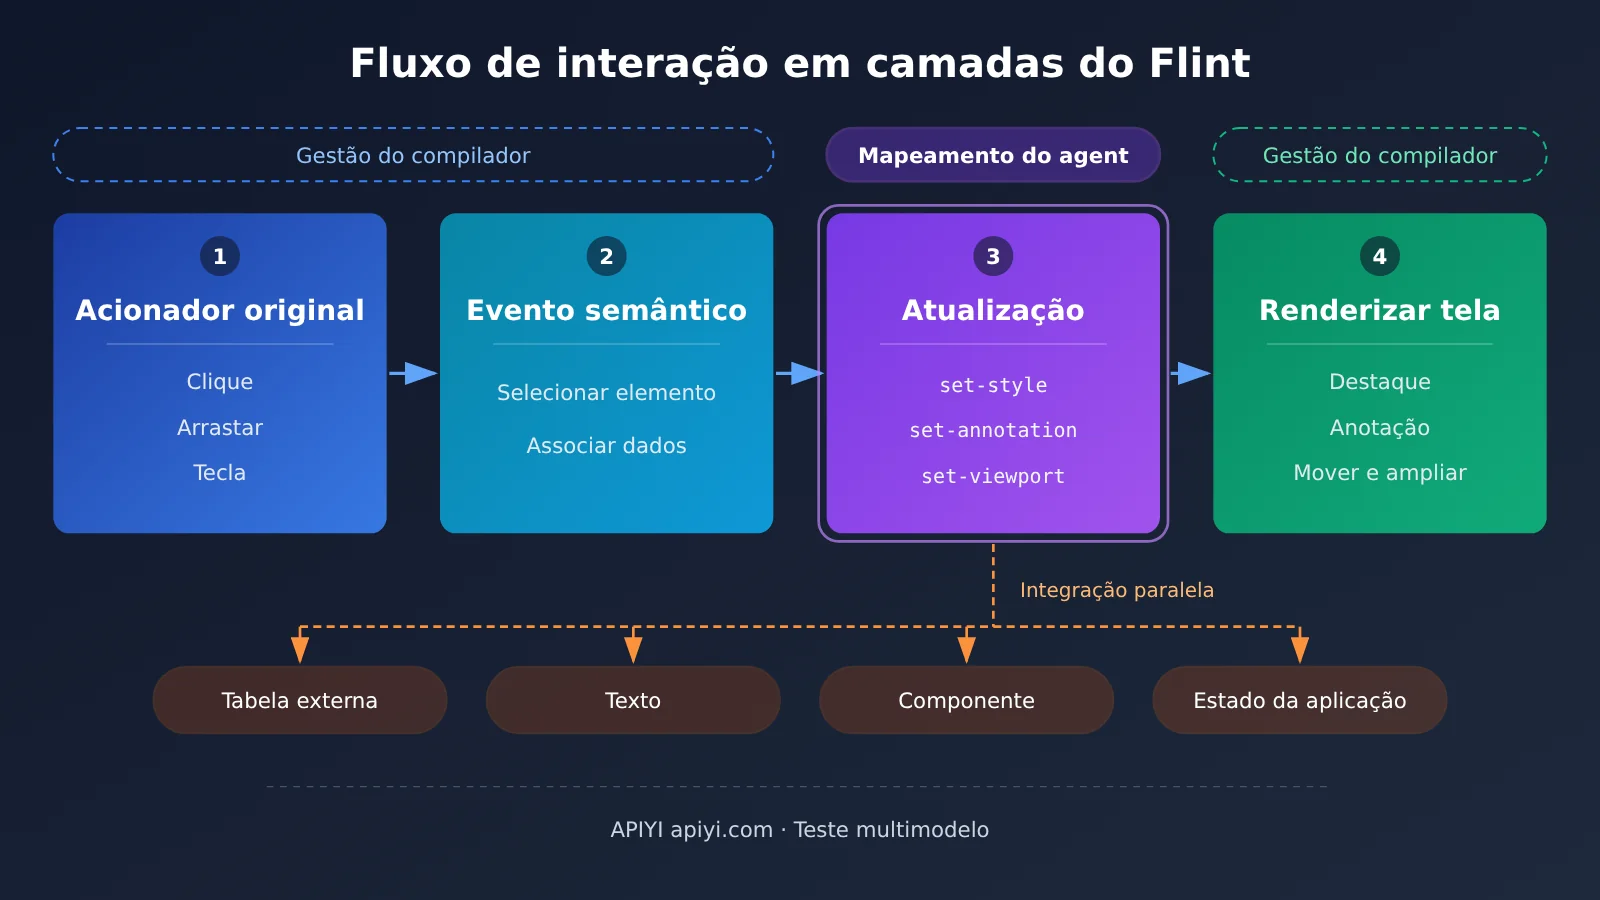
A imagem acima mostra a divisão central apresentada no blog: o compilador gerencia a lógica visual, enquanto o usuário descreve a lógica de interação no nível semântico. O agent cuida apenas da camada intermediária, que mapeia “qual evento corresponde a qual atualização”, deixando as duas pontas, mais propensas a erros, para o framework.
O princípio aplicável além do Flint-interactive: projetar especificações de saída de alto nível para agentes
Além do Flint-interactive, o que mais vale aproveitar neste caso é a decisão de engenharia por trás dele: não peça ao agente para produzir a camada em que ele tem mais chances de errar. O código de renderização de baixo nível tem dependências complexas e um ciclo de feedback longo. Por isso, deixar o agente tentando acertar nessa camada acaba saindo caro.
Por outro ângulo, o Flint transforma um problema aberto de programação em um problema de “mapear opções dentro de um vocabulário limitado”. O espaço de saída do agente fica menor, a estrutura se torna mais uniforme e a validação fica mais fácil. A mesma ideia também se aplica a cenários como orquestração de fluxos de trabalho, geração de formulários e formatação de relatórios.
| Critério | Adequado para saída do agente | Adequado para o compilador ou o runtime |
|---|---|---|
| Expressa uma intenção de negócio? | Sim, como “destacar o mesmo grupo após selecionar um país” | Não, como converter coordenadas de pixels |
| Depende de muitos estados implícitos? | Depende de poucos; um único mapeamento basta para descrevê-lo | Depende de muitos e exige acompanhamento contínuo |
| É fácil identificar a origem de um erro? | A especificação tem uma estrutura clara e é fácil de validar | Os detalhes de renderização ficam dispersos e são difíceis de investigar |
| É reutilizável? | Pode ser incorporado a uma configuração predefinida, como linked-brush | É infraestrutura genérica, implementada uma única vez |
Ao projetar o formato de saída do seu agente, você pode usar essa tabela como checklist. Se uma camada expressa intenções, tem poucas dependências de estado e é fácil de validar, ela é adequada para o agente. Caso contrário, deve ficar a cargo de código determinístico ou de um compilador.
Vale destacar que o blog de pesquisa não apresentou dados quantitativos sobre redução no consumo de tokens ou aumento da taxa de sucesso. Portanto, em vez de simplesmente presumir que esse princípio trará benefícios, teste-o nas suas próprias tarefas.
Guia rápido do Flint-interactive: 3 formas de integração
O blog apresenta três caminhos, voltados a usuários de gráficos, desenvolvedores de aplicações e designers de interação. Vamos conhecê-los em ordem crescente de complexidade.
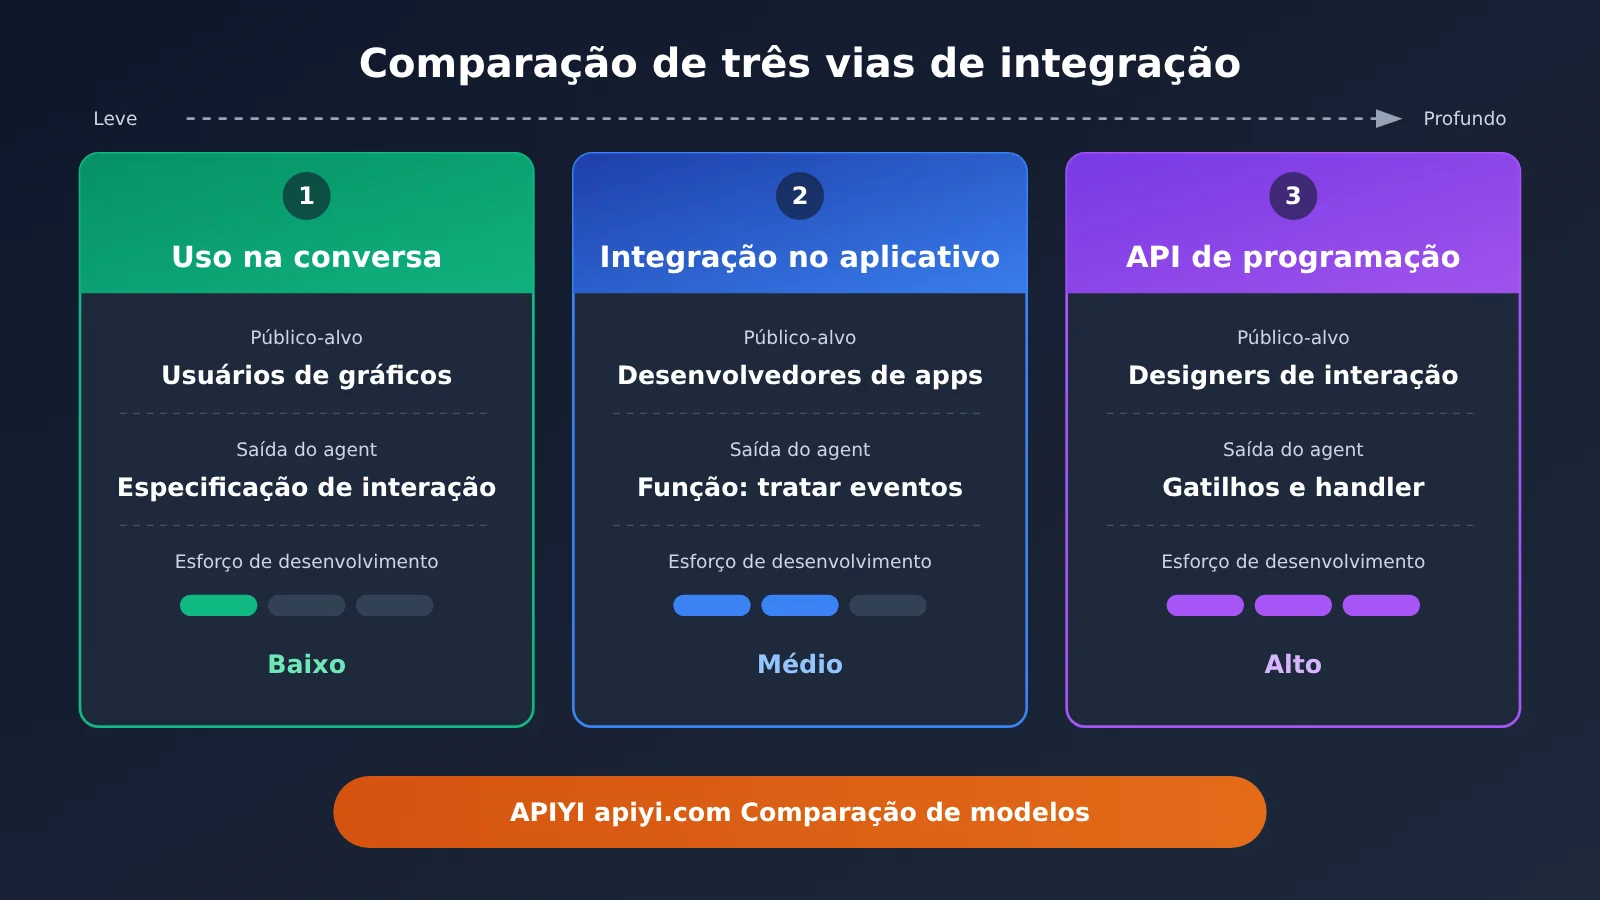
| Caminho de integração | Público-alvo | O que o agente ou a aplicação produz | Cenário típico |
|---|---|---|---|
| Uso na conversa (Flint-MCP + MCP Apps) | Usuários de gráficos | Especificação do gráfico Flint + interaction_spec |
Explorar dados no chat e usar a seleção em perguntas posteriores |
| Integração à aplicação (Flint Interactive Canvas) | Desenvolvedores de aplicações | Funções de tratamento de eventos semânticos + operações de atualização enviadas ao Canvas | Dashboards, histórias com dados e interação entre gráficos e tabelas |
| Interações personalizadas (API de programação) | Designers de interação | Gatilho trigger + função handle personalizada | Interações sob medida além das predefinidas, como DimpVis |
Caminho 1: usar o Flint-interactive em uma conversa (MCP)
Essa é a opção mais simples. Com o Flint-MCP e o MCP Apps, é possível usar o Flint Interactive diretamente em um ambiente de chat ou canvas. Para configurá-lo, siga o guia oficial de configuração do MCP. Depois da integração, o fluxo é mais ou menos assim:
- Siga o guia oficial de configuração do MCP para integrar o Flint-MCP a um ambiente de chat ou canvas compatível com MCP Apps;
- Diga ao agente qual gráfico criar e quais interações você quer, por exemplo: “permitir a seleção por área e destacar os países do mesmo grupo”;
- Além da especificação do gráfico Flint, o agente gera um
interaction_spece renderiza um gráfico interativo na conversa; - Faça uma seleção no gráfico: o conteúdo selecionado pode ser passado como contexto para as próximas mensagens.
O passo 4 é especialmente útil. Depois de selecionar uma região com dados atípicos, o usuário pode perguntar diretamente “por que esses pontos estão mais altos?”. O agente recebe o resultado estruturado da seleção, em vez de uma descrição vaga em texto.
Caminho dois: integrar o Flint-interactive Canvas a um aplicativo
Para usar o Flint Interactive Canvas em seu próprio dashboard ou narrativa de dados, vale entender o fluxo de dados nos dois sentidos:
- Gráfico → aplicativo: o Flint Canvas emite eventos semânticos que seu aplicativo recebe por meio de funções de tratamento. Eles podem ser usados para filtrar uma tabela, atualizar outro gráfico ou alterar o estado do aplicativo;
- Aplicativo → gráfico: quando um componente do aplicativo precisa controlar mudanças no gráfico, basta enviar operações de atualização ao Flint Canvas.
O exemplo do blog mostra essa interação nos dois sentidos entre gráfico e tabela: clicar em uma linha da tabela destaca o ponto correspondente no gráfico, e vice-versa. Para produtos de relatórios, essa é a base da experiência de interação entre gráficos e texto. O blog também menciona que você pode compartilhar a skill interaction-author com seu agente de programação para que ele ajude a adicionar interações predefinidas ao aplicativo.
Caminho três: criar interações personalizadas no Flint-interactive com a API de programação
Quando as interações predefinidas, como a seleção vinculada por área do linked-brush, não forem suficientes, você pode usar a API de programação para definir um gatilho (trigger) e uma função handle personalizada, mapeando eventos semânticos para uma sequência de atualizações personalizadas no gráfico.
No exemplo do blog, ao clicar em um país, ele é destacado e recebe um rótulo com seu nome. Esse handler combina as operações set-style e set-annotation, sem precisar manipular marcadores gráficos específicos do renderizador. Em um exemplo mais complexo com DimpVis, o usuário pode arrastar um ponto ao longo de uma trajetória temporal para observar como mudam a temperatura e a precipitação em todas as cidades.
🚀 Dica para começar: use primeiro o caminho um para verificar na conversa se seus dados são adequados para interações. Depois, decida se vale investir no caminho dois ou três. Você pode acessar os modelos que alimentam o agente de forma unificada pela APIYI apiyi.com e alternar entre alguns dos principais modelos no mesmo código para ver qual gera um
interaction_specválido com mais consistência.
Avalie a confiabilidade de agentes na geração de especificações Flint-interactive
O blog não informa quais modelos ou agentes geram especificações Flint com mais qualidade. Por isso, vale criar um processo simples de avaliação antes de colocar a solução em produção. Considere os seguintes indicadores:
| Indicador | Como avaliar | O que mostra |
|---|---|---|
| Taxa de sucesso na primeira tentativa | Calcule a proporção de resultados que são renderizados corretamente e permitem interação já na primeira tentativa | Reflete diretamente o custo de geração |
| Média de rodadas de correção | Registre quantas rodadas de conversa são necessárias entre a primeira geração e um resultado utilizável | Indica o consumo de tokens e de tempo |
| Aderência à intenção de interação | Verifique manualmente se o comportamento das interações corresponde aos requisitos | Uma especificação válida não significa que a intenção foi atendida |
| Estabilidade contra regressões | Verifique se as demais interações continuam funcionando após uma alteração em uma delas | Aborda o problema de confiabilidade mencionado no blog |
Uma boa ideia é preparar um conjunto fixo de requisitos de interação para os testes e usar o mesmo comando para comparar duas abordagens: “escrever diretamente o código de renderização” e “gerar uma especificação Flint”. Com uma interface de agregação de modelos como a APIYI, você pode comparar vários modelos em um único script, sem precisar integrar o SDK de cada fornecedor separadamente.
Perguntas frequentes FAQ
Q1: O que é Flint-interactive?
Flint-interactive é uma linguagem de visualização interativa de dados lançada pela Microsoft Research com base no Flint. Ela usa um compilador para transformar as interações do usuário em eventos semânticos e, em seguida, modifica os gráficos por meio de operações de atualização de alto nível. Assim, usuários e agentes podem descrever interações como cliques, filtros, zoom, destaque e integração entre gráficos usando especificações concisas.
Q2: Qual é a diferença entre Flint-interactive e deixar um agente escrever diretamente o código de interação dos gráficos?
Ao escrever o código diretamente, o agente precisa lidar com eventos, detecção de elementos e redesenho ao mesmo tempo. Isso oferece mais flexibilidade, mas torna a depuração em várias rodadas mais trabalhosa e aumenta a chance de erros. Com Flint-interactive, a lógica visual fica a cargo do compilador, e o agente apenas descreve “qual atualização corresponde a cada evento semântico”. O resultado é mais curto e tem uma estrutura mais fácil de validar.
Q3: Quando Flint-interactive foi lançado?
O blog da Microsoft Research publicou essa pesquisa em 22 de outubro de 2026. Trata-se de um resultado recente. As fontes não especificam a licença de código aberto, a maturidade nem a disponibilidade para produção. Antes de usá-lo em um projeto oficial, vale consultar as informações mais recentes no repositório oficial.
Q4: Para quais aplicações Flint-interactive é mais indicado?
– **Análise de dados conversacional**: selecionar pontos de dados em uma área no chat e usar o resultado em perguntas posteriores;
– **Relatórios e dashboards**: conectar vários gráficos e clicar em um deles para filtrar uma tabela de detalhes;
– **Narrativas com dados**: destacar elementos em gráficos e trechos do texto de forma bidirecional, como nas narrativas interativas do jornalismo de dados.
Q5: Como preparar a invocação do modelo ao criar um agente que usa Flint-interactive?
Flint resolve a questão de “o que gerar”, mas o modelo ainda precisa ser integrado separadamente. Uma opção prática é acessar vários modelos populares pela APIYI, em apiyi.com, e testar o mesmo conjunto de requisitos de interação por uma interface unificada. Assim, você pode comparar a taxa de especificações utilizáveis na primeira tentativa e o número de rodadas de correção de cada modelo antes de escolher qual usar em produção.
Q6: Como uma pessoa responsável pelo produto pode decidir se a equipe deve adotar Flint-interactive?
Comece respondendo a duas perguntas: seus usuários realmente precisam explorar os gráficos? E a taxa de retrabalho dos gráficos interativos gerados atualmente pelo agente é alta? Se ambas as respostas forem sim, vale fazer uma validação em pequena escala usando o caminho 1. Durante os testes, a plataforma APIYI permite alternar rapidamente entre modelos e manter os custos de validação baixos.
Q7: Quais são as limitações conhecidas ou os pontos ainda não confirmados de Flint-interactive?
– **Falta de dados quantitativos**: o blog não divulgou números específicos sobre economia de tokens ou aumento da taxa de sucesso;
– **Compatibilidade com modelos desconhecida**: não há indicação de quais modelos geram especificações Flint com melhores resultados;
– **Vocabulário de interações limitado**: interações fora das opções predefinidas precisam ser implementadas por conta própria usando a API de programação. A equipe oficial incentiva o envio de novas opções predefinidas no GitHub para ampliar esse vocabulário.
Flint-interactive: principais pontos
- Origem do custo: quando o agente escreve diretamente o código de interação, são necessárias várias rodadas de depuração, com alto consumo de tokens e risco de introduzir novos bugs nas correções;
- Eventos semânticos: o compilador traduz ações brutas, como cliques e arrastos, em informações como “quais dados foram selecionados”;
- Operações de atualização: use set-style, set-annotation e set-viewport para declarar mudanças na visualização, sem mexer na renderização de baixo nível;
- Separação de responsabilidades: o compilador cuida da lógica visual, a lógica de interação é descrita na camada semântica e o ambiente de execução gerencia a máquina de estados do Canvas;
- Três caminhos: MCP em conversas, Canvas em aplicações e API de programação para interações personalizadas;
- Princípio aplicável a outros projetos: defina especificações de saída de alto nível para o agente e delegue a camada mais propensa a erros a um sistema determinístico;
- Validação prática: use a interface unificada da APIYI para comparar vários modelos e testar a estabilidade da geração de especificações.
Resumo
A abordagem de eventos semânticos do Flint-interactive pode ser resumida em três pontos:
- Identificação precisa do problema: a dificuldade de gerar gráficos interativos não está na falta de capacidade do modelo, mas na ausência de uma linguagem de interação que seja expressiva e, ao mesmo tempo, suficientemente abstrata;
- Divisão clara de responsabilidades: o compilador interpreta eventos e atualiza a visualização; o agente apenas descreve o mapeamento de “evento → atualização”;
- Formas de integração em camadas: da experimentação em conversas à integração em aplicações e à criação de interações personalizadas, é possível avançar conforme a necessidade.
Para equipes que desenvolvem agentes de relatórios ou análise de dados, mesmo que não usem o Flint por enquanto, vale aproveitar seus princípios de design para repensar o formato de saída dos próprios agentes.
Na hora de testar, uma opção é usar a APIYI, em apiyi.com, para acessar vários modelos populares por uma interface unificada. Assim, você pode comparar os resultados gerados para o mesmo conjunto de requisitos de interação e encontrar mais rapidamente a combinação de modelo e especificação adequada ao seu negócio.
📚 Referências
- Microsoft Research Blog – Flint-interactive: blog oficial de pesquisa sobre o Flint-interactive
- Link:
microsoft.com/en-us/research/blog/flint-interactive-a-language-for-creating-interactive-data-visualizations - Descrição: apresenta eventos semânticos, operações de atualização, a máquina de estados do Canvas e as três formas de uso: MCP, Canvas e API de programação. O blog também inclui links para o guia de configuração do MCP, a biblioteca de exemplos interativos e a API de programação.
Autor: equipe técnica da APIYI
Troca de experiências técnicas: acesse APIYI em apiyi.com para conversar conosco sobre experiências práticas com agentes e integração de múltiplos modelos. Para mais informações, consulte a central de documentação em docs.apiyi.com.