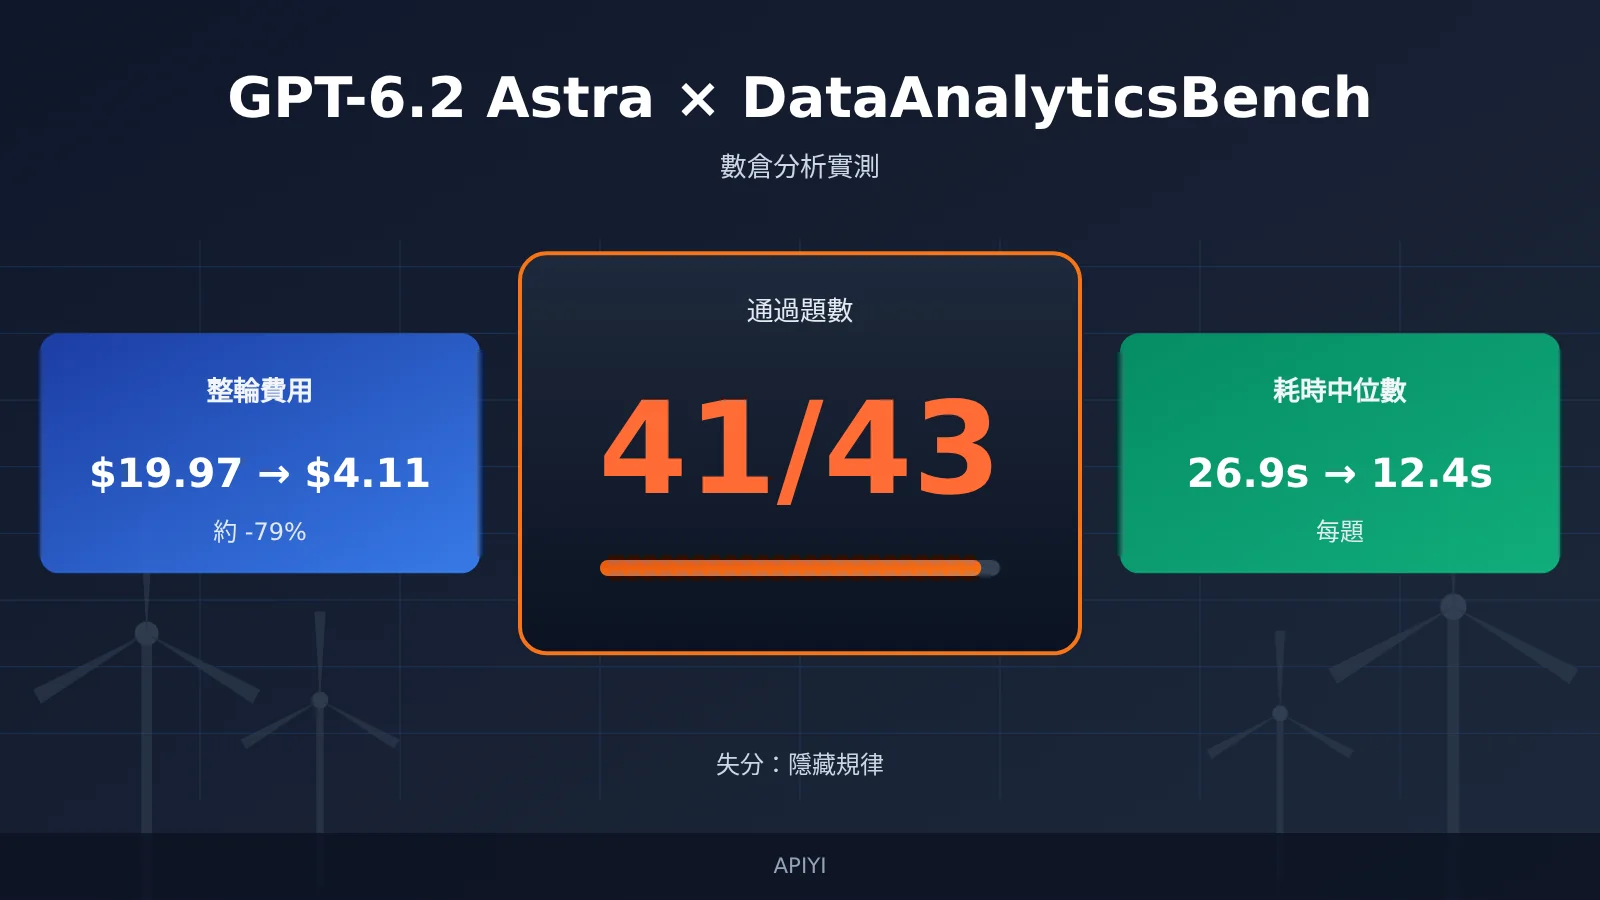
核心結論:在 Plotly 的 DataAnalyticsBench 實測中,GPT-6.2 Astra 的 43 道數據分析題通過 41 道。前代 GPT-6 Astra 的成績是 43/43。兩道失分都出在“隱藏規律”這一類題,其餘五類題全部通過。與此同時,整輪費用從 $19.97 降到 $4.11,每題耗時中位數從 26.9 秒縮短到 12.4 秒。新一代 Astra 用兩道題的代價換來了不到前代四分之一的花費和不到一半的等待時間,但它在主動追查異常方面是否真的退步,目前只有一輪數據,還需要用自己的數據複測。
您讀完此文能瞭解到什麼?
- DataAnalyticsBench 測什麼、怎麼判分,41/43 這個分數的邊界在哪裏。
- 六類題的逐項得分,以及兩道失分題分別是怎麼失敗的。
- 費用下降約 79% 的兩個來源:費率下調和工作量減少,各自貢獻多少。
- GPT-6.2 Astra 與 GPT-6 Astra、GPT-6.1 Sol、GPT-6.2 Sol 在得分、費用、延遲上的取捨。
- 一套可直接改造的複測方法和 Python 代碼,用來在自己的數倉上驗證結論。
索引:To Know 表格解釋評測裏的專有概念,影響速覽按人羣概括這條新聞的意義。“客觀事實”部分依次交代測試環境與判分規則、六類題得分、費用與耗時數據,以及 OpenAI 官方的模型身份和價格口徑。“分析判斷”部分解讀 41/43 的含義,提出隱藏規律題失分的解釋假設,拆解費用下降的來源,並給出選型建議和複測代碼。
GPT-6.2 Astra DataAnalyticsBench 需要先知道的概念
| 概念 | 簡要解釋 |
|---|---|
| DataAnalyticsBench | Plotly 與 Mila 研究者設計的 43 道數倉分析題,在模擬風電運營數據上考查模型的分析能力 |
| 測試運行環境 | 爲每個模型提供相同數倉,以及查詢、畫圖、展示表格等只讀工具的測評系統 |
| 評分規則 | 逐題規定什麼樣的回答算充分滿足題意,只判通過或不通過,不給部分分 |
| 數據質量問題 | 缺失、重複、異常記錄等會影響分析結論的輸入問題,題中有刻意植入 |
| 統計陷阱 | 直觀算法或彙總方式可能把人引向錯誤結論的題目 |
| 隱藏規律 | 題乾沒有點明、需要模型主動追查的異常模式或原因 |
| 每題耗時中位數 | 把 43 道題的實際經過時間排序後取中間值,本榜包含工具查詢耗時 |
| 整輪費用 | 同一模型完成全部 43 道題的累計調用費用 |
| 緩存命中 | 重複的輸入前綴被服務端緩存後,以更低單價計費的那部分輸入 token |
GPT-6.2 Astra DataAnalyticsBench 評分對不同人羣的影響速覽
- API 選型者:GPT-6.2 Astra 的單位成本和響應速度明顯改善,常規報表、口徑澄清這類任務可以優先考慮。異常排查類任務暫時不宜直接照搬榜單結論。
- 數據產品開發者:做“自然語言問數”、BI 助手這類產品時,延遲中位數減半對交互體驗影響很大。不過要單獨評估模型在多輪探索上的“耐心”,必要時在提示詞或工作流裏強制追加檢查步驟。
- 分析團隊:可以把模型當成更快的初稿分析員,但根因調查類結論仍需要人工複覈。用 API易 apiyi.com 這類 OpenAI 兼容的聚合接口,可以在同一套代碼裏切換四個模型做對照測試。
GPT-6.2 Astra DataAnalyticsBench 客觀事實
GPT-6.2 Astra 測試場景與判分規則
DataAnalyticsBench 由 Plotly 與 Mila 研究者設計,使用一個模擬的風電運營數倉。數倉包含 44 張表、約 1,990 萬行和 554 列,涵蓋設備遙測、告警、工單、檢查和天氣等數據。每道題在 Plotly Studio Embedded 中運行,經 OpenRouter 調用模型。模型能用的工具只有四種只讀工具:列出數據集、執行 SQL、畫圖、展示表格。
模型自行決定查詢路徑和作答時機,測試方不會替它規劃步驟。這意味着評測考的不只是寫 SQL,還包括“查到哪一步纔夠”的判斷。
判分方面,評測逐題按答案鍵和評分規則判定是否通過,沒有部分分。裁判模型爲 Claude Sonnet 5,溫度設爲 0。主辦方用 SQL、pandas 和 Polars 三種方式獨立生成答案並交叉校驗,人工審覈失敗軌跡,也審查滿分結果。兩類特殊題有明確的過關條件:
- 歧義題:模型通過澄清,或者交代假設並給出替代解法,即可過關。
- 數據不可回答的題:準確指出現有數據的限制即可過關。
題庫也有明確邊界:單一業務域(風電運營)、英文、同一測試環境,每個模型只跑一輪。題目、數據和答案鍵由主辦方保留,不對外公開。
來源:Plotly,Introducing DataAnalyticsBench,2026-10-14 發佈,2026-11-19 更新,plotly.com/blog/introducing-dataanalyticsbench/
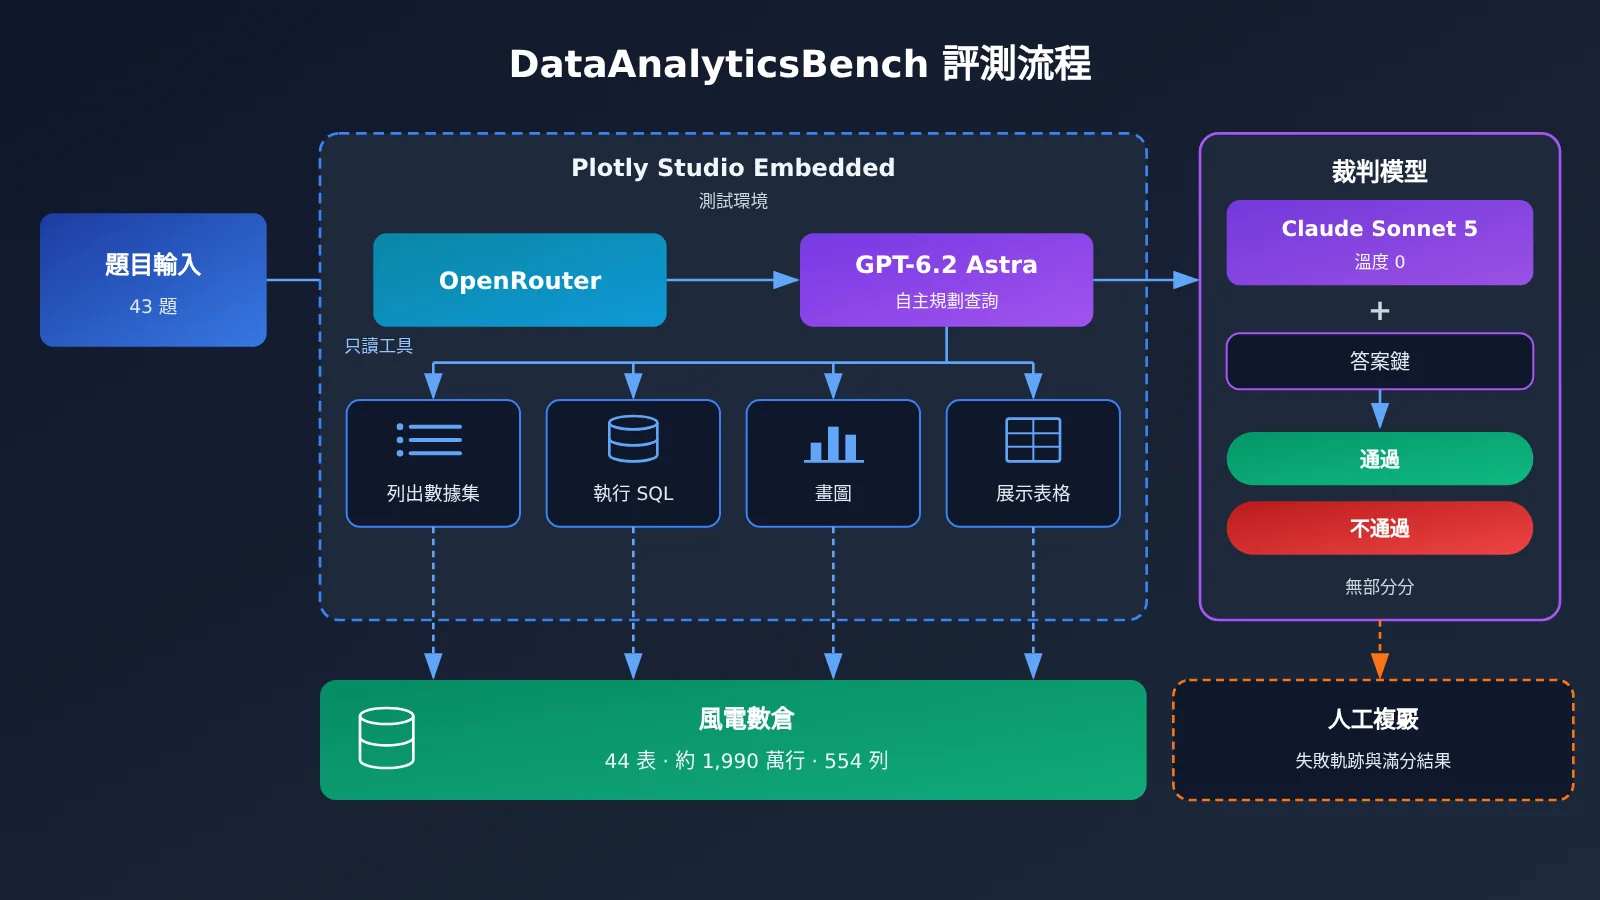
圖示說明:這套“模型自主規劃查詢 + 只讀工具 + 逐題判通過”的結構,可以在自己的環境裏用 API易 apiyi.com 的 OpenAI 兼容接口近似復現,做內部對照測試。
GPT-6.2 Astra 六類題得分:失分集中在隱藏規律
Plotly 在 2026 年 11 月 17 日發佈的 Astra 專項報告給出了分類得分:
| 題類 | GPT-6.2 Astra | GPT-6 Astra | 考查點 |
|---|---|---|---|
| 常規分析 | 20/20 | 20/20 | 多步 SQL、表連接和時間區間 |
| 歧義判斷 | 5/5 | 5/5 | 澄清口徑或說明合理假設 |
| 數據不可回答 | 5/5 | 5/5 | 依據現有數據識別不可回答的問題 |
| 數據質量 | 3/3 | 3/3 | 識別植入的質量問題 |
| 統計陷阱 | 5/5 | 5/5 | 識別直觀算法可能造成的誤導 |
| 隱藏規律 | 3/5 | 5/5 | 主動追查沒有點明的異常規律 |
| 總計 | 41/43 | 43/43 | 各題等權,逐題判通過 |
前五類題合計 38/38,兩代表現完全一致。差距全部來自隱藏規律題:新一代 3/5,前代 5/5。
兩道失分題都經過 Plotly 人工複覈,失敗方式不同:
- 一道題中,模型始終沒有定位到植入的規律。
- 另一道題中,模型找到了應該調查的位置,卻把真正的原因排除了。
報告還給出一個過程數據:在隱藏規律題上,GPT-6.2 Astra 平均每題執行約 9 次數據庫查詢,GPT-6 Astra 約 15 次。
來源:Plotly,GPT-6.2 Astra Benchmark Results for Data Analysis,2026-11-17,plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/
GPT-6.2 Astra 費用與耗時:兩代與同廠對照
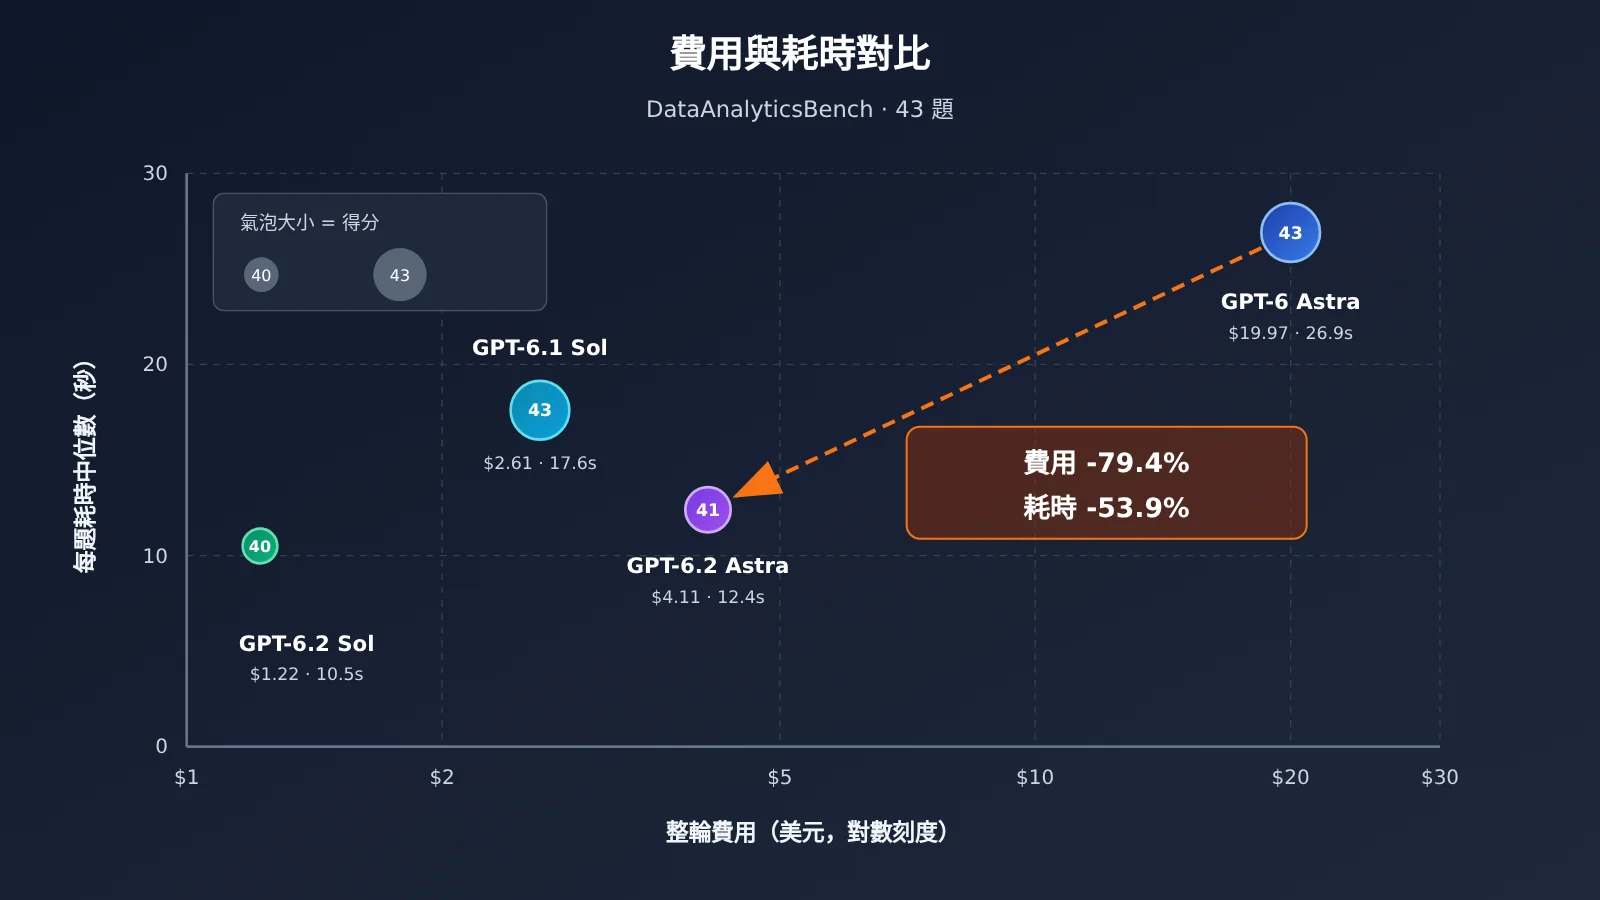
| 模型 | 得分 | 整輪費用 | 每題耗時中位數 |
|---|---|---|---|
| GPT-6.2 Astra | 41/43 | $4.11 | 12.4 秒 |
| GPT-6 Astra | 43/43 | $19.97 | 26.9 秒 |
| GPT-6.1 Sol | 43/43 | $2.61 | 17.6 秒 |
| GPT-6.2 Sol | 40/43 | $1.22 | 10.5 秒 |
按原表計算,GPT-6.2 Astra 相比前代整輪費用下降約 79.4%,每題耗時中位數縮短約 53.9%。作者實測中,6.2 Astra 整輪約 13 分鐘,前代約 32 分鐘。這裏的耗時是包含工具查詢在內的實際經過時間,不是純模型推理時間。
單題費用有兩種口徑,需要分開看:$4.11 ÷ 43 得到每題均攤約 $0.096;更新後的總榜則把 $0.066 標爲本輪單題費用的中位數。均攤值高於中位數,說明少數題目花費明顯偏高,拉高了平均值。
Plotly 還提供了兩代原輪的工作量明細:
| 工作量指標 | GPT-6 Astra(前代) | GPT-6.2 Astra |
|---|---|---|
| 工具調用次數 | 266 次 | 148 次 |
| 模型調用次數 | 249 次 | 171 次 |
| 輸入 token | 約 910 萬 | 約 440 萬 |
| 輸出 token | 約 7.8 萬 | 約 3.4 萬 |
| 輸入緩存命中佔比 | 93% | 98% |
Plotly 按新費率重算前代原樣的用量,估算約爲 $11。需要注意,這些費用來自 Plotly 測試當時的 OpenRouter 價格,不是 OpenAI 官方價目表的直接換算。
來源:Plotly Astra 專項報告 plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/;Plotly 總榜 plotly.com/blog/introducing-dataanalyticsbench/#full-results
GPT-6.2 Astra 模型身份與官方價格口徑
OpenAI 於 2026 年 11 月 17 日發佈 GPT-6.2 Astra 和 GPT-6.2 Sol。Astra 面向複雜推理、編碼和專業工作,API 模型 ID 爲 gpt-6.2-astra。OpenAI 發佈公告中的評測屬於廠商口徑,Plotly 的 DataAnalyticsBench 是另一套第三方評測,兩者不能混在一起比較。
按模型卡,Astra 接受文本和圖像輸入、輸出文本,上下文爲 1,050,000 token,最大輸入 922,000 token,最大輸出 128,000 token。它同時支持 Responses API 和 Chat Completions API,內置工具、Multi-agent 和後臺完成窗口等能力以 Responses API 爲準。模型卡還說明,reasoning.effort 設爲 none 的請求會被拒絕。
OpenAI 標準短上下文純文本價格(每百萬 token)爲:普通輸入 $8,緩存命中輸入 $0.40,輸出 $40。官方稱,相比前代,普通輸入和輸出單價降低 20%,緩存命中輸入單價降低 60%。
來源:OpenAI 發佈公告 openai.com/index/introducing-gpt-6-2-astra-sol/;模型卡 developers.openai.com/api/docs/models/gpt-6.2-astra;API 更新日誌 developers.openai.com/api/docs/changelog;價格表 developers.openai.com/api/docs/pricing
GPT-6.2 Astra DataAnalyticsBench 分析判斷
41/43 該怎麼讀:不是“整體變弱”
把 41/43 拆開看,GPT-6.2 Astra 在常規分析、歧義、不可回答、數據質量和統計陷阱五類題上沒有丟分。這五類題覆蓋了日常報表和口徑覈對的大部分場景。如果業務主要是這類問題,從這輪數據看,新一代 Astra 的質量與前代相當,成本和速度卻明顯更好。
兩題差距還需要放到波動範圍裏看。Plotly 報告稱,對其他模型復跑時曾出現最多三題的波動。因此,41 對 43 更適合當作“這一輪的觀察值”,而不是穩定的能力差。比較準確的說法是:隱藏規律這一類出現了值得追蹤的信號,但單輪數據還不足以確認存在退化。
隱藏規律題爲何值得複測:探索深度的解釋假設
以下是基於報告數據的解釋假設,並非 Plotly 的結論。隱藏規律題上,新一代平均每題約 9 次查詢,前代約 15 次;兩道失分題的表現,一個是“沒找到”,一個是“找到了位置但排除了真因”。兩者都像是“查得不夠深就收手”:前者探索範圍不夠,後者在驗證階段過早下了否定結論。
這和費用、延遲下降可能來自同一種行爲變化,即模型更傾向於少查幾次就作答。在常規題上,這種傾向直接轉化爲效率;在需要反覆假設、驗證的根因題上,則可能變成風險。要驗證這個假設,需要在自己的數據上對照查詢次數與通過率的關係,而不是隻看總分。
GPT-6.2 Astra 費用與速度爲何同步下降
$19.97 到 $4.11 的下降可以拆成兩段,基於 Plotly 的重算數據:
- 費率因素:前代原樣的用量按新費率重算約 $11,即單靠降價,費用大約從 $19.97 降到 $11,降幅約 45%。官方的緩存輸入單價降低 60%,在緩存命中率高達 93% 至 98% 的場景下,這部分作用尤其明顯。
- 工作量因素:從約 $11 到 $4.11,靠的是工作量減少。工具調用從 266 次降到 148 次,輸入 token 從約 910 萬減少到約 440 萬,輸出 token 減少一半以上,緩存命中佔比從 93% 提高到 98%。
用官方單價粗算新一代的用量,結果也與 $4.11 處在同一量級:約 440 萬輸入中 98% 走緩存價,其餘按普通輸入價,再加上約 3.4 萬輸出 token。這說明在數據分析這類長上下文、多輪工具調用的場景中,緩存命中率和調用輪數對成本的影響可能比單價本身更大。速度提升同理:查詢更少、模型調用更少,經過時間自然縮短。
💰 成本建議:評估這類 Agent 型任務的費用時,要記錄緩存命中 token 和工具調用輪數,不能只看單價表。通過 API易 apiyi.com 按量調用時,可以對照賬單與日誌中的 usage 字段,覈實緩存是否生效。
GPT-6.2 Astra 與 GPT-6.1 Sol、GPT-6.2 Sol 的取捨
四個模型的位置各不相同:
- GPT-6.1 Sol:在這套設置下以 $2.61 取得 43/43,是本輪“滿分裏最便宜”的選項,代價是耗時中位數 17.6 秒,慢於 6.2 Astra。
- GPT-6.2 Astra:41/43、$4.11、12.4 秒,優勢出現在得分和速度一起比較時。如果只看成本和得分,它並不佔優。
- GPT-6.2 Sol:$1.22、10.5 秒,最便宜也最快,但得分 40/43 最低。
- GPT-6 Astra:滿分,但費用和延遲都明顯偏高,在這組對照中已很難找到首選理由。
幾者之間的分差都在 Plotly 提到的最多三題波動範圍內。這意味着單看總分難以排出可靠的先後順序,真正可靠的區分維度是費用和延遲。實際選擇時,交互式問數產品對延遲敏感,可以優先比較 6.2 Astra 和 6.2 Sol;離線批量分析對延遲不敏感,6.1 Sol 的性價比更值得關注。
如何用自己的數據複測 GPT-6.2 Astra
以下複測方法屬於編輯建議。DataAnalyticsBench 只覆蓋風電運營、英文、單一環境,與多數團隊的真實數倉差異很大。比較穩妥的做法是用自有數據做一個小型題集,固定數據、工具和提示詞,多跑幾輪,分別統計不同類型任務的表現。
| 子集 | 建議題量 | 重點記錄 | 判斷用途 |
|---|---|---|---|
| 常規報表 | 15-20 題 | 通過率、中位延遲 | 日常問數能否放心交給模型 |
| 歧義口徑 | 5 題左右 | 是否主動澄清或說明假設 | 防止“默默選一個口徑” |
| 統計偏差 | 5 題左右 | 是否識別辛普森悖論等陷阱 | 結論可信度 |
| 異常根因 | 5-8 題 | 通過率、查詢次數、P90 延遲 | 驗證隱藏規律題的失分信號 |
| 全部題目 | — | 每輪總費用、緩存命中率 | 成本預算 |
每個模型建議至少跑 3 輪,記錄均值和波動。尾部延遲(P90)要單獨記錄:中位數好看不代表最慢的那幾題能接受。
下面是最簡調用示例,模型 ID 採用 OpenAI 公佈的 gpt-6.2-astra,可用模型以平臺列表爲準:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.2-astra",
    reasoning_effort="medium",  # 模型卡說明 effort 爲 none 的請求會被拒絕
    messages=[{"role": "user", "content": "上月各風場故障工單數環比變化最大的是哪個?請說明計算口徑。"}],
)
print(resp.choices[0].message.content)
查看完整複測腳本:按子集統計通過率、費用與 P50/P90 延遲
import time
import statistics
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODELS = ["gpt-6.2-astra", "gpt-6-astra", "gpt-6.1-sol", "gpt-6.2-sol"]

# 自建題集:category 對應複測表中的子集,checker 由你按答案鍵實現
TASKS = [
    {"id": "r01", "category": "常規報表", "prompt": "...", "checker": lambda a: "..." in a},
    {"id": "h01", "category": "異常根因", "prompt": "...", "checker": lambda a: "..." in a},
]

# 官方直連單價(美元/百萬 token),僅用於粗估;實際以平臺賬單爲準
PRICE = {"input": 8.0, "cached": 0.40, "output": 40.0}

def estimate_cost(usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * PRICE["input"] + cached * PRICE["cached"]
            + usage.completion_tokens * PRICE["output"]) / 1_000_000

def p90(values):
    values = sorted(values)
    return values[max(0, int(len(values) * 0.9) - 1)]

def run(model, rounds=3):
    stats = {}
    for _ in range(rounds):
        for t in TASKS:
            start = time.perf_counter()
            resp = client.chat.completions.create(
                model=model,
                reasoning_effort="medium",
                messages=[{"role": "user", "content": t["prompt"]}],
            )
            elapsed = time.perf_counter() - start
            answer = resp.choices[0].message.content or ""
            s = stats.setdefault(t["category"], {"pass": 0, "n": 0, "lat": [], "cost": 0.0})
            s["n"] += 1
            s["pass"] += int(t["checker"](answer))
            s["lat"].append(elapsed)
            s["cost"] += estimate_cost(resp.usage)
    for cat, s in stats.items():
        print(f"{model} | {cat} | 通過率 {s['pass']}/{s['n']} | "
              f"P50 {statistics.median(s['lat']):.1f}s | P90 {p90(s['lat']):.1f}s | "
              f"估算費用 ${s['cost']:.3f}")

for m in MODELS:
    run(m)
這段腳本只做單輪問答。如果要貼近 DataAnalyticsBench 的設置,還需要接入只讀 SQL 工具,讓模型自主多輪查詢,並額外記錄每題的工具調用次數,用來檢驗前文“查詢次數與失分”的假設。
🎯 複測建議:四個模型都走 OpenAI 兼容協議,通過 API易 apiyi.com 用同一個 API Key 即可切換,新用戶的免費測試額度足夠先跑一輪小題集,再決定是否擴大規模。
榜單給出的是方向,具體到自己的數倉、自己的異常類型,答案只能自己跑出來。陸游在《冬夜讀書示子聿》中寫道:“紙上得來終覺淺,絕知此事要躬行。”
作者:APIYI 技術團隊
技術交流:歡迎通過 API易 apiyi.com 首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心