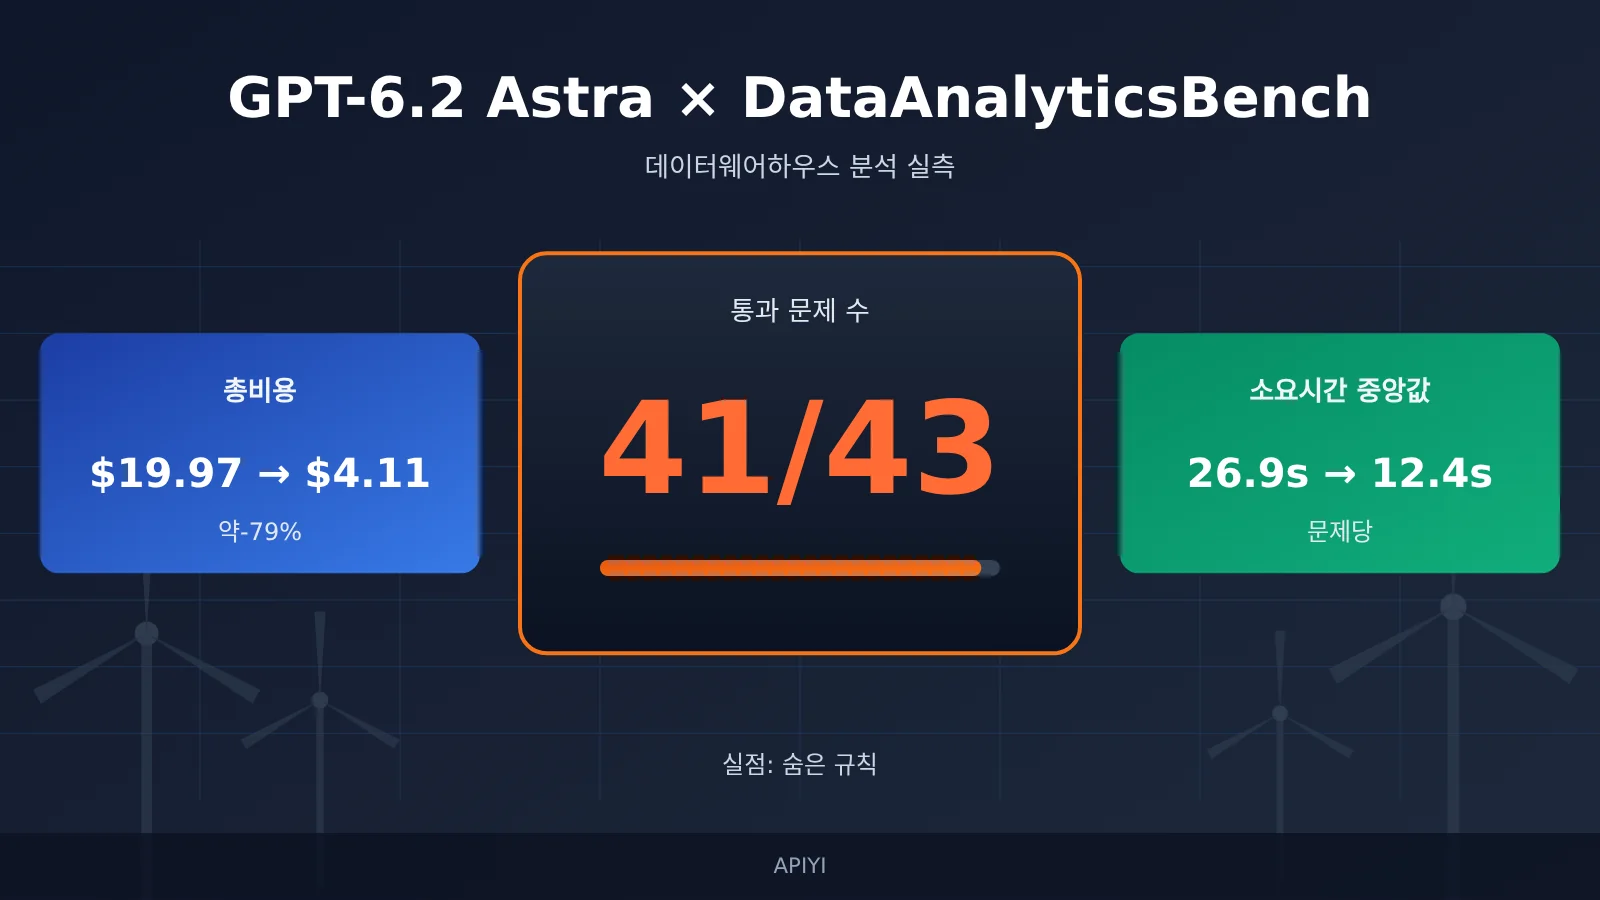
핵심 결론: Plotly의 DataAnalyticsBench 실측에서 GPT-6.2 Astra는 43개의 데이터 분석 문항 중 41개 문항을 통과했어요. 전대 GPT-6 Astra의 성적은 43/43이었어요. 두 문항의 실점은 모두 “숨겨진 패턴” 유형에서 나왔고, 나머지 다섯 유형은 전부 통과했어요. 동시에 전체 실행 비용은 $19.97에서 $4.11로, 문항당 소요 시간 중앙값은 26.9초에서 12.4초로 줄었어요. 신형 Astra는 두 문항을 놓친 대신 전대의 4분의 1도 안 되는 비용과 절반도 안 되는 대기 시간을 얻었어요. 하지만 이상 징후를 능동적으로 추적하는 능력이 정말로 후퇴했는지는 아직 한 차례 데이터만 있어서, 자체 데이터로 재검증해 봐야 해요.
이 글에서 무엇을 얻을 수 있나요?
- DataAnalyticsBench가 무엇을 측정하고 어떻게 채점하는지, 41/43이라는 점수의 경계가 어디인지.
- 여섯 유형의 문항별 점수와, 두 실점 문항이 각각 어떻게 실패했는지.
- 비용이 약 79% 줄어든 두 원천인 단가 인하와 작업량 감소가 각각 얼마나 기여했는지.
- GPT-6.2 Astra와 GPT-6 Astra, GPT-6.1 Sol, GPT-6.2 Sol이 점수, 비용, 지연 시간에서 보이는 트레이드오프.
- 자체 데이터 웨어하우스에서 결론을 검증할 수 있도록 바로 응용할 수 있는 재측정 방법과 Python 코드.
인덱스: To Know 표는 평가에서 쓰이는 전문 개념을 설명하고, 영향 훑어보기에서는 독자군별로 이 뉴스가 갖는 의미를 요약해요. “객관적 사실” 부분은 테스트 환경과 채점 규칙, 여섯 유형별 점수, 비용과 소요 시간 데이터, 그리고 OpenAI 공식 기준의 모델 식별 정보와 가격 기준을 차례로 설명해요. “분석 및 판단” 부분은 41/43의 의미를 해석하고, 숨겨진 패턴 문항에서 실점한 이유를 설명하는 가설을 제시하며, 비용 절감의 원천을 분해하고, 모델 선택 제안과 재측정 코드를 제공해요.
GPT-6.2 Astra DataAnalyticsBench, 먼저 알아야 할 개념
| 개념 | 간단한 설명 |
|---|---|
| DataAnalyticsBench | Plotly와 Mila 연구자들이 설계한 43개의 데이터 웨어하우스 분석 문제로, 모의 풍력 발전 운영 데이터를 바탕으로 모델의 분석 능력을 평가하는 벤치마크예요 |
| 테스트 실행 환경 | 모든 모델에 동일한 데이터 웨어하우스를 제공하고, 쿼리·차트 생성·표 표시 같은 읽기 전용 도구를 함께 제공하는 평가 시스템이에요 |
| 채점 규칙 | 문제마다 어떤 답변이 문제 의도를 충분히 충족하는지 정해 두고, 통과 또는 불통과만 판정하며 부분 점수는 주지 않아요 |
| 데이터 품질 문제 | 결측, 중복, 이상 레코드처럼 분석 결론에 영향을 줄 수 있는 입력 문제로, 문제 안에 의도적으로 심어져 있어요 |
| 통계 함정 | 직관적인 알고리즘이나 집계 방식이 사람을 잘못된 결론으로 끌고 갈 수 있도록 만든 문제예요 |
| 숨은 패턴 | 문제 지문에는 명시되지 않아서, 모델이 스스로 파고들어 찾아내야 하는 이상 패턴이나 원인이에요 |
| 문제당 소요 시간 중앙값 | 43개 문제의 실제 경과 시간을 정렬한 뒤 가운데 값을 취한 것으로, 이 순위표에는 도구 쿼리 소요 시간도 포함돼요 |
| 전체 라운드 비용 | 같은 모델이 43개 문제를 모두 완료하는 동안 누적된 호출 비용이에요 |
| 캐시 적중 | 반복되는 입력 프리픽스가 서버 측에 캐시되어 더 낮은 단가로 청구되는 입력 토큰 부분이에요 |
GPT-6.2 Astra DataAnalyticsBench 점수가 사용자층별로 미치는 영향 한눈에 보기
- API 선택 담당자: GPT-6.2 Astra의 단가와 응답 속도가 눈에 띄게 개선됐어요. 일상적인 리포트나 지표 정의 정리 같은 작업에는 우선 고려해볼 만하죠. 다만 이상 원인을 추적하는 유형의 작업에는 당분간 벤치마크 결론을 그대로 적용하기 어려워요.
- 데이터 제품 개발자: “자연어로 질문하기”, BI 어시스턴트 같은 제품을 만들 때 지연 시간 중위값이 절반으로 줄어드는 건 인터랙션 경험에 큰 영향을 줘요. 다만 다중 턴 탐색에서 모델의 “인내심”은 별도로 평가해야 하고, 필요하면 프롬프트나 워크플로에 검사 단계를 강제로 덧붙이는 게 좋아요.
- 분석 팀: 모델을 더 빠른 초안 분석 담당자로 활용할 수 있어요. 다만 근본 원인 조사 같은 결론은 여전히 사람이 다시 검토해야 하죠. APIYI apiyi.com 같은 OpenAI 호환 통합 인터페이스를 쓰면 동일한 코드에서 네 가지 모델을 전환하며 대조 테스트를 진행할 수 있어요.
GPT-6.2 Astra DataAnalyticsBench 객관적 사실
GPT-6.2 Astra 테스트 시나리오와 채점 규칙
DataAnalyticsBench는 Plotly와 Mila 연구진이 설계했고, 풍력 발전 운영을 모사한 데이터 웨어하우스를 사용해요. 이 웨어하우스는 44개의 테이블, 약 1,990만 행, 554개의 컬럼으로 이루어져 있으며 설비 원격 측정(텔레메트리), 알람, 작업 지시(워크 오더), 점검, 날씨 등의 데이터를 담고 있어요. 각 문제는 Plotly Studio Embedded에서 실행되고, OpenRouter를 거쳐 모델을 호출해요. 모델이 쓸 수 있는 도구는 단 네 가지, 모두 읽기 전용 도구예요: 데이터셋 목록 조회, SQL 실행, 차트 그리기, 표 표시.
모델이 쿼리 경로와 답변 시점을 스스로 정하고, 테스트 측은 단계를 대신 설계해 주지 않아요. 즉 이 평가는 SQL 작성 능력만 보는 게 아니라 “어디까지 조회해야 충분한가”를 판단하는 능력까지 본다는 뜻이에요.
채점은 문제마다 정답 키와 채점 규칙에 따라 통과 여부만 판정하고, 부분 점수는 없어요. 심판 모델은 Claude Sonnet 5이고 온도(temperature)는 0으로 설정했어요. 주최 측은 SQL, pandas, Polars 세 가지 방식으로 정답을 각각 생성해 교차 검증했고, 실패한 트레이스는 사람이 검토했으며 만점 결과도 따로 점검했어요. 두 가지 특별 유형 문제에는 명확한 통과 조건이 있어요:
- 모호한 문제: 모델이 질문을 명확히 하거나(되물어 확인), 가정을 명시하고 대체 해법을 제시하면 통과예요.
- 데이터로 답할 수 없는 문제: 현재 데이터의 한계를 정확히 지적하면 통과예요.
문제 은행에도 분명한 경계가 있어요: 단일 업무 도메인(풍력 발전 운영), 영어, 동일한 테스트 환경이고, 각 모델은 한 라운드만 실행해요. 문제, 데이터, 정답 키는 주최 측이 보관하며 외부에 공개하지 않아요.
출처: Plotly, Introducing DataAnalyticsBench, 2026-10-14 발표, 2026-11-19 업데이트, plotly.com/blog/introducing-dataanalyticsbench/
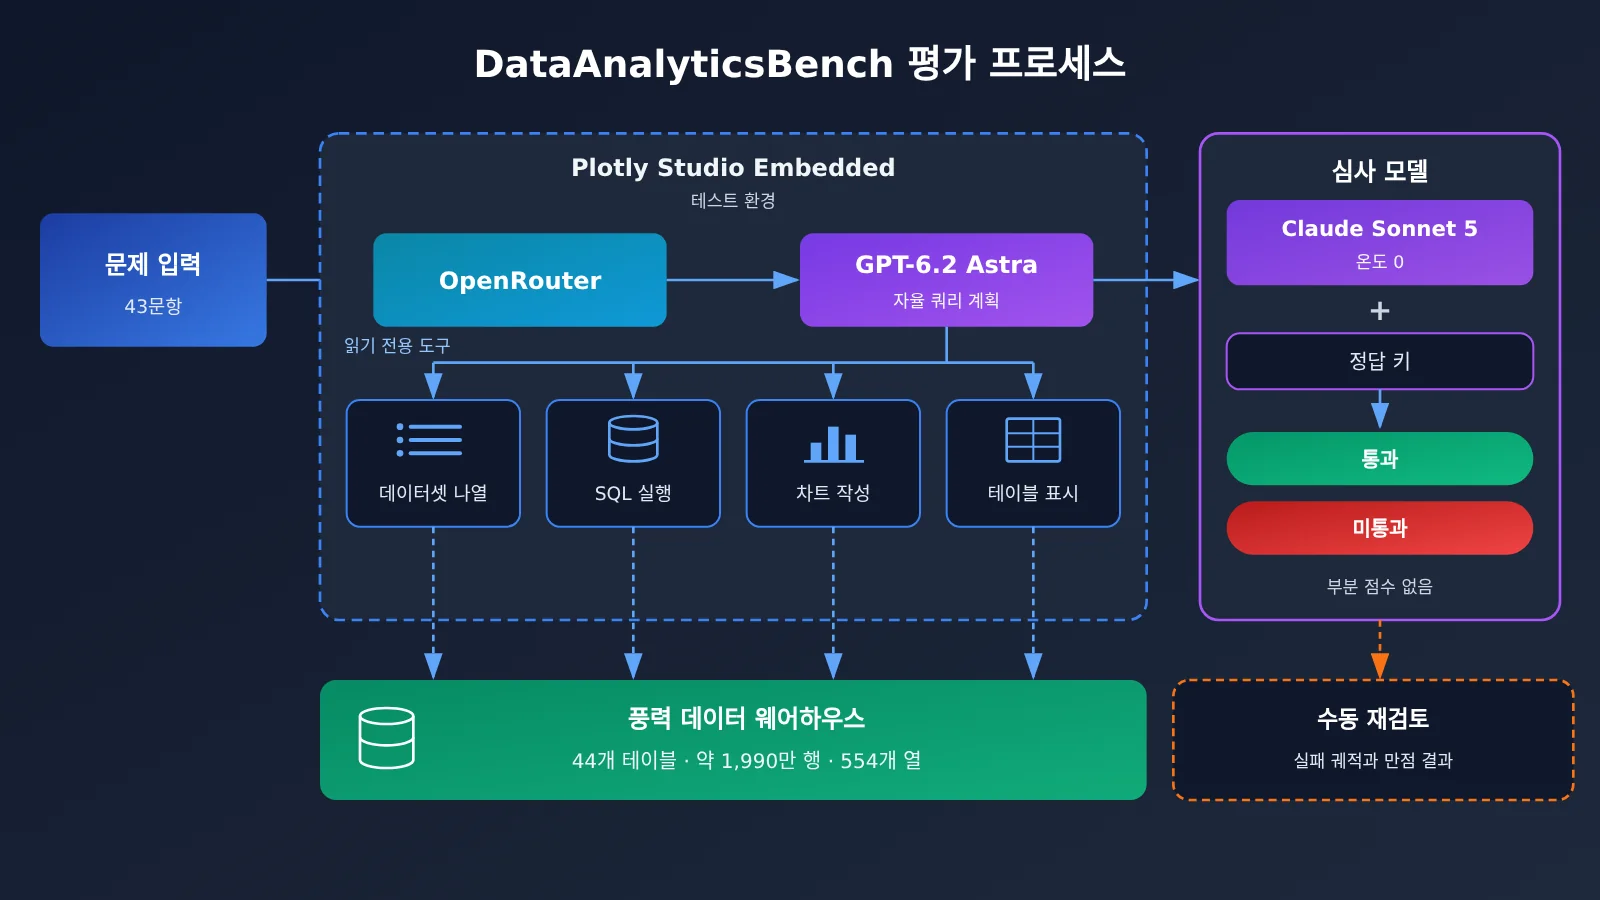
그림 설명: 이 “모델이 스스로 쿼리 계획 + 읽기 전용 도구 + 문제별 통과 판정” 구조는 자체 환경에서 APIYI apiyi.com의 OpenAI 호환 인터페이스를 이용해 비슷하게 재현하고 내부 대조 테스트를 해볼 수 있어요.
GPT-6.2 Astra 6개 문항 유형별 점수: 실점은 ‘숨은 패턴’에 집중
Plotly가 2026년 11월 17일 발표한 Astra 전문 리포트에서 유형별 점수를 공개했어요:
| 문항 유형 | GPT-6.2 Astra | GPT-6 Astra | 평가 포인트 |
|---|---|---|---|
| 일반 분석 | 20/20 | 20/20 | 다단계 SQL, 테이블 조인, 시간 구간 |
| 모호성 판단 | 5/5 | 5/5 | 기준을 명확히 하거나 합리적 가정 설명 |
| 데이터로 답할 수 없음 | 5/5 | 5/5 | 보유 데이터로 답할 수 없는 질문 식별 |
| 데이터 품질 | 3/3 | 3/3 | 심어 놓은 품질 문제 식별 |
| 통계 함정 | 5/5 | 5/5 | 직관적 알고리즘이 유발할 수 있는 오해 식별 |
| 숨은 패턴 | 3/5 | 5/5 | 명시되지 않은 이상 패턴을 능동적으로 추적 |
| 총계 | 41/43 | 43/43 | 모든 문항 동일 가중치, 문항별 통과 판정 |
앞의 다섯 유형은 합계 38/38로 두 모델의 성적이 완전히 같았어요. 차이는 전부 숨은 패턴 문항에서 나왔죠. 신형 모델은 3/5, 이전 모델은 5/5였어요.
실점한 두 문항은 모두 Plotly의 수동 검토를 거쳤고, 실패 방식이 서로 달랐어요:
- 한 문항에서는 모델이 끝내 심어 놓은 패턴을 찾아내지 못했어요.
- 다른 문항에서는 모델이 조사해야 할 위치는 찾았지만, 진짜 원인은 배제해 버렸어요.
리포트는 과정 데이터도 하나 제시했어요. 숨은 패턴 문항에서 GPT-6.2 Astra는 문항당 평균 약 9회의 데이터베이스 쿼리를 실행한 반면, GPT-6 Astra는 약 15회였어요.
출처: Plotly, GPT-6.2 Astra Benchmark Results for Data Analysis, 2026-11-17, plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/
GPT-6.2 Astra 비용과 소요 시간: 두 세대와 동일 제조사 대조
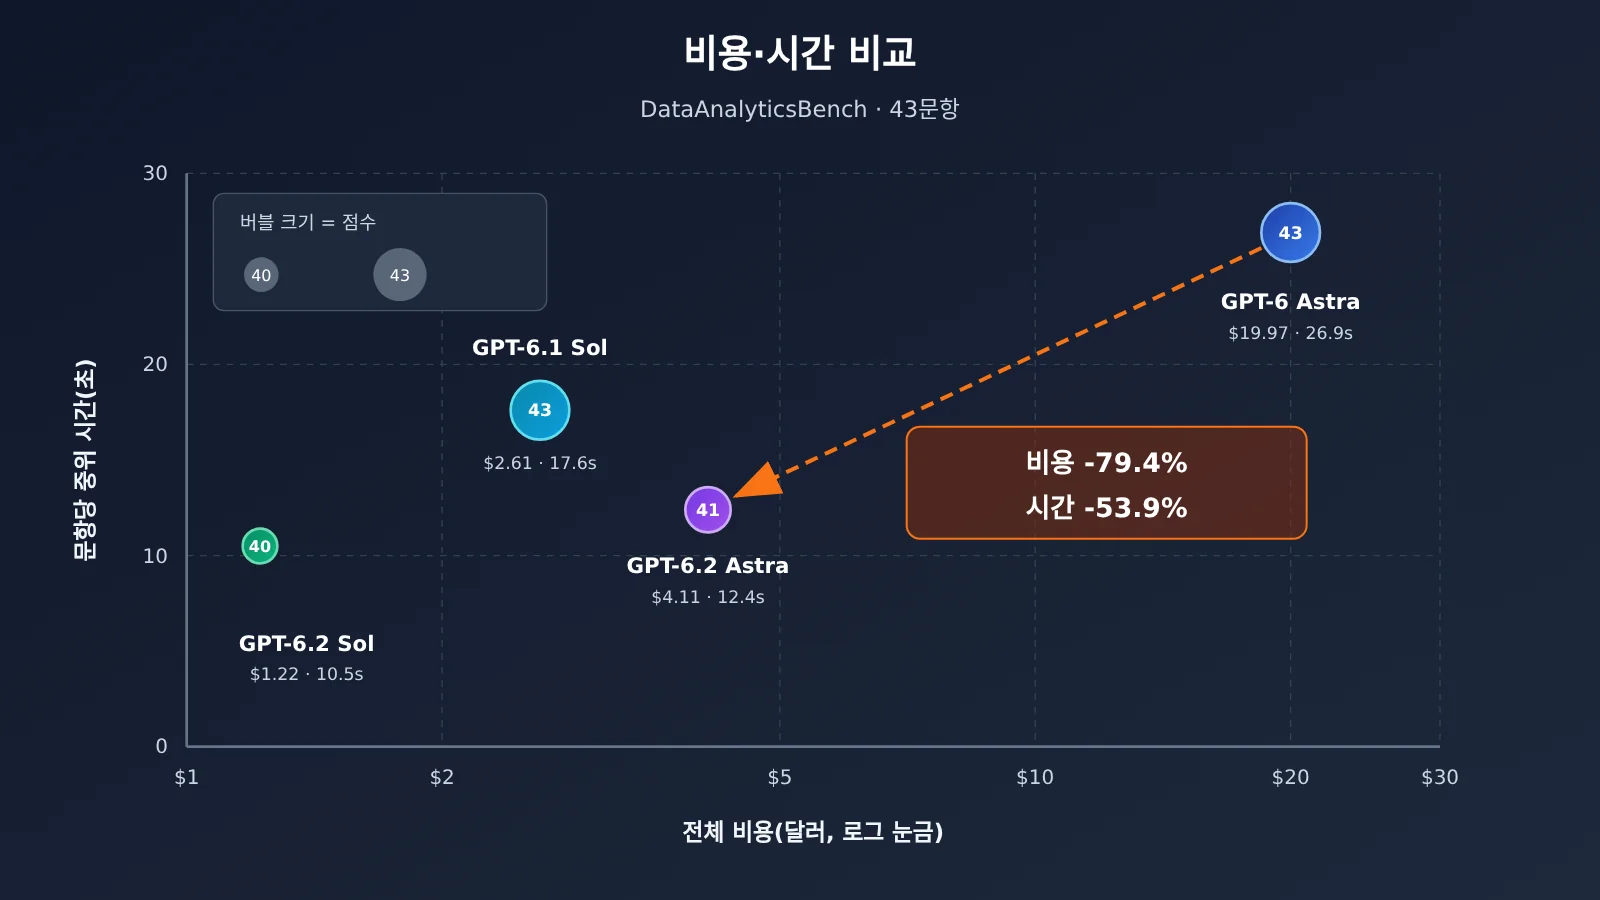
| 모델 | 점수 | 전체 라운드 비용 | 문제당 소요 시간 중앙값 |
|---|---|---|---|
| GPT-6.2 Astra | 41/43 | $4.11 | 12.4초 |
| GPT-6 Astra | 43/43 | $19.97 | 26.9초 |
| GPT-6.1 Sol | 43/43 | $2.61 | 17.6초 |
| GPT-6.2 Sol | 40/43 | $1.22 | 10.5초 |
원표를 기준으로 계산하면 GPT-6.2 Astra는 이전 세대 대비 전체 라운드 비용이 약 79.4% 감소했고, 문제당 소요 시간 중앙값은 약 53.9% 짧아졌어요. 작성자의 실측에서도 6.2 Astra는 전체 라운드가 약 13분, 이전 세대는 약 32분이었어요. 여기서 소요 시간은 도구 조회까지 포함한 실제 경과 시간이고, 순수 모델 추론 시간은 아니에요.
문제당 비용은 두 가지 기준이 있어서 나눠 살펴봐야 해요. $4.11 ÷ 43을 하면 문제당 평균 약 $0.096이 되고, 업데이트된 종합 순위표에서는 $0.066을 이번 라운드 문제당 비용의 중앙값으로 표기했어요. 평균값이 중앙값보다 높다는 건 일부 문제의 비용이 확실히 높아서 전체 평균을 끌어올렸다는 뜻이에요.
Plotly는 두 세대 원래 라운드의 작업량 상세 내역도 함께 제공했어요:
| 작업량 지표 | GPT-6 Astra (이전 세대) | GPT-6.2 Astra |
|---|---|---|
| 도구 호출 횟수 | 266회 | 148회 |
| 모델 호출 횟수 | 249회 | 171회 |
| 입력 token | 약 910만 | 약 440만 |
| 출력 token | 약 7.8만 | 약 3.4만 |
| 입력 캐시 적중 비율 | 93% | 98% |
Plotly가 새로운 요율로 이전 세대의 원래 사용량을 그대로 다시 계산해 보니 약 $11로 추산됐어요. 주의할 점은, 이 비용이 Plotly 테스트 당시의 OpenRouter 가격에서 나온 것이지 OpenAI 공식 가격표를 직접 환산한 값은 아니라는 거예요.
출처: Plotly Astra 특별 보고서 plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/; Plotly 종합 순위표 plotly.com/blog/introducing-dataanalyticsbench/#full-results
GPT-6.2 Astra 모델 정체성 및 공식 가격 기준
OpenAI는 2026년 11월 17일에 GPT-6.2 Astra와 GPT-6.2 Sol을 발표했어요. Astra는 복잡한 추론, 코딩, 전문 업무를 겨냥하며, API 모델 ID는 gpt-6.2-astra예요. OpenAI 발표 공지에 포함된 평가 결과는 제조사 자체 기준이고, Plotly의 DataAnalyticsBench는 별개의 제3자 평가이므로 두 가지를 섞어서 비교하면 안 돼요.
모델 카드에 따르면 Astra는 텍스트와 이미지를 입력받아 텍스트를 출력하고, 컨텍스트는 1,050,000 token, 최대 입력은 922,000 token, 최대 출력은 128,000 token이에요. Responses API와 Chat Completions API를 모두 지원하며, 내장 도구, Multi-agent, 백그라운드 완료 윈도우 등의 기능은 Responses API를 기준으로 해요. 모델 카드는 또한 reasoning.effort를 none으로 설정한 요청은 거부된다고 설명하고 있어요.
OpenAI 표준 단문맥 순수 텍스트 가격(백만 token당)은 일반 입력 $8, 캐시 적중 입력 $0.40, 출력 $40이에요. 공식 측은 이전 세대 대비 일반 입력과 출력 단가가 20% 낮아지고, 캐시 적중 입력 단가가 60% 낮아졌다고 밝혔어요.
출처: OpenAI 발표 공지 openai.com/index/introducing-gpt-6-2-astra-sol/; 모델 카드 developers.openai.com/api/docs/models/gpt-6.2-astra; API 변경 로그 developers.openai.com/api/docs/changelog; 가격표 developers.openai.com/api/docs/pricing
GPT-6.2 Astra DataAnalyticsBench 분석 판단
41/43을 어떻게 읽어야 할까: “전체적으로 약해졌다”가 아니에요
41/43을 나눠서 보면, GPT-6.2 Astra는 일반 분석, 모호성, 답변 불가, 데이터 품질, 통계적 함정 이렇게 다섯 가지 유형의 문제에서는 점수를 잃지 않았어요. 이 다섯 유형은 일상적인 리포트와 지표 기준 대조의 대부분 시나리오를 포괄해요. 만약 업무가 주로 이런 문제라면, 이번 라운드 데이터로 볼 때 새로운 Astra의 품질은 전작과 비슷한 수준이지만 비용과 속도는 확실히 더 나아요.
두 문제의 차이는 변동 범위 안에 넣어서 봐야 해요. Plotly 보고서에 따르면 다른 모델을 다시 돌렸을 때 최대 세 문제의 변동이 나타난 적이 있다고 해요. 따라서 41 대 43은 “이번 라운드의 관측값”으로 받아들이는 게 더 적절하고, 안정적인 능력 차이라고 보기는 어려워요. 비교적 정확한 표현은 이래요. 숨은 규칙 유형에서 추적할 만한 신호가 나타났지만, 단일 라운드 데이터만으로는 성능 저하가 존재한다고 확인하기에는 아직 부족해요.
숨은 규칙 문제는 왜 다시 측정해 볼 가치가 있을까: 탐색 깊이에 관한 설명 가설
다음은 보고서 데이터를 바탕으로 한 설명 가설이며, Plotly의 결론은 아니에요. 숨은 규칙 문제에서는 신형 모델이 문제당 평균 약 9회 조회했고, 이전 모델은 약 15회 조회했어요. 점수를 잃은 두 문제의 양상은 하나는 “찾지 못함”, 다른 하나는 “위치는 찾았지만 진짜 원인을 배제함”이었죠. 둘 다 “충분히 깊게 파고들지 않고 손을 떼는” 모습이에요. 앞선 경우는 탐색 범위가 부족했고, 뒤의 경우는 검증 단계에서 너무 일찍 부정적인 결론을 내린 거예요.
이 같은 양상은 비용과 지연 시간의 감소가 같은 행동 변화, 즉 모델이 몇 번만 조회하고 답하려는 경향에서 비롯됐을 가능성을 보여줘요. 일반 문제에서는 이런 경향이 곧바로 효율로 이어지지만, 반복적인 가설 수립과 검증이 필요한 근본 원인 문제에서는 위험이 될 수 있어요. 이 가설을 검증하려면 총점만 보지 말고, 자신의 데이터에서 조회 횟수와 통과율의 관계를 대조해 봐야 해요.
GPT-6.2 Astra의 비용과 속도는 왜 함께 줄었을까
$19.97에서 $4.11로 떨어진 것은 Plotly의 재계산 데이터를 기준으로 두 구간으로 나눌 수 있어요.
- 요율 요인: 이전 모델의 사용량을 그대로 새 요율로 재계산하면 약 $11이에요. 즉 가격 인하만으로도 비용이 $19.97에서 $11로, 약 45% 줄어드는 셈이죠. 공식 캐시 입력 단가가 60% 낮아졌는데, 캐시 적중률이 93%에서 98%에 달하는 시나리오에서는 이 부분의 효과가 특히 두드러져요.
- 작업량 요인: 약 $11에서 $4.11로 줄어든 것은 작업량 감소 덕분이에요. 도구 호출이 266회에서 148회로 줄고, 입력 토큰이 약 910만에서 약 440만으로 감소했으며, 출력 토큰은 절반 이상 줄었고, 캐시 적중 비중은 93%에서 98%로 올랐어요.
공식 단가로 신형 모델의 사용량을 대략 계산해 보면 결과도 $4.11과 같은 규모예요. 약 440만 입력 중 98%가 캐시 가격으로 책정되고, 나머지는 일반 입력 가격이 적용되며, 여기에 약 3.4만 출력 토큰이 더해져요. 이는 데이터 분석처럼 컨텍스트 윈도우가 길고 도구 호출이 여러 라운드 이어지는 시나리오에서는 캐시 적중률과 호출 라운드 수가 단가 자체보다 비용에 더 큰 영향을 줄 수 있다는 뜻이에요. 속도 향상도 같은 원리예요. 조회가 줄고 모델 호출이 줄면 경과 시간도 자연히 짧아지죠.
💰 비용 제안: 이런 에이전트형 작업의 비용을 평가할 때는 캐시 적중 토큰과 도구 호출 라운드 수를 기록해야 하며, 단가표만 보고 판단해서는 안 돼요. APIYI apiyi.com을 통해 종량제로 호출할 때는 청구서와 로그의 usage 필드를 대조해 캐시가 실제로 적용됐는지 확인할 수 있어요.
GPT-6.2 Astra와 GPT-6.1 Sol, GPT-6.2 Sol 사이의 선택
네 모델의 위치는 각기 달라요.
- GPT-6.1 Sol: 이 설정에서는 $2.61로 43/43을 기록했어요. 이번 라운드에서 만점을 받은 옵션 중 가장 저렴한 선택이지만, 중앙값 기준 17.6초가 걸려 6.2 Astra보다 느려요.
- GPT-6.2 Astra: 41/43, $4.11, 12.4초예요. 장점은 점수와 속도를 함께 비교할 때 드러나요. 비용과 점수만 보면 우위는 아니에요.
- GPT-6.2 Sol: $1.22, 10.5초로 가장 저렴하고 가장 빠르지만, 점수는 40/43으로 가장 낮아요.
- GPT-6 Astra: 만점이지만 비용과 지연이 모두 눈에 띄게 높아서, 이 비교에서는 선택할 이유를 찾기 어려워요.
모델 간 점수 차이는 Plotly가 언급한 최대 세 문제 변동 범위 안에 있어요. 즉, 총점만으로는 신뢰할 만한 순위를 매기기 어렵고, 실제로 믿을 수 있는 구분 기준은 비용과 지연이에요. 실제 선택에서는 지연에 민감한 인터랙티브 데이터 질의 제품이라면 6.2 Astra와 6.2 Sol을 먼저 비교해 볼 수 있어요. 지연에 민감하지 않은 오프라인 배치 분석에서는 6.1 Sol의 가성비를 더 눈여겨볼 만해요.
자체 데이터로 GPT-6.2 Astra 다시 검증하기
아래 재검증 방법은 편집 제안이에요. DataAnalyticsBench는 풍력 발전 운영, 영어, 단일 환경만 다루기 때문에 대부분 팀의 실제 데이터 웨어하우스와는 차이가 커요. 더 안전한 방법은 자체 데이터로 작은 문제 세트를 만들고, 데이터·도구·프롬프트를 고정한 뒤 여러 라운드를 돌려 작업 유형별 성능을 각각 집계하는 거예요.
| 하위 집합 | 권장 문항 수 | 중점 기록 | 판단 용도 |
|---|---|---|---|
| 일반 보고서 | 15-20문항 | 통과율, 중위 지연 시간 | 일상적인 수치 질의를 모델에 맡겨도 되는지 |
| 모호한 기준 | 5문항 정도 | 스스로 명확히 묻는지, 가정을 설명하는지 | “조용히 한 가지 기준을 골라버리는” 상황 방지 |
| 통계 편향 | 5문항 정도 | 심슨의 역설 같은 함정을 알아채는지 | 결론의 신뢰도 |
| 이상 원인 분석 | 5-8문항 | 통과율, 쿼리 횟수, P90 지연 시간 | 숨은 규칙 문제에서의 감점 신호 검증 |
| 전체 문항 | — | 라운드별 총비용, 캐시 적중률 | 비용 예산 |
각 모델은 최소 3라운드 이상 돌리고 평균과 변동을 기록하는 걸 권장해요. 꼬리 지연(P90)은 따로 기록해야 해요. 중위값이 좋다고 해서 가장 느린 몇 문항도 감당할 수 있다는 뜻은 아니니까요.
아래는 가장 간단한 호출 예시예요. 모델 ID는 OpenAI가 공개한 gpt-6.2-astra를 사용했고, 실제 사용 가능한 모델은 플랫폼 목록을 기준으로 확인하세요:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.2-astra",
    reasoning_effort="medium",  # 모델 카드에 따르면 effort가 none인 요청은 거부돼요
    messages=[{"role": "user", "content": "上月各风场故障工单数环比变化最大的是哪个?请说明计算口径。"}],
)
print(resp.choices[0].message.content)
전체 재측정 스크립트 보기: 하위 집합별 통과율, 비용, P50/P90 지연 시간 집계
import time
import statistics
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODELS = ["gpt-6.2-astra", "gpt-6-astra", "gpt-6.1-sol", "gpt-6.2-sol"]

# 자체 제작 문제 세트: category는 재측정 표의 하위 집합에 대응하며, checker는 정답 키에 맞춰 직접 구현합니다
TASKS = [
    {"id": "r01", "category": "常规报表", "prompt": "...", "checker": lambda a: "..." in a},
    {"id": "h01", "category": "异常根因", "prompt": "...", "checker": lambda a: "..." in a},
]

# 공식 직결 단가(달러/백만 토큰)이며 대략적인 추정에만 사용합니다. 실제 기준은 플랫폼 청구서입니다
PRICE = {"input": 8.0, "cached": 0.40, "output": 40.0}

def estimate_cost(usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * PRICE["input"] + cached * PRICE["cached"]
            + usage.completion_tokens * PRICE["output"]) / 1_000_000

def p90(values):
    values = sorted(values)
    return values[max(0, int(len(values) * 0.9) - 1)]

def run(model, rounds=3):
    stats = {}
    for _ in range(rounds):
        for t in TASKS:
            start = time.perf_counter()
            resp = client.chat.completions.create(
                model=model,
                reasoning_effort="medium",
                messages=[{"role": "user", "content": t["prompt"]}],
            )
            elapsed = time.perf_counter() - start
            answer = resp.choices[0].message.content or ""
            s = stats.setdefault(t["category"], {"pass": 0, "n": 0, "lat": [], "cost": 0.0})
            s["n"] += 1
            s["pass"] += int(t["checker"](answer))
            s["lat"].append(elapsed)
            s["cost"] += estimate_cost(resp.usage)
    for cat, s in stats.items():
        print(f"{model} | {cat} | 通过率 {s['pass']}/{s['n']} | "
              f"P50 {statistics.median(s['lat']):.1f}s | P90 {p90(s['lat']):.1f}s | "
              f"估算费用 ${s['cost']:.3f}")

for m in MODELS:
    run(m)
이 스크립트는 단일 턴 질의응답만 수행해요. DataAnalyticsBench의 설정에 더 가깝게 맞추려면 읽기 전용 SQL 도구를 연결해서 모델이 스스로 여러 턴에 걸쳐 질의하도록 하고, 문항별 도구 호출 횟수를 추가로 기록해 앞서 언급한 “질의 횟수와 감점” 가설을 검증해야 합니다.
🎯 재측정 제안: 네 모델 모두 OpenAI 호환 프로토콜을 사용하므로, APIYI apiyi.com을 통해 동일한 API 키 하나로 전환할 수 있어요. 신규 사용자에게 제공되는 무료 테스트 크레딧은 소규모 문제 세트로 먼저 한 라운드를 돌려본 뒤 규모 확대 여부를 결정하기에 충분합니다.
리더보드가 제시하는 것은 방향일 뿐, 자신의 데이터 웨어하우스와 자신의 이상 유형에 맞는 답은 직접 실행해 봐야만 얻을 수 있습니다. 루유(陸游)는 《동야독서시자율(冬夜讀書示子聿)》에서 이렇게 노래했어요. “책에서 얻은 것은 결국 얕으니, 이 일을 깊이 알려면 직접 몸으로 실천해야 하네.”
작성자: APIYI 기술팀
기술 교류: APIYI apiyi.com 홈페이지를 통해 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.