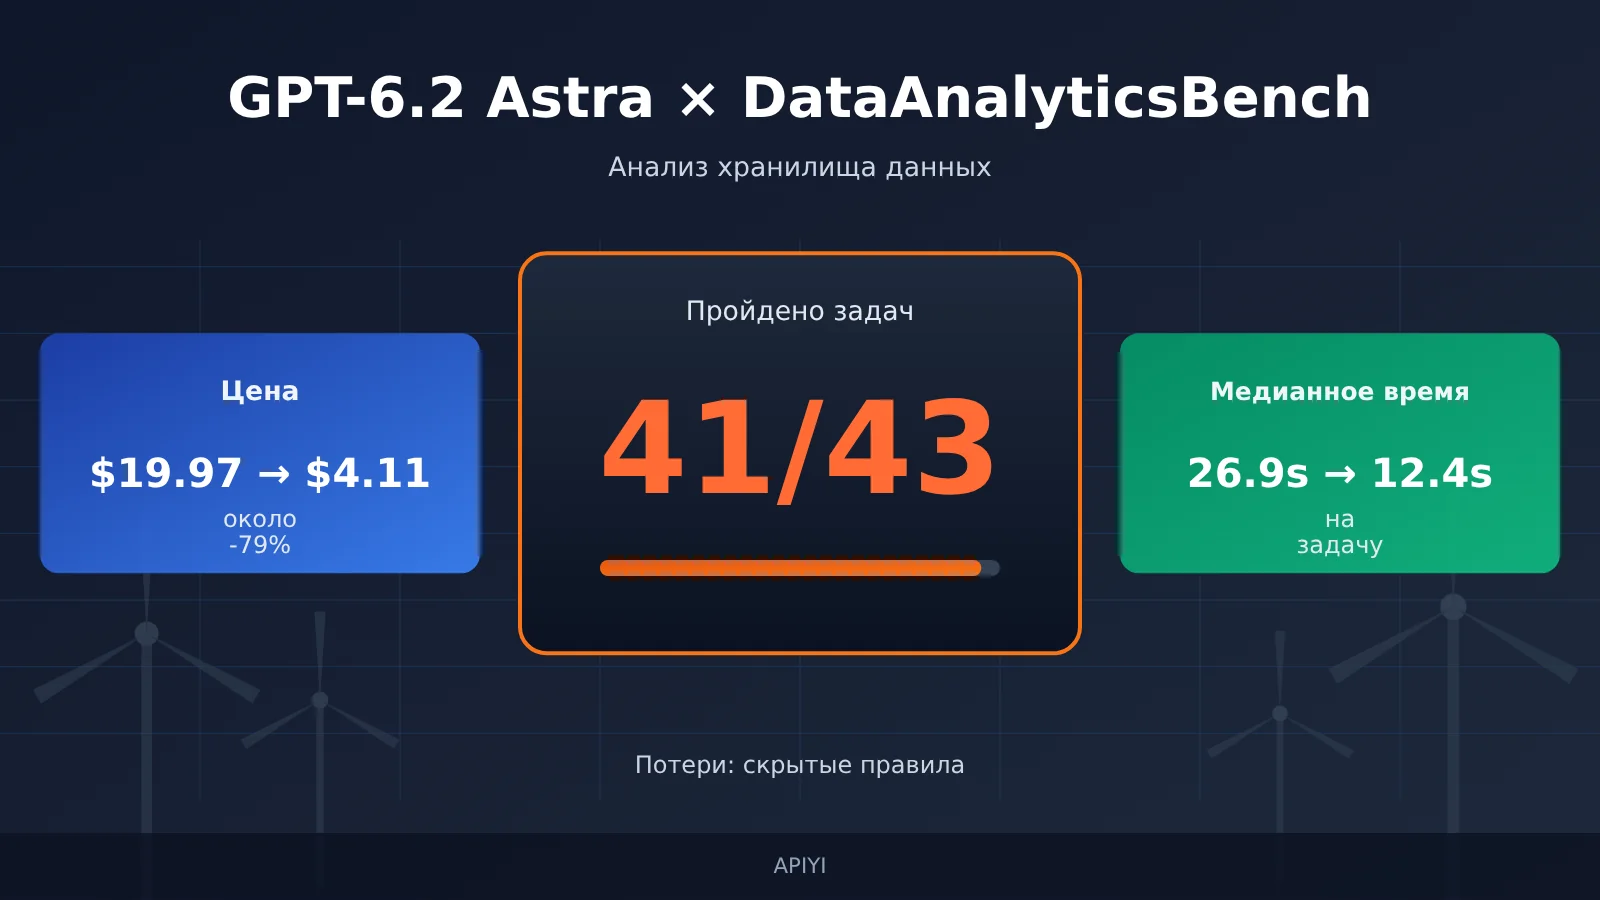
Главный вывод: в реальном тесте DataAnalyticsBench от Plotly GPT-6.2 Astra прошла 41 из 43 задач по анализу данных. У предыдущего поколения, GPT-6 Astra, результат был 43/43. Оба провала — в категории «скрытые закономерности», остальные пять категорий пройдены полностью. При этом стоимость всего прогона снизилась с $19.97 до $4.11, а медианное время на задачу сократилось с 26.9 секунды до 12.4 секунды. Новая Astra ценой двух задач получила менее четверти прежних затрат и менее половины времени ожидания — но действительно ли она стала хуже в проактивном поиске аномалий, пока судить рано: есть только один прогон, и проверять это нужно на собственных данных.
Что вы узнаете из этой статьи?
- Что именно измеряет DataAnalyticsBench, как он ставит оценки и где проходят границы результата 41/43.
- Баллы по каждой из шести категорий задач и то, как именно провалились две задачи.
- Два источника снижения стоимости примерно на 79% — уменьшение тарифа и сокращение объёма работы, — и сколько даёт каждый.
- Компромиссы между GPT-6.2 Astra и GPT-6 Astra, GPT-6.1 Sol, GPT-6.2 Sol по баллам, стоимости и задержке.
- Готовый к адаптации метод повторного теста и код на Python, чтобы проверить выводы на собственном хранилище данных.
Навигация: таблица To Know поясняет специальные понятия бенчмарка, а краткий обзор последствий по категориям читателей объясняет, что эта новость значит для каждой из них. В разделе «Объективные факты» последовательно описаны тестовая среда и правила оценки, результаты по шести категориям, данные о стоимости и времени, а также официальная идентификация модели и ценовые параметры от OpenAI. В разделе «Анализ и выводы» разбирается смысл 41/43, выдвигаются гипотезы, объясняющие провал на задачах со скрытыми закономерностями, раскладывается по источникам снижение стоимости, а также даются рекомендации по выбору модели и код для повторного теста.
GPT-6.2 Astra DataAnalyticsBench: что нужно знать заранее
| Понятие | Краткое объяснение |
|---|---|
| DataAnalyticsBench | 43 задачи по анализу хранилища данных, разработанные исследователями из Plotly и Mila; проверяют аналитические способности модели на смоделированных данных эксплуатации ветропарка |
| Среда тестирования | Система оценки, которая даёт каждой модели одинаковое хранилище данных и инструменты только для чтения: запросы, построение графиков, отображение таблиц |
| Правила оценки | Для каждой задачи заранее определено, какой ответ считается достаточным; ставится только «зачёт / незачёт», частичные баллы не начисляются |
| Проблемы качества данных | Пропуски, дубликаты, аномальные записи и другие проблемы во входных данных, влияющие на выводы анализа; в задачи они внедрены намеренно |
| Статистические ловушки | Задачи, в которых интуитивный алгоритм или способ агрегации может привести к неверным выводам |
| Скрытые закономерности | Аномальные паттерны или причины, не указанные в условии, которые модель должна выявить самостоятельно |
| Медианное время на задачу | Фактическое время прохождения всех 43 задач сортируется, берётся серединное значение; в этом рейтинге учитывается время запросов к инструментам |
| Стоимость полного раунда | Суммарная стоимость вызовов одной модели на выполнение всех 43 задач |
| Попадания в кэш | Та часть входных токенов, которая после серверного кэширования повторяющихся входных префиксов тарифицируется по более низкой цене |
Краткий обзор: как оценки GPT-6.2 Astra в DataAnalyticsBench влияют на разные группы
- Тем, кто выбирает API: у GPT-6.2 Astra заметно улучшились удельная стоимость и скорость отклика, поэтому для типовых задач вроде обычной отчётности и уточнения трактовки показателей её можно смело ставить в приоритет. А вот для задач поиска аномалий пока не стоит напрямую переносить выводы из рейтинга.
- Разработчикам data-продуктов: когда делаешь продукты вроде «запросов к данным на естественном языке» или BI-ассистентов, снижение медианной задержки вдвое очень сильно сказывается на интерактивном опыте. Но отдельно стоит оценить «терпение» модели при многошаговом исследовании — при необходимости принудительно добавляйте шаги проверки в промпт или рабочий процесс.
- Аналитическим командам: модель можно воспринимать как более быстрого аналитика, который готовит черновик, но выводы по расследованиям первопричин всё равно требуют ручной проверки. Если использовать агрегирующий интерфейс с совместимостью с OpenAI, такой как APIYI apiyi.com, можно в одном и том же коде переключать четыре модели для сравнительного тестирования.
Объективные факты о GPT-6.2 Astra DataAnalyticsBench
Сценарии тестирования и правила оценки GPT-6.2 Astra
DataAnalyticsBench разработан исследователями Plotly и Mila и использует имитационное хранилище данных по эксплуатации ветроэнергетики. В хранилище 44 таблицы, около 19,9 млн строк и 554 столбца — телеметрия оборудования, алерты, рабочие заявки, результаты осмотров и погодные данные. Каждое задание выполняется в Plotly Studio Embedded, а модель вызывается через OpenRouter. В распоряжении модели всего четыре инструмента, и все они только для чтения: вывести список наборов данных, выполнить SQL, построить график, показать таблицу.
Модель сама решает, по какому пути идти в запросах и когда давать ответ: организаторы не планируют шаги за неё. Это значит, что проверяют не только умение писать SQL, но и способность понять, «на каком шаге собранных данных уже достаточно».
С оценкой всё строго: каждое задание проверяется по ключу ответов и правилам оценки, результат — либо «сдано», либо «не сдано», частичных баллов нет. Модель-судья — Claude Sonnet 5 с температурой 0. Организаторы независимо генерируют ответы тремя способами — через SQL, pandas и Polars — и перекрёстно сверяют их, вручную разбирают траектории проваленных попыток и проверяют результаты с максимальным баллом. Для двух типов особых заданий есть чёткие условия прохождения:
- Неоднозначные задания: модель проходит, если уточняет вопрос либо явно оговаривает допущения и предлагает альтернативное решение.
- Задания, на которые данных нет: достаточно точно указать ограничения имеющихся данных.
У банка заданий тоже есть чёткие границы: одна предметная область (эксплуатация ветроэнергетики), английский язык, одна и та же тестовая среда, каждая модель прогоняется только один раз. Задания, данные и ключи ответов остаются у организаторов и публично не раскрываются.
Источник: Plotly, Introducing DataAnalyticsBench, опубликовано 2026-10-14, обновлено 2026-11-19, plotly.com/blog/introducing-dataanalyticsbench/
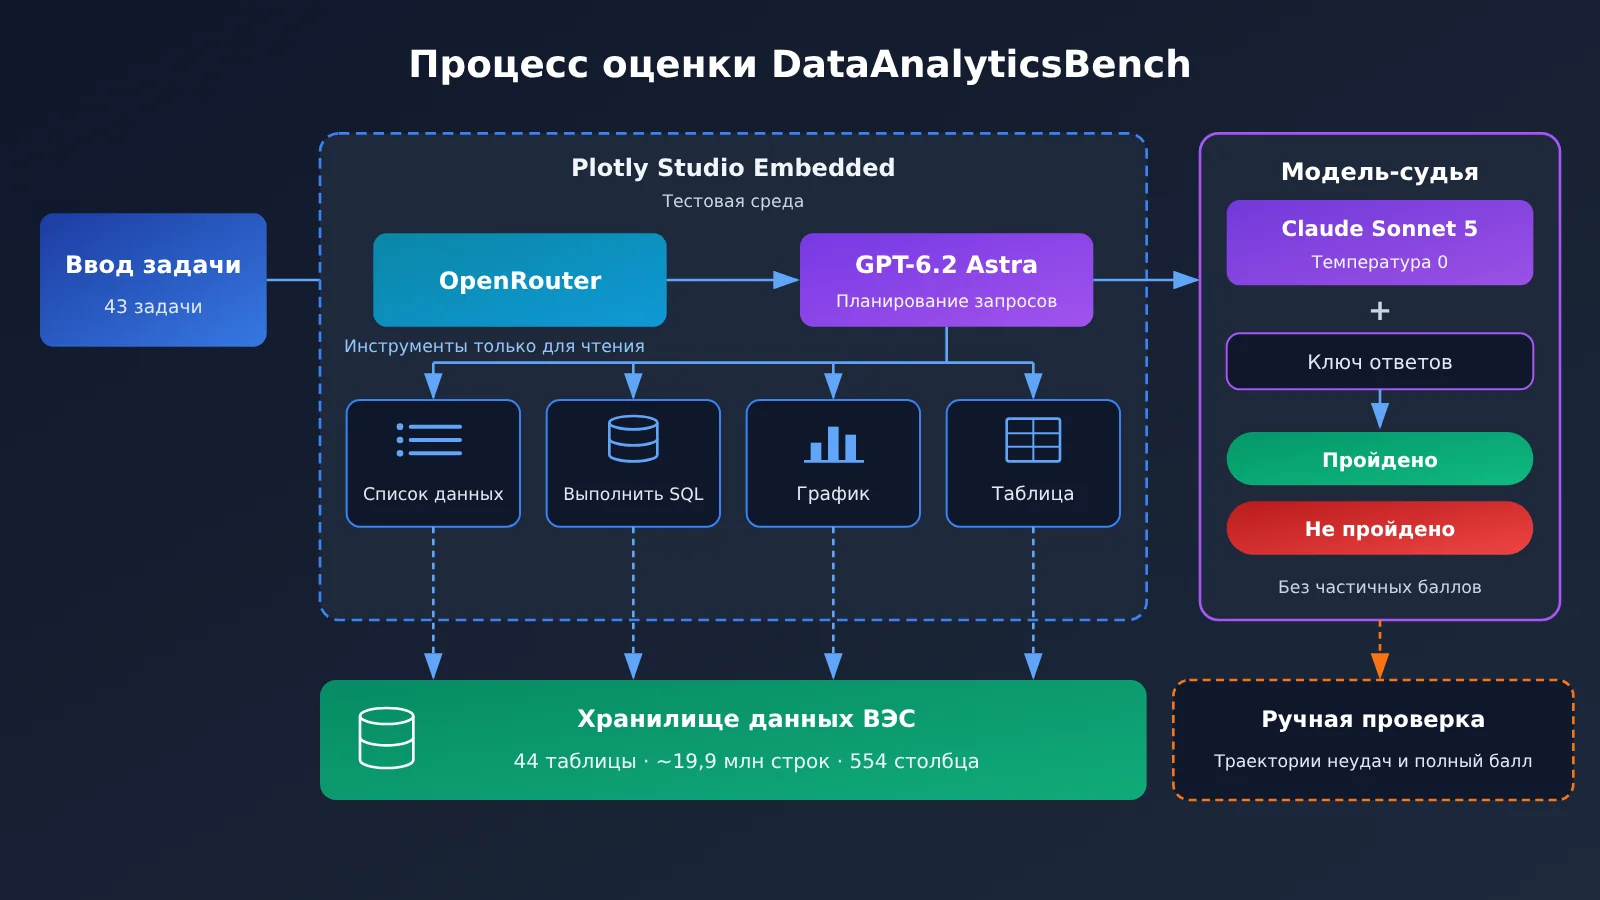
Пояснение к схеме: такую структуру — «модель сама планирует запросы + инструменты только для чтения + проверка каждого задания по принципу „сдано / не сдано“» — можно приблизительно воспроизвести у себя, используя OpenAI-совместимый интерфейс APIYI apiyi.com, и провести внутренний контрольный тест.
GPT-6.2 Astra: баллы по шести типам задач — потери сосредоточены в скрытых закономерностях
Специальный отчёт по Astra, опубликованный Plotly 17 ноября 2026 года, приводит баллы по категориям:
| Тип задачи | GPT-6.2 Astra | GPT-6 Astra | Что проверяется |
|---|---|---|---|
| Стандартный анализ | 20/20 | 20/20 | Многошаговые SQL-запросы, соединения таблиц и временные интервалы |
| Разрешение неоднозначности | 5/5 | 5/5 | Уточнить трактовку или явно указать разумные допущения |
| Вопросы, на которые нет ответа в данных | 5/5 | 5/5 | По имеющимся данным распознать вопросы, на которые нельзя ответить |
| Качество данных | 3/3 | 3/3 | Обнаружить внедрённые проблемы качества |
| Статистические ловушки | 5/5 | 5/5 | Распознать, как интуитивно очевидный алгоритм может вводить в заблуждение |
| Скрытые закономерности | 3/5 | 5/5 | Самостоятельно отследить аномальные закономерности, о которых прямо не сказано |
| Итого | 41/43 | 43/43 | Все задачи с равным весом, каждая проверяется отдельно |
Первые пять категорий дают в сумме 38/38 — оба поколения показали полностью одинаковый результат. Вся разница приходится на задачи со скрытыми закономерностями: новое поколение — 3/5, предыдущее — 5/5.
Обе задачи, где были потеряны баллы, прошли ручную проверку в Plotly, и провалились они по-разному:
- В одной задаче модель так и не нашла внедрённую закономерность.
- В другой модели нашла место, которое стоило исследовать, но отбросила настоящую причину.
В отчёте есть ещё одно наблюдение о процессе: на задачах со скрытыми закономерностями GPT-6.2 Astra в среднем выполняла около 9 запросов к базе на задачу, а GPT-6 Astra — около 15.
Источник: Plotly, GPT-6.2 Astra Benchmark Results for Data Analysis, 2026-11-17, plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/
Расходы и время GPT-6.2 Astra: два поколения и модели того же производителя
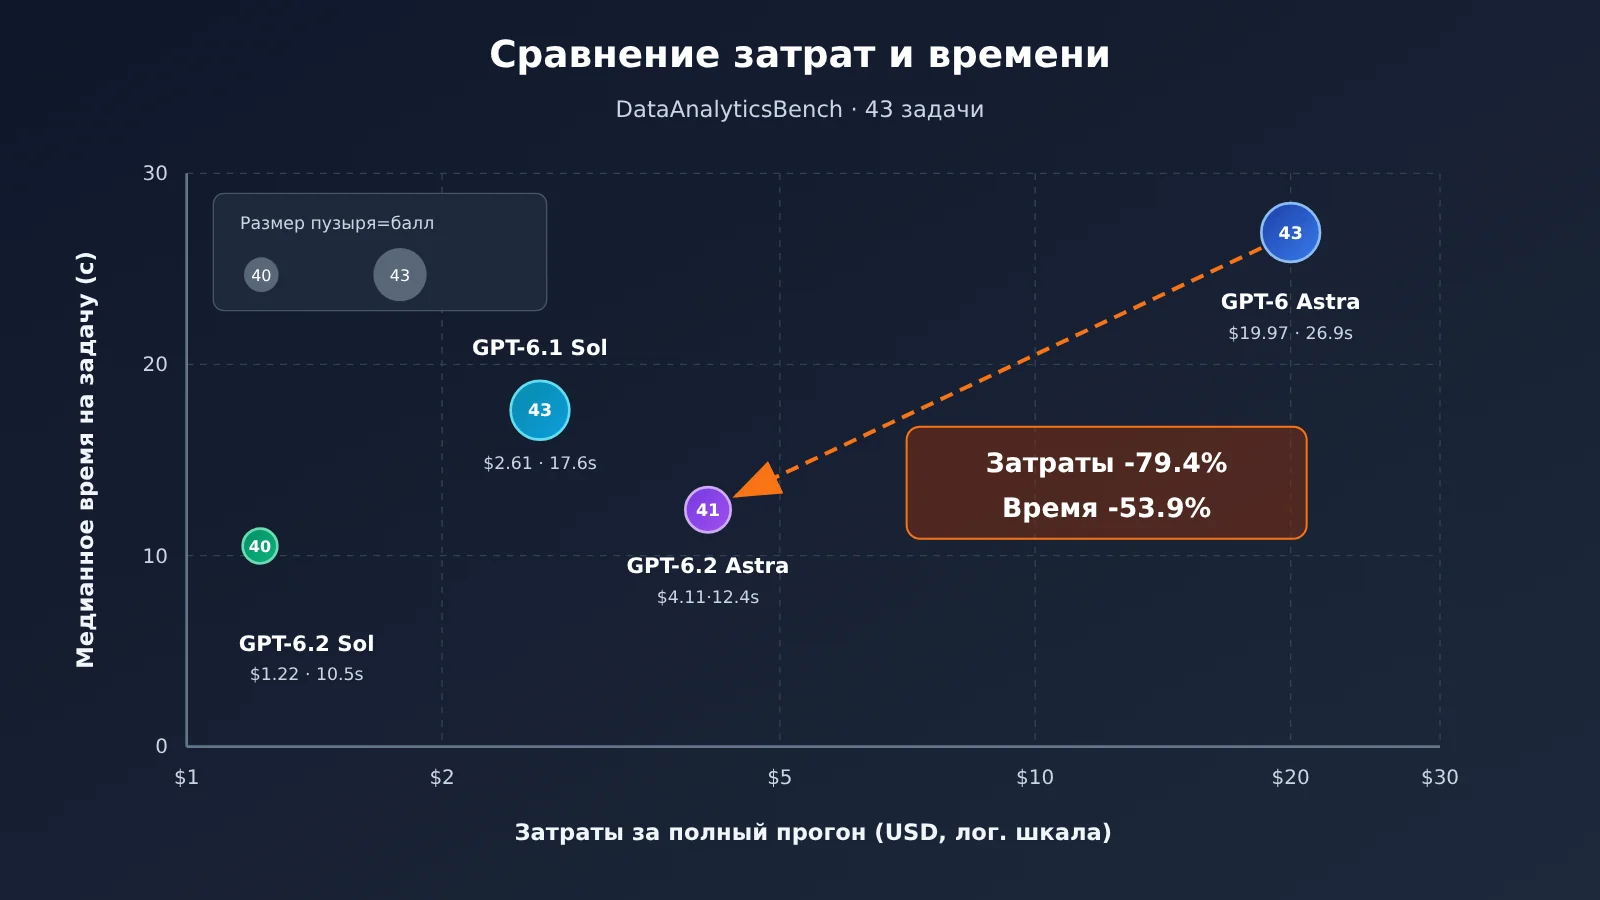
| Модель | Балл | Стоимость полного прогона | Медианное время на задачу |
|---|---|---|---|
| GPT-6.2 Astra | 41/43 | $4.11 | 12.4 секунды |
| GPT-6 Astra | 43/43 | $19.97 | 26.9 секунды |
| GPT-6.1 Sol | 43/43 | $2.61 | 17.6 секунды |
| GPT-6.2 Sol | 40/43 | $1.22 | 10.5 секунды |
Если считать по исходной таблице, у GPT-6.2 Astra стоимость полного прогона упала примерно на 79.4% по сравнению с предыдущим поколением, а медианное время на задачу сократилось примерно на 53.9%. В собственных замерах автора полный прогон 6.2 Astra занял около 13 минут, а у предыдущего поколения — около 32 минут. Время здесь — это фактически прошедшее время с учётом запросов к инструментам, а не чистое время инференса модели.
Стоимость одной задачи считают двумя способами, и их надо различать: $4.11 ÷ 43 даёт примерно $0.096 на задачу в среднем; в обновлённом общем рейтинге значение $0.066 указано как медиана стоимости одной задачи в этом прогоне. Среднее выше медианы — значит, несколько задач стоили заметно дороже остальных и подтянули среднее вверх.
Plotly также приводит детализацию объёма работы для исходных прогонов обоих поколений:
| Показатель объёма работы | GPT-6 Astra (предыдущее поколение) | GPT-6.2 Astra |
|---|---|---|
| Количество вызовов инструментов | 266 | 148 |
| Количество вызовов модели | 249 | 171 |
| Входные токены | около 9.1 млн | около 4.4 млн |
| Выходные токены | около 78 тыс. | около 34 тыс. |
| Доля попаданий в кэш входных токенов | 93% | 98% |
Plotly пересчитал прежний объём использования предыдущего поколения по новым тарифам и получил оценку около $11. Важно: эти расходы взяты из цен OpenRouter на момент тестирования Plotly, а не выведены напрямую из официального прайс-листа OpenAI.
Источник: специальный отчёт Plotly об Astra plotly.com/blog/gpt-6-2-astra-plotly-data-analytics-bench/; общий рейтинг Plotly plotly.com/blog/introducing-dataanalyticsbench/#full-results
Идентификация модели GPT-6.2 Astra и официальные ценовые параметры
OpenAI выпустила GPT-6.2 Astra и GPT-6.2 Sol 17 ноября 2026 года. Astra предназначена для сложных рассуждений, программирования и профессиональных задач; ID модели в API — gpt-6.2-astra. Оценки из анонса OpenAI отражают позицию самого производителя, а DataAnalyticsBench от Plotly — это отдельный сторонний бенчмарк; эти результаты нельзя смешивать при сравнении.
Согласно карточке модели, Astra принимает на вход текст и изображения, а на выходе выдаёт текст; контекстное окно составляет 1,050,000 токенов, максимальный объём ввода — 922,000 токенов, максимальный объём вывода — 128,000 токенов. Она поддерживает как Responses API, так и Chat Completions API; такие возможности, как встроенные инструменты, Multi-agent и окно фоновых завершений, реализуются через Responses API. В карточке модели также указано, что запросы, в которых reasoning.effort установлен в none, отклоняются.
Стандартная цена OpenAI для короткого контекста и чисто текстовых запросов (за миллион токенов) составляет: обычный ввод — $8, ввод с попаданием в кэш — $0.40, вывод — $40. По данным OpenAI, по сравнению с предыдущим поколением цена обычного ввода и вывода снижена на 20%, а цена ввода с попаданием в кэш — на 60%.
Источники: анонс OpenAI openai.com/index/introducing-gpt-6-2-astra-sol/; карточка модели developers.openai.com/api/docs/models/gpt-6.2-astra; журнал изменений API developers.openai.com/api/docs/changelog; таблица цен developers.openai.com/api/docs/pricing
GPT-6.2 Astra DataAnalyticsBench: аналитические выводы
Как читать 41/43: это не «общее ослабление»
Если разложить 41/43 по категориям, GPT-6.2 Astra не потеряла баллов в пяти типах задач: стандартный анализ, неоднозначность, вопросы без ответа, качество данных и статистические ловушки. Эти пять категорий покрывают большую часть повседневных отчётов и сверки определений. Если бизнес в основном сталкивается именно с такими задачами, то по данным этого раунда качество нового Astra сопоставимо с предыдущим поколением, а стоимость и скорость заметно лучше.
Разрыв в два балла стоит рассматривать в пределах диапазона колебаний. Plotly сообщает, что при повторных прогонах других моделей наблюдались колебания до трёх задач. Поэтому 41 против 43 уместнее воспринимать как «наблюдение этого раунда», а не как стабильную разницу в возможностях. Более точная формулировка: в категории скрытых закономерностей появился сигнал, за которым стоит следить, но одного раунда данных недостаточно, чтобы подтвердить деградацию.
Почему задачи на скрытые закономерности стоит перепроверять: объяснительная гипотеза о глубине исследования
Дальше — объяснительная гипотеза на основе данных отчёта, а не выводы Plotly. На задачах со скрытой закономерностью новое поколение делает в среднем около 9 запросов на задачу, предыдущее — около 15. Из двух проваленных задач одна — «не нашёл», другая — «нашёл место, но отбросил истинную причину». Обе выглядят как «остановился, не копнув достаточно глубоко»: в первом случае не хватило охвата поиска, во втором — на этапе проверки слишком рано был сделан отрицательный вывод.
Это может объясняться тем же изменением поведения, что и падение стоимости и задержки: модель склонна отвечать после меньшего числа запросов. На обычных задачах эта склонность напрямую превращается в эффективность; на задачах поиска корневой причины, где нужны повторные гипотезы и проверки, она может стать риском. Чтобы проверить эту гипотезу, нужно на своих данных сопоставить число запросов с процентом прохождения, а не смотреть только на итоговый балл.
Почему у GPT-6.2 Astra стоимость и скорость снизились одновременно
Падение с $19.97 до $4.11 можно разбить на два этапа, опираясь на пересчитанные данные Plotly:
- Тарифный фактор: если пересчитать прежний объём использования по новым тарифам, получится около $11, то есть только за счёт снижения цен стоимость падает примерно с $19.97 до $11 — на ~45%. Официальная цена кэшированного ввода ниже на 60%, и при доле попаданий в кэш 93–98% этот эффект особенно заметен.
- Фактор объёма работы: путь от ~$11 до $4.11 — это сокращение объёма работы. Вызовы инструментов снизились с 266 до 148, входные токены — с ~9,1 млн до ~4,4 млн, выходные токены сократились более чем вдвое, доля попаданий в кэш выросла с 93% до 98%.
Грубый расчёт нового объёма по официальным ценам даёт тот же порядок величины — около $4.11: из ~4,4 млн входных токенов 98% идут по цене кэша, остальные — по обычной цене ввода, плюс ~34 тыс. выходных токенов. Это показывает, что в таких сценариях анализа данных с длинным контекстом и многократными вызовами инструментов доля попаданий в кэш и число раундов вызова могут влиять на стоимость сильнее, чем сама цена за токен. Со скоростью то же самое: меньше запросов, меньше вызовов модели — время выполнения естественно сокращается.
💰 Совет по стоимости: при оценке затрат на такие агентские задачи фиксируйте токены с попаданием в кэш и число раундов вызова инструментов, а не смотрите только на прайс-лист. При оплате по факту через APIYI apiyi.com сверяйте поля usage в счёте и логах, чтобы проверить, работает ли кэширование.
Выбор между GPT-6.2 Astra, GPT-6.1 Sol и GPT-6.2 Sol
У четырёх моделей разные позиции:
- GPT-6.1 Sol: при этих настройках за $2.61 получает 43/43 — это самый дешёвый вариант среди «максимальных баллов» в этом раунде, но платить за это приходится медианным временем 17.6 секунды, что медленнее, чем у GPT-6.2 Astra.
- GPT-6.2 Astra: 41/43, $4.11, 12.4 секунды; преимущество появляется, когда балл и скорость оценивают вместе. Если смотреть только на стоимость и балл, модель не выигрывает.
- GPT-6.2 Sol: $1.22, 10.5 секунды — самая дешёвая и быстрая, но балл 40/43 у неё самый низкий.
- GPT-6 Astra: максимальный балл, но стоимость и задержка заметно выше; в этой группе сравнения уже трудно найти повод выбрать её первой.
Разница в баллах между ними находится в пределах колебаний до трёх заданий, о которых упоминает Plotly. Это значит, что только по общему баллу трудно выстроить надёжный порядок; действительно надёжные критерии для различения — стоимость и задержка. На практике интерактивные продукты для запросов к данным чувствительны к задержке, поэтому в первую очередь стоит сравнивать GPT-6.2 Astra и GPT-6.2 Sol; офлайн-пакетный анализ к задержке нечувствителен, и для него важнее посмотреть на соотношение цены и качества у GPT-6.1 Sol.
Как перепроверить GPT-6.2 Astra на собственных данных
Описанная ниже методика перепроверки — это редакционная рекомендация. DataAnalyticsBench покрывает только эксплуатацию ветроэнергетики, английский язык и одну среду, что сильно отличается от реального хранилища данных большинства команд. Более надёжный подход — собрать небольшой набор задач на собственных данных, зафиксировать данные, инструменты и промпты, прогонять несколько раундов и отдельно подсчитывать результаты по разным типам задач.
| Подмножество | Рекомендуемый объём | Что фиксировать | Для чего использовать |
|---|---|---|---|
| Обычные отчёты | 15–20 задач | доля успешных ответов, медианная задержка | можно ли спокойно передавать модели повседневные запросы к данным |
| Неоднозначные определения | около 5 задач | уточняет ли модель активно или объясняет допущения | чтобы не было «молчаливого выбора одного определения» |
| Статистические смещения | около 5 задач | распознаёт ли ловушки вроде парадокса Симпсона | достоверность выводов |
| Корневые причины аномалий | 5–8 задач | доля успешных ответов, число запросов, задержка P90 | сигнал о потерях баллов на задачах со скрытыми закономерностями |
| Все задачи | — | общая стоимость каждого раунда, доля попаданий в кэш | бюджет затрат |
Каждую модель рекомендуется прогонять не менее 3 раундов, записывая средние значения и разброс. Отдельно нужно фиксировать хвостовую задержку (P90): хорошая медиана ещё не значит, что самые медленные задачи приемлемы.
Ниже — минимальный пример вызова. ID модели взят из опубликованного OpenAI gpt-6.2-astra; список доступных моделей смотрите на платформе:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.2-astra",
    reasoning_effort="medium",  # в карточке модели указано, что запросы с effort = none будут отклонены
    messages=[{"role": "user", "content": "上月各风场故障工单数环比变化最大的是哪个?请说明计算口径。"}],
)
print(resp.choices[0].message.content)
Посмотреть полный скрипт перепроверки: статистика по подмножествам с долей успешных ответов, стоимостью и задержками P50/P90
import time
import statistics
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODELS = ["gpt-6.2-astra", "gpt-6-astra", "gpt-6.1-sol", "gpt-6.2-sol"]

# Собственный набор задач: category соответствует подмножеству из таблицы повторного теста,
# checker реализуете сами по ключу ответов
TASKS = [
    {"id": "r01", "category": "常规报表", "prompt": "...", "checker": lambda a: "..." in a},
    {"id": "h01", "category": "异常根因", "prompt": "...", "checker": lambda a: "..." in a},
]

# Официальная цена при прямом подключении (USD за миллион токенов), только для грубой оценки;
# по факту ориентируйтесь на счёт платформы
PRICE = {"input": 8.0, "cached": 0.40, "output": 40.0}

def estimate_cost(usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * PRICE["input"] + cached * PRICE["cached"]
            + usage.completion_tokens * PRICE["output"]) / 1_000_000

def p90(values):
    values = sorted(values)
    return values[max(0, int(len(values) * 0.9) - 1)]

def run(model, rounds=3):
    stats = {}
    for _ in range(rounds):
        for t in TASKS:
            start = time.perf_counter()
            resp = client.chat.completions.create(
                model=model,
                reasoning_effort="medium",
                messages=[{"role": "user", "content": t["prompt"]}],
            )
            elapsed = time.perf_counter() - start
            answer = resp.choices[0].message.content or ""
            s = stats.setdefault(t["category"], {"pass": 0, "n": 0, "lat": [], "cost": 0.0})
            s["n"] += 1
            s["pass"] += int(t["checker"](answer))
            s["lat"].append(elapsed)
            s["cost"] += estimate_cost(resp.usage)
    for cat, s in stats.items():
        print(f"{model} | {cat} | 通过率 {s['pass']}/{s['n']} | "
              f"P50 {statistics.median(s['lat']):.1f}s | P90 {p90(s['lat']):.1f}s | "
              f"估算费用 ${s['cost']:.3f}")

for m in MODELS:
    run(m)
Этот скрипт делает только один раунд «вопрос — ответ». Чтобы приблизиться к условиям DataAnalyticsBench, нужно ещё подключить SQL-инструмент с доступом только на чтение, дать модели самой выполнять несколько раундов запросов и дополнительно фиксировать по каждой задаче число вызовов инструмента — так можно проверить гипотезу из предыдущей части о «количестве запросов и потерянных баллах».
🎯 Совет по повторному тесту: все четыре модели работают по протоколу, совместимому с OpenAI, и через APIYI apiyi.com переключаются одним и тем же API-ключом. Бесплатного пробного лимита для новых пользователей вполне хватит, чтобы сначала прогнать один небольшой набор задач, а потом уже решать, расширять ли масштаб.
Рейтинг подсказывает направление. Но когда речь заходит о собственном хранилище данных и собственных типах аномалий, ответ можно получить только самому, запустив тесты. Лу Ю в стихотворении «Ночное чтение при свече — наставление сыну Цзыюю» писал: «Всё, что взято с бумаги, всегда поверхностно; чтобы постичь суть дела, нужно делать его самому».
Автор: техническая команда APIYI
Связь по техническим вопросам: будем рады, если напишете нам через главную страницу APIYI apiyi.com; больше материалов по подключению — в центре документации docs.apiyi.com