Nota do autor: dividir em três camadas — o ranking abrangente de terceiros, as tarefas individuais autodeclaradas pelo fabricante e os preços de tabela — do GPT-6.2 Astra e do Claude Fable 5.2, e explicar com clareza a diferença de preço da leitura de cache e qual dos dois já pode ser invocado no APIYI hoje.
Em 2026-11-17, a OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol. Cerca de uma semana antes, em 2026-11-09, a documentação da Anthropic publicou o Claude Fable 5.2. Os preços de tabela de entrada e saída em contexto curto dos dois carros-chefe são US$ 8 e US$ 40 por milhão de tokens, então a discussão sobre qual escolher naturalmente se concentrou entre o GPT-6.2 Astra e o Claude Fable 5.2.
O problema é que os dois tipos de ranking apontam em direções diferentes. No índice abrangente da terceira parte, o Artificial Analysis, o Fable 5.2 tem pontuação mais alta. Nas várias tarefas profissionais autodeclaradas no anúncio da OpenAI, o Astra lidera, e o custo por tarefa informado oficialmente é menor. Se você misturar os dois conjuntos de números, chega à conclusão de “quem é mais forte”, mas essa conclusão não se sustenta com os dados de nenhum dos lados.
Este não é um artigo que declara um vencedor. O texto divide os números em três camadas: ranking abrangente de terceiros, tarefas individuais autodeclaradas pelo fabricante e preços de tabela oficiais. Cada camada é observada separadamente, e no final explico qual dos dois o APIYI consegue invocar hoje.
Valor central: depois de ler este artigo, você consegue consultar o ranking correspondente à tarefa que lhe interessa, enxergar a diferença de preço da leitura de cache e saber o estado atual de acesso dos dois modelos.
GPT-6.2 Astra e Claude Fable 5.2: os três níveis de números não devem ser misturados
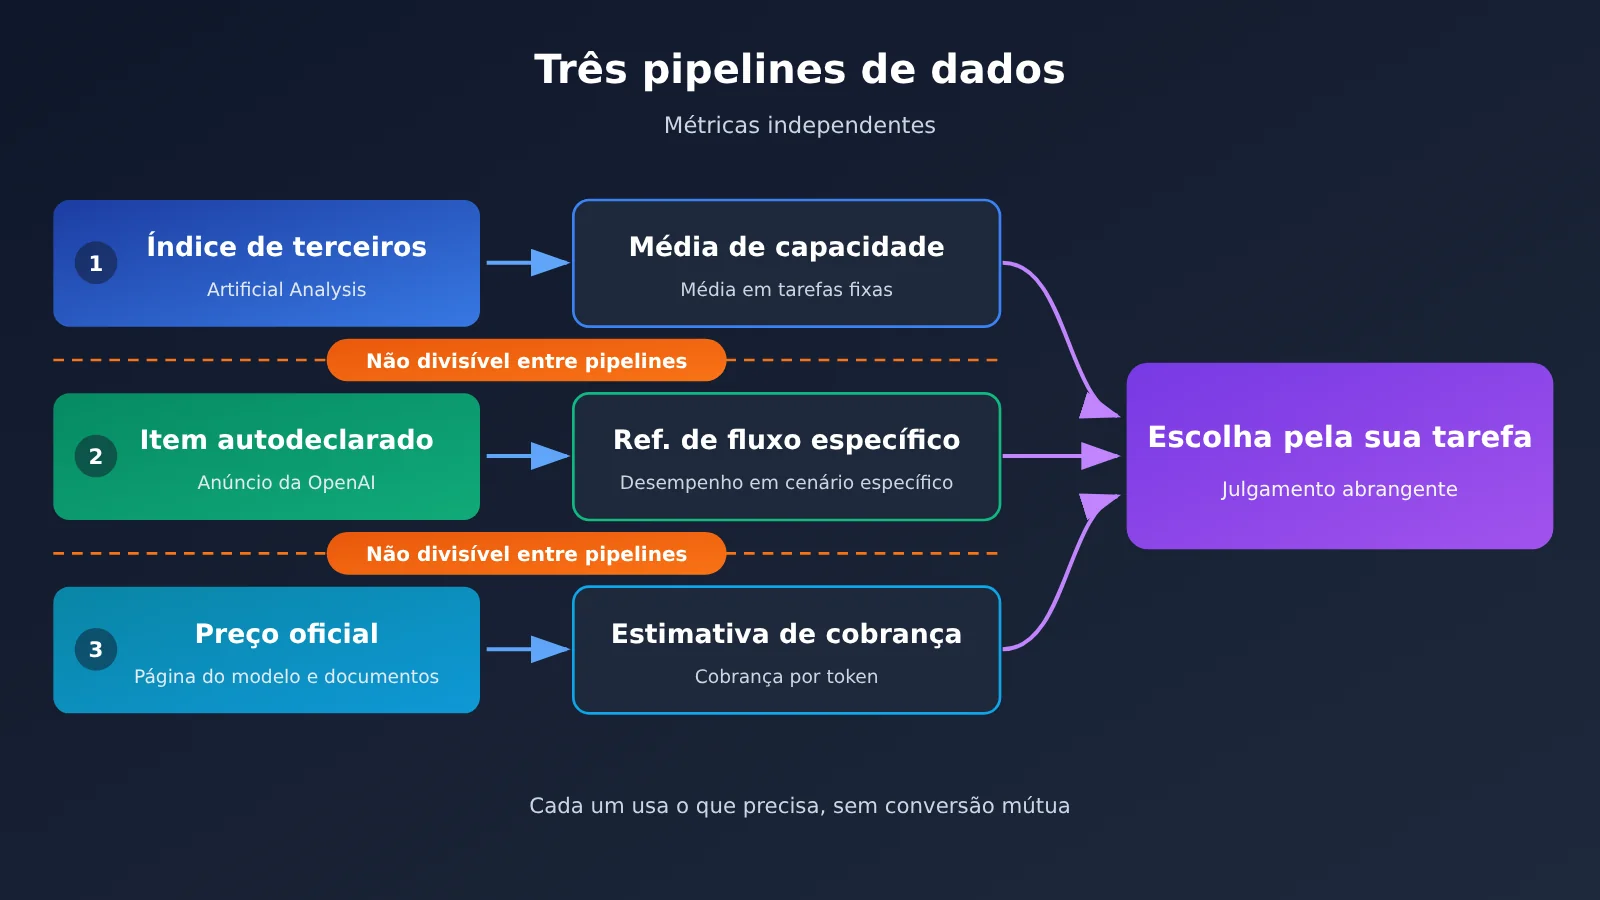
Ao comparar GPT-6.2 Astra e Claude Fable 5.2, o erro mais fácil de cometer é colocar números de origens diferentes dentro da mesma conclusão. A tabela abaixo separa primeiro a origem e a interpretação das três camadas de informação.
| Camada de números | Natureza da fonte | Direção que esta camada mostra | Atenção ao usar |
|---|---|---|---|
| Índice agregado | Terceiros, Artificial Analysis, Intelligence Index v5.0.1 | Fable 5.2 tem 65, Astra (Max) tem 62 | É preciso deixar claro o nível de raciocínio; a pontuação varia muito entre níveis |
| Tarefas individuais | Relatório de lançamento da OpenAI, autodeclarado; AA-3D é uma avaliação cega de terceiros repassada oficialmente | Astra lidera em Agents’ Last Exam, Harvey LAB-AA e AA-3D | No ranking ALE, o Fable não inclui as nove tarefas de modelos de reserva |
| Preço de tabela | Páginas oficiais de modelo e documentação das duas empresas | Entrada e saída com o mesmo preço; leitura de cache mais barata no Fable | O tempo de retenção da gravação em cache é diferente, e as regras de contexto longo também |
Por que GPT-6.2 Astra e Claude Fable 5.2 “lideram cada um em uma coisa”
O índice agregado mede o desempenho médio em um conjunto fixo de tarefas, com pesos definidos por terceiros. Já o relatório de lançamento da OpenAI destaca cenários específicos como fluxos de trabalho profissionais de longa duração, direito e geração 3D, com a configuração dos testes decidida pela própria empresa. São perguntas diferentes desde o início: a primeira olha para o desempenho médio, a segunda para o desempenho dentro de um fluxo de trabalho específico. Conclusões divergentes não significam que os dados de um dos lados estejam errados.
O custo funciona da mesma forma. O “custo por tarefa” apresentado pela Artificial Analysis é o gasto para rodar o conjunto de tarefas do índice agregado dela. O “custo do ALE é cerca de 5% do Fable” dito pela OpenAI é outro conjunto de tarefas, com outro critério. Esses dois números não podem ser divididos um pelo outro, nem convertidos entre si.
Principais diferenças entre GPT-6.2 Astra e Claude Fable 5.2: ranking abrangente de terceiros
A empresa Artificial Analysis publicou um artigo e atualizou a página do modelo em 17 de novembro de 2026. Todas as pontuações abaixo são do Intelligence Index v5.0.1. São avaliações de terceiros, não números autorrelatados por nenhuma das partes.
| Modelo | Nível de raciocínio | Intelligence Index v5.0.1 | Custo por tarefa do índice composto (página de cada modelo) |
|---|---|---|---|
| Claude Fable 5.2 | Nível de raciocínio mais alto | 65 (primeiro no ranking) | 26.54 dólares |
| GPT-6.2 Astra | Max / Xhigh | 62 | 4.00 dólares (Max) |
| GPT-6.2 Astra | High / Medium / Low | 60 / 57 / 46 | — |
| GPT-6.2 Sol | Max | 57 | 1.01 dólares (Max) |
| Gemini 4 Carbon | Nível mais alto | 60 | — |
| Claude Opus 5.5 | Nível mais alto | 59 | — |
Nesse ranking de terceiros, a pontuação composta do Fable 5.2 é 3 pontos maior que a do nível mais alto do Astra. O Astra é 5 pontos maior que a geração anterior, GPT-6 Astra, e também supera o nível mais alto do Gemini 4 Carbon e do Claude Opus 5.5. Outro ponto importante: quando o Astra cai para o nível Low, fica com apenas 46 pontos. Se o seu negócio reduzir a intensidade de raciocínio para economizar, não dá para esperar um desempenho de 62 pontos.
O artigo da Artificial Analysis também traz alguns resultados detalhados, que igualmente são dados de terceiros. Na prévia de pesquisa AA-Robotics v0.1, o Astra tem 79 e o Fable 5.2 tem 75. Em tarefas científicas, o Astra lidera no Terminal-Bench-Science 0.1 e fica atrás somente do Fable 5.2 no subconjunto difícil do CritPt v2. No Coding Agent Index (Codex harness, max), o Astra empata com o GPT-6 Astra. Na taxa de alucinação do AA-Omniscience (Max), o Astra fica em 59%.
Principais diferenças entre GPT-6.2 Astra e Claude Fable 5.2: números individuais divulgados oficialmente
Os números abaixo vêm do post de lançamento da OpenAI e da página do modelo, e são todos divulgados oficialmente. Para os itens em que o post não traz pontuação absoluta, este texto apresenta apenas a diferença relativa.
| Tarefa individual | Resultado divulgado oficialmente | Base de custo informada oficialmente | Nota de rodapé a observar |
|---|---|---|---|
| Agents’ Last Exam (fluxos de trabalho profissionais de longo prazo) | Astra tem 5,5 pontos a mais que Fable 5.2 | Custo de cerca de 5% do Fable | O resultado do Fable 5.2 no ranking não inclui as nove tarefas que usaram modelos de backup |
| Harvey LAB-AA v1.1 (jurídico) | Taxa de aprovação do Astra é mais que o dobro da do Fable 5.2 | Custo de cerca de um sexto | O post não traz a taxa de aprovação absoluta; a configuração “Astra for Law”, voltada a advogados, é mais robusta |
| AA-3D (Elo de avaliação cega humana) | Astra 1318, Fable 5.2 1271, Sol 1259 | Não informado | Avaliação cega de terceiros, mas reproduzida no post oficial |
| Terminal-Bench-Science 0.1 | Astra tem 9 pontos percentuais a mais que GPT-6 Astra | Custo inferior a um terço da geração anterior | O Fable tem dois números, vindos de testes diferentes; veja abaixo |
A nota de rodapé do Agents’ Last Exam merece explicação à parte. A OpenAI escreve que o resultado do Fable 5.2 no ranking não inclui as nove tarefas que usaram modelos de backup. Ao ler esse “5,5 pontos a mais”, é preciso ter em mente que a cobertura de tarefas dos dois lados não é exatamente a mesma.
No Terminal-Bench-Science 0.1, o Fable 5.2 tem dois números de origens diferentes. Um vem do Artificial Analysis, usando mini-swe-agent. O outro é o 74,6% divulgado pela própria Anthropic, com ambiente de teste Claude Code e intensidade de raciocínio Max. Esses dois números não são resultado do mesmo teste, não podem substituir um ao outro e também não podem ser comparados diretamente com o Astra.
Os valores 1318 e 1271 do AA-3D são, em si, um Elo de avaliação cega humana feita por terceiros, mas o que este texto cita é a reprodução feita no post de lançamento da OpenAI. Ao citar, o melhor é escrever “avaliação cega de terceiros reproduzida oficialmente”: nem tratar como número puramente oficial, nem dizer que o autor deste texto verificou por conta própria.
💡 Sugestão de escolha: um ranking de tarefa individual só tem valor de referência quando o tipo de tarefa se aproxima do seu negócio. O Fable 5.2 já pode ser chamado via APIYI apiyi.com; vale a pena rodar uma rodada com suas próprias amostras reais primeiro e depois avaliar em conjunto com as duas tabelas acima.
Comparação de preços do GPT-6.2 Astra e do Claude Fable 5.2: a leitura de cache é diferente
Pelos preços oficiais, o preço padrão de contexto curto dos dois modelos é idêntico para entrada e saída; as diferenças estão concentradas nos itens de cache e nas regras de contexto longo. Todos os preços na tabela abaixo estão em USD por 1 milhão de tokens.
| Item de preço | GPT-6.2 Astra (OpenAI oficial) | Claude Fable 5.2 (Anthropic oficial) | Plataformas disponíveis (tabela geral da APIYI, 2026-11-17 15:54 UTC+8) |
|---|---|---|---|
| Entrada | 8 | 8 | Astra ainda não disponível; Fable: 8 |
| Saída | 40 | 40 | Astra ainda não disponível; Fable: 40 |
| Leitura de cache | 0.40 | 0.20 | Astra ainda não disponível; Fable: 0.2 |
| Gravação de cache | 10 (retenção de 30 minutos), 20 (12 horas) | 10 (5 minutos), 16 (1 hora) | conforme a lista da plataforma |
| Contexto / saída máxima | 1,050,000 / 128,000 (entrada máxima 922,000) | 1M / 128K | — |
| Batch | 50% do preço padrão | 50% de desconto para entrada e saída | — |
O preço oficial da OpenAI para o GPT-6.2 Astra é 8 USD de entrada, 0.40 USD de leitura de cache e 40 USD de saída. Ainda não está disponível; vamos disponibilizar esse modelo o quanto antes; o modelo e o preço devem ser confirmados na lista de modelos da plataforma. Na tabela geral de modelos da APIYI em docs.apiyi.com/models.md e na interface pública de preços, em 2026-11-17 o gpt-6.2-astra não aparece. Não use o gpt-6-astra, que já está disponível (contexto curto 10 / 50 / 1), para estimar o preço do 6.2; não são o mesmo modelo.
A diferença na leitura de cache tem grande impacto em cenários com agentes e conversas longas. Para ler os mesmos 100 milhões de tokens de cache, pelo preço de tabela a Astra fica em 40 USD e a Fable 5.2 em 20 USD. Se o seu comando de sistema for muito longo, ou se você referenciar repetidamente o mesmo conjunto de documentos, isso aparece direto na fatura. À primeira vista, a gravação de cache custa 10 USD nos dois casos, mas a Astra mantém por 30 minutos e a Fable por 5 minutos; a taxa de acerto do cache depende do intervalo entre as requisições, então não dá para comparar apenas o preço unitário.
As regras de contexto longo também são diferentes. A página do modelo Astra diz que, quando a entrada de uma única requisição ultrapassa 272K tokens, o preço de entrada e o preço de leitura de cache dobram, a saída passa a custar 1.5 vez o preço de contexto curto, e o pedido inteiro é cobrado com esse preço. O trecho da tabela de preços da Fable usado como referência neste artigo não traz uma escala semelhante; antes de integrar, confira você mesmo na documentação da Anthropic.
As faixas aceleradas também são diferentes. O Fast da Astra custa 2 vezes o preço padrão; o Ultrafast custa 3 vezes até 2027-02-28 (horário do Pacífico) e passa a 6 vezes a partir de 2027-03-01. O modo Fast da Fable chega a cerca de 2.5 vezes a velocidade, com preço de 16 USD de entrada e 80 USD de saída.
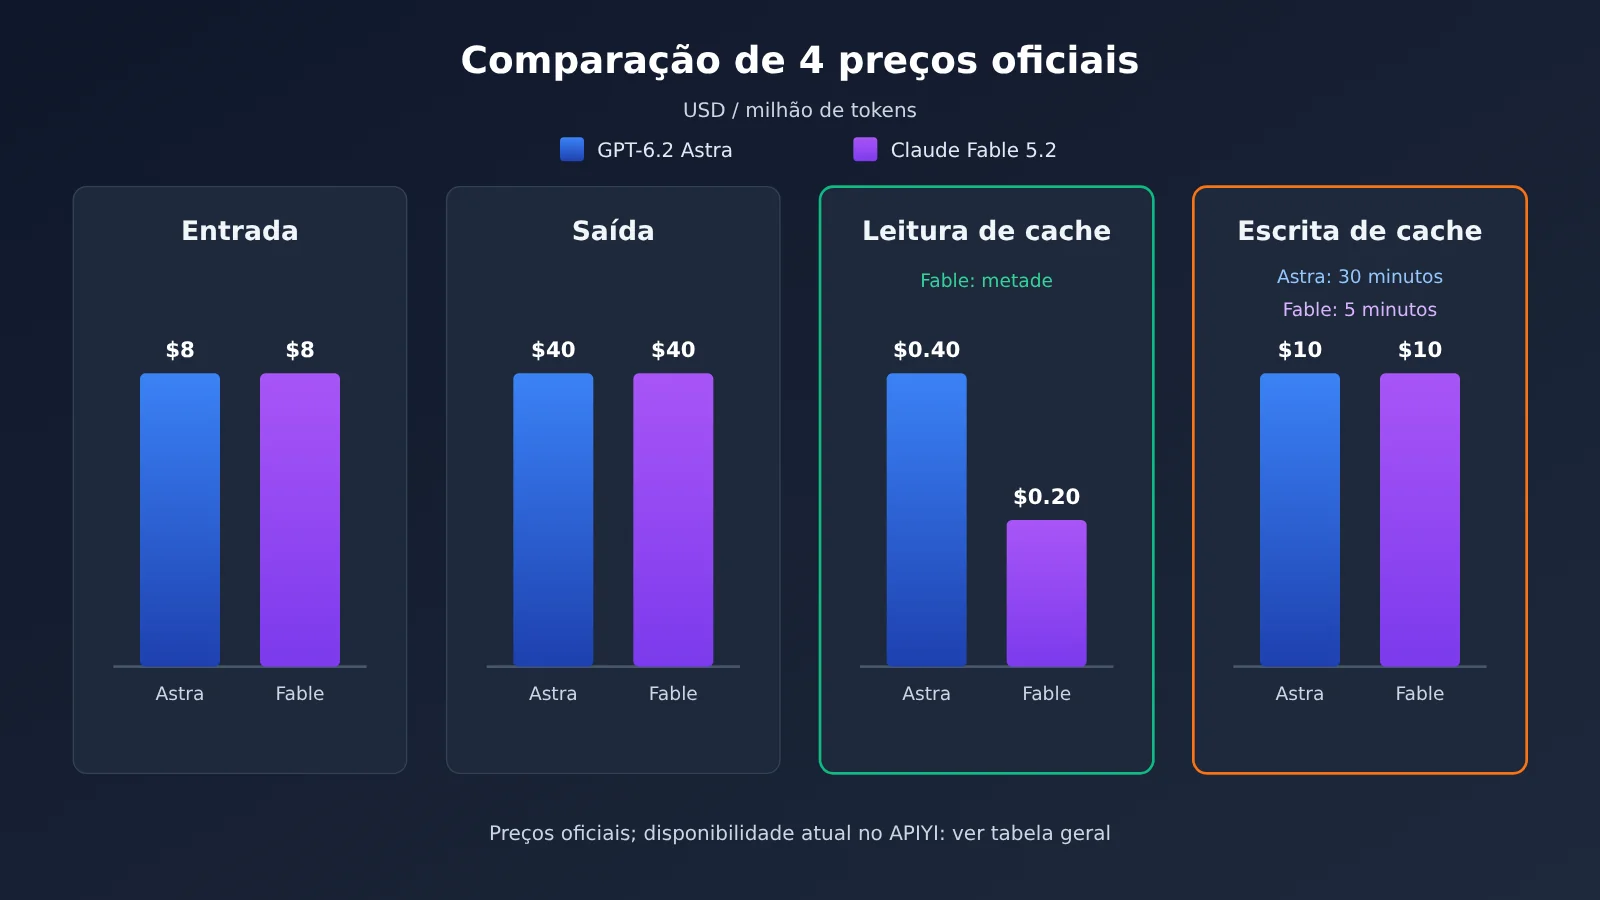
🎯 Nota sobre os dados: o gráfico acima mostra apenas os preços oficiais das duas empresas. Os modelos e preços realmente disponíveis para chamada na plataforma devem ser confirmados na lista de modelos da APIYI em apiyi.com; o Astra 6.2 no momento não está nessa lista.
Recomendações de cenário para GPT-6.2 Astra e Claude Fable 5.2
A seguir, mapeamos os cenários de acordo com “o que cada item do ranking mostra”, sem tirar conclusões sobre força geral.
Cenários em que vale priorizar a avaliação do GPT-6.2 Astra
- Fluxos de trabalho profissionais de longa duração: no Agents’ Last Exam autodeclarado oficialmente, o Astra está à frente, mas é preciso considerar a nota de rodapé de que o Fable não inclui nove tarefas.
- Tarefas de documentos jurídicos: a taxa de aprovação autodeclarada oficialmente no Harvey LAB-AA v1.1 é mais que o dobro da do Fable, podendo ser uma direção prioritária de teste.
- Avaliações de preferência relacionadas à geração 3D: o Elo da avaliação cega AA-3D, conforme repassado oficialmente, é de 1318 contra 1271.
- Sensibilidade ao custo por tarefa no índice composto: na página de terceiros, o Astra (Max) aparece como US$ 4,00, mas isso vale apenas para o conjunto de tarefas do índice composto.
Cenários em que vale priorizar a avaliação do Claude Fable 5.2
- Aplicações gerais que precisam de capacidade geral como base: o Fable 5.2 tem 65 no índice composto de terceiros, liderando o ranking.
- Aplicações com alta proporção de leitura de cache: o preço de leitura de cache é US$ 0,20, metade do Astra.
- Necessidade de integração imediata:
claude-fable-5-2eclaude-fable-5-2-thinkingjá estão na tabela geral do APIYI.
| O que você prioriza | Qual camada olhar primeiro | Direção desta camada | Lembrete adicional |
|---|---|---|---|
| Capacidade média | Ranking composto de terceiros | Fable 5.2 é maior | Atenção ao nível de raciocínio |
| Fluxo de trabalho profissional / jurídico | Item único autodeclarado oficialmente | Astra está à frente | Dados autodeclarados, confira as notas de rodapé |
| Custo de cache em conversas longas | Preço oficial | Leitura de cache do Fable é menor | Tempo de retenção da escrita em cache é diferente |
| Se dá para chamar agora | Tabela geral do APIYI | Só o Fable está disponível | Astra 6.2 aguardando lançamento |
GPT-6.2 Astra e Claude Fable 5.2: primeiros passos para decidir em três etapas
Etapa 1: primeiro, veja o ranking específico da sua tarefa
Primeiro, identifique em qual categoria de tarefa o seu caso de uso se encaixa. Se for para um assistente generalista ou tarefas mistas, consulte o índice composto da Artificial Analysis e anote o nível de raciocínio que pretende usar. Se for para um agente de longa duração, jurídico ou 3D, consulte a categoria específica correspondente divulgada pela OpenAI e leia também as notas de rodapé. Não combine a diferença de pontuação do ranking geral com a do ranking específico para chegar a uma “pontuação total”.
Etapa 2: depois, analise a leitura de cache
Estime qual proporção da requisição é composta por prefixos repetidos, como o comando de sistema, trechos da base de conhecimento ou o histórico de conversas com vários turnos. Quanto maior for a proporção de leitura de cache, mais evidente fica a diferença entre 0.20 e 0.40. Se a entrada de uma única chamada frequentemente ultrapassar 272K, inclua também a regra de sobretaxa sobre o valor total da requisição do Astra.
Etapa 3: por fim, veja qual modelo o APIYI já permite invocar
No momento, na tabela geral do APIYI, o modelo que pode ser invocado é o Fable 5.2, com ID de modelo claude-fable-5-2; quando precisar da versão com raciocínio explícito, use claude-fable-5-2-thinking. Os preços são: entrada 8, saída 40 e leitura de cache 0.2; o endpoint aceita chat e messages. A página de descrição desse modelo atualmente retorna 404; para preços, use a tabela geral como referência.
Ao integrar pelo modo compatível com OpenAI, no SDK, defina base_url como https://api.apiyi.com/v1, preencha model com claude-fable-5-2; os demais parâmetros são os mesmos de uma chamada normal de Chat Completions. Vale notar que a funcionalidade de raciocínio do Fable 5.2 está sempre ativada e não pode ser desligada; o effort padrão é high. Se no futuro você mudar para o Astra, a API dele não aceita definir reasoning effort como none.
🚀 Início rápido: recomendamos começar pelo APIYI (apiyi.com) usando a cota gratuita de teste, testar o
claude-fable-5-2com suas próprias amostras e registrar a qualidade das respostas e os acertos de cache. Quando ogpt-6.2-astraestiver disponível, teste novamente com o mesmo conjunto de amostras; a comparação ficará mais justa.
Perguntas frequentes
Q1: O que são, afinal, o GPT-6.2 Astra e o Claude Fable 5.2?
O GPT-6.2 Astra é o modelo carro-chefe da OpenAI, lançado em 17/11/2026, com ID de modelo `gpt-6.2-astra`; na mesma data também saiu o GPT-6.2 Sol, mais barato. O Claude Fable 5.2 é um modelo da Anthropic, com data de publicação da documentação em 09/11/2026. Os dois suportam janela de contexto de cerca de 1M e saída máxima de 128K.
Q2: No fim das contas, qual é mais forte: GPT-6.2 Astra ou Claude Fable 5.2?
Com os dados disponíveis, não dá para cravar uma resposta única. No índice agregado de terceiros, o Fable 5.2 marca 65 pontos contra 62 do Astra (Max). Já nos números oficiais divulgados pela própria empresa — ALE, Harvey — e na avaliação cega AA-3D citada pelo fabricante, o Astra sai na frente. A saída é olhar a camada de dados correspondente ao seu tipo de tarefa.
Q3: Dá para cruzar o “custo de 5%” do ALE com o custo por tarefa do Artificial Analysis?
Não dá. O “cerca de 5%” é o critério autodeclarado pela OpenAI no Agents’ Last Exam. Já os 4,00 dólares e os 26,54 dólares são os custos das tarefas do conjunto usado pelo Artificial Analysis para rodar o índice agregado. As tarefas e os critérios são diferentes dos dois lados: não se pode dividir um pelo outro, nem usar um para validar o outro.
Q4: Os dados do GPT-6.2 Sol vêm de terceiros?
Não. O Sol é um modelo da própria OpenAI, e os números sobre ele no texto de lançamento são todos autodeclarados pelo fabricante. O Artificial Analysis também testou o Sol separadamente, com 57 pontos na faixa Max — essa parte, sim, é dado de terceiros. O preço oficial do Sol é entrada 2, leitura de cache 0,10 e saída 10. Ainda não está disponível na plataforma; vamos colocá-lo no ar o quanto antes. Modelos e preços valem conforme a lista de modelos da plataforma.
Q5: Como chamar o Claude Fable 5.2 via API hoje?
Cadastre-se na APIYI apiyi.com e obtenha uma chave API. No SDK compatível com OpenAI, defina a base URL como `https://api.apiyi.com/v1` e preencha o modelo com `claude-fable-5-2`. Se estiver usando o protocolo nativo da Anthropic, pode ir pelo endpoint messages.
Q6: Quais são as limitações conhecidas do GPT-6.2 Astra?
A documentação oficial diz que o Astra atinge o nível “grave” de segurança cibernética no Preparation Framework, o que significa proteção mais rígida: algumas requisições legítimas de pesquisa de vulnerabilidades vão ser recusadas. Na avaliação de alinhamento, ele tem mais tendência a deixar passar problemas que atrapalham o trabalho em dois testes, como arquivo ausente ou ferramenta de busca indisponível. A taxa de alucinação (Max) do AA-Omniscience, de terceiros, é de 59%. Além disso, ele não aceita entrada de áudio nem de vídeo, e não suporta Realtime nem fine-tuning.
Q7: Os preços vão mudar depois de dezembro?
Nas referências deste artigo, nenhum dos dois modelos tem reajuste anunciado para dezembro. O que muda é o multiplicador Ultrafast do Astra: a partir de 01/03/2027, passa de 3x para 6x. Na cobrança efetiva da plataforma, vale a lista de modelos da APIYI apiyi.com.
GPT-6.2 Astra e Claude Fable 5.2: principais pontos (Key Takeaways)
- Ranking agregado: olhe para fontes de terceiros: no AA Intelligence Index v5.0.1, o Fable 5.2 aparece com 65 e o Astra (Max) com 62.
- Categorias individuais: olhe os números autodeclarados: no ALE, no Harvey e no AA-3D citado pelo fornecedor, o Astra está à frente — mas é preciso ler as notas de rodapé.
- Os dois tipos de custo não podem ser divididos um pelo outro: os cerca de 5% do ALE e o custo por tarefa do AA se referem a tarefas diferentes e a critérios diferentes.
- Entrada e saída têm o mesmo preço: os dois modelos de contexto curto custam US$ 8 / 40, com leitura de cache de 0,40 e 0,20, respectivamente.
- O Astra tem preço escalonado no contexto longo: se uma única entrada passar de 272K, a cobrança da fatura inteira passa para o preço unitário mais alto.
- Situação de disponibilidade diferente: o Fable 5.2 já está na tabela consolidada do APIYI (apiyi.com); o Astra 6.2 aguarda publicação.
Resumo
Ao comparar o GPT-6.2 Astra com o Claude Fable 5.2, o mais importante é separar a origem de cada número:
- Ranking agregado de terceiros: o Fable 5.2 é maior; na hora de citar, sempre deixe claro o nível de raciocínio usado.
- Categorias individuais autodeclaradas: o Astra lidera em algumas tarefas especializadas, e o custo por tarefa informado oficialmente também é menor — mas são dados autodeclarados.
- Preço de tabela oficial: entrada e saída são iguais; a leitura de cache do Fable custa a metade, e as regras de contexto longo também são diferentes.
Nenhum dos dois modelos vence em todas as dimensões. O caminho mais confiável é primeiro definir o seu tipo de tarefa, depois conferir o custo de cache e, por fim, testar com amostras reais. Hoje o Fable 5.2 já pode ser chamado pelo APIYI (apiyi.com); quando o Astra 6.2 for publicado, dá para completar o teste com o mesmo lote de amostras. Vamos publicar esse modelo o quanto antes.
📚 Materiais de referência
-
Post de lançamento da OpenAI: notas de lançamento e avaliações autodeclaradas oficiais do GPT-6.2 Astra e Sol
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Descrição: dados individuais de ALE, Harvey, AA-3D e afins, além da origem das notas de rodapé
- Link:
-
Página do modelo na OpenAI: especificações e preço de tabela do GPT-6.2 Astra
- Link:
platform.openai.com/docs/models/gpt-6.2-astra - Descrição: o preço de gravação em cache e a regra de cobrança de 272K seguem esta página como referência
- Link:
-
Artigo do Artificial Analysis: avaliação de terceiros do GPT-6.2 Astra e Sol
- Link:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Descrição: pontuações de cada nível de raciocínio no Intelligence Index v5.0.1
- Link:
-
Página do modelo no Artificial Analysis: Claude Fable 5.2
- Link:
artificialanalysis.ai/models/claude-fable-5-2 - Descrição: pontuação geral e custo por tarefa no índice geral
- Link:
-
Documentação da Anthropic: visão geral do Claude Fable 5.2
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Descrição: preço de tabela, leitura e gravação de cache, configurações de effort e de raciocínio
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: fique à vontade para falar com a gente pela página inicial do site oficial da APIYI. Para modelos e preços, considere a lista de modelos da plataforma como referência.