Nota do autor: a partir de quatro ângulos — modalidades, precificação de contexto longo, pontuação composta de terceiros e a mudança de preços de 1º de dezembro —, este artigo destrincha a lógica de escolha entre GPT-6.2 Sol e Gemini 4 Carbon e explica por que “preço de tabela igual” não significa “fatura igual”.
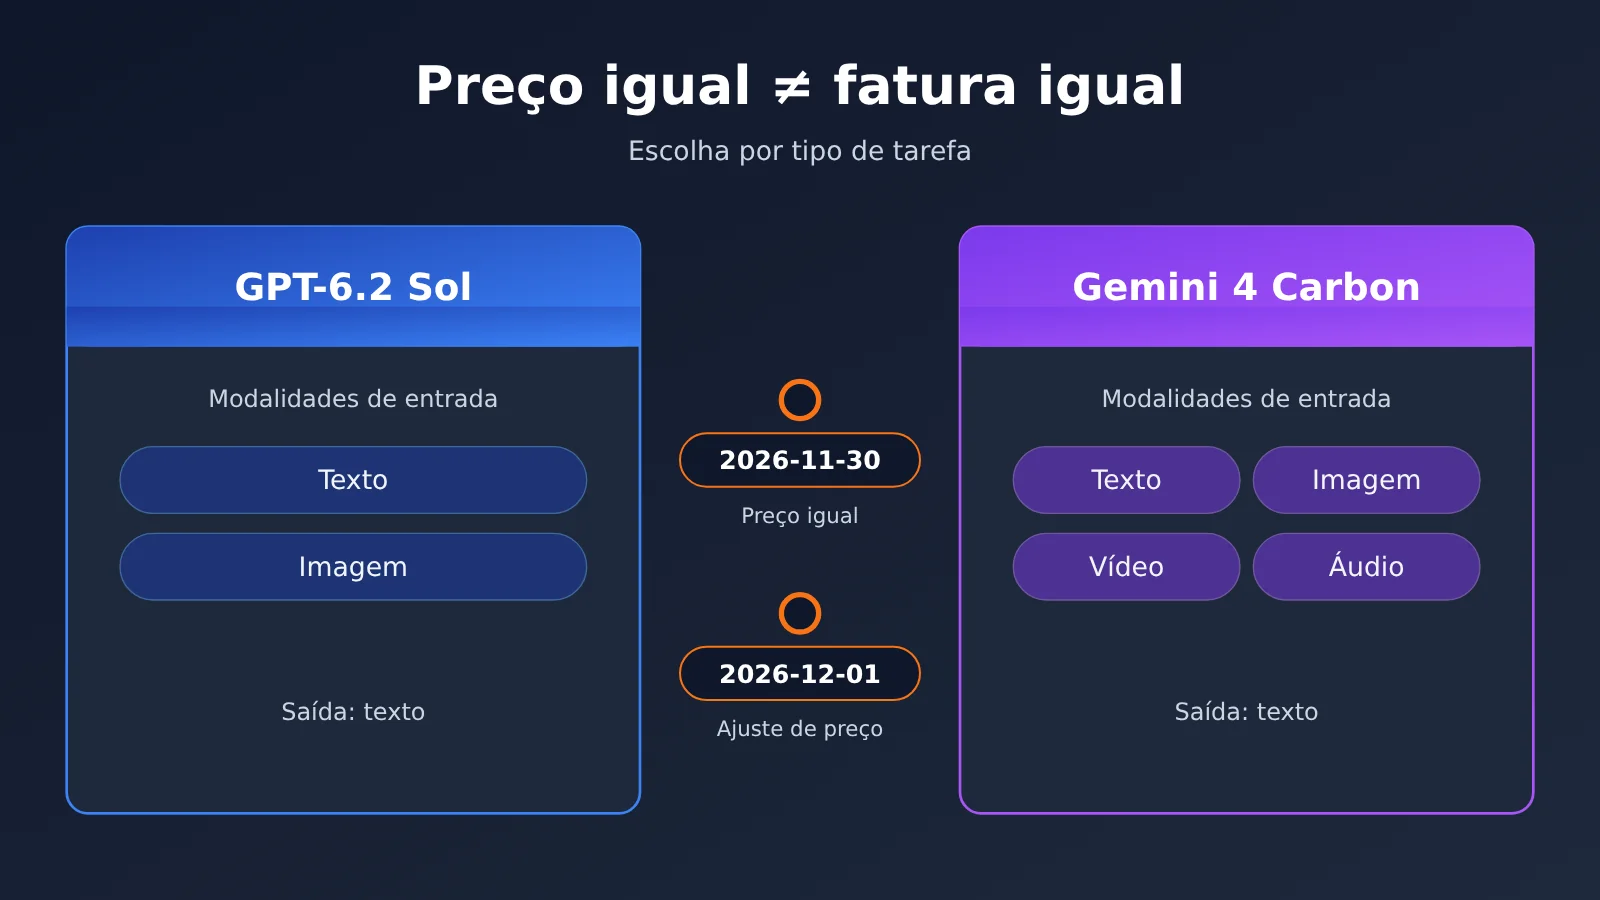
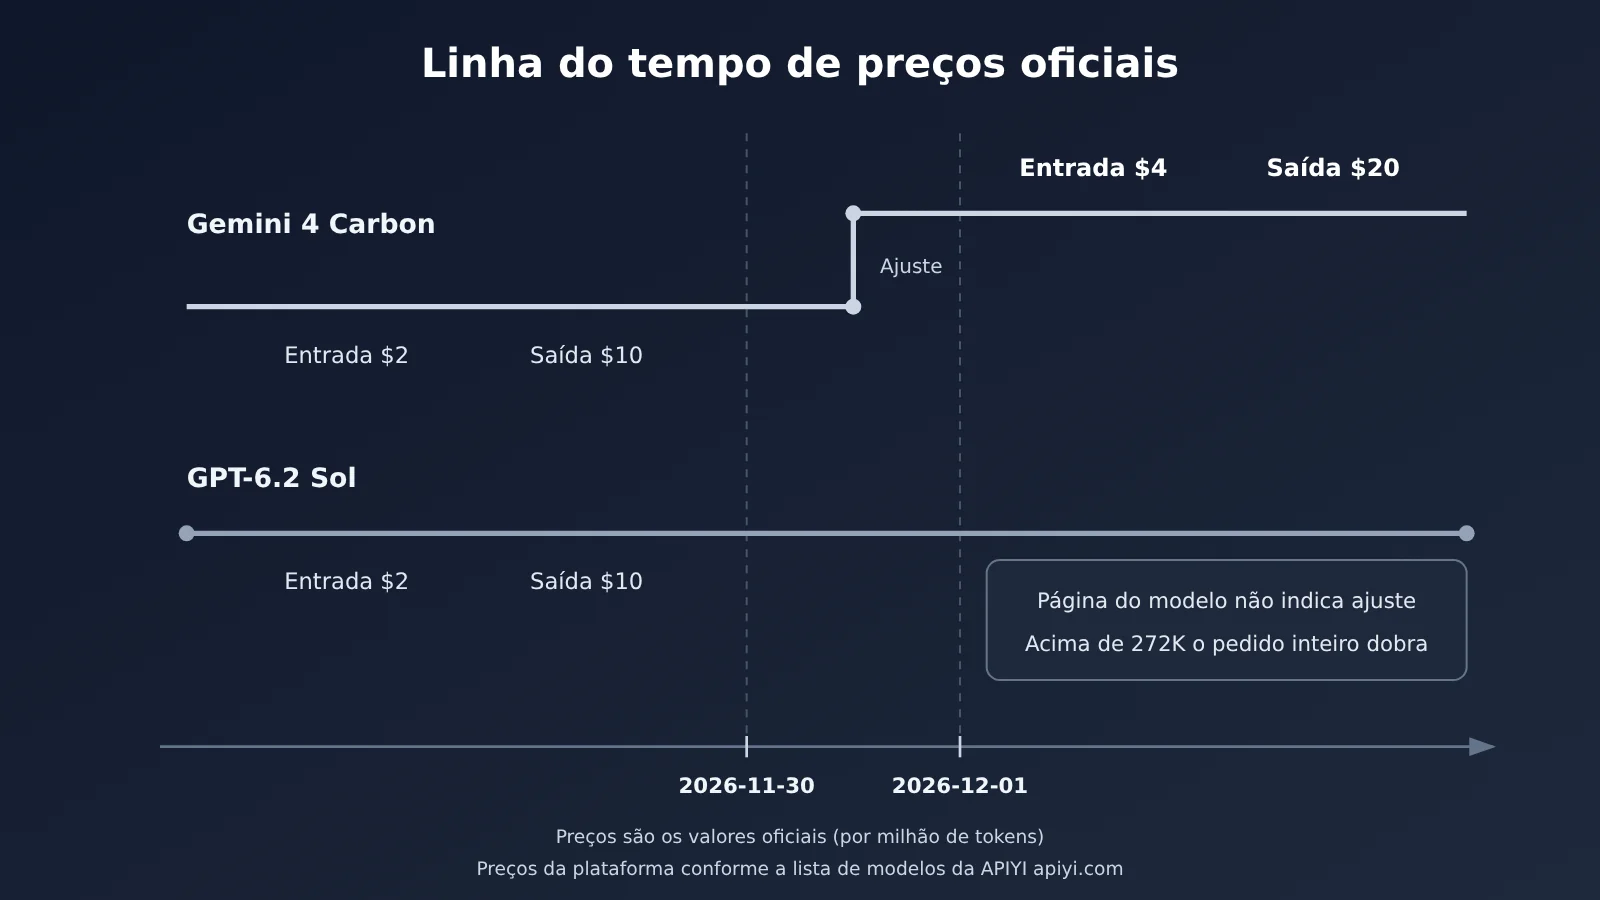
Em 17 de novembro de 2026, a OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol. Uma semana antes, em 10 de novembro, a Google lançou o Gemini 4 Carbon. Abra as tabelas de preços oficiais dos dois lados e você vai ver que até 2026-11-30, o preço padrão de contexto curto dos dois modelos é exatamente o mesmo: US$ 2 de entrada, US$ 10 de saída e US$ 0,10 de leitura de cache (por 1 milhão de tokens).
Este não é um artigo para decretar “quem é mais barato”. Os números da tabela de preços são iguais, mas as regras de precificação, as modalidades suportadas e a pontuação composta de terceiros não são — e os preços oficiais do Carbon também mudam a partir de 1º de dezembro. Quando você sobrepõe essas diferenças às suas requisições reais, a fatura dos dois lados pode ficar bem diferente.
Valor central: ao terminar a leitura, você vai lembrar de uma data limite (2026-11-30) e vai conseguir julgar, pelo tipo de tarefa que precisa executar, qual dos dois — GPT-6.2 Sol ou Gemini 4 Carbon — é a escolha mais adequada.
Pontos principais do GPT-6.2 Sol e do Gemini 4 Carbon
Começamos com uma tabela reunindo as informações que mais pesam na hora de escolher. Os preços listados são os oficiais dos fabricantes, por 1 milhão de tokens; a pontuação geral vem da Artificial Analysis, avaliação independente de terceiros, com o nível de raciocínio indicado.
| Ponto | GPT-6.2 Sol | Gemini 4 Carbon | Relevância para a escolha |
|---|---|---|---|
| Preço oficial com contexto curto (até 30/11) | Entrada $2 / Saída $10 / Leitura de cache $0.10 | Entrada $2 / Saída $10 (inclui tokens de raciocínio) / Leitura de cache $0.10 | Mesmo preço de tabela, mas regras de cobrança diferentes |
| Preço oficial a partir de 1º de dezembro | A página do modelo não menciona reajuste | Entrada $4 / Saída $20 / Leitura de cache $0.20 | O preço introdutório do Carbon tem data limite |
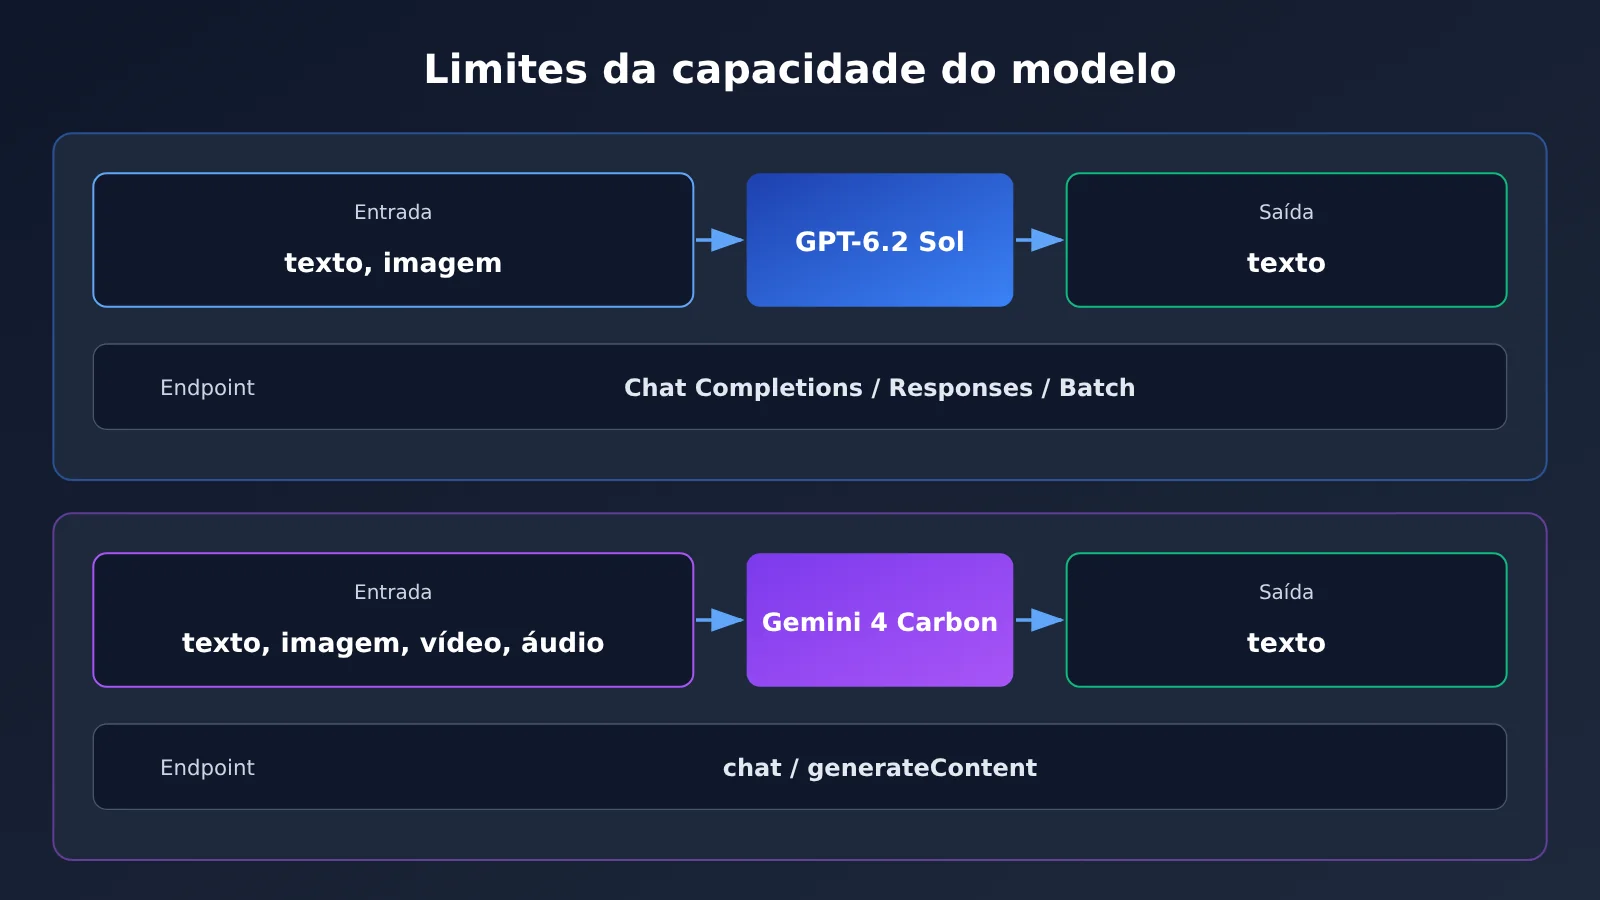
| Modalidades de entrada | Texto, imagem | Texto, imagem, vídeo, áudio | Diferença fica evidente quando há demanda de áudio e vídeo |
| Pedido total em dobro para entradas acima de 272K | Aplicável | A tabela de preços do Google não tem essa linha | Cenários com documentos longos exigem cálculo à parte |
| Pontuação geral de terceiros (AA Intelligence Index v5.0.1) | Nível de raciocínio Max: 57 | Nível máximo de raciocínio: 60 | Métrica de terceiros; não equivale ao desempenho na sua tarefa |
GPT-6.2 Sol e Gemini 4 Carbon em detalhes
O GPT-6.2 Sol é o modelo posicionado como “eficiente” no lançamento da OpenAI. Segundo a página oficial do modelo, ele aceita apenas texto e imagem como entrada e gera somente texto, com janela de contexto de 1.050.000 tokens, entrada máxima de 922.000, saída máxima de 128.000 e corte de conhecimento em 01/06/2026. Quanto aos endpoints, há suporte para Chat Completions, Responses e Batch, mas não para Realtime, Assistants, fine-tuning, geração de imagens, vídeo e voz. E um detalhe que costuma pegar todo mundo de surpresa: a API não aceita definir o reasoning effort como none.
O Gemini 4 Carbon se destaca pela cobertura de modalidades mais completa. De acordo com a página de documentação da APIYI, ele aceita texto, imagem, vídeo e áudio como entrada, gera texto como saída, tem contexto de 1.048.576 tokens, saída máxima de 65.536 e corte de conhecimento em março de 2026. A página de preços do Google deixa claro que o Carbon suporta apenas cache implícito e também não tem nível gratuito. O preço introdutório dele é o mesmo do Argon, e a nota de rodapé das release notes indica que após 30 de novembro os valores passam a ser $4 / $20.
Principais diferenças entre GPT-6.2 Sol e Gemini 4 Carbon
Ao colocar os dois modelos lado a lado, o que realmente determina a fatura e a experiência são os critérios abaixo. Aqui não há uma coluna de “vencedor”, porque a vantagem de cada item depende do formato das suas requisições.
| Critério de comparação | GPT-6.2 Sol | Gemini 4 Carbon | Como avaliar |
|---|---|---|---|
| Janela de contexto / Saída máxima | 1,050,000 / 128,000 | 1,048,576 / 65,536 | Se você precisa de saídas muito longas, fique de olho no limite do Sol |
| Precificação de entradas longas | Acima de 272K, o preço unitário de entrada e de cache dobra e a saída custa 1,5x — cobrado pela requisição inteira | A tabela de preços oficial não lista essa regra | Para processar documentos longos em lote, faça a estimativa separadamente |
| Mecanismo de cache | A escrita do cache é cobrada à parte: 30 minutos por $2.50, 12 horas por $5 | Suporta apenas cache implícito | A taxa de acerto do cache impacta diretamente a fatura |
| Tokens de raciocínio | Suporta raciocínio, e o effort não pode ser definido como none | O preço de saída já inclui os tokens de raciocínio | O tamanho do raciocínio amplia o volume real de saída |
| Validade dos preços | A página do modelo não menciona reajuste | Dobram a partir de 1º de dezembro | Projetos que atravessam meses devem ser calculados em dois períodos |
| Diferença de preço por região | Não abordado | Nas regiões do Cloud fora da zona global, cerca de 10% mais caro | A região de implantação influencia o preço unitário |
GPT-6.2 Sol e Gemini 4 Carbon: por que a fatura pode ser diferente mesmo com o mesmo preço de tabela
O primeiro motivo é o tempo. Até 2026-11-30, o preço oficial padrão do Carbon é de $2 para entrada, $10 para saída e $0.10 para leitura de cache; a partir de 2026-12-01, passa a ser $4 de entrada, $20 de saída e $0.20 de leitura de cache. A região global do Google Cloud cobra o mesmo, e as regiões fora da global saem cerca de 10% mais caras — até 30 de novembro, entrada de $2.20 e saída de $11. A página do modelo do Sol não menciona nenhum reajuste parecido, então, num projeto que atravessa dezembro, o orçamento da parte do Carbon precisa ser calculado em dois períodos.
O segundo motivo é a regra de entrada longa. A página do modelo do Sol deixa claro: quando a entrada de uma única requisição passa de 272K tokens, os preços unitários de entrada e de cache dobram, e a saída é cobrada a 1.5x o valor do contexto curto — tudo calculado sobre o pedido inteiro, e não apenas sobre a parte que excede o limite. A tabela do Google não tem nenhuma linha assim. Se suas requisições costumam passar de 272K, mesmo com os preços de contexto curto idênticos, o preço unitário real já é diferente dos dois lados.
O terceiro motivo são os próprios tokens. Modelos diferentes tokenizam e raciocinam de formas diferentes: o mesmo trecho de texto, a mesma pergunta, pode gerar quantidades distintas de tokens de entrada e saída em cada lado. O preço de saída do Carbon já inclui os tokens de pensamento, e o Sol também gera tokens de raciocínio — ou seja, comparar só o preço unitário, sem olhar o consumo real, leva a conclusões pouco confiáveis.
Agora, os preços da plataforma. Segundo os dados da tabela geral da APIYI de 2026-11-17 15:54 (UTC+8) e o endpoint público de preços consultado no mesmo dia, o modelo disponível para invocação na plataforma é o gemini-4-carbon, com preço listado de $2 de entrada, $0.1 de leitura de cache e $10 de saída, nos grupos Default e SVIP, multiplicador 1. Vale destacar: essa página traz o preço introdutório e não menciona o reajuste do Google em 1º de dezembro — depois dessa data, use como referência os preços em tempo real da lista de modelos da APIYI em apiyi.com.
Quanto ao GPT-6.2 Sol, os preços oficiais padrão da OpenAI para contexto curto são: $2 de entrada, $0.10 de leitura de cache, $2.50 de escrita de cache (30 minutos) e $10 de saída; Batch custa 50% do preço padrão, Fast custa 2x, e o Ultrafast custa 3x até 2027-02-28 (horário do Pacífico) e 6x a partir de 2027-03-01. Ele ainda não está disponível na plataforma, mas vamos publicá-lo o quanto antes; confirme modelo e preço na lista de modelos da plataforma. Os modelos gpt-6.1-sol e gpt-6-sol da plataforma são versões anteriores, e seus preços não podem ser usados como referência para o 6.2.
Pontuação agregada de GPT-6.2 Sol e Gemini 4 Carbon: veja separadamente os dados de terceiros e os oficiais
No Intelligence Index v5.0.1, da fonte independente Artificial Analysis, as pontuações do GPT-6.2 Sol em cada nível de raciocínio foram: Max 57, Xhigh 56, High 55, Medium 53 e Low 41; o artigo informa que o Gemini 4 Carbon chega a 60 no nível mais alto de raciocínio. A mesma fonte menciona que, no nível Max, o custo por tarefa do índice agregado do Sol foi de US$ 1,01 e que, no Coding Agent Index (Codex harness, max), ele ficou 3 pontos abaixo do GPT-6.1 Sol — principalmente porque perdeu 14 pontos no SWE-Atlas-QnA-AA, com maior tendência de omitir fatos-chave; a taxa de alucinação no AA-Omniscience (Max) ficou em 55%. Os materiais de terceiros não informam o custo por tarefa do Carbon, e aqui não faremos nenhuma estimativa.
Os números oficialmente autodeclarados pela OpenAI seguem outra régua. Segundo a própria empresa, no FrontierCode 2.0 o GPT-6.2 Sol ficou a menos de 0,5 ponto do Astra, com cerca de um quinto do custo (ambos no nível Max); no LifeVal, benchmark criado pela própria OpenAI, o Sol pontuou acima do GPT-6 Astra, com cerca de um sétimo do custo; e, no GDPval v2, o Sol ficou 5,3 pontos acima do GPT-6.1 Sol. São dados autodeclarados, com conjuntos de teste, níveis de raciocínio e modelos de comparação diferentes dos usados por terceiros — as duas séries de números não devem ser misturadas numa única conclusão do tipo “quem é mais forte”.
Recomendações de cenários: GPT-6.2 Sol vs Gemini 4 Carbon
A escolha do modelo, no fim das contas, depende do tipo de trabalho que você precisa fazer. Abaixo vão as tendências por formato de tarefa — com um pressuposto: você vai validar tudo de novo nos seus próprios dados.
Cenários para escolher o GPT-6.2 Sol
- Precisa de saídas únicas muito longas: a saída máxima do Sol é de 128,000 tokens, ideal para gerar relatórios longos e arquivos de código extensos de uma só vez.
- Já construiu fluxos de trabalho baseados na interface Responses: o Sol é compatível com Responses; o Carbon não tem o endpoint Responses na APIYI.
- A maioria das requisições fica dentro de 272K e você consegue usar cache explícito: a escrita de cache do Sol tem precificação separada, e a leitura do cache custa apenas $0.10 — quando a taxa de acerto é alta, o controle de custos fica mais fácil.
- Tarefas cotidianas de escritório e modificações em código: os resultados auto-reportados oficialmente no LifeVal e no FrontierCode 2.0 apontam nessa direção, mas fique atento: análises de terceiros indicam que ele tende a omitir fatos-chave com mais facilidade.
Cenários para escolher o Gemini 4 Carbon
- A entrada inclui vídeo ou áudio: gravações de reuniões, vídeos de demonstração de produtos, gravações de aulas — o Sol não consegue receber esse tipo de conteúdo diretamente.
- A entrada única frequentemente ultrapassa 272K: a tabela de preços do Google não tem a regra de cobrança em dobro da requisição inteira, o que torna o preço unitário mais fácil de prever em cenários de documentos longos.
- Você dá peso à pontuação agregada de terceiros: no AA, a categoria máxima de raciocínio atinge 60, acima dos 57 da categoria Max do Sol.
- O projeto termina antes de 30 de novembro: durante o período de preço promocional de lançamento, o preço unitário é o mais baixo; se o projeto atravessar o mês, será preciso recalcular com os novos preços de dezembro.
| Formato de tarefa | Vale mais a pena testar primeiro | Razão principal | Pontos que exigem verificação adicional |
|---|---|---|---|
| Compreensão de áudio/vídeo, transcrição e análise | Gemini 4 Carbon | Aceita entrada de vídeo e áudio | Mudança de preço a partir de dezembro |
| Geração de textos muito longos | GPT-6.2 Sol | Saída máxima de 128K | Consumo de tokens de raciocínio |
| Perguntas e respostas sobre documentos longos acima de 300K | Fazer as contas com os dois | O Sol tem a regra de cobrança em dobro da requisição inteira | Número real de tokens |
| Agents e modificações em código | Testar com os dois | As conclusões oficiais e as de terceiros apontam direções diferentes | Casos de omissão de fatos-chave |
| Base de conhecimento de atendimento com alta taxa de acerto de cache | Testar com os dois | Cache explícito no Sol, cache implícito no Carbon | Taxa de acerto real |
Primeiros passos com GPT-6.2 Sol e Gemini 4 Carbon
Este artigo não traz blocos de código; ele apenas explica quais pontos você precisa ajustar na integração. Ambos os modelos funcionam com o protocolo Chat Completions compatível com OpenAI, então o custo da migração fica principalmente no nome do modelo e nos parâmetros.
- Confirme se o modelo está disponível: primeiro, pesquise o ID do modelo na lista de modelos da APIYI. Atualmente, o modelo disponível para invocação é o
gemini-4-carbon; ogpt-6.2-solainda não foi lançado, mas vamos disponibilizá-lo o quanto antes. O nome do modelo e os preços devem sempre ser confirmados na lista de modelos da plataforma. - Substitua o base_url: na configuração do seu OpenAI SDK atual, altere o base_url para
https://api.apiyi.com/v1e troque a api_key pela Key gerada pela plataforma; o restante da forma de chamada permanece igual. - Escolha o endpoint: na plataforma, o Carbon suporta o endpoint chat e o generateContent nativo do Gemini; não há suporte a Responses. Se o seu código depende do Responses, será preciso migrar para o endpoint chat.
- Trate o parâmetro de raciocínio: quando o Sol for lançado e você for invocar o
gpt-6.2-sol, não defina o reasoning effort como none — a API rejeita esse tipo de requisição. - Registre o consumo real: em cada requisição, anote a contagem de tokens de entrada e de saída retornados e multiplique o consumo real pelo preço unitário da data correspondente, em vez de comparar diretamente os preços de tabela.
🚀 Começo rápido: recomendamos aproveitar primeiro a cota de teste gratuita para novos usuários da APIYI em apiyi.com, rodar 20 a 50 requisições reais suas no
gemini-4-carbone registrar o consumo de tokens e a qualidade das saídas. Quando o 6.2 Sol for lançado, execute o mesmo lote de requisições novamente — só assim a comparação dos resultados terá valor de referência.
Recomendações de decisão: GPT-6.2 Sol e Gemini 4 Carbon
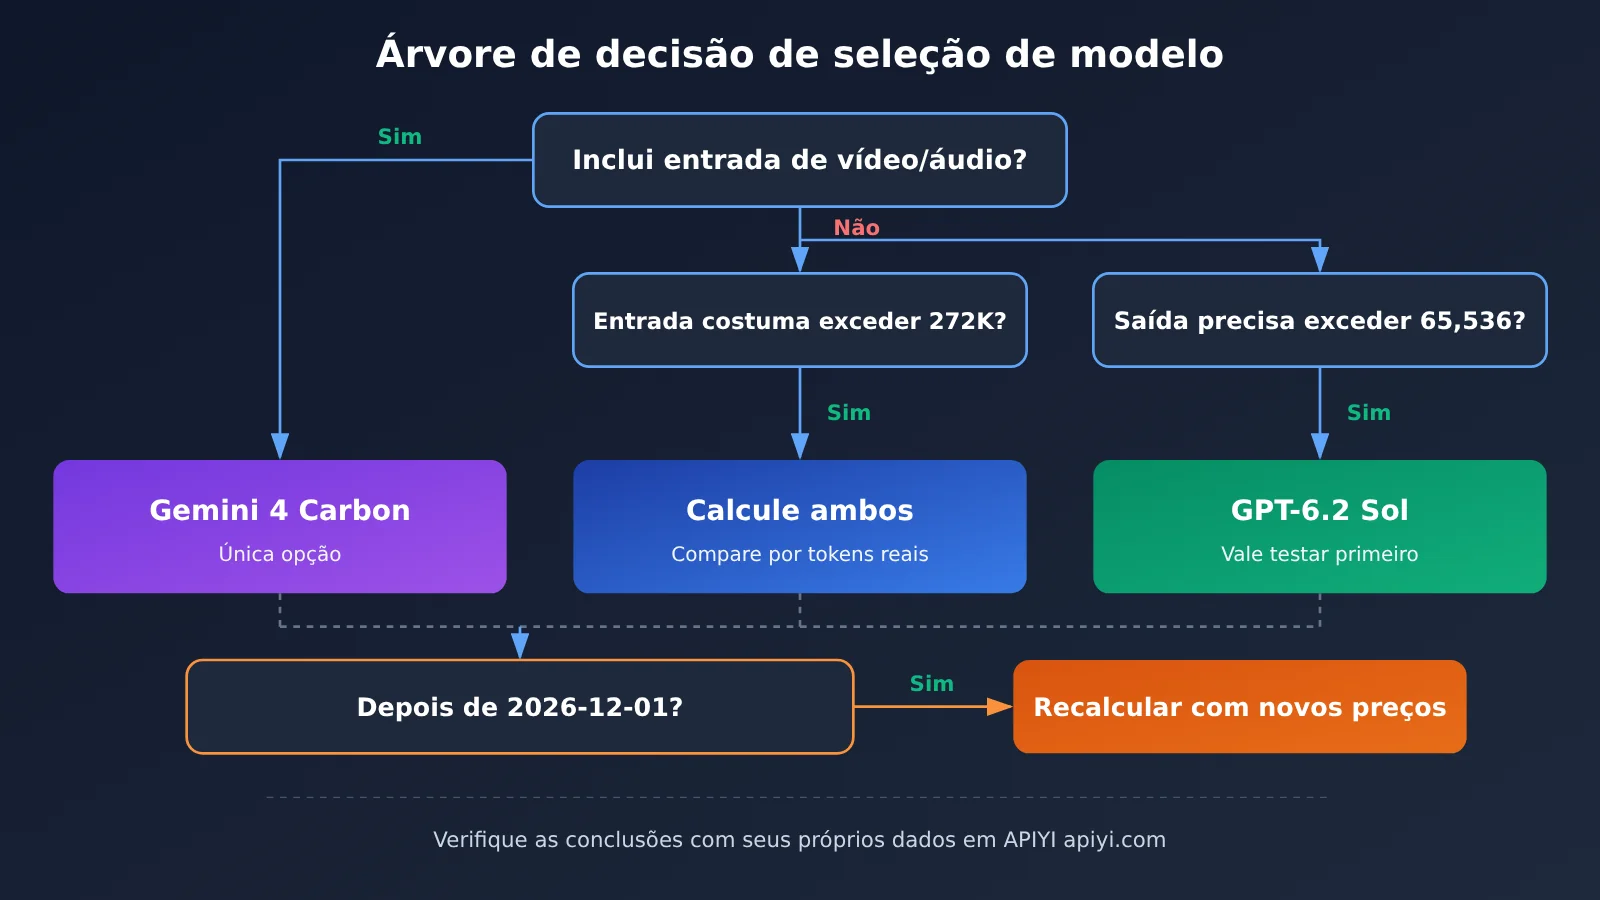
A escolha do modelo pode seguir esta ordem: “primeiro a modalidade, depois o comprimento e, por fim, o tempo”. Se a entrada tiver áudio ou vídeo, o Carbon é praticamente a única opção; se for só texto e imagem, verifique se as requisições costumam passar de 272K e se você precisa de uma saída única acima de 65.536; por último, veja se o projeto vai se estender além de 1º de dezembro.
| Modelo | Vantagem principal | Pontos de atenção | Plataformas disponíveis |
|---|---|---|---|
| GPT-6.2 Sol | Saída máxima de 128K, suporta Responses e Batch | Acima de 272K, o pedido inteiro custa o dobro; não aceita effort definido como none | API da OpenAI; ainda não disponível na APIYI — consulte a lista de modelos da plataforma |
| Gemini 4 Carbon | Suporta entrada de vídeo e áudio, maior nível entre provedores terceirizados: 60 | A partir de 1º de dezembro, o preço oficial dobra; suporta apenas cache implícito | Google AI Studio, Google Cloud; já disponível na APIYI apiyi.com |
💡 Sugestão de escolha: os dois modelos têm o mesmo preço de tabela até o fim de novembro, mas isso é só o ponto de partida. Recomendo usar o mesmo lote de requisições reais para medir o consumo de tokens em cada plataforma, multiplicar pelos preços unitários de novembro e dezembro, respectivamente, e analisar o resultado separado por tipo de tarefa, em vez de ficar só com um total geral.
Perguntas Frequentes (FAQ)
Q1: O que são GPT-6.2 Sol e Gemini 4 Carbon?
O GPT-6.2 Sol é o modelo eficiente lançado pela OpenAI em 2026-11-17, com ID de modelo `gpt-6.2-sol`, que recebe texto e imagem e gera texto. O Gemini 4 Carbon é o modelo lançado pelo Google em 2026-11-10, que recebe texto, imagem, vídeo e áudio, e gera texto.
Q2: Os preços de tabela dos dois são iguais — dá no mesmo usar qualquer um?
Não. O preço de tabela é apenas o valor unitário por 1 milhão de tokens; a fatura real também depende da quantidade de tokens, do comprimento da inferência, da taxa de acerto do cache, de a entrada ultrapassar 272K (válido apenas para o Sol) e de a requisição acontecer antes ou depois de 1º de dezembro. Este artigo não pretende julgar qual é mais barato — a recomendação é que você faça as contas com as suas próprias requisições.
Q3: Quando termina o preço de lançamento do Gemini 4 Carbon?
De acordo com as notas de lançamento do Google e a página de preços, o preço de lançamento vai até 2026-11-30, e a partir de 2026-12-01 passa a ser $4 para entrada, $20 para saída e $0.20 para leitura de cache. A página de documentação da APIYI ainda exibe o preço de lançamento; depois de 1º de dezembro, considere como referência os preços da lista de modelos da plataforma.
Q4: As pontuações agregadas de terceiros, 60 e 57, provam que o Carbon é mais forte?
Só indicam que, no Intelligence Index v5.0.1 da Artificial Analysis, o Carbon alcançou 60 na faixa mais alta de raciocínio, enquanto o Sol marcou 57 na faixa Max. Os resultados auto-reportados pela própria OpenAI, como FrontierCode 2.0 e LifeVal, seguem outra metodologia — os dois conjuntos não podem ser combinados. O desempenho nas tarefas do seu negócio você precisa testar por conta própria.
Q5: Como invocar esses dois modelos via API?
Registre-se na APIYI (apiyi.com), gere uma chave API, use a interface Chat Completions compatível com OpenAI e defina o modelo como `gemini-4-carbon` para invocar o Carbon. O GPT-6.2 Sol ainda não está disponível na plataforma — vamos publicá-lo o quanto antes; os modelos e preços disponíveis devem ser confirmados na lista de modelos da plataforma.
Q6: Quais são as limitações conhecidas do GPT-6.2 Sol?
Conforme a página oficial do modelo, o Sol não aceita entrada de áudio ou vídeo, nem oferece suporte a Realtime, Assistants, fine-tuning e endpoints de voz; entradas acima de 272K fazem o pedido inteiro ser cobrado com um acréscimo de preço. A Artificial Analysis, de terceiros, aponta que ele tende a omitir fatos-chave com mais facilidade no SWE-Atlas-QnA-AA. A OpenAI também mencionou que os dois modelos 6.2 têm proteções de segurança cibernética mais rigorosas, e parte das requisições legítimas de pesquisa de vulnerabilidades será recusada.
Q7: Quais são as limitações conhecidas do Gemini 4 Carbon?
De acordo com a página de documentação da APIYI, a saída máxima é de 65,536 tokens, abaixo dos 128,000 do Sol; o conhecimento vai até 2026-03, anterior ao 2026-06-01 do Sol. Ele oferece apenas cache implícito, não tem tier gratuito e, na plataforma, também não há endpoint Responses. Além disso, a partir de dezembro o preço oficial dobra, então projetos de longo prazo precisam se planejar com antecedência.
GPT-6.2 Sol e Gemini 4 Carbon: Pontos-Chave (Key Takeaways)
- Data limite: até 2026-11-30, os preços oficiais de tabela para contexto curto são iguais nos dois lados; a partir de 12-01, o Carbon sobe para $4 / $20.
- Preço de tabela não é a conta: o número de tokens, o comprimento da inferência e a taxa de acerto do cache determinam juntos o custo real.
- Regra para entradas longas: a duplicação do pedido inteiro acima de 272K vale só para o Sol; cenários com documentos longos exigem um cálculo à parte.
- Diferença de modalidade: o Carbon aceita vídeo e áudio; o Sol aceita apenas texto e imagem.
- Analise as pontuações separadamente: no benchmark independente AA, o Carbon atinge 60 no nível mais alto e o Sol Max fica com 57 — e esses números não podem ser combinados com os autoinformados oficialmente.
- Como começar: o Carbon já pode ser invocado na APIYI; o Sol ainda não está disponível — vale sempre a lista de modelos da plataforma.
Resumo
Pontos de decisão na escolha entre GPT-6.2 Sol e Gemini 4 Carbon:
- Primeiro, a modalidade: com entrada de áudio e vídeo, só o Carbon dá conta; para apenas texto e imagem, os dois servem.
- Depois, o comprimento: se as entradas costumam passar de 272K, refaça a conta com a regra de dobrar o pedido inteiro do Sol; para saídas únicas muito longas, olhe o limite de 128K do Sol.
- Por último, o prazo: para projetos que atravessam 1º de dezembro, faça o orçamento da parte do Carbon pelos novos preços.
Os números iguais na tabela de preços são só o ponto de partida da comparação. A resposta realmente confiável vem das suas próprias requisições, do seu próprio consumo de tokens e do preço unitário da data correspondente.
A recomendação é começar usando o crédito gratuito na APIYI (apiyi.com) para rodar um lote de tarefas reais testando o gemini-4-carbon; quando o 6.2 Sol estiver disponível, use o mesmo conjunto de dados para fazer a comparação.
📚 Referências
-
Post de lançamento da OpenAI: notas de lançamento do GPT-6.2 Astra e Sol
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Descrição: preços oficiais e dados de capacidade auto-reportados pela própria OpenAI
- Link:
-
Página de modelos da OpenAI: especificações e regras de precificação do GPT-6.2 Sol
- Link:
platform.openai.com/docs/models/gpt-6.2-sol - Descrição: contexto, endpoints e a regra de dobro para pedidos completos a partir de 272K
- Link:
-
Artigo da Artificial Analysis: interpretação do índice de terceiros após o lançamento do GPT-6.2
- Link:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Descrição: pontuação agregada de terceiros e dados por faixa de raciocínio
- Link:
-
Notas de lançamento do Google: anúncio de disponibilidade do Gemini 4 Carbon
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available - Descrição: preço introdutório e nota de rodapé com os valores após 30 de novembro
- Link:
Autor: Equipe técnica da APIYI
Intercâmbio técnico: sinta-se à vontade para entrar em contato conosco pela página inicial do site da APIYI; os modelos e preços podem ser consultados na central de documentação em docs.apiyi.com