ملاحظة المؤلف: نفصل في هذا المقال بين ثلاثة مستويات من الأرقام: التصنيف الشامل لدى جهة خارجية، والنتائج التي تعلنها كل شركة رسميًا عن مهام فردية، والأسعار المعلنة. بهذه الطريقة نوضح الفرق في تسعير قراءة الذاكرة المؤقتة (cache read)، ونبين أي النموذجين يمكن استدعاؤه حاليًا عبر APIYI.
في 2026-11-17، أعلنت OpenAI عن GPT-6.2 Astra وGPT-6.2 Sol. وقبل ذلك بنحو أسبوع، في 2026-11-09، نشرت Anthropic في وثائقها نموذج Claude Fable 5.2. سعر الإدخال في السياق القصير وسعر الإخراج للنموذجين الرائدين متطابقان: 8 دولارات لكل مليون token للإدخال و40 دولارًا للإخراج. لذلك تركزت نقاشات اختيار النموذج بطبيعة الحال على GPT-6.2 Astra وClaude Fable 5.2.
المشكلة أن التصنيفين يعطيان اتجاهين غير متطابقين. في المؤشر الشامل لدى جهة خارجية مثل Artificial Analysis، حصل Fable 5.2 على درجة أعلى. أما في عدة مهام تخصصية أعلنت عنها OpenAI في بيان الإصدار، فقد تقدم Astra، وكانت التكلفة لكل مهمة التي أعلنتها الجهة أقل. وإذا خلطنا بين مجموعتي الأرقام فسنصل إلى نتيجة “أيّهما أقوى”، لكن هذه النتيجة لا يسندها كلا الطرفين معًا.
هذا ليس مقالًا يعلن فوز أحد الطرفين. نقسم الأرقام هنا إلى ثلاثة مستويات: التصنيف الشامل لدى جهة خارجية، والنتائج الرسمية لمهام فردية، والأسعار الرسمية. ننظر إلى كل مستوى على حدة، ثم نوضح في النهاية أي النموذجين يمكن استدعاؤه عبر APIYI الآن.
القيمة الأساسية: بعد قراءة هذا المقال، ستستطيع البحث في التصنيف المناسب للمهمة التي تهمك، ورؤية الفرق في سعر قراءة الذاكرة المؤقتة، ومعرفة حالة الوصول الحالية إلى النموذجين.
GPT-6.2 Astra وClaude Fable 5.2: النقاط الأساسية — ثلاث طبقات من الأرقام لا تخلط بينها
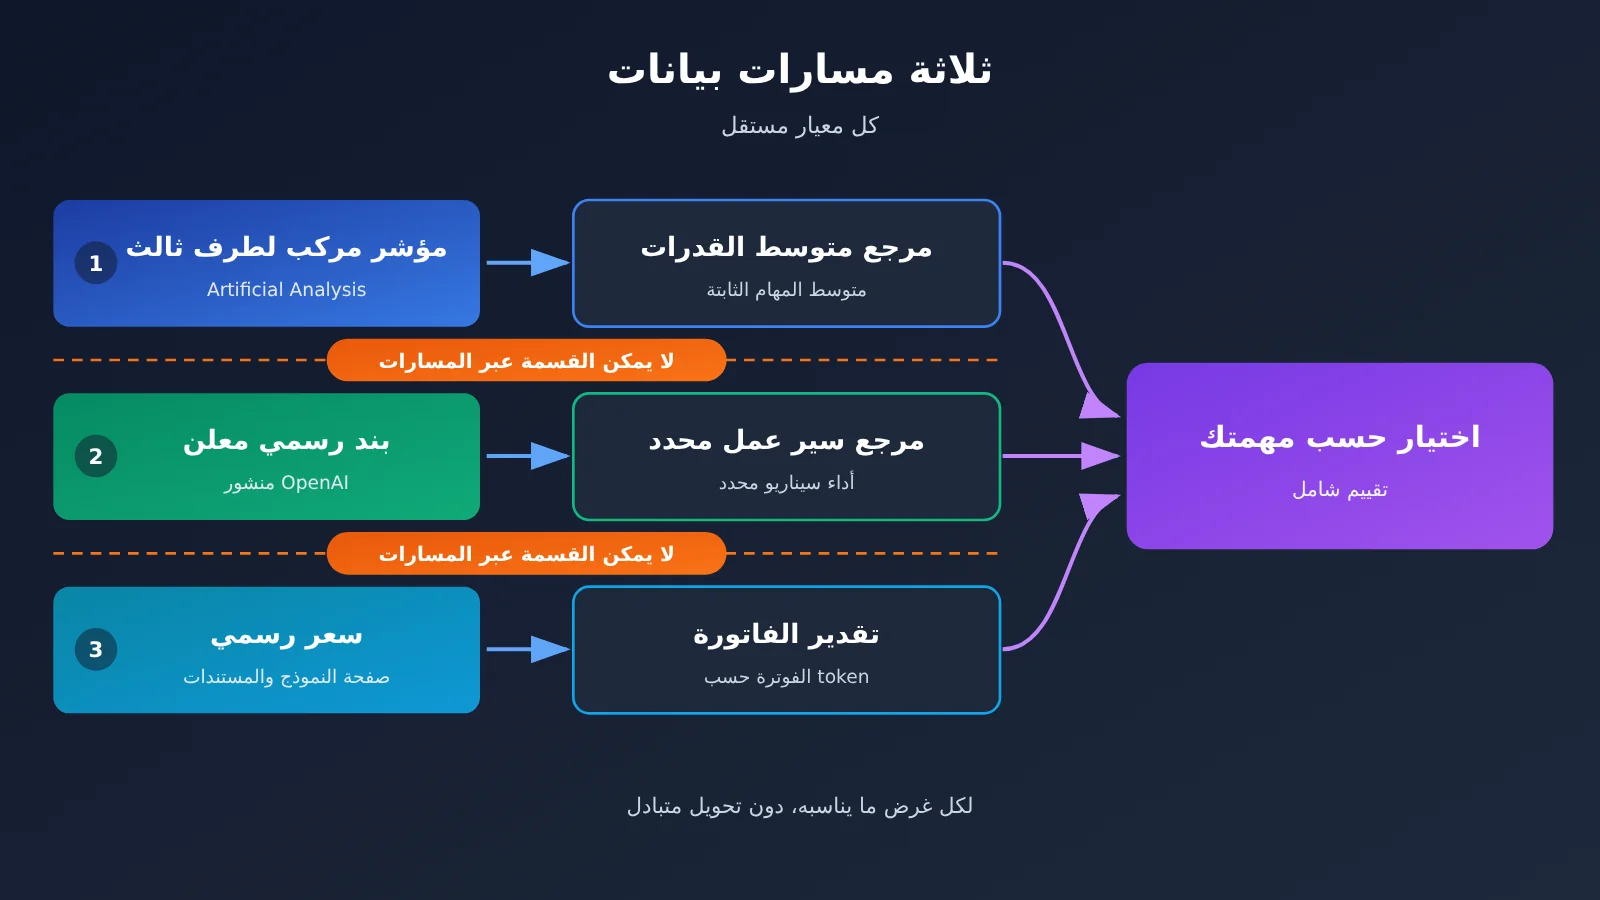
عند مقارنة GPT-6.2 Astra بـ Claude Fable 5.2، أكثر ما يوقعك في الخطأ هو وضع أرقام من مصادر مختلفة داخل استنتاج واحد. يوضح الجدول التالي أولاً مصدر كل طبقة من طبقات المعلومات الثلاث، وما تقوله كل طبقة.
| طبقة الرقم | طبيعة المصدر | الاتجاه الذي تُظهره هذه الطبقة | ما يجب الانتباه إليه عند الاستخدام |
|---|---|---|---|
| اللوحة الشاملة | طرف ثالث هو Artificial Analysis، إصدار Intelligence Index v5.0.1 | Fable 5.2 يسجل 65، وAstra (Max) يسجل 62 | يجب ذكر مستوى الاستدلال صراحةً، فالفروق بين المستويات كبيرة جدًا |
| مهمة منفردة | إعلان رسمي في منشور OpenAI، وAA-3D هو تقييم أعمى من طرف ثالث نقلته الجهة الرسمية | Astra يتقدّم في Agents’ Last Exam وHarvey LAB-AA وAA-3D | في لوحة ALE، نتائج Fable لا تتضمن المهام التسع الخاصة بالنموذج الاحتياطي |
| السعر المعلن | صفحتا النموذجين الرسميتان والوثائق الرسمية | سعر الإدخال والإخراج متساوٍ، وقراءة الـ cache أرخص لدى Fable | مدة الاحتفاظ بكتابة الـ cache مختلفة، وقواعد السياق الطويل مختلفة |
لماذا «يتصدّر» كلٌّ من GPT-6.2 Astra وClaude Fable 5.2 في بند واحد؟
المؤشر الشامل يقيس متوسط الأداء على مجموعة ثابتة من المهام، بأوزان يحددها طرف ثالث. أما منشور OpenAI فيختار سيناريوهات محددة مثل سير العمل المهني الطويل، والمجالات القانونية، وتوليد 3D، وإعدادات الاختبار يضعها الطرف الرسمي. السؤالان مختلفان من الأصل: الأول ينظر إلى المتوسط العام، والثاني إلى الأداء داخل سير عمل معيّن. واختلاف الاستنتاجات لا يعني أن بيانات أحد الطرفين فيها خلل.
الأمر نفسه ينطبق على التكلفة. «تكلفة المهمة الواحدة» التي يقدمها Artificial Analysis هي تكلفة تشغيل مهام مؤشره الشامل. أما ما تقوله OpenAI من أن «تكلفة ALE تبلغ نحو 5% من تكلفة Fable» فهو مجموعة مهام أخرى وبمنهجية حساب أخرى. هذان الرقمان لا يمكن قسمة أحدهما على الآخر، ولا التحويل بينهما.
الفروق الجوهرية بين GPT-6.2 Astra وClaude Fable 5.2: التصنيف الشامل من طرف ثالث
نشرت Artificial Analysis مقالًا في 2026-11-17 وحدّثت صفحة النماذج. جميع الدرجات الواردة أدناه هي من Intelligence Index v5.0.1، وهي نتائج تقييم طرف ثالث وليست أرقامًا أعلن عنها أي من الطرفين.
| النموذج | مستوى الاستدلال | Intelligence Index v5.0.1 | تكلفة المهمة الواحدة للمؤشر الشامل (من صفحة كل نموذج) |
|---|---|---|---|
| Claude Fable 5.2 | أعلى مستوى استدلال | 65 (الأول في التصنيف) | 26.54 دولارًا |
| GPT-6.2 Astra | Max / Xhigh | 62 | 4.00 دولارات (Max) |
| GPT-6.2 Astra | High / Medium / Low | 60 / 57 / 46 | — |
| GPT-6.2 Sol | Max | 57 | 1.01 دولار (Max) |
| Gemini 4 Carbon | أعلى مستوى | 60 | — |
| Claude Opus 5.5 | أعلى مستوى | 59 | — |
في هذا التصنيف الذي أعده طرف ثالث، تتفوق Fable 5.2 على أعلى مستوى في Astra بفارق 3 نقاط في الدرجة الإجمالية. كما تتفوق Astra على الجيل السابق GPT-6 Astra بخمس نقاط، وتتجاوز أيضًا أعلى مستوى في Gemini 4 Carbon وClaude Opus 5.5. ومن المهم الانتباه إلى أن Astra عند خفضها إلى مستوى Low تحصل على 46 نقطة فقط. لذا، إذا خفّضت أعمالك قوة الاستدلال لتقليل التكلفة، فلا يمكنك توقع النتائج بناءً على درجة 62.
يتضمن مقال Artificial Analysis أيضًا عدة نتائج تفصيلية أخرى، وهي كذلك بيانات طرف ثالث. في المعاينة البحثية AA-Robotics v0.1 حصلت Astra على 79 وحصلت Fable 5.2 على 75. وفي المهام العلمية، تتصدر Astra في Terminal-Bench-Science 0.1، وفي المجموعة الفرعية الصعبة من CritPt v2 تأتي في المرتبة الثانية بعد Fable 5.2 فقط. وفي Coding Agent Index (Codex harness، max) تتعادل Astra مع GPT-6 Astra. أما في AA-Omniscience، فبلغ معدل الهلوسة (Max) لدى Astra نسبة 59%.
الفروق الجوهرية بين GPT-6.2 Astra وClaude Fable 5.2: الأرقام الرسمية لكل اختبار
الأرقام أدناه مأخوذة من وثيقة إصدار OpenAI وصفحة النموذج، وكلها أرقام رسمية معلنة من الشركة. أما البنود التي لم تُعطِ فيها وثيقة الإصدار درجة مطلقة، فهذا المقال يكتفي بذكر الفرق النسبي فقط.
| المهمة الفرعية | النتيجة الرسمية المعلنة | معيار التكلفة الرسمي | الحواشي التي يجب الانتباه إليها |
|---|---|---|---|
| Agents’ Last Exam (سير عمل احترافي طويل المدى) | Astra أعلى من Fable 5.2 بمقدار 5.5 نقطة | التكلفة نحو 5% من تكلفة Fable | نتيجة Fable 5.2 على اللوحة لا تشمل تسع مهام استُخدم فيها نموذج بديل |
| Harvey LAB-AA v1.1 (المجال القانوني) | معدل نجاح Astra يتجاوز ضعف معدل Fable 5.2 | التكلفة نحو السدس | وثيقة الإصدار لم تعطِ معدل النجاح المطلق؛ وإعداد “Astra for Law” الموجّه للمحامين أعلى |
| AA-3D (تقييم أعمى بشري بنظام Elo) | Astra 1318، وFable 5.2 1271، وSol 1259 | لم تُعطَ | تقييم أعمى من طرف ثالث، لكنه منقول عبر وثيقة الإصدار الرسمية |
| Terminal-Bench-Science 0.1 | Astra أعلى من GPT-6 Astra بتسع نقاط مئوية | التكلفة أقل من ثلث تكلفة الجيل السابق | لـFable رقمَان صادران عن اختبارين مختلفين، التفاصيل أدناه |
يجب توضيح حاشية Agents’ Last Exam بشكل منفصل. فقد نصّت OpenAI على أن نتيجة Fable 5.2 على اللوحة لا تشمل تسع مهام استُخدم فيها نموذج بديل. لذلك عند قراءة عبارة “أعلى بـ5.5 نقطة”، ينبغي أن تعرف أن تغطية المهام على الجانبين ليست متطابقة تمامًا.
وفي Terminal-Bench-Science 0.1، هناك رقمَان لـFable 5.2 من مصدرين مختلفين. أحدهما من Artificial Analysis باستخدام mini-swe-agent. والآخر هو 74.6% المعلنة من Anthropic، في بيئة اختبار هي Claude Code وبقوة استدلال Max. هذان الرقمان ليسا ناتجين عن الاختبار نفسه، فلا يمكن أن يحل أحدهما محل الآخر، ولا يمكن مقارنتهما مباشرة مع Astra.
الرقمان 1318 و1271 في AA-3D هما في الأصل تقييم Elo أعمى بشري من طرف ثالث، لكن ما يقتبسه هذا المقال هو نقل وثيقة إصدار OpenAI لهما. ومن الأفضل عند الاقتباس أن تكتب “تقييم أعمى من طرف ثالث منقول رسميًا”، فلا تصفه بأنه رقم رسمي محض، ولا تنسبه إلى تحقق مستقل من كاتب هذا المقال.
💡 نصيحة للاختيار: لا تكون لوحة الاختبار الفرعي ذات قيمة مرجعية إلا عندما يكون نوع المهمة قريبًا من طبيعة عملك. يمكن بالفعل استدعاء Fable 5.2 عبر خدمة وكيل API في APIYI apiyi.com، فيمكنك أولًا تشغيل جولة باستخدام عيناتك الحقيقية، ثم الجمع بينها وبين الجدولين أعلاه للوصول إلى قرار.
مقارنة الأسعار المعلنة بين GPT-6.2 Astra وClaude Fable 5.2: اختلاف قراءة الذاكرة المؤقتة
وفقًا للأسعار الرسمية المعلنة، يتساوى النموذجان تمامًا في الإدخال والإخراج بالسعر القياسي للسياق القصير، ويتركز الفرق في بنود الذاكرة المؤقتة وقواعد السياق الطويل. جميع الأسعار في الجدول أدناه بالدولار لكل مليون توكن.
| بند التسعير | GPT-6.2 Astra (OpenAI رسميًا) | Claude Fable 5.2 (Anthropic رسميًا) | المنصات المتاحة (جدول APIYI الإجمالي 2026-11-17 15:54 UTC+8) |
|---|---|---|---|
| الإدخال | 8 | 8 | Astra لم يُدرج بعد؛ Fable بسعر 8 |
| الإخراج | 40 | 40 | Astra لم يُدرج بعد؛ Fable بسعر 40 |
| قراءة الذاكرة المؤقتة | 0.40 | 0.20 | Astra لم يُدرج بعد؛ Fable بسعر 0.2 |
| كتابة الذاكرة المؤقتة | 10 (احتفاظ 30 دقيقة)، 20 (12 ساعة) | 10 (5 دقائق)، 16 (ساعة واحدة) | وفقًا لقائمة المنصة |
| نافذة السياق / الحد الأقصى للإخراج | 1,050,000 / 128,000 (الحد الأقصى للإدخال 922,000) | 1M / 128K | — |
| الدفعات (Batch) | 50% من السعر القياسي | خصم 50% على الإدخال والإخراج | — |
السعر الرسمي المعلن من OpenAI لـ GPT-6.2 Astra هو 8 دولارات للإدخال، و0.40 دولار لقراءة الذاكرة المؤقتة، و40 دولارًا للإخراج. لم يُدرج النموذج بعد، وسنطرحه في أقرب وقت ممكن؛ ويعتمد الطراز والسعر على قائمة الطرازات في المنصة. في جدول النماذج الإجمالي لدى APIYI على docs.apiyi.com/models.md وفي واجهة الأسعار العامة، لم يكن gpt-6.2-astra موجودًا في 2026-11-17. لا تستخدم النموذج المُدرج بالفعل gpt-6-astra (السياق القصير 10 / 50 / 1) لتقدير سعر 6.2، فهذان ليسا النموذج نفسه.
لاختلاف قراءة الذاكرة المؤقتة أثر كبير في سيناريوهات الوكلاء والمحادثات الطويلة. عند قراءة 100 مليون توكن من الذاكرة المؤقتة نفسها، يكون السعر المعلن لـ Astra هو 40 دولارًا، ولـ Fable 5.2 هو 20 دولارًا. إذا كان موجه النظام لديك طويلًا، أو كنت تستشهد بالم stesso مجموعة من المستندات بشكل متكرر، فسيظهر هذا البند مباشرة في فاتورتك. تبدو كتابة الذاكرة المؤقتة عند الجانبين بسعر 10 دولارات، لكن Astra يحتفظ بالبيانات 30 دقيقة، بينما يحتفظ Fable بها 5 دقائق، لذا تتأثر نسبة الإصابة بفواصل الطلبات؛ لا يمكن الاكتفاء بمقارنة سعر الوحدة.
تختلف أيضًا قواعد السياق الطويل. توضح صفحة نموذج Astra أنه عندما يتجاوز إدخال الطلب الواحد 272K توكن، يتضاعف سعر الإدخال والذاكرة المؤقتة، ويصبح سعر الإخراج 1.5 ضعف سعر السياق القصير، ويُحسب الطلب بأكمله بهذا السعر. لا يتضمن مقتطف أسعار Fable المرجعي في هذا المقال أي شرائح مماثلة؛ قبل الاعتماد عليه، تحقق بنفسك من وثائق Anthropic.
كما تختلف فئات التسريع بين الجانبين. فئة Fast لدى Astra تساوي ضعف السعر القياسي، وUltrafast حتى 2027-02-28 (بتوقيت المحيط الهادئ) تساوي 3 أضعاف، وبدءًا من 2027-03-01 تصبح 6 أضعاف. أما Fast mode لدى Fable فتبلغ سرعتها القصوى نحو 2.5 ضعف، بسعر 16 دولارًا للإدخال و80 دولارًا للإخراج.
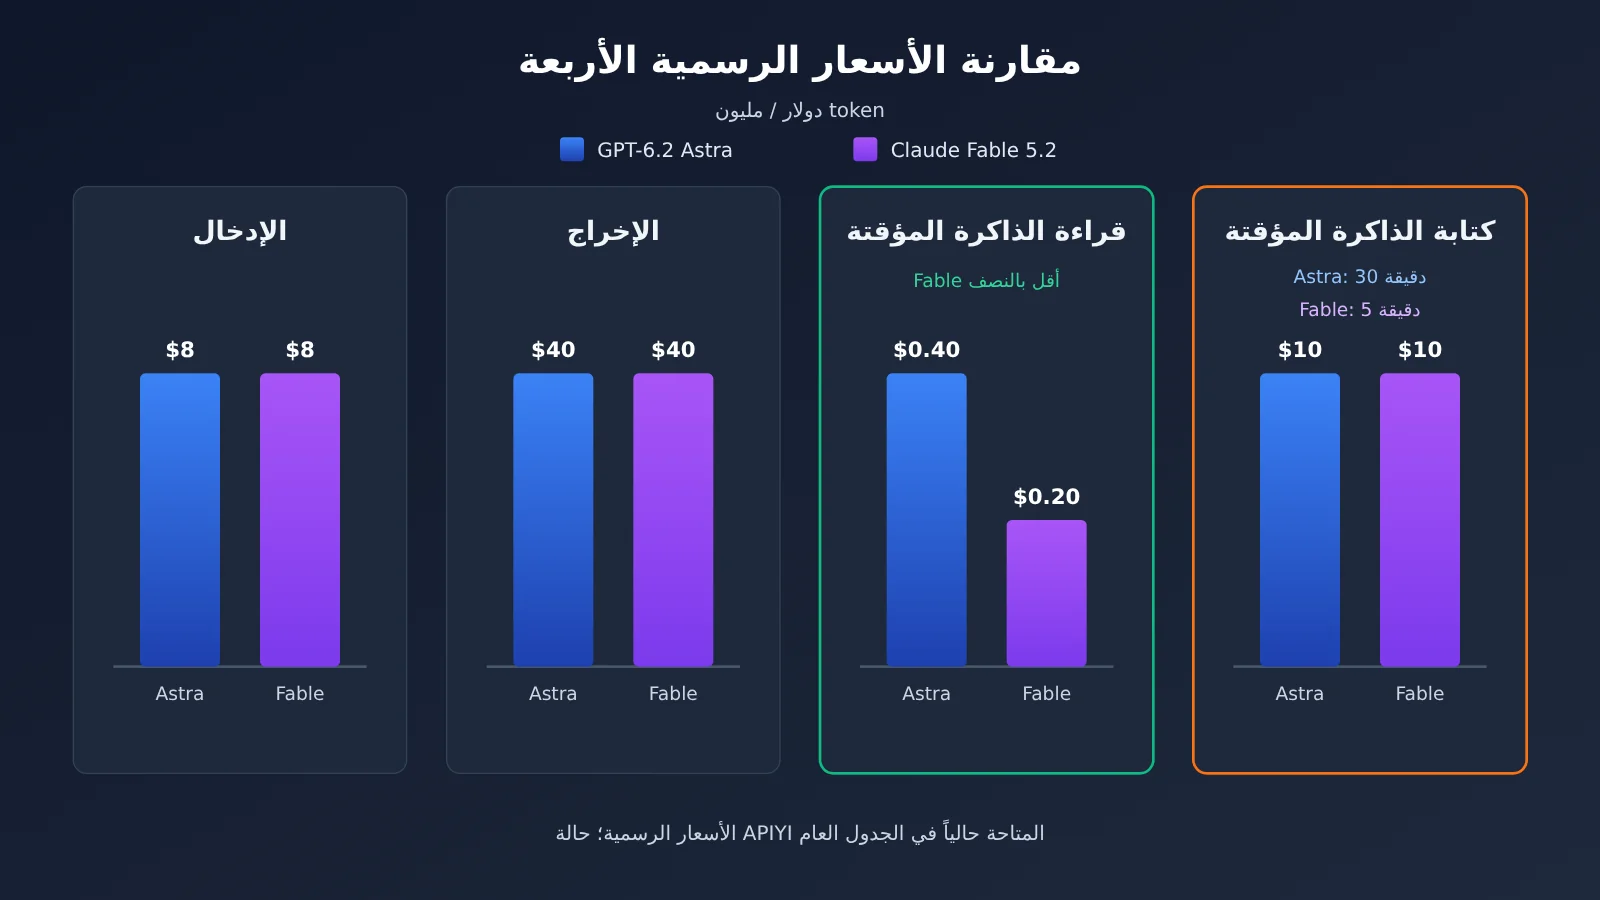
🎯 ملاحظة حول البيانات: يعرض الرسم أعلاه السعر الرسمي المعلن للشركتين فقط. أما النماذج والأسعار القابلة للاستدعاء فعليًا على المنصة، فالمرجع فيها هو قائمة النماذج على APIYI apiyi.com. وAstra 6.2 غير موجود في القائمة حاليًا.
توصيات السيناريوهات لـ GPT-6.2 Astra وClaude Fable 5.2
في ما يلي نربط السيناريوهات بما يظهره كل بند في لوحة الترتيب، من دون إصدار حكم على القوة الإجمالية.
سيناريوهات يُعطى فيها الأولوية لتقييم GPT-6.2 Astra
- سير العمل الاحترافي الطويل: يتقدّم Astra في Agents’ Last Exam المعلن رسميًا، مع ضرورة مراعاة الحاشية التي تقول إن Fable لا تشمل تسع مهام.
- مهام الوثائق القانونية: معدل النجاح المعلن رسميًا في Harvey LAB-AA v1.1 يزيد على ضعف نظيره لدى Fable، ويمكن اعتبار هذا اتجاهًا رئيسيًا للاختبار.
- تقييمات التفضيل المرتبطة بتوليد 3D: تقييم AA-3D الأعمى الذي نقلته الشركة رسميًا سجّل Elo 1318 مقابل 1271.
- الحساسية لتكلفة المهمة الواحدة في المؤشر المركب: تظهر صفحة الطرف الثالث سعر Astra (Max) عند 4.00 دولارات، لكن هذا ينطبق على مجموعة مهام المؤشر المركب وحدها.
سيناريوهات يُعطى فيها الأولوية لتقييم Claude Fable 5.2
- التطبيقات العامة التي تحتاج إلى قدرة إجمالية احتياطية: سجّل Fable 5.2 قيمة 65 في المؤشر المركب لدى الطرف الثالث، وجاء في المرتبة الأولى على اللوحة.
- التطبيقات ذات نسبة قراءة عالية من الذاكرة المؤقتة: سعر قراءة الذاكرة المؤقتة الرسمي 0.20 دولار، أي نصف سعر Astra.
- الحاجة إلى تكامل فوري:
claude-fable-5-2وclaude-fable-5-2-thinkingمدرجان بالفعل في جدول APIYI العام.
| ما يهمك | أي طبقة تنظر إليها أولًا | ماذا تقول هذه الطبقة | ملاحظة إضافية |
|---|---|---|---|
| متوسط القدرة | لوحة الترتيب المركبة من طرف ثالث | Fable 5.2 أعلى | انتبه إلى مستوى الاستدلال |
| سير العمل الاحترافي / القانون | بند رسمي معلن من الشركة | Astra متقدم | بيانات معلنة من الشركة؛ راجع الحاشية |
| تكلفة التخزين المؤقت في المحادثات الطويلة | السعر الرسمي | قراءة الذاكرة المؤقتة لدى Fable أقل | مدة الاحتفاظ بكتابة الذاكرة المؤقتة مختلفة |
| هل يمكن الاستدعاء الآن؟ | جدول APIYI العام | Fable فقط متوفر | Astra 6.2 في انتظار الإدراج |
GPT-6.2 Astra وClaude Fable 5.2: البدء السريع واتخاذ القرار في ثلاث خطوات
الخطوة الأولى: ابدأ باللوحة التي تخصّ مهمتك
حدّد أولاً نوع المهمة التي ينتمي إليها عملك. إذا كان الأمر يتعلق بمساعد عام أو مهام مختلطة، فارجع إلى المؤشر الشامل من Artificial Analysis، وسجّل مستوى الاستدلال الذي تنوي استخدامه. وإذا كان يتعلق بوكيل طويل المدى أو مهام قانونية أو ثلاثية الأبعاد، فارجع إلى نتيجة البند المنفرد المقابلة التي أعلنتها OpenAI بنفسها، واقرأ الحواشي أيضًا. لا تجمع فرق النقاط في اللوحة الإجمالية مع فرق النقاط في لوحة البند المنفرد لتصنع منهما «درجة إجمالية».
الخطوة الثانية: ثم انظر إلى قراءة التخزين المؤقت
قدّر نسبة البادئة المتكررة في الطلب، مثل موجه النظام أو مقتطفات قاعدة المعرفة أو سجل المحادثة متعدد الأدوار. فكلما ارتفعت نسبة قراءة التخزين المؤقت، أصبح الفرق بين 0.20 و0.40 أوضح. وإذا كان الإدخال في الطلب الواحد يتجاوز 272K بشكل متكرر، فاحسب أيضًا قاعدة زيادة السعر على الطلب بأكمله الخاصة بـ Astra.
الخطوة الثالثة: ثم انظر إلى ما يمكن استدعاؤه الآن عبر APIYI
حاليًا، النموذج المتاح للاستدعاء في الجدول العام لـ APIYI هو Fable 5.2، بمعرّف النموذج claude-fable-5-2، وإذا كنت تحتاج إلى إصدار التفكير الصريح فاستخدم claude-fable-5-2-thinking. السعر المعلن هو 8 للإدخال، و40 للإخراج، و0.2 لقراءة التخزين المؤقت، وتدعم نقطة النهاية chat وmessages. صفحة وصف هذا النموذج تُرجع حاليًا 404، لذا فإن السعر المعتمد هو ما في الجدول العام.
عند الاتصال بطريقة متوافقة مع OpenAI، عيّن base_url في SDK إلى https://api.apiyi.com/v1، وضع model مساويًا لـ claude-fable-5-2، وستكون بقية المعاملات كما هي عند استدعاء Chat Completions عادةً. تجدر الإشارة إلى أن ميزة التفكير في Fable 5.2 مفعّلة دائمًا ولا يمكن تعطيلها، وقيمة effort الافتراضية هي high. وإذا انتقلت لاحقًا إلى Astra، فإن API الخاص به لا يقبل ضبط reasoning effort على none.
🚀 بداية سريعة: يُنصح أولًا باستخدام حصة الاختبار المجانية على APIYI apiyi.com، واختبار
claude-fable-5-2بعيناتك الخاصة، وتسجيل جودة الإخراج ومعدل إصابات التخزين المؤقت. وبعد إتاحةgpt-6.2-astra، أعد الاختبار على الدفعة نفسها من العينات؛ ستكون المقارنة أعدل.
الأسئلة الشائعة (FAQ)
س1: ما هو كل من GPT-6.2 Astra وClaude Fable 5.2؟
GPT-6.2 Astra هو النموذج الرائد الذي أطلقته OpenAI في 2026-11-17، ومعرّف الطراز هو `gpt-6.2-astra`، وقد صدر معه أيضًا النموذج الأقل تكلفة GPT-6.2 Sol. أما Claude Fable 5.2 فهو نموذج من Anthropic، وتاريخ نشر وثائقه هو 2026-11-09. يدعم كلا النموذجين نافذة سياق تبلغ نحو 1M، وحدًا أقصى للإخراج يبلغ 128K.
س2: أي النموذجين أقوى فعلاً: GPT-6.2 Astra أم Claude Fable 5.2؟
لا يمكن للبيانات المتاحة أن تقدّم إجابة واحدة. ففي المؤشر المركّب الصادر عن طرف ثالث، حصل Fable 5.2 على 65 نقطة، وهو أعلى من 62 نقطة التي حصل عليها Astra (Max). أما في تقييمات ALE وHarvey المعلنة رسميًا، وكذلك في التقييم الأعمى AA-3D الذي نقلته الجهة الرسمية، فإن Astra متقدّم. لذلك عليك أن تنظر إلى طبقة البيانات المقابلة لنوع مهمتك.
س3: هل يمكن التحقق المتبادل بين «التكلفة 5%» في ALE والتكلفة لكل مهمة لدى Artificial Analysis؟
لا. فعبارة «نحو 5%» هي معيار أعلنته OpenAI نفسها على اختبار Agents’ Last Exam. أما 4.00 دولار و26.54 دولار فهما تكلفة تشغيل Artificial Analysis لتلك المجموعة من المهام الخاصة بالمؤشر المركّب. المهام والمعايير مختلفة في الحالتين، فلا يمكن قسمة أحدهما على الآخر، ولا استخدام أحدهما للتحقق من الآخر.
س4: هل بيانات GPT-6.2 Sol مأخوذة من طرف ثالث؟
لا. فـ Sol نموذج من OpenAI نفسها، والأرقام الواردة عنه في بيان الإصدار كلها إعلانات رسمية. وقد اختبرت Artificial Analysis نموذج Sol بشكل منفصل أيضًا، وسجّل في فئة Max نحو 57 نقطة، وهذا الجزء هو البيانات الخارجية. السعر الرسمي المعلن لـ Sol هو 2 للإدخال، و0.10 لقراءة الذاكرة المؤقتة، و10 للإخراج. ولم يُدرج بعد على المنصة، وسنحرص على إدراجه في أقرب وقت؛ والطراز والسعر يعتمدان على قائمة الطرازات في المنصة.
س5: كيف يمكن الآن استدعاء Claude Fable 5.2 عبر API؟
سجّل في APIYI على apiyi.com واحصل على مفتاح API، ثم في SDK المتوافقة مع OpenAI اضبط عنوان URL الأساسي على `https://api.apiyi.com/v1`، واملأ الطراز بـ `claude-fable-5-2`. وإذا كنت تستخدم بروتوكول Anthropic الأصلي، فيمكنك استخدام نقطة نهاية messages.
س6: ما القيود المعروفة لدى GPT-6.2 Astra؟
توضح الجهة الرسمية أن Astra بلغ في إطار الجاهزية مستوى «حرج» في الأمن السيبراني، لذا فإن الحماية أكثر صرامة، وبعض طلبات البحث المشروعة في الثغرات ستُرفض. وفي تقييمات المحاذاة، يزداد احتمال أن يفوّت في اختبارين اثنين المشكلات التي تعترض الطريق، مثل ملفات مفقودة أو أدوات بحث غير متاحة. وتبلغ نسبة الهلوسة لدى AA-Omniscience من طرف ثالث (Max) نحو 59%. كما أنه لا يدعم إدخال الصوت أو الفيديو، ولا يدعم Realtime أو الضبط الدقيق.
س7: هل ستتغير الأسعار المعلنة بعد ديسمبر؟
وفقًا للمراجع المذكورة في هذا المقال، لم يعلن أي من الطرازين عن تعديلات سعرية في ديسمبر. الذي سيتغير هو معامل Ultrafast في Astra: اعتبارًا من 2027-03-01 سيرتفع من 3 أضعاف إلى 6 أضعاف. أما الفوترة الفعلية على المنصة فتتبع قائمة الطرازات على APIYI apiyi.com.
النقاط الرئيسية في GPT-6.2 Astra وClaude Fable 5.2
- الترتيب الشامل يُقرأ من طرف ثالث: على AA Intelligence Index v5.0.1 حصل Fable 5.2 على 65، وحصل Astra (Max) على 62.
- المهام المنفردة تُقرأ من الإفصاح الرسمي: يتقدم Astra في ALE وHarvey وفي AA-3D كما نقلته الجهة الرسمية، لكن يجب قراءة الحواشي.
- لا يمكن قسمة التكلفتين على بعضهما: نسبة 5% تقريبًا في ALE وتكلفة المهمة الواحدة لدى AA تنتميان إلى مهام مختلفة ومعايير حساب مختلفة.
- الإدخال والإخراج بالسعر نفسه للطرازين: كلاهما في السياق القصير بسعر 8 / 40 دولارًا، وقراءة الذاكرة المؤقتة 0.40 و0.20 على الترتيب.
- Astra للسياق الطويل بشرائح سعرية: إذا تجاوز الإدخال الواحد 272K، تُحتسب الفاتورة كاملة بالسعر الأعلى.
- حالة الوصول مختلفة: Fable 5.2 مدرج بالفعل في الجدول العام على APIYI apiyi.com، بينما Astra 6.2 في انتظار الإدراج.
الملخص
عند مقارنة GPT-6.2 Astra وClaude Fable 5.2، يكون التركيز على فصل مصادر الأرقام:
- لوحات التصنيف الشاملة من طرف ثالث: Fable 5.2 يتقدم، وعند الاستشهاد يجب توضيح مستوى الاستدلال.
- النتائج الفردية المعلنة رسميًا: يتقدم Astra في عدة مهام متخصصة، كما أن التكلفة لكل مهمة المعلنة رسميًا أقل، لكنها بيانات تُعلنها الشركة نفسها.
- الأسعار الرسمية: سعر الإدخال والإخراج متطابق، وقراءة الذاكرة المؤقتة مع Fable أرخص بالنصف، وقواعد السياق الطويل مختلفة أيضًا.
لا يتفوق أي من النموذجين في جميع الأبعاد. الطريقة الأكثر موثوقية هي تحديد نوع المهمة أولًا، ثم التحقق من تكلفة الذاكرة المؤقتة، وأخيرًا الاختبار بعينات حقيقية. حاليًا يمكن استدعاء Fable 5.2 عبر APIYI apiyi.com، وبعد إطلاق Astra 6.2 يمكن إعادة الاختبار بنفس مجموعة العينات. سنعمل على إطلاق هذا النموذج في أقرب وقت.
📚 المراجع
-
منشور OpenAI: ملاحظات إصدار GPT-6.2 Astra وSol والتقييمات المعلنة رسميًا
- الرابط:
openai.com/index/introducing-gpt-6-2-astra-sol - الوصف: بيانات ALE وHarvey وAA-3D وغيرها من العناصر الفردية ومصادر الحواشي
- الرابط:
-
صفحة نموذج OpenAI: مواصفات وأسعار GPT-6.2 Astra
- الرابط:
platform.openai.com/docs/models/gpt-6.2-astra - الوصف: سعر كتابة الذاكرة المؤقتة وقاعدة تسعير 272K تُعتمد من هنا
- الرابط:
-
مقال Artificial Analysis: تقييم طرف ثالث لـ GPT-6.2 Astra وSol
- الرابط:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - الوصف: درجات كل مستوى استدلال في Intelligence Index v5.0.1
- الرابط:
-
صفحة نموذج Artificial Analysis: Claude Fable 5.2
- الرابط:
artificialanalysis.ai/models/claude-fable-5-2 - الوصف: الدرجة الإجمالية وتكلفة المهمة الواحدة في المؤشر الشامل
- الرابط:
-
وثائق Anthropic: نظرة عامة على Claude Fable 5.2
- الرابط:
platform.claude.com/docs/en/models/fable-5-2/overview - الوصف: الأسعار، وقراءة/كتابة الذاكرة المؤقتة، وإعدادات effort والتفكير
- الرابط:
المؤلف: فريق APIYI التقني
التواصل التقني: نرحب بالتواصل معنا عبر الصفحة الرئيسية لموقع APIYI الرسمي، ويُرجى اعتبار قائمة الطُرازات في المنصة مرجعًا للطرازات والأسعار.