Nota do autor: as pontuações em rankings públicos podem ser infladas por otimizações direcionadas. Este artigo explica as causas do benchmaxing, apresenta 5 verificações de confiabilidade e mostra como montar um conjunto privado de testes com tarefas próprias em 4 etapas.
A conclusão, de cara: as pontuações dos rankings podem servir como ponto de partida para a investigação, mas não devem determinar, por si só, a escolha de um modelo. Os modelos líderes costumam ficar separados por apenas alguns pontos nos rankings gerais, e essa diferença já pode mudar quem ocupa o primeiro lugar. Quando a margem é tão pequena, otimizações voltadas às questões dos testes podem influenciar a classificação. Esse fenômeno é conhecido como benchmaxing.
O que realmente importa na escolha é o desempenho dos modelos candidatos nas tarefas do seu negócio. Este artigo não classifica modelos nem julga quem está “trapaceando”. O conteúdo se divide em três partes: como identificar pontuações potencialmente infladas, como montar um pequeno conjunto privado de testes com chamados reais e em quais situações os rankings não cobrem os indicadores que interessam a você.
O que é benchmaxing: 3 causas de notas infladas nos rankings
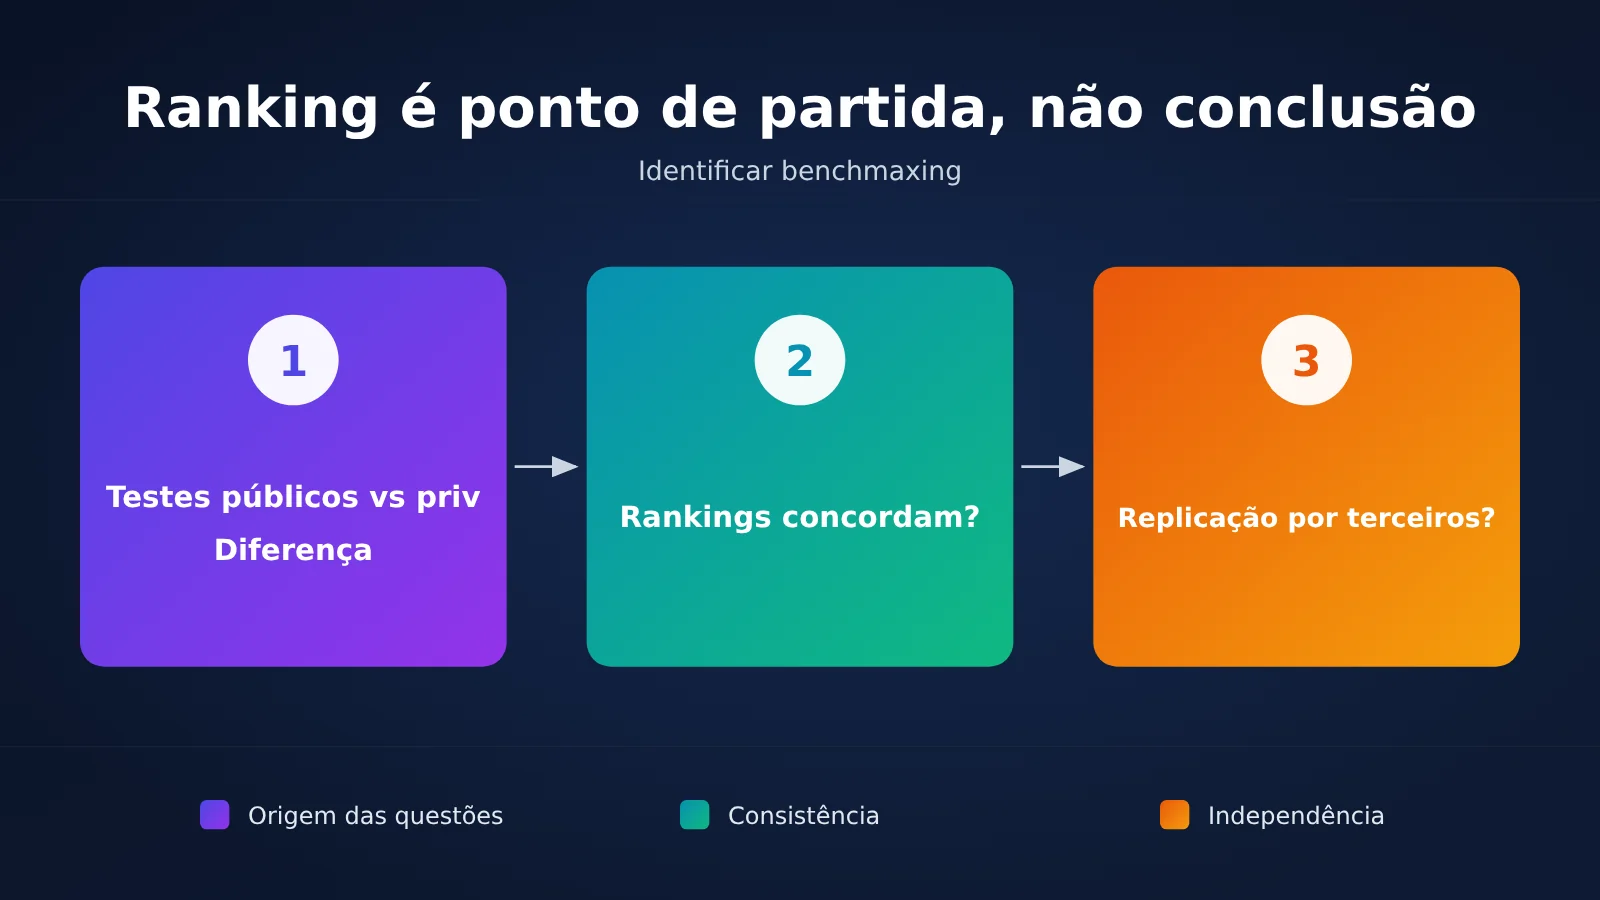
Segundo um artigo da MindStudio de 1º de novembro de 2026, benchmaxing é treinar ou ajustar um modelo para alcançar notas altas em benchmarks conhecidos, em vez de melhorar suas capacidades gerais. O sinal típico é este: o modelo se destaca no ranking, mas seu desempenho cai bastante diante de questões novas que avaliam a mesma capacidade.
| Causa | Como acontece | Indícios |
|---|---|---|
| Questões nos dados de treinamento | Questões do benchmark ou variantes muito parecidas entram no corpus de treinamento, de forma intencional ou não | A nota é alta nas questões originais, mas cai quando elas são reformuladas |
| Ajuste fino por tipo de questão | O modelo é otimizado para os formatos e padrões de raciocínio favorecidos por um benchmark específico | Destaca-se em um único ranking, mas tem desempenho mediano nos demais |
| Circulação prolongada de questões públicas | As questões são discutidas em fóruns e blogs e acabam entrando nos dados coletados da web | Quanto mais antigo o benchmark público, mais próximas da saturação ficam as notas |
Benchmaxing nem sempre é intencional
O artigo ressalta que nenhuma dessas três situações exige má-fé. Um laboratório pode acreditar de fato que está melhorando a capacidade geral de raciocínio, quando na prática está ajustando o modelo em excesso a alguns tipos de questão conhecidos. Quanto mais tempo um benchmark fica público, menos ele se parece com uma avaliação de capacidade e mais com um simulado que o modelo já resolveu antes.
Por isso, na hora de avaliar, olhe para as evidências, não para as intenções. O que importa é saber se o desempenho se mantém em questões novas, não especular se alguém fez isso de propósito.
Por que surge o benchmaxing: ritmo de lançamentos e comparações entre modelos
As pontuações são a maneira mais simples de os laboratórios mostrarem progresso a investidores, desenvolvedores e ao público, sem precisar abrir espaço para uma auditoria independente completa. Um número como “59 pontos no índice geral” cabe facilmente em um comunicado à imprensa e pode ser comparado com o resultado de um concorrente. Quanto mais simples o número, maior a pressão para otimizá-lo.
O segundo fator é o ritmo de lançamentos. Segundo a mesma matéria da MindStudio, um modelo da família Google Gemini marcou 50 pontos no Artificial Analysis Index. Cerca de um mês depois, seu sucessor, da mesma empresa, marcou 59 e chegou ao topo. Esses dados têm apenas uma fonte, e este artigo não os verificou de forma independente. O ponto da matéria original é que, quando as iterações acontecem em questão de semanas e a diferença entre os líderes é de poucos pontos, qualquer forma de abrir vantagem se torna atraente.
Antes de ler o ranking, classifique os fatos
Ao citar uma pontuação, primeiro entenda a que categoria ela pertence. A tabela abaixo usa os casos abordados neste artigo como exemplo:
| Tipo de informação | Caso neste artigo | Como avaliar a confiabilidade |
|---|---|---|
| Declaração oficial / previsão verbal | Musk afirmou que o Grok 5 poderia chegar “perto da pontuação máxima” no Humanity’s Last Exam e que o Grok 4 alcançou cerca de 52% na parte textual do teste | São uma previsão e uma declaração do próprio Musk, não resultados de testes independentes |
| Teste independente de terceiros | O Artificial Analysis Index reúne testes de raciocínio, programação, ciências, matemática e outras áreas | Pode servir como referência, desde que a data da consulta seja informada |
| Reportagem de uma única fonte | A pontuação do Grok 4.7 no índice, seu resultado no Terminal-Bench e a evolução do Gemini de 50 para 59 pontos | A MindStudio é a única fonte; os dados não foram verificados de forma independente |
| Desconhecido | A data exata e a abrangência da mudança da Artificial Analysis para questões privadas | Vale o que consta na explicação oficial; este artigo não faz suposições |
Segundo a MindStudio, o Grok 4.7 ficou atrás dos modelos líderes tanto no índice geral independente quanto no Terminal-Bench. A matéria original usa essa “diferença entre as expectativas públicas e os testes independentes” como um sinal a ser examinado e deixa claro que isso não significa que a xAI tenha mais problemas do que outras empresas. Este artigo segue a mesma abordagem, sem tirar conclusões.
5 sinais para avaliar a confiabilidade das pontuações nos rankings
A resposta dos avaliadores independentes é simples: não divulgar as questões. Se elas nunca forem publicadas, ninguém poderá treinar especificamente para elas. Segundo a MindStudio, instituições como a Artificial Analysis já passaram a usar questões privadas. Dentro de uma mesma categoria de capacidade, a diferença entre a pontuação em questões públicas e em novas questões privadas é considerada um dos sinais mais confiáveis de benchmaxing.
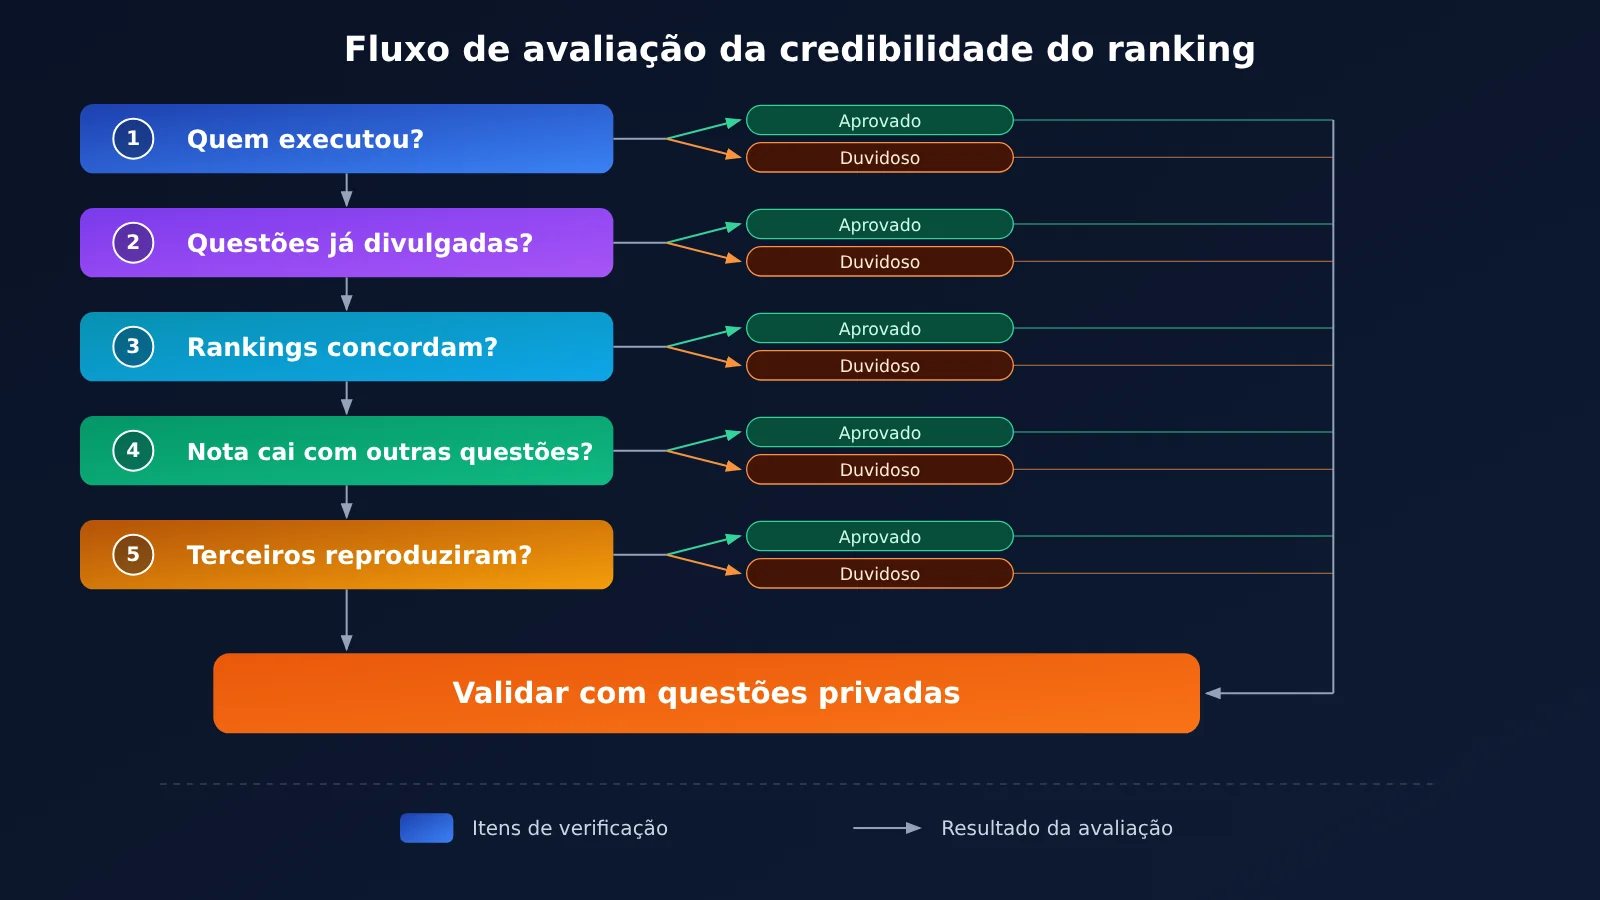
Com base nas recomendações do artigo original, dá para resumir a avaliação nesta lista de cinco itens:
| Nº | Item de verificação | Como verificar | Sinal positivo | Sinal de alerta |
|---|---|---|---|---|
| 1 | Quem executou a avaliação | Veja se o resultado vem de um relatório técnico do fabricante ou de uma página de avaliação independente | Execução independente por terceiros | Apenas resultados divulgados pelo fabricante |
| 2 | As questões já foram publicadas? | Confira se a data de publicação do benchmark é anterior à data de corte do treinamento do modelo | Questões privadas ou publicadas após o treinamento | Questões antigas, públicas há anos |
| 3 | Os resultados são consistentes entre rankings? | Compare vários benchmarks, como os de raciocínio, programação e matemática | Posições semelhantes nos diferentes rankings | Destaque em apenas um ranking |
| 4 | A pontuação cai quando as questões mudam? | Compare conjuntos públicos e privados, além de questões originais e reformuladas | Diferença pequena após a troca das questões | Queda significativa após a troca |
| 5 | Terceiros reproduziram os resultados? | Procure relatórios de reprodução independente e confira as configurações da avaliação | Reprodução por várias partes e configurações transparentes | Resultados impossíveis de reproduzir ou configurações não divulgadas |
Por que é mais difícil manipular um índice composto
Segundo o artigo original, o valor do Artificial Analysis Index está em combinar vários tipos de teste em uma única pontuação. É possível sobreajustar um modelo a um teste específico, mas fazer o mesmo ao mesmo tempo para testes de raciocínio, programação, ciências e matemática é muito mais difícil, especialmente quando algumas questões não são públicas. Por isso, vale dar mais peso ao item 3, “resultados consistentes entre rankings”.
Crie uma bateria privada de testes com suas próprias tarefas: processo em 4 passos
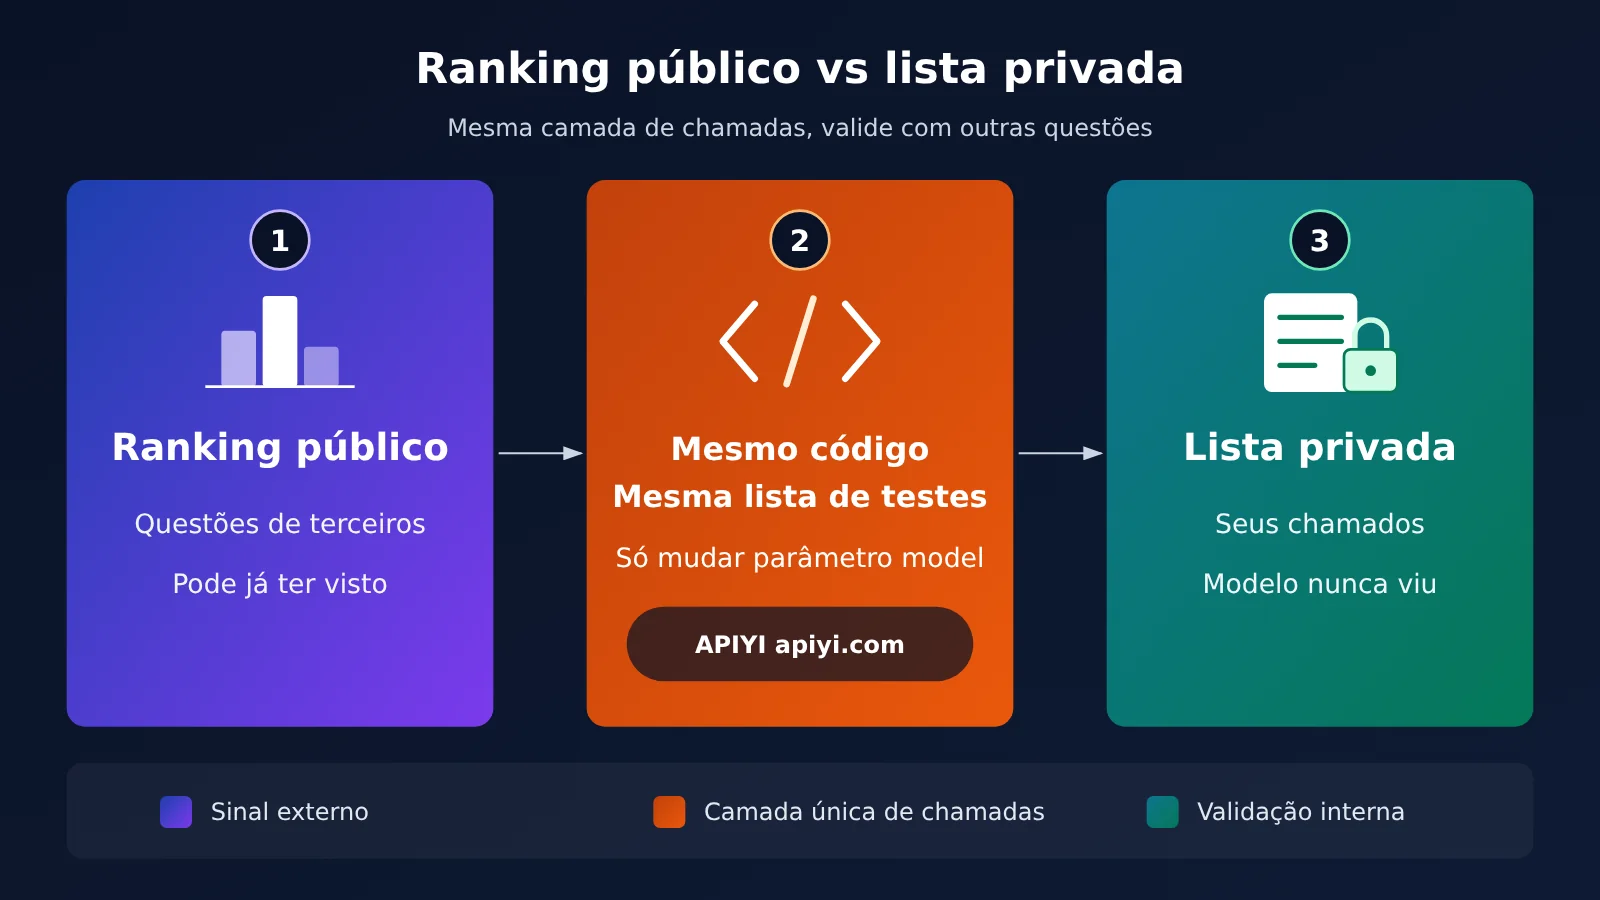
Por mais confiável que seja um ranking, ele ainda avalia tarefas de outras pessoas. Para escolher o modelo ideal, use sua própria bateria privada de testes. A vantagem é que nenhum laboratório terá visto essas tarefas antes.
| Etapa | O que fazer | Como fazer | Resultado |
|---|---|---|---|
| ① Selecionar amostras | Escolher tarefas reais do negócio | Use chamados reais, casos de falha em logs de produção e conversas de reclamação de usuários; separe por tipo de tarefa e comece com 20 a 50 exemplos por categoria | Conjunto inicial de testes com etiquetas |
| ② Definir critérios de aceitação | Estabelecer o que é considerado “bom o suficiente” | Priorize resultados verificáveis, como campos JSON, etiquetas de classificação e aprovação em testes unitários; para respostas abertas, use critérios de pontuação e faça uma revisão manual de uma proporção fixa das respostas | Script e critérios de pontuação |
| ③ Testar vários modelos | Controlar as variáveis para comparar os resultados | Use o mesmo comando, os mesmos parâmetros e a mesma pessoa avaliadora ou as mesmas regras de pontuação; registre pontuação, latência e consumo de tokens | Tabela comparativa de resultados |
| ④ Atualizar regularmente | Evitar que a bateria vire um simulado previsível | Adicione novos casos de falha todo mês e retire tarefas em que todos os modelos atinjam a pontuação máxima; reserve parte dos testes sem usá-los no ajuste de parâmetros | Bateria de testes versionada |
Amostragem e critérios de aceitação do conjunto privado de testes
Na hora de selecionar os casos, as falhas são mais valiosas que os sucessos. Conversas em que o usuário precisou repetir a pergunta, houve intervenção humana ou foi registrada uma avaliação negativa são as que melhor revelam as diferenças entre os modelos. Defina os critérios de aceitação antes de executar os testes; caso contrário, é fácil ajustá-los para justificar os resultados depois.
A definição de “bom o suficiente” precisa ser mensurável. Por exemplo: “a precisão dos campos na extração estruturada atinge determinado limite” ou “as respostas de atendimento não apresentam erros factuais na revisão humana por amostragem”. A proporção revisada depende do risco: em operações de alto risco, vale revisar uma amostra maior; em tarefas de baixo risco, a avaliação pode ser principalmente automática.
Como controlar as variáveis na comparação entre modelos
O problema mais comum nas comparações é não controlar as variáveis: usar um comando cuidadosamente ajustado para o modelo A e um comando padrão para o modelo B. O jeito certo é usar o mesmo código e o mesmo conjunto de testes, trocando apenas o nome do modelo.
Se os modelos candidatos vierem de diferentes fornecedores, manter vários SDKs pode dar trabalho. A APIYI é compatível com o formato da OpenAI: um único token permite acessar modelos de vários fornecedores, e basta alterar o parâmetro model para trocar de modelo. Isso facilita executar o mesmo conjunto de testes com o mesmo script de avaliação. Veja como configurar:
- SDK oficial da OpenAI para Python: ao inicializar o cliente, defina
base_urlcomohttps://api.apiyi.com/v1e preenchaapi_keycom o token da plataforma - Troca de modelo no ciclo de avaliação: altere apenas o campo
model, usando os nomes da lista de modelos da APIYI apiyi.com - Parâmetros de amostragem fixos: configure
temperature=0e o mesmo valor demax_tokenspara todos os modelos, reduzindo a influência da aleatoriedade - Registro de uso: leia o campo
usagedas respostas e some o consumo de tokens de cada modelo no conjunto de testes
🚀 Para começar: escolha 3 a 4 modelos bem colocados nos rankings e que tenham passado pelas 5 verificações acima. Acesse cada um pela APIYI apiyi.com com o mesmo token e, em uma tarde, você terá uma primeira comparação baseada em 50 chamados reais.
Evite ajustar seus próprios parâmetros para a lista de testes
Você também pode acabar praticando benchmaxing na sua própria lista de testes. Ajustar o comando repetidamente até que um modelo acerte todas as 50 questões não é, na prática, diferente de um fornecedor otimizar para subir no ranking. Para evitar isso:
- Separe um conjunto de teste: reserve cerca de 30% das questões, ajuste os parâmetros usando apenas o conjunto de desenvolvimento e tome a decisão final com base no conjunto reservado
- Congele os comandos: ao iniciar a comparação oficial, fixe os comandos por número de versão; qualquer alteração exige executar novamente todos os modelos
- Renove as questões: a cada atualização da lista, inclua casos recentes de falha para acompanhar as mudanças do negócio
Quando não olhar apenas para as pontuações do ranking
Mesmo que as pontuações do ranking sejam totalmente confiáveis, elas podem não medir o que importa para você. Nos cenários abaixo, o ranking serve, no máximo, como referência geral:
| Cenário | Por que o ranking não cobre | Que avaliação complementar fazer |
|---|---|---|
| Tarefas especializadas de nicho | Termos do setor, formatos internos e idiomas menos difundidos raramente aparecem em benchmarks gerais | Uma lista privada de testes composta por dados reais do negócio |
| Uso de ferramentas e agentes | Perguntas e respostas em uma única rodada não medem a estabilidade de chamadas em várias etapas nem a taxa de acerto no formato dos parâmetros | Taxa de sucesso em tarefas de ponta a ponta e taxa de erros no formato de chamadas de função |
| Custo e latência | O ranking classifica apenas a capacidade, sem considerar o custo por requisição nem a latência até o primeiro token | Registrar também o uso de tokens e o tempo de resposta durante os testes |
| Estabilidade | Uma única execução não revela as oscilações em produção | Executar a mesma questão várias vezes e verificar a consistência dos resultados |
Uma regra prática: depois que a capacidade atende ao necessário, o que importa comparar é o custo-benefício e a estabilidade. O primeiro e o terceiro colocados no ranking podem atender igualmente aos requisitos na sua lista de testes. Nesse caso, o modelo com menor latência e custo mais controlável costuma ser a melhor escolha. Com o acesso unificado pela APIYI apiyi.com, você pode comparar lado a lado a capacidade, o tempo de resposta e o uso de tokens na mesma tabela de resultados.
Perguntas frequentes (FAQ)
Q1: Benchmaxing é a mesma coisa que o modelo trapacear?
Não. Questões podem entrar nos dados de treinamento acidentalmente, por meio de rastreadores, e a equipe pode otimizar o modelo para determinados tipos de questão acreditando que está melhorando sua capacidade de raciocínio. Na avaliação, o que importa é verificar se a pontuação se mantém com questões diferentes, sem tirar conclusões sobre a intenção.
Q2: Em quais situações as pontuações dos rankings ainda são confiáveis?
As pontuações continuam sendo um sinal útil quando as questões são privadas ou surgiram após a data de corte do treinamento, o teste é executado de forma independente por terceiros, as conclusões são consistentes entre vários rankings e os resultados são reproduzidos por outras pessoas. É mais difícil inflar um índice que combina vários tipos de teste do que uma pontuação de benchmark isolada.
Q3: Quantas questões uma lista privada precisa ter, no mínimo?
Não existe um padrão único. Na prática, comece com 20 a 50 exemplos reais para cada tipo de tarefa, o suficiente para identificar diferenças evidentes. Se as diferenças não forem claras, aumente a quantidade de questões e reserve um conjunto para validação.
Q4: Como comparar modelos de diferentes empresas usando o mesmo código?
O jeito mais simples é usar uma interface compatível com a OpenAI. Depois de obter um token pela APIYI em apiyi.com, aponte `base_url` para o endereço da plataforma e altere apenas o parâmetro `model` no loop. Assim, você pode comparar os modelos usando a mesma lista de questões. Consulte a lista da plataforma para saber quais modelos estão disponíveis.
Q5: O Grok 5 está perto da pontuação máxima no Humanity’s Last Exam?
Até a data deste artigo, isso é uma previsão pública de Musk, não um resultado de teste. Se essa pontuação realmente aparecer no futuro, vale conferir os cinco itens da lista de verificação, especialmente o desempenho da mesma capacidade em novas questões privadas. Depois, use sua própria lista de questões na APIYI em apiyi.com para verificar se o modelo atende às necessidades do seu negócio.
Benchmaxing e avaliação com tarefas próprias: principais pontos
- Definição: benchmaxing é a otimização para questões conhecidas de um teste, fazendo com que a pontuação no ranking supere a capacidade real do modelo.
- Causas: questões incluídas nos dados de treinamento, ajuste fino por tipo de questão e circulação prolongada de testes públicos. Nenhuma dessas situações exige má intenção.
- Principal sinal: queda de desempenho quando a mesma capacidade é avaliada com questões novas.
- 5 verificações: quem executou o teste, se as questões já foram divulgadas, se os resultados são consistentes em vários rankings, se a pontuação cai com questões novas e se há reprodução por terceiros.
- Questionário em 4 etapas: selecionar amostras, definir critérios de aceitação, testar vários modelos e atualizar as questões regularmente. Reserve também um conjunto de validação para evitar sobreajuste ao próprio teste.
- Invocação unificada: com a interface compatível com OpenAI da APIYI em apiyi.com, basta alterar o parâmetro
modelpara trocar de modelo.
Resumo: rankings são o ponto de partida, não a conclusão
Você pode começar hoje com três ações. Primeiro, passe cada pontuação dos rankings que você acompanha pela lista de 5 verificações e registre o tipo de evidência e a data da referência. Segundo, selecione 50 casos de falha nos logs do último mês e defina os critérios de aceitação antes de testar os modelos. Terceiro, execute uma rodada com 3 a 4 modelos candidatos, usando o mesmo código e os mesmos parâmetros, e registre a pontuação, a latência e o consumo.
Uma opção é usar a APIYI em apiyi.com para comparar vários modelos com um único token e atualizar o questionário mensalmente. A escolha deve se basear nas suas próprias tarefas, não nas provas de outras pessoas.
📚 Referências
- MindStudio: O que é benchmaxing? Por que os laboratórios de IA estão ocultando as perguntas dos testes (2026-11-01)
- Link:
mindstudio.ai/blog/ai-benchmark-maxing-private-tests -
Descrição: definição e causas do benchmaxing, tendência de uso de perguntas privadas e única fonte dos dados sobre Gemini e Grok citados no artigo
-
Site oficial da Artificial Analysis: avaliações independentes de modelos e índice geral
- Link:
artificialanalysis.ai - Descrição: consulte as informações oficiais para confirmar quando e em que medida houve a mudança para perguntas privadas
Autores: equipe técnica da APIYI
Contato técnico: entre em contato conosco pela página inicial da APIYI em apiyi.com. Para mais informações sobre integração, acesse a documentação em docs.apiyi.com.