作者注:本文以 openJiuwen WorkSwarm 的 컨텍스트 전환 메커니즘을 사례로, ‘인계 요약 + 아카이브 검색’ 패턴을 살펴보고 장시간 실행되는 에이전트가 컨텍스트 윈도우 한계에 대응할 때 선택할 수 있는 설계 방식과 트레이드오프를 정리해요.
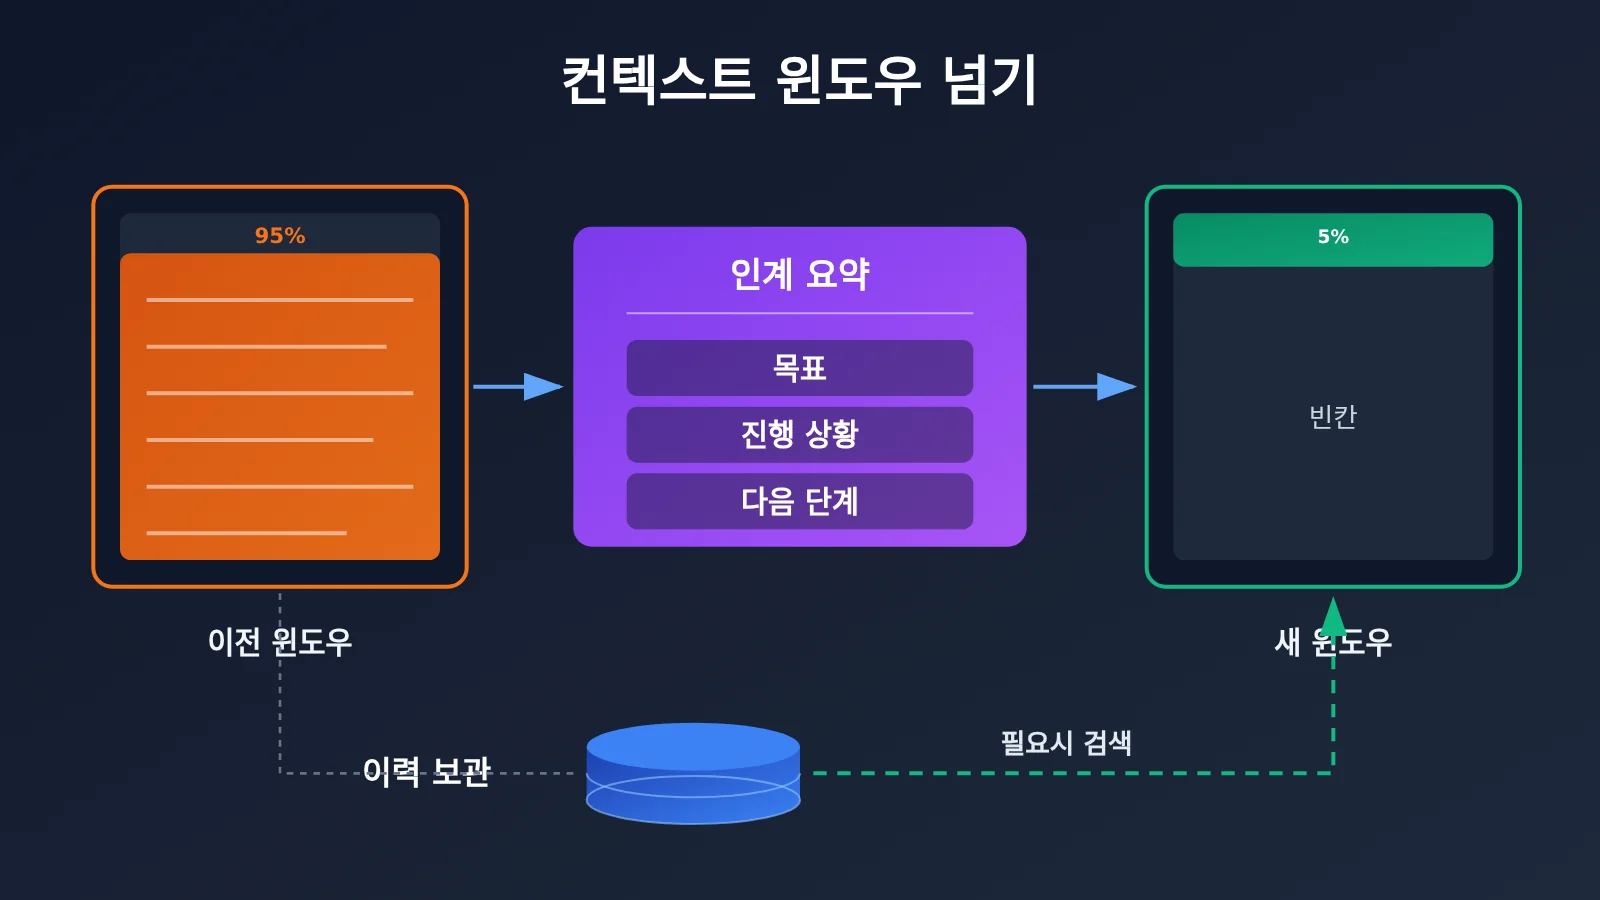
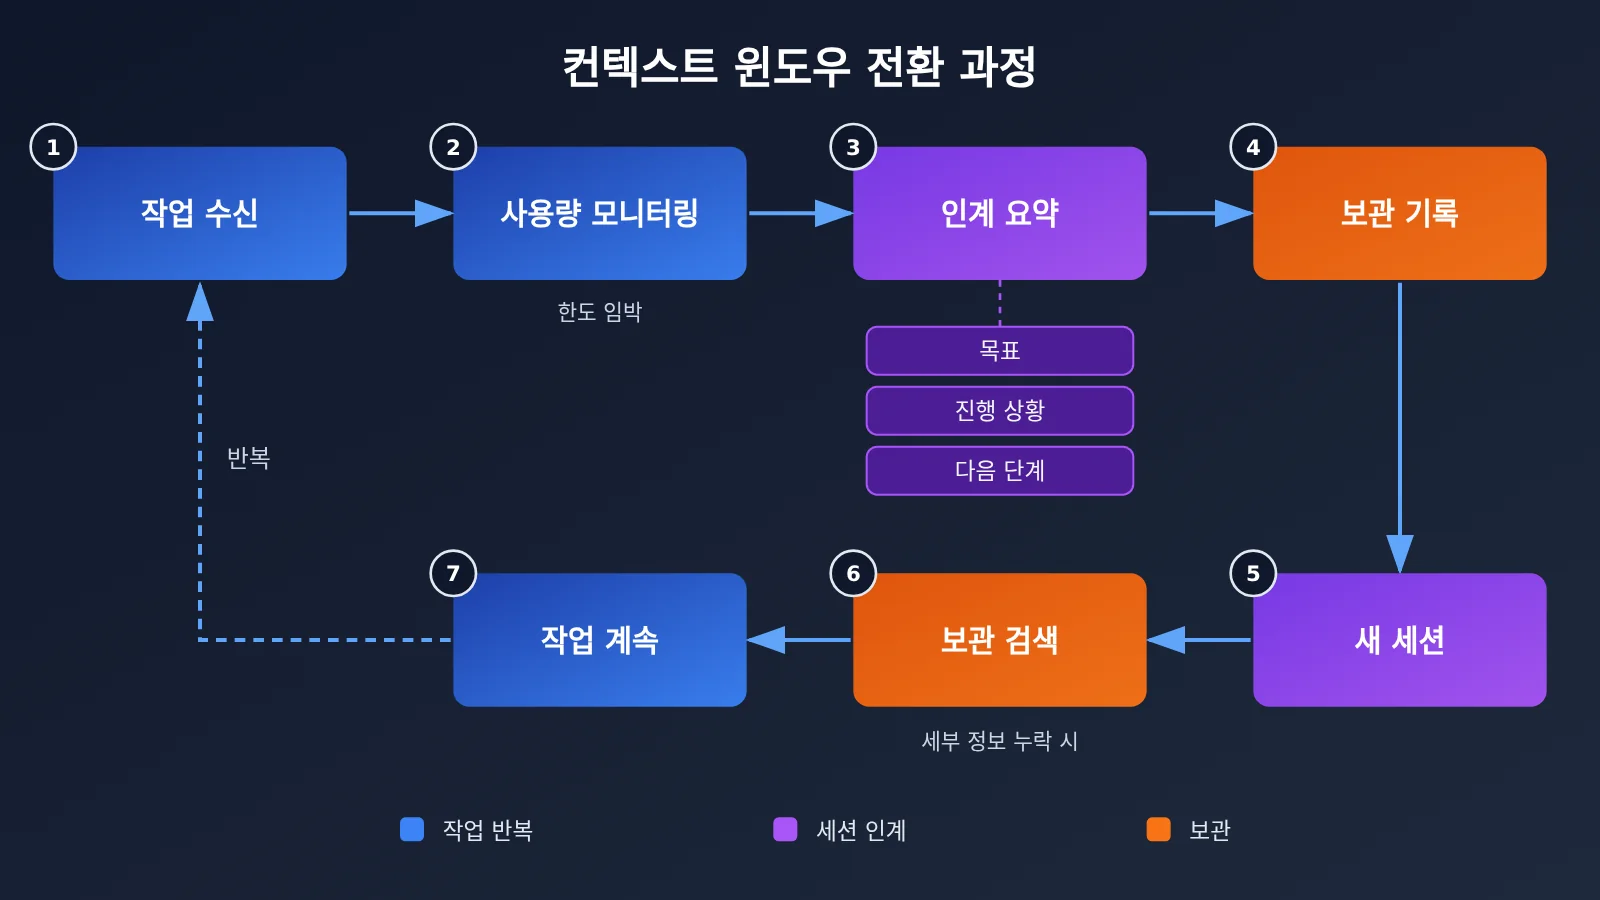
화웨이가 지원하는 오픈소스 에이전트 커뮤니티 openJiuwen이 최근 Hyper-Agent 클러스터 아키텍처를 공개했어요. 그중 개발자가 주목할 만한 부분이 있어요. 에이전트의 컨텍스트 윈도우가 한계에 가까워지면 목표, 진행 상황, 다음 단계를 담은 인계 요약을 가지고 새 윈도우로 전환해요. 세부 정보가 필요할 때는 아카이브에 저장된 이력을 검색해요. 한 문장으로 설명할 수 있는 메커니즘이지만, 그 뒤에는 장시간 실행되는 모든 에이전트가 마주하는 엔지니어링 문제가 있어요.
이건 단순한 소문이 아니에요. 관련 기능은 openJiuwen WorkSwarm과 함께 공개됐으며, 코드는 JiuwenSwarm이라는 이름으로 GitHub에 오픈소스로 공개돼 있어요. 이 글에서는 이 메커니즘을 사례로 인계 요약에 무엇을 담을지, 언제 전환할지, 언제 아카이브를 다시 검색할지라는 세 가지 설계 문제를 살펴봐요. 그리고 ‘더 긴 컨텍스트에 의존하는 방식’과 ‘요약 인계 + 검색 방식’의 트레이드오프를 비교해요.
핵심 가치: 이 글을 읽고 나면 자신의 에이전트 애플리케이션에 적용할 수 있는 컨텍스트 윈도우 한계 대응 방안과 각각의 위험을 정리할 수 있어요.
인계 요약 + 아카이브 검색: 핵심 정보 한눈에 보기
먼저 참고 자료에서 확인할 수 있는 사실을 정리하고, 이것이 개발자에게 어떤 의미인지 살펴볼게요. 아래 정보는 모두 공개 보도를 바탕으로 하며, 보도에서 확인되지 않은 구현 세부 사항은 뒤에서 별도로 표시했어요.
| 항목 | 내용 |
|---|---|
| 발표 주체 | 화웨이가 지원하는 오픈소스 에이전트 커뮤니티 openJiuwen |
| 발표 내용 | Hyper-Agent 클러스터 아키텍처와 이를 구현한 openJiuwen WorkSwarm |
| 오픈소스 현황 | JiuwenSwarm이라는 이름으로 GitHub에 코드 공개 |
| 핵심 변화 | 지속형 에이전트(Persistent Agent)가 고유한 정체성과 상태를 유지하고, 세션은 시스템이 스케줄링하는 기반 리소스로 전환 |
| 컨텍스트 메커니즘 | 윈도우가 한계에 가까워지면 ‘목표, 진행 상황, 다음 단계’를 담은 인계 요약과 함께 새 윈도우로 전환하고, 세부 정보가 필요할 때 아카이브 기록 검색 |
| 보도 시점 | 2026년 11월 초 |
지속형 에이전트가 컨텍스트 윈도우 한계를 해결해야 하는 이유
WorkSwarm은 에이전트가 단일 채팅 세션에서 벗어나 페이슈, 딩딩 등의 업무용 그룹 채팅에 ‘디지털 직원’으로 장기간 상주하도록 설계됐어요. 하나의 에이전트가 여러 외부 그룹 채팅에서 여러 작업을 진행하고, 한 채널에서 요청을 받아 다른 채널에 결과를 전달할 수 있어요. 시스템은 게이트웨이로 인스턴트 메신저와 웹 인터페이스를 연결하고, AgentServer가 에이전트와 업무 세션을 스케줄링해요.
이런 환경에서는 컨텍스트 윈도우 한계가 가끔 발생하는 문제가 아니라 반드시 마주하게 되는 문제예요. 단발성 질문에 답하는 챗봇은 윈도우를 가득 채울 일이 드물지만, 며칠에 걸쳐 프로젝트를 진행하는 에이전트는 대화 기록과 도구 호출 결과, 파일 내용이 계속 쌓이기 때문이에요. 보도에 따르면 WorkSwarm의 활동 대시보드에는 에이전트별 토큰 사용량도 표시돼요. 이는 컨텍스트 소비량이 이런 시스템에서 지속적으로 살펴봐야 할 운영 지표라는 뜻이에요.
리소스로서의 세션: 인계 요약의 전제
인계 요약 메커니즘을 이해하려면 WorkSwarm이 ‘에이전트’와 ‘세션’을 분리했다는 점이 중요해요. 에이전트의 정체성과 상태는 계속 유지되지만, 세션은 시스템이 할당하고 동시에 스케줄링하며 컨텍스트와 함께 복원할 수 있는 리소스예요. 세션을 교체할 수 있으니 ‘윈도우가 차면 새 윈도우로 바꾼다’는 것도 자연스러운 설계 방식이에요.
인계 요약은 이전 세션과 새 세션 사이에 최소한이면서도 충분한 작업 상태를 전달해요. 아카이브 기록 덕분에 이전 세션의 세부 정보도 사라지지 않아요. 다만 ‘항상 컨텍스트에 있는’ 정보에서 ‘필요할 때 불러오는’ 정보로 바뀌는 거예요.
인계 요약 설계 문제 1: 무엇을 담아야 할까?
보도에서 제시한 세 가지 요소는 목표, 진행 상황, 다음 단계예요. 간결한 구조지만 실제로 적용하려면 각 항목을 더 세분화해야 해요. 아래 표는 이 세 요소를 바탕으로 확장한 설계 참고안으로, 엔지니어링 관점의 제안이지 JiuwenSwarm에서 구현된 것으로 확인된 내용은 아니에요.
| 필드 | 권장 내용 | 누락 시 위험 |
|---|---|---|
| 목표 | 원래 작업 설명, 결과물 요구사항, 요청자와 전달 채널 | 새 윈도우에서 원래 요구사항을 벗어나거나 잘못된 그룹 또는 형식으로 결과물을 전달할 수 있어요 |
| 진행 상황 | 완료된 하위 작업, 주요 결정과 그 이유 | 작업을 중복하거나 이미 확정된 방안을 뒤집을 수 있어요 |
| 다음 단계 | 할 일, 진행을 막는 요인, 기다리는 외부 응답 | 작업이 멈추고 에이전트가 어디서부터 이어야 할지 모를 수 있어요 |
| 제약 조건(확장) | 사용자가 명시한 금지 사항, 권한 범위, 형식 선호도 | 사용자가 이미 밝힌 선호도를 어겨 경험이 단절될 수 있어요 |
| 색인(확장) | 주요 정보가 보관 기록에 저장된 위치나 키워드 | 세부 정보가 필요할 때 찾지 못해 보관 기록이 제 역할을 못 할 수 있어요 |
이 중 ‘제약 조건’과 ‘색인’은 저희가 추가한 항목이에요. 제약 조건이 중요한 이유는 사용자가 긴 대화에서 간간이 표현한 선호도(예: “보고서는 한 페이지를 넘기지 마세요”)가 요약 과정에서 빠지기 쉽기 때문이에요. 색인은 인계 요약과 보관 기록 검색을 연결하는 다리 역할을 해요. 요약이 짧을수록 새 윈도우에 “세부 정보가 어디에 있는지” 알려줄 필요가 커져요.
WorkSwarm에서는 여러 그룹과 채널을 사용하면서 생기는 복잡성도 고려해야 해요. 보도에 따르면 그룹 간 공유에는 사용자 승인이 필요하며, 일회성 또는 영구 권한을 부여하고 나중에 철회할 수도 있어요. 이런 권한 상태가 인계 요약에 기록되지 않으면 새 윈도우의 에이전트가 권한을 잘못 판단할 수 있어요. 따라서 이 정보는 자유 텍스트보다 구조화된 필드로 저장하는 편이 적합해요.
인계 요약 설계 문제 2: 컨텍스트 전환 시점
보도에서는 “한도에 가까워지면” 전환한다고만 설명해요. 구체적인 임계값과 요약을 모델이 생성하는지, 규칙에 따라 생성하는지는 공개 자료에 나와 있지 않아 JiuwenSwarm의 소스 코드나 문서를 확인해야 해요. 엔지니어링 관점에서 전환 시점은 보통 다음과 같이 선택할 수 있어요.
| 트리거 전략 | 구현 방식 | 장점 | 위험 |
|---|---|---|---|
| 고정 비율 임계값 | 토큰 사용량이 윈도우의 일정 비율에 도달하면 전환 | 구현이 간단하고 동작을 예측하기 쉬움 | 작업의 중요한 단계 도중에 전환될 수 있음 |
| 여유 공간 임계값 | 남은 공간이 다음 입력과 요약 생성에 필요한 분량보다 적어지면 전환 | 요약 생성에 필요한 공간을 확보할 수 있음 | 다음 입력의 크기를 예측해야 함 |
| 작업 경계 트리거 | 하위 작업 완료, 사용자 응답 대기 등 자연스러운 중단 지점에서 전환 | 요약이 더 완전하고 전환 비용이 낮음 | 윈도우가 가득 차기 전에 중단 지점이 나타나지 않을 수 있음 |
| 혼합 전략 | 작업 경계에서 우선 전환하고, 강제 임계값을 넘으면 즉시 전환 | 완전성과 안전성을 모두 고려할 수 있음 | 로직이 더 복잡하고 테스트가 더 많이 필요함 |
특히 인계 요약을 생성하는 데도 컨텍스트가 소모된다는 점에 주의해야 해요. 윈도우가 완전히 찰 때까지 기다리면 모델이 이력을 모두 읽고 고품질 요약을 작성할 공간이 부족할 수 있어요. 따라서 어떤 전략을 쓰든 요약 생성에 필요한 여유 공간을 확보해야 해요.
모델이 생성한 요약은 유연하고 작업의 의미를 이해할 수 있어요. 반면 규칙에 따라 생성한 요약은 안정적이지만, 대화에 암묵적으로 담긴 결정을 포착하기 어려워요. 예를 들어 작업 목록의 상태 필드를 직접 추출하는 방식이 여기에 해당해요. 실무에서는 두 방식을 결합하는 경우가 많아요. 구조화된 상태는 프로그램이 관리하고, 모델은 자연어로 진행 상황을 보충하는 역할만 맡는 거예요.
인수인계 요약 + 아카이브 검색 구현하기: 초간단 프로토타입
아래는 이 패턴의 아이디어를 보여주는 초간단 프로토타입이에요. JiuwenSwarm의 실제 구현은 아닙니다. 추정 토큰 사용량이 임계값에 가까워지면 모델이 인수인계 요약을 생성하고, 오래된 메시지를 아카이브에 저장해요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

HANDOFF_PROMPT = "请将以上工作记录整理为交接摘要,包含:目标、进展、下一步、约束、关键信息索引。"

def make_handoff(messages, model="gpt-4o-mini"):
    resp = client.chat.completions.create(
        model=model,
        messages=messages + [{"role": "user", "content": HANDOFF_PROMPT}]
    )
    return resp.choices[0].message.content
전체 프로토타입 코드 보기(전환 판단 및 아카이브 검색 포함)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"
CONTEXT_LIMIT = 100_000      # 예시 값이며, 사용하는 모델의 실제 컨텍스트 윈도우에 맞게 조정
SWITCH_RATIO = 0.7           # 요약 생성을 위한 공간 확보
HANDOFF_PROMPT = (
    "请将以上工作记录整理为交接摘要,分为五部分:"
    "1.目标 2.进展(含关键决策及理由)3.下一步 4.用户约束 5.关键信息索引(关键词列表)"
)

class LongRunningAgent:
    def __init__(self, system_prompt: str):
        self.system_prompt = system_prompt
        self.messages: List[Dict] = [{"role": "system", "content": system_prompt}]
        self.archive: List[Dict] = []   # 아카이브 기록. 운영 환경에서는 데이터베이스나 벡터 DB로 대체 가능

    def estimate_tokens(self) -> int:
        # 대략적인 추정치. 운영 환경에서는 해당 모델의 토크나이저를 사용해야 함
        return sum(len(m["content"]) for m in self.messages)

    def maybe_switch(self):
        if self.estimate_tokens() < CONTEXT_LIMIT * SWITCH_RATIO:
            return
        resp = client.chat.completions.create(
            model=MODEL,
            messages=self.messages + [{"role": "user", "content": HANDOFF_PROMPT}]
        )
        summary = resp.choices[0].message.content
        self.archive.extend(self.messages[1:])      # 이전 대화를 아카이브에 저장
        self.messages = [
            {"role": "system", "content": self.system_prompt},
            {"role": "system", "content": f"【交接摘要】\n{summary}"}
        ]

    def search_archive(self, keyword: str, top_k: int = 5) -> str:
        hits = [m["content"] for m in self.archive if keyword in m["content"]]
        return "\n---\n".join(hits[-top_k:]) or "归档中未找到相关记录"

    def chat(self, user_input: str) -> str:
        self.maybe_switch()
        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MODEL, messages=self.messages)
        answer = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": answer})
        return answer

agent = LongRunningAgent("你是负责跟进项目周报的数字员工。")
print(agent.chat("请记录:本周报告不要超过一页。"))
이 프로토타입의 아카이브 검색은 단순한 키워드 매칭이에요. 보도에서는 JiuwenSwarm이 벡터 검색을 사용하는지, 다른 방식을 사용하는지 밝히지 않았어요. 실제 프로젝트에서는 아카이브 규모에 따라 전문 검색, 벡터 검색 또는 두 방식을 혼합해 사용할 수 있어요. search_archive를 도구로 등록해 모델이 호출 시점을 직접 결정하도록 할 수도 있습니다.
🚀 빠른 시작: 이런 프로토타입을 만들 때 요약 생성과 주 작업에 서로 다른 모델을 사용할 수 있어요. 예를 들어 가벼운 모델로 요약을 생성하고, 성능이 뛰어난 모델로 주 작업을 처리하는 방식이에요. APIYI apiyi.com에서는 API 키 하나로 OpenAI, Claude, Gemini 등의 모델을 호출할 수 있어 같은 코드에서 모델을 바꿔가며 비교하기 편해요. 신규 사용자에게는 무료 테스트 크레딧도 제공됩니다.
인계 요약 설계 문제 3: 언제 보관된 대화 기록을 다시 조회할까?
보관 기록 검색은 ‘요약에는 필연적으로 정보 손실이 따른다’는 근본적인 문제를 해결해요. 어떤 방식으로 압축하든 정보는 사라지기 마련이죠. 핵심은 빠진 정보를 다시 찾아낼 수 있느냐예요. 보관 기록을 다시 조회하는 시점은 크게 세 가지 방식으로 설계할 수 있어요.
- 모델의 자율 호출: 검색 기능을 도구로 제공하고, 모델이 정보가 부족하다고 판단하면 직접 조회해요. 유연하지만 모델이 ‘자신이 무엇을 모르는지’ 판단할 수 있어야 해요.
- 규칙 기반 실행: 사용자가 요약에 없는 개체, 파일명, 시점을 언급하면 프로그램이 자동으로 검색하고 결과를 제공해요. 제어하기 쉽지만 규칙으로 다룰 수 있는 범위가 제한적이에요.
- 인덱스 기반 조회: 인계 요약에 핵심 정보의 인덱스를 남겨두고, 새 컨텍스트 윈도우에서 관련 주제가 나오면 인덱스를 따라 정확히 불러와요. 요약 단계에서 인덱스를 얼마나 잘 만들었는지가 중요해요.
가장 큰 위험은 ‘무엇을 빠뜨렸는지 모르는 것’이에요. 요약에서 사용자의 선호 사항이 빠지고 새 컨텍스트 윈도우에도 그 존재를 알려주는 단서가 없다면, 모델은 검색할 생각조차 하지 못해요. 앞서 요약에 ‘제약 조건’과 ‘인덱스’ 필드를 추가하자고 제안한 이유도 바로 여기에 있어요. 이 필드들이 보관 기록을 다시 조회할 실마리를 제공하거든요.
더 긴 컨텍스트 활용 vs 인수인계 요약: 영향 분석
컨텍스트 윈도우의 한계에 부딪혔을 때는 컨텍스트가 더 긴 모델로 바꾸는 방법도 있어요. 두 방식은 함께 사용할 수도 있지만, 적합한 상황은 다릅니다. 아래 표는 효과 측정 데이터가 아닌 판단에 기반한 분석이에요.
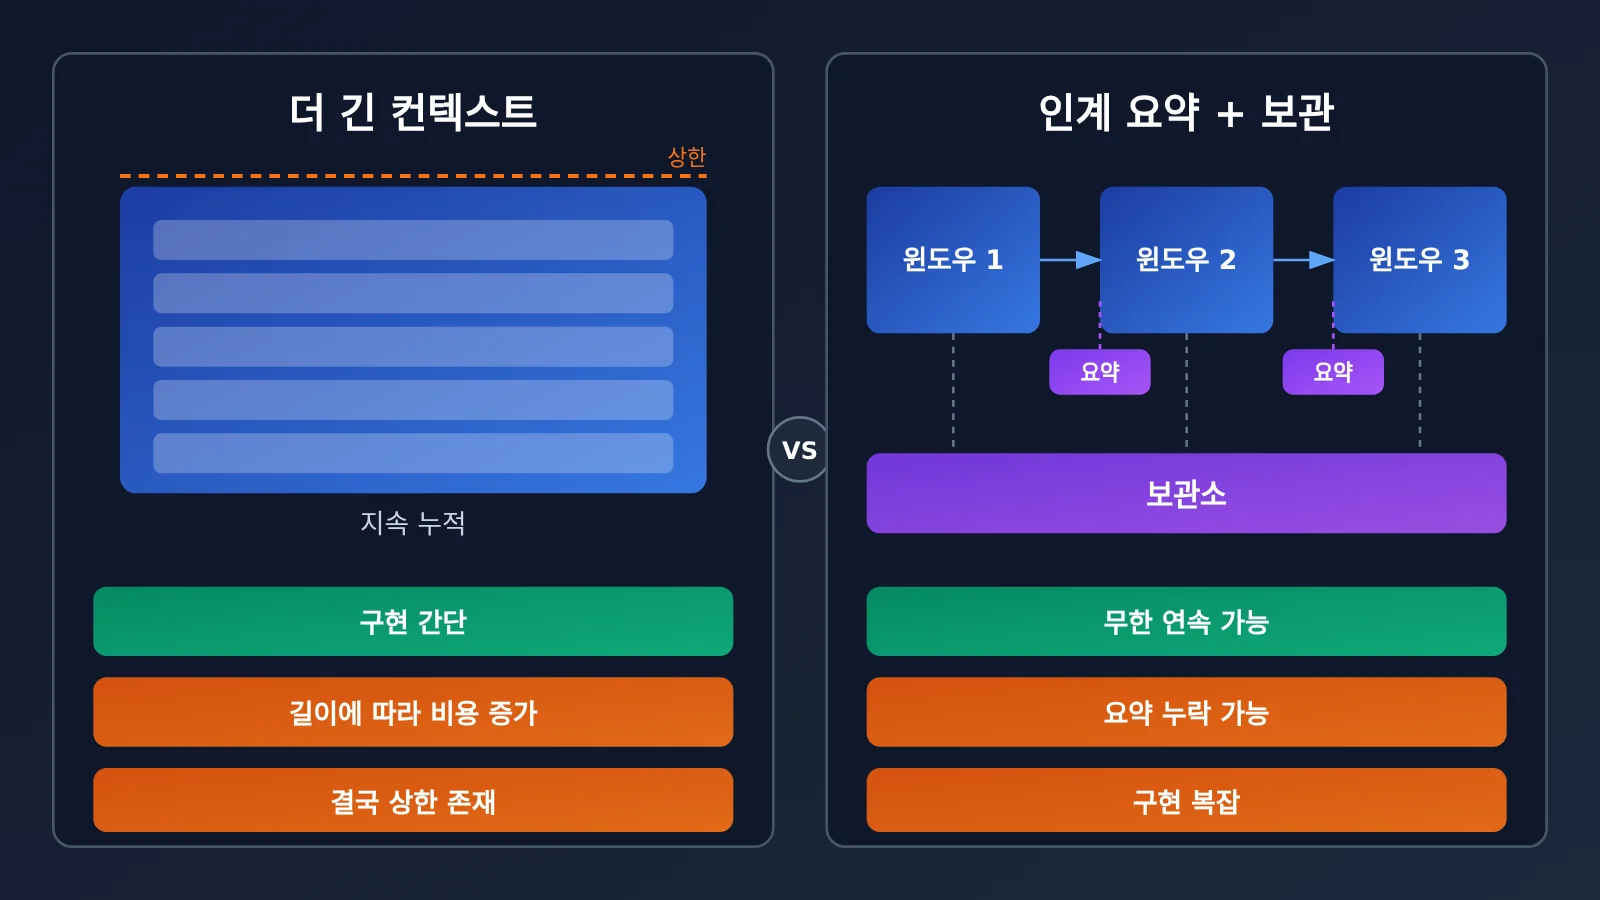
| 항목 | 더 긴 컨텍스트 활용 | 인수인계 요약 + 아카이브 검색 |
|---|---|---|
| 구현 복잡도 | 낮음, 거의 수정할 필요 없음 | 높음, 요약·아카이브·검색 로직이 모두 필요 |
| 정보 완전성 | 원본 정보가 모두 포함됨 | 요약 과정에서 정보가 손실되어 검색으로 보완해야 함 |
| 작업 지속 시간 | 모델의 윈도우 크기에 따라 제한됨 | 이론적으로 계속 이어갈 수 있음 |
| 단일 호출 비용 | 이력이 쌓일수록 계속 증가 | 전환할 때마다 감소 |
| 주요 위험 | 매우 긴 입력에서 핵심 정보가 묻힘 | 요약에서 누락된 세부 사항을 검색으로도 찾지 못함 |
| 적합한 상황 | 중간 길이의 작업이나 전체 내용을 대조해야 하는 작업 | 며칠에서 몇 주에 걸친 지속적인 작업 |
| 사용 가능한 플랫폼 | APIYI apiyi.com 등에서 다양한 컨텍스트 크기의 모델 제공 | 플랫폼에 관계없이 모든 모델에 적용 가능 |
💡 선택 가이드: 작업을 보통 하나의 긴 윈도우 안에서 끝낼 수 있다면, 긴 컨텍스트 모델로 바꾸는 편이 더 간편해요. 반면 에이전트가 WorkSwarm의 디지털 직원처럼 장기간 상주해야 한다면 인수인계 요약은 사실상 필수예요. 먼저 APIYI apiyi.com에서 컨텍스트 크기가 다른 모델로 같은 작업을 실행해 실제 사용량을 확인한 뒤, 요약 메커니즘을 개발할지 결정할 수 있어요.
개발자에게 미치는 영향
- 컨텍스트 관리가 아키텍처 차원의 문제가 돼요: WorkSwarm은 세션을 스케줄링할 수 있는 자원으로 다뤄요. 즉, 컨텍스트 전환을 오류 발생 후의 임시 조치가 아니라 시스템 설계에 포함한다는 뜻이에요.
- 상태를 명시적으로 모델링해야 해요: 인수인계 요약의 품질은 에이전트가 목표, 결정 사항, 할 일을 명확히 기록했는지에 달려 있어요. 따라서 개발자는 설계 단계부터 상태 구조를 계획해야 해요.
- 관측 가능성이 더욱 중요해져요: WorkSwarm은 활동 패널에 토큰 사용량과 응답 시간을 표시해요. 장기간 작동하는 에이전트도 전환 빈도와 검색 적중 여부를 모니터링해야 해요.
업계에 미치는 영향
- 세션형에서 상주형으로: 에이전트가 ‘일문일답’에서 ‘장기간 상주하는 작업 그룹’으로 발전하면서, 컨텍스트를 여러 윈도우에 걸쳐 이어가는 능력은 이런 제품의 핵심 인프라가 될 거예요.
- 오픈소스 구현이 참고 자료가 돼요: JiuwenSwarm이 오픈소스로 공개되면서 개발자는 전환 임계값, 요약 생성, 검색 구현을 처음부터 시행착오를 겪지 않고 직접 살펴볼 수 있어요.
자주 묻는 질문 FAQ
Q1: ‘인계 요약 + 아카이브 검색’ 방식이란 무엇인가요?
오랫동안 실행되는 에이전트가 컨텍스트 윈도우의 한계를 넘어서 작업을 이어가는 방식이에요. 윈도우가 한계에 가까워지면 에이전트는 목표, 진행 상황, 다음 단계가 담긴 인계 요약만 가지고 새 윈도우로 전환해요. 전체 기록은 아카이브에 보관하고, 세부 정보가 필요할 때 검색해요. openJiuwen WorkSwarm이 이 방식을 채택했어요.
Q2: 컨텍스트가 더 긴 모델로 바꾸면 해결되지 않나요?
중간 길이의 작업이라면 긴 컨텍스트를 지원하는 모델로 바꾸는 것이 가장 간편해요. 하지만 장기간 실행되는 에이전트는 기록이 계속 쌓이기 때문에 어떤 윈도우든 결국 가득 차요. 입력이 지나치게 길면 핵심 정보가 묻힐 수도 있고요. 먼저 APIYI apiyi.com에서 컨텍스트 크기가 다른 모델로 실제 작업을 테스트한 뒤, 요약 메커니즘이 필요한지 판단해 보세요.
Q3: WorkSwarm의 전환 임곗값과 요약 생성 방식은 무엇인가요?
현재 공개된 보도에는 구체적인 임곗값, 모델과 규칙 중 어떤 방식으로 요약을 생성하는지, 아카이브 검색에 벡터 검색을 사용하는지 등이 밝혀져 있지 않아요. 이런 구현 세부 사항은 GitHub의 JiuwenSwarm 오픈소스 코드나 공식 문서에서 확인해야 해요. 이 글의 관련 설명은 일반적인 엔지니어링 분석이에요.
Q4: API로 인계 요약 방식을 빠르게 검증하려면 어떻게 하나요?
다음 단계로 프로토타입을 만들 수 있어요.
1. APIYI apiyi.com에 가입하고 API 키와 무료 테스트 크레딧을 받으세요.
2. 이 글의 프로토타입 코드에서 base_url을 `https://api.apiyi.com/v1`로 설정하세요.
3. 실제 긴 대화로 테스트하고, 전환 후에도 에이전트가 핵심 제약 조건을 기억하는지 확인하세요.
Q5: 이 방식에는 어떤 위험이 알려져 있나요?
가장 큰 위험은 요약에서 세부 정보가 누락되고, 새 윈도우에 이를 검색할 단서도 남지 않는 것이에요. 작업의 중요한 단계 도중에 전환하면 상태가 일관되지 않을 수도 있어요. 또한 이 메커니즘이 작업 품질에 미치는 실제 영향에 관한 공개 테스트 데이터는 아직 없으므로, 도입 전에 각자의 사용 환경에서 충분히 검증해야 해요.
인수인계 요약과 컨텍스트 윈도우 핵심 요점 Key Takeaways
- 핵심 메커니즘: 윈도우가 거의 차면 목표, 진행 상황, 다음 단계를 담은 인수인계 요약과 함께 새 윈도우로 전환해요.
- 전제 조건: 에이전트의 정체성과 세션을 분리해 세션을 스케줄링하고 복구할 수 있는 리소스로 다뤄요.
- 요약 설계: 세 가지 핵심 요소에 사용자 제약 조건과 아카이브 인덱스를 추가해 누락 위험을 줄여요.
- 전환 시점: 요약 생성에 필요한 공간을 남겨두고, 가능하면 작업 경계에서 전환해요.
- 아카이브 재조회: 요약에는 정보 손실이 따르므로, 검색 경로가 있어야 정보를 다시 찾을 수 있어요.
- 방식 선택: 중간 규모 작업에는 긴 컨텍스트 모델을 사용할 수 있지만, 장기 실행 작업에는 요약을 통한 인수인계가 더 필요해요.
- 빠른 검증: APIYI apiyi.com의 멀티모델 통합 인터페이스로 프로토타입을 만들어 비교할 수 있어요.
정리
openJiuwen WorkSwarm의 컨텍스트 전환 메커니즘은 장시간 실행되는 에이전트에 유용한 참고 모델을 제시해요.
- 인수인계 요약에 작업 상태를 담아요: 목표, 진행 상황, 다음 단계가 최소 구성 요소이며, 제약 조건과 인덱스를 추가하면 실용적이에요.
- 전환 시점에 여유를 둬요: 요약을 생성할 때도 컨텍스트가 소모되므로, 윈도우가 완전히 찰 때까지 기다리면 안 돼요.
- 아카이브 검색으로 정보 손실에 대비해요: 요약에는 핵심만 담고, 세부 정보는 필요할 때 검색해요.
에이전트를 단일 세션에서 장기 실행 방식으로 확장하고 있다면, 먼저 상태 구조를 정리한 뒤 긴 컨텍스트 모델로 바꿀지 인수인계 요약을 도입할지 결정해 보세요. APIYI apiyi.com으로 프로토타입을 빠르게 만들고, 여러 모델의 요약 품질과 컨텍스트 사용량을 비교해 보는 것도 추천해요.
📚 참고 자료
- Pandaily 보도: openJiuwen Hyper-Agent 스웜 아키텍처와 WorkSwarm 디지털 직원
- 링크:
pandaily.com/openjiuwen-hyper-agent-swarm-architecture-persistent-agents-workswarm-digital-employees -
설명: 지속형 에이전트, 컨텍스트 전환, 인수인계 요약 메커니즘을 소개하는 영문 기사
-
JiuwenSwarm 오픈소스 코드: openJiuwen WorkSwarm의 오픈소스 구현
- 링크:
github.com(JiuwenSwarm 검색) - 설명: 전환 임곗값, 요약 생성, 아카이브 검색의 구체적인 구현 확인
작성자: APIYI 기술팀
기술 문의: APIYI apiyi.com 홈페이지에서 문의해 주세요. 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.