9월 하순부터 10월 초까지 최첨단 대규모 언어 모델이 잇달아 업데이트됐어요. Anthropic은 9월 22일 Claude Opus 5.5를 출시했고, 불과 8일 뒤 Google이 Gemini 4 Argon을 선보였어요. 두 모델은 장기 추론, 에이전트 기반 코딩, 기업 지식 업무를 핵심 용도로 내세우며 포지셔닝도 상당히 비슷해요. 정식 가격도 입력 100만 토큰당 4달러, 출력 100만 토큰당 20달러로 동일하죠. 그래서 개발자가 모델을 선택할 때 가장 자주 묻는 질문 중 하나가 바로 Gemini 4 Argon과 Claude Opus 5.5의 비교예요.
현재 공개된 정보는 많지 않아요. 가장 상세한 1차 자료는 Google이 Argon 평가 문서에 공개한 19개 항목의 벤치마크 비교표예요. 이 표에는 Claude Opus 5.5도 포함돼 있죠. 이 글에서는 해당 표를 중심으로 각 항목을 살펴보고, Artificial Analysis와 Vals 등 제3자 독립 평가 결과에 더해 가격, 출력 한도, 사용 가능 여부 같은 엔지니어링 요소도 함께 짚어볼게요. 두 모델이 각각 어떤 상황에 적합한지 판단하는 데 도움이 될 거예요.
핵심 가치: 이 글을 읽고 나면 Google의 평가표에서 어떤 수치는 신뢰할 만하고 어떤 수치는 감안해서 봐야 하는지 이해할 수 있어요. 또 자신의 업무 상황에 맞춰 Gemini 4 Argon과 Claude Opus 5.5 중 적합한 모델을 선택할 수 있습니다.
Gemini 4 Argon vs Claude Opus 5.5 기본 사양 비교
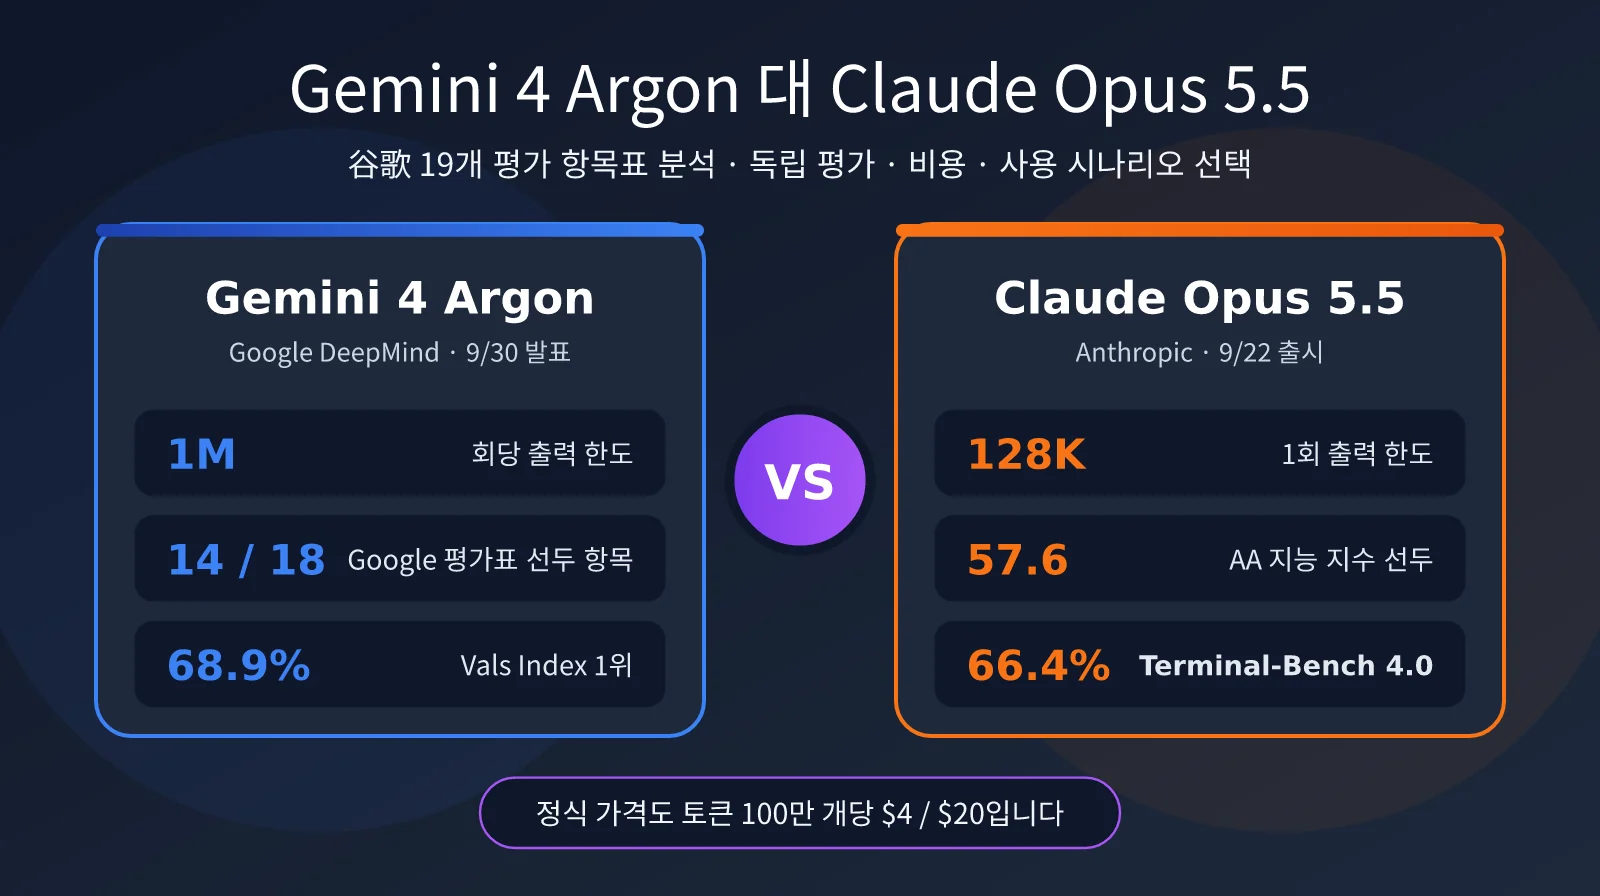
벤치마크 점수를 살펴보기 전에 두 모델의 기본 사양부터 비교해볼게요. 정식 가격은 두 모델이 완전히 같고, 실제 차이는 출력 한도, 사용 가능 여부, 출시 초기 가격 세 가지에서 두드러져요.
| 비교 항목 | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| 출시일 | 2026년 9월 30일 | 2026년 9월 22일 |
| 현재 사용 가능 여부 | Fairwind 프로그램과 Vertex AI를 통해 순차적으로 확대 중이며, 유료 API는 아직 전면 공개되지 않음 | Claude API, Bedrock, Vertex AI, Foundry에서 전면 사용 가능 |
| 모델 ID | 공식 미공개 | claude-opus-5-5 |
| 가격(입력/출력) | 출시 초기 $2/$10, 정식 $4/$20 | $4/$20 |
| 캐시 읽기 | 입력 가격 95% 할인(최저 $0.10) | $0.20 |
| Batch 일괄 처리 가격 | 미공개 | $2/$10 |
| 컨텍스트 윈도우 | 공식 미공개(제3자 자료에 따르면 1M) | 1M, 장문 컨텍스트 추가 요금 없음 |
| 요청당 출력 한도 | 1M 토큰 | 128K 토큰 |
| 추론 제어 | High 등 추론 단계 제공 | low부터 max까지 5단계 effort, 적응형 사고 지원 |
표에서 볼 수 있듯이 Argon의 가장 큰 사양상 강점은 1M 토큰 출력 한도예요. Opus 5.5의 약 8배에 달해, 초장문 코드 생성이나 대규모 마이그레이션 작업에 적합하죠. 반면 Opus 5.5의 가장 큰 장점은 지금 바로 안정적으로 사용할 수 있다는 점이에요. 모델 ID가 명확하고 주요 클라우드 플랫폼에서 모두 제공되며, Batch 반값 요금과 5단계 effort 제어도 지원해 엔지니어링 측면에서 훨씬 성숙한 상태예요.
🎯 비교 팁: 두 모델의 정식 가격은 같으니, 작업 유형을 기준으로 선택하는 게 좋아요. APIYI apiyi.com 플랫폼에서 동일한 인터페이스로 Claude Opus 5.5와 Gemini 계열 모델을 호출해 실제 업무에 쓰는 프롬프트로 나란히 테스트해보세요. 벤치마크 순위만 보는 것보다 더 신뢰할 수 있는 결과를 얻을 수 있어요.
Gemini 4 Argon vs Claude Opus 5.5 구글 평가표 항목별 분석
아래는 Google이 Argon 평가 문서에서 공개한 비교 데이터입니다. Argon과 Opus 5.5 두 열만 남기고, 항목별로 정리했어요. 다만 Google이 발표한 자체 평가표라는 점에 유의해야 합니다. Argon 점수는 Google이 직접 측정했고, Opus 5.5 점수는 대부분 공개 리더보드나 Anthropic 시스템 카드에서 가져왔으며, 일부 벤치마크는 Google이 같은 조건으로 다시 측정했습니다.
| 분야 | 벤치마크 | Gemini 4 Argon | Claude Opus 5.5 | 우세한 모델 |
|---|---|---|---|---|
| 지식 업무 | Vals Index | 68.9% | 67.0% | Argon +1.9 |
| 지식 업무 | AutomationBench | 51.3% | 42.5% | Argon +8.8 |
| 지식 업무 | Vals Finance Agent v2 | 65.4% | 58.6% | Argon +6.8 |
| 지식 업무 | Harvey 법률 에이전트 | 19.6% | 3.8% | Argon +15.8 |
| 에이전트 코딩 | DeepSWE v1.1 | 77.9% | 74.2% | Argon +3.7 |
| 에이전트 코딩 | FrontierSWE v2 | 55.0% | 62.3% | Opus +7.3 |
| 에이전트 코딩 | Vibe Code Bench | 91.9% | 90.3% | Argon +1.6 |
| 에이전트 코딩 | Terminal-Bench 4.0 | 57.4% | 66.4% | Opus +9.0 |
| ML 엔지니어링 | PostTrainBench | 45.3% | 49.3% | Opus +4.0 |
| 과학·수학 | Terminal-Bench Science 0.1 | 57.6% | 63.3% | Opus +5.7 |
| 과학·수학 | LABBench 2 | 88.8% | 73.1% | Argon +15.7 |
| 과학·수학 | RiemannBench | 76.0% | 69.6% | Argon +6.4 |
| 긴 컨텍스트 | GraphWalks ≤128K | 99.7% | 90.6% | Argon +9.1 |
| 긴 컨텍스트 | GraphWalks 256K–1M | 84.2% | 66.8% | Argon +17.4 |
| 컴퓨터 조작 | Agent’s Last Exam | 39.5% | 38.2% | Argon +1.3 |
| 멀티모달 | Chartography | 71.6% | 66.3% | Argon +5.3 |
| 멀티모달 | LVBench 장시간 동영상 | 91.7% | 83.7% | Argon +8.0 |
| 사이버 보안 | CWE-bench v1 | 68.0% | 67.0% | Argon +1.0 |
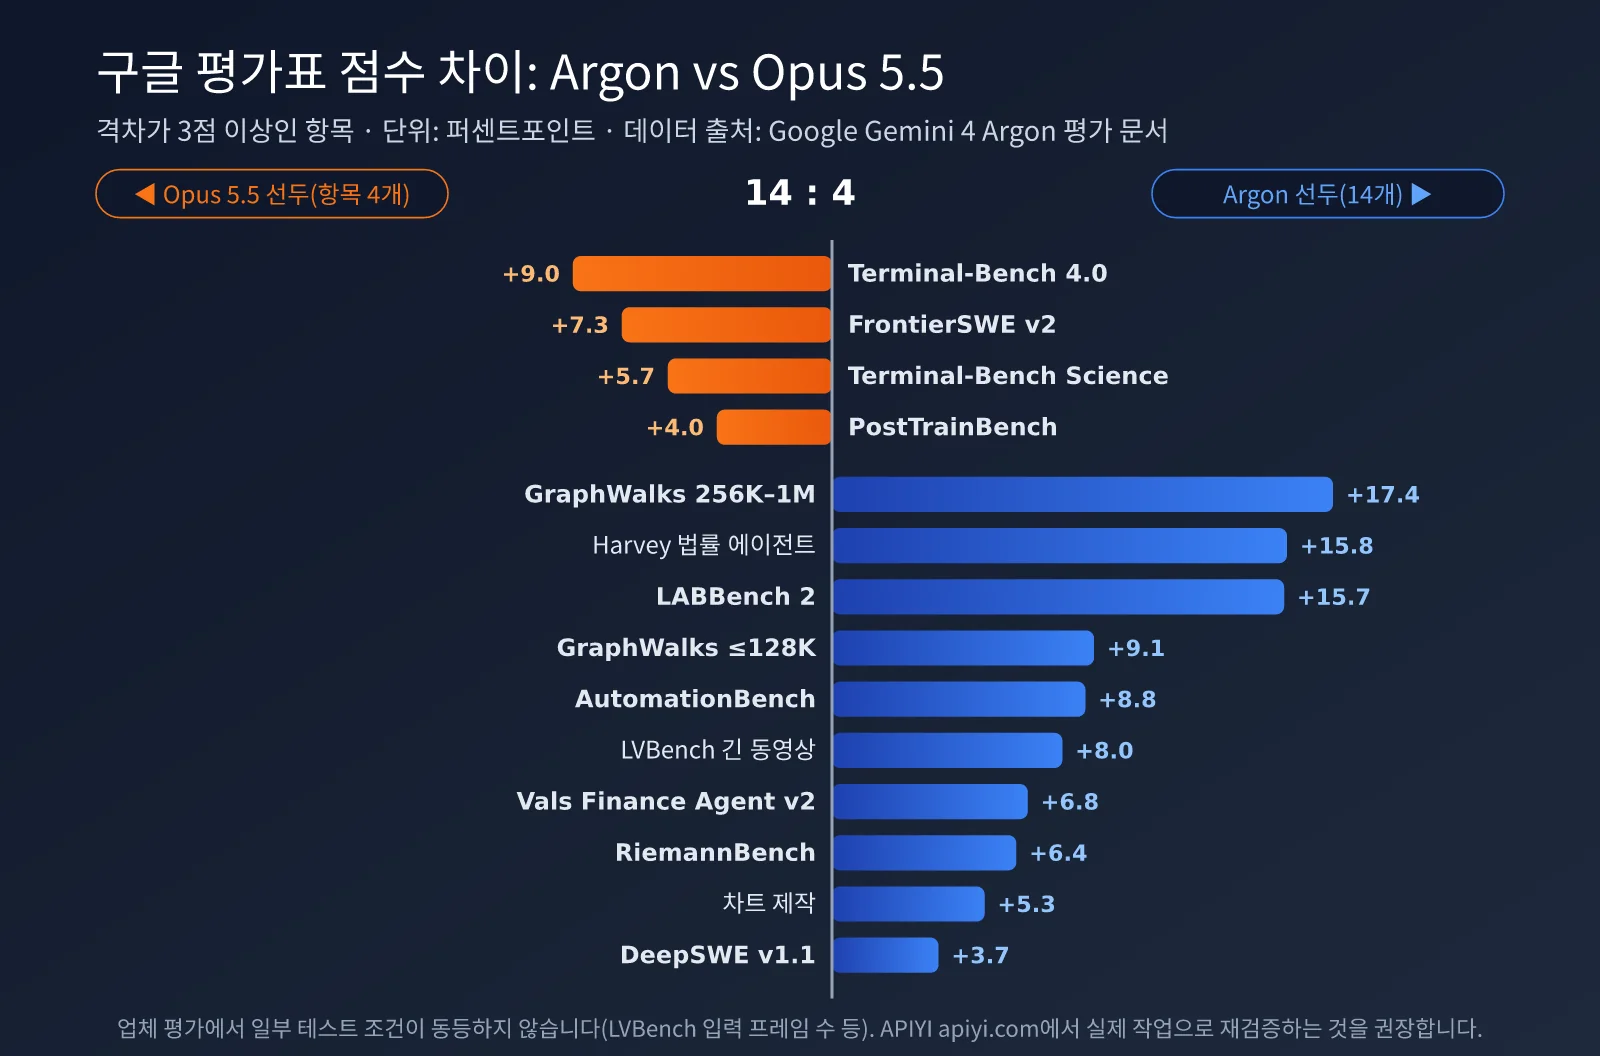
두 모델 모두 점수가 있는 18개 벤치마크에서 Argon은 14개, Opus 5.5는 4개 항목에서 앞섰습니다. Opus 5.5가 앞선 4개 항목은 일정한 경향을 보여요. FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench, Terminal-Bench Science로, 모두 실제 터미널 환경에서 오랜 시간 작업하고 명령을 반복해서 실행해야 하는 과제입니다. Argon이 큰 점수 차로 앞선 항목은 긴 컨텍스트(GraphWalks 256K–1M에서 17.4점 차), 법률 에이전트, 생명과학(LABBench 2)에 집중돼 있습니다.
구글 평가표를 해석할 때 감안해야 할 점
자사 모델에 유리한 결과가 나오기 쉬운 것이 업체 자체 평가표의 특성입니다. 이 표의 각주에도 주의해서 볼 만한 내용이 몇 가지 있어요. 이런 점을 고려해야 Gemini 4 Argon과 Claude Opus 5.5의 점수 차이를 제대로 해석할 수 있습니다.
- LVBench 입력 프레임 수가 다릅니다: Argon은 초당 1프레임씩 전체 동영상을 읽지만, Opus 5.5는 API 제한 때문에 최대 600프레임만 입력할 수 있습니다. 장시간 동영상 점수 차이의 일부는 입력 조건이 같지 않아서 생겼을 수 있습니다.
- Terminal-Bench Science의 시간 제한이 더 넉넉했습니다: Argon의 검증 시간 제한은 기본값의 6배로 설정됐습니다. 그런데도 Argon은 Opus 5.5보다 5.7점 낮았습니다.
- DeepSWE 테스트 프레임워크가 서로 다릅니다: Argon은 mini-swe 에이전트 프레임워크로 자체 평가했고, Claude 점수는 Anthropic 시스템 카드에서 가져왔습니다. 두 모델의 테스트 프레임워크가 일치하지 않습니다.
- Anthropic이 공개한 자체 평가 점수와 차이가 있습니다: Anthropic이 공개한 Opus 5.5 점수는 AutomationBench 40.0%, 도구 사용 조건의 Chartography 89.0%, OSWorld 2.0 81.8%입니다. Google 표에서는 Chartography 점수가 66.3%로만 나와 있고, OSWorld 항목은 비어 있습니다.
즉, 테스트 조건을 맞추면 두 모델의 차이는 표에 드러난 것보다 작을 수 있습니다. 긴 컨텍스트, 법률, 생명과학 분야에서 Argon이 크게 앞선 결과는 신뢰도가 높은 편입니다. 반면 Vals Index, Vibe Code, CWE-bench처럼 차이가 1~2점에 불과한 항목은 사실상 무승부로 볼 수 있습니다.
Gemini 4 Argon vs Claude Opus 5.5 독립 평가 결과
제3자 독립 평가 결과는 Google의 평가표와 일치하지 않으며, 종합 지능 지수에서는 정반대의 결과가 나오기도 해요. 아래 표는 Artificial Analysis(AA)와 Vals에서 공개한 데이터를 정리한 내용입니다.
| 독립 평가 항목 | Gemini 4 Argon | Claude Opus 5.5 | 우세 모델 |
|---|---|---|---|
| AA 지능 지수 v4.3 | 52.6 | 57.6 | Opus +5.0 |
| Vals Index 순위 | 68.90%(1위) | 66.97%(3위) | Argon +1.9 |
| AA Terminal-Bench 4.0 | 57.1% | 59.6% | Opus +2.5 |
| AA Humanity’s Last Exam | 57.1% | 61.4% | Opus +4.3 |
| AA SciCode | 61.8% | 66.9% | Opus +5.1 |
| AA 장문 컨텍스트 추론 | 79.7% | 84.7% | Opus +5.0 |
| AA GDPval(Elo) | 1611 | 1846 | Opus +235 |
| AA AutomationBench | 77.5% | 69.5% | Argon +8.0 |
| AA 출력 속도 | 48.9 token/s | 92.2 token/s | Opus 약 1.9배 빠름 |
AA 평가에서 Opus 5.5는 추론, 과학 프로그래밍, 장문 컨텍스트 추론, GDPval 직업 과제에서 모두 앞섰고, Argon은 AutomationBench의 업무 자동화 분야에서만 뚜렷하게 우세했어요. 다만 AA의 비교가 완전히 공정한 것은 아니에요. Argon은 High 설정으로만 평가된 반면, Opus 5.5는 적응형 추론을 사용하는 Max 설정으로 평가됐어요. 따라서 점수 차이의 일부는 모델의 능력 차이가 아니라 추론 강도 설정에서 비롯됐을 수 있습니다.
Vals Index에서는 Argon이 41개 모델 중 1위, Opus 5.5가 3위를 차지했어요. 하지만 두 모델의 차이는 표준 오차 약 1.5개 수준으로, Argon이 약간 앞서긴 해도 우위가 확실하다고 보기는 어렵습니다. 종합하면 Gemini 4 Argon과 Claude Opus 5.5는 전반적인 성능이 같은 수준이며, 한쪽이 다른 쪽을 압도한다고 볼 수는 없어요.
💡 평가 팁: 평가 기관마다 서로 반대되는 결론을 내놓을 수 있으니, 최종적으로는 직접 확보한 데이터로 판단해야 해요. APIYI(apiyi.com) 플랫폼에서는 통합 인터페이스를 통해 Claude, Gemini, GPT 계열 모델을 전환할 수 있어, 나만의 소규모 평가 세트를 빠르게 구성하기 좋습니다.
Gemini 4 Argon vs Claude Opus 5.5 핵심 차이 살펴보기
점수는 잠시 제쳐두고 두 모델의 설계 방향을 살펴보면, 개별 벤치마크의 점수 차이보다 모델 선택에 더 유용한 단서를 얻을 수 있어요.
긴 작업 흐름에 대한 두 가지 접근 방식
Gemini 4 Argon은 한 번의 출력에서 더 많은 내용을 생성하는 데 초점을 맞췄어요. 출력 한도가 100만 토큰이라 한 번의 요청으로 수십만 줄의 코드나 매우 긴 보고서를 연속해서 생성할 수 있습니다. Google 내부에서는 이를 활용해 Fuchsia Zircon 커널의 C/C++ 코드 80만 줄 이상을 Rust로 마이그레이션하고, libgav1의 SIMD 코드 3만 2천 줄을 교체하는 등의 작업을 수행했어요. 작업을 잘게 나누거나 컨텍스트를 이어 붙일 필요가 줄어들기 때문에, “한 번에 대량의 결과물을 만들어야 하는” 상황에 특히 적합합니다.
Claude Opus 5.5는 추론 과정을 더 세밀하게 제어하는 데 초점을 맞췄어요. 초대형 출력을 지향하기보다는 low부터 max까지 다섯 단계의 effort 설정과 항상 켜져 있는 적응형 사고 기능을 제공합니다. 개발자는 작업의 난이도에 맞춰 추론 깊이와 비용을 조절할 수 있어요. Claude Code 같은 에이전트 프레임워크와 함께 사용하면 여러 차례 도구를 호출하면서 실행하고, 결과를 살펴보고, 수정하는 작업에 더 강합니다. Terminal-Bench처럼 터미널과 상호작용하는 과제에서 Opus 5.5가 뚜렷하게 앞서는 이유도 여기에 있어요.
속도, 지연 시간, 안정성
Artificial Analysis 평가에 따르면 Opus 5.5의 출력 속도는 약 92 token/s로, Argon의 48.9 token/s보다 거의 두 배 빨라요. 실시간 상호작용이 필요한 프로그래밍 도우미나 고객 지원 에이전트에서는 이 차이가 사용자 경험에 바로 드러납니다. Argon은 한 번의 요청으로 더 많은 작업을 처리할 수 있다는 점이 강점이에요. 실시간성이 크게 중요하지 않지만 작업 하나의 규모가 큰 백그라운드 작업에 적합합니다.
또한 Opus 5.5는 여러 클라우드 플랫폼에서 이미 몇 주 동안 안정적으로 운영되고 있어, 할당량과 요청 제한, 오류 처리에 관한 문서도 잘 갖춰져 있습니다. 반면 Argon은 아직 출시 범위를 넓혀 가는 초기 단계라 할당량과 요청 제한 정책이 명확하지 않아요. SLA 요구 수준이 높은 프로덕션 시스템에서는 이 요소도 벤치마크 점수 못지않게 중요하게 봐야 합니다.
안전성과 프롬프트 인젝션 방어
두 회사 모두 에이전트 안전성을 주요 과제로 보고 있어요. Google은 Argon이 자사 모델 가운데 간접 프롬프트 인젝션에 가장 강한 내성을 갖췄으며 Gray Swan IPI 벤치마크에서도 앞선다고 밝혔지만, 구체적인 점수는 공개하지 않았습니다. 한편 제3자 보안 업체의 분석에 따르면 Opus 5.5는 같은 벤치마크에서 Claude Fable 5.1과 함께 인젝션 성공률이 가장 낮았습니다. 즉, 두 모델 모두 프롬프트 인젝션 방어에서 최상위권에 속하며 각자 우위를 주장할 수 있어요. 외부 웹페이지, 이메일, 문서를 읽어야 하는 에이전트라면 어느 모델을 선택하든 모델 외부에서 도구 권한을 분리하고 사람의 확인 절차를 마련해야 합니다.
Gemini 4 Argon vs Claude Opus 5.5 비용 비교
두 모델의 공식 가격은 같지만, 같은 작업에서도 사용하는 토큰 수가 달라 실제 비용에는 큰 차이가 날 수 있어요. 아래 표는 제3자 기관이 실제 측정한 작업당 비용입니다.
| 비용 기준 | Gemini 4 Argon | Claude Opus 5.5 | 차이 |
|---|---|---|---|
| AA 작업당 평균 비용 | $1.99(체험 가격) | $5.98 | Argon은 약 1/3 |
| AA 전체 지수 실행 비용 | $2,407 | $8,708 | Argon은 약 28% |
| Vals 테스트 1회 비용 | $15.68 | $32.14 | Argon은 약 49% |
| 정식 가격 기준 AA 작업당 비용 | 약 $3.98 | $5.98 | Argon이 여전히 약 1/3 저렴 |
| Batch 대량 작업 | 미공개 | 반값 $2/$10 | Opus는 확정된 대량 작업 할인 제공 |
정식 가격인 $4/$20을 기준으로 계산해도 Argon은 AA 테스트에서 작업당 비용이 Opus 5.5보다 약 3분의 1 저렴해요. 그 이유 중 하나는 Opus 5.5가 Max 설정에서 추론을 더 오래 수행하기 때문입니다. Opus 5.5의 effort를 medium이나 high로 조정하면 비용이 크게 낮아질 수 있어요. 이것이 바로 Opus 5.5의 5단계 effort 제어가 실질적으로 유용한 이유입니다. 또한 오프라인 배치 작업에서는 Opus 5.5의 Batch 반값 할인이 확정적으로 제공돼, 아직 대량 작업 가격이 공개되지 않은 Argon보다 비용을 예측하기 쉬워요.
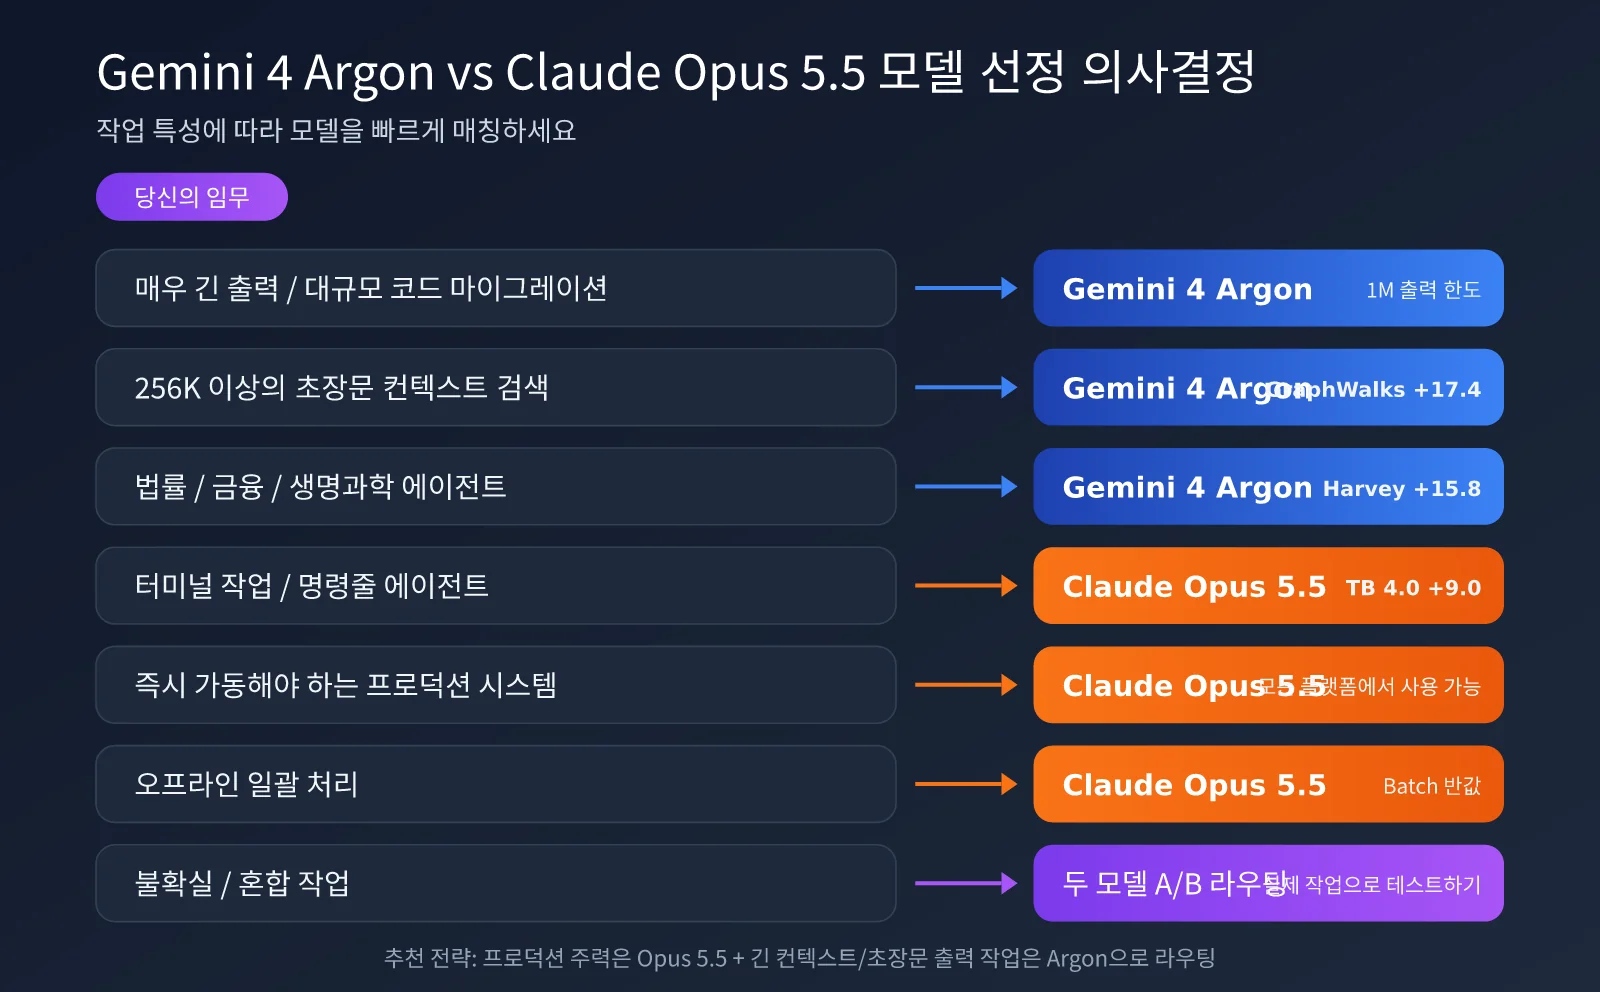
Gemini 4 Argon vs Claude Opus 5.5: 상황별 추천과 선택 가이드
Google 평가 결과와 독립 평가, 비용, 사용 가능 여부를 종합하면 작업 유형별로 비교적 명확하게 모델을 추천할 수 있어요.
| 사용 사례 | 추천 모델 | 주요 이유 |
|---|---|---|
| 대규모 코드 마이그레이션 / 초장문 코드 생성 | Gemini 4 Argon | 출력 한도 1M, DeepSWE에서 3.7점 앞섬 |
| 256K 이상 초장문 컨텍스트 검색 | Gemini 4 Argon | GraphWalks 256K–1M 구간에서 17.4점 앞섬 |
| 법률·금융 전문 에이전트 | Gemini 4 Argon | Harvey에서 15.8점, Finance Agent에서 6.8점 앞섬 |
| 장시간 동영상 및 차트 이해 | Gemini 4 Argon | LVBench와 Chartography 모두 우세 |
| 터미널 조작 및 명령줄 에이전트 | Claude Opus 5.5 | Terminal-Bench 4.0에서 9점 앞섬 |
| 과학 연구용 프로그래밍 및 복잡한 추론 | Claude Opus 5.5 | AA의 SciCode, HLE, CritPt에서 모두 우세 |
| 즉시 출시해야 하는 프로덕션 시스템 | Claude Opus 5.5 | 모든 플랫폼에서 사용 가능하며 모델 ID와 할당량이 명확함 |
| 오프라인 대량 처리 | Claude Opus 5.5 | Batch 반값 $2/$10이 확정됨 |
Gemini 4 Argon과 Claude Opus 5.5를 함께 사용하는 모델 라우팅
대부분의 팀에 가장 현실적인 전략은 둘 중 하나만 선택하는 것이 아니라, 두 모델을 함께 라우팅하는 거예요. 우선 프로덕션의 주력 모델로 Opus 5.5를 사용하고, Argon이 강점을 보이는 장문 컨텍스트나 초장문 출력 작업은 점차 Argon으로 라우팅하면 됩니다. 다음은 OpenAI 호환 인터페이스를 사용하는 간단한 예제입니다.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

OPUS = "claude-opus-5-5"
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")  # 以平台实际上线 ID 为准

def pick_model(prompt_tokens: int, need_long_output: bool) -> str:
    # 超长上下文或超长输出走 Argon,其余默认 Opus 5.5
    return ARGON if prompt_tokens > 256_000 or need_long_output else OPUS

model = pick_model(prompt_tokens=12_000, need_long_output=False)
resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "排查这个 CI 流水线失败的原因"}],
)
print(model, resp.choices[0].message.content)
전체 코드 보기: 같은 작업으로 두 모델 A/B 비교
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODELS = {
    "claude-opus-5-5": (4.0, 20.0),
    os.getenv("ARGON_MODEL", "gemini-4-argon"): (
        float(os.getenv("ARGON_PRICE_IN", "2")),
        float(os.getenv("ARGON_PRICE_OUT", "10")),
    ),
}

TASKS = [
    "阅读以下合同条款,列出对乙方不利的 5 处风险并给出修改建议:...",
    "把这段 Python 2 代码迁移到 Python 3.12 并补充类型注解:...",
    "根据以下日志定位服务超时的根因:...",
]


def run(model: str, task: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        max_tokens=16000,
        messages=[{"role": "user", "content": task}],
    )
    u = resp.usage
    price_in, price_out = MODELS[model]
    cost = (u.prompt_tokens * price_in + u.completion_tokens * price_out) / 1_000_000
    return {
        "model": model,
        "latency": round(time.time() - start, 1),
        "out_tokens": u.completion_tokens,
        "cost": round(cost, 4),
        "answer": resp.choices[0].message.content,
    }


if __name__ == "__main__":
    for task in TASKS:
        print("=" * 60, "\n任务:", task[:30])
        for model in MODELS:
            r = run(model, task)
            print(f"[{r['model']}] {r['latency']}s, 输出 {r['out_tokens']} token, ${r['cost']}")
이 A/B 스크립트는 같은 작업에서 각 모델의 지연 시간, 출력 토큰 수, 비용을 기록해요. 실제 업무를 대표하는 작업 30~50개를 준비한 뒤, 사람이 직접 채점하거나 평가 모델을 사용해 점수를 매겨 두 모델의 라우팅 비율을 정하는 것을 권장합니다.
🚀 빠른 시작: 먼저 APIYI apiyi.com에 가입해 테스트 크레딧을 받고 Claude Opus 5.5로 위 A/B 스크립트를 실행해 보세요. Argon이 플랫폼에서 정식으로 제공되면 환경 변수의 모델 이름만 바꿔 바로 비교 테스트를 진행할 수 있습니다.
자주 묻는 질문
Q1: Gemini 4 Argon과 Claude Opus 5.5 중 어느 모델이 더 뛰어난가요?
정답은 없어요. Google 평가표에서는 Argon이 14개 항목에서 앞섰고, Opus 5.5는 4개 항목에서 앞섰어요. 하지만 Artificial Analysis의 종합 지능 지수에서는 Opus 5.5가 57.6점으로 Argon의 52.6점보다 높았어요. 두 모델은 같은 수준이라고 볼 수 있어요. Argon은 긴 컨텍스트, 매우 긴 출력, 전문 분야 에이전트에 강하고, Opus 5.5는 터미널 작업, 복잡한 추론, 엔지니어링 성숙도에서 강점을 보여요.
Q2: Google 평가표의 데이터는 신뢰할 수 있나요?
참고 자료로 활용할 수 있지만, 그대로 받아들이기보다는 감안해서 볼 필요가 있어요. Google이 공개한 자체 평가표이며, 일부 벤치마크는 테스트 조건이 동등하지 않아요. 예를 들어 LVBench의 입력 프레임 수와 Terminal-Bench Science의 시간 제한 설정이 달라요. Anthropic이 자체 공개한 데이터와 비교했을 때 Opus 5.5의 일부 점수도 낮게 나온 편이에요. 5점 이상 차이가 나는 항목을 중심으로 참고하고, 1~2점 차이는 사실상 동점으로 보는 것을 권해요.
Q3: 지금 두 모델을 모두 호출할 수 있나요?
Claude Opus 5.5는 Claude API, Bedrock, Vertex AI, Foundry에서 모두 사용할 수 있어요. Gemini 4 Argon은 아직 단계적으로 제공 범위를 확대하고 있어요. Vertex AI에서는 사용할 수 있지만, 유료 API는 아직 전면 공개되지 않았어요. 우선 APIYI apiyi.com을 통해 Opus 5.5와 Gemini 계열 모델을 연동한 뒤, Argon이 정식 출시되면 model 매개변수만 바꿔 두 모델을 비교해 보세요.
Q4: 두 모델의 가격이 같다면 실제로는 어느 쪽이 더 저렴한가요?
제3자 실측 결과에 따르면 Argon의 작업당 비용은 Opus 5.5의 약 3분의 1에서 2분의 1 수준이에요. 초기 도입 시기에는 비용 측면에서 더 유리할 수 있어요. 하지만 Opus 5.5도 effort 단계를 낮추고 Batch를 사용하면 비용을 크게 줄일 수 있어요. 가장 정확한 방법은 실제 작업에서 usage를 기록한 뒤 계산하는 거예요. APIYI apiyi.com 플랫폼에서는 통합 청구서를 통해 두 모델의 실제 비용을 쉽게 비교할 수 있어요.
요약
Gemini 4 Argon과 Claude Opus 5.5는 팽팽하게 맞서는 모델이에요. Google 평가표에서는 Argon이 긴 컨텍스트, 법률·금융 에이전트, 생명과학, 멀티모달 분야에서 두드러진 강점을 보였어요. 특히 최대 1M 토큰 출력은 독보적인 기능이에요. 반면 독립 평가에서는 Opus 5.5가 추론, 과학·연구용 코딩, 터미널 작업에서 더 뛰어났어요. 모든 주요 플랫폼에서 사용할 수 있고 엔지니어링 측면에서도 더 성숙한 상태예요.
현재 권장하는 전략은 프로덕션 환경에서는 Claude Opus 5.5를 주력으로 사용하고, Gemini 4 Argon은 긴 컨텍스트와 매우 긴 출력이 필요한 작업에 전용 모델로 단계적으로 도입하는 것이에요. 실제 작업 데이터로 A/B 비교도 꾸준히 진행하세요. Argon 유료 API가 전면 공개되고 독립 평가 결과가 더 나오면, 데이터를 바탕으로 모델 라우팅 비율을 조정하면 돼요.
Claude와 Gemini 계열 모델을 APIYI apiyi.com 플랫폼에 통합해 사용하면 하나의 인터페이스와 청구서로 여러 모델을 비교하고 라우팅할 수 있어요. 실제 데이터에 기반해 모델을 선택해 보세요.
참고 자료:
- Google 공식 블로그의 Gemini 4 Argon 출시 안내: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Anthropic Claude Opus 5.5 출시 정보: anthropic.com/news
- Artificial Analysis 지능 지수 및 모델 비교: artificialanalysis.ai
- Vals AI 모델 평가 순위: vals.ai
- Gemini 4 Argon 전체 평가표 정리(ToolScout): toolscout.ai/news/gemini-4-argon-benchmarks
작성자: APIYI Team | 최신 대규모 언어 모델 평가와 선택 정보를 꾸준히 다룹니다. 더 많은 모델 연동 소식은 APIYI apiyi.com에서 확인하세요.