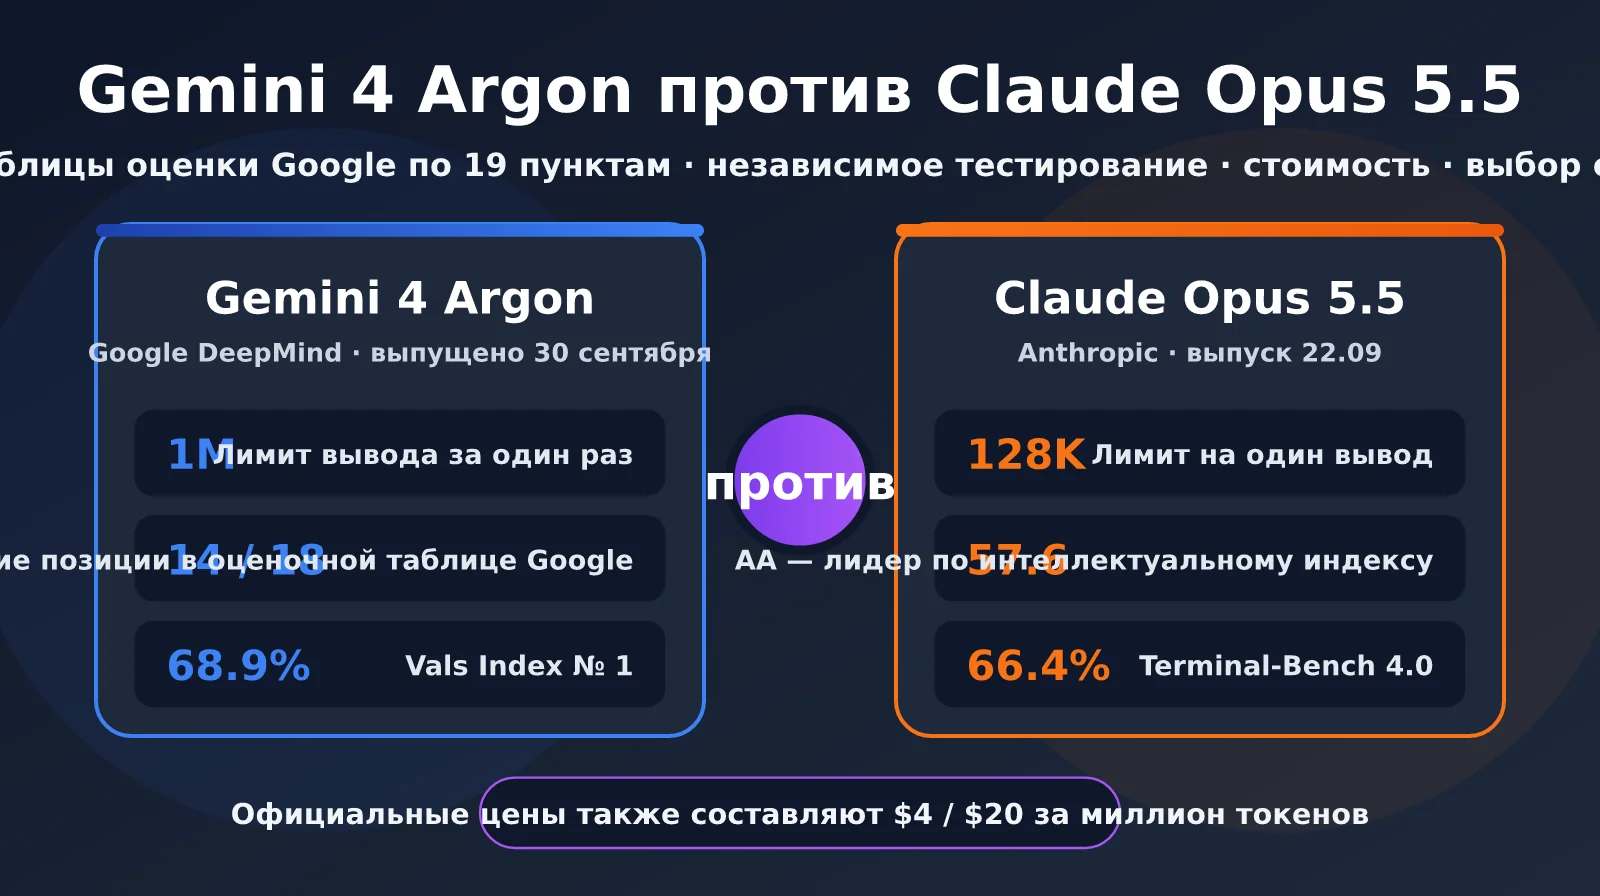
С конца сентября до начала октября ведущие большие языковые модели обновлялись одна за другой: 22 сентября Anthropic выпустила Claude Opus 5.5, а всего через 8 дней Google представила Gemini 4 Argon. Модели во многом ориентированы на одни и те же задачи: сложные многоэтапные рассуждения, программирование с помощью ИИ-агентов и работу с корпоративными знаниями. Официальные цены тоже совпадают: $4 за миллион входных токенов и $20 за миллион выходных. Поэтому вопрос «Gemini 4 Argon или Claude Opus 5.5?» — один из самых частых при выборе модели.
Пока общедоступной информации немного. Самый полный первичный источник — таблица Google с результатами сравнения по 19 бенчмаркам, опубликованная в документации Argon. В ней есть и Claude Opus 5.5. В этой статье мы разберём таблицу по пунктам, а также добавим данные независимых сторонних оценок Artificial Analysis и Vals. Ещё учтём цену, лимит вывода, доступность и другие инженерные факторы — всё это поможет понять, для каких задач подходит каждая модель.
Главное: после прочтения вы будете понимать, каким цифрам в таблице Google можно доверять, а какие стоит воспринимать с оговорками. И сможете выбрать Gemini 4 Argon или Claude Opus 5.5 с учётом своих задач.
Gemini 4 Argon и Claude Opus 5.5: сравнение основных параметров
Прежде чем переходить к результатам тестов, сравним основные параметры моделей. Официальные цены у них одинаковые, а ключевые различия — в лимите вывода, доступности и цене для раннего доступа.
| Параметр | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Дата выпуска | 30 сентября 2026 года | 22 сентября 2026 года |
| Доступность | Доступ постепенно открывают в рамках программы Fairwind и через Vertex AI; платный API пока доступен не всем | Уже доступна повсеместно: Claude API, Bedrock, Vertex AI, Foundry |
| ID модели | Официально пока не опубликован | claude-opus-5-5 |
| Цена (ввод/вывод) | Для раннего доступа — $2/$10, официальная — $4/$20 | $4/$20 |
| Чтение из кэша | Скидка 95% от цены входных токенов (от $0,10) | $0,20 |
| Пакетная обработка (Batch) | Цена не опубликована | $2/$10 |
| Контекстное окно | Официально не опубликовано; по данным сторонних источников — 1 млн токенов | 1 млн токенов, без доплаты за длинный контекст |
| Лимит вывода за один запрос | 1 млн токенов | 128 тыс. токенов |
| Настройка рассуждений | Несколько уровней, включая High | Пять уровней effort — от low до max, адаптивное мышление |
Главное преимущество Argon по характеристикам — лимит вывода в 1 млн токенов: это примерно в 8 раз больше, чем у Opus 5.5. Такая модель подойдёт для генерации очень длинного кода и масштабной миграции. Главное преимущество Opus 5.5 — её уже можно стабильно использовать: ID модели известен, она доступна на всех основных облачных платформах, а также поддерживает пакетную обработку за полцены и пять уровней effort. С точки зрения готовности к работе в продакшене она заметно опережает конкурента.
🎯 Совет по выбору: официальные цены у моделей одинаковые, поэтому выбирать стоит по типу задачи. Рекомендуем через платформу APIYI (apiyi.com) вызывать Claude Opus 5.5 и модели Gemini через один и тот же интерфейс и сравнить их на своих реальных задачах. Это надёжнее, чем ориентироваться только на рейтинги.
Gemini 4 Argon vs Claude Opus 5.5: подробный разбор таблицы Google
Ниже приведены сравнительные данные из опубликованного Google документа с результатами тестирования Argon. В таблице оставлены только столбцы Argon и Opus 5.5, а результаты сгруппированы по категориям. Важно учитывать, что это таблица самого Google: результаты Argon получены в ходе внутренних тестов Google, а результаты Opus 5.5 в основном взяты из открытых рейтингов и системных карточек Anthropic. Некоторые тесты Google запускал повторно для обеих моделей.
| Категория | Тест | Gemini 4 Argon | Claude Opus 5.5 | Лидер |
|---|---|---|---|---|
| Работа со знаниями | Vals Index | 68.9% | 67.0% | Argon +1.9 |
| Работа со знаниями | AutomationBench | 51.3% | 42.5% | Argon +8.8 |
| Работа со знаниями | Vals Finance Agent v2 | 65.4% | 58.6% | Argon +6.8 |
| Работа со знаниями | Юридический агент Harvey | 19.6% | 3.8% | Argon +15.8 |
| Агентное программирование | DeepSWE v1.1 | 77.9% | 74.2% | Argon +3.7 |
| Агентное программирование | FrontierSWE v2 | 55.0% | 62.3% | Opus +7.3 |
| Агентное программирование | Vibe Code Bench | 91.9% | 90.3% | Argon +1.6 |
| Агентное программирование | Terminal-Bench 4.0 | 57.4% | 66.4% | Opus +9.0 |
| ML-инжиниринг | PostTrainBench | 45.3% | 49.3% | Opus +4.0 |
| Наука и математика | Terminal-Bench Science 0.1 | 57.6% | 63.3% | Opus +5.7 |
| Наука и математика | LABBench 2 | 88.8% | 73.1% | Argon +15.7 |
| Наука и математика | RiemannBench | 76.0% | 69.6% | Argon +6.4 |
| Длинный контекст | GraphWalks ≤128K | 99.7% | 90.6% | Argon +9.1 |
| Длинный контекст | GraphWalks 256K–1M | 84.2% | 66.8% | Argon +17.4 |
| Работа с компьютером | Agent’s Last Exam | 39.5% | 38.2% | Argon +1.3 |
| Мультимодальность | Chartography | 71.6% | 66.3% | Argon +5.3 |
| Мультимодальность | LVBench: длинные видео | 91.7% | 83.7% | Argon +8.0 |
| Кибербезопасность | CWE-bench v1 | 68.0% | 67.0% | Argon +1.0 |
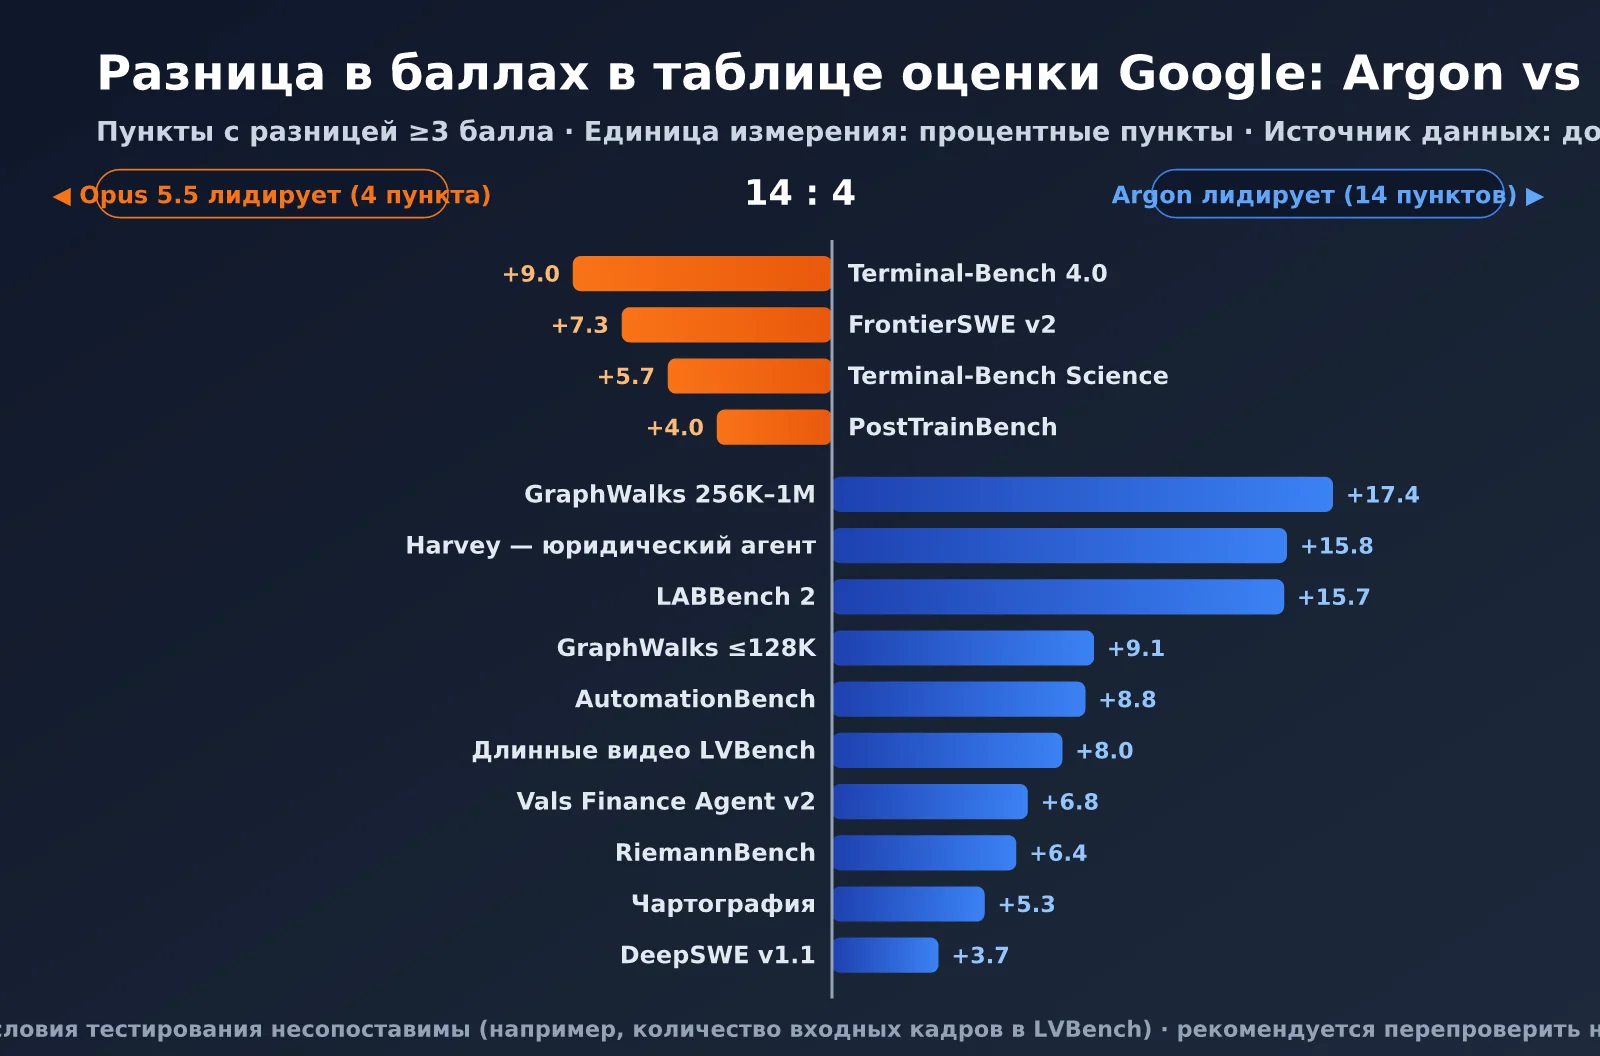
Из 18 тестов, для которых есть результаты обеих моделей, Argon лидирует в 14, а Opus 5.5 — в 4. Победы Opus 5.5 распределились довольно закономерно: FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench и Terminal-Bench Science — это задачи, где нужно долго работать в реальной среде терминала и многократно выполнять команды. У Argon самые крупные отрывы — в работе с длинным контекстом (преимущество в 17.4 балла на GraphWalks 256K–1M), а также в юридических задачах и науках о жизни (LABBench 2).
К каким результатам в таблице Google стоит относиться с оговорками
Таблицы с результатами тестирования от самих разработчиков неизбежно выгодны их моделям. В сносках к этой таблице тоже есть несколько важных деталей. Чтобы правильно оценить разницу между Gemini 4 Argon и Claude Opus 5.5, стоит учитывать следующее:
- В LVBench использовалось разное количество входных кадров: Argon обрабатывал полное видео с частотой 1 кадр в секунду, а Opus 5.5 из-за ограничений API мог получить на вход не более 600 кадров. Часть разрыва в результатах на длинных видео объясняется разными условиями тестирования.
- Для Terminal-Bench Science увеличили время ожидания: для Argon тайм-аут проверки установили в шесть раз выше значения по умолчанию. И даже с таким послаблением Argon уступил Opus 5.5 5.7 балла.
- Для DeepSWE использовались разные тестовые фреймворки: Argon проверяли самостоятельно с помощью фреймворка mini-swe agent, а результат Claude взяли из системной карточки Anthropic. Условия тестирования не совпадают.
- Данные отличаются от опубликованных Anthropic: в собственных результатах Anthropic у Opus 5.5 показатель AutomationBench составляет 40.0%, Chartography с инструментами — 89.0%, а OSWorld 2.0 — 81.8%. В таблице Google для Chartography указано лишь 66.3%, а поле OSWorld оставлено пустым.
Иными словами, при одинаковых условиях разница между моделями меньше, чем можно предположить по таблице. Преимущество Argon в работе с длинным контекстом, юридических задачах и науках о жизни достаточно велико, чтобы считать его убедительным. А результаты вроде Vals Index, Vibe Code и CWE-bench, где разница составляет всего 1–2 балла, можно считать практически равными.
Результаты независимой оценки Gemini 4 Argon и Claude Opus 5.5
Выводы независимых оценок сторонних организаций не совпадают с таблицей Google, а по интегральному индексу интеллекта результаты даже расходятся в противоположных направлениях. Ниже собраны опубликованные данные Artificial Analysis (AA) и Vals.
| Независимый тест | Gemini 4 Argon | Claude Opus 5.5 | Лидер |
|---|---|---|---|
| Индекс интеллекта AA v4.3 | 52.6 | 57.6 | Opus +5.0 |
| Место в рейтинге Vals Index | 68.90% (1-е место) | 66.97% (3-е место) | Argon +1.9 |
| AA Terminal-Bench 4.0 | 57.1% | 59.6% | Opus +2.5 |
| AA Humanity’s Last Exam | 57.1% | 61.4% | Opus +4.3 |
| AA SciCode | 61.8% | 66.9% | Opus +5.1 |
| Рассуждения с длинным контекстом AA | 79.7% | 84.7% | Opus +5.0 |
| AA GDPval (Elo) | 1611 | 1846 | Opus +235 |
| AA AutomationBench | 77.5% | 69.5% | Argon +8.0 |
| Скорость генерации AA | 48.9 токена/с | 92.2 токена/с | Opus примерно в 1,9 раза быстрее |
В тестах AA Opus 5.5 уверенно лидирует в рассуждениях, научном программировании, работе с длинным контекстом и профессиональных задачах GDPval. Argon заметно опережает его только в автоматизации бизнес-процессов на AutomationBench. Однако сравнение AA не совсем справедливо: Argon тестировали только в режиме High, а Opus 5.5 — в режиме Max с адаптивным рассуждением. Часть разницы может объясняться настройками интенсивности рассуждений, а не только уровнем способностей моделей.
В Vals Index Argon занимает первое место среди 41 модели, а Opus 5.5 — третье. Но разница между ними составляет примерно 1,5 стандартной ошибки: Argon немного впереди, однако его преимущество нельзя считать однозначным. В целом Gemini 4 Argon и Claude Opus 5.5 относятся к одному уровню по совокупным возможностям — ни одна модель не разгромила другую.
💡 Совет по оценке: выводы разных оценочных организаций могут расходиться, поэтому в конечном счёте стоит опираться на собственные данные. Платформа APIYI apiyi.com позволяет переключаться между моделями Claude, Gemini, GPT и других семейств через единый интерфейс — это удобно для быстрой сборки собственного небольшого набора тестов.
Ключевые различия Gemini 4 Argon и Claude Opus 5.5
Если отвлечься от оценок, различия в подходе к разработке этих моделей помогут с выбором лучше, чем разница в отдельных тестах.
Два подхода к задачам с длинной цепочкой действий
Подход Gemini 4 Argon — увеличить объём одного ответа. Лимит вывода в 1 млн токенов позволяет за один запрос сгенерировать сотни тысяч строк кода или очень длинный отчёт. В Google с помощью модели перенесли более 800 тысяч строк кода ядра Fuchsia Zircon с C/C++ на Rust, а также заменили 32 тысячи строк SIMD-кода в libgav1 и выполнили другие задачи. Такой подход сокращает необходимость разбивать работу на части и склеивать контекст, поэтому особенно хорошо подходит для сценариев, где нужно «за один раз создать большой объём материала».
Claude Opus 5.5 делает ставку на более управляемый процесс рассуждений. Модель не стремится к огромному объёму вывода, зато предлагает пять уровней effort — от low до max — и всегда включённое адаптивное мышление. Это позволяет разработчикам подстраивать глубину рассуждений и затраты под сложность задачи. В сочетании с агентными фреймворками вроде Claude Code Opus 5.5 лучше справляется с многократными вызовами инструментов: выполняет действия, анализирует результат и вносит исправления. Это также объясняет его заметное преимущество в задачах интерактивной работы с терминалом, таких как Terminal-Bench.
Скорость, задержка и стабильность
По данным тестов Artificial Analysis, Opus 5.5 генерирует около 92 токенов в секунду — почти вдвое быстрее Argon с его 48,9 токена в секунду. Для помощников по программированию с интерактивным режимом и клиентских агентов такая разница напрямую влияет на удобство использования. Преимущество Argon в том, что за один запрос он может выполнить больший объём работы. Поэтому он подходит для фоновых задач, где не так важна скорость ответа, но сам объём работы очень велик.
Кроме того, Opus 5.5 уже несколько недель стабильно работает на нескольких облачных платформах. Для него хорошо документированы квоты, ограничения скорости запросов и обработка ошибок. Argon пока находится на раннем этапе расширения доступа, а правила квотирования и ограничения запросов ещё не до конца понятны. Для производственных систем с высокими требованиями к SLA этот фактор не менее важен, чем результаты тестов.
Безопасность и защита от инъекций в промпт
Обе компании уделяют особое внимание безопасности агентов. Google утверждает, что Argon — самая устойчивая к косвенным инъекциям в промпт модель из всех созданных компанией. В тесте Gray Swan IPI она показала лучший результат, но конкретные баллы не опубликованы. Анализ стороннего поставщика решений по безопасности, в свою очередь, показывает, что Opus 5.5 делит с Claude Fable 5.1 последнее место по доле успешных инъекций в том же тесте. Иными словами, обе модели входят в лидирующую группу по защите от инъекций в промпт, и каждая может заявить о преимуществе. Если агенту нужно читать внешние сайты, письма и документы, при выборе любой из моделей всё равно необходимо отдельно настраивать права доступа к инструментам и предусматривать подтверждение действий человеком.
Сравнение стоимости Gemini 4 Argon и Claude Opus 5.5
Официальные цены у моделей одинаковые, но на одни и те же задачи они тратят разное количество токенов, поэтому реальная стоимость заметно отличается. В таблице приведены расходы на одну задачу по результатам независимых тестов.
| Показатель стоимости | Gemini 4 Argon | Claude Opus 5.5 | Разница |
|---|---|---|---|
| Средняя стоимость одной задачи AA | $1.99 (цена для раннего доступа) | $5.98 | Argon обходится примерно в 3 раза дешевле |
| Общая стоимость полного прогона индекса AA | $2,407 | $8,708 | Argon — примерно 28% от стоимости Opus |
| Стоимость одного теста Vals | $15.68 | $32.14 | Argon — примерно 49% от стоимости Opus |
| Стоимость одной задачи AA по официальному тарифу | около $3.98 | $5.98 | Argon всё ещё примерно на треть дешевле |
| Пакетная обработка Batch | цена не объявлена | вдвое дешевле: $2/$10 | Для Opus есть гарантированная скидка на пакетную обработку |
Даже если пересчитать стоимость Argon по официальному тарифу $4/$20, одна задача в тесте AA всё равно обходится примерно на треть дешевле, чем у Opus 5.5. Отчасти это объясняется тем, что в режиме Max Opus 5.5 дольше рассуждает. Если установить для Opus 5.5 уровень effort на medium или high, стоимость заметно снизится — в этом и состоит практическая ценность пяти уровней настройки effort. Кроме того, для офлайн-задач пакетной обработки у Opus 5.5 уже действует гарантированная скидка 50% по тарифу Batch. Пока Argon не объявила цены на пакетную обработку, это более предсказуемый вариант.
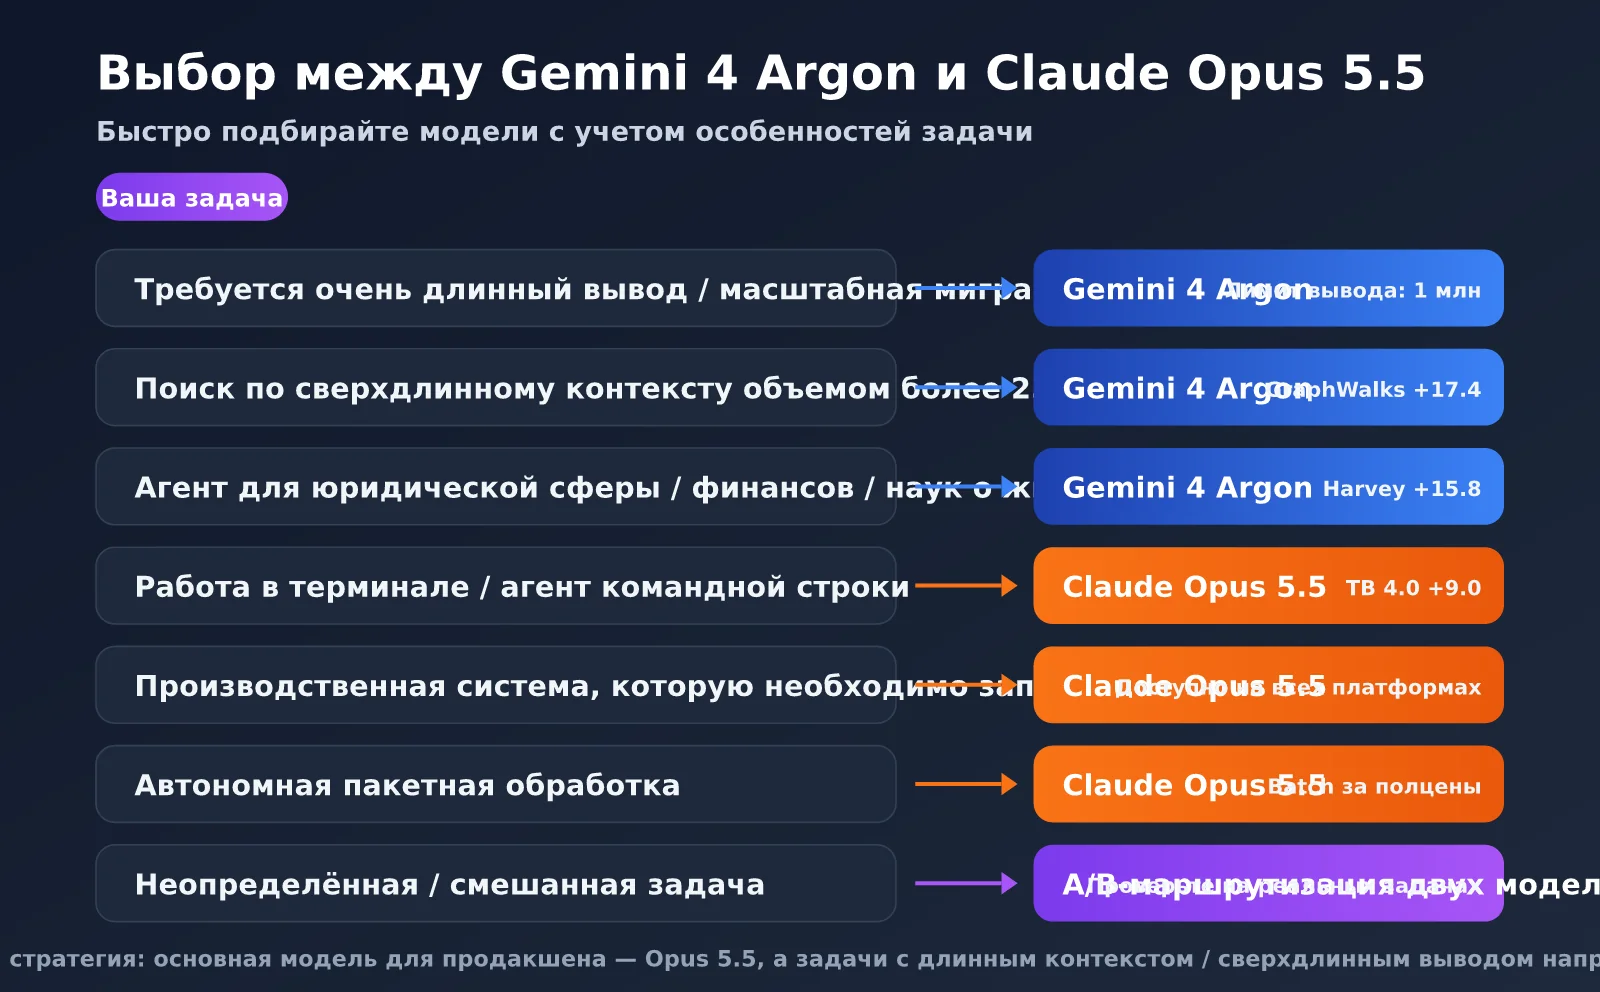
Gemini 4 Argon и Claude Opus 5.5: рекомендации по сценариям и советы по выбору
Если учитывать таблицу бенчмарков Google, независимые оценки, стоимость и доступность моделей, рекомендации для разных сценариев выглядят достаточно однозначно:
| Сценарий использования | Рекомендуемая модель | Основная причина |
|---|---|---|
| Масштабная миграция кода / генерация очень длинных фрагментов кода | Gemini 4 Argon | Лимит вывода — 1 млн токенов, преимущество в 3,7 балла на DeepSWE |
| Поиск в сверхдлинном контексте свыше 256K токенов | Gemini 4 Argon | Преимущество в 17,4 балла на GraphWalks при контексте 256K–1M |
| Профессиональные агенты для юридической и финансовой сферы | Gemini 4 Argon | Преимущество в 15,8 балла на Harvey и в 6,8 балла на Finance Agent |
| Понимание длинных видео и диаграмм | Gemini 4 Argon | Преимущество на LVBench и Chartography |
| Работа в терминале и агенты командной строки | Claude Opus 5.5 | Преимущество в 9 баллов на Terminal-Bench 4.0 |
| Научное программирование и сложные рассуждения | Claude Opus 5.5 | Преимущество на SciCode, HLE и CritPt от Artificial Analysis |
| Продакшен-системы, которые нужно запустить прямо сейчас | Claude Opus 5.5 | Доступна на всех платформах, ID модели и квоты известны |
| Пакетная обработка офлайн | Claude Opus 5.5 | Стоимость Batch уже определена: вдвое ниже, $2/$10 |
Практика маршрутизации запросов между Gemini 4 Argon и Claude Opus 5.5
Для большинства команд самый практичный подход — не выбирать одну модель, а распределять запросы между обеими: сначала использовать Opus 5.5 как основную модель в продакшене, а затем постепенно направлять в Argon задачи, где важны длинный контекст и сверхдлинный вывод. Ниже — минимальный пример с интерфейсом, совместимым с OpenAI.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

OPUS = "claude-opus-5-5"
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")  # 以平台实际上线 ID 为准

def pick_model(prompt_tokens: int, need_long_output: bool) -> str:
    # 超长上下文或超长输出走 Argon,其余默认 Opus 5.5
    return ARGON if prompt_tokens > 256_000 or need_long_output else OPUS

model = pick_model(prompt_tokens=12_000, need_long_output=False)
resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "排查这个 CI 流水线失败的原因"}],
)
print(model, resp.choices[0].message.content)
Полный код: A/B-сравнение двух моделей на одной задаче
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODELS = {
    "claude-opus-5-5": (4.0, 20.0),
    os.getenv("ARGON_MODEL", "gemini-4-argon"): (
        float(os.getenv("ARGON_PRICE_IN", "2")),
        float(os.getenv("ARGON_PRICE_OUT", "10")),
    ),
}

TASKS = [
    "阅读以下合同条款,列出对乙方不利的 5 处风险并给出修改建议:...",
    "把这段 Python 2 代码迁移到 Python 3.12 并补充类型注解:...",
    "根据以下日志定位服务超时的根因:...",
]


def run(model: str, task: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        max_tokens=16000,
        messages=[{"role": "user", "content": task}],
    )
    u = resp.usage
    price_in, price_out = MODELS[model]
    cost = (u.prompt_tokens * price_in + u.completion_tokens * price_out) / 1_000_000
    return {
        "model": model,
        "latency": round(time.time() - start, 1),
        "out_tokens": u.completion_tokens,
        "cost": round(cost, 4),
        "answer": resp.choices[0].message.content,
    }


if __name__ == "__main__":
    for task in TASKS:
        print("=" * 60, "\n任务:", task[:30])
        for model in MODELS:
            r = run(model, task)
            print(f"[{r['model']}] {r['latency']}s, 输出 {r['out_tokens']} token, ${r['cost']}")
Этот A/B-скрипт записывает задержку, количество выходных токенов и стоимость для каждой модели на одной и той же задаче. Подготовьте 30–50 реальных задач, характерных для вашего бизнеса, оцените ответы вручную или с помощью модели-оценщика — и только после этого решайте, в какой пропорции направлять запросы в каждую модель.
🚀 Быстрый старт: зарегистрируйтесь на APIYI apiyi.com и получите тестовый баланс, чтобы запустить приведённый выше A/B-скрипт с Claude Opus 5.5. Когда Argon официально появится на платформе, достаточно будет изменить имя модели в переменной окружения — и можно сразу приступать к сравнительному тестированию.
Часто задаваемые вопросы
Вопрос 1. Какая модель лучше — Gemini 4 Argon или Claude Opus 5.5?
Однозначного ответа нет. В таблице бенчмарков Google Argon лидирует по 14 показателям, а Opus 5.5 — по 4. Однако в сводном индексе интеллекта Artificial Analysis Opus 5.5 опережает Argon: 57,6 против 52,6. Обе модели относятся к одному классу: Argon сильнее в работе с длинным контекстом, генерации очень длинных ответов и профессиональных агентах, а Opus 5.5 — в работе с терминалом, сложных рассуждениях и зрелости инженерной экосистемы.
Вопрос 2. Можно ли доверять данным из таблицы бенчмарков Google?
Их можно использовать как ориентир, но с оговорками. Это таблица, опубликованная Google, и условия некоторых тестов не полностью сопоставимы: например, различается число входных кадров в LVBench и настройки тайм-аута в Terminal-Bench Science. Кроме того, результаты Opus 5.5 в некоторых случаях ниже, чем в данных, опубликованных самой Anthropic. Рекомендуем обращать особое внимание на тесты, где разрыв превышает 5 баллов, а разницу в 1–2 балла считать ничьей.
Вопрос 3. Можно ли уже сейчас вызывать обе модели?
Claude Opus 5.5 уже доступна через Claude API, Bedrock, Vertex AI и Foundry. Gemini 4 Argon пока подключают постепенно: модель уже можно получить через Vertex AI, но платный API ещё не открыт для всех. Для начала можно подключить Opus 5.5 и модели Gemini через APIYI apiyi.com, а после официального запуска Argon просто изменить параметр `model` и сравнить результаты.
Вопрос 4. Если цена у моделей одинаковая, какая из них обойдётся дешевле на практике?
По результатам независимых тестов, стоимость выполнения одной задачи на Argon составляет примерно от трети до половины стоимости на Opus 5.5. На этапе пробного использования преимущество Argon особенно заметно. Однако стоимость Opus 5.5 можно существенно снизить, выбрав более низкий уровень effort и используя Batch с половинной ценой. Самый точный способ сравнить расходы — записать фактические значения `usage` на реальных задачах. Единый счёт на платформе APIYI apiyi.com позволяет легко сопоставить расходы на обе модели.
Итоги
Gemini 4 Argon и Claude Opus 5.5 — достойные соперники. По данным тестов Google, Argon заметно лучше справляется с длинным контекстом, агентными задачами в юридической и финансовой сферах, задачами в области наук о жизни и мультимодальными сценариями. А лимит в 1 млн токенов на выход — и вовсе уникальная возможность. Независимые тесты, напротив, показывают, что Opus 5.5 сильнее в рассуждениях, научном программировании и работе с терминалом. Кроме того, он уже доступен на всех платформах и хорошо подготовлен к использованию в инженерных проектах.
На данном этапе мы рекомендуем использовать Claude Opus 5.5 как основную модель в продакшене, а Gemini 4 Argon постепенно подключать для задач с длинным контекстом и сверхдлинными ответами. Параллельно проводите A/B-тестирование на собственном наборе реальных задач. Когда платный API Argon станет доступен повсеместно и появится больше независимых оценок, можно будет скорректировать распределение запросов на основе полученных данных.
Рекомендуем подключить модели Claude и Gemini через платформу APIYI apiyi.com. Единый интерфейс и общий счёт упростят сравнение моделей и маршрутизацию запросов, а выбор можно будет делать на основе реальных данных.
Источники:
- Официальная статья Google о выпуске Gemini 4 Argon: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Информация Anthropic о выпуске Claude Opus 5.5: anthropic.com/news
- Индекс интеллекта и сравнение моделей от Artificial Analysis: artificialanalysis.ai
- Рейтинг моделей Vals AI: vals.ai
- Сводная таблица тестов Gemini 4 Argon (ToolScout): toolscout.ai/news/gemini-4-argon-benchmarks
Автор: команда APIYI | Следим за новыми тестами Больших языковых моделей и помогаем выбирать подходящие решения. Больше новостей о подключении моделей — на APIYI apiyi.com