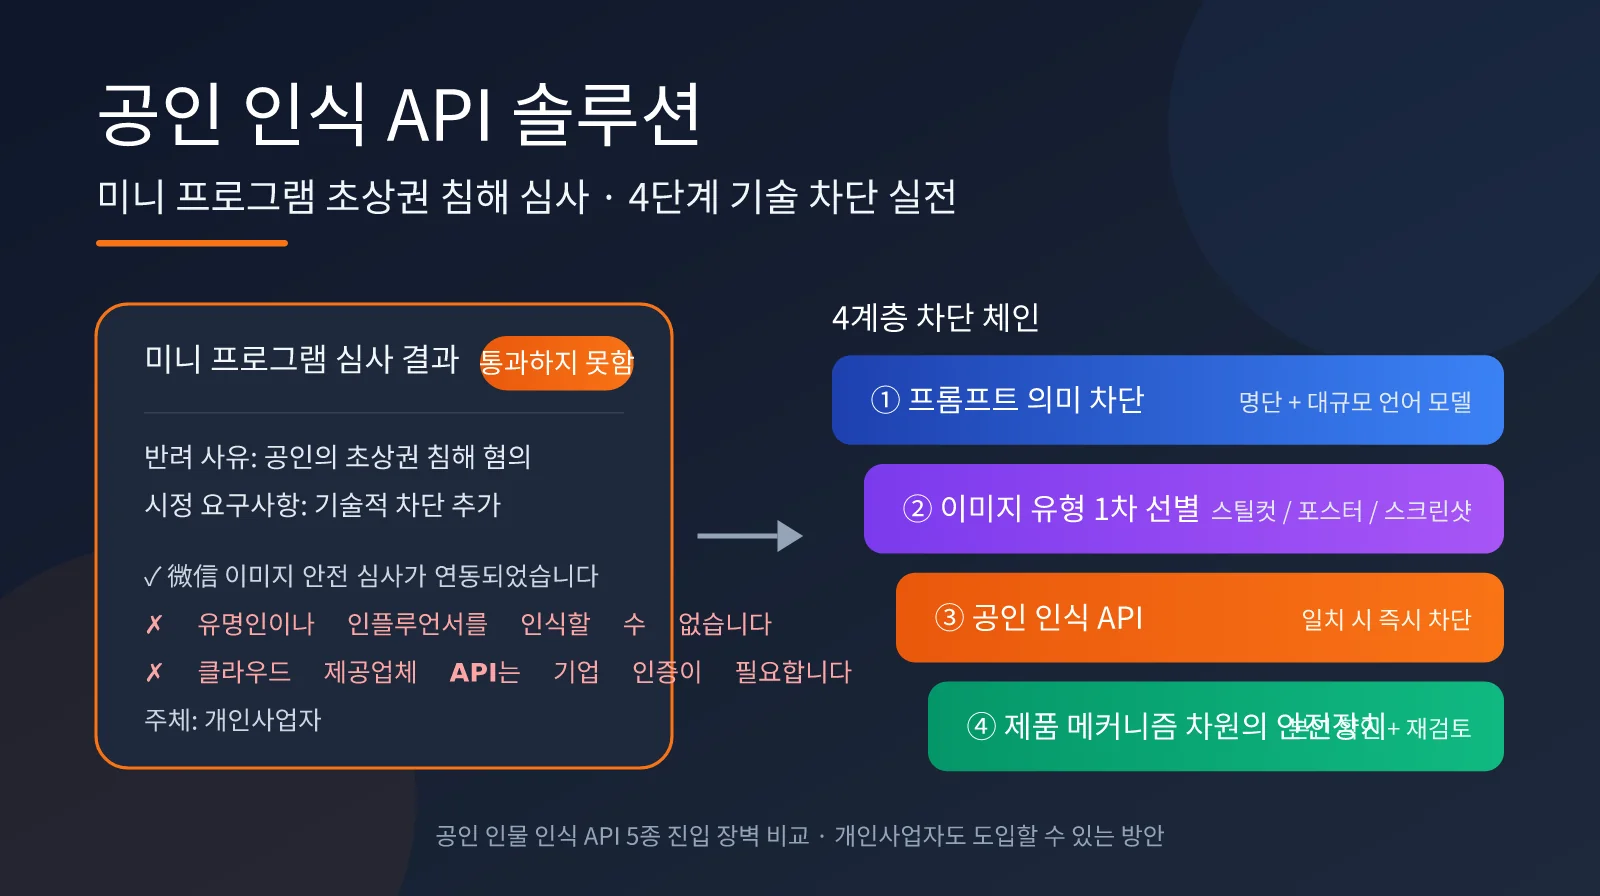
최근 AI 이미지 미니 프로그램을 개발하는 한 개발자가 개발자 단체 채팅방에 도움을 요청했어요. 미니 프로그램 심사가 공인 초상권 침해 문제로 막혔고, 위챗 측에서 “기술적 차단 기능을 추가하라”고 요구했다는 거예요. 이미 위챗 이미지 안전 심사 기능을 연동했지만, 이 API는 연예인이나 인플루언서를 식별하지 못했어요. 알리바바 클라우드에는 바로 사용할 수 있는 연예인 식별 API가 있지만, 기업 인증이 필요했죠. 이 개발자는 개인 사업자였고요.
이런 문제는 AI 프로필 사진, 얼굴 바꾸기, 아바타 생성, 포스터 디자인 관련 미니 프로그램에서 흔히 발생해요. 심사 담당자가 확인하는 건 “콘텐츠 안전 API를 연동했는가?”가 아니라 “사용자가 이 제품으로 공인의 초상을 생성하거나 유포할 수 있는가?”예요. 차단 과정에서 한 단계라도 빠지면 심사가 계속 반려될 수 있어요.
이 글에서는 공인 식별 API를 중심으로 위챗 콘텐츠 안전 API의 기능 범위를 먼저 짚고, 주요 공인 식별 API 5종의 도입 조건을 비교한 뒤, 개인 사업자도 적용할 수 있는 4단계 기술적 차단 방안을 소개할게요.
핵심 가치: 글을 끝까지 읽으면 어떤 공인 식별 API를 선택해야 하는지, 차단 절차를 어떻게 구성할지, 심사 신청 시 기술 방안을 어떻게 설명해야 하는지 알 수 있어요.
공인 식별 API가 미니 프로그램 심사의 필수 관문이 된 이유
위챗은 AI 생성 및 이미지 편집 미니 프로그램을 점점 더 엄격하게 심사하고 있어요. 여기에는 명확한 규제 근거가 있습니다. 《인터넷 정보 서비스 심층 합성 관리 규정》은 2023년 1월 10일부터 시행됐으며, 얼굴이나 음성 등 생체 식별 정보를 편집하는 기능을 제공하는 서비스 운영자에게 편집 대상자에게 알리고 별도의 동의를 받도록 요구해요. 2025년 9월 1일부터 시행된 《인공지능 생성·합성 콘텐츠 표시 방법》은 AI 생성 콘텐츠에 명시적·암묵적 표시를 하도록 추가로 요구하고요.
이런 상황에서 플랫폼이 가장 우려하는 건 ‘연예인 얼굴’의 악용이에요. 사용자가 배우의 드라마 장면을 업로드해 AI 프로필 사진을 만들거나, 인플루언서 사진으로 얼굴을 바꾸거나, 연예인 이름을 입력해 ‘같은 스타일’의 이미지를 생성하는 경우가 대표적이죠. 이런 행위는 초상권 침해에 해당할 수 있으며, 미니 프로그램 운영자는 이를 기술적으로 차단할 의무가 있어요. 따라서 심사 의견의 “기술적 차단 기능을 추가하라”는 말은 사용자의 업로드 단계와 생성 단계 모두에서 공인을 식별할 수 있어야 한다는 뜻이에요.
위챗 콘텐츠 안전 API의 기능 범위
개발자들은 먼저 위챗 공식 콘텐츠 안전 API를 연동하는 경우가 많지만, 이 API가 해결하는 문제는 공인 식별과는 달라요. 아래 표에서 위챗 API가 검사할 수 있는 항목과 초상권 침해를 막기 위해 실제로 필요한 기능을 비교해 볼게요.
| 검사 항목 | 위챗 msgSecCheck / mediaCheckAsync | 초상권 침해 차단에 필요한 기능 |
|---|---|---|
| 음란·저속 콘텐츠 | ✅ 지원 | 필요 |
| 시사·정치 관련 민감 콘텐츠 | ✅ 지원(일부 정치 관련 인물) | 필요 |
| 폭력·테러, 불법 콘텐츠, 욕설 | ✅ 지원 | 필요 |
| 연예인 식별 | ❌ 인물 신원 정보를 반환하지 않음 | 핵심 요구 사항 |
| 인플루언서·스트리머 식별 | ❌ 지원하지 않음 | 핵심 요구 사항 |
| 프롬프트에 입력된 연예인 이름 | ⚠️ 텍스트 위반 여부만 판단하며, 초상 생성 의도는 파악하지 못함 | 핵심 요구 사항 |
위챗 msgSecCheck는 텍스트 검사에, mediaCheckAsync는 이미지와 오디오의 비동기 검사에 사용돼요. 두 API는 주로 음란물, 정치 관련 민감 콘텐츠, 폭력·테러, 욕설 등 위반 콘텐츠를 식별하지만, “이 이미지에 어떤 연예인이 나오는지”는 알려주지 않아요. 따라서 위챗 API만 연동하면 심사 담당자 입장에서는 ‘일반적인 콘텐츠 안전’만 확보했을 뿐, ‘공인 초상 차단’은 완료하지 않은 셈이에요.
🎯 기술 제안: 공인 식별 API는 차단 절차의 한 단계일 뿐이에요. 프롬프트 단계의 차단이 오히려 더 중요하고 비용도 적게 들 때가 많습니다. APIYI apiyi.com 플랫폼을 통해 대규모 언어 모델로 프롬프트 의미를 검사하는 방법을 권장해요. OpenAI API 형식과 호환되며, 개인 개발자도 바로 가입해 사용할 수 있어 이 단계를 빠르게 보완할 수 있습니다.
5가지 유명인 식별 API 솔루션 비교
정보가 왜곡되지 않도록 아래 솔루션은 각 업체의 영문 공식 문서를 바탕으로 정리했어요. 먼저 짚고 넘어갈 점은 유명인 식별이 얼굴 인식에 해당한다는 거예요. 대부분의 대형 업체는 이 기능에 접근 제한을 두고 있으며, 바로 이 때문에 개인사업자가 “방법이 없다”고 느끼곤 합니다.
유명인 식별 API의 접근 조건과 기능 한눈에 보기
| 솔루션 | API 기능 | 이용 조건 | 중국어권 유명인·인플루언서 커버리지 | 요금 참고 |
|---|---|---|---|---|
| Alibaba Cloud 비전 AI / 콘텐츠 보안 | 유명인 식별 DetectCelebrity. 이미지 심사 강화 버전에서 infoType=publicFigure를 사용하면 유명인의 이름과 위치를 반환 |
개발자들의 경험에 따르면 기업 실명 인증 필요 | 높음 | 호출량 기준 과금 |
| Tencent Cloud 이미지 콘텐츠 보안 IMS | 위반 태그와 2차 태그를 반환하며, 일부 시나리오에서는 인물 이름도 반환 | 기업 인증 필요(개인사업자도 영업허가증 인증을 시도할 수 있음) | 중상 | 호출량 기준 과금 |
| AWS Rekognition | RecognizeCelebrities는 이미지 한 장에서 최대 64명의 유명인을 식별하고 이름, ID, 신뢰도, 참고 링크를 반환 |
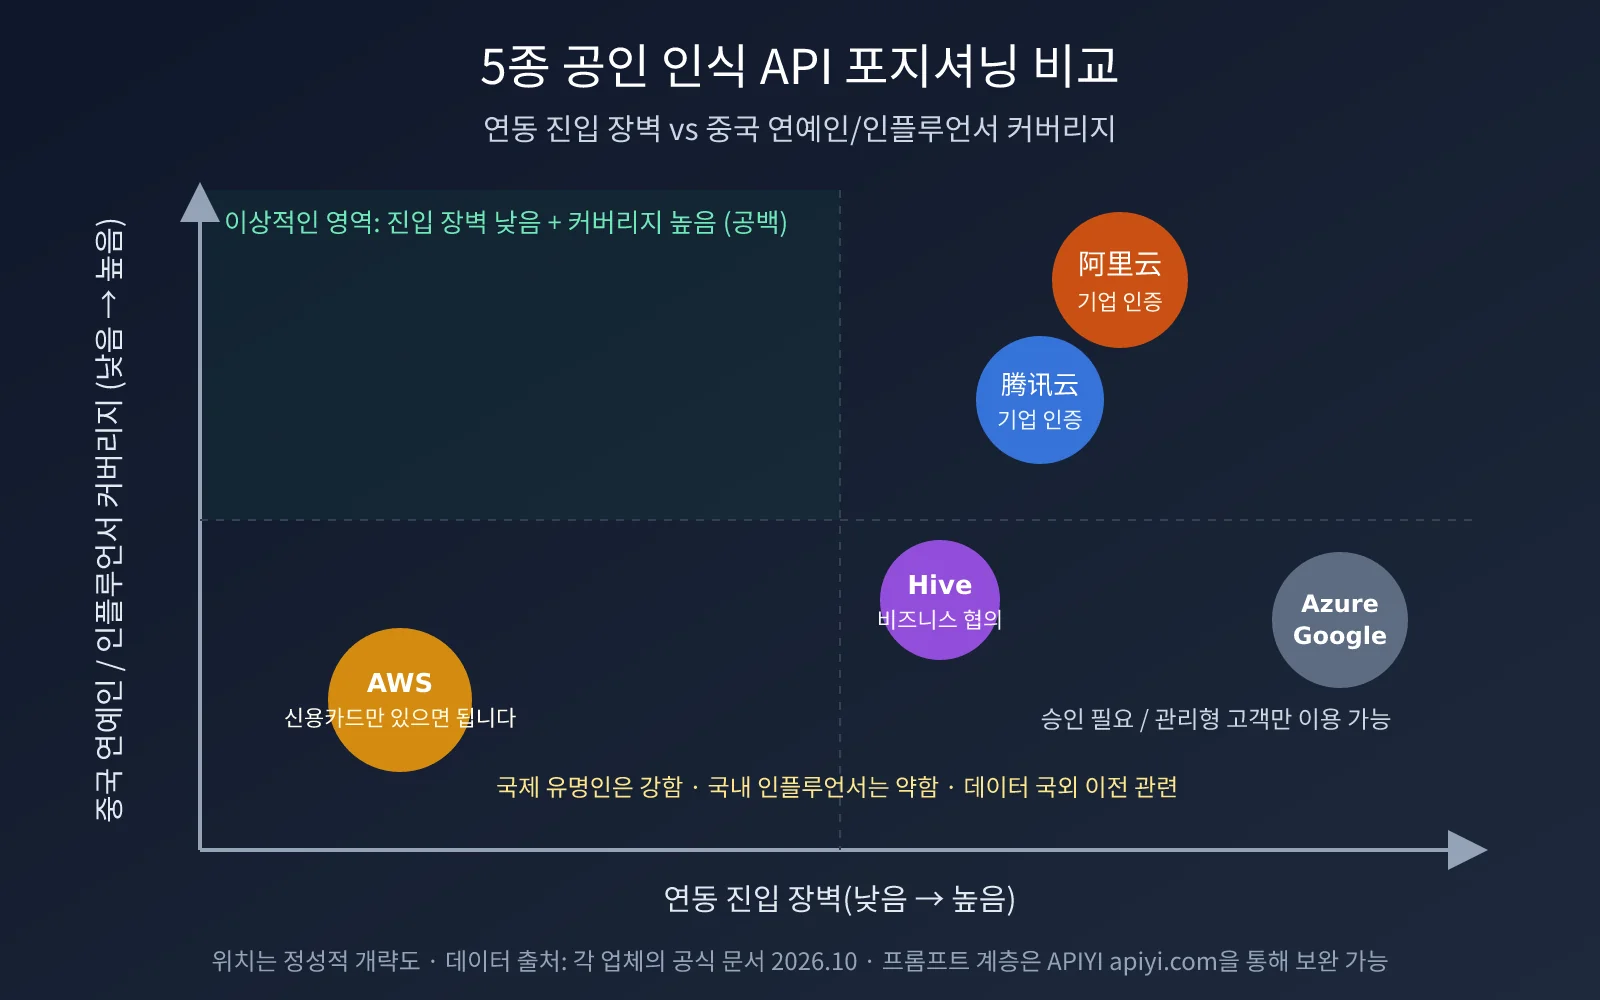
해외 계정은 신용카드만 등록하면 이용 가능하며 사전 승인 불필요 | 해외 유명인은 강세, 중국 내 인플루언서는 약세 | 첫 100만 장은 장당 $0.001 |
| Hive Celebrity Recognition | 정치인, 운동선수, 종교 지도자, 유명인 등 5만 명 이상 지원 | API 키 신청 필요, 기업 고객 중심 | 중간 | 공식 사이트에 요금 미공개 |
| Azure / Google Cloud Vision | 유명인 식별 | Azure는 2022년 6월부터 관리형 고객에게만 제공. Google은 사람이 심사한 미디어·엔터테인먼트 고객만 이용 가능 | 중간 | 사전 승인 필요 |
표에서 볼 수 있듯이 접근 조건이 가장 낮은 서비스는 AWS Rekognition이에요. 다만 유명인 데이터베이스는 해외 영화·스포츠·정치·경제계 인물 중심이라 중국 내 인플루언서나 스트리머의 커버리지는 제한적입니다. 또한 얼굴 정보는 《개인정보 보호법》상 민감한 개인정보에 해당해요. 사용자가 업로드한 사진을 해외 서비스로 전송하면 데이터 국외 이전 관련 규정도 고려해야 하며, 심사 자료를 제출할 때 이 점을 함께 검토해야 합니다.
개인사업자가 현실적으로 선택할 수 있는 방법
먼저 오해하기 쉬운 점부터 짚어볼게요. 중국 주요 클라우드 업체의 실명 인증 체계에서는 영업허가증을 보유한 개인사업자도 보통 ‘기업 인증’ 절차를 이용할 수 있어요. 다만 민감도가 높은 일부 API는 추가 자격 심사를 요구하기도 합니다. 따라서 “개인사업자는 기업이 아니다”라는 말이 항상 맞는 것은 아니에요. 먼저 Alibaba Cloud나 Tencent Cloud 고객센터에 문의해 해당 API의 구체적인 개통 조건을 확인해 보세요.
개통이 불가능하다는 답을 받았다면 접근 방식을 바꿔야 해요. ‘누구인지 식별하는 것’에 모든 부담을 맡기지 말고, 여러 단계의 필터를 두어 유명인의 초상이 생성 과정에 들어오지 못하게 하는 거예요. 심사 담당자가 중요하게 보는 것은 어떤 유명인 식별 API를 썼는지가 아니라, 차단 효과와 대응 체계가 얼마나 완전한지입니다.
유명인 식별을 위한 4단계 기술 차단 구조
아래 구조는 ‘앞단에서 먼저 차단하고, 단계별로 기준을 강화한다’는 원칙으로 설계했어요. 앞쪽 단계일수록 비용이 저렴하고 빠르며, 뒤쪽 단계일수록 정확도가 높고 비용도 더 많이 듭니다. 대부분의 위험 요청은 앞의 두 단계에서 걸러낼 수 있어요.
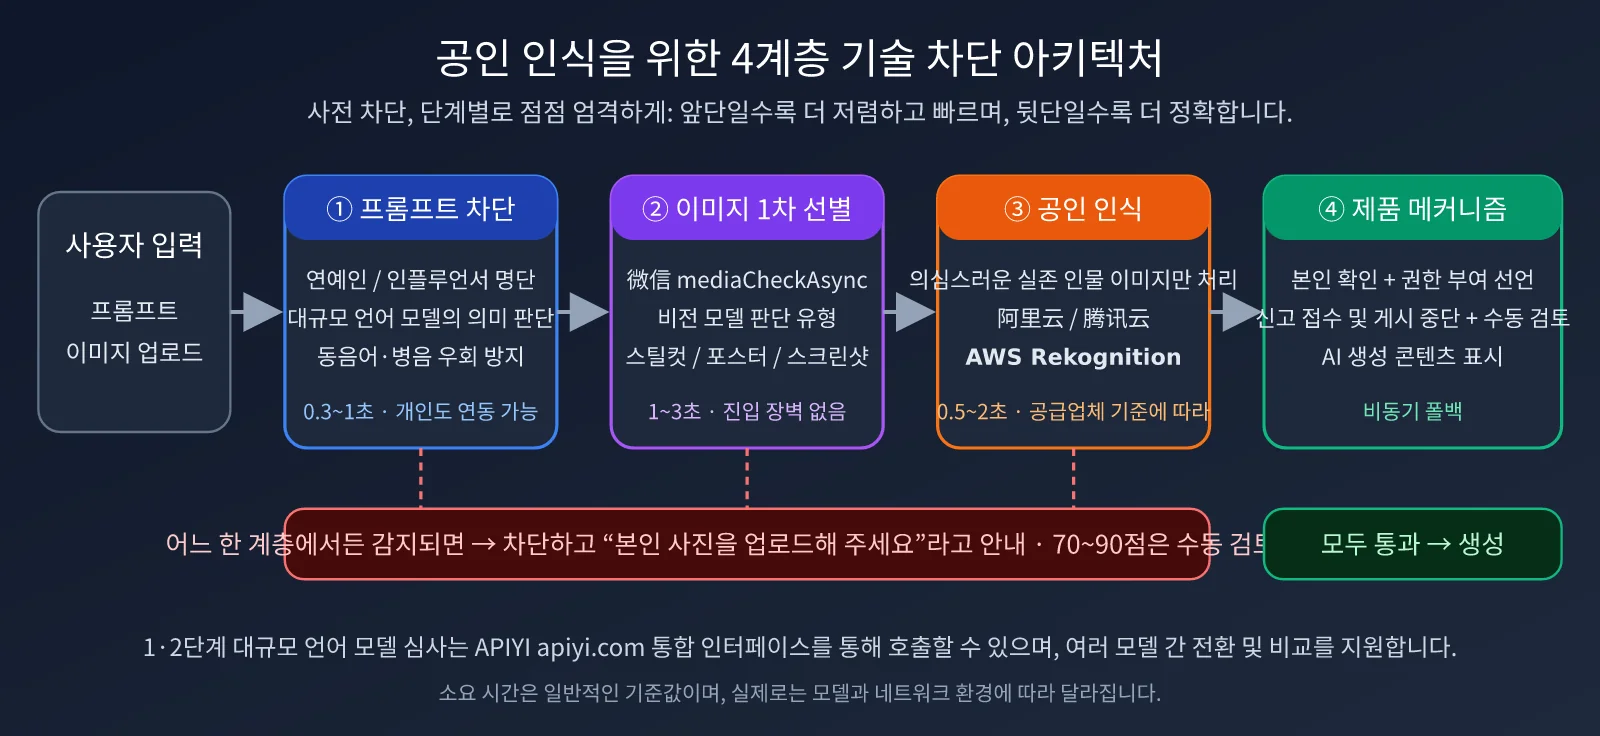
4단계 차단 구조의 역할
| 단계 | 차단 대상 | 구현 방식 | 일반적인 소요 시간 | 이용 조건 |
|---|---|---|---|---|
| 1단계 프롬프트 차단 | “유명인 화보를 만들어 줘”, “인플루언서 얼굴로 바꿔 줘” | 키워드 목록 + 대규모 언어 모델의 의미 분석 | 0.3~1초 | 없음, 개인도 이용 가능 |
| 2단계 이미지 1차 필터링 | 영화·드라마 장면, 포스터, 잡지 표지, 라이브 방송 캡처 | WeChat mediaCheckAsync + 비전 대규모 언어 모델로 이미지 유형 판단 |
1~3초 | 없음 |
| 3단계 유명인 식별 API | 이미 알려진 유명인의 실제 사진 | Alibaba Cloud / Tencent Cloud / AWS Rekognition | 0.5~2초 | 업체에 따라 다름 |
| 4단계 제품 차원의 대응 | 필터링을 통과한 콘텐츠 및 논란 소지가 있는 콘텐츠 | 권리 보유 확인, 신고·삭제, 수동 검토, AI 생성 표시 | 비동기 | 없음 |
1단계는 비용 대비 효과가 가장 큰 단계예요. AI 생성형 미니 프로그램에서 저작권 침해로 이어지는 요청은 대부분 프롬프트에서 시작합니다. 유명인의 이름을 직접 입력하거나 “누구누구처럼 생긴 얼굴”을 만들어 달라고 하는 식이죠. 키워드 목록만으로는 동음이의어, 병음, 약어를 이용한 우회를 막기 어렵지만, 대규모 언어 모델로 의미를 판단하면 재현율을 크게 높일 수 있어요.
2단계의 핵심은 “누구인지 식별하는 게 아니라, 어떤 종류의 이미지인지 식별하는 것”입니다. 비전 대규모 언어 모델은 사진 속 실제 인물의 신원을 밝히지 않는 경우가 많고, OpenAI도 GPT-4o가 실제 인물을 식별하는 기능을 명시적으로 제한하고 있어요. 하지만 이미지가 “영화·드라마 장면, 유명인 포스터, 잡지 표지, 방송국 로고가 포함된 라이브 방송 캡처”인지 판단하는 건 충분히 가능합니다. 이런 이미지 자체가 위험 신호이므로 바로 차단하거나 3단계로 넘길 수 있어요.
1단계: 프롬프트 의미 기반 차단 코드 예시
아래는 프롬프트가 실제 유명인과 관련 있는지 대규모 언어 모델로 판단하는 간단한 예시예요. 모델은 구조화된 JSON을 반환하고, 백엔드에서 그 결과에 따라 요청을 허용하거나 차단합니다.
import json
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")  # APIYI 统一接口

def check_prompt(prompt: str) -> dict:
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        response_format={"type": "json_object"},
        messages=[
            {"role": "system", "content": "判断用户提示词是否要求生成、模仿或替换真实公众人物(明星、网红、主播、政治人物、运动员)的肖像。"
             "只输出 JSON:{\"risk\": true/false, \"names\": [], \"reason\": \"\"}"},
            {"role": "user", "content": prompt},
        ],
    )
    return json.loads(resp.choices[0].message.content)

print(check_prompt("帮我生成一张和那个唱《青花瓷》的歌手同款的写真"))
이 예시의 프롬프트에는 인물 이름이 직접 나오지 않아 키워드 목록으로는 감지할 수 없어요. 하지만 대규모 언어 모델은 문맥을 바탕으로 특정 가수를 가리킨다는 점을 추론해 위험 요청으로 판단할 수 있습니다.
📦 펼쳐서 전체 예시 보기: 프롬프트 + 이미지 2단계 차단
import base64, json
import boto3
from openai import OpenAI

llm = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")  # APIYI 统一接口
rek = boto3.client("rekognition", region_name="ap-southeast-1")

BLOCK_NAMES = {"示例明星A", "示例网红B"}  # 本地名单,命中直接拦截

def llm_json(messages):
    resp = llm.chat.completions.create(
        model="gpt-4o-mini",
        response_format={"type": "json_object"},
        messages=messages,
    )
    return json.loads(resp.choices[0].message.content)

def layer1_prompt(prompt: str) -> bool:
    if any(n in prompt for n in BLOCK_NAMES):
        return True
    r = llm_json([
        {"role": "system", "content": "判断提示词是否涉及真实公众人物肖像,只输出 JSON:{\"risk\": bool}"},
        {"role": "user", "content": prompt},
    ])
    return r.get("risk", False)

def layer2_image(img_bytes: bytes) -> str:
    """不识别身份,只判断图片类型,返回 block / suspect / pass"""
    b64 = base64.b64encode(img_bytes).decode()
    r = llm_json([
        {"role": "system", "content": "不要识别人物身份。只判断图片类型,输出 JSON:"
         "{\"type\": \"selfie|film_still|poster|magazine|live_screenshot|non_human|other\", \"real_person\": bool}"},
        {"role": "user", "content": [
            {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{b64}"}},
        ]},
    ])
    if r.get("type") in {"film_still", "poster", "magazine", "live_screenshot"}:
        return "block"
    return "suspect" if r.get("real_person") else "pass"

def layer3_celebrity(img_bytes: bytes, threshold: float = 90.0) -> bool:
    res = rek.recognize_celebrities(Image={"Bytes": img_bytes})
    return any(c["MatchConfidence"] >= threshold for c in res["CelebrityFaces"])

def moderate(prompt: str, img_bytes: bytes | None) -> str:
    if layer1_prompt(prompt):
        return "blocked: prompt"
    if img_bytes:
        verdict = layer2_image(img_bytes)
        if verdict == "block":
            return "blocked: image_type"
        if verdict == "suspect" and layer3_celebrity(img_bytes):
            return "blocked: public_figure"
    return "pass"
전체 예시에서는 2단계에서 ‘실제 인물 사진’으로 판단된 이미지에만 3단계 API를 호출해요. 이렇게 하면 유명인 식별 API 비용을 아끼고, 외부로 전송하는 얼굴 데이터의 양도 줄일 수 있습니다. Alibaba Cloud나 Tencent Cloud API를 이미 사용할 수 있다면 layer3_celebrity를 해당 SDK 호출로 바꾸면 돼요.
🚀 빠르게 시작하기: 1단계와 2단계 모두 대규모 언어 모델을 사용해요. 먼저 APIYI apiyi.com에서 테스트 크레딧을 받아 실제 사용자 프롬프트와 이미지 100개를 넣어 보고, 차단율과 오탐률을 측정한 뒤 배포하는 것을 추천합니다. 같은 코드로 GPT, Gemini, Claude 등 여러 모델을 바꿔 가며 성능을 비교할 수도 있어요.
공인 식별 결과의 임계값과 대응 전략
식별 결과는 단순히 ‘예’ 또는 ‘아니요’로 나뉘지 않아요. 신뢰도 임계값에 따라 오차단율과 누락 통과율이 달라져요. Hive 공식 문서에서는 실제 사진에 0.85, AI 생성 콘텐츠에 0.9를 권장해요. AWS Rekognition이 반환하는 MatchConfidence는 0~100 범위이므로 같은 방식으로 설정할 수 있어요.
| 신뢰도 구간 | 대응 조치 | 사용자 안내 문구 | 설명 |
|---|---|---|---|
| ≥ 90 | 즉시 차단 | “이미지에 공인의 초상이 포함된 것으로 의심됩니다. 본인 사진을 업로드해 주세요.” | 신뢰도가 높아 오차단 가능성이 낮아요 |
| 70-90 | 차단 후 수동 검토 대기열에 등록 | “이미지를 검토하고 있어요. 잠시만 기다려 주세요.” | 닮은 얼굴이나 각도·가림 문제로 보통 이 구간에 해당해요 |
| 얼굴은 감지했지만 일치 항목 없음 | 통과, 로그 보관 | 없음 | 일반 사용자의 정상적인 사진 |
| 얼굴 감지 안 됨 | 통과 | 없음 | 풍경, 반려동물, 사물 등 |
AI 프로필 사진 서비스라면 ‘본인 확인’을 추가하는 편이 더 안전해요. 먼저 사용자에게 기준이 될 셀카를 업로드하도록 하고, 이후 업로드하는 사진은 기준 얼굴과의 유사도가 일정 수준에 도달해야 생성할 수 있도록 하는 방식이에요. 이렇게 하면 공인 식별 API가 일부 인지도가 낮은 인플루언서를 식별하지 못하더라도, 다른 사람의 얼굴을 사용하는 일을 구조적으로 막을 수 있어요.
💡 선택 가이드: 국내 인플루언서와 스트리머가 주요 위험 요소라면 해외 공인 식별 API의 인물 데이터베이스만으로는 부족해요. 1단계 프롬프트 차단과 ‘본인 확인’ 절차에 중점을 두는 게 좋아요. 1단계 대규모 언어 모델 호출은 APIYI apiyi.com을 통해 연동할 수 있으며, 비용은 보통 이미지 인식 비용의 몇 분의 1 수준이에요.
심사 신청 시 공인 차단 방안을 설명하는 방법
기술을 갖추는 것만큼 심사 담당자가 이해할 수 있도록 설명하는 것도 중요해요. 심사 비고나 보충 자료에 다음 구조로 작성하는 것을 권장해요.
- 차단 흐름: 프롬프트, 이미지 업로드, 생성 결과의 각 단계에 어떤 탐지 기능을 적용했는지 설명해요.
- 공인 식별 기능: 사용 중인 공인 식별 API 또는 대체 방안과, 식별 결과에 따른 조치를 명시해요.
- 제품 내 보호 장치: 사용자 약관의 초상권 이용 허가 조항, 업로드 전 ‘본인 사진만 허용’ 확인 팝업, 신고 기능과 삭제 처리 기한을 설명해요.
- AI 콘텐츠 표시: 생성 이미지에 ‘AI 생성’이라는 명시적 표시를 추가하고, 파일 메타데이터에도 비가시성 표시를 기록해요.
- 테스트 증거: 연예인 사진이나 연예인 이름이 포함된 프롬프트로 테스트해 차단된 화면을 캡처하거나 녹화해 첨부해요.
이 중에서도 5번 항목이 가장 설득력 있어요. 심사 담당자는 연예인 사진을 직접 사용해 테스트하는 경우가 많아요. 녹화 영상에서 ‘연예인 드라마 사진 업로드 → 차단’, ‘연예인 이름 입력 → 차단’ 과정을 보여 주면 통과 가능성이 크게 높아져요.
공인 식별 API 관련 자주 묻는 질문
Q1: 대규모 언어 모델만으로 공인 식별 API를 완전히 대체할 수 있나요?
완전히 대체할 수는 없어요. 주요 비전 대규모 언어 모델은 개인정보 보호 정책상 사진 속 실제 인물이 누구인지 답변하지 않는 경우가 많고, 식별이 가능하더라도 결과가 안정적이지 않아 확정적인 신원 판단에는 적합하지 않아요. 대규모 언어 모델은 프롬프트의 의미를 파악해 차단하거나 이미지 유형을 판별하는 데 적합하고, 신원 식별은 전용 공인 식별 API에 맡기는 편이 좋아요. APIYI apiyi.com을 통해 동일한 샘플로 여러 모델의 차단 성능을 테스트한 뒤 역할을 나눌 수 있어요.
Q2: AWS Rekognition은 국내 연예인을 식별할 수 있나요?
인지도가 높은 일부 중국어권 영화·드라마 배우와 스포츠 스타는 식별할 수 있지만, 국내 인플루언서와 스트리머, 숏폼 콘텐츠 크리에이터는 데이터베이스에 포함된 비율이 현저히 낮아요. 또한 해외 서비스이므로 얼굴과 같은 민감한 개인정보를 처리할 때는 데이터 국외 이전 관련 규정을 검토해야 해요. 2단계에서 의심스러운 것으로 분류된 사진에만 API를 호출하고, 개인정보 처리방침에도 관련 내용을 정확히 고지하는 것이 좋아요.
Q3: 개인사업자는 알리바바 클라우드의 연예인 식별 기능을 신청할 수 없나요?
그렇지는 않아요. 개인사업자도 사업자등록증이 있으면 보통 클라우드 서비스 기업 인증을 완료할 수 있지만, 일부 API는 추가 자격 심사를 요구해요. 해당 API의 이용 조건을 문의하려면 먼저 고객 지원 티켓을 제출하고, 대안으로 텐센트 클라우드도 준비해 두는 것이 좋아요.
Q4: 프롬프트 차단에 대규모 언어 모델을 사용하면 비용이 많이 드나요?
비용이 매우 낮아요. 프롬프트 검토 한 번에 보통 수백 개의 토큰만 사용하며, 경량 모델을 쓰면 이미지 인식 한 번보다 훨씬 저렴해요. APIYI apiyi.com을 통해 사용량에 따라 요금을 낼 수도 있어 호출량 변동이 큰 미니 프로그램에 적합해요.
Q5: 차단 기능을 적용했는데도 심사에서 거부되면 어떻게 해야 하나요?
먼저 거부 사유에 ‘기존 콘텐츠’ 문제가 포함되어 있는지 확인해 보세요. 예를 들어 미니 프로그램의 예시 이미지나 템플릿 이미지에 연예인 사진이 사용되었는지 점검해야 해요. 기술적인 차단 기능을 구현하고도 메인 화면의 예시 이미지에 연예인 이미지를 사용해 다시 거부되는 경우가 많아요. 이런 이미지는 모두 자체 저작권을 보유한 이미지나 AI가 생성한 가상 인물 이미지로 교체해야 해요.
요약
미니 프로그램이 유명인의 초상권 침해 문제로 ‘기술적 차단 기능을 추가하라’는 요구를 받았다면, 핵심은 만능 유명인 식별 API를 찾는 게 아니라 완전한 차단 절차를 구축하는 거예요. 위챗 콘텐츠 안전 API는 일반적인 위반 사항만 다루며 연예인이나 인플루언서는 식별하지 못해요. 알리바바 클라우드와 텐센트 클라우드의 유명인 식별 기능이 국내 상황에 가장 적합하지만, 기업 인증이 필요해요. AWS Rekognition은 이용 요건이 가장 낮지만 국내 인플루언서 데이터가 제한적이고, 데이터 국외 이전 문제도 고려해야 해요. Azure와 Google은 일반 개발자가 이용하기 어려운 편이에요.
개인사업자라면 가장 현실적인 방법은 먼저 사업자등록증으로 클라우드 사업자의 기업 인증을 받을 수 있는지 확인하는 거예요. 동시에 프롬프트 의미 기반 차단과 이미지 유형 1차 선별 기능을 도입하고, 본인 확인과 이용 허가 확인, 수동 검수 절차를 추가하세요. 마지막으로 차단 기능이 효과적으로 작동한다는 점을 테스트 녹화 영상으로 심사 담당자에게 보여주면 돼요.
APIYI apiyi.com을 이용하면 1단계와 2단계의 대규모 언어 모델 심사 기능을 빠르게 구축할 수 있어요. 실제 샘플로 차단율을 검증한 뒤 심사를 신청해 보세요.
작성자: APIYI Team. AI 대규모 언어 모델 API의 실제 적용을 전문으로 합니다. 더 많은 기술 솔루션과 테스트 사용량은 APIYI apiyi.com에서 확인할 수 있어요.