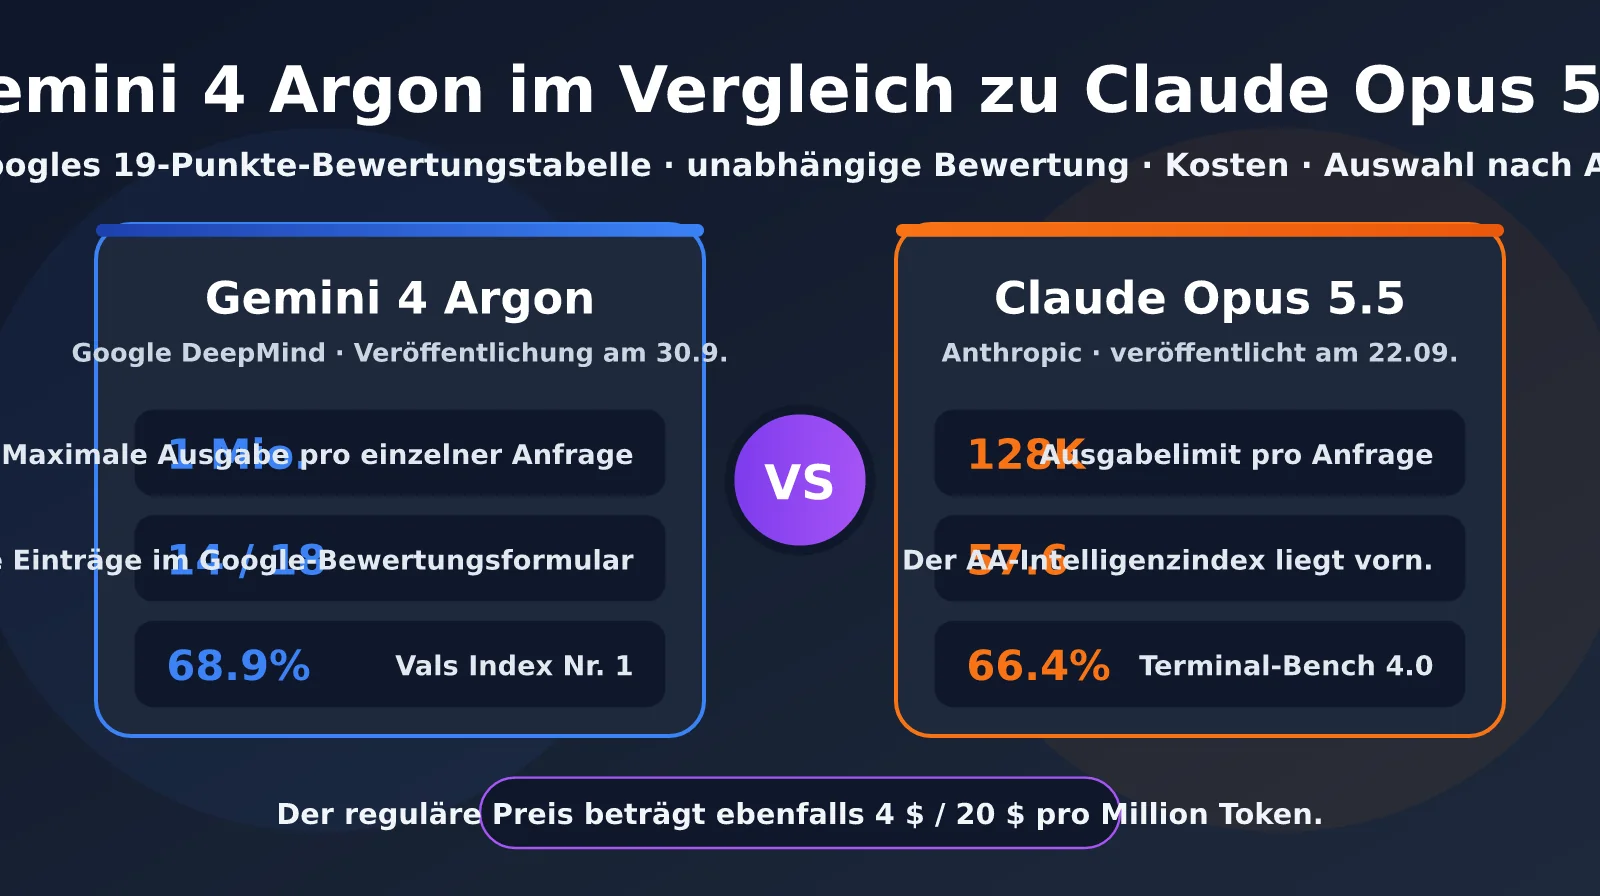
Von Ende September bis Anfang Oktober wurden mehrere führende Große Sprachmodelle in kurzer Folge aktualisiert: Anthropic veröffentlichte am 22. September Claude Opus 5.5, nur acht Tage später brachte Google Gemini 4 Argon heraus. Die Modelle sind ähnlich positioniert: Beide setzen auf mehrstufiges Schlussfolgern, agentisches Programmieren und Wissensarbeit in Unternehmen. Auch die offiziellen Preise sind identisch: 4 $ pro Million Eingabe-Token und 20 $ pro Million Ausgabe-Token. Kein Wunder also, dass Entwickler häufig fragen, wie sich Gemini 4 Argon und Claude Opus 5.5 im Vergleich schlagen.
Bislang gibt es nur wenige öffentlich zugängliche Informationen. Die umfassendsten Primärdaten stammen aus einer Vergleichstabelle mit 19 Benchmarks in Googles Argon-Evaluierungsdokumentation, in der auch Claude Opus 5.5 aufgeführt ist. Dieser Artikel geht die Tabelle Punkt für Punkt durch und ergänzt die Ergebnisse um unabhängige Tests von Drittanbietern wie Artificial Analysis und Vals sowie um technische Faktoren wie Preis, Ausgabelimit und Verfügbarkeit. So lässt sich besser einschätzen, für welche Anwendungsfälle sich die beiden Modelle eignen.
Das Wichtigste: Nach der Lektüre wissen Sie, welche Zahlen in Googles Evaluierungstabelle belastbar sind und welche Sie mit Vorsicht betrachten sollten. Außerdem können Sie anhand Ihres konkreten Anwendungsfalls zwischen Gemini 4 Argon und Claude Opus 5.5 wählen.
Gemini 4 Argon vs. Claude Opus 5.5: Vergleich der Basisdaten
Bevor wir uns die Benchmark-Ergebnisse ansehen, vergleichen wir zunächst die Basisdaten der beiden Modelle. Die offiziellen Preise sind identisch. Die entscheidenden Unterschiede liegen bei Ausgabelimit, Verfügbarkeit und Einführungspreis.
| Vergleichspunkt | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Veröffentlichungsdatum | 30. September 2026 | 22. September 2026 |
| Aktuelle Verfügbarkeit | Über das Fairwind-Programm und Vertex AI schrittweise verfügbar; die kostenpflichtige API ist noch nicht allgemein zugänglich | Vollständig verfügbar: Claude API, Bedrock, Vertex AI, Foundry |
| Modell-ID | Noch nicht offiziell bekannt gegeben | claude-opus-5-5 |
| Preis (Eingabe/Ausgabe) | Einführungspreis: 2 $/10 $, regulär: 4 $/20 $ | 4 $/20 $ |
| Cache-Lesezugriff | 95 % Rabatt auf den Eingabepreis (ab 0,10 $) | 0,20 $ |
| Batch-Preis | Noch nicht bekannt gegeben | 2 $/10 $ |
| Kontextfenster | Offiziell nicht bekannt gegeben (laut Drittanbietern 1 Mio.) | 1 Mio., kein Aufpreis für lange Kontexte |
| Ausgabelimit pro Anfrage | 1 Mio. Token | 128.000 Token |
| Steuerung des Schlussfolgerns | Mehrere Stufen, darunter „High“ | Fünf Effort-Stufen von „low“ bis „max“, adaptives Denken |
Die Tabelle zeigt den größten klaren Vorteil von Argon: ein Ausgabelimit von 1 Mio. Token, etwa achtmal so viel wie bei Opus 5.5. Das eignet sich für die Generierung sehr langer Codeblöcke und umfangreiche Migrationsaufgaben. Opus 5.5 punktet dagegen vor allem damit, dass es bereits heute zuverlässig verfügbar ist: Die Modell-ID steht fest, das Modell ist auf allen wichtigen Cloud-Plattformen verfügbar und bietet außerdem Batch-Verarbeitung zum halben Preis sowie fünf Effort-Stufen. Insgesamt ist es damit deutlich ausgereifter für den produktiven Einsatz.
🎯 Empfehlung für den Vergleich: Da die regulären Preise beider Modelle gleich sind, sollte die Auswahl vor allem vom Aufgabentyp abhängen. Wir empfehlen, Claude Opus 5.5 und die Gemini-Modelle über dieselbe Schnittstelle auf der Plattform APIYI apiyi.com aufzurufen und mit den eigenen realen Aufgaben direkt miteinander zu vergleichen. Das ist verlässlicher, als sich nur auf Ranglisten zu stützen.
Gemini 4 Argon vs. Claude Opus 5.5: Googles Benchmark-Tabelle im Detail
Unten stehen die Vergleichsdaten, die Google in der Benchmark-Dokumentation zu Argon veröffentlicht hat. Hier sind nur die Spalten für Argon und Opus 5.5 aufgeführt, nach Kategorien sortiert. Wichtig ist: Es handelt sich um eine vom Hersteller veröffentlichte Tabelle. Die Argon-Ergebnisse stammen aus Tests von Google selbst. Die Opus-5.5-Ergebnisse kommen überwiegend aus öffentlichen Ranglisten oder der System Card von Anthropic. Einige Benchmarks hat Google einheitlich für beide Modelle erneut ausgeführt.
| Kategorie | Benchmark | Gemini 4 Argon | Claude Opus 5.5 | Führendes Modell |
|---|---|---|---|---|
| Wissensarbeit | Vals Index | 68.9% | 67.0% | Argon +1.9 |
| Wissensarbeit | AutomationBench | 51.3% | 42.5% | Argon +8.8 |
| Wissensarbeit | Vals Finance Agent v2 | 65.4% | 58.6% | Argon +6.8 |
| Wissensarbeit | Harvey Legal Agent | 19.6% | 3.8% | Argon +15.8 |
| Agentisches Programmieren | DeepSWE v1.1 | 77.9% | 74.2% | Argon +3.7 |
| Agentisches Programmieren | FrontierSWE v2 | 55.0% | 62.3% | Opus +7.3 |
| Agentisches Programmieren | Vibe Code Bench | 91.9% | 90.3% | Argon +1.6 |
| Agentisches Programmieren | Terminal-Bench 4.0 | 57.4% | 66.4% | Opus +9.0 |
| ML-Engineering | PostTrainBench | 45.3% | 49.3% | Opus +4.0 |
| Wissenschaft und Mathematik | Terminal-Bench Science 0.1 | 57.6% | 63.3% | Opus +5.7 |
| Wissenschaft und Mathematik | LABBench 2 | 88.8% | 73.1% | Argon +15.7 |
| Wissenschaft und Mathematik | RiemannBench | 76.0% | 69.6% | Argon +6.4 |
| Langer Kontext | GraphWalks ≤128K | 99.7% | 90.6% | Argon +9.1 |
| Langer Kontext | GraphWalks 256K–1M | 84.2% | 66.8% | Argon +17.4 |
| Computerbedienung | Agent’s Last Exam | 39.5% | 38.2% | Argon +1.3 |
| Multimodal | Chartography | 71.6% | 66.3% | Argon +5.3 |
| Multimodal | LVBench – lange Videos | 91.7% | 83.7% | Argon +8.0 |
| Cybersicherheit | CWE-bench v1 | 68.0% | 67.0% | Argon +1.0 |
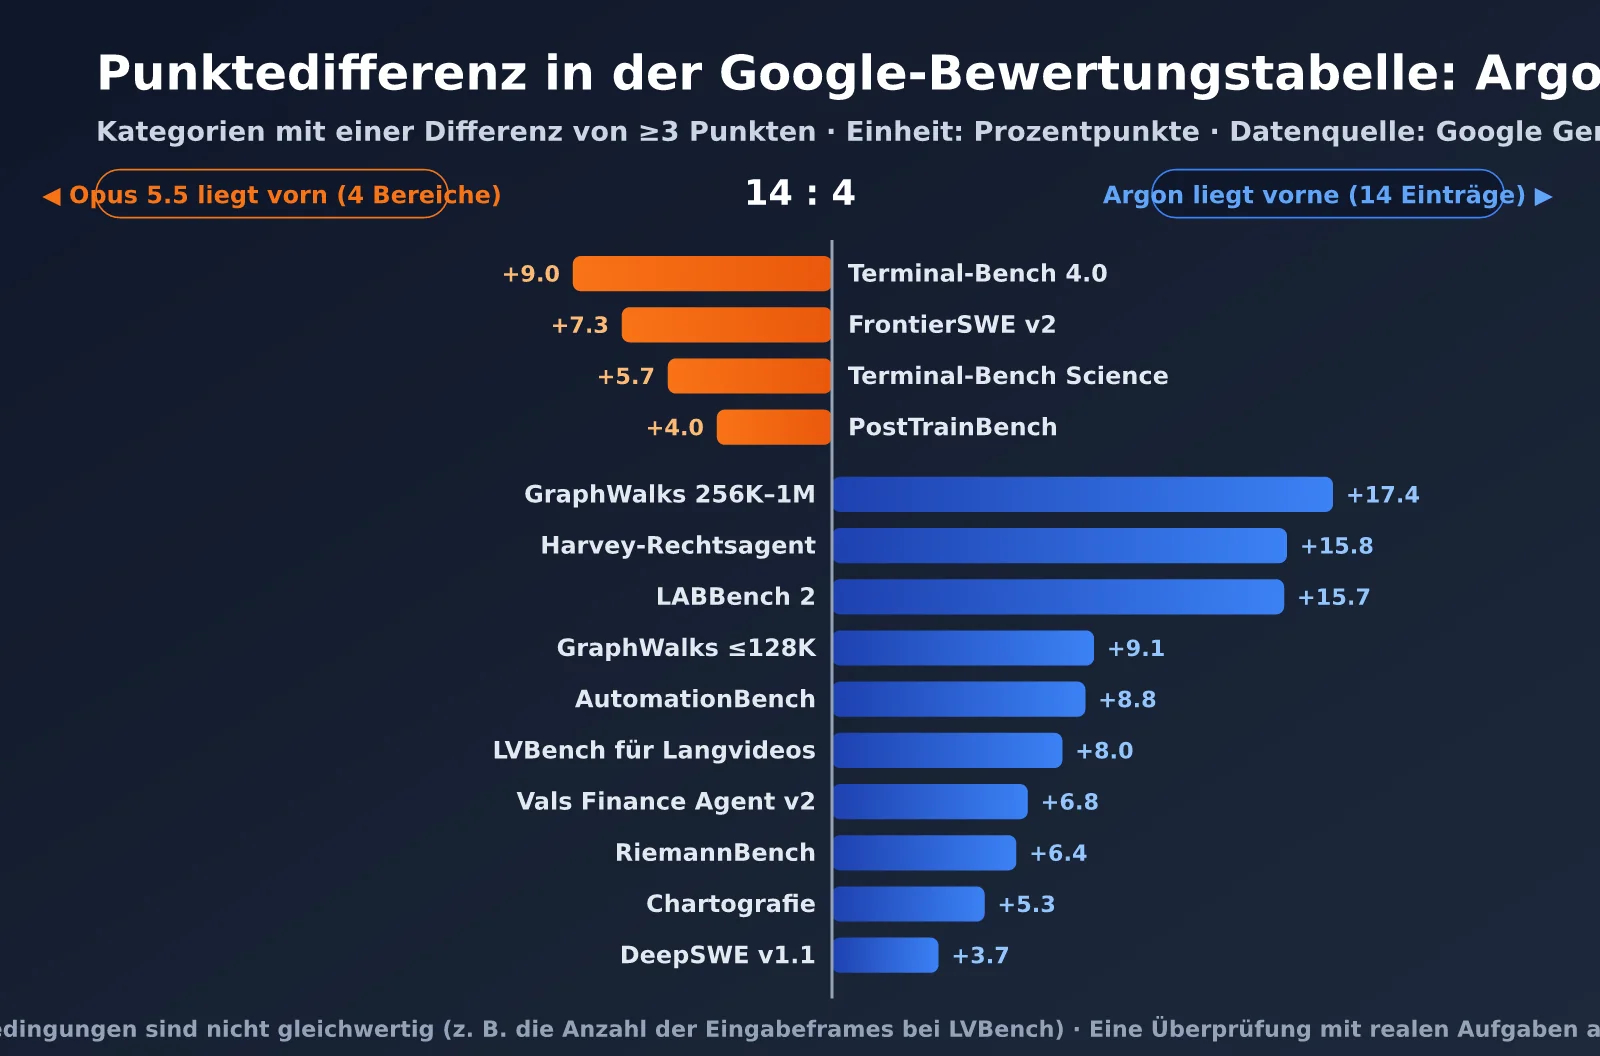
Bei den 18 Benchmarks, für die Ergebnisse zu beiden Modellen vorliegen, liegt Argon in 14 Fällen vorn, Opus 5.5 in 4. Die vier Siege von Opus 5.5 folgen einem klaren Muster: FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench und Terminal-Bench Science verlangen allesamt längere Arbeit in einer echten Terminalumgebung mit wiederholter Befehlsausführung. Argons deutliche Vorsprünge konzentrieren sich dagegen auf lange Kontexte (17,4 Punkte Vorsprung bei GraphWalks 256K–1M), Legal Agents und die Lebenswissenschaften (LABBench 2).
Wo Googles Benchmark-Tabelle mit Vorsicht zu lesen ist
Benchmark-Tabellen der Hersteller sind naturgemäß vorteilhaft für die eigenen Modelle. Auch in den Fußnoten dieser Tabelle gibt es einige Details, die man beachten sollte. Nur wenn man sie kennt, lassen sich die Abstände zwischen Gemini 4 Argon und Claude Opus 5.5 richtig einordnen:
- Unterschiedliche Zahl von Eingabeframes bei LVBench: Argon verarbeitet das vollständige Video mit einem Frame pro Sekunde. Bei Opus 5.5 begrenzt die API die Eingabe auf 600 Frames. Der Leistungsunterschied bei langen Videos ist also teilweise auf ungleiche Eingabebedingungen zurückzuführen.
- Großzügigeres Zeitlimit bei Terminal-Bench Science: Für Argon wurde das Zeitlimit zur Verifizierung auf das Sechsfache des Standardwerts gesetzt. Trotzdem liegt Argon noch 5,7 Punkte hinter Opus 5.5.
- Unterschiedliche Testframeworks bei DeepSWE: Argon wurde mit dem mini-swe-Agent-Framework getestet. Claudes Ergebnis stammt aus der System Card von Anthropic. Die Tests wurden also nicht mit demselben Framework durchgeführt.
- Abweichungen zu den von Anthropic selbst veröffentlichten Daten: In Anthropics eigenen Angaben zu Opus 5.5 liegt AutomationBench bei 40.0 %, Chartography mit Tools bei 89.0 % und OSWorld 2.0 bei 81.8 %. In Googles Tabelle wird für Chartography nur 66.3 % angegeben; das Feld für OSWorld bleibt leer.
Anders gesagt: Bei vergleichbaren Testbedingungen fällt der Abstand zwischen den beiden Modellen geringer aus, als es die Tabelle vermuten lässt. Argons Vorsprung bei langen Kontexten, Legal-Aufgaben und Lebenswissenschaften ist groß genug, um als belastbar zu gelten. Bei Vals Index, Vibe Code und CWE-bench, wo der Abstand nur ein bis zwei Punkte beträgt, kann man die Ergebnisse im Wesentlichen als Gleichstand betrachten.
Unabhängige Testergebnisse: Gemini 4 Argon vs. Claude Opus 5.5
Die Ergebnisse unabhängiger Tests weichen von Googles Benchmark-Tabelle ab – beim allgemeinen Intelligenzindex zeigen sie sogar in die entgegengesetzte Richtung. Die folgende Tabelle fasst die veröffentlichten Daten von Artificial Analysis (AA) und Vals zusammen.
| Unabhängiger Test | Gemini 4 Argon | Claude Opus 5.5 | Führendes Modell |
|---|---|---|---|
| AA Intelligence Index v4.3 | 52,6 | 57,6 | Opus +5,0 |
| Vals Index – Rang | 68,90 % (Platz 1) | 66,97 % (Platz 3) | Argon +1,9 |
| AA Terminal-Bench 4.0 | 57,1 % | 59,6 % | Opus +2,5 |
| AA Humanity’s Last Exam | 57,1 % | 61,4 % | Opus +4,3 |
| AA SciCode | 61,8 % | 66,9 % | Opus +5,1 |
| AA Long-Context Reasoning | 79,7 % | 84,7 % | Opus +5,0 |
| AA GDPval (Elo) | 1611 | 1846 | Opus +235 |
| AA AutomationBench | 77,5 % | 69,5 % | Argon +8,0 |
| AA-Ausgabegeschwindigkeit | 48,9 Token/s | 92,2 Token/s | Opus etwa 1,9-mal schneller |
In den Tests von AA liegt Opus 5.5 bei Schlussfolgerungen, wissenschaftlicher Programmierung, Schlussfolgerungen mit langem Kontext und beruflichen Aufgaben aus GDPval durchweg vorn. Argon schneidet lediglich bei der Geschäftsautomatisierung mit AutomationBench deutlich besser ab. Der Vergleich von AA ist allerdings nicht ganz fair: Argon wurde nur mit der Einstellung „High“ getestet, während für Opus 5.5 die Einstellung „Max“ mit adaptivem Reasoning verwendet wurde. Ein Teil des Abstands könnte daher auf die unterschiedliche Intensität der Schlussfolgerungen zurückzuführen sein und nicht ausschließlich auf die Fähigkeiten der Modelle.
Der Vals Index setzt Argon unter 41 Modellen auf Platz eins und Opus 5.5 auf Platz drei. Der Abstand zwischen den beiden beträgt jedoch etwa 1,5 Standardfehler. Argon liegt damit leicht vorn, der Vorsprung ist aber nicht eindeutig. Insgesamt gehören Gemini 4 Argon und Claude Opus 5.5 bei ihren allgemeinen Fähigkeiten zur selben Leistungsklasse – keines der beiden Modelle dominiert das andere.
💡 Hinweis zu Benchmarks: Die Ergebnisse verschiedener Testorganisationen können in unterschiedliche Richtungen weisen. Letztlich kommt es darauf an, wie die Modelle mit den eigenen Daten abschneiden. Die Plattform APIYI apiyi.com ermöglicht es, Claude, Gemini, GPT und weitere Modellfamilien über eine einheitliche Schnittstelle zu wechseln – ideal, um schnell einen eigenen kleinen Testsatz aufzubauen.
Die wichtigsten Unterschiede zwischen Gemini 4 Argon und Claude Opus 5.5
Abseits der Punktzahlen geben die unterschiedlichen Designansätze der beiden Modelle oft bessere Hinweise für die Auswahl als die Ergebnisse einzelner Benchmarks.
Zwei Ansätze für Aufgaben mit langen Abläufen
Gemini 4 Argon setzt darauf, bei einer einzelnen Ausgabe mehr Spielraum zu bieten. Dank des Ausgabelimits von 1M kann eine Anfrage mehrere hunderttausend Codezeilen oder einen extrem langen Bericht am Stück erzeugen. Google hat das Modell intern unter anderem genutzt, um mehr als 800.000 Zeilen C/C++ des Fuchsia-Zircon-Kernels nach Rust zu migrieren und 32.000 Zeilen SIMD-Code in libgav1 zu ersetzen. Dieser Ansatz reduziert die Aufteilung von Aufgaben und das Zusammenführen von Kontexten. Er eignet sich besonders für Szenarien, in denen „sehr viel Inhalt auf einmal“ erstellt werden soll.
Claude Opus 5.5 verfolgt einen anderen Ansatz: Der Schlussfolgerungsprozess soll besser steuerbar sein. Statt auf besonders große Ausgaben zu setzen, bietet das Modell fünf Effort-Stufen von „Low“ bis „Max“ sowie adaptives Denken, das immer aktiviert ist. So können Entwickler die Tiefe der Schlussfolgerungen und die Kosten an die jeweilige Aufgabe anpassen. In Verbindung mit Agenten-Frameworks wie Claude Code ist Opus 5.5 besonders stark darin, über mehrere Runden hinweg Werkzeuge aufzurufen, Ergebnisse zu prüfen und das Vorgehen anzupassen. Das erklärt auch seinen deutlichen Vorsprung bei interaktiven Terminal-Aufgaben wie Terminal-Bench.
Geschwindigkeit, Latenz und Stabilität
Laut den Tests von Artificial Analysis erreicht Opus 5.5 eine Ausgabegeschwindigkeit von etwa 92 Token/s – fast doppelt so viel wie Argon mit 48,9 Token/s. Für Programmierassistenten und Kundenservice-Agenten, die in Echtzeit reagieren müssen, wirkt sich dieser Unterschied unmittelbar auf die Nutzererfahrung aus. Argons Vorteil: Eine einzelne Anfrage kann mehr Arbeit erledigen. Das macht das Modell für Hintergrundaufgaben mit sehr großem Umfang geeignet, bei denen Echtzeitfähigkeit weniger wichtig ist.
Opus 5.5 läuft außerdem seit mehreren Wochen stabil auf verschiedenen Cloud-Plattformen. Für Kontingente, Ratenbegrenzungen und Fehlerbehandlung gibt es bereits eine ausgereifte Dokumentation. Argon befindet sich noch in der frühen Phase der breiteren Bereitstellung; Kontingente und Ratenbegrenzungen sind bislang nicht klar definiert. Bei Produktionssystemen mit hohen SLA-Anforderungen sollte dieser Punkt mindestens ebenso stark gewichtet werden wie die Benchmark-Ergebnisse.
Sicherheit und Schutz vor Prompt-Injection
Beide Unternehmen legen großen Wert auf die Sicherheit von Agenten. Google bezeichnet Argon als sein bisher widerstandsfähigstes Modell gegen indirekte Prompt-Injection und gibt an, dass es im Gray Swan IPI-Benchmark führend sei, hat jedoch keine konkreten Punktzahlen veröffentlicht. Analysen eines unabhängigen Sicherheitsanbieters zufolge weist Opus 5.5 im selben Benchmark gemeinsam mit Claude Fable 5.1 die niedrigste Erfolgsquote bei Prompt-Injection-Angriffen auf. Beide Modelle gehören beim Schutz vor Prompt-Injection also zur Spitzengruppe, und beide können für sich beanspruchen, führend zu sein. Agenten, die externe Webseiten, E-Mails oder Dokumente lesen müssen, brauchen unabhängig von der Modellwahl zusätzliche Schutzmaßnahmen: Dazu gehören getrennte Werkzeugberechtigungen und ein Mechanismus für manuelle Bestätigungen.
Gemini 4 Argon vs. Claude Opus 5.5: Kostenvergleich
Beide Modelle haben offiziell denselben Preis. Da sie für dieselbe Aufgabe jedoch unterschiedlich viele Tokens verbrauchen, können die tatsächlichen Kosten stark voneinander abweichen. Die folgende Tabelle zeigt die Kosten pro Aufgabe, gemessen von unabhängigen Drittanbietern.
| Kostenkennzahl | Gemini 4 Argon | Claude Opus 5.5 | Unterschied |
|---|---|---|---|
| Durchschnittliche Kosten pro AA-Aufgabe | 1,99 $ (Einführungspreis) | 5,98 $ | Argon kostet etwa ein Drittel |
| Gesamtkosten für den vollständigen AA-Index | 2.407 $ | 8.708 $ | Argon kostet etwa 28 % |
| Kosten pro Vals-Test | 15,68 $ | 32,14 $ | Argon kostet etwa 49 % |
| AA-Aufgabe zum offiziellen Preis | ca. 3,98 $ | 5,98 $ | Argon ist weiterhin etwa ein Drittel günstiger |
| Batch-Aufgaben | Noch nicht bekannt gegeben | Halbierter Preis: 2 $/10 $ | Für Opus gibt es einen festen Batch-Rabatt |
Selbst zum offiziellen Preis von 4 $/20 $ liegen die Kosten pro AA-Aufgabe bei Argon noch etwa ein Drittel unter denen von Opus 5.5. Ein Grund dafür ist, dass Opus 5.5 im Max-Modus länger nachdenkt. Wird der Effort-Wert für Opus 5.5 auf „medium“ oder „high“ gesetzt, sinken die Kosten deutlich. Darin zeigt sich der praktische Nutzen der fünf Effort-Stufen von Opus 5.5. Für Offline-Batch-Aufgaben bietet der fest zugesicherte halbierte Preis von Opus 5.5 außerdem mehr Planungssicherheit als die noch nicht bekannt gegebenen Batch-Preise von Argon.
Gemini 4 Argon vs. Claude Opus 5.5: Empfehlungen und Entscheidungshilfe nach Einsatzszenario
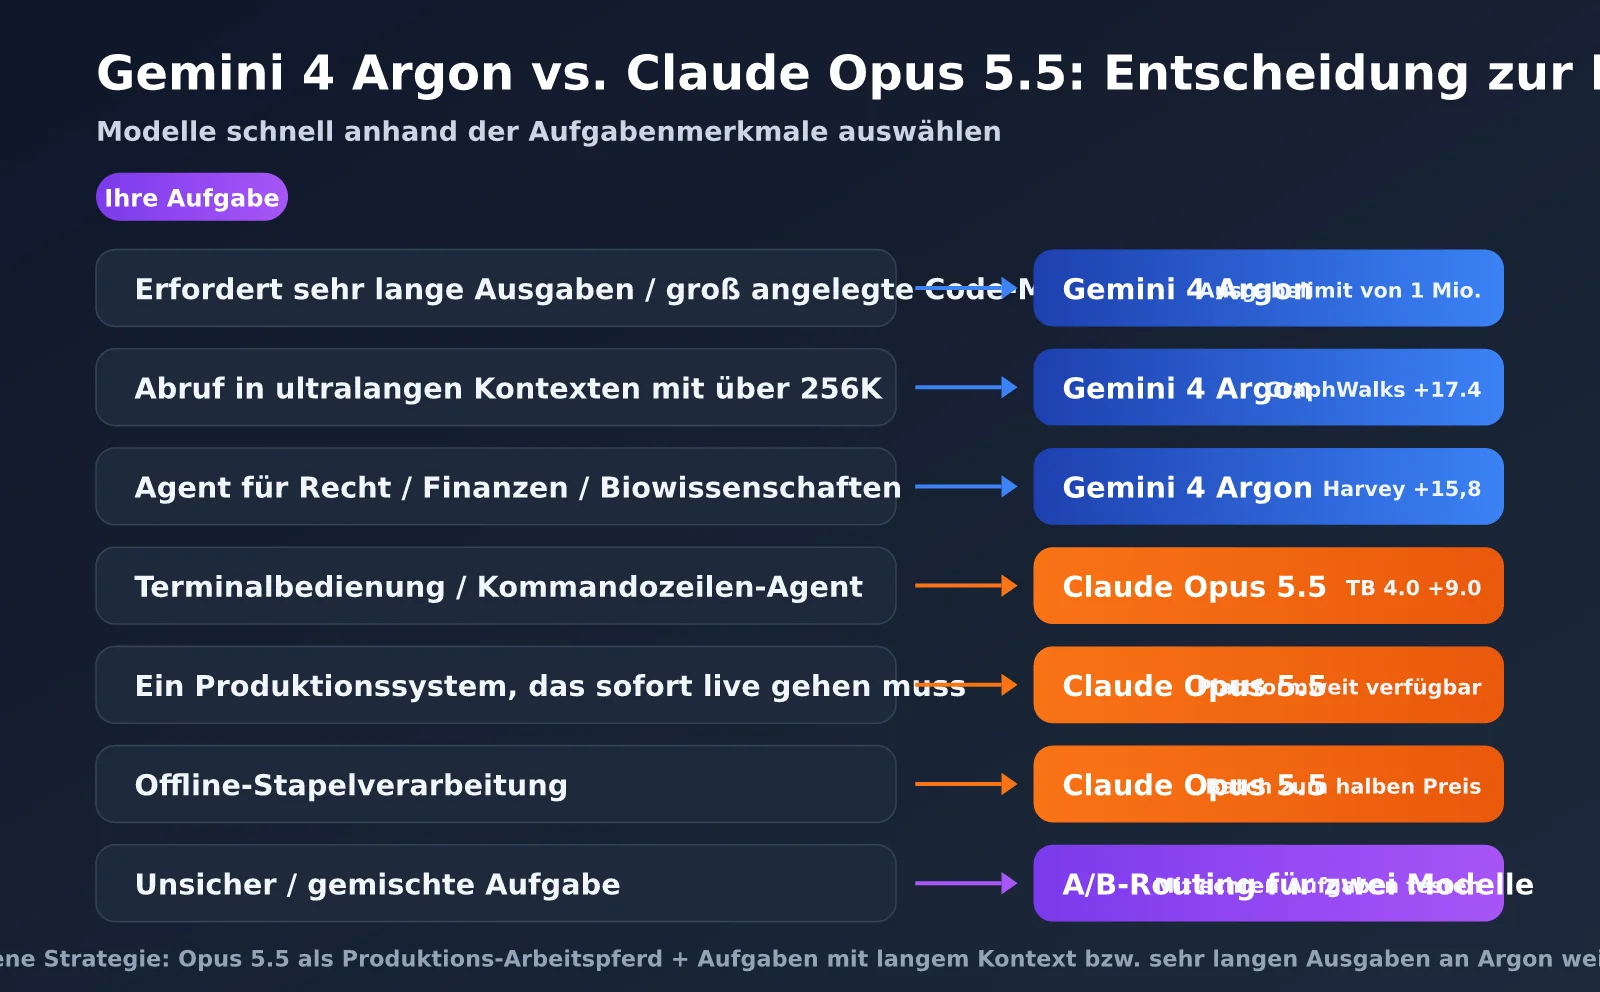
Unter Berücksichtigung der Google-Benchmarks, unabhängiger Tests, der Kosten und der Verfügbarkeit lassen sich für verschiedene Aufgaben recht klare Empfehlungen aussprechen:
| Einsatzszenario | Empfohlenes Modell | Hauptgrund |
|---|---|---|
| Umfangreiche Code-Migrationen / sehr lange Codegenerierung | Gemini 4 Argon | Ausgabegrenze von 1 Mio. Tokens, 3,7 Punkte Vorsprung bei DeepSWE |
| Suche in sehr langen Kontexten mit mehr als 256K Tokens | Gemini 4 Argon | 17,4 Punkte Vorsprung bei GraphWalks mit 256K–1M Tokens |
| Agenten für Recht und Finanzen | Gemini 4 Argon | 15,8 Punkte Vorsprung bei Harvey, 6,8 Punkte bei Finance Agent |
| Verständnis langer Videos und von Diagrammen | Gemini 4 Argon | Führend bei LVBench und Chartography |
| Terminalbedienung und Kommandozeilen-Agenten | Claude Opus 5.5 | 9 Punkte Vorsprung bei Terminal-Bench 4.0 |
| Wissenschaftliches Programmieren und komplexes Schlussfolgern | Claude Opus 5.5 | Führend bei SciCode, HLE und CritPt von AA |
| Produktivsysteme, die sofort live gehen müssen | Claude Opus 5.5 | Auf allen Plattformen verfügbar, Modell-ID und Kontingente klar definiert |
| Offline-Stapelverarbeitung | Claude Opus 5.5 | Der halbierte Batch-Preis von 2 $/10 $ ist bestätigt |
Gemini 4 Argon vs. Claude Opus 5.5: Praxisbeispiel für das Routing zwischen zwei Modellen
Für die meisten Teams ist es am sinnvollsten, nicht nur eines der beiden Modelle auszuwählen, sondern beide einzusetzen und Anfragen passend weiterzuleiten: Opus 5.5 zunächst als Hauptmodell im Produktivbetrieb verwenden und Aufgaben mit langen Kontexten oder sehr langen Ausgaben nach und nach an Argon übergeben. Das folgende Minimalbeispiel nutzt eine OpenAI-kompatible Schnittstelle.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

OPUS = "claude-opus-5-5"
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")  # 以平台实际上线 ID 为准

def pick_model(prompt_tokens: int, need_long_output: bool) -> str:
    # 超长上下文或超长输出走 Argon,其余默认 Opus 5.5
    return ARGON if prompt_tokens > 256_000 or need_long_output else OPUS

model = pick_model(prompt_tokens=12_000, need_long_output=False)
resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "排查这个 CI 流水线失败的原因"}],
)
print(model, resp.choices[0].message.content)
Vollständigen Code anzeigen: A/B-Vergleich beider Modelle mit derselben Aufgabe
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODELS = {
    "claude-opus-5-5": (4.0, 20.0),
    os.getenv("ARGON_MODEL", "gemini-4-argon"): (
        float(os.getenv("ARGON_PRICE_IN", "2")),
        float(os.getenv("ARGON_PRICE_OUT", "10")),
    ),
}

TASKS = [
    "阅读以下合同条款,列出对乙方不利的 5 处风险并给出修改建议:...",
    "把这段 Python 2 代码迁移到 Python 3.12 并补充类型注解:...",
    "根据以下日志定位服务超时的根因:...",
]


def run(model: str, task: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        max_tokens=16000,
        messages=[{"role": "user", "content": task}],
    )
    u = resp.usage
    price_in, price_out = MODELS[model]
    cost = (u.prompt_tokens * price_in + u.completion_tokens * price_out) / 1_000_000
    return {
        "model": model,
        "latency": round(time.time() - start, 1),
        "out_tokens": u.completion_tokens,
        "cost": round(cost, 4),
        "answer": resp.choices[0].message.content,
    }


if __name__ == "__main__":
    for task in TASKS:
        print("=" * 60, "\n任务:", task[:30])
        for model in MODELS:
            r = run(model, task)
            print(f"[{r['model']}] {r['latency']}s, 输出 {r['out_tokens']} token, ${r['cost']}")
Dieses A/B-Skript erfasst für jedes Modell die Antwortzeit, die Zahl der ausgegebenen Tokens und die Kosten für dieselbe Aufgabe. Am besten stellen Sie zunächst 30–50 realistische Aufgaben aus Ihrem Arbeitsalltag zusammen. Lassen Sie die Antworten anschließend manuell oder mithilfe eines Bewertungsmodells beurteilen und legen Sie dann fest, wie häufig Anfragen an die beiden Modelle weitergeleitet werden sollen.
🚀 Schnellstart: Registrieren Sie sich zunächst bei APIYI auf apiyi.com und sichern Sie sich ein Testguthaben. Damit können Sie das A/B-Skript mit Claude Opus 5.5 ausprobieren. Sobald Argon auf der Plattform offiziell verfügbar ist, müssen Sie nur den Modellnamen in der Umgebungsvariable ändern, um beide Modelle zu vergleichen.
Häufig gestellte Fragen
F1: Welches Modell ist tatsächlich leistungsfähiger – Gemini 4 Argon oder Claude Opus 5.5?
Eine eindeutige Antwort gibt es nicht. In Googles Benchmark-Tabelle liegt Argon in 14 Kategorien vorn, Opus 5.5 in 4. Im Intelligence Index von Artificial Analysis führt dagegen Opus 5.5 mit 57,6 zu 52,6. Beide Modelle spielen in derselben Liga: Argon punktet mit langen Kontexten, sehr langen Ausgaben und spezialisierten Agenten für Fachgebiete. Opus 5.5 überzeugt bei der Bedienung von Terminals, komplexen Schlussfolgerungen und dem Reifegrad seiner Engineering-Lösung.
F2: Sind die Daten in Googles Benchmark-Tabelle verlässlich?
Sie können als Orientierung dienen, sollten aber mit Vorsicht betrachtet werden. Es handelt sich um eine von Google veröffentlichte Tabelle. Bei einigen Benchmarks sind die Testbedingungen nicht gleichwertig, etwa bei der Anzahl der Eingabeframes in LVBench oder den Timeout-Einstellungen von Terminal-Bench Science. Im Vergleich zu den von Anthropic selbst veröffentlichten Daten fallen außerdem einige Ergebnisse von Opus 5.5 niedriger aus. Empfehlenswert ist, vor allem Ergebnisse mit einem Vorsprung von mehr als 5 Punkten zu berücksichtigen. Unterschiede von 1–2 Punkten kann man als Gleichstand betrachten.
F3: Kann ich beide Modelle bereits gleichzeitig nutzen?
Claude Opus 5.5 ist über die Claude API, Bedrock, Vertex AI und Foundry umfassend verfügbar. Gemini 4 Argon wird derzeit noch schrittweise bereitgestellt. Das Modell lässt sich bereits über Vertex AI abrufen, die kostenpflichtige API ist jedoch noch nicht flächendeckend verfügbar. Wir empfehlen, Opus 5.5 und die Gemini-Modellreihe zunächst über APIYI auf apiyi.com anzubinden. Sobald Argon offiziell verfügbar ist, können Sie für den Vergleich einfach den Parameter `model` ändern.
F4: Beide Modelle kosten gleich viel – welches ist im praktischen Einsatz günstiger?
Laut Messungen Dritter liegen die Kosten pro Aufgabe bei Argon ungefähr bei einem Drittel bis zur Hälfte der Kosten von Opus 5.5. Besonders während der Einführungsphase ist der Kostenvorteil deutlich. Bei Opus 5.5 lassen sich die Kosten jedoch erheblich senken, indem Sie eine niedrigere Effort-Stufe wählen und die Batch-Verarbeitung zum halben Preis nutzen. Am genauesten ist es, reale Aufgaben auszuführen, die tatsächliche Nutzung zu protokollieren und anschließend die Kosten zu berechnen. Über die einheitliche Abrechnung auf der APIYI-Plattform unter apiyi.com lassen sich die tatsächlichen Ausgaben für beide Modelle bequem vergleichen.
Fazit
Gemini 4 Argon und Claude Opus 5.5 liefern sich ein Kopf-an-Kopf-Rennen. Laut Googles Benchmark-Tabelle hat Argon deutliche Vorteile bei langen Kontexten, Agenten für Recht und Finanzen, den Lebenswissenschaften und multimodalen Aufgaben. Das Ausgabelimit von 1 Mio. Tokens ist zudem eine außergewöhnliche Stärke. In unabhängigen Benchmarks schneidet Opus 5.5 dagegen bei Schlussfolgerungen, wissenschaftlichem Programmieren und der Bedienung von Terminals besser ab. Außerdem ist es bereits auf allen Plattformen verfügbar und technisch ausgereift.
Unsere Empfehlung für den aktuellen Einsatz: Claude Opus 5.5 als Hauptmodell in der Produktion verwenden und Gemini 4 Argon schrittweise als Spezialmodell für Aufgaben mit langen Kontexten und sehr langen Ausgaben einführen. Vergleichen Sie beide Modelle außerdem kontinuierlich mit Ihren eigenen realen Aufgaben. Sobald die kostenpflichtige Argon-API umfassend verfügbar ist und weitere unabhängige Benchmarks vorliegen, können Sie die Modellverteilung anhand der Daten anpassen.
Wir empfehlen, die Claude- und Gemini-Modellreihen zentral über die APIYI-Plattform unter apiyi.com anzubinden. So können Sie mehrere Modelle über eine Schnittstelle und eine Abrechnung vergleichen und Anfragen weiterleiten – und Ihre Modellwahl auf echte Daten stützen.
Quellen:
- Offizieller Google-Blogbeitrag zur Veröffentlichung von Gemini 4 Argon: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Informationen zur Veröffentlichung von Claude Opus 5.5 durch Anthropic: anthropic.com/news
- Intelligence Index und Modellvergleiche von Artificial Analysis: artificialanalysis.ai
- Modell-Benchmark-Rangliste von Vals AI: vals.ai
- Zusammenstellung der vollständigen Benchmark-Tabelle für Gemini 4 Argon (ToolScout): toolscout.ai/news/gemini-4-argon-benchmarks
Autor: APIYI Team | Wir verfolgen kontinuierlich die neuesten Benchmarks und die Auswahl großer Sprachmodelle. Weitere Informationen zur Anbindung von Modellen finden Sie auf APIYI unter apiyi.com.