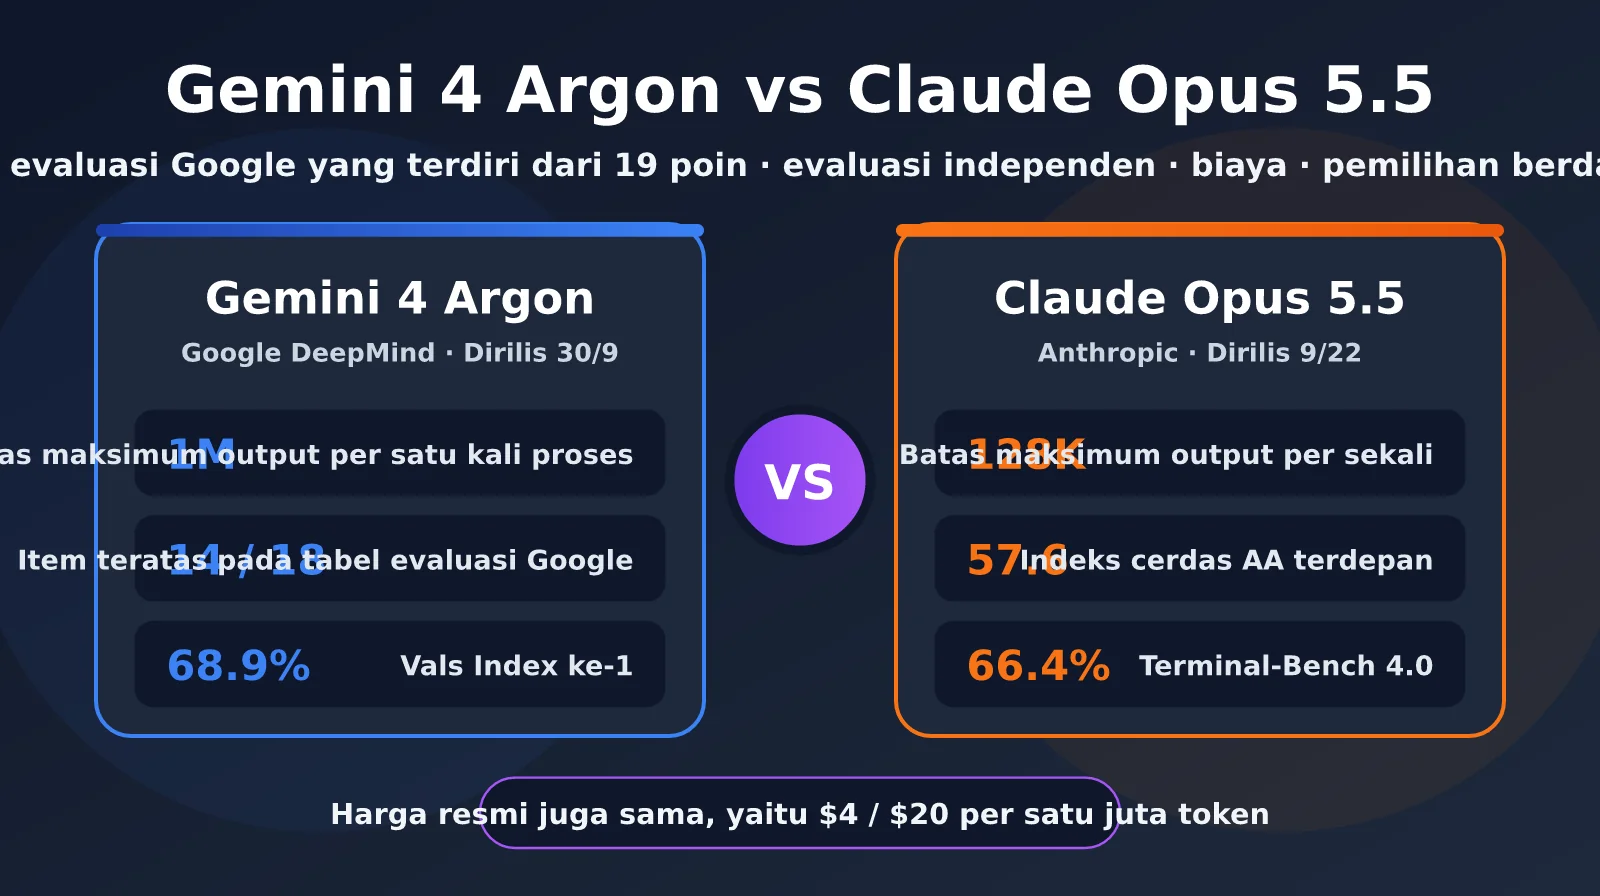
Pada akhir September hingga awal Oktober, model bahasa besar terdepan mengalami pembaruan besar-besaran. Anthropic merilis Claude Opus 5.5 pada 22 September, lalu hanya 8 hari kemudian Google meluncurkan Gemini 4 Argon. Keduanya memiliki fokus yang sangat mirip: penalaran berantai panjang, pemrograman berbasis agen, dan pekerjaan berbasis pengetahuan untuk perusahaan. Harga resminya pun sama, yaitu $4 per satu juta token input dan $20 per satu juta token output. Karena itu, Gemini 4 Argon vs Claude Opus 5.5 menjadi salah satu pertanyaan yang paling sering diajukan developer saat memilih model.
Informasi publik yang tersedia saat ini masih terbatas. Data primer paling lengkap adalah tabel perbandingan 19 tolok ukur yang disertakan Google dalam dokumen evaluasi Argon, termasuk hasil Claude Opus 5.5. Artikel ini mengulas setiap bagian tabel tersebut, lalu melengkapinya dengan evaluasi independen dari pihak ketiga seperti Artificial Analysis dan Vals, serta faktor teknis seperti harga, batas output, dan ketersediaan. Tujuannya membantu Anda menentukan skenario yang paling cocok untuk masing-masing model.
Manfaat utama: Setelah membaca artikel ini, Anda akan memahami angka mana dalam tabel evaluasi Google yang dapat diandalkan dan mana yang perlu disikapi dengan hati-hati. Anda juga bisa memilih antara Gemini 4 Argon dan Claude Opus 5.5 sesuai kebutuhan bisnis.
Perbandingan Spesifikasi Dasar Gemini 4 Argon vs Claude Opus 5.5
Sebelum membahas skor evaluasi, mari bandingkan dulu spesifikasi dasar kedua model. Harga resminya sama persis. Perbedaan utamanya terletak pada batas output, ketersediaan, dan harga perkenalan.
| Aspek perbandingan | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Tanggal rilis | 30 September 2026 | 22 September 2026 |
| Ketersediaan saat ini | Program Fairwind + peluncuran bertahap di Vertex AI; API berbayar belum tersedia secara luas | Tersedia secara luas: Claude API, Bedrock, Vertex AI, Foundry |
| ID model | Belum diumumkan secara resmi | claude-opus-5-5 |
| Harga (input/output) | Harga perkenalan $2/$10, harga resmi $4/$20 | $4/$20 |
| Pembacaan cache | Diskon 95% dari harga input (mulai dari $0,10) | $0,20 |
| Harga Batch | Belum diumumkan | $2/$10 |
| Jendela konteks | Belum diumumkan secara resmi (pihak ketiga menyebut 1M) | 1M, tanpa biaya tambahan untuk konteks panjang |
| Batas output per permintaan | 1M token | 128K token |
| Kontrol penalaran | Tingkat penalaran seperti High | Lima tingkat effort, dari low hingga max, dengan pemikiran adaptif |
Dari tabel spesifikasi, keunggulan teknis terbesar Argon adalah batas output 1M, sekitar 8 kali lipat dari Opus 5.5. Ini cocok untuk pembuatan kode yang sangat panjang dan tugas migrasi berskala besar. Keunggulan utama Opus 5.5 adalah sudah bisa digunakan secara stabil saat ini: ID modelnya jelas, tersedia di semua platform cloud utama, serta menawarkan Batch dengan harga setengah dan lima tingkat kontrol effort. Dari sisi kesiapan untuk penggunaan rekayasa, Opus 5.5 jelas lebih matang.
🎯 Saran perbandingan: Harga resmi kedua model sama, jadi pemilihan terutama bergantung pada jenis tugas. Kami menyarankan Anda menggunakan APIYI apiyi.com untuk memanggil Claude Opus 5.5 dan model Gemini melalui antarmuka yang sama, lalu mengujinya secara berdampingan dengan tugas nyata Anda. Cara ini lebih bisa diandalkan daripada sekadar melihat peringkat.
Gemini 4 Argon vs Claude Opus 5.5: Bedah Tabel Evaluasi Google
Berikut data perbandingan yang dipublikasikan Google dalam dokumen evaluasi Argon. Di sini hanya dua kolom—Argon dan Opus 5.5—yang ditampilkan, lalu datanya dikelompokkan berdasarkan kategori. Perlu diingat, ini adalah tabel dari pihak vendor: skor Argon diperoleh Google sendiri, sedangkan sebagian besar skor Opus 5.5 berasal dari papan peringkat publik atau system card Anthropic. Beberapa tolok ukur juga diuji ulang oleh Google.
| Kategori | Tolok ukur | Gemini 4 Argon | Claude Opus 5.5 | Unggul |
|---|---|---|---|---|
| Pekerjaan pengetahuan | Vals Index | 68.9% | 67.0% | Argon +1.9 |
| Pekerjaan pengetahuan | AutomationBench | 51.3% | 42.5% | Argon +8.8 |
| Pekerjaan pengetahuan | Vals Finance Agent v2 | 65.4% | 58.6% | Argon +6.8 |
| Pekerjaan pengetahuan | Harvey Legal Agent | 19.6% | 3.8% | Argon +15.8 |
| Pemrograman agen | DeepSWE v1.1 | 77.9% | 74.2% | Argon +3.7 |
| Pemrograman agen | FrontierSWE v2 | 55.0% | 62.3% | Opus +7.3 |
| Pemrograman agen | Vibe Code Bench | 91.9% | 90.3% | Argon +1.6 |
| Pemrograman agen | Terminal-Bench 4.0 | 57.4% | 66.4% | Opus +9.0 |
| Rekayasa ML | PostTrainBench | 45.3% | 49.3% | Opus +4.0 |
| Sains dan matematika | Terminal-Bench Science 0.1 | 57.6% | 63.3% | Opus +5.7 |
| Sains dan matematika | LABBench 2 | 88.8% | 73.1% | Argon +15.7 |
| Sains dan matematika | RiemannBench | 76.0% | 69.6% | Argon +6.4 |
| Konteks panjang | GraphWalks ≤128K | 99.7% | 90.6% | Argon +9.1 |
| Konteks panjang | GraphWalks 256K–1M | 84.2% | 66.8% | Argon +17.4 |
| Pengoperasian komputer | Agent’s Last Exam | 39.5% | 38.2% | Argon +1.3 |
| Multimodal | Chartography | 71.6% | 66.3% | Argon +5.3 |
| Multimodal | LVBench video panjang | 91.7% | 83.7% | Argon +8.0 |
| Keamanan siber | CWE-bench v1 | 68.0% | 67.0% | Argon +1.0 |
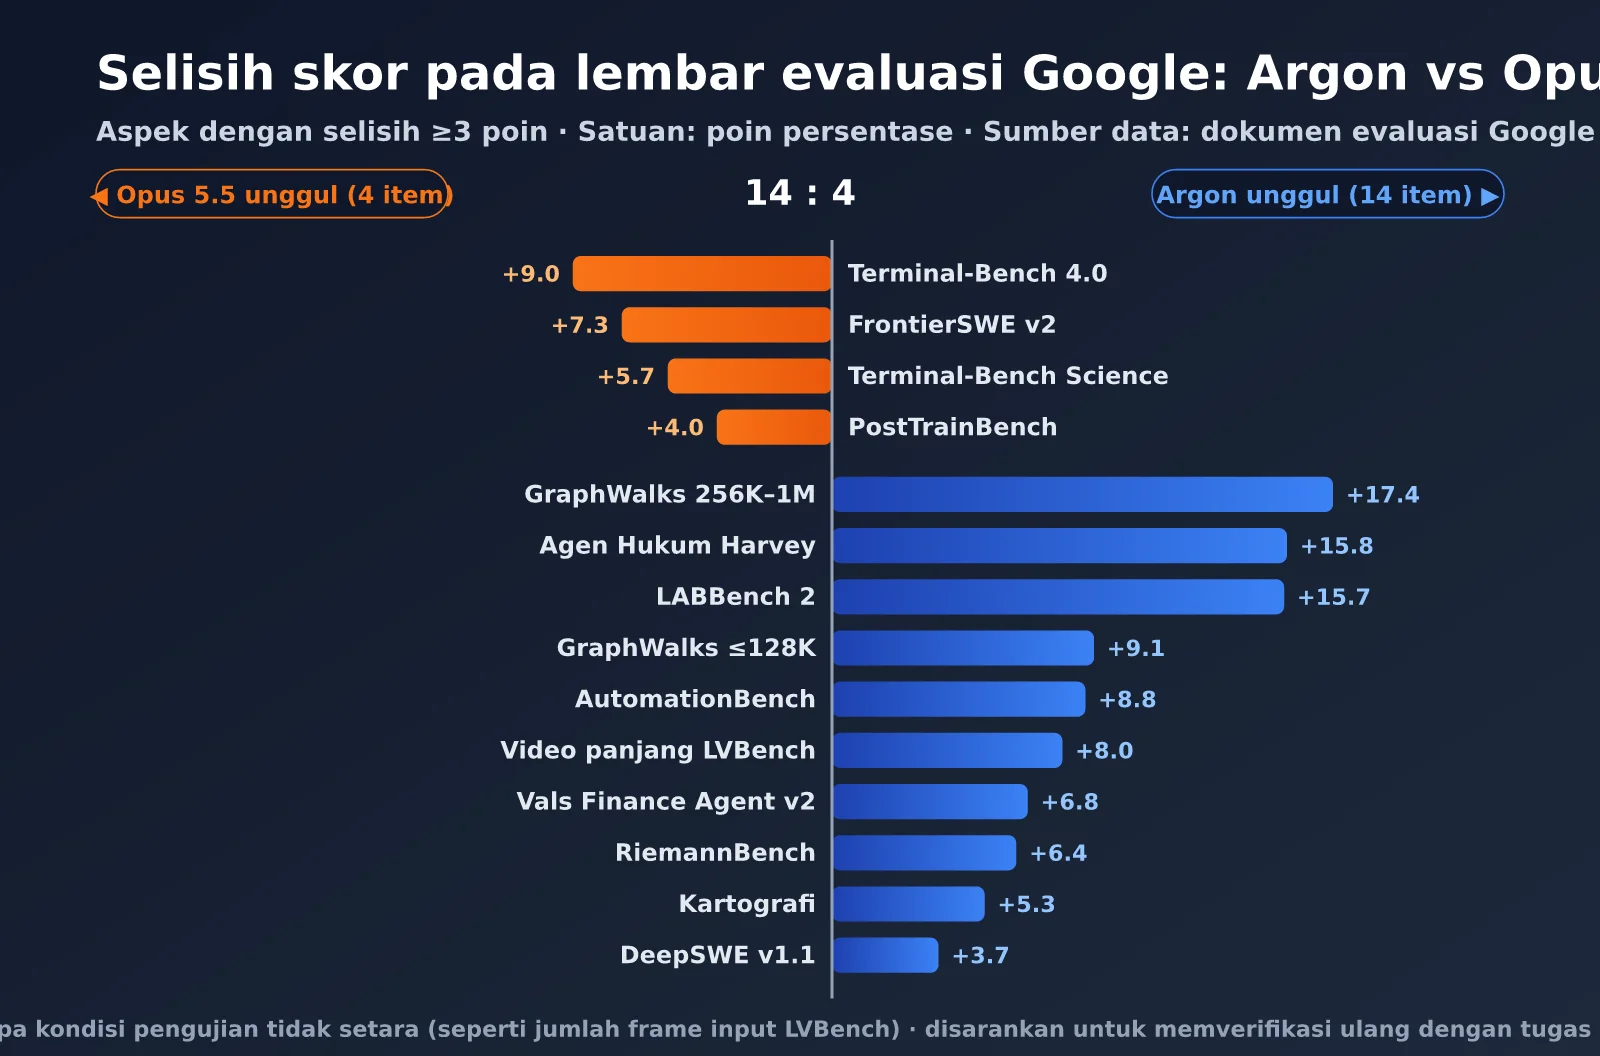
Dari 18 tolok ukur yang memiliki skor untuk kedua model, Argon unggul di 14 tolok ukur, sementara Opus 5.5 unggul di 4 tolok ukur. Kemenangan Opus 5.5 cukup konsisten: FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench, dan Terminal-Bench Science. Semua tolok ukur ini menguji tugas yang membutuhkan operasi berulang dalam lingkungan terminal nyata dalam waktu lama. Keunggulan Argon yang paling besar terlihat pada konteks panjang (unggul 17.4 poin di GraphWalks 256K–1M), agen hukum, dan ilmu hayati (LABBench 2).
Hal yang perlu dicermati dalam tabel evaluasi Google
Tabel evaluasi dari vendor secara alami cenderung menguntungkan model mereka sendiri. Catatan kaki tabel ini juga memuat beberapa detail penting. Memahami detail ini akan membantu kita menafsirkan selisih skor Gemini 4 Argon vs Claude Opus 5.5 dengan tepat:
- Jumlah frame input LVBench berbeda: Argon memproses video lengkap dengan kecepatan 1 frame per detik, sedangkan Opus 5.5 hanya bisa menerima 600 frame karena batasan API. Jadi, sebagian selisih skor video panjang berasal dari kondisi input yang tidak setara.
- Batas waktu Terminal-Bench Science dilonggarkan: Batas waktu verifikasi untuk Argon ditetapkan 6 kali lipat dari nilai default. Meski begitu, Argon tetap tertinggal 5.7 poin dari Opus 5.5.
- Kerangka pengujian DeepSWE berbeda: Argon diuji sendiri menggunakan kerangka mini-swe agent, sedangkan skor Claude diambil dari system card Anthropic. Artinya, kerangka pengujiannya tidak sama.
- Ada perbedaan dengan data yang dilaporkan Anthropic sendiri: Dalam skor Opus 5.5 yang dipublikasikan Anthropic, AutomationBench mencapai 40.0%, Chartography dengan alat mencapai 89.0%, dan OSWorld 2.0 mencapai 81.8%. Sementara itu, tabel Google hanya mencantumkan 66.3% untuk Chartography dan mengosongkan kolom OSWorld.
Dengan kata lain, ketika kondisi pengujian diselaraskan, selisih kedua model lebih kecil daripada yang terlihat di tabel. Keunggulan Argon pada konteks panjang, hukum, dan ilmu hayati cukup besar sehingga lebih meyakinkan. Sementara itu, hasil pada Vals Index, Vibe Code, CWE-bench, dan tolok ukur lain yang selisihnya hanya 1–2 poin pada dasarnya bisa dianggap imbang.
Hasil Evaluasi Independen Gemini 4 Argon vs Claude Opus 5.5
Kesimpulan dari evaluasi independen pihak ketiga tidak sejalan dengan tabel evaluasi Google. Bahkan, arah hasilnya berlawanan pada indeks kecerdasan keseluruhan. Tabel di bawah merangkum data publik dari Artificial Analysis (AA) dan Vals.
| Aspek evaluasi independen | Gemini 4 Argon | Claude Opus 5.5 | Unggul |
|---|---|---|---|
| Indeks Kecerdasan AA v4.3 | 52.6 | 57.6 | Opus +5.0 |
| Peringkat Vals Index | 68.90% (peringkat 1) | 66.97% (peringkat 3) | Argon +1.9 |
| AA Terminal-Bench 4.0 | 57.1% | 59.6% | Opus +2.5 |
| AA Humanity’s Last Exam | 57.1% | 61.4% | Opus +4.3 |
| AA SciCode | 61.8% | 66.9% | Opus +5.1 |
| Penalaran konteks panjang AA | 79.7% | 84.7% | Opus +5.0 |
| AA GDPval (Elo) | 1611 | 1846 | Opus +235 |
| AA AutomationBench | 77.5% | 69.5% | Argon +8.0 |
| Kecepatan output AA | 48.9 token/s | 92.2 token/s | Opus sekitar 1,9 kali lebih cepat |
Dalam pengujian AA, Opus 5.5 unggul di semua aspek, mulai dari penalaran, pemrograman ilmiah, penalaran konteks panjang, hingga tugas profesional GDPval. Argon hanya unggul jelas di AutomationBench untuk otomatisasi bisnis. Namun, perbandingan AA ini tidak sepenuhnya adil: Argon hanya diuji pada tingkat High, sedangkan Opus 5.5 menggunakan tingkat Max dengan penalaran adaptif. Sebagian selisihnya mungkin berasal dari pengaturan intensitas penalaran, bukan semata-mata perbedaan kemampuan.
Sementara itu, Vals Index menempatkan Argon di posisi pertama dari 41 model dan Opus 5.5 di posisi ketiga. Namun, selisih keduanya hanya sekitar 1,5 galat baku. Artinya, Argon sedikit lebih unggul, tetapi keunggulan tersebut belum pasti. Secara keseluruhan, Gemini 4 Argon dan Claude Opus 5.5 berada di kelas yang sama dalam hal kemampuan keseluruhan; tidak ada yang benar-benar mengungguli yang lain secara telak.
💡 Tips evaluasi: Kesimpulan dari berbagai lembaga evaluasi bisa saja berlawanan. Pada akhirnya, data Anda sendiri yang paling penting. Platform APIYI apiyi.com mendukung peralihan antara model Claude, Gemini, GPT, dan seri lainnya melalui satu antarmuka terpadu, sehingga cocok untuk membuat set evaluasi kecil sendiri dengan cepat.
Memahami Perbedaan Utama Gemini 4 Argon vs Claude Opus 5.5
Jika mengesampingkan skor, perbedaan pendekatan desain kedua model ini justru lebih berguna untuk menentukan pilihan dibandingkan selisih skor pada satu tolok ukur.
Dua pendekatan untuk tugas berantai panjang
Pendekatan Gemini 4 Argon adalah memperbesar ruang untuk satu kali output. Batas output 1M memungkinkan model menghasilkan ratusan ribu baris kode atau laporan yang sangat panjang dalam satu permintaan. Google menggunakannya secara internal untuk memigrasikan lebih dari 800 ribu baris kode C/C++ pada kernel Fuchsia Zircon ke Rust, serta mengganti 32 ribu baris kode SIMD di libgav1, dan tugas-tugas lainnya. Desain ini mengurangi kebutuhan untuk memecah tugas dan menyambungkan konteks, sehingga sangat cocok untuk skenario yang membutuhkan “produksi konten dalam jumlah besar sekaligus”.
Pendekatan Claude Opus 5.5 adalah membuat proses penalaran lebih terkendali. Model ini tidak mengejar output berukuran sangat besar. Sebagai gantinya, tersedia lima tingkat effort, dari low hingga max, serta fitur berpikir adaptif yang selalu aktif. Dengan begitu, developer dapat menyesuaikan kedalaman penalaran dan biaya sesuai tingkat kesulitan tugas. Jika dipadukan dengan kerangka kerja agen seperti Claude Code, Opus 5.5 lebih piawai melakukan pemanggilan alat berulang kali dalam beberapa putaran—menjalankan, mengamati, lalu memperbaiki. Ini juga menjelaskan keunggulannya yang cukup besar pada tugas interaksi terminal seperti Terminal-Bench.
Kecepatan, latensi, dan stabilitas
Pengujian Artificial Analysis menunjukkan bahwa kecepatan output Opus 5.5 sekitar 92 token/s, hampir dua kali lipat kecepatan Argon yang mencapai 48,9 token/s. Bagi asisten pemrograman dan agen layanan pelanggan yang membutuhkan interaksi real-time, selisih ini akan langsung terasa oleh pengguna. Keunggulan Argon adalah kemampuannya menyelesaikan lebih banyak pekerjaan dalam satu permintaan. Model ini cocok untuk pekerjaan latar belakang dengan volume tugas yang sangat besar, tetapi tidak terlalu menuntut respons real-time.
Selain itu, Opus 5.5 sudah berjalan stabil di beberapa platform cloud selama beberapa minggu. Dokumentasi terkait kuota, pembatasan laju, dan penanganan kesalahan juga sudah matang. Sementara itu, Argon masih berada pada tahap awal perluasan akses, dan kebijakan kuota serta pembatasan lajunya belum jelas. Untuk sistem produksi dengan tuntutan SLA yang tinggi, faktor ini semestinya memiliki bobot yang tidak kalah penting dari skor tolok ukur.
Keamanan dan perlindungan terhadap injeksi petunjuk
Kedua perusahaan sama-sama memprioritaskan keamanan agen. Google menyebut Argon sebagai model mereka yang paling tangguh sejauh ini dalam menghadapi injeksi petunjuk tidak langsung. Argon juga memimpin dalam tolok ukur Gray Swan IPI, tetapi Google tidak mengungkapkan skor spesifiknya. Di sisi lain, analisis dari vendor keamanan pihak ketiga menunjukkan bahwa Opus 5.5 memiliki tingkat keberhasilan injeksi terendah bersama Claude Fable 5.1 pada tolok ukur yang sama. Dengan kata lain, kedua model berada di jajaran teratas dalam perlindungan terhadap injeksi petunjuk, dan masing-masing bisa mengklaim keunggulan. Untuk agen yang perlu membaca halaman web, email, atau dokumen dari sumber eksternal, apa pun model yang dipilih, izin akses alat tetap perlu diisolasi dan mekanisme konfirmasi manual tetap perlu diterapkan.
Perbandingan Biaya Gemini 4 Argon vs Claude Opus 5.5
Harga resmi keduanya sama, tetapi jumlah token yang digunakan untuk tugas yang sama berbeda. Akibatnya, biaya sebenarnya bisa jauh berbeda. Tabel berikut menunjukkan biaya per tugas berdasarkan pengujian langsung oleh lembaga pihak ketiga.
| Dasar perhitungan biaya | Gemini 4 Argon | Claude Opus 5.5 | Selisih |
|---|---|---|---|
| Biaya rata-rata per tugas AA | $1.99 (harga perkenalan) | $5.98 | Argon sekitar 1/3 biaya Opus |
| Total biaya AA untuk menjalankan seluruh indeks | $2,407 | $8,708 | Argon sekitar 28% dari biaya Opus |
| Biaya per pengujian Vals | $15.68 | $32.14 | Argon sekitar 49% dari biaya Opus |
| Biaya per tugas AA berdasarkan harga resmi | Sekitar $3.98 | $5.98 | Argon tetap sekitar 1/3 lebih murah |
| Tugas Batch | Belum diumumkan | Setengah harga: $2/$10 | Opus memiliki diskon Batch yang sudah dipastikan |
Bahkan jika dihitung berdasarkan harga resmi $4/$20, biaya per tugas Argon dalam pengujian AA masih sekitar sepertiga lebih rendah daripada Opus 5.5. Salah satu penyebabnya adalah proses penalaran Opus 5.5 yang lebih panjang pada tingkat Max. Jika effort Opus 5.5 diatur ke medium atau high, biayanya akan turun secara signifikan. Di sinilah manfaat nyata dari lima tingkat kontrol effort Opus 5.5 terlihat. Selain itu, untuk tugas pemrosesan batch offline, diskon setengah harga Batch Opus 5.5 yang sudah dipastikan saat ini memberikan kepastian lebih besar daripada harga batch Argon yang belum diumumkan.
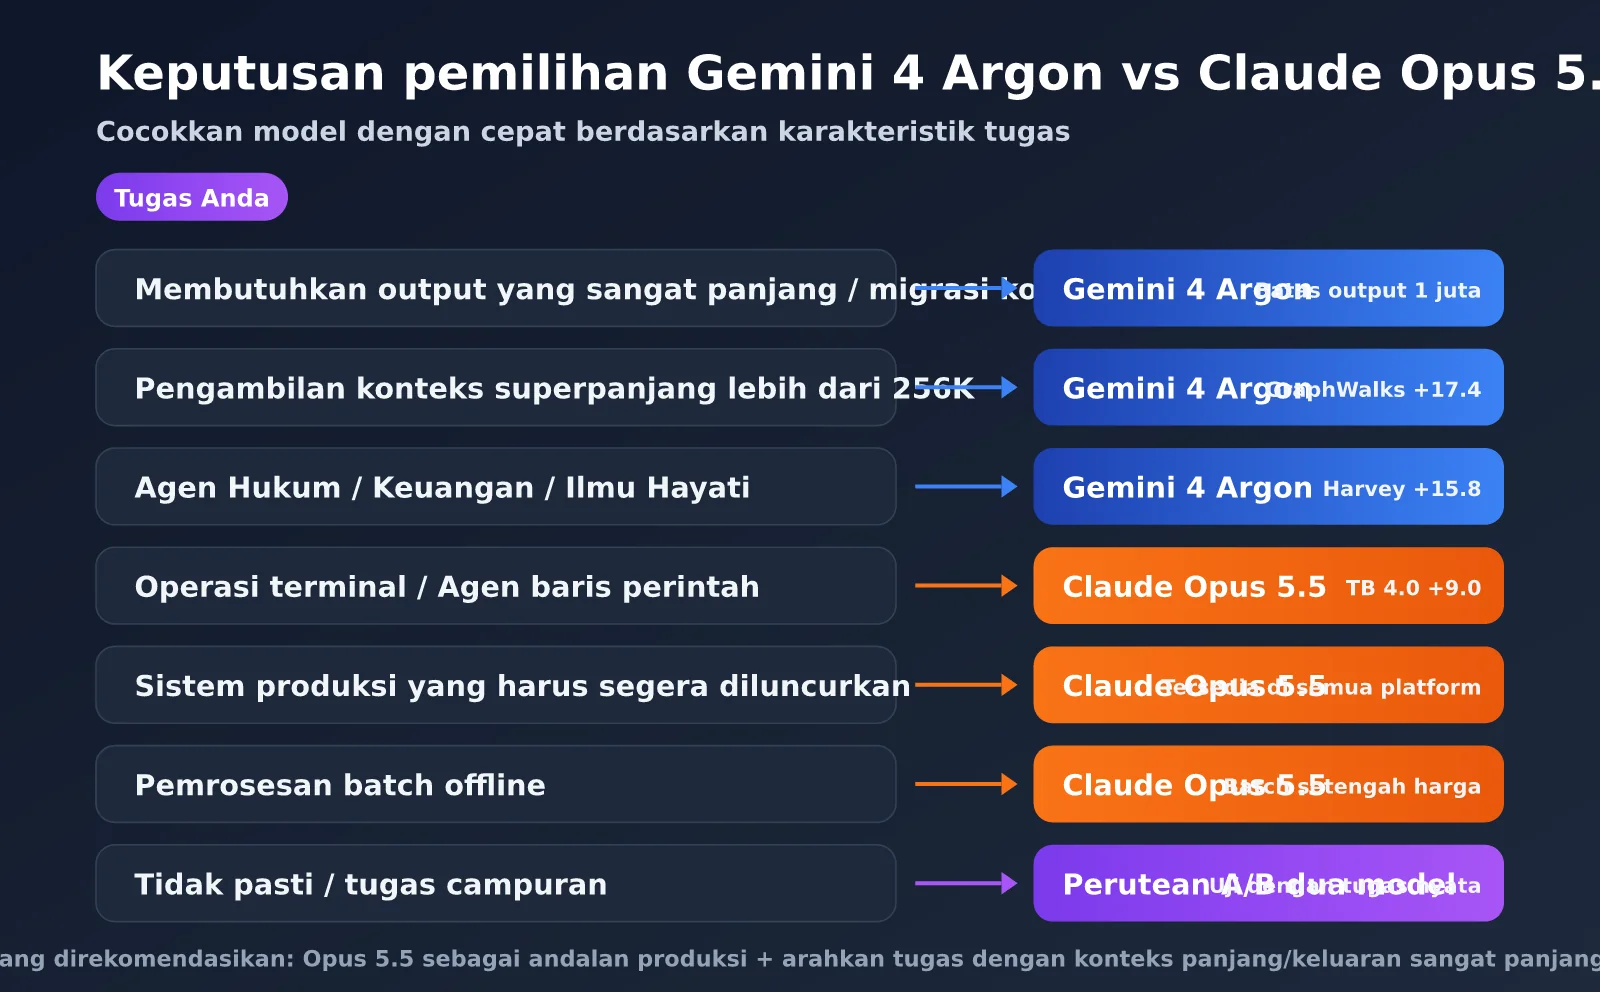
Rekomendasi Skenario dan Panduan Memilih Gemini 4 Argon vs Claude Opus 5.5
Berdasarkan evaluasi Google, pengujian independen, biaya, dan ketersediaan, rekomendasi untuk berbagai skenario tugas bisa dirangkum sebagai berikut:
| Skenario penggunaan | Model yang direkomendasikan | Alasan utama |
|---|---|---|
| Migrasi kode skala besar / pembuatan kode sangat panjang | Gemini 4 Argon | Batas output 1M, unggul 3,7 poin di DeepSWE |
| Pencarian dalam konteks sangat panjang di atas 256K | Gemini 4 Argon | Unggul 17,4 poin di GraphWalks 256K–1M |
| Agent profesional untuk bidang hukum dan keuangan | Gemini 4 Argon | Unggul 15,8 poin di Harvey dan 6,8 poin di Finance Agent |
| Pemahaman video panjang dan diagram | Gemini 4 Argon | Unggul di LVBench dan Chartography |
| Operasi terminal dan agent baris perintah | Claude Opus 5.5 | Unggul 9 poin di Terminal-Bench 4.0 |
| Pemrograman untuk riset ilmiah dan penalaran kompleks | Claude Opus 5.5 | Unggul di SciCode, HLE, dan CritPt pada AA |
| Sistem produksi yang harus segera diluncurkan | Claude Opus 5.5 | Tersedia di semua platform, ID model dan kuotanya jelas |
| Pemrosesan batch offline | Claude Opus 5.5 | Harga Batch setengah tarif, $2/$10, sudah dipastikan |
Praktik Perutean Dua Model: Gemini 4 Argon vs Claude Opus 5.5
Bagi sebagian besar tim, strategi yang paling praktis bukan memilih salah satu, melainkan menggunakan perutean dua model: jadikan Opus 5.5 sebagai andalan produksi, lalu secara bertahap arahkan tugas yang cocok untuk Argon—seperti tugas dengan konteks panjang dan output sangat panjang—ke Argon. Berikut contoh sederhana menggunakan antarmuka yang kompatibel dengan OpenAI.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI
)

OPUS = "claude-opus-5-5"
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")  # Gunakan ID yang benar-benar tersedia di platform

def pick_model(prompt_tokens: int, need_long_output: bool) -> str:
    # Arahkan konteks atau output yang sangat panjang ke Argon; selain itu, gunakan Opus 5.5 secara default
    return ARGON if prompt_tokens > 256_000 or need_long_output else OPUS

model = pick_model(prompt_tokens=12_000, need_long_output=False)
resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "排查这个 CI 流水线失败的原因"}],
)
print(model, resp.choices[0].message.content)
Lihat kode lengkap: Perbandingan A/B dua model untuk tugas yang sama
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODELS = {
    "claude-opus-5-5": (4.0, 20.0),
    os.getenv("ARGON_MODEL", "gemini-4-argon"): (
        float(os.getenv("ARGON_PRICE_IN", "2")),
        float(os.getenv("ARGON_PRICE_OUT", "10")),
    ),
}

TASKS = [
    "阅读以下合同条款,列出对乙方不利的 5 处风险并给出修改建议:...",
    "把这段 Python 2 代码迁移到 Python 3.12 并补充类型注解:...",
    "根据以下日志定位服务超时的根因:...",
]


def run(model: str, task: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        max_tokens=16000,
        messages=[{"role": "user", "content": task}],
    )
    u = resp.usage
    price_in, price_out = MODELS[model]
    cost = (u.prompt_tokens * price_in + u.completion_tokens * price_out) / 1_000_000
    return {
        "model": model,
        "latency": round(time.time() - start, 1),
        "out_tokens": u.completion_tokens,
        "cost": round(cost, 4),
        "answer": resp.choices[0].message.content,
    }


if __name__ == "__main__":
    for task in TASKS:
        print("=" * 60, "\n任务:", task[:30])
        for model in MODELS:
            r = run(model, task)
            print(f"[{r['model']}] {r['latency']}s, 输出 {r['out_tokens']} token, ${r['cost']}")
Skrip A/B ini mencatat latensi, token output, dan biaya setiap model untuk tugas yang sama. Sebaiknya siapkan 30–50 tugas nyata yang mewakili kebutuhan bisnis Anda, lalu beri penilaian secara manual atau menggunakan model penilai sebelum menentukan proporsi perutean kedua model.
🚀 Mulai cepat: Anda bisa mendaftar di APIYI apiyi.com untuk mendapatkan kredit uji coba, lalu menjalankan skrip A/B di atas dengan Claude Opus 5.5. Setelah Argon resmi tersedia di platform, Anda cukup mengubah nama model di variabel lingkungan untuk mulai membandingkannya.
Pertanyaan Umum
Q1: Mana yang lebih unggul, Gemini 4 Argon atau Claude Opus 5.5?
Tidak ada jawaban mutlak. Dalam tabel evaluasi Google, Argon unggul di 14 kategori, sedangkan Opus 5.5 unggul di 4 kategori. Namun, dalam Indeks Kecerdasan gabungan Artificial Analysis, Opus 5.5 memimpin dengan skor 57,6 dibandingkan 52,6. Keduanya berada di kelas yang sama: Argon unggul dalam konteks panjang, keluaran sangat panjang, dan Agent untuk bidang khusus; sementara Opus 5.5 unggul dalam operasi terminal, penalaran kompleks, dan kematangan rekayasa.
Q2: Apakah data dalam tabel evaluasi Google bisa dipercaya?
Data tersebut bisa dijadikan acuan, tetapi perlu disikapi dengan hati-hati. Tabel ini diterbitkan oleh Google, dan kondisi pengujian pada beberapa tolok ukur tidak sepenuhnya setara, misalnya jumlah frame masukan di LVBench dan pengaturan batas waktu di Terminal-Bench Science. Beberapa skor Opus 5.5 juga lebih rendah dibandingkan data yang dilaporkan Anthropic sendiri. Sebaiknya, fokuskan perhatian pada kategori dengan selisih keunggulan lebih dari 5 poin. Selisih 1–2 poin bisa dianggap imbang.
Q3: Apakah kedua model sudah bisa digunakan sekaligus?
Claude Opus 5.5 sudah tersedia secara luas melalui Claude API, Bedrock, Vertex AI, dan Foundry. Gemini 4 Argon masih diluncurkan secara bertahap. Model ini sudah bisa diakses melalui Vertex AI, tetapi API berbayarnya belum tersedia secara luas. Anda bisa menggunakan APIYI di apiyi.com untuk mulai mengakses Opus 5.5 dan model Gemini. Setelah Argon resmi tersedia, Anda bisa langsung mengganti parameter `model` untuk membandingkannya.
Q4: Harganya sama, model mana yang lebih hemat dalam penggunaan nyata?
Berdasarkan pengujian pihak ketiga, biaya Argon untuk setiap tugas sekitar sepertiga hingga setengah dari biaya Opus 5.5, dengan keunggulan yang lebih terasa selama periode uji coba. Namun, biaya Opus 5.5 bisa ditekan cukup banyak dengan menurunkan tingkat effort dan menggunakan Batch yang menawarkan harga setengah. Cara paling akurat adalah mencatat `usage` dari tugas nyata lalu menghitung biayanya. Tagihan terpadu di platform APIYI apiyi.com memudahkan perbandingan biaya aktual kedua model secara langsung.
Kesimpulan
Gemini 4 Argon vs Claude Opus 5.5 adalah persaingan yang seimbang. Berdasarkan tabel evaluasi Google, Argon unggul dalam konteks panjang, Agent untuk bidang hukum dan keuangan, ilmu hayati, serta multimodal. Batas keluaran 1 juta token juga menjadikannya unggul dalam kemampuan yang sangat spesifik ini. Sementara itu, evaluasi independen menunjukkan bahwa Opus 5.5 lebih unggul dalam penalaran, pemrograman untuk penelitian ilmiah, dan operasi terminal. Model ini juga sudah tersedia di semua platform dan lebih matang dari sisi rekayasa.
Strategi yang disarankan saat ini: gunakan Claude Opus 5.5 sebagai model utama di lingkungan produksi, lalu mulai terapkan Gemini 4 Argon secara bertahap untuk tugas yang membutuhkan konteks panjang dan keluaran sangat panjang. Sambil berjalan, terus lakukan perbandingan A/B menggunakan kumpulan tugas nyata Anda sendiri. Setelah API berbayar Argon tersedia secara luas dan lebih banyak evaluasi independen diterbitkan, sesuaikan proporsi perutean berdasarkan data.
Kami menyarankan penggunaan platform APIYI apiyi.com untuk mengakses model Claude dan Gemini secara terpadu. Dengan satu antarmuka dan satu tagihan, Anda bisa membandingkan dan mengatur perutean beberapa model, sehingga keputusan pemilihan model didasarkan pada data nyata.
Referensi:
- Artikel peluncuran Gemini 4 Argon di blog resmi Google: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Informasi peluncuran Claude Opus 5.5 dari Anthropic: anthropic.com/news
- Indeks Kecerdasan dan perbandingan model Artificial Analysis: artificialanalysis.ai
- Peringkat evaluasi model Vals AI: vals.ai
- Rangkuman tabel evaluasi lengkap Gemini 4 Argon (ToolScout): toolscout.ai/news/gemini-4-argon-benchmarks
Penulis: APIYI Team | Terus mengikuti evaluasi dan pemilihan Model Bahasa Besar mutakhir. Kunjungi APIYI apiyi.com untuk informasi lebih lanjut tentang akses ke berbagai model.