작성자 메모: Gemini 4 Argon과 Carbon의 추론 투입량, 응답 속도, 작업 비용 차이를 비교해서, 개발자가 작업 난이도에 맞게 모델을 고를 수 있도록 도와드려요.
Google은 2026년 10월 13일에 Gemini 4 Argon을 공개했어요. 이어서 10월 28일에 Gemini 4 Carbon을 처음 발표했고, 11월 10일에는 개발자, 기업, 일반 사용자를 대상으로 Carbon을 정식 개방했어요. 이 소식을 들은 개발자 다수가 먼저 이렇게 생각했을 거예요. “Carbon이 Argon의 상위 버전이자 대체재인가?” 이 글에서는 추론 투입량, 응답 지연 시간, 작업 비용, 적합한 사용 시나리오, 추론 단계의 5가지 기준으로 Gemini 4 Argon과 Carbon의 실제 차이를 비교해 볼게요.
“고사양이 무조건 더 좋다”는 식의 어정쩡한 절충 분석이 아니에요. Google 공식 개발자 문서에 따르면 대부분의 엔지니어링 작업과 지식 노동에는 지금도 Argon이 권장되고, Carbon은 더 깊은 추론과 더 긴 검증 과정이 필요한 작업을 위한 모델이에요. 이 글은 Google 공식 문서를 주된 근거로 삼았고, 서드파티 데이터는 평가 버전과 추론 등급을 함께 표기했어요.
핵심 가치: 이 글을 읽고 나면 어떤 작업은 Argon에 맡기고, 어떤 작업은 Carbon에 맡길 만한지 알 수 있어요. 그리고 Thinking Level로 품질, 속도, 비용을 어떻게 조절하는지도 파악할 수 있어요.
Gemini 4 Argon과 Carbon을 비교하기 전에 알아둘 7가지 용어
추론 모델 두 개를 비교할 때는 헷갈리기 쉬운 개념이 몇 가지 있어요. 먼저 이 개념들을 구분해 두면 뒤에 나오는 데이터를 잘못 읽는 일을 막을 수 있어요.
- 추론 수준(Thinking Level): 모델이 얼마나 깊이 생각할지 조절하는 설정이에요. Carbon은 LOW, MEDIUM, HIGH 세 단계를 제공해요.
- 사고 토큰(Thinking Token): 모델이 추론하는 과정에서 생성하는 토큰이에요. 출력 토큰으로 계산해 과금해요.
- 작업 비용: 하나의 작업을 끝내기까지 이루어진 모든 모델 호출의 비용이에요. 한 번의 요청 비용과는 달라요.
- 추론 지연 시간: 모델이 요청을 받은 뒤 결과를 내놓기까지 걸리는 시간이에요. 이 글에서는 첫 번째 답변 토큰이 나오기까지의 지연 시간을 중점적으로 살펴봐요.
- 캐시 읽기: 이미 있는 입력 컨텍스트를 재사용하는 과금 방식이에요. 일반 입력보다 가격이 훨씬 저렴해요.
- Agent: 도구를 활용해 여러 단계의 작업을 수행하는 에이전트예요. 예를 들어 코드를 작성하고, 테스트를 돌리고, 문제를 수정하는 식이에요.
- 벤치마크: 고정된 작업 세트로 모델을 평가하고 비교하는 방법이에요. 결론은 해당 테스트 구성에서만 성립해요.
Google은 왜 Gemini 4 Argon과 Carbon을 동시에 내놓았을까
Google DeepMind의 Carbon 모델 카드에 따르면 Gemini 4 Carbon은 Gemini 4 Argon을 기반으로 만들어졌어요. 즉 두 모델은 같은 모델 기반을 공유하고, Carbon은 그 위에 고난도 추론, 복잡한 소프트웨어 엔지니어링, 장기 Agent 워크플로, 과학 연구, 사이버 보안 방어 분야를 더 강화한 버전이에요. 다만 Google은 Carbon의 파라미터 수를 공개하지 않았고, 두 모델의 내부 연산 아키텍처가 어떻게 다른지도 밝히지 않았어요. 그래서 “Carbon이 Argon보다 몇 배 크다”는 식의 주장은 근거가 없어요.
Carbon이 더 강하다면 왜 Argon을 그냥 대체하지 않을까요? 두 모델이 해결하는 작업의 성격이 다르기 때문이에요. 일상적인 기능 개발이나 자주 오가는 코드 수정은 응답 속도와 턴마다 드는 토큰 비용이 더 중요해요. 반면 아키텍처 설계, 여러 서브시스템에 걸친 근본 원인 조사, 과학적 증명 같은 작업은 모델이 가설을 거듭 세우고, 검증하고, 수정할 수 있는지가 더 중요해요. Google이 개발자 문서에서 제시한 선택 기준도 대체가 아니라 역할 분담이에요. Argon은 대부분의 일상적인 엔지니어링을 맡고, Carbon은 더 어렵고 오래 걸리는 추론 작업을 맡는 거죠.
이런 역할 분담은 Google의 자체 제품에서도 드러나요. Antigravity의 /swarm 멀티 Agent 프리뷰 기능에서 Google은 Carbon이 전체 아키텍처 설계, 작업 조율, 보안 검토를 맡고, 일반적인 코드 구현과 병렬 파일 수정은 더 빠르고 가벼운 모델에 맡기라고 권장해요. 일반 사용자 쪽도 마찬가지예요. Google AI Pro 구독의 모델 혜택은 주로 Argon이고, Carbon은 Ultra 구독에 포함돼요.
Gemini 4 Argon과 Carbon의 핵심 차이: 한 번의 추론에 얼마나 투자하느냐
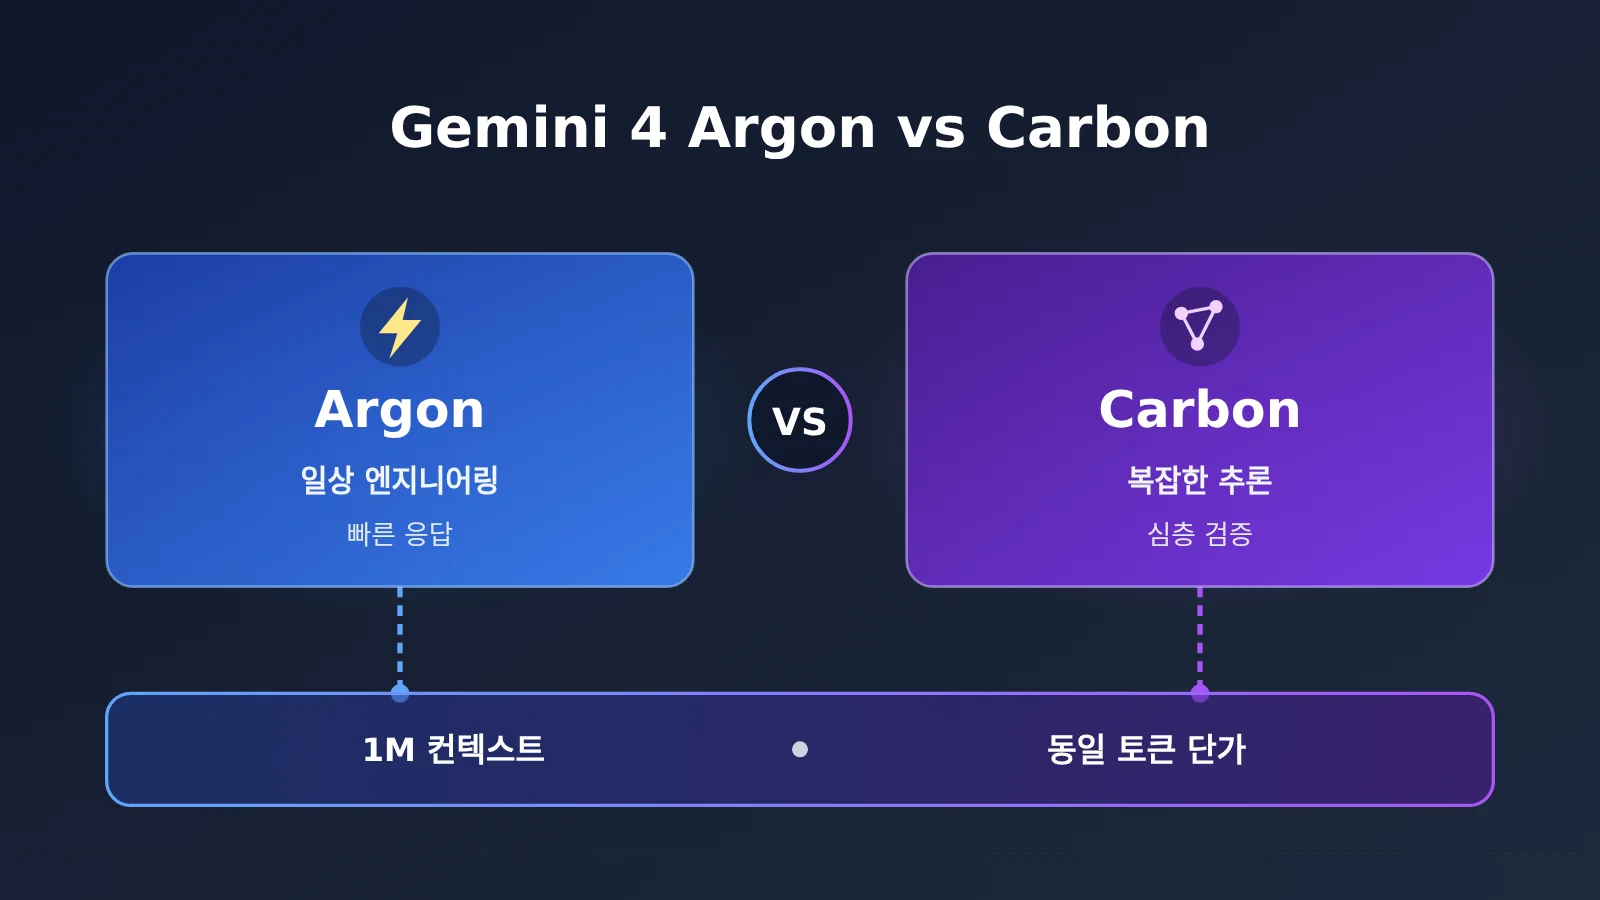
Google은 Carbon 개발자 가이드의 “Choosing between Carbon and Argon” 섹션에서 두 모델의 차이를 가장 직접적으로 설명해요. Carbon은 한 번의 추론마다 더 많은 사고 토큰(Thinking Token)을 써서 자신의 작업을 더 충분히 탐색하고 검증해요. 반면 Argon은 응답이 더 빠르고 한 번에 쓰는 토큰이 적어서, 인터랙티브 코딩이나 일상적인 기능 개발에 잘 맞아요. 두 모델은 1M 토큰 통합 컨텍스트 윈도우(1,048,576 토큰, 입력과 출력이 함께 사용)와 내장 도구 기능을 공유하고, 토큰당 가격도 같아요.
| 비교 항목 | Gemini 4 Argon | Gemini 4 Carbon | 더 적합한 모델 |
|---|---|---|---|
| 제품 포지셔닝 | 고성능·고효율 범용 추론 모델 | 더 깊이 있는 복잡한 추론 모델 | 작업에 따라 다름 |
| 추론 1회당 사고 토큰 | 상대적으로 적음 | 추론마다 더 많이 사용 | Argon이 더 경제적 |
| 응답 속도 | 더 빠름 | 복잡한 작업에서는 더 느림 | Argon |
| 인터랙티브 개발 | 더 적합 | 난도 높은 작업에 활용 가능 | Argon |
| 일상적인 기능 개발 | 권장 | 보통은 필요 없음 | Argon |
| 아키텍처 설계, 근본 원인 조사 | 충분히 수행 가능 | 매우 복잡하고 심층적인 조사에 더 적합 | Carbon |
| 과학적 증명, 보안 감사 | 수행 가능 / 지원 | 복잡한 추론과 검증에 더 적합 | Carbon |
| 컨텍스트 및 토큰 단가 | 1M 공유 컨텍스트, 단가 동일 | 1M 공유 컨텍스트, 단가 동일 | 동일 |
이 표를 보면 Gemini 4 Argon과 Carbon을 가르는 기준은 “할 수 있느냐 없느냐”가 아니라 “더 오래 생각할 만한 가치가 있느냐”예요. Argon도 아키텍처 설계와 근본 원인 조사를 해낼 수 있어요. 다만 문제가 복잡해서 여러 번 가설을 세우고 검증해야 할 때는, Carbon이 사고 토큰을 더 많이 투입해서 더 신뢰할 수 있는 결과를 만들어 내요.
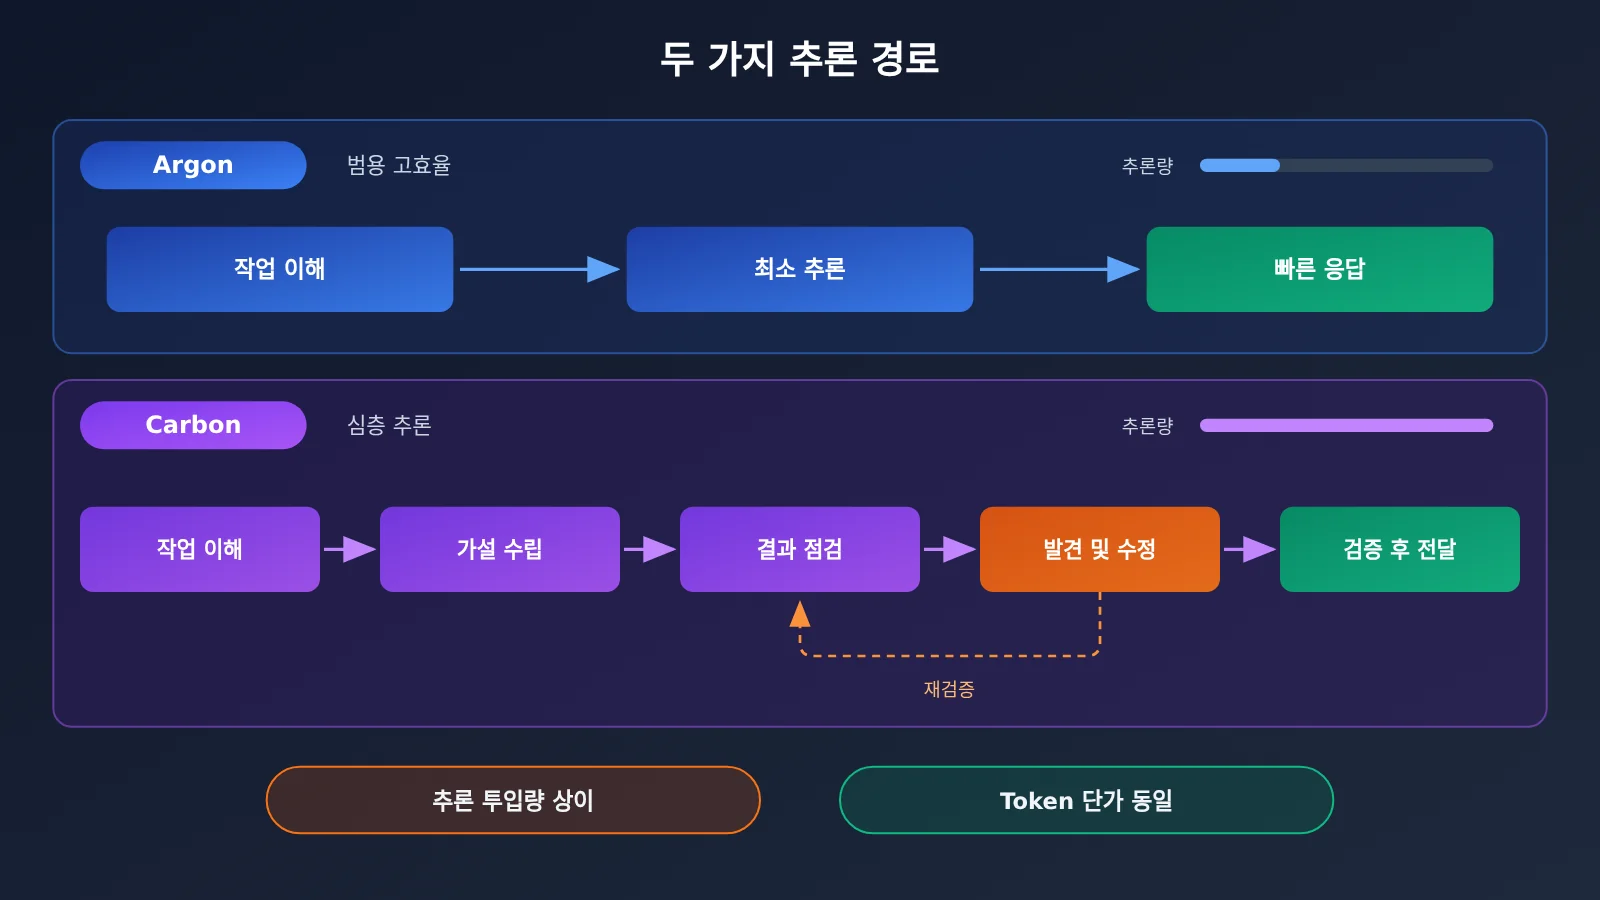
Carbon의 작업 방식은 완결된 실행 루프에 더 가까워요. 목표와 제약 조건을 이해하고, 작업을 쪼개고, 계획을 세우고, 도구를 호출하고, 중간 결과를 점검하고, 오류를 찾아내고, 수정한 뒤 다시 검증해서 최종 결과를 전달해요. 이런 루프 덕분에 장시간 작업에서 강점을 보이고, 첫 응답까지 기다리는 시간이 더 긴 이유도 설명돼요.
Gemini 4 Argon과 Carbon 독립 벤치마크 비교
공식 발표만으로는 부족하고, 독립적인 데이터로 검증할 필요가 있어요. Artificial Analysis는 Intelligence Index v5.0.1에서 Carbon과 Argon을 직접 비교하는 페이지를 제공해요. 아래 데이터는 모두 High 추론 설정에서 측정한 결과예요.
| 지표 (AA v5.0.1, High 추론) | Carbon High | Argon High | 차이 |
|---|---|---|---|
| 종합 능력 지수 | 60 | 50 | Carbon +10 |
| AutomationBench-AA | 77.8% | 77.5% | 사실상 동률 |
| Terminal-Bench 4.0 | 65.2% | 57.1% | Carbon 우세 |
| FrontierCode 2.0 | 40.6% | 25.7% | Carbon 크게 우세 |
| AA-Omniscience (지식 신뢰도 점수) | 54 | 46 | Carbon 우세 |
| HLE-Diamond | 69.1% | 56.7% | Carbon 우세 |
| 작업당 비용 | $7.76 | $9.95 | Carbon이 더 저렴 |
| 작업당 소요 시간 | 25.6분 | 28.9분 | Carbon이 더 짧음 |
| 첫 답변 토큰 지연 시간 | 약 68초 | 약 37초 | Argon이 더 빠름 |
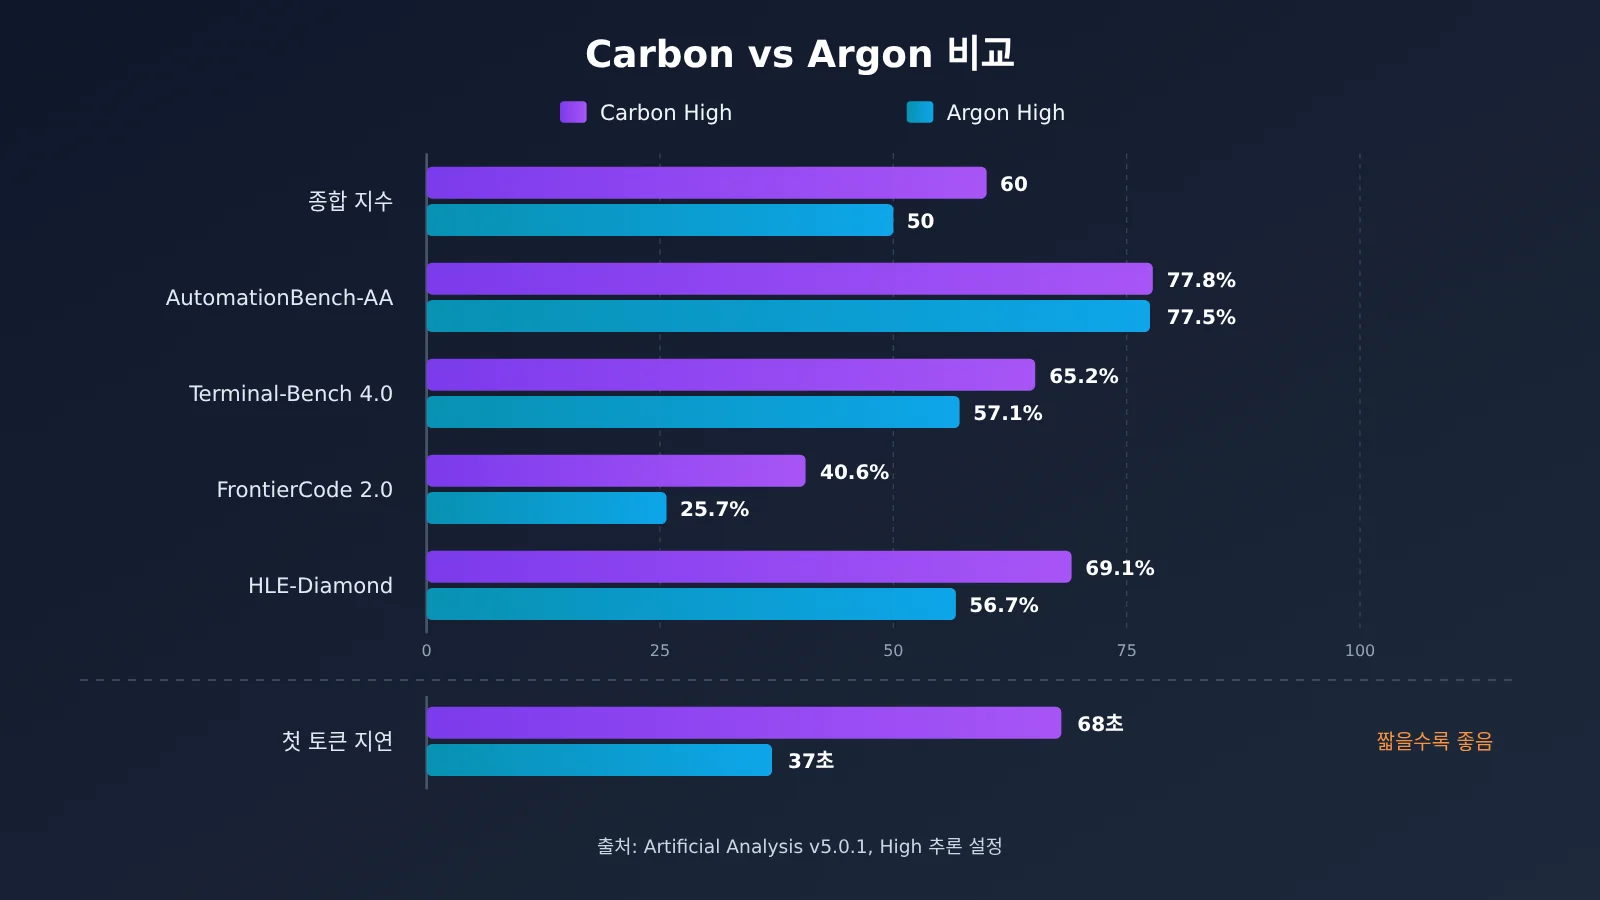
눈여겨볼 만한 결론을 정리해 볼게요.
- 복잡한 엔지니어링과 추론에서 차이가 가장 커요: FrontierCode 2.0은 약 15%p, HLE-Diamond는 약 12%p, Terminal-Bench 4.0은 약 8%p 앞서요.
- 일반적인 자동화 작업에서는 차이가 거의 없어요: AutomationBench-AA는 0.3%p 차이에 불과해요. 정해진 흐름대로 처리하는 자동화 작업이라면 Argon으로도 충분하다는 뜻이에요.
- 지식 신뢰도가 높아졌어요: AA-Omniscience 점수는 54 대 46이고, Google 모델 카드의 Agentic Honesty Benchmark에서도 Carbon이 92%, Argon이 70%로 나타났어요.
- Argon은 첫 응답이 훨씬 빨라요: 약 37초 대 약 68초예요. Carbon이 추론에 더 많은 자원을 쓰기 때문에 치르는 직접적인 대가예요.
Google 공식 모델 카드(평가 시점은 2026년 10월로 표기되어 있고, 보통 Pass@1에 사용 가능한 최고 추론 등급 기준이에요)에서도 같은 경향이 나타나요. SWE-sweep에서는 Carbon 9.6%, Argon 4.3%예요. GraphWalks(256k~1M, BFS F1)에서는 Carbon 96.2%, Argon 84.2%고요. Terminal-Bench Science 0.1에서는 Carbon 64.8%, Argon 52.9%예요. 다만 공식 모델 카드와 Artificial Analysis는 평가 체계와 시점이 서로 달라서, 둘을 섞어 순위를 매기는 건 적절하지 않아요. 또 Carbon 모델 페이지에는 High 설정의 작업당 소요 시간이 24.9분으로 표시되어 있어서, 비교 페이지의 25.6분과 조금 달라요. 이 글의 비교 표는 비교 페이지 데이터를 기준으로 했어요.
벤치마크 점수가 전부는 아니에요. Google DeepMind와 Artificial Analysis가 공동으로 내놓은 MKA 멀티모달 지식 업무 평가에서는 10개 산업 전체에서 앞선 모델이 하나도 없었어요. Argon은 과학 분야에서, Carbon은 의료·헬스케어 분야에서 앞섰고요. Carbon의 종합 점수가 더 높다고 해서 모든 분야에서 Argon보다 낫다는 뜻은 아니라는 점을 기억해 두세요.
💡 비교 시 참고: 벤치마크는 정해진 작업 세트에서의 성능만 보여줘요. 내 업무에 Carbon이 필요한지 가장 확실하게 알아보는 방법은 실제 작업을 두 모델에 각각 돌려 보는 거예요. APIYI(apiyi.com)에서는 같은 API 키와 같은 OpenAI 호환 코드로 두 모델을 오갈 수 있어서, 소규모 비교 테스트를 하기 편해요.
왜 Gemini 4 Carbon은 매 라운드 토큰을 더 쓰는데도 더 비싸지 않을 수 있을까
이 부분이 가장 오해하기 쉬워요. Gemini 4 Argon과 Carbon의 토큰 단가는 같아요. 2026년 11월 30일까지의 출시 기념가는 입력 100만 토큰당 2달러, 출력 100만 토큰당 10달러예요. 12월 1일부터는 각각 4달러와 20달러로 조정돼요. 캐시 입력 가격은 입력 가격에서 95% 할인된 수준이에요. 사고(thinking) 토큰은 출력 토큰 요금에 포함되기 때문에, Carbon이 라운드마다 더 오래 생각하면 한 라운드 청구액은 보통 더 높아져요.
하지만 작업 청구액은 한 라운드 청구액과 달라요. Artificial Analysis v5.0.1의 High 설정 비교에서 Carbon의 작업당 비용은 7.76달러, Argon은 9.95달러였어요. Carbon이 오히려 약 22% 저렴했고, 소요 시간도 약 3분 짧았어요. 합리적인 해석은 이래요. 전체 작업의 비용은 작업을 끝내는 데 몇 라운드가 필요했는지, 얼마나 돌아갔는지, 몇 번 다시 작업했는지에 따라 정해져요. Carbon이 초반에 더 깊이 생각해서 실수를 줄이면, 이후의 재시도와 수정 라운드가 줄어들 수 있어요.
| 설정 (AA v5.0.1) | 종합 점수 | 작업당 비용 | 작업당 소요 시간 | 첫 응답 지연 |
|---|---|---|---|---|
| Carbon Low | 54 | $7.19 | 22.3분 | 12.37초 |
| Carbon Medium | 58 | $6.59 | 23.3분 | 23.16초 |
| Carbon High | 60 | $7.76 | 24.9분 | 67.54초 |
| Argon High | 50 | $9.95 | 28.9분 | 약 37초 |
이 데이터에는 직관과 어긋나는 점이 하나 더 있어요. Carbon Medium의 작업 비용이 Low보다 낮다는 거예요. 추론 단계가 낮을수록 한 라운드는 저렴하지만, 작업을 끝내려면 더 많은 라운드가 필요할 수 있어요. 다만 비교 범위에는 특히 주의해야 해요.
- 이 비용은 해당 평가 체계에서 작업 하나당 평균 비용이에요. 표준 가격인 4/20달러 기준으로 계산한 값이고, 일반적인 API 요청 한 번의 가격이 아니에요. 출시 기념가로 추산하면 같은 토큰 사용량에서 비용이 약 절반으로 줄어요.
- 24.9분 같은 소요 시간은 에이전트 평가 작업의 가중 소요 시간이에요. 일반적인 질문 하나에 25분을 기다려야 한다는 뜻이 아니에요.
- 이 결론은 AA Index의 작업 세트에만 해당돼요. 작업 자체가 단순해서 한두 라운드면 끝난다면, Argon이나 더 낮은 단계의 라운드당 비용 이점이 그대로 더 낮은 청구액으로 나타나요.
💰 비용 팁: 모델을 평가할 때는 단가만 비교하지 말고 “작업 하나를 끝내는 데 쓴 총 토큰 수와 총 소요 시간”을 기록하세요. APIYI(apiyi.com)는 종량제 과금 방식이고, 콘솔에서 호출별 사용량 내역을 확인할 수 있어요. 그래서 여러분의 업무에서 Argon과 Carbon의 실제 작업 비용을 계산해 보기에 알맞아요.
Gemini 4 Argon과 Carbon, 언제 어떤 모델을 쓸까
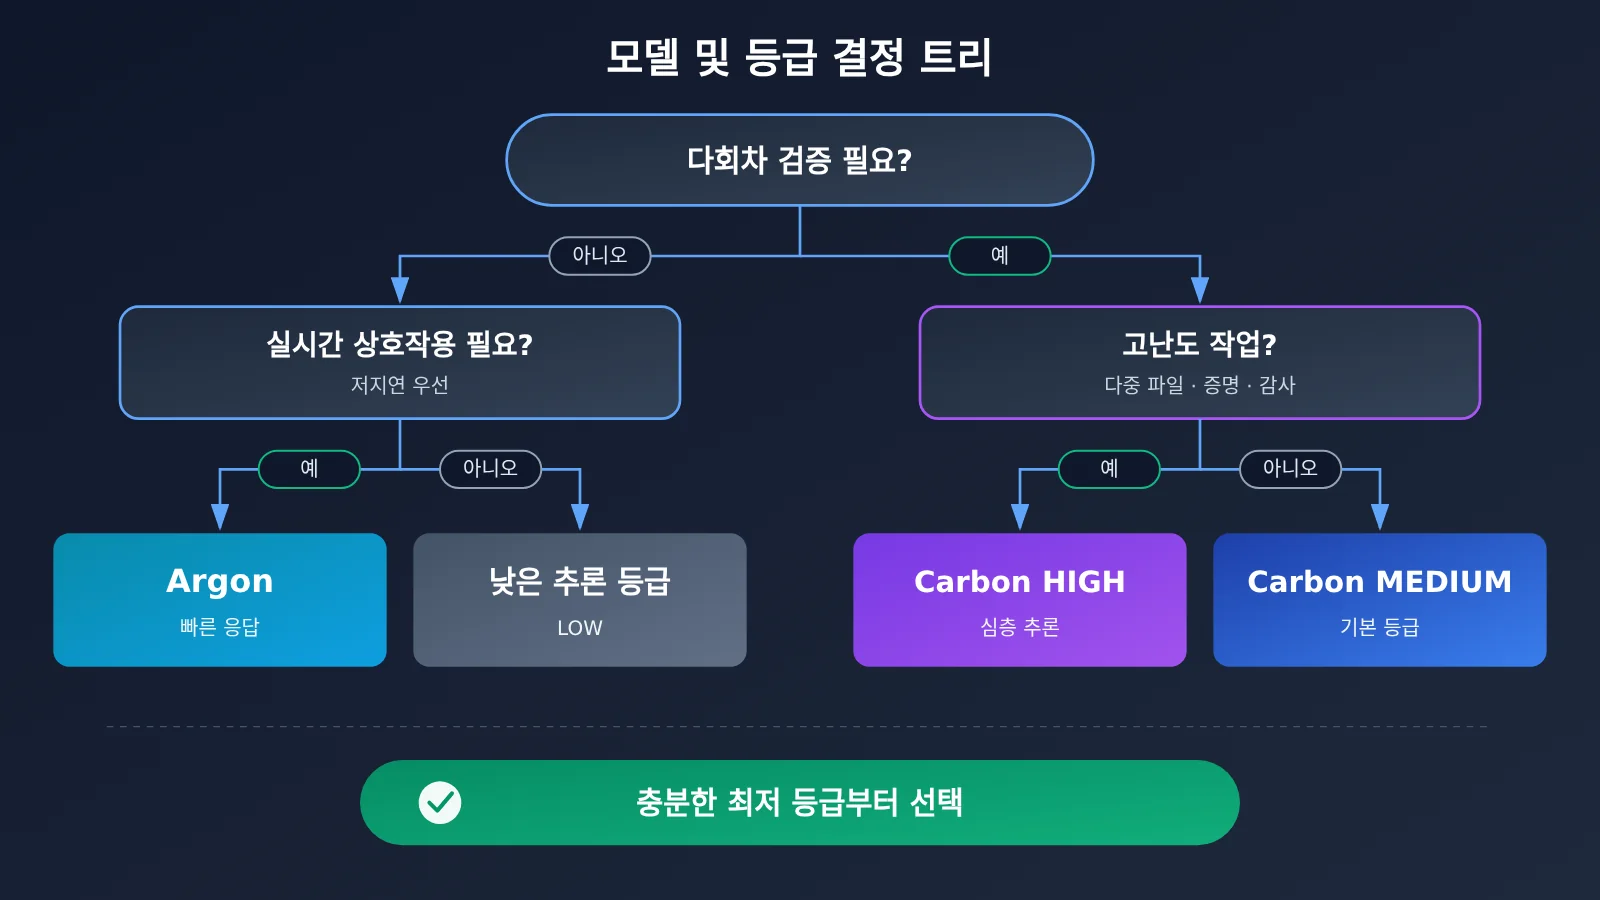
Google의 공식 포지셔닝과 앞에서 본 데이터를 종합하면 작업 난이도에 따라 모델을 나눠 쓸 수 있어요. 핵심 원칙은 먼저 이 작업에 더 깊은 추론이 필요한지 따져 보고, 그다음에 모델과 등급을 고르는 거예요.
| 작업 유형 | 추천 모델 | 추천 등급 | 이유 |
|---|---|---|---|
| 일상적인 기능 개발, 일반 코드 수정 | Argon | 기본 또는 중간 | 응답이 빠르고 턴당 비용이 낮아서 잦은 상호작용에 적합해요 |
| 인터랙티브 코딩, IDE 실시간 지원 | Argon | 중간 | 첫 응답 지연이 눈에 띄게 낮아요 |
| 여러 파일에 걸친 복잡한 프로젝트, 아키텍처 설계 | Carbon | HIGH | FrontierCode, Terminal-Bench에서 격차가 뚜렷해요 |
| 서브시스템을 넘나드는 심층 근본 원인 조사 | Carbon | MEDIUM / HIGH | 여러 가설을 탐색하고 반복해서 검증해야 해요 |
| 고난도 과학 추론, 형식 증명 | Carbon | HIGH | 공식적으로 형식 증명을 HIGH 용도로 분류하고 있어요 |
| 보안 감사, 취약점 발견 | Carbon | HIGH | 공식 포지셔닝상 복잡한 감사에 더 적합해요 |
| 단순 분류, 요약, 메타데이터 추출 | 낮은 추론 등급 | LOW | 비용에 민감하고 깊은 추론이 필요 없어요 |
Gemini 4 Argon을 선택하면 좋은 경우
- 상호작용이 잦은 개발 작업: 함수 하나를 작성하거나, 스타일을 고치거나, 테스트를 보완할 때는 37초와 68초를 기다리는 체감 차이가 매우 커요.
- 일반적인 지식 업무와 자동화 워크플로: AutomationBench-AA에서는 두 모델이 거의 비슷해서, 굳이 격차에 비용을 낼 필요가 없어요.
- 과학 분야 지식 업무: MKA 평가에서 Argon이 과학 분야에서 앞서 있으니 우선적으로 시도해 볼 만해요.
Gemini 4 Carbon을 선택하면 좋은 경우
- 백그라운드에서 오래 실행되는 Agent 작업: 첫 응답 지연에는 둔감하고, 한 번에 제대로 처리하는 게 더 중요한 경우예요.
- 복잡한 엔지니어링과 아키텍처 결정: 여러 파일에 걸친 마이그레이션, 시스템 리팩터링, 복잡한 코드 감사 등이 여기에 해당해요.
- 결과의 검증 가능성이 중요한 작업: 과학 추론, 보안 감사, 자체 점검이 필요한 분석 보고서 같은 작업이에요.
커뮤니티의 초기 반응도 이런 역할 분담을 뒷받침해요. Hacker News와 Reddit에서는 Carbon이 다른 모델이 놓친 문제를 찾아냈다는 개발자도 있고, 첫 답변까지 너무 오래 기다려야 하고 할당량도 빨리 소진된다고 불평하는 개발자도 있어요. 한 Reddit 사용자는 Go 프로젝트에서 Carbon Medium으로 230개 파일이 얽힌 라이브러리를 마이그레이션했고 첫 실행에 성공했다고 해요. 다만 작성자도 샘플이 4개 단계뿐이고 대조 실험이 아니라고 밝혔으니, 참고용 사례로만 보는 게 좋아요.
Thinking Level로 Gemini 4 Carbon의 품질, 속도, 비용 제어하기
Carbon은 LOW, MEDIUM, HIGH 세 가지 추론 등급을 제공해요. 공개 모델 gemini-4-carbon은 기본값으로 MEDIUM을 사용해요. 공식 문서에서 권장하는 용도는 다음과 같아요. LOW는 분류, 요약, 메타데이터 추출에 쓰고, MEDIUM은 일반 코드, 도구 호출, 문서 질의응답, 영상 이해에 써요. HIGH는 다중 파일 소프트웨어 엔지니어링, 아키텍처 설계, 형식 증명, 취약점 발견에 적합해요.
기본값이 MEDIUM인 데에는 이유가 있어요. AA v5.0.1에서 Carbon Medium의 종합 점수는 58점으로 High보다 2점밖에 낮지 않은데, 작업 비용은 가장 낮고 첫 응답 지연 시간은 High의 약 3분의 1 수준이에요. AA-Omniscience 사실 신뢰성 테스트에서도 Medium이 답변을 지어낸 비율은 4.2%로, High의 11.4%와 Low의 20.0%보다 낮았어요(특정 테스트의 지표이며, 일반적인 환각 비율은 아니에요). Google 역시 개발자에게 여러 등급을 직접 테스트해 보라고 권하면서, 무조건 HIGH를 쓰기보다 품질 요건을 충족하는 가장 낮은 등급을 선택하라고 안내해요.
호출할 때 알아 두어야 할 Carbon의 기술적 제한도 몇 가지 있어요. thinking_budget은 지원되지 않으며, 사용하면 HTTP 400이 반환돼요. MINIMAL 등급도 지원하지 않아요. temperature, top_p, top_k는 무시되고요. 명시적 Context Caching은 지원하지 않지만, 공통 프롬프트 프리픽스가 4096 토큰 이상이면 자동 암시적 캐싱이 적용될 수 있어요.
최소 예제
아래는 OpenAI 호환 인터페이스로 Gemini 4 Carbon을 호출하는 예제예요. 10여 줄이면 바로 실행할 수 있어요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # 모델 ID는 플랫폼 모델 목록을 기준으로 하세요
    messages=[{"role": "user", "content": "分析这段服务超时日志的可能根因"}]
)
print(response.choices[0].message.content)
전체 구현 코드 보기: 작업 난이도에 따라 Argon과 Carbon 라우팅하기
import time
import openai
from typing import Literal

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 모델 이름은 예시이므로, 플랫폼 모델 목록에 있는 실제 ID를 기준으로 하세요
ARGON_MODEL = "gemini-4-argon"
CARBON_MODEL = "gemini-4-carbon"

Difficulty = Literal["simple", "daily", "complex", "extreme"]

def route(difficulty: Difficulty) -> tuple[str, str]:
    """작업 난이도에 따라 (모델, 추론 단계)를 반환"""
    if difficulty == "simple":
        return CARBON_MODEL, "low"      # 분류, 요약, 메타데이터 추출
    if difficulty == "daily":
        return ARGON_MODEL, "medium"    # 일상적인 개발, 잦은 상호작용
    if difficulty == "complex":
        return CARBON_MODEL, "medium"   # 근본 원인 조사, 일반적인 에이전트 작업
    return CARBON_MODEL, "high"         # 다중 파일 엔지니어링, 증명, 보안 감사

def run_task(prompt: str, difficulty: Difficulty) -> dict:
    model, effort = route(difficulty)
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        # 추론 단계 파라미터의 매핑 방식은 플랫폼 문서를 기준으로 하세요.
        # Carbon은 thinking_budget을 지원하지 않으며, 전달하면 400 오류가 발생해요
        reasoning_effort=effort,
    )
    usage = resp.usage
    return {
        "model": model,
        "effort": effort,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,  # 사고(thinking) 토큰 포함
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    result = run_task("为订单服务设计分库分表迁移方案,并列出验证步骤", "extreme")
    print(result["model"], result["effort"], result["seconds"], "s")
    print("输出 Token:", result["completion_tokens"])
🚀 빠른 시작 팁: 먼저 APIYI(apiyi.com)에 가입해서 무료 테스트 크레딧을 받아 보세요. 위의 라우팅 함수로 같은 실제 작업 묶음을 Argon과 Carbon의 여러 단계에 각각 맡기고, 소요 시간과
completion_tokens를 기록해 보면 돼요. API 키 하나로 모든 비교를 끝낼 수 있어서, 여러 SDK를 따로 연동할 필요가 없어요.
Gemini 4 Argon과 Carbon 선택 가이드
딱 한 가지 규칙만 기억해야 한다면 이거예요. 기본은 Argon으로 쓰고, 깊이 고민해야 하는 작업일 때만 Carbon으로 올리세요. 실제로 적용할 때는 세 단계로 나눠서 진행하면 좋아요.
- 분류 규칙 만들기: 앞에서 본 시나리오 표를 기준으로 작업을 간단, 일상, 복잡, 매우 어려움의 네 가지로 나누고, 일상 작업은 기본적으로 Argon으로 처리해요.
- 소규모 샘플 비교: 각 유형에서 실제 작업을 10~20개씩 골라 Argon과 Carbon의 각 단계별 통과율, 총 토큰 사용량, 총 소요 시간을 비교해요.
- 작업 비용에 맞춰 단계 정하기: 품질 기준을 충족하는 가장 낮은 단계를 선택하고, 모델, 가격, 리더보드가 언제든 바뀔 수 있으니 주기적으로 다시 테스트하세요.
멀티 에이전트 시스템이라면 Google /swarm의 접근 방식을 참고해 보세요. Carbon은 계획 수립, 조율, 검토를 맡기고, Argon이나 더 가벼운 모델은 대량 실행을 맡기는 방식이에요. 이렇게 하면 Carbon의 깊이 있는 추론은 활용하면서도, 모든 단계가 Carbon의 지연 시간을 떠안지 않아도 돼요.
💡 선택 팁: 두 모델의 토큰 단가는 같기 때문에, 실제로 차이를 만드는 건 작업의 구조예요. APIYI(apiyi.com)에서 OpenAI 호환 인터페이스로 Argon과 Carbon을 함께 연동해 두고, 코드 레벨에서 라우팅으로 전환하는 방식을 추천해요. 나중에 전략을 조정하더라도 비즈니스 코드는 수정하지 않아도 돼요.
자주 묻는 질문 FAQ
Q1: Gemini 4 Argon과 Carbon은 어떤 관계인가요?
Google DeepMind 모델 카드에 따르면 Gemini 4 Carbon은 Gemini 4 Argon을 기반으로 만들어졌어요. 두 모델 모두 Gemini 4 추론 모델 시리즈에 속하며, 1M 토큰 컨텍스트 윈도우와 내장 도구 기능을 공유해요. Carbon은 한 번의 응답에서 더 많은 사고 토큰을 투입해 탐색과 검증을 진행하고, Argon은 응답 속도와 단일 턴 효율에 더 무게를 둬요. Google은 두 모델의 파라미터 수와 아키텍처 차이를 공개하지 않았어요.
Q2: Carbon이 Argon을 완전히 대체하나요?
아니에요. Google은 대부분의 엔지니어링 및 지식 업무에는 Argon이 여전히 이상적인 선택이고, Carbon은 더 어렵고 더 긴 호흡의 작업에 적합하다고 분명히 밝혔어요. AutomationBench-AA에서 두 모델이 거의 비슷한 점수를 기록했고, MKA의 과학 분야에서는 Argon이 앞선 점을 보면, Argon도 많은 시나리오에서 여전히 경쟁력이 있어요.
Q3: 두 모델의 가격은 같나요? 가격은 언제 바뀌나요?
Google 개발자 문서에 따르면 두 모델은 토큰당 가격이 동일해요. 출시 기념 가격은 100만 입력/출력 토큰당 2달러/10달러이고, 2026년 11월 30일까지 적용돼요. 12월 1일부터는 4달러/20달러로 조정돼요. 사고 토큰은 출력 비용에 포함되기 때문에, 단가가 같다고 해서 작업당 비용이 같은 것은 아니에요.
Q4: Carbon은 첫 응답이 느린데, 채팅 애플리케이션에 적합할까요?
실시간성이 중요한 시나리오에는 적합하지 않아요. AA v5.0.1 기준으로 Carbon High의 첫 번째 답변 토큰 지연 시간은 약 68초, Argon High는 약 37초, Carbon Low는 약 12초예요. 실시간 상호작용에는 Argon을, 백그라운드의 복잡한 분석이나 장기 에이전트 작업에는 Carbon을 추천해요.
Q5: API로 Argon과 Carbon을 빠르게 비교하려면 어떻게 하나요?
여러 모델을 지원하는 API 통합 플랫폼을 사용하는 것을 추천해요.
1. APIYI(apiyi.com)에 가입해서 API 키와 무료 테스트 크레딧을 받으세요.
2. 코드의 base_url을 `https://api.apiyi.com/v1`로 설정하세요.
3. `model` 파라미터만 바꾸면 두 모델을 오갈 수 있고, 여기에 추론 단계 설정을 함께 조합해 비교해 볼 수 있어요.
Q6: Google AI Ultra 구독이 없어도 Carbon을 쓸 수 있나요?
쓸 수 있어요. Ultra 구독은 일반 사용자용 서비스(Gemini 앱 등)에서 Carbon을 직접 선택할 수 있는지를 결정할 뿐이고, AI Pro에는 주로 Argon이 포함돼요. 개발자는 Gemini API 유료 티어를 통해 Carbon을 호출할 수 있어서 Ultra를 구매할 필요가 없어요. 다만 Google 공식 Carbon API에는 무료 티어가 없다는 점은 알아두세요.
Q7: Carbon에는 어떤 알려진 제한 사항이 있나요?
모델 카드에는 다음과 같은 내용이 공개되어 있어요. 환각이 여전히 발생할 수 있고, 높은 추론 등급에서는 토큰을 많이 소모할 수 있으며, 응답이 느리거나 타임아웃이 발생할 수 있어요. 지식 컷오프는 2026년 3월이고, 프롬프트 인젝션 방어도 아직 개선이 필요해요. 또한 `thinking_budget`은 지원되지 않고 샘플링 파라미터는 무시되기 때문에, 기존 코드를 마이그레이션할 때 확인이 필요해요.
Gemini 4 Argon과 Carbon 핵심 요약 Key Takeaways
- 관계 설정: Carbon은 Argon을 기반으로 만들어졌어요. 둘은 역할을 나눠 서로 보완하는 관계이고, 상위·하위 모델로 서로를 대체하는 구조가 아니에요.
- 핵심 차이: Carbon은 매 턴마다 더 많이 생각하고 더 꼼꼼하게 검증해요. Argon은 응답이 더 빠르고 한 턴당 비용이 적게 들어요.
- 벤치마크 성능: AA v5.0.1 High 설정에서 Carbon은 종합 60점, Argon은 50점을 기록했어요.
- 비용의 진실: 단가는 같아요. 그런데 AA 태스크에서는 Carbon High의 태스크당 비용이 오히려 Argon High보다 낮아요.
- 등급 선택: Carbon의 기본값은 MEDIUM이에요. “충분한 가장 낮은 등급”을 기준으로 LOW/MEDIUM/HIGH 중에서 고르면 돼요.
- 시작 방법: APIYI(apiyi.com)를 통해 OpenAI 호환 코드 하나로 두 모델을 함께 테스트할 수 있어요.
정리
Gemini 4 Argon과 Carbon의 차이는 세 가지로 요약할 수 있어요.
- 추론에 투입하는 양이 달라요: Argon은 효율을 맡고, Carbon은 더 많은 사고 토큰(Token)을 써서 복잡한 추론의 한계에 도전해요.
- 지연 시간과 비용은 따로 봐야 해요: Carbon은 첫 응답이 더 느리지만, 특정 평가에서는 전체 태스크 비용이 더 낮을 수 있어요.
- 선택 기준은 작업 난이도예요: 일상적인 엔지니어링 작업은 Argon을 우선 사용하고, 복잡한 엔지니어링, 과학적 추론, 보안 감사는 Carbon에 맡기세요.
모든 요청을 최고 추론 등급으로 처리하지 마세요. 실제 작업으로 유형별 “충분한 등급”을 먼저 측정해 보는 것이 품질, 속도, 비용을 함께 관리하는 핵심이에요. APIYI(apiyi.com)에서 두 모델이 여러분의 업무에서 실제로 어떤 성능을 내는지 빠르게 검증해 보세요. 이 플랫폼은 종량제 과금과 여러 모델을 하나로 묶은 통합 인터페이스를 지원해요.
📚 참고 자료
- Gemini 4 Carbon Model Card: Google DeepMind 공식 모델 카드
- 링크:
deepmind.google/models/model-cards/gemini-4-carbon -
설명: Carbon이 Argon을 기반으로 구축된 방식, 컨텍스트 사양, 공식 평가 결과, 알려진 한계
-
Choosing between Carbon and Argon: Google AI Studio 개발자 문서
- 링크:
aistudio.google.com/docs/whats-new-gemini-4-carbon -
설명: 두 모델의 공식 포지셔닝 차이와 Thinking Level 선택 가이드
-
Gemini 4 Carbon Developer Guide: Google Cloud 개발자 가이드
- 링크:
docs.cloud.google.cn/gemini-enterprise-agent-platform/models/guides/gemini-4-carbon -
설명: 추론 등급, API 파라미터 제한, 긴 디코딩 관련 안내
-
Gemini API 가격 정책: Google AI for Developers
- 링크:
ai.google.dev/gemini-api/docs/pricing -
설명: 출시 가격, 12월 가격 조정, 캐시 및 Thinking 토큰 과금 규칙
-
Gemini 4 Carbon vs Gemini 4 Argon: Artificial Analysis 비교 페이지
- 링크:
artificialanalysis.ai/zh/models/comparisons/gemini-4-carbon-vs-gemini-4-argon -
설명: AA Index v5.0.1 High 설정에서의 성능, 비용, 지연 시간 비교
-
MKA 멀티모달 지식 업무 평가: Artificial Analysis
- 링크:
artificialanalysis.ai/zh/evaluations/mka - 설명: 산업별 선두 모델과 작업당 비용 데이터
작성자: APIYI 기술팀
기술 교류: APIYI 웹사이트 첫 페이지에서 언제든 문의해 주세요. 더 많은 모델 연동 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요.