작가의 말: DeepSeek가 Super-agent 연구 프로토타입을 오픈소스로 공개했어요. Claude Code, Codex와는 실제로 무엇이 다를까요? 모델, 프로그래밍 도구, 스케줄링 시스템의 세 계층을 6가지 관점에서 살펴보고 작업 방식에 맞는 선택지를 제안해요.
2026년 10월 31일, DeepSeek Harness 팀은 기술 글 《Super-agent 설계 탐구: 더 자율적인 에이전트 시스템을 향해》를 발표하고, 관련 프로토타입인 dsh-superagent-prototype을 공식 GitHub에 MIT 라이선스로 공개했어요. 상시 실행 Router와 독립 Worker로 구성된 2계층 스케줄링 아키텍처는 곧바로 화제가 됐어요. Bloomberg와 사우스차이나모닝포스트 등은 이를 Claude Code, Codex와의 경쟁 구도에서 보도했죠.
이 글은 또 하나의 “누가 누구를 대체할까”를 다루는 편 가르기 글이 아니에요. 저장소에는 연구 프로토타입이라는 점이 명시돼 있고, Claude Code와 Codex도 이미 단일 세션 도구를 넘어섰어요. DeepSeek Super-agent를 Claude Code, Codex와 비교할 때 정말 중요한 질문은 이것이에요. 차이는 기반 모델에서 비롯될까요, 아니면 에이전트의 스케줄링 시스템에서 비롯될까요?
이 글에서 얻을 수 있는 것: 세 도구가 각각 어떤 계층에 속하는지 구분하고, DeepSeek가 설계에서 중점을 둔 부분의 실제 의미를 이해할 수 있어요. 나아가 자신의 작업 방식에 맞는 도구 조합도 선택할 수 있어요.
DeepSeek Super-agent 핵심 정보 한눈에 보기
먼저 사실관계부터 짚어볼게요. DeepSeek Super-agent는 새로운 기반 모델이 아니라, 대규모 언어 모델을 중심으로 구축한 Agent 시스템 아키텍처예요. 현재 공개된 것도 정식 상용 제품이 아닌 연구용 프로토타입이에요.
| 정보 항목 | 상세 내용 |
|---|---|
| 공개일 | 2026년 10월 31일(기술 문서와 저장소가 같은 날 공개) |
| 공개 주체 | DeepSeek Harness 팀 |
| 프로젝트명 | deepseek-ai/dsh-superagent-prototype, 주로 TypeScript 사용 |
| 오픈소스 라이선스 | MIT, 무료로 다운로드하고 수정할 수 있으며 라이선스 의무를 준수하면 상용 프로젝트에도 사용 가능 |
| 프로젝트 상태 | 연구용 프로토타입, 정식 제품 출시일과 별도 구독 가격은 공개되지 않음 |
| 실행 환경 | DeepSeek Harness 환경과 설정된 모델 제공업체 필요 |
| 현재 지원 범위 | GitHub 저장소 하나를 모니터링하며, 선택적으로 Feishu를 연동해 Issue부터 PR까지 작업 진행 |
11월 2일 기준 프로젝트 페이지에는 약 8,900개의 Star와 898개의 Fork가 표시됐으며, 이 수치는 계속 변하고 있어요. Star 수는 관심도를 나타낼 뿐, 실제 설치 수나 코딩 성공률을 의미하지는 않아요.
DeepSeek Super-agent가 해결하려는 문제
DeepSeek 팀은 모델의 개별 작업 능력이 향상되면서 효율성의 병목이 모델 능력에서 사람의 주의력으로 옮겨가고 있다고 봐요. 팀의 경험에 따르면 한 사람이 효과적으로 관리할 수 있는 활성 Agent 세션은 보통 3~5개 정도예요.
컨텍스트가 분산되고 창을 자주 전환해야 하는 데다, 작업이 끝날 때마다 다음 지시를 내려야 하기 때문이에요. 도구 호출로 세션이 막히거나 로컬 기기가 절전 모드에 들어가 작업이 중단되는 문제도 있어요.
3~5개라는 수치는 DeepSeek 팀의 경험에 따른 판단이지 업계 통계는 아니에요. 다만 Super-agent의 연구 방향은 분명하게 보여줘요. 모델을 더 똑똑하게 만드는 대신 세션 스케줄링, 이벤트 처리, 컨텍스트 관리를 ‘사람’에서 ‘시스템’으로 옮기는 거예요.
팀은 이를 위해 Continuous(연속성), Productive(높은 생산성), Proactive(능동성), Persistent(지속성)라는 네 가지 목표 특성을 제시했어요. 이는 설계 목표일 뿐, 프로토타입이 이미 모두 구현했다는 뜻은 아니에요.
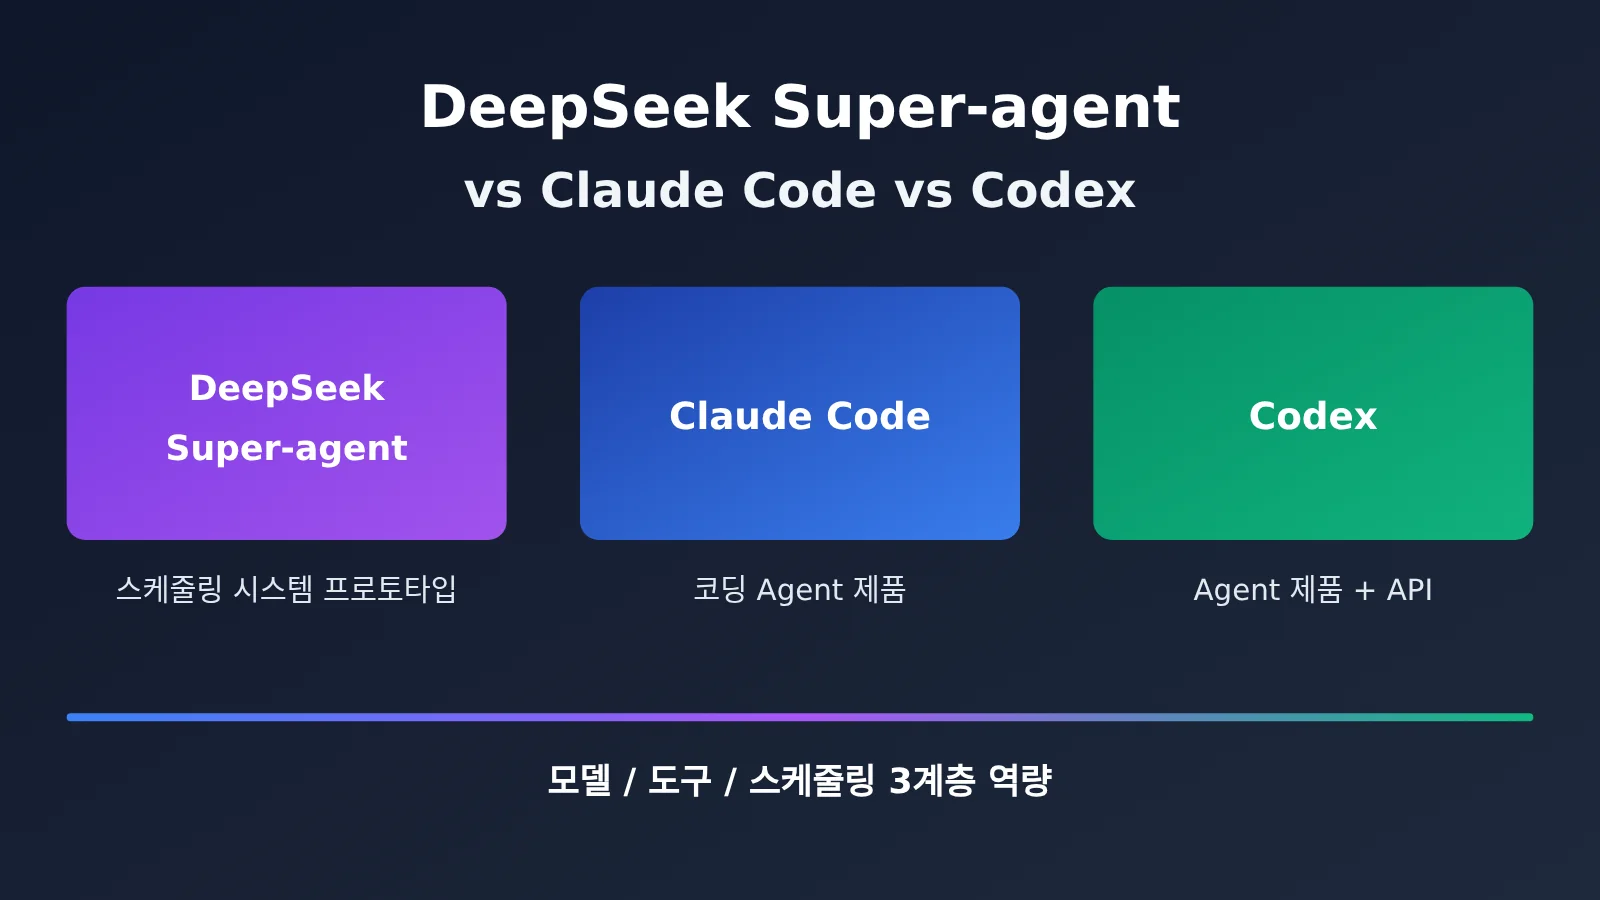
DeepSeek Super-agent와 Claude Code, Codex 비교: 먼저 세 가지 계층부터 구분해요
“누가 더 강한가”를 논하기 전에 세 제품이 완전히 같은 계층에 있지는 않다는 점을 알아야 해요. Claude Code와 Codex는 프로그래밍을 위한 Agent 제품이자 도구 생태계예요. 반면 Super-agent는 Agent 바깥에서 상시 실행, 이벤트 기반 처리, 다중 작업 조율을 지원하는 운영 메커니즘에 초점을 맞춰요. 실제 추론과 도구 실행은 여전히 기반 모델과 DeepSeek Harness에 의존해요.
따라서 비교도 세 계층으로 나눠야 해요. 모델 능력은 단일 단계의 추론과 코드 생성 품질을, 프로그래밍 도구 능력은 파일 읽기와 쓰기, 테스트 실행, PR 생성을 할 수 있는지를 결정해요. 스케줄링 시스템 능력은 여러 작업을 어떻게 접수하고, 배정하고, 추적하고, 결과를 전달할지를 결정해요. 세 계층을 섞어서 비교하면 오해의 소지가 있는 결론을 내리기 쉬워요.
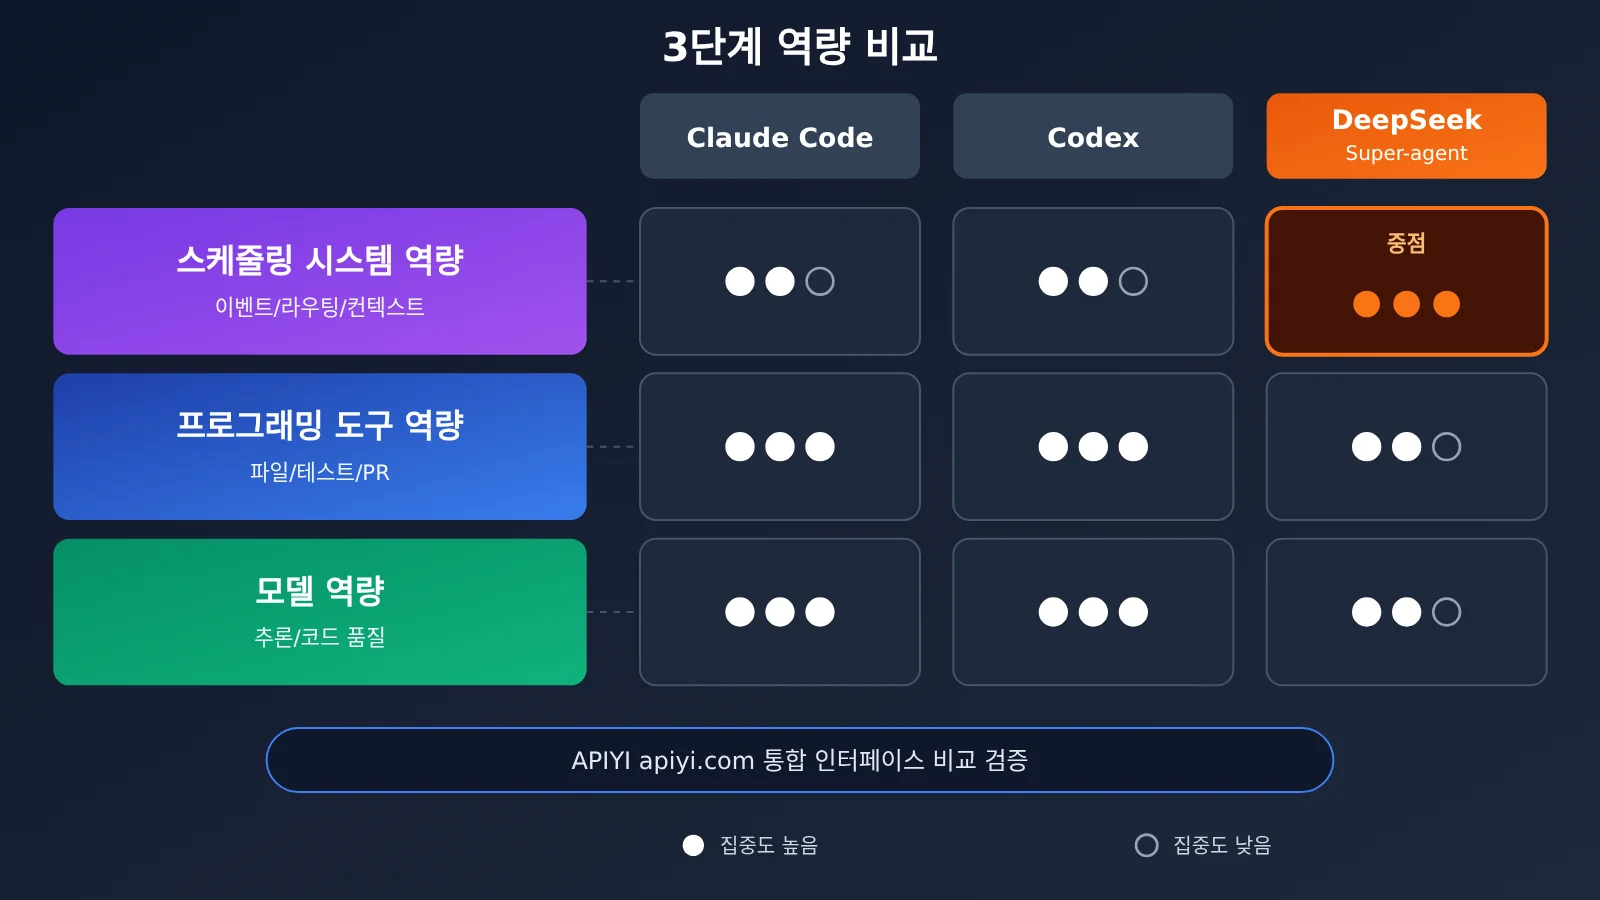
아래에서는 현재 공개된 기능의 메커니즘을 6가지 기준으로 비교해요. 이 표는 “메커니즘”을 비교한 것이지, 동일한 조건에서 측정한 성능 순위가 아니라는 점에 유의하세요.
| 비교 기준 | DeepSeek Super-agent 프로토타입 | Claude Code 생태계 | Codex / OpenAI 생태계 |
|---|---|---|---|
| 단일 작업 프로그래밍 | Harness와 선택한 모델에 의존하며 Worker가 실행 | 성숙한 프로그래밍 Agent, CLI·데스크톱·클라우드 지원 | 성숙한 프로그래밍 Agent, 로컬·클라우드 지원 |
| 다중 Agent 협업 | Router + Worker의 2계층 구조 | Subagents, 실험적 Agent Teams | 병렬 세션, Worktrees; Multi-agent는 API 기능 |
| 이벤트 트리거 | GitHub, 선택적으로 Feishu | GitHub Actions, Channels(리서치 프리뷰) | 지원되는 앱 이벤트 자동화, GitHub Actions 워크플로 |
| 백그라운드 지속 실행 | Worker 세션 지원; 여러 기기에 걸친 지속 실행은 아직 설계 탐색 단계 | 백그라운드 Agent, 클라우드 예약 작업 | 클라우드 작업, 백그라운드 예약 작업 |
| 컨텍스트 관리 | 상주 Router가 전체 컨텍스트를 유지하고 Worker는 분리 | 하위 Agent의 독립적인 컨텍스트, 팀의 공유 작업 목록 | 클라우드 작업별 작업 공간 분리, 메인 Agent가 결과 취합 |
| 배포 비용 | 자체 배포, Node.js·tmux·전용 GitHub 계정 등이 필요 | 정식 제품으로 시작하기 쉬움 | 정식 제품으로 시작하기 쉬움 |
각 항목이 실제로 갖는 의미도 달라요. “단일 작업 프로그래밍”은 일상적인 코딩 경험을 좌우해요. “이벤트 트리거”와 “백그라운드 실행”은 지켜보고 있지 않을 때도 Agent가 일할 수 있는지를 결정해요. “컨텍스트 관리”는 작업이 많아졌을 때 서로 간섭하지 않도록 해주고, “배포 비용”은 팀이 처음에 시간을 투자할 의향이 있는지에 직접적인 영향을 줘요.
Claude Code의 멀티 에이전트 능력도 만만치 않아요
Anthropic 공식 문서에 따르면 Claude Code의 Subagents는 독립적인 컨텍스트 윈도우를 갖고 있어요. 전용 시스템 지침을 설정하고, 도구 사용 범위를 제한하거나 서로 다른 모델을 지정할 수도 있죠. 백그라운드에서 조사와 일부 구현 작업을 병렬로 수행하는 것도 가능해요. 실험적 기능인 Agent Teams는 여기서 한 걸음 더 나아가요. 한 명의 Lead와 여러 Teammate가 각각 독립적인 Claude Code 세션으로 작동하며, 작업 목록을 공유하고 팀원끼리 직접 메시지를 주고받을 수 있어요. 이 기능은 기본적으로 꺼져 있으며, 공식 문서에서도 조율 부담과 토큰 소비가 늘어난다고 안내해요.
이벤트 대응과 지속 실행 기능도 살펴볼게요. claude-code-action은 Issue와 PR 댓글의 @claude에 응답하고, 적절하게 설정하면 Issue를 PR로 전환할 수 있어요. 연구 프리뷰로 제공되는 Channels는 MCP를 통해 채팅 메시지, Webhook, CI 결과를 실행 중인 세션에 전달하지만, 세션을 계속 실행해 둬야 해요. 이 밖에도 세션 내 /loop, 데스크톱 예약 작업, 클라우드 예약 작업이 있어요. 일부 작업은 로컬 컴퓨터를 끈 뒤에도 클라우드에서 계속 실행할 수 있죠. 따라서 “Claude Code는 수동적으로 입력만 기다린다”는 인식은 이미 오래된 이야기에요.
Codex의 멀티태스킹 능력: 제품과 API를 구분해서 살펴봐야 해요
Codex는 Git Worktree를 활용해 하나의 프로젝트에 여러 독립적인 작업 디렉터리를 만들고, 서로 다른 세션에서 각기 다른 브랜치를 병렬로 수정할 수 있어요. Codex Cloud는 격리된 작업 공간에서 코드를 분석하고, 변경 사항을 구현하고, 테스트를 실행해요. 로컬 컴퓨터를 꺼도 클라우드 작업은 계속 진행돼요. ChatGPT/Codex 생태계는 백그라운드 예약 작업도 지원하며, 자격을 갖춘 사용자는 GitHub 등 앱 이벤트를 통한 작업 실행과 PR 활동 필터링도 이용할 수 있어요.
여기서 혼동하기 쉬운 점이 있어요. OpenAI Agents API와 Responses API가 제공하는 멀티 에이전트 기능은 API 기능이에요. 메인 에이전트가 하위 에이전트에 작업을 분배하고, 하위 에이전트가 독립적인 컨텍스트를 갖는 기능이죠. 이를 Codex의 모든 제품 인터페이스에서 기본으로 제공하는 기능과 동일시할 수는 없어요. 마찬가지로 OpenAI Cookbook에서 소개하는 “CI 실패 후 GitHub Actions로 Codex CLI를 호출해 수정 PR을 생성하는 방법”은 워크플로를 구축하는 방식이지, Codex CLI에 기본 내장된 기능은 아니에요.
DeepSeek Super-agent의 Router + Worker 스케줄링
DeepSeek 프로토타입의 핵심 흐름은 Source → Trigger → Eval → Ticket → Assignment → Executor → Result로 요약할 수 있어요. GitHub나 Feishu에서 이벤트가 들어오면 먼저 결정론적 규칙으로 권한을 필터링하고, 모델이 작업 생성 여부를 판단해요. 수락된 작업은 별도 Ticket으로 생성되어 독립 작업 디렉터리를 가진 Worker에 할당되고, 결과는 GitHub PR처럼 원래 채널로 반환돼요.
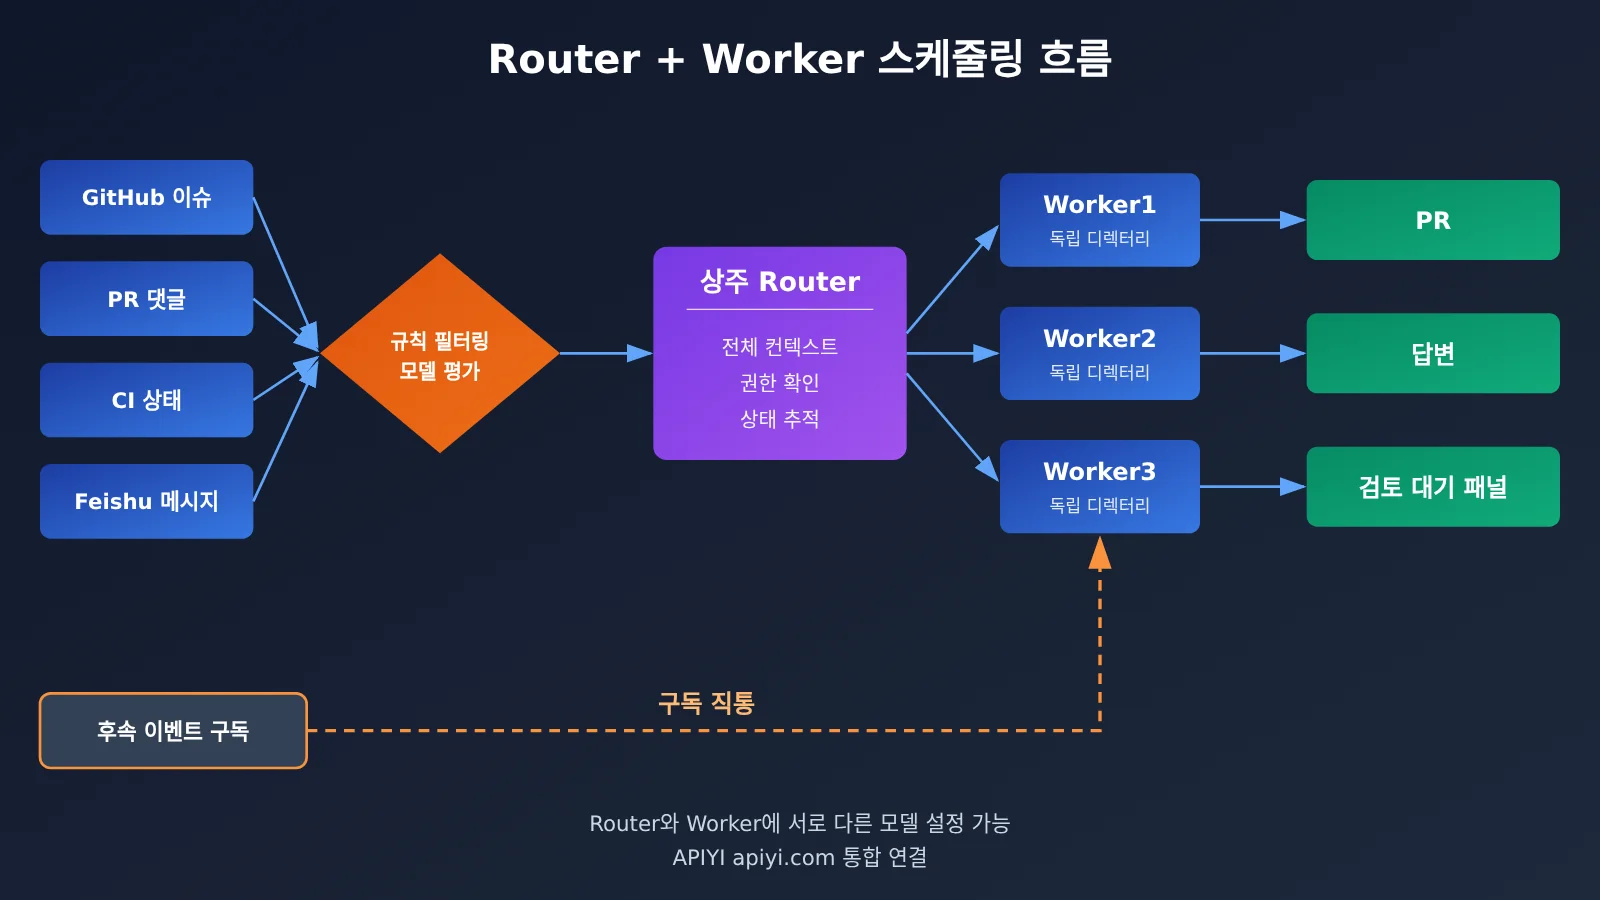
Router는 장기간 실행되는 메인 세션이에요. 메시지 수신, 전역 컨텍스트 유지, 작업 생성 판단, 권한 확인, 작업 할당과 추적을 담당하며, 원칙적으로 복잡한 코딩은 맡지 않아요. 공식 설명에 따르면 이런 특성 덕분에 상황에 따라 더 가벼운 모델을 선택해 스케줄링 비용을 줄일 수 있어요. 반면 Worker는 명확한 작업 지시를 받아 격리된 디렉터리에서 코드를 작성하고, 테스트를 실행하고, 후속 피드백을 처리한 뒤 결과를 제출해요.
진짜 차이점: DeepSeek Super-agent 스케줄링 시스템의 설계 초점
Claude Code와 Codex에도 멀티 Agent, 백그라운드 작업, 이벤트 처리 기능이 있는데, DeepSeek의 차별점은 무엇일까요? 답은 기능의 유무가 아니라 누가 작업을 관리하는지, 그리고 관리 범위가 어디까지인지에 있어요.
일반적인 메인 Agent나 Agent Team의 Team Lead는 하나의 복잡한 작업을 계획하고 조율하며 결과를 취합하는 데 깊이 관여해요. 반면 DeepSeek의 Router는 여러 작업에 걸친 상위 수준의 조율에 집중해요. 상시 실행되는 Router 하나가 비교적 독립적인 여러 업무를 동시에 관리하죠. 사용자는 논리적으로 하나의 Super-agent만 상대하며 GitHub, Lark(飞书) 같은 업무 채널에서 직접 소통할 수 있어요. Worker 세션을 일일이 관리할 필요도 없고요.
DeepSeek도 Agent Team의 메인 Agent가 전체 상호작용과 작업 분배만 담당하고 직접 실행하지 않도록 설정하면 비슷한 2계층 아키텍처를 만들 수 있다고 인정해요. 따라서 Router + Worker 자체가 다른 곳에서는 구현할 수 없는 고유한 기능은 아니에요. 진짜 차이는 상시 이벤트 감지, 작업 간 라우팅, 통합 업무 컨텍스트를 체계화한 정도에 있어요. 구체적으로는 세 가지예요.
- 상시 실행 Router: 작업마다 임시로 실행되는 조율자가 아니라 장기간 온라인 상태를 유지하는 메인 세션이에요. 전체 컨텍스트도 작업이 바뀌어도 이어져요.
- 이벤트 구독 직접 전달: 특정 Thread를 구독한 Worker가 후속 이벤트를 직접 받을 수 있어요. 예를 들어 같은 PR에 새 댓글이 달리면 Router가 다시 분배할 필요가 줄어들어요.
- 보수적인 능동성: 작업을 Explicit(명시적 요청)과 Inferred(추론된 후보)로 나눠요. 추론된 작업은 기본적으로
observe모드에서 기록만 하고 실행하지 않으며, PR 자동 병합도 기본적으로 꺼져 있어요.
DeepSeek Super-agent 공식 실험 데이터 읽는 법
DeepSeek은 합성 데이터로 스케줄링 실험을 진행했어요. 매회 약 300개 메시지 중 약 20개는 작업 요청이고, 나머지는 잡담, 후속 피드백, 취소 요청, CI 메시지였어요. 프로그래밍 작업은 일정 시간이 걸리는 모의 도구로 대체했고, 각 방식을 5회 실행했어요.
| 방식 | P50 완료 시간 | P95 완료 시간 | 회당 캐시 읽기 토큰 |
|---|---|---|---|
| Super-agent | 12.4분 | 15.7분 | 약 2,320만 |
| Super-agent, 구독 직접 전달 제거 | 12.6분 | 15.5분 | 약 3,180만 |
| 단일 Session + Subagent, 중립적 프롬프트 | 20.4분 | 29.5분 | 약 610만 |
| 단일 Session + Subagent, 위임 우선 | 13.8분 | 29.0분 | 약 1,080만 |
이 데이터에서 주목할 점은 두 가지예요. 첫째, 위임 우선 단일 세션 방식과 비교하면 Super-agent의 P50 우위는 작지만 P95는 훨씬 짧아요. 2계층 아키텍처의 주요 이점이 작업이 많아질 때 오래 지연되는 경우를 줄이는 것임을 보여줘요. 둘째, 구독 직접 전달을 제거해도 완료 시간은 거의 변하지 않았지만, 캐시 읽기는 약 2,320만에서 약 3,180만으로 늘었어요. 즉, 구독 직접 전달의 주된 역할은 속도 향상보다 Router의 중복 처리를 줄이는 데 있어요.
다만 해석의 범위를 분명히 해야 해요. 이 실험은 코드 생성 품질이 아닌 스케줄링을 테스트한 것이에요. 비교 대상도 특정 프롬프트를 적용한 단일 Session + Subagent이지, Claude Code나 Codex의 완제품을 같은 조건에서 실측한 결과가 아니에요. 따라서 실제 프로그래밍 효율이 39% 또는 47% 향상됐다는 근거로 삼을 수 없고, 세 제품의 속도 순위를 매길 수도 없어요. 공식적으로 공개된 또 다른 Router 일괄 처리 테스트에서는 분당 이벤트가 약 40개일 때 평균 배치 크기가 2.8로 늘고, 결정당 평균 추론 시간이 1.6초로 줄었어요. 이 역시 해당 테스트 부하에서 사용 가능하다는 점만 보여줘요.
DeepSeek Super-agent의 비용과 보안 경계
속도가 빨라지는 대신 Token을 더 많이 사용해요. 합성 테스트에서 Super-agent의 캐시 읽기량은 중립적인 단일 세션 방식의 약 3.8배였어요. 하지만 총비용도 3.8배가 된다는 뜻은 아니에요. 실제 비용은 모델 가격, 캐시 적중률, 입력과 출력 Token 양, Router와 Worker에 사용하는 모델에 따라 달라져요. 공식 문서에서도 실제 작업 요청 한 건당 평균 비용은 아직 공개하지 않았어요.
참고로 아래는 2026년 11월 2일 기준 DeepSeek 공식 API 가격이에요. 단위는 100만 Token당 미국 달러이며, Super-agent 요금제가 아닌 모델 사용 요금이에요.
| 모델 및 시간대 | 입력 캐시 미적중 | 입력 캐시 적중 | 출력 |
|---|---|---|---|
| DeepSeek V4.1 Flash 비혼잡 시간 | $0.15 | $0.003 | $0.60 |
| DeepSeek V4.1 Flash 혼잡 시간 | $0.30 | $0.006 | $1.20 |
| DeepSeek V4 Pro 비혼잡 시간 | $0.66 | $0.022 | $1.98 |
| DeepSeek V4 Pro 혼잡 시간 | $1.32 | $0.044 | $3.96 |
Search와 Fetch는 각각 성공한 요청 1,000건당 $0.75예요. 2026년 11월 1일 베이징 시간 00:00부터 과금이 시작됐으며, 실제 호출할 때만 비용이 발생해요. 직접 배포한다면 서버 자원, 상시 운영비, 인력 유지보수 비용도 고려해야 해요. Claude Code와 Codex는 구독, API, 클라우드 실행 등 요금제가 다양해 현재 세 서비스를 통일된 ‘기준을 충족한 PR당 비용’으로 비교하기는 어려워요.
💰 비용 관리 팁: 멀티 Agent 아키텍처의 비용은 ‘어떤 역할에 어떤 모델을 쓰는가’에 크게 좌우돼요. Router에는 경량 모델을, Worker에는 고성능 모델을 쓰는 조합을 시험해 보고 싶다면 APIYI apiyi.com에서 API 키 하나로 여러 주요 모델에 접근할 수 있어요. 사용량에 따라 과금되므로 하나의 청구서에서 조합별 Token 사용 비용을 확인하기 편해요.
보안도 간과할 수 없어요. 공식 배포 문서에 따르면 Router와 Worker의 전용 프리셋은 danger-full-access 모드로 실행돼요. 기본적으로 운영자의 시스템 사용자 권한을 사용하므로 홈 디렉터리의 파일을 읽고, 로컬 프로그램을 실행하거나, 로컬 인증 정보에 접근할 수 있어요. 공식 문서는 별도의 시스템 사용자와 GitHub 봇 계정을 사용하도록 권장해요.
외부 댓글과 메시지를 수신하는 과정에서는 프롬프트 인젝션 위험도 생겨요. 커뮤니티에는 commit 6337fc8을 대상으로 관리 인터페이스의 검증 등에서 잠재적 문제를 지적한 제3자 감사 보고서도 나왔어요. 다만 전체 공격 과정이 독립적으로 재현되지는 않았으므로, 실제 발생한 사건이 아닌 ‘잠재적 위험’으로 봐야 해요.
DeepSeek Super-agent 영향 분석
개발자에게 미치는 영향
- 평가 기준을 넓혀야 해요: 도구를 선택할 때 기반 모델의 점수뿐 아니라 이벤트 연동, 작업 격리, 백그라운드 실행, 사람의 검토 절차가 팀의 업무 흐름에 맞는지도 살펴봐야 해요.
- 프로토타입은 쓸 수 있지만 손이 많이 가요: 커뮤니티 사용자 xxxxkkkqq는 비공개 저장소에서 Issue를 PR 단계까지 진행하는 데 성공했지만, 알림이 오지 않거나 배포 점검은 정상인데 메시지가 전달되지 않는 문제, 시스템 언어가 중국어라 테스트 단언이 실패하는 문제도 겪었어요. 다른 사용자는 WSL2에서 한 시간 만에 Node.js 24 프로세스 인식 오류와 GitHub 댓글 누락이라는 두 가지 결함을 발견했어요.
- 추가 개발에 활용할 가치가 커요: TypeScript, GitHub 연동, 모델 API를 유지보수할 수 있는 팀이라면 Router, 이벤트, 작업 티켓, Worker, 권한 규칙을 아우르는 참조 구현으로 활용할 수 있어요.
업계에 미치는 영향
- 경쟁의 초점이 넓어지고 있어요: AI 코딩의 경쟁은 더 이상 모델 간 대결에만 국한되지 않아요. Agent Harness, 워크플로 설계, 개발자 경험도 그만큼 중요한 요소가 되고 있어요.
- ‘능동형 Agent’가 체계를 갖춰가고 있어요: DeepSeek는 ‘능동적인 작업’을 권한 정책, observe 모드, 사람의 최종 검토와 결합해 “Agent가 팀의 주의를 낭비하지 않을까?”라는 현실적인 우려에 대응했어요.
이러한 기능을 고려하면 작업 방식에 따라 다음과 같이 선택할 수 있어요.
| 작업 방식 | 추천 조합 | 이유 |
|---|---|---|
| 일상적인 단일 코딩 작업 | Claude Code 또는 Codex | 정식 제품으로 시작하기 쉽고 스케줄링 시스템을 배포할 필요가 없어요 |
| 독립적인 여러 작업의 병렬 처리 | Claude Code Agent Teams / 백그라운드 Agent, Codex Worktrees / 클라우드 작업 | 이미 성숙한 병렬 처리 및 격리 메커니즘을 갖추고 있어요 |
| 장기적인 이벤트 감지와 통합 라우팅 연구 | DeepSeek Super-agent 프로토타입 | 상시 실행되는 Router와 이벤트 구독 설계를 가장 직접적으로 보여줘요 |
| 자체 Agent 오케스트레이션 시스템 구축 | 오픈소스 프로토타입 + 멀티모델 API | 스케줄링 로직과 모델별 역할을 자유롭게 설정할 수 있어요 |
| 보안에 민감한 프로덕션 저장소 | 연구용 프로토타입을 직접 사용하는 것은 아직 권장하지 않아요 | 높은 권한으로 실행하는 데 따른 보안 문제 등을 아직 보완해야 해요 |
🎯 선택 가이드: 도구를 꼭 하나만 선택할 필요는 없어요. 많은 팀이 일상적인 코딩은 Claude Code나 Codex에 맡기고, 자체 스케줄링 계층으로 이벤트와 라우팅을 처리해요. 자체 계층을 구축할 때는 먼저 APIYI apiyi.com에서 무료 테스트 크레딧을 받아 여러 모델이 Router와 Worker 역할을 얼마나 잘 수행하는지 비교해 볼 수 있어요.
API로 DeepSeek Super-agent의 Router 방식 구현하기
스케줄링 시스템을 이해하는 가장 좋은 방법은 최소한의 버전을 직접 만들어 보는 거예요. 아래 예제는 OpenAI 호환 인터페이스로 ‘경량 모델이 라우팅을 판단하는 방식’을 구현해요. 아이디어를 설명하기 위한 예제이며, DeepSeek 프로토타입의 실제 코드는 아니에요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

event = "PR #42 评论:CI 在 test_auth.py 失败,请帮忙看看"
resp = client.chat.completions.create(
    model="ROUTER_MODEL",  # 替换为控制台中可用的轻量模型名
    messages=[{"role": "user", "content": f"判断该事件是否需要建任务,只回答 YES/NO:{event}"}]
)
print(resp.choices[0].message.content)
전체 Router + Worker 예제 코드 보기
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一个 Key 接入多家模型
)

ROUTER_MODEL = "ROUTER_MODEL"   # 轻量模型:负责路由判断
WORKER_MODEL = "WORKER_MODEL"   # 强模型:负责具体任务
AUTHORIZED_USERS = {"alice", "bob"}  # 确定性规则:授权名单

@dataclass
class Ticket:
    thread_id: str
    task: str
    history: list = field(default_factory=list)

tickets: dict[str, Ticket] = {}

def router_eval(event: dict) -> bool:
    """先规则过滤,再由模型判断是否建任务"""
    if event["user"] not in AUTHORIZED_USERS:
        return False  # 未授权:仅观察,不执行
    resp = client.chat.completions.create(
        model=ROUTER_MODEL,
        messages=[
            {"role": "system", "content": "你是任务路由器,只回答 YES 或 NO。"},
            {"role": "user", "content": f"该消息是否是需要执行的工作请求?\n{event['text']}"}
        ],
        max_tokens=5
    )
    return "YES" in resp.choices[0].message.content.upper()

def worker_run(ticket: Ticket, text: str) -> str:
    """Worker 使用独立上下文处理任务"""
    ticket.history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model=WORKER_MODEL,
        messages=[{"role": "system", "content": "你是代码修复助手,给出修复思路。"}] + ticket.history
    )
    answer = resp.choices[0].message.content
    ticket.history.append({"role": "assistant", "content": answer})
    return answer

def handle(event: dict) -> str:
    tid = event["thread_id"]
    # 订阅直通:已有 Ticket 的后续事件直接交给对应 Worker
    if tid in tickets:
        return worker_run(tickets[tid], event["text"])
    if router_eval(event):
        tickets[tid] = Ticket(thread_id=tid, task=event["text"])
        return worker_run(tickets[tid], event["text"])
    return "已记录,未建任务"

print(handle({"thread_id": "pr-42", "user": "alice", "text": "CI 在 test_auth.py 失败"}))
print(handle({"thread_id": "pr-42", "user": "alice", "text": "补充:只在 Python 3.12 下失败"}))
이 예제에는 세 가지 특징이 있어요. 모델 판단에 앞서 결정적 규칙을 적용하고, Router와 Worker에 서로 다른 모델을 사용하며, 같은 Thread의 후속 이벤트는 기존 Worker의 컨텍스트로 바로 전달해요. 실제 시스템에는 작업 디렉터리 격리, 권한 샌드박스, 상태 영속화, 사람의 검토도 필요해요. 프로토타입에서도 아직 보완 중인 부분이에요.
🚀 빠르게 시작하기: 위 코드는 API 키와 모델 이름만 바꾸면 실행할 수 있어요. APIYI apiyi.com 콘솔에서 현재 사용 가능한 모델 목록을 확인해 보세요. 신규 사용자에게는 무료 테스트 크레딧이 제공되므로, 낮은 비용으로 스케줄링 방식을 검증한 뒤 추가 개발 여부를 결정하기 좋아요.
자주 묻는 질문 FAQ
Q1: DeepSeek Super-agent는 새로운 모델인가요?
아니요. Super-agent는 모델 외부에서 작동하는 Agent 시스템 아키텍처이며, 오픈소스로 공개된 것은 DeepSeek Harness 기반 연구 프로토타입이에요. 특정 DeepSeek 모델을 반드시 사용해야 하는 것은 아니며, 설정에서 Router와 Worker 각각의 모델 제공업체와 모델을 지정할 수 있어요.
Q2: DeepSeek Super-agent가 Claude Code와 Codex를 대체할까요?
현재로서는 그렇게 말할 근거가 없어요. 세 제품은 역할이 달라요. Claude Code와 Codex는 성숙한 코딩 Agent 제품이고, Super-agent는 외부에서 작업을 지속적으로 스케줄링하는 데 중점을 둬요. 11월 2일 기준 동일한 조건에서 대규모로 진행한 공개 코딩 비교도 없으며, 공식 합성 실험을 세 제품의 성능 비교 결과로 볼 수는 없어요.
Q3: Claude Code와 Codex도 이벤트 트리거와 백그라운드 작업을 처리할 수 있나요?
네. Claude Code는 GitHub Actions, 연구 미리보기 단계의 Channels, 백그라운드 Agent, 클라우드 예약 작업을 제공해요. Codex 생태계에는 클라우드 작업, Worktrees, 백그라운드 예약 작업, 지원되는 앱의 이벤트 자동화 기능이 있어요. 차이는 기능의 유무가 아니라 사용 경로, 자격 요건, 구현 방식에 있어요.
Q4: DeepSeek Super-agent 프로토타입은 무료인가요?
코드는 MIT 라이선스로 무료 공개되어 있지만, 모델 호출에는 여전히 토큰 기준 요금이 부과되며 서버, 유지보수, 사람의 검토 비용도 들어요. 오픈소스라고 해서 모든 작업의 총비용이 더 낮은 것은 아니에요. 여러 모델의 API 비용을 통합 관리하고 싶다면 APIYI apiyi.com에서 사용량 기준으로 호출하고 사용 내역을 한곳에서 확인할 수 있어요.
Q5: Router + Worker 방식으로 여러 모델의 역할을 나누는 실험을 저렴하게 하려면 어떻게 해야 하나요?
본문의 예제 코드를 참고해 `base_url`을 `https://api.apiyi.com/v1`로 설정하고, 경량 모델은 라우팅에, 고성능 모델은 작업 실행에 사용할 수 있어요. APIYI apiyi.com에 가입하면 무료 테스트 크레딧을 받을 수 있으며, 하나의 API 키로 OpenAI, Claude, Gemini 등 주요 모델을 전환하며 비교할 수 있어요.
Q6: DeepSeek Super-agent 프로토타입의 알려진 한계는 무엇인가요?
현재 단일 github.com 저장소만 감시할 수 있고 GitHub Enterprise Server는 지원하지 않아요. 배포하려면 Node.js 22.19+ 또는 24+, tmux, GitHub CLI 2.48+와 전용 봇 계정이 필요해요. Worker는 기본적으로 높은 권한으로 실행되므로 프롬프트 인젝션과 자격 증명 관련 위험이 있어요. 커뮤니티에서는 알림 누락과 Node.js 24 호환성 문제도 보고되어 민감한 프로덕션 저장소에 바로 사용하는 것은 권장하지 않아요.
DeepSeek Super-agent와 Claude Code, Codex 비교 핵심 요약 Key Takeaways
- 비교 대상의 계층이 달라요: Super-agent는 오케스트레이션 시스템 프로토타입이고, Claude Code와 Codex는 코딩 Agent 제품이에요.
- 멀티 Agent가 독점 기능은 아니에요: Claude Code와 Codex도 서브 Agent, 병렬 세션, 백그라운드 작업과 이벤트 기능을 제공해요.
- 진짜 차이는 체계적인 설계에 있어요: 상시 실행되는 Router, 작업 간 라우팅, 구독 이벤트의 직접 전달과 통합 컨텍스트가 핵심이에요.
- 실험 데이터에는 한계가 있어요: 합성 환경의 오케스트레이션 실험은 조정 성능만 보여줄 뿐, 코딩 품질이나 세 제품의 순위를 뜻하지 않아요.
- 속도를 얻는 대신 토큰을 더 써요: 캐시 읽기량이 단일 세션 방식의 약 3.8배로, 비용은 모델 조합에 따라 따로 계산해야 해요.
- 보안을 먼저 고려해야 해요: 높은 권한으로 실행하거나 외부 입력을 받을 때의 인젝션 위험에 대비해 별도 계정과 사람의 검수가 필요해요.
- 직접 검증하는 편이 더 확실해요: APIYI apiyi.com의 키 하나로 여러 모델을 활용한 Router와 Worker 역할 분담을 시험해 볼 수 있어요.
정리
DeepSeek Super-agent와 Claude Code, Codex를 비교한 핵심 결론은 다음과 같아요.
- 가장 큰 차이는 계층이에요: 모델 성능, 코딩 도구의 기능, 오케스트레이션 시스템의 기능은 서로 다르므로 한데 섞어 비교하기 어려워요.
- DeepSeek의 가치는 오케스트레이션 설계에 있어요: 상시 이벤트 감지, 작업 간 라우팅, 통합 컨텍스트를 체계화하고 권한 부여와 observe 모드로 자율적인 동작을 제어해요.
- 완성도 차이는 분명해요: 프로토타입에도 Issue에서 PR까지 이어진 실제 사례가 있지만, 설치 편의성·안정성·보안은 더 다듬어야 해요. 일상적인 코딩에는 여전히 Claude Code와 Codex가 더 안정적인 선택이에요.
AI 코딩 경쟁은 “어떤 모델이 더 강한가”를 넘어 Agent Harness, 워크플로, 개발자 경험을 아우르는 경쟁으로 확장되고 있어요. 대부분의 팀에는 검증된 제품으로 일상적인 코딩을 처리하면서 자체 오케스트레이션 계층을 소규모로 시험하는 방법이 더 실용적이에요.
APIYI apiyi.com을 통해 여러 주요 모델에 통합 접속하고, 각 모델을 Router와 Worker로 활용했을 때의 성능과 비용을 빠르게 검증해 보세요.
📚 참고 자료
- DeepSeek Super-agent 공식 프로토타입 저장소: 프로젝트 현황, 소스 코드와 적용 범위
- 링크:
github.com/deepseek-ai/dsh-superagent-prototype -
설명: README, 배포 문서, 권한 부여 방식과 설계 철학 문서 포함
-
DeepSeek API 공식 가격표: 모델 가격과 Search/Fetch 비용
- 링크:
api-docs.deepseek.com/quick_start/pricing -
설명: Router/Worker 모델 비용 산정 기준
-
Claude Code Subagents 및 Agent Teams 문서: 멀티 Agent 기능 설명
- 링크:
code.claude.com/docs/en/sub-agents,code.claude.com/docs/en/agent-teams -
설명: 하위 Agent의 독립적인 컨텍스트와 팀 협업 방식 안내
-
Claude Code Channels 및 예약 작업 문서: 이벤트 푸시와 지속 실행
- 링크:
code.claude.com/docs/en/channels,code.claude.com/docs/en/scheduled-tasks -
설명: 연구 프리뷰 기능의 사용 조건과 제한 사항 안내
-
Codex Cloud 및 Worktrees 문서: 클라우드 작업과 병렬 작업 공간
- 링크:
help.openai.com/en/articles/20001545-using-codex-cloud,learn.chatgpt.com/docs/environments/git-worktrees -
설명: Codex 제품 기능을 구분하는 공식 자료
-
OpenAI Agents API Multi-agent 가이드: API 수준의 멀티 Agent 오케스트레이션
- 링크:
developers.openai.com/api/docs/guides/agents-api/multi-agent -
설명: Codex 제품 기능과 구분해서 살펴보세요
-
DeepSeek Harness 커뮤니티 실사용 논의: 이슈부터 PR까지의 전체 과정 보고서
- 링크:
github.com/deepseek-ai/deepseek-harness/discussions/11706 - 설명: 프로토타입의 실제 실행 결과와 자주 발생하는 문제 안내
작성자: APIYI 기술팀
기술 교류: APIYI 공식 홈페이지에서 문의해 주세요. 여러 모델의 연동과 Agent 오케스트레이션에 관한 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.