Nota del autor: comparo Gemini 4 Argon y Carbon en esfuerzo de razonamiento, velocidad de respuesta y costo por tarea, para ayudarte a elegir el modelo según la dificultad de lo que necesitas resolver.
Google lanzó Gemini 4 Argon el 13 de octubre de 2026, presentó Carbon por primera vez el 28 de octubre y lo abrió oficialmente a desarrolladores, empresas y usuarios el 10 de noviembre. La primera pregunta de muchos desarrolladores fue: ¿Carbon es el reemplazo mejorado de Argon? En este artículo comparamos las diferencias reales entre ambos en 5 dimensiones: esfuerzo de razonamiento, latencia de respuesta, costo por tarea, escenarios de uso y niveles de razonamiento.
Esto no es un análisis que concluya que «lo más potente siempre es mejor». La documentación oficial para desarrolladores de Google ya aclara que Argon sigue siendo la opción recomendada para la mayoría del trabajo de ingeniería y de conocimiento, mientras que Carbon está pensado para tareas que requieren un razonamiento más profundo y ciclos de verificación más largos. Este artículo se basa principalmente en la documentación oficial de Google; los datos de terceros indican la versión de evaluación y el nivel de razonamiento usado.
Lo que te llevas: al terminar sabrás qué tareas conviene dejar en Argon, cuáles justifican usar Carbon y cómo usar Thinking Level para equilibrar calidad, velocidad y costo.
7 términos que conviene conocer antes de comparar Gemini 4 Argon y Carbon
Al comparar dos modelos de razonamiento, hay varios conceptos que se suelen mezclar. Si los separamos desde el principio, los datos que vienen después no se malinterpretan:
- Nivel de razonamiento (Thinking Level): el ajuste que controla cuánto esfuerzo dedica el modelo a pensar. Carbon ofrece tres niveles: LOW, MEDIUM y HIGH.
- Tokens de razonamiento: los tokens que genera el modelo mientras razona. Se facturan como tokens de salida.
- Costo por tarea: lo que cuestan todas las invocaciones del modelo necesarias para completar una tarea. No es lo mismo que el costo de una sola solicitud.
- Latencia de razonamiento: el tiempo que pasa desde que el modelo recibe la solicitud hasta que produce un resultado. En este artículo nos fijamos sobre todo en la latencia del primer token de la respuesta.
- Lectura de caché: una forma de facturación que reutiliza un contexto de entrada ya existente, con un precio mucho menor que el de la entrada normal.
- Agente: un sistema que ejecuta tareas de varios pasos mediante herramientas, por ejemplo escribir código, ejecutar pruebas y luego corregir errores.
- Benchmark (prueba de referencia): un método para evaluar y comparar modelos con un conjunto fijo de tareas. Sus conclusiones solo son válidas para esa configuración de prueba.
Por qué Google lanza Gemini 4 Argon y Carbon al mismo tiempo
Según la ficha del modelo Carbon de Google DeepMind, Gemini 4 Carbon está construido sobre Gemini 4 Argon. Es decir, comparten una base común, y Carbon es una versión reforzada para razonamiento de alta dificultad, ingeniería de software compleja, flujos de trabajo de agentes de larga duración, investigación científica y defensa en ciberseguridad. Ahora bien, Google no ha revelado el número de parámetros de Carbon ni ha publicado las diferencias de arquitectura de cómputo interna entre ambos, así que afirmaciones como «Carbon es varias veces más grande que Argon» no tienen respaldo.
Si Carbon es más potente, ¿por qué no sustituye directamente a Argon? Porque cada uno resuelve un tipo de trabajo distinto. El desarrollo diario de funcionalidades y las modificaciones de código con mucha interacción dependen más de la velocidad de respuesta y del gasto de tokens en cada turno. En cambio, tareas como el diseño de arquitectura, la investigación de causas raíz que cruzan varios subsistemas o las demostraciones científicas dependen más de que el modelo pueda plantear hipótesis, verificarlas y corregirlas una y otra vez. La recomendación de Google en su documentación para desarrolladores también habla de reparto de funciones, no de reemplazo: Argon se encarga de la mayor parte de la ingeniería cotidiana y Carbon de las tareas de razonamiento más difíciles y de más largo aliento.
Este reparto también se ve en los productos de Google. En la función en vista previa multiagente /swarm de Antigravity, Google recomienda que Carbon asuma el diseño de la arquitectura general, la coordinación de tareas y la revisión de seguridad, mientras que la implementación de código rutinario y las modificaciones de archivos en paralelo se dejan a modelos más rápidos y ligeros. Lo mismo ocurre en el lado del consumidor: los beneficios de modelo de la suscripción Google AI Pro son principalmente de Argon, y solo la suscripción Ultra incluye Carbon.
Diferencias clave entre Gemini 4 Argon y Carbon: cuánto razonan en cada turno
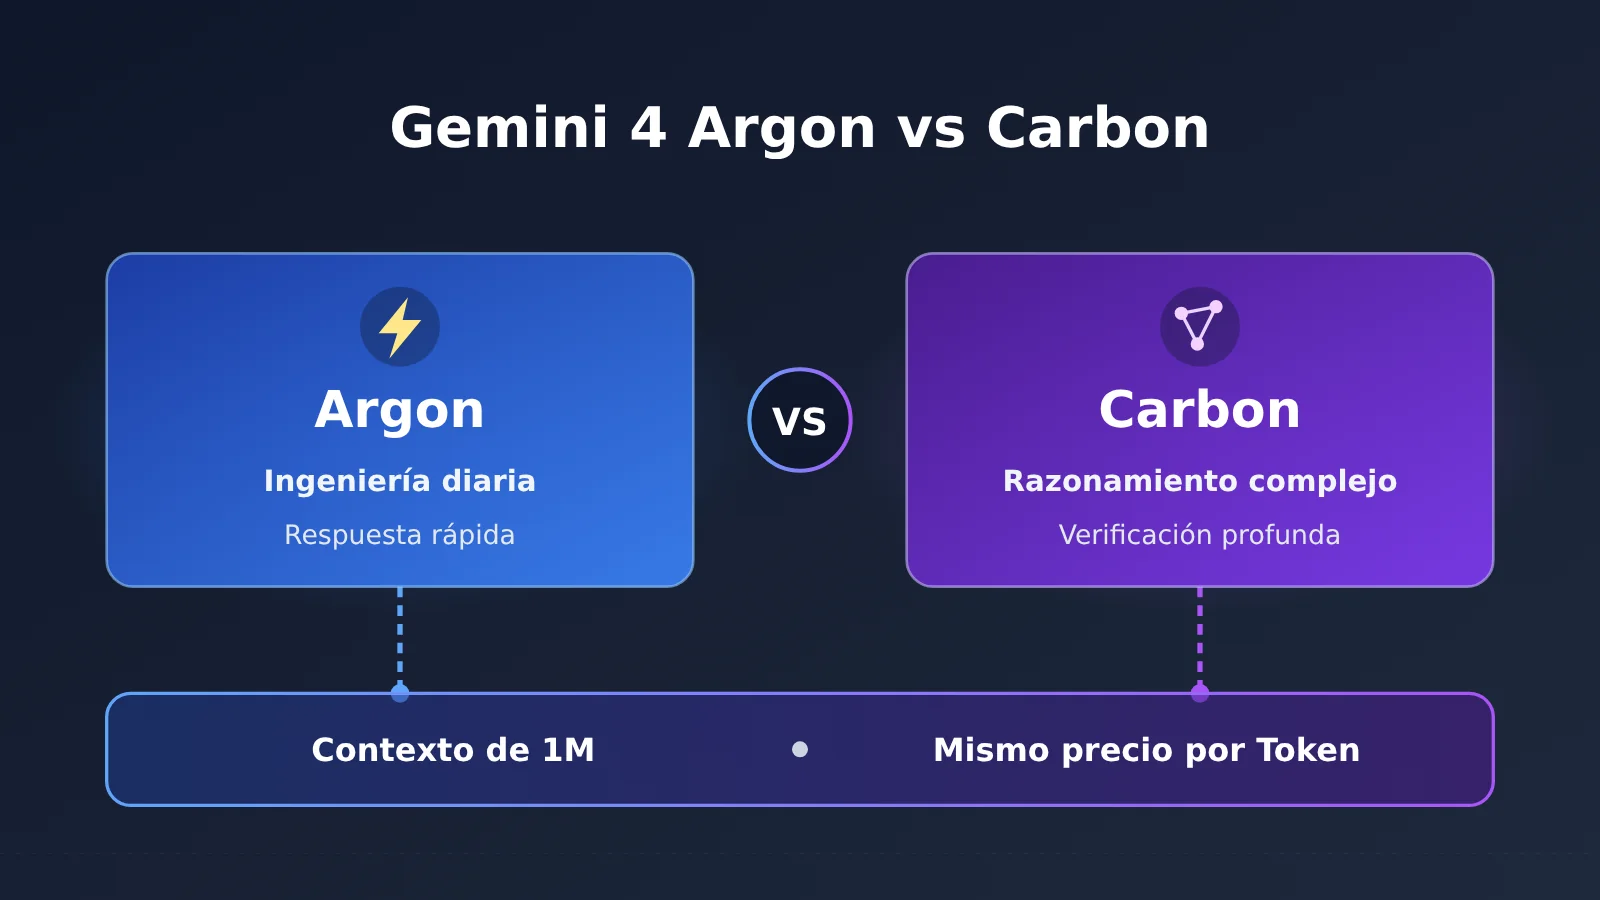
Google da la explicación más directa en la sección «Choosing between Carbon and Argon» de la guía para desarrolladores de Carbon. Carbon gasta más tokens de pensamiento en cada turno para explorar y verificar su propio trabajo con más profundidad. Argon, en cambio, responde más rápido y consume menos tokens por turno, así que encaja mejor con la programación interactiva y el desarrollo de funcionalidades del día a día. Los dos comparten una ventana de contexto unificada de 1M tokens (1.048.576 tokens, compartidos entre entrada y salida), comparten las mismas herramientas integradas y tienen el mismo precio por token.
| Dimensión | Gemini 4 Argon | Gemini 4 Carbon | Más adecuado |
|---|---|---|---|
| Posicionamiento | Modelo de razonamiento general, de alto rendimiento y eficiente | Modelo de razonamiento más profundo para tareas complejas | Depende de la tarea |
| Tokens de pensamiento por turno | Relativamente pocos | Usa más en cada turno | Argon ahorra más |
| Velocidad de respuesta | Más rápida | Más lenta en tareas complejas | Argon |
| Desarrollo interactivo | Más adecuado | Se puede usar en tareas de alta dificultad | Argon |
| Desarrollo de funcionalidades cotidianas | Recomendado | Normalmente innecesario | Argon |
| Diseño de arquitectura, investigación de causas raíz | Puede encargarse | Más adecuado para casos extremadamente complejos e investigaciones profundas | Carbon |
| Demostraciones científicas, auditorías de seguridad | Puede encargarse / compatible | Más adecuado para razonamiento y verificación complejos | Carbon |
| Contexto y precio por token | Contexto compartido de 1M, mismo precio | Contexto compartido de 1M, mismo precio | Empate |
La tabla deja claro que la línea que separa a Gemini 4 Argon de Carbon no es «si puede hacerlo o no», sino «si vale la pena pensarlo más». Argon también puede encargarse del diseño de arquitectura y de la investigación de causas raíz. Pero cuando el problema es tan complejo que exige varias rondas de hipótesis y verificación, Carbon está dispuesto a invertir más tokens de pensamiento para conseguir un resultado más fiable.
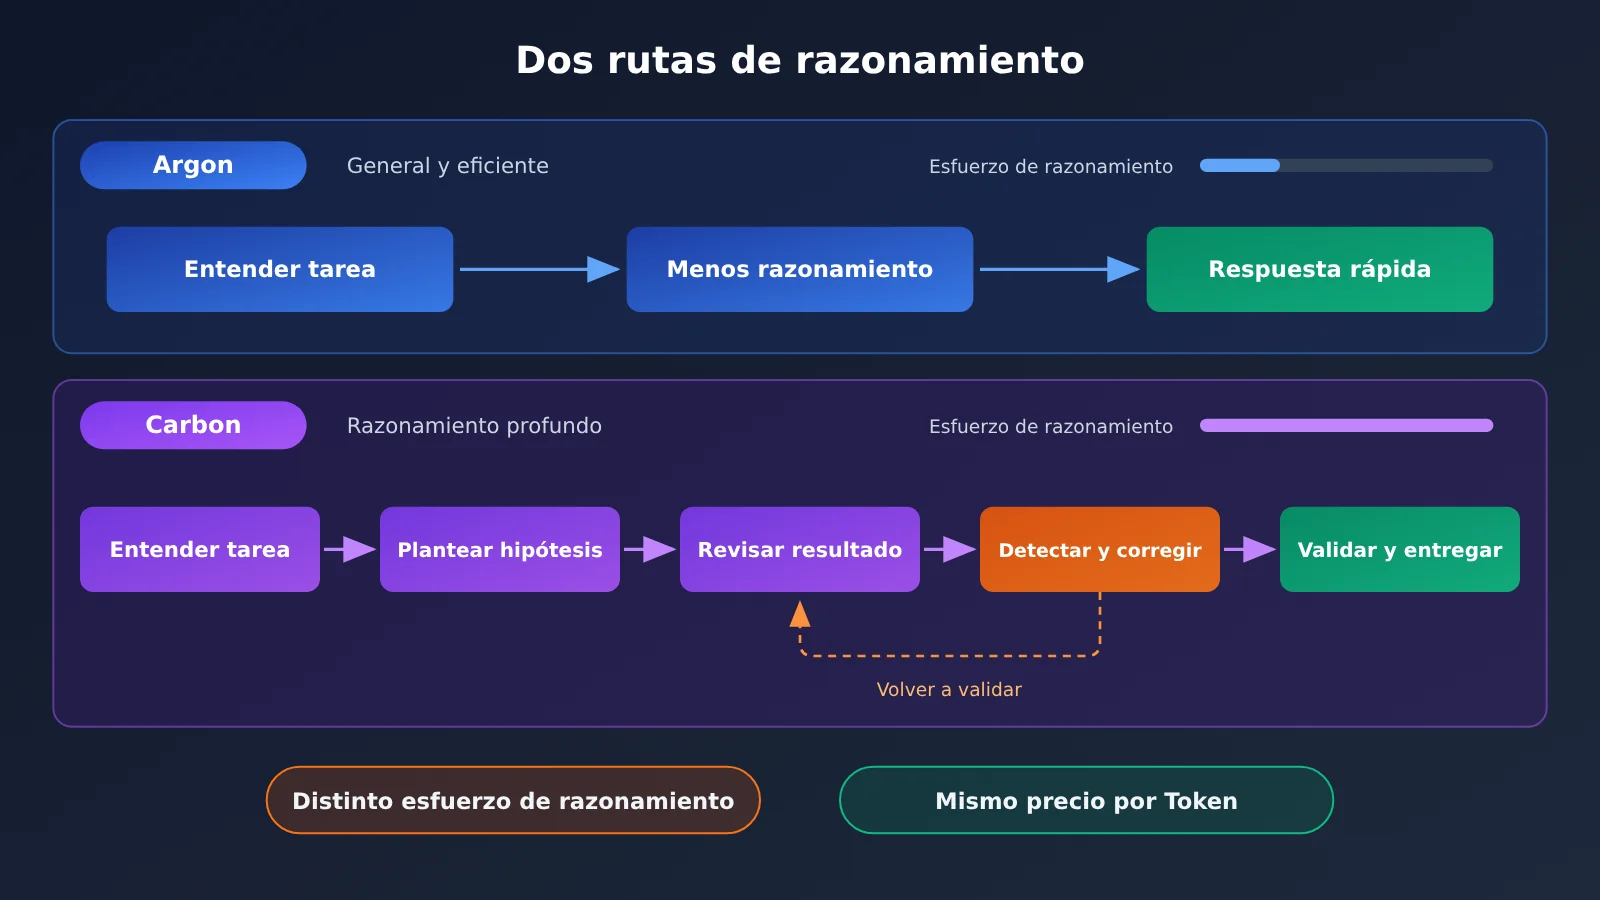
La forma de trabajar de Carbon se parece más a un ciclo de ejecución completo: entiende el objetivo y las restricciones, descompone la tarea, elabora un plan, llama a herramientas, revisa los resultados intermedios, identifica errores, los corrige, vuelve a verificar y, por último, entrega. Este ciclo le da ventaja en tareas de larga duración y explica también por qué tarda más en dar la primera respuesta.
Comparativa de benchmarks independientes: Gemini 4 Argon vs. Carbon
Las afirmaciones oficiales necesitan datos independientes que las respalden. Artificial Analysis ofrece, dentro de su Intelligence Index v5.0.1, una página de comparación directa entre Carbon y Argon. Todos los datos que verás a continuación corresponden a la configuración de razonamiento High.
| Métrica (AA v5.0.1, razonamiento High) | Carbon High | Argon High | Diferencia |
|---|---|---|---|
| Índice de capacidad global | 60 | 50 | Carbon +10 |
| AutomationBench-AA | 77.8% | 77.5% | Prácticamente empate |
| Terminal-Bench 4.0 | 65.2% | 57.1% | Carbon por delante |
| FrontierCode 2.0 | 40.6% | 25.7% | Carbon muy por delante |
| AA-Omniscience (puntuación de fiabilidad del conocimiento) | 54 | 46 | Carbon por delante |
| HLE-Diamond | 69.1% | 56.7% | Carbon por delante |
| Costo por tarea | $7.76 | $9.95 | Carbon más barato |
| Tiempo por tarea | 25.6 minutos | 28.9 minutos | Carbon más rápido |
| Latencia del primer token de respuesta | ~68 segundos | ~37 segundos | Argon más rápido |
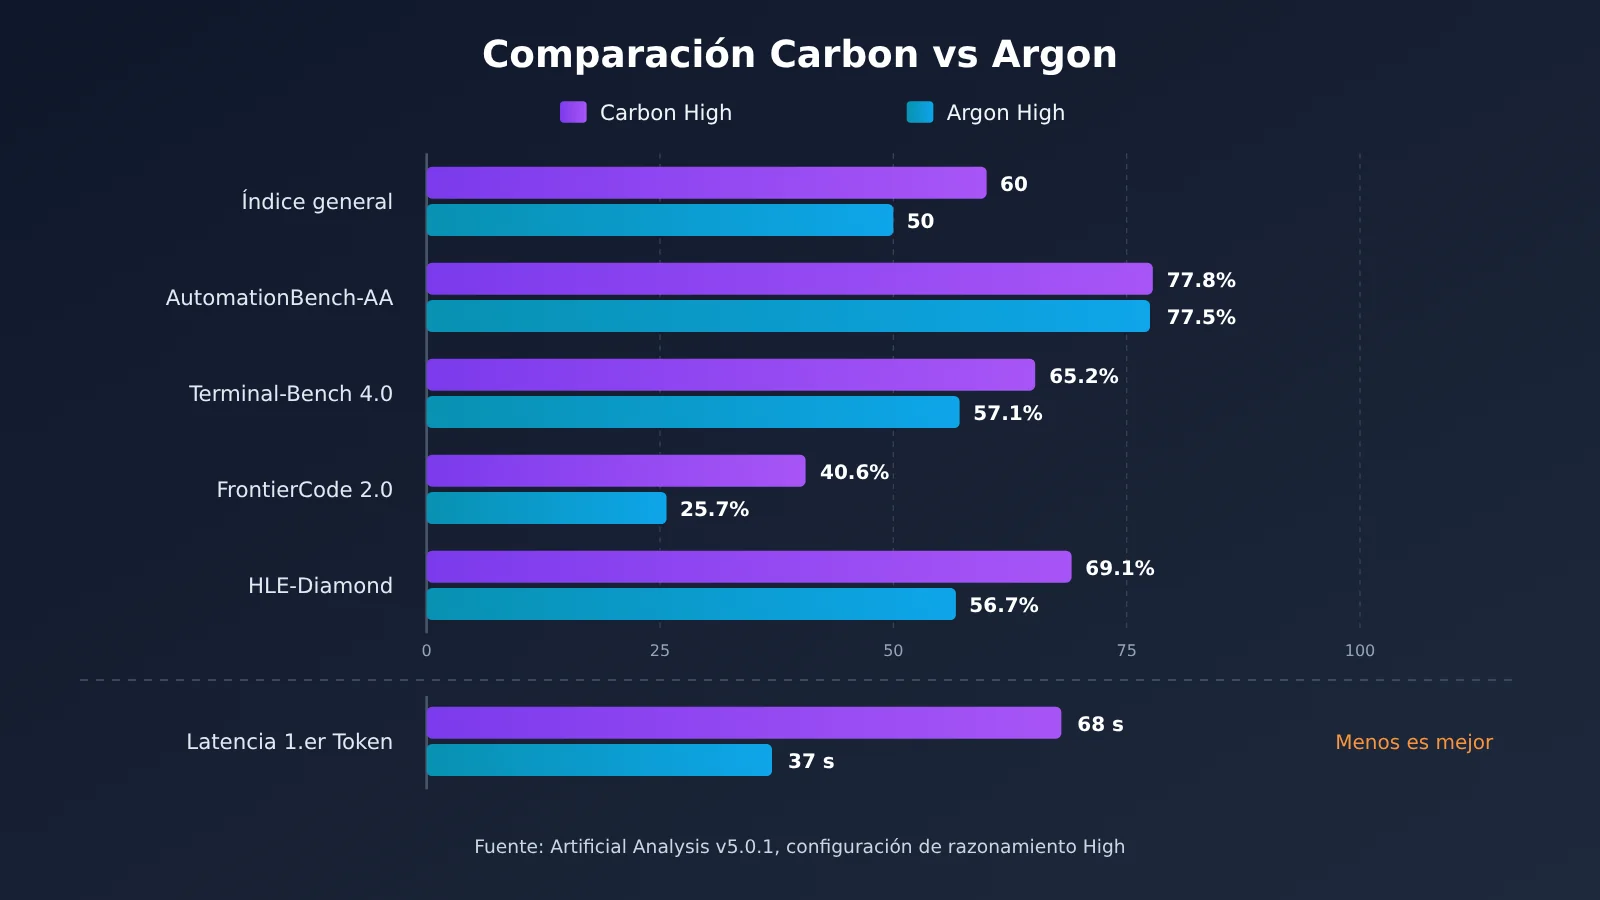
Algunas conclusiones que merece la pena destacar:
- La mayor brecha está en ingeniería compleja y razonamiento complejo: en FrontierCode 2.0 Carbon lleva casi 15 puntos porcentuales de ventaja, en HLE-Diamond unos 12 y en Terminal-Bench 4.0 unos 8.
- En tareas de automatización convencionales la diferencia es mínima: en AutomationBench-AA solo hay 0.3 puntos porcentuales de distancia, lo que indica que, para tareas automáticas basadas en flujos de trabajo, Argon ya es más que suficiente.
- Mejora en la fiabilidad del conocimiento: AA-Omniscience marca 54 frente a 46, y el Agentic Honesty Benchmark de la ficha del modelo de Google también muestra un 92% para Carbon frente a un 70% para Argon.
- Argon responde mucho antes: unos 37 segundos frente a unos 68, que es el costo directo de que Carbon dedique más esfuerzo al razonamiento.
La ficha oficial del modelo de Google (con la evaluación fechada en octubre de 2026, normalmente en Pass@1 y usando el nivel de razonamiento más alto disponible) muestra la misma tendencia: en SWE-sweep, Carbon obtiene un 9.6% y Argon un 4.3%; en GraphWalks (256k–1M, BFS F1), Carbon logra un 96.2% y Argon un 84.2%; y en Terminal-Bench Science 0.1, Carbon alcanza un 64.8% y Argon un 52.9%. Ten en cuenta que la ficha oficial y Artificial Analysis usan sistemas de evaluación distintos y se midieron en momentos diferentes, así que no conviene mezclarlos en un mismo ranking. Además, la página del modelo Carbon indica un tiempo por tarea de 24.9 minutos en High, algo distinto de los 25.6 minutos de la página de comparación; en este artículo, la tabla usa los datos de la página de comparación.
Los resultados de los benchmarks tampoco lo son todo. En MKA, la evaluación multimodal de trabajo del conocimiento que lanzaron conjuntamente Google DeepMind y Artificial Analysis, ningún modelo lidera en los 10 sectores: Argon va por delante en ciencia y Carbon en salud. Es un buen recordatorio de que el hecho de que Carbon tenga una puntuación global más alta no significa que supere a Argon en cada ámbito concreto.
💡 Nota comparativa: los benchmarks solo reflejan el rendimiento en un conjunto fijo de tareas. La forma más fiable de saber si tu caso de uso necesita Carbon es ejecutar ambos modelos con tus propias tareas reales. Con APIYI (apiyi.com) puedes cambiar entre los dos modelos usando la misma clave API y el mismo código compatible con OpenAI, lo que facilita hacer pruebas comparativas a pequeña escala.
Por qué Gemini 4 Carbon consume más tokens por turno y aun así no tiene por qué ser más caro
Este es el punto que más se presta a malentendidos. Gemini 4 Argon y Carbon tienen el mismo precio por token: hasta el 30 de noviembre de 2026, el precio de lanzamiento es de 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida; a partir del 1 de diciembre sube a 4 y 20 dólares respectivamente. Los tokens de entrada en caché tienen un descuento del 95 % sobre el precio de entrada. Los tokens de razonamiento cuentan como tokens de salida, así que, como Carbon «piensa» más en cada turno, la factura por turno suele ser más alta.
Pero la factura por tarea no es lo mismo que la factura por turno. En la comparación de Artificial Analysis v5.0.1 con configuración High, Carbon cuesta 7,76 dólares por tarea y Argon 9,95 dólares: Carbon resulta un 22 % más barato y además tarda unos 3 minutos menos. Una explicación razonable es que el coste de una tarea completa depende de cuántos turnos hacen falta para terminarla, de cuántos rodeos se dan por el camino y de cuántas veces hay que rehacer el trabajo. Si Carbon piensa más al principio y comete menos errores, se reducen los reintentos y los turnos de corrección posteriores.
| Configuración (AA v5.0.1) | Puntuación global | Coste por tarea | Tiempo por tarea | Latencia de primera respuesta |
|---|---|---|---|---|
| Carbon Low | 54 | $7.19 | 22,3 min | 12,37 s |
| Carbon Medium | 58 | $6.59 | 23,3 min | 23,16 s |
| Carbon High | 60 | $7.76 | 24,9 min | 67,54 s |
| Argon High | 50 | $9.95 | 28,9 min | unos 37 s |
Estos datos esconden otro hallazgo poco intuitivo: el coste por tarea de Carbon Medium es menor que el de Low. Cuanto más bajo es el nivel de razonamiento, más barato sale cada turno, pero puede que hagan falta más turnos para completar la tarea. Eso sí, conviene tener muy claros los límites de la comparación:
- Estos costes son el coste medio por tarea dentro de este sistema de evaluación, calculado con el precio estándar de 4/20 dólares; no es el precio de una petición de API normal. Con el precio de lanzamiento, a igual consumo de tokens el coste sería aproximadamente la mitad.
- Duraciones como los 24,9 minutos son tiempos ponderados de tareas de evaluación de agentes; no significa que una pregunta normal vaya a tardar 25 minutos en responderse.
- Las conclusiones solo valen para las tareas del AA Index. Si tus tareas son sencillas y se resuelven en uno o dos turnos, la ventaja por turno de Argon o de los niveles más bajos se traducirá directamente en una factura menor.
💰 Consejo de costes: al evaluar modelos, registra el total de tokens y el tiempo total necesarios para completar una tarea, en lugar de comparar solo el precio unitario. APIYI (apiyi.com) funciona con facturación por uso y su consola permite consultar el detalle de consumo de cada invocación, lo que resulta útil para calcular el coste real de Argon y Carbon en tus propias tareas.
Cuándo elegir Gemini 4 Argon y cuándo Carbon
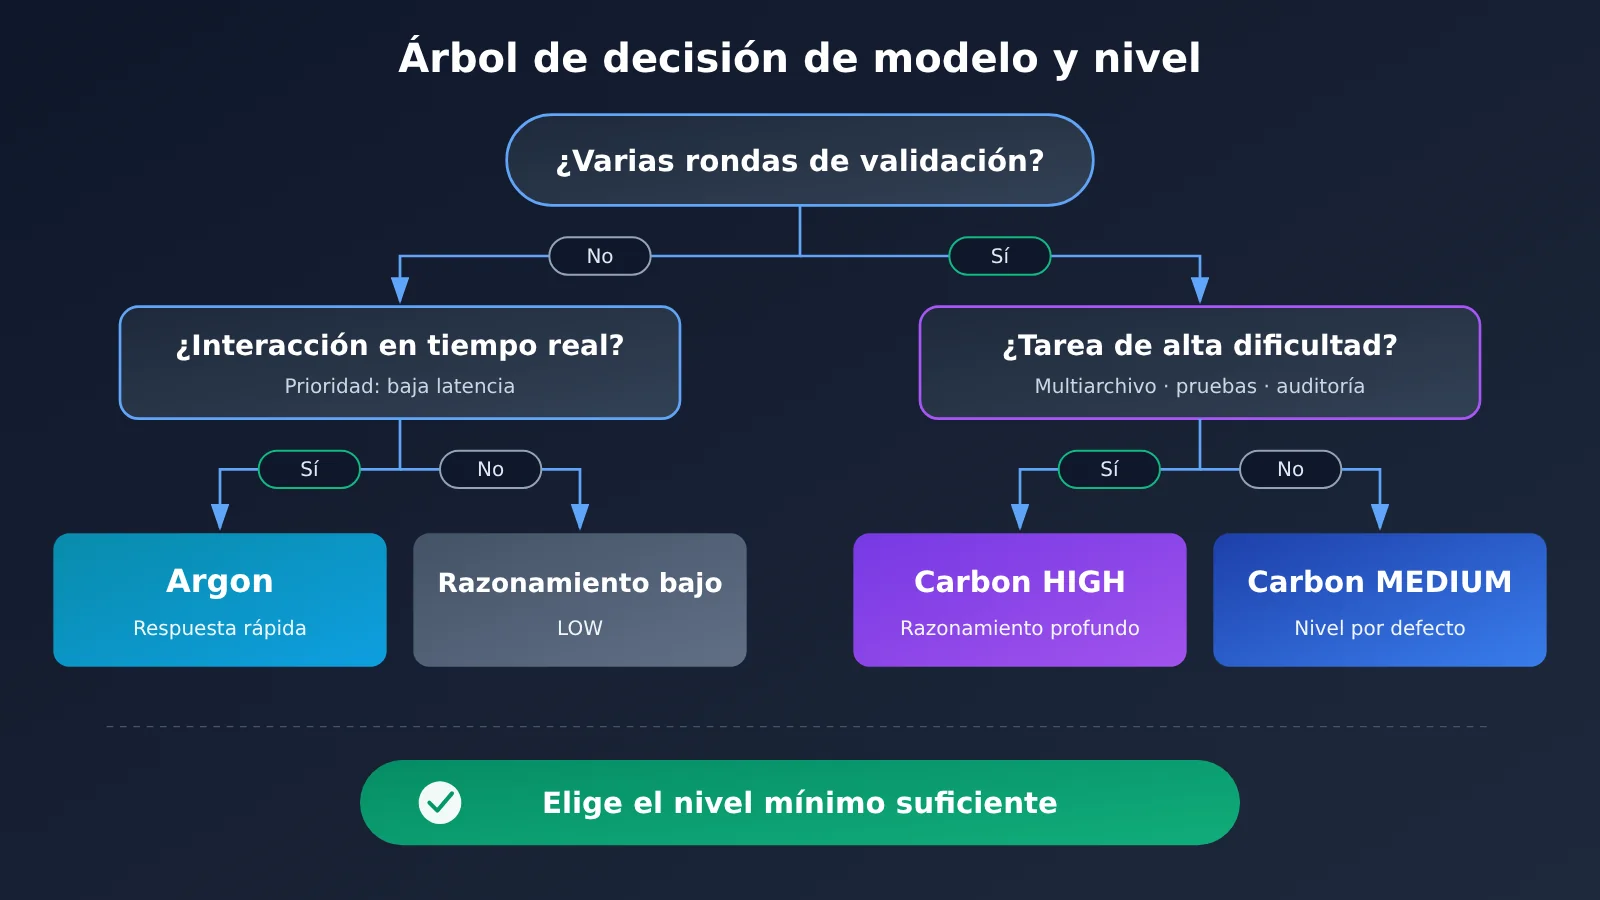
Si combinamos el posicionamiento oficial de Google con los datos anteriores, lo más práctico es repartir las tareas según su dificultad. El principio central es: primero pregúntate si la tarea merece un razonamiento más profundo y, solo después, decide qué modelo y qué nivel usar.
| Tipo de tarea | Modelo recomendado | Nivel recomendado | Motivo |
|---|---|---|---|
| Desarrollo de funcionalidades del día a día, modificaciones habituales de código | Argon | Por defecto o medio | Responde rápido, tiene bajo costo por turno y encaja bien con interacciones frecuentes |
| Programación interactiva, asistencia en tiempo real en el IDE | Argon | Medio | La latencia de la primera respuesta es claramente menor |
| Proyectos complejos con varios archivos, diseño de arquitectura | Carbon | HIGH | La diferencia en FrontierCode y Terminal-Bench es notable |
| Investigación profunda de causas raíz entre subsistemas | Carbon | MEDIUM / HIGH | Requiere explorar varias hipótesis y verificarlas repetidamente |
| Razonamiento científico de alta dificultad, demostraciones formales | Carbon | HIGH | Oficialmente, las demostraciones formales se clasifican como un uso de nivel HIGH |
| Auditorías de seguridad, detección de vulnerabilidades | Carbon | HIGH | Según el posicionamiento oficial, es más adecuado para auditorías complejas |
| Clasificación simple, resúmenes, extracción de metadatos | Nivel de razonamiento bajo | LOW | Sensible al costo, no necesita razonamiento profundo |
Escenarios para elegir Gemini 4 Argon
- Trabajo de desarrollo con mucha interacción: escribir una función suelta, cambiar estilos, añadir tests… la diferencia de sensación entre esperar 37 segundos y 68 segundos es enorme.
- Trabajo de conocimiento general y flujos automatizados: en AutomationBench-AA los dos están casi empatados, así que no tiene sentido pagar por una diferencia que no existe.
- Trabajo de conocimiento en el ámbito científico: en la evaluación MKA, Argon va por delante en ciencia, así que conviene probarlo primero.
Escenarios para elegir Gemini 4 Carbon
- Tareas de agente de larga duración que corren en segundo plano: la latencia de la primera respuesta no importa tanto; lo que cuenta es acertar a la primera.
- Ingeniería compleja y decisiones de arquitectura: migraciones de varios archivos, refactorización de sistemas, auditorías de código complejas.
- Tareas donde los resultados deben ser verificables: razonamiento científico, auditorías de seguridad, informes de análisis que requieren autocomprobación.
Los primeros comentarios de la comunidad también confirman este reparto. En Hacker News y Reddit, algunos desarrolladores opinan que Carbon detecta problemas que otros modelos pasan por alto, mientras que otros se quejan de que la primera respuesta tarda demasiado y de que la cuota se consume rápido. Un usuario de Reddit migró con Carbon Medium una biblioteca de 230 archivos en un proyecto en Go y funcionó a la primera, aunque el propio autor aclara que la muestra es de solo 4 fases y no un experimento controlado, así que solo sirve como caso de referencia.
Cómo usar Thinking Level para controlar la calidad, la velocidad y el costo de Gemini 4 Carbon
Carbon ofrece tres niveles de razonamiento: LOW, MEDIUM y HIGH. El modelo público gemini-4-carbon usa MEDIUM por defecto. Según las recomendaciones oficiales, cada nivel encaja con estos usos: LOW para clasificación, resúmenes y extracción de metadatos; MEDIUM para código convencional, invocación de herramientas, preguntas y respuestas sobre documentos y comprensión de video; HIGH para ingeniería de software con varios archivos, diseño de arquitectura, pruebas formales y descubrimiento de vulnerabilidades.
Que MEDIUM sea el valor por defecto tiene su lógica. En AA v5.0.1, Carbon Medium obtiene una puntuación global de 58, solo 2 puntos menos que High, con el costo por tarea más bajo y una latencia de primera respuesta de aproximadamente un tercio de la de High. En la prueba de fiabilidad factual AA-Omniscience, la proporción de respuestas inventadas de Medium es del 4,2 %, frente al 11,4 % de High y el 20,0 % de Low (es una métrica de esa prueba concreta, no una tasa general de alucinaciones). Google también recomienda a los desarrolladores probar los distintos niveles y elegir el más bajo que cumpla con el requisito de calidad, en lugar de usar HIGH siempre y sin condiciones.
Al invocar el modelo, conviene tener en cuenta además algunas limitaciones técnicas de Carbon: thinking_budget no es compatible y usarlo devuelve un error HTTP 400; el nivel MINIMAL no está disponible; los parámetros temperature, top_p y top_k se ignoran; no admite Context Caching explícito, pero si el prefijo común de la indicación alcanza 4096 tokens o más, se activa automáticamente el caché implícito.
Ejemplo mínimo
A continuación llamamos a Gemini 4 Carbon con la interfaz compatible con OpenAI, en poco más de 10 líneas de código:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # El ID del modelo debe coincidir con la lista de modelos de la plataforma
    messages=[{"role": "user", "content": "分析这段服务超时日志的可能根因"}]
)
print(response.choices[0].message.content)
Ver el código completo: enrutar entre Argon y Carbon según la dificultad de la tarea
import time
import openai
from typing import Literal

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Los nombres de modelo son solo ejemplos; usa los ID reales de la lista de modelos de la plataforma
ARGON_MODEL = "gemini-4-argon"
CARBON_MODEL = "gemini-4-carbon"

Difficulty = Literal["simple", "daily", "complex", "extreme"]

def route(difficulty: Difficulty) -> tuple[str, str]:
    """Devuelve (modelo, nivel de razonamiento) según la dificultad de la tarea"""
    if difficulty == "simple":
        return CARBON_MODEL, "low"      # Clasificación, resúmenes, extracción de metadatos
    if difficulty == "daily":
        return ARGON_MODEL, "medium"    # Desarrollo diario, interacciones frecuentes
    if difficulty == "complex":
        return CARBON_MODEL, "medium"   # Investigación de causas raíz, tareas de Agent habituales
    return CARBON_MODEL, "high"         # Ingeniería multiarchivo, demostraciones, auditorías de seguridad

def run_task(prompt: str, difficulty: Difficulty) -> dict:
    model, effort = route(difficulty)
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        # La forma de mapear el parámetro del nivel de razonamiento depende de la documentación de la plataforma;
        # Carbon no admite thinking_budget, y si lo envías devuelve un error 400
        reasoning_effort=effort,
    )
    usage = resp.usage
    return {
        "model": model,
        "effort": effort,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,  # Incluye los tokens de razonamiento
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    result = run_task("为订单服务设计分库分表迁移方案,并列出验证步骤", "extreme")
    print(result["model"], result["effort"], result["seconds"], "s")
    print("输出 Token:", result["completion_tokens"])
🚀 Recomendación para empezar: lo mejor es registrarte en APIYI (apiyi.com) y reclamar el crédito de prueba gratuito. Después, usa la función de enrutamiento de arriba para pasar el mismo conjunto de tareas reales por Argon y Carbon en distintos niveles, y anota el tiempo y los
completion_tokensde cada uno. Con una sola clave API haces todas las comparaciones, sin tener que integrar varios SDK por separado.
Recomendaciones para elegir entre Gemini 4 Argon y Carbon
Si solo puedes quedarte con una regla: usa Argon por defecto y sube a Carbon cuando la tarea realmente merezca pensarse a fondo. En la práctica se puede aplicar en tres pasos:
- Define reglas de enrutamiento: según la tabla de escenarios de arriba, clasifica las tareas en cuatro tipos (simples, cotidianas, complejas y muy difíciles) y envía las cotidianas a Argon por defecto.
- Haz una prueba con una muestra pequeña: elige entre 10 y 20 tareas reales de cada tipo y compara Argon y cada nivel de Carbon según tasa de acierto, total de tokens y tiempo total.
- Elige el nivel según el costo de la tarea: quédate con el nivel más bajo que alcance tu umbral de calidad y vuelve a medir de forma periódica, porque los modelos, los precios y los rankings pueden cambiar.
En sistemas con varios agentes también puedes inspirarte en el enfoque de Google /swarm: deja que Carbon se encargue de planificar, coordinar y revisar, y que Argon u otro modelo más ligero ejecute el trabajo en volumen. Así aprovechas el razonamiento profundo de Carbon sin cargar con su latencia en cada paso.
💡 Nuestra recomendación: el precio por token de ambos modelos es el mismo, así que lo que realmente marca la diferencia es la estructura de tus tareas. Te sugerimos conectar Argon y Carbon a la vez desde APIYI (apiyi.com) usando la interfaz compatible con OpenAI y cambiar entre ellos mediante enrutamiento en el código. De ese modo, cuando quieras ajustar la estrategia no tendrás que tocar la lógica de negocio.
Preguntas frecuentes (FAQ)
P1: ¿Qué relación hay entre Gemini 4 Argon y Carbon?
Según la ficha del modelo de Google DeepMind, Gemini 4 Carbon está construido sobre Gemini 4 Argon. Ambos pertenecen a la serie de modelos de razonamiento Gemini 4 y comparten 1M de tokens de ventana de contexto y herramientas integradas. Carbon dedica más tokens de pensamiento en cada turno para explorar y verificar, mientras que Argon prioriza la velocidad de respuesta y la eficiencia por turno. Google no ha revelado las diferencias de parámetros ni de arquitectura entre ambos.
P2: ¿Carbon va a reemplazar por completo a Argon?
No. Google deja claro que Argon sigue siendo la opción ideal para la mayoría de las tareas de ingeniería y trabajo del conocimiento, mientras que Carbon está pensado para tareas más difíciles y de más largo plazo. Si miramos los datos, como que en AutomationBench-AA ambos están casi empatados o que en MKA Argon va por delante en el ámbito científico, Argon sigue siendo muy competitivo en muchos escenarios.
P3: ¿Los dos modelos cuestan lo mismo? ¿Cuándo cambia el precio?
La documentación para desarrolladores de Google indica que ambos usan el mismo precio por token. El precio de lanzamiento es de 2/10 dólares por millón de tokens de entrada/salida, válido hasta el 30 de noviembre de 2026; a partir del 1 de diciembre pasa a 4/20 dólares. Los tokens de pensamiento cuentan como salida, así que que el precio unitario sea igual no significa que el costo de una tarea también lo sea.
P4: Carbon tarda mucho en dar la primera respuesta, ¿sirve para una aplicación de chat?
No es lo más recomendable para escenarios que exigen respuesta en tiempo real. En AA v5.0.1, la latencia hasta el primer token de respuesta de Carbon High es de unos 68 segundos, la de Argon High ronda los 37 segundos y la de Carbon Low unos 12 segundos. Para interacción en tiempo real conviene usar Argon; Carbon encaja mejor en análisis complejos en segundo plano y tareas de agentes de larga duración.
P5: ¿Cómo comparar rápidamente Argon y Carbon por API?
Lo más práctico es usar una plataforma de agregación de API que soporte varios modelos:
1. Entra en APIYI (apiyi.com), regístrate y obtén tu clave API y una cuota gratuita de prueba;
2. Configura el `base_url` de tu código como `https://api.apiyi.com/v1`;
3. Cambia solo el parámetro `model` para alternar entre los dos modelos, y combínalo con los distintos niveles de razonamiento para hacer la comparación.
P6: ¿Puedo usar Carbon sin una suscripción a Google AI Ultra?
Sí. La suscripción Ultra solo determina si, del lado del consumidor (la app de Gemini, etc.), puedes elegir Carbon directamente; AI Pro incluye principalmente Argon. Los desarrolladores pueden invocar Carbon con el nivel de pago de la API de Gemini sin comprar Ultra. Eso sí, ten en cuenta que la API oficial de Google para Carbon no ofrece nivel gratuito.
P7: ¿Qué limitaciones conocidas tiene Carbon?
La ficha del modelo señala lo siguiente: todavía puede alucinar, los niveles de razonamiento altos pueden consumir muchísimos tokens, puede responder lento o dar timeout, su corte de conocimiento es marzo de 2026 y la protección contra Prompt Injection aún debe mejorar. Además, `thinking_budget` no está soportado y los parámetros de muestreo se ignoran, así que conviene revisarlo al migrar código antiguo.
Puntos clave sobre Gemini 4 Argon y Carbon (Key Takeaways)
- Relación entre ambos: Carbon está construido sobre Argon. Se reparten el trabajo y se complementan; no es una versión «alta» que sustituya a una «básica».
- Diferencia principal: Carbon piensa más en cada turno y verifica mejor sus resultados; Argon responde más rápido y gasta menos por turno.
- Rendimiento en benchmarks: con la configuración High de AA v5.0.1, Carbon obtiene 60 puntos en el índice global y Argon, 50.
- La verdad sobre el costo: el precio unitario es el mismo, y en las tareas de AA Carbon High termina costando menos por tarea que Argon High.
- Elección del nivel: Carbon usa MEDIUM por defecto. Elige entre LOW, MEDIUM y HIGH según el principio del «nivel mínimo que sea suficiente».
- Cómo empezar: con APIYI (apiyi.com) puedes probar los dos modelos con un único código compatible con OpenAI.
Conclusión
Las diferencias entre Gemini 4 Argon y Carbon se resumen en tres puntos:
- Distinta inversión en razonamiento: Argon se centra en la eficiencia, mientras que Carbon usa más tokens de pensamiento para llevar al límite el razonamiento complejo.
- Latencia y costo se miran por separado: Carbon tarda más en dar la primera respuesta, pero en ciertas evaluaciones el costo de la tarea completa puede ser menor.
- La dificultad de la tarea decide: para el trabajo de ingeniería del día a día, mejor Argon; deja para Carbon la ingeniería compleja, el razonamiento científico y las auditorías de seguridad.
No envíes todas las solicitudes al nivel de razonamiento más alto. Lo más importante para controlar la calidad, la velocidad y el costo es medir primero, con tareas reales, cuál es el «nivel suficiente» para cada tipo de trabajo. Te recomendamos usar APIYI (apiyi.com) para comprobar rápidamente cómo rinden ambos modelos en tu caso de uso; la plataforma ofrece facturación por consumo y una interfaz unificada para varios modelos.
📚 Referencias
- Gemini 4 Carbon Model Card: ficha oficial del modelo de Google DeepMind
- Enlace:
deepmind.google/models/model-cards/gemini-4-carbon -
Descripción: Carbon está construido sobre Argon; incluye especificaciones de contexto, evaluaciones oficiales y limitaciones conocidas
-
Choosing between Carbon and Argon: documentación para desarrolladores de Google AI Studio
- Enlace:
aistudio.google.com/docs/whats-new-gemini-4-carbon -
Descripción: diferencias de posicionamiento oficial entre ambos modelos y recomendaciones para elegir el Thinking Level
-
Gemini 4 Carbon Developer Guide: guía para desarrolladores de Google Cloud
- Enlace:
docs.cloud.google.cn/gemini-enterprise-agent-platform/models/guides/gemini-4-carbon -
Descripción: niveles de razonamiento, límites de parámetros de la API y notas sobre decodificación larga
-
Precios de la API de Gemini: Google AI for Developers
- Enlace:
ai.google.dev/gemini-api/docs/pricing -
Descripción: precio de lanzamiento, ajuste de precios de diciembre, y reglas de facturación de caché y tokens de razonamiento
-
Gemini 4 Carbon vs Gemini 4 Argon: página comparativa de Artificial Analysis
- Enlace:
artificialanalysis.ai/zh/models/comparisons/gemini-4-carbon-vs-gemini-4-argon -
Descripción: comparación de capacidades, costes y latencia con la configuración High de AA Index v5.0.1
-
Evaluación multimodal de trabajo del conocimiento MKA: Artificial Analysis
- Enlace:
artificialanalysis.ai/zh/evaluations/mka - Descripción: modelos líderes por sector y datos de coste por tarea
Autor: equipo técnico de APIYI
Intercambio técnico: puedes contactarnos desde la página principal de APIYI. Para más información sobre cómo integrar otros modelos, visita el centro de documentación en docs.apiyi.com