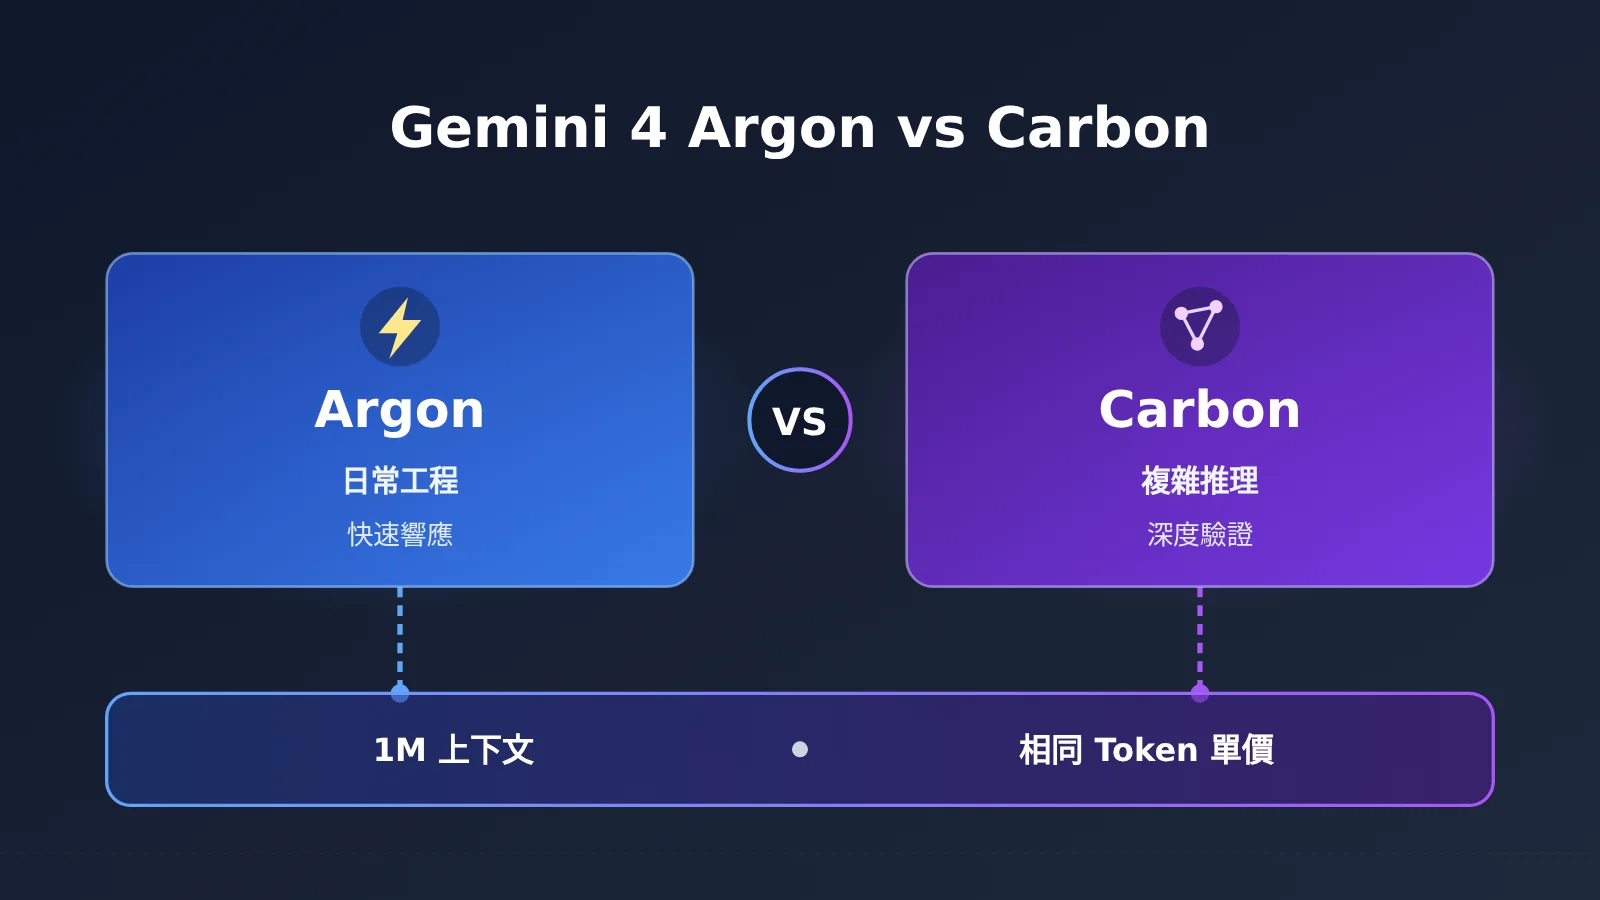
作者注:比較 Gemini 4 Argon 與 Carbon 在推理投入、響應速度和任務成本上的差別,幫助開發者按任務難度選擇模型。
Google 在 2026 年 10 月 13 日發佈 Gemini 4 Argon,10 月 28 日首次公佈 Gemini 4 Carbon,11 月 10 日向開發者、企業和消費者正式開放 Carbon。很多開發者第一反應是:Carbon 是不是 Argon 的升級替代品?本文從 推理投入、響應延遲、任務成本、適用場景、推理檔位 5 個維度,對比 Gemini 4 Argon 和 Carbon 的真實差異。
這不是一份“高配一定更好”的折中分析。Google 官方開發者文檔已經說明,Argon 仍然是大多數工程和知識工作的推薦選擇,Carbon 則面向需要更深推理和更長驗證週期的任務。本文以 Google 官方文檔爲主要依據,第三方數據會標註評測版本和推理等級。
核心價值:讀完本文,你會知道哪些任務交給 Argon,哪些任務值得交給 Carbon,以及如何用 Thinking Level 控制質量、速度和成本。
Gemini 4 Argon 和 Carbon 對比前需要了解的 7 個術語
對比兩款推理模型時,有幾個概念容易混用。先把它們分開,後面的數據纔不會被誤讀:
- 推理檔位(Thinking Level):控制模型思考投入的設置,Carbon 提供 LOW、MEDIUM、HIGH 三檔。
- 思考 Token:模型進行推理時產生的 Token,按輸出 Token 計費。
- 任務成本:完成一個任務全部模型調用的費用,不等於單次請求費用。
- 推理延遲:模型從接收請求到產生結果所經歷的時間,本文重點看首個答案 Token 延遲。
- 緩存讀取:複用已有輸入上下文的計費方式,價格遠低於普通輸入。
- Agent:能通過工具執行多步驟任務的智能體,例如寫代碼、跑測試、再修復。
- 基準測試:用一組固定任務評估和比較模型的方法,結論只對該測試配置成立。
爲什麼 Google 同時推出 Gemini 4 Argon 和 Carbon
根據 Google DeepMind 的 Carbon 模型卡,Gemini 4 Carbon 基於 Gemini 4 Argon 構建。也就是說,兩者有共同的模型基礎,Carbon 是在此之上針對高難度推理、複雜軟件工程、長週期 Agent 工作流、科學研究和網絡安全防禦進一步強化的版本。需要注意的是,Google 沒有披露 Carbon 的參數量,也沒有公開兩者內部計算架構的差異,因此“Carbon 是 Argon 幾倍大”這類說法沒有依據。
既然 Carbon 更強,爲什麼不讓它直接替代 Argon?原因在於兩者解決的是不同類型的工作。日常功能開發、頻繁交互的代碼修改,更看重響應速度和每輪的 Token 開銷;而架構設計、跨子系統根因調查、科學證明這類任務,更看重模型能否反覆提出假設、驗證和修正。Google 在開發者文檔中給出的選擇建議也是分工而非替代:Argon 負責大多數日常工程,Carbon 負責更困難、更長週期的推理任務。
這種分工在 Google 自己的產品裏也有體現。Antigravity 的 /swarm 多 Agent 預覽功能中,Google 建議由 Carbon 承擔總體架構設計、任務協調和安全審查,常規代碼實現和並行文件修改交給更快、更輕量的模型。消費者端同樣如此:Google AI Pro 訂閱的模型權益主要是 Argon,Ultra 訂閱才包含 Carbon。
Gemini 4 Argon 和 Carbon 核心差異:每輪推理投入不同
Google 在 Carbon 開發者指南的“Choosing between Carbon and Argon”章節中給出了最直接的解釋:Carbon 每輪花費更多思考 Token,用於更充分地探索和驗證自己的工作;Argon 則以更快的響應和更低的單輪 Token 消耗,服務交互式編程和日常功能開發。兩者共享 1M Token 統一上下文窗口(1,048,576 Token,輸入與輸出共享)、共享內置工具能力,並使用相同的每 Token 價格。
| 對比維度 | Gemini 4 Argon | Gemini 4 Carbon | 更適合 |
|---|---|---|---|
| 產品定位 | 高性能、高效率的通用推理模型 | 更深度的複雜推理模型 | 看任務 |
| 每輪思考 Token | 相對較少 | 每輪使用更多 | Argon 更省 |
| 響應速度 | 更快 | 複雜任務下更慢 | Argon |
| 交互式開發 | 更適合 | 可用於高難度任務 | Argon |
| 日常功能開發 | 推薦 | 通常沒有必要 | Argon |
| 架構設計、根因調查 | 可承擔 | 更適合極複雜、深度調查 | Carbon |
| 科學證明、安全審計 | 可承擔 / 支持 | 更適合複雜推理與驗證 | Carbon |
| 上下文與 Token 單價 | 1M 共享上下文,單價相同 | 1M 共享上下文,單價相同 | 持平 |
從這張表可以看出,Gemini 4 Argon 和 Carbon 的分界線不是“能不能做”,而是“值不值得多想”。Argon 也能承擔架構設計和根因調查,只是當問題複雜到需要多輪假設和驗證時,Carbon 願意投入更多思考 Token 去換取更可靠的結果。
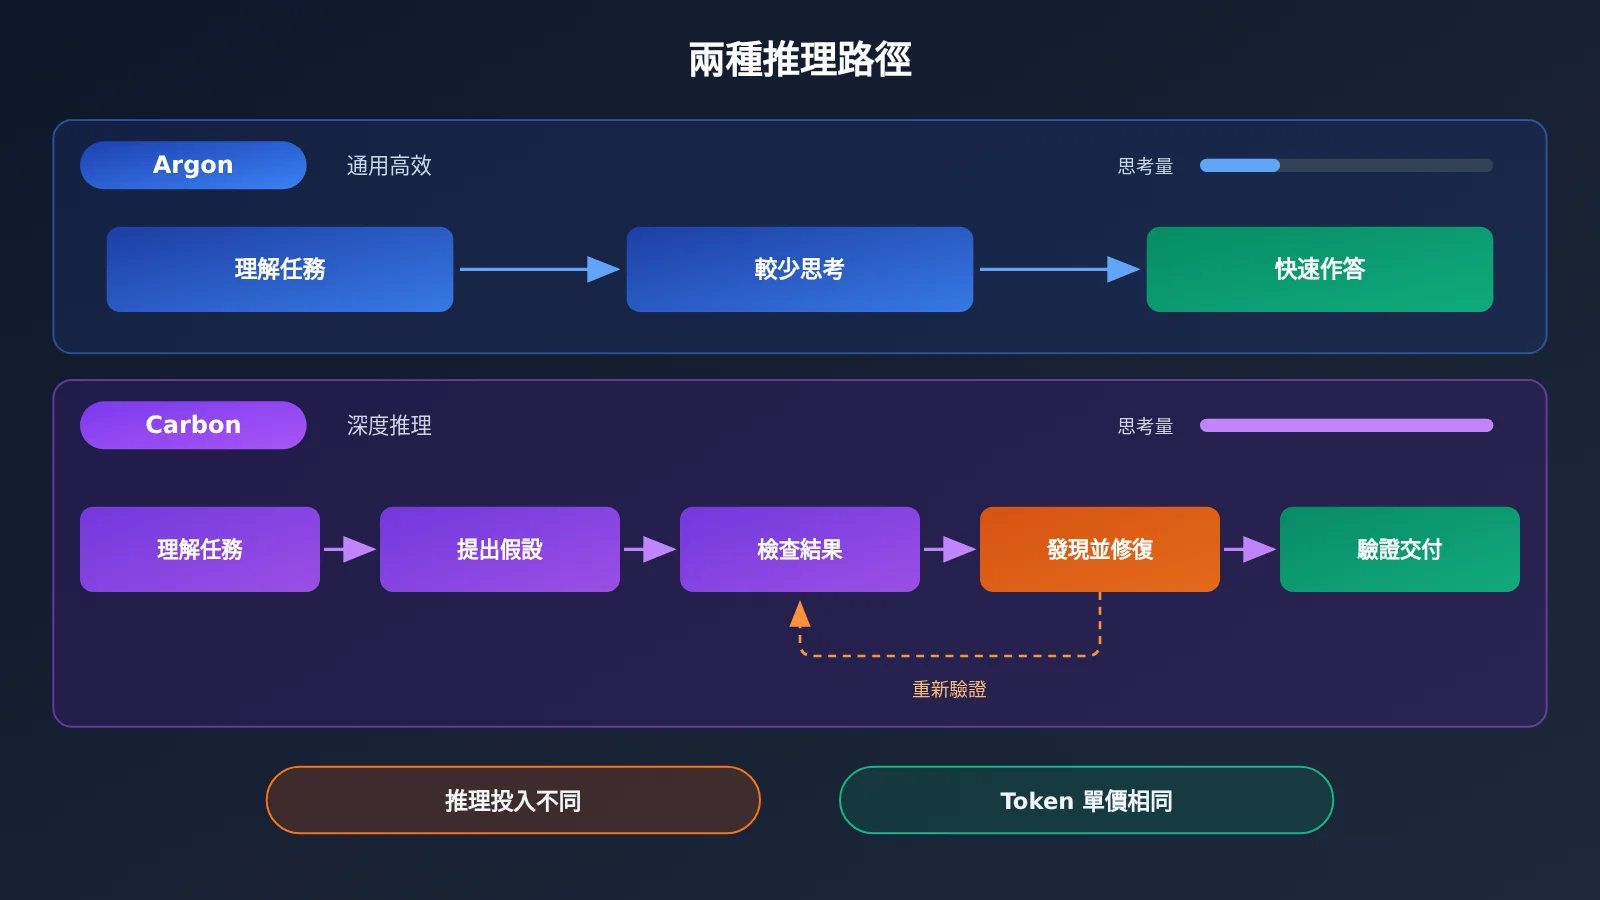
Carbon 的工作方式更接近一個完整的執行閉環:理解目標和約束、拆解任務、制定計劃、調用工具、檢查中間結果、識別錯誤、修改並重新驗證,最後交付。這個閉環讓它在長週期任務中更有優勢,也解釋了爲什麼它的首次回答等待時間更長。
Gemini 4 Argon 和 Carbon 獨立基準測試對比
官方說法需要獨立數據來驗證。Artificial Analysis 在 Intelligence Index v5.0.1 中提供了 Carbon 與 Argon 的直接對比頁面,以下數據均爲 High 推理配置下的結果。
| 指標(AA v5.0.1,High 推理) | Carbon High | Argon High | 差距 |
|---|---|---|---|
| 綜合能力指數 | 60 | 50 | Carbon +10 |
| AutomationBench-AA | 77.8% | 77.5% | 基本持平 |
| Terminal-Bench 4.0 | 65.2% | 57.1% | Carbon 領先 |
| FrontierCode 2.0 | 40.6% | 25.7% | Carbon 明顯領先 |
| AA-Omniscience(知識可靠性得分) | 54 | 46 | Carbon 領先 |
| HLE-Diamond | 69.1% | 56.7% | Carbon 領先 |
| 每任務成本 | $7.76 | $9.95 | Carbon 更低 |
| 每任務耗時 | 25.6 分鐘 | 28.9 分鐘 | Carbon 更短 |
| 首個答案 Token 延遲 | 約 68 秒 | 約 37 秒 | Argon 更快 |
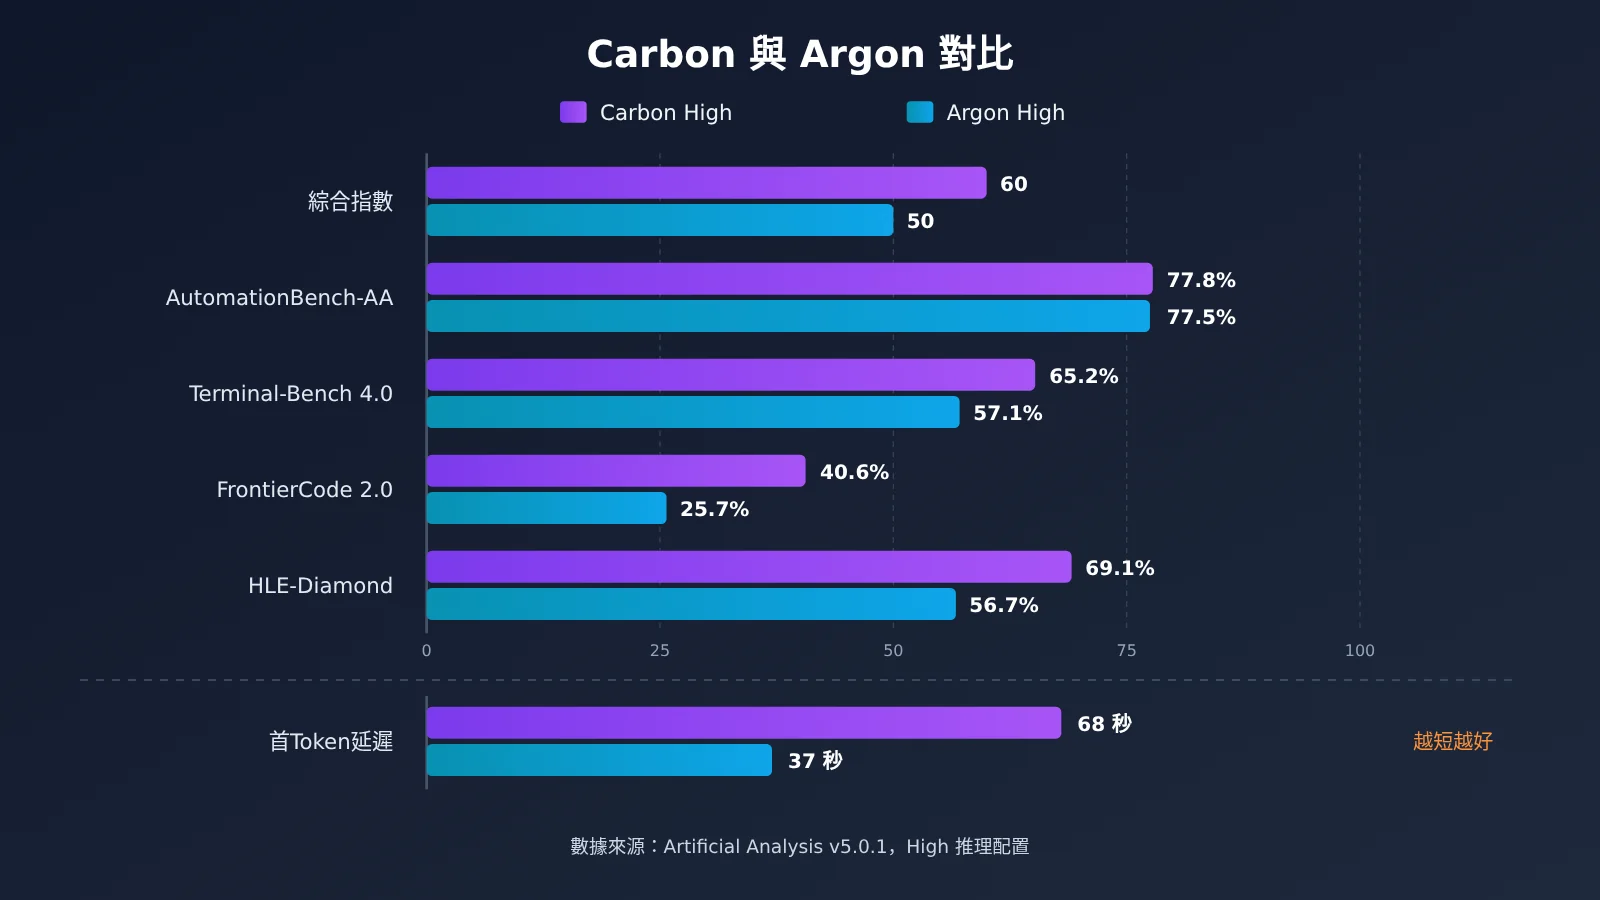
幾個值得關注的結論:
- 複雜工程與複雜推理差距最大:FrontierCode 2.0 領先近 15 個百分點,HLE-Diamond 領先約 12 個百分點,Terminal-Bench 4.0 領先約 8 個百分點。
- 常規自動化任務差距很小:AutomationBench-AA 只差 0.3 個百分點,說明在流程化自動任務上,Argon 已經足夠。
- 知識可靠性有提升:AA-Omniscience 得分 54 對 46,Google 模型卡中的 Agentic Honesty Benchmark 也顯示 Carbon 爲 92%、Argon 爲 70%。
- Argon 首次響應明顯更快:約 37 秒對約 68 秒,這是 Carbon 多投入推理的直接代價。
Google 官方模型卡(評測時間標註爲 2026 年 10 月,通常爲 Pass@1、使用最高可用推理等級)也給出了一致的趨勢:SWE-sweep 上 Carbon 9.6%、Argon 4.3%;GraphWalks(256k—1M,BFS F1)上 Carbon 96.2%、Argon 84.2%;Terminal-Bench Science 0.1 上 Carbon 64.8%、Argon 52.9%。官方模型卡與 Artificial Analysis 屬於不同評測體系和時間點,不宜混合排名。另外,Carbon 模型頁面顯示的 High 每任務耗時爲 24.9 分鐘,與對比頁的 25.6 分鐘略有差異,本文對比表以對比頁數據爲準。
基準成績也不是全部。在 Google DeepMind 與 Artificial Analysis 聯合推出的 MKA 多模態知識工作評測中,沒有任何模型在全部 10 個行業領先:Argon 在科學領域領先,Carbon 在醫療健康領域領先。這提醒我們,Carbon 綜合分更高,並不意味着它在每個具體領域都勝過 Argon。
💡 對比說明:基準測試只能反映固定任務集下的表現。你的業務場景是否需要 Carbon,最可靠的辦法是用自己的真實任務各跑一遍。通過 API易 apiyi.com 可以用同一個 API Key 和同一套 OpenAI 兼容代碼切換兩款模型,便於做小規模對照測試。
爲什麼 Gemini 4 Carbon 每輪消耗更多 Token,卻不一定更貴
這是最容易誤解的一點。Gemini 4 Argon 和 Carbon 的 Token 單價相同:2026 年 11 月 30 日前首發價爲每百萬輸入 Token 2 美元、每百萬輸出 Token 10 美元;12 月 1 日起調整爲 4 美元和 20 美元;緩存輸入價格相當於輸入價格的 95% 折扣。思考 Token 計入輸出 Token 費用,所以 Carbon 每輪多想,單輪賬單通常更高。
但任務賬單不等於單輪賬單。在 Artificial Analysis v5.0.1 的 High 配置對比中,Carbon 每任務成本爲 7.76 美元,Argon 爲 9.95 美元,Carbon 反而便宜約 22%,耗時也短了 3 分鐘左右。一個合理的解釋是:完整任務的成本取決於完成任務需要多少輪、走了多少彎路、返工了幾次。如果 Carbon 前期多思考、少犯錯,後續的重試和修復輪次就可能減少。
| 配置(AA v5.0.1) | 綜合分 | 每任務成本 | 每任務耗時 | 首次回答延遲 |
|---|---|---|---|---|
| Carbon Low | 54 | $7.19 | 22.3 分鐘 | 12.37 秒 |
| Carbon Medium | 58 | $6.59 | 23.3 分鐘 | 23.16 秒 |
| Carbon High | 60 | $7.76 | 24.9 分鐘 | 67.54 秒 |
| Argon High | 50 | $9.95 | 28.9 分鐘 | 約 37 秒 |
這組數據還有一個反直覺的發現:Carbon Medium 的任務成本低於 Low。推理檔位越低,單輪越省,但可能需要更多輪才能完成任務。不過要特別注意比較邊界:
- 這些成本是該評測體系中平均每個任務的成本,按標準價格 4/20 美元口徑計算,不是一次普通 API 請求的價格;按首發價估算,同等 Token 用量成本約減半。
- 24.9 分鐘這類耗時是 Agent 評測任務的加權耗時,不代表普通提問需要等 25 分鐘。
- 結論僅限於 AA Index 這套任務。如果你的任務本身很簡單,一兩輪就能完成,Argon 或更低檔位的單輪優勢就會直接體現爲更低賬單。
💰 成本建議:評估模型時請記錄“完成一個任務的總 Token 和總時長”,而不是隻比較單價。API易 apiyi.com 採用按量計費,控制檯可以查看每次調用的用量明細,適合用來覈算 Argon 與 Carbon 在你業務上的真實任務成本。
何時選擇 Gemini 4 Argon,何時選擇 Carbon
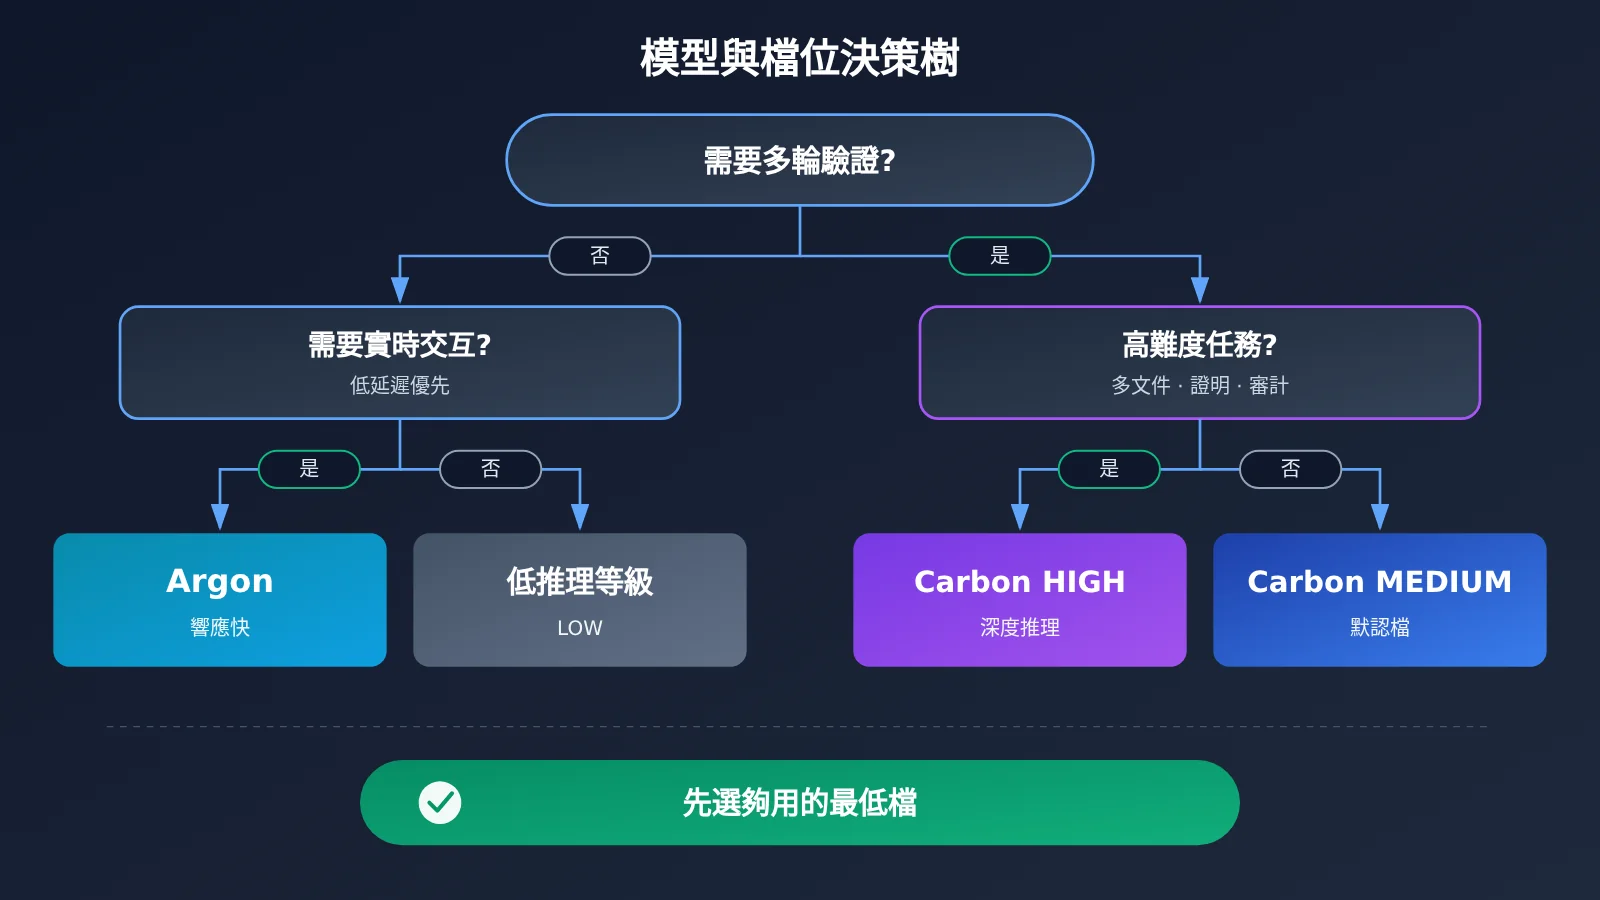
結合 Google 官方定位和上面的數據,可以按任務難度來分流。核心原則是:先問任務是否值得更深的推理,再決定用哪個模型和哪一檔。
| 任務類型 | 推薦模型 | 推薦檔位 | 理由 |
|---|---|---|---|
| 日常功能開發、常規代碼修改 | Argon | 默認或中等 | 響應快,單輪開銷低,適合頻繁交互 |
| 交互式編程、IDE 實時輔助 | Argon | 中等 | 首次響應延遲明顯更低 |
| 多文件複雜工程、架構設計 | Carbon | HIGH | FrontierCode、Terminal-Bench 差距明顯 |
| 跨子系統深度根因調查 | Carbon | MEDIUM / HIGH | 需要多假設探索和反覆驗證 |
| 高難度科學推理、形式化證明 | Carbon | HIGH | 官方將形式化證明列爲 HIGH 用途 |
| 安全審計、漏洞發現 | Carbon | HIGH | 官方定位更適合複雜審計 |
| 簡單分類、摘要、元數據提取 | 低推理等級 | LOW | 成本敏感,無需深度推理 |
選擇 Gemini 4 Argon 的場景
- 頻繁交互的開發工作:寫單個函數、改樣式、補測試,等待 37 秒和 68 秒的體感差別很大。
- 常規知識工作與自動化流程:AutomationBench-AA 兩者幾乎持平,沒必要爲差距買單。
- 科學領域知識工作:在 MKA 評測中,Argon 在科學領域領先,可以優先試用。
選擇 Gemini 4 Carbon 的場景
- 後臺運行的長週期 Agent 任務:對首次延遲不敏感,更在意一次做對。
- 複雜工程與架構決策:多文件遷移、系統重構、複雜代碼審計。
- 對結果可驗證性要求高的任務:科學推理、安全審計、需要自我檢查的分析報告。
社區早期反饋也印證了這一分工。Hacker News 和 Reddit 上有開發者認爲 Carbon 能發現其他模型遺漏的問題,也有人抱怨首次回答等待過長、額度消耗快。一位 Reddit 用戶在 Go 項目中用 Carbon Medium 遷移一個涉及 230 個文件的庫並首次運行成功,但作者也說明樣本只有 4 個階段、不是對照實驗,只能作爲參考案例。
如何使用 Thinking Level 控制 Gemini 4 Carbon 的質量、速度與成本
Carbon 提供 LOW、MEDIUM、HIGH 三個推理等級,公開模型 gemini-4-carbon 默認使用 MEDIUM。官方建議的用途劃分爲:LOW 用於分類、摘要、元數據提取;MEDIUM 用於常規代碼、工具調用、文檔問答、視頻理解;HIGH 用於多文件軟件工程、架構設計、形式化證明、漏洞發現。
默認 MEDIUM 有它的道理。在 AA v5.0.1 中,Carbon Medium 綜合分 58,只比 High 低 2 分,但任務成本最低、首次回答延遲約爲 High 的三分之一;在 AA-Omniscience 事實可靠性測試中,Medium 的編造答案比例爲 4.2%,低於 High 的 11.4% 和 Low 的 20.0%(這是特定測試的指標,不是通用幻覺率)。Google 也建議開發者測試不同檔位,選擇滿足質量要求的最低等級,而不是無條件使用 HIGH。
調用時還有幾個 Carbon 的技術限制需要留意:thinking_budget 不受支持,使用會返回 HTTP 400;不支持 MINIMAL 等級;temperature、top_p、top_k 會被忽略;不支持顯式 Context Caching,但公共提示詞前綴達到 4096 Token 及以上可觸發自動隱式緩存。
極簡示例
下面用 OpenAI 兼容接口調用 Gemini 4 Carbon,10 餘行代碼即可運行:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # 模型 ID 以平臺模型列表爲準
    messages=[{"role": "user", "content": "分析這段服務超時日誌的可能根因"}]
)
print(response.choices[0].message.content)
查看完整實現代碼:按任務難度路由 Argon 與 Carbon
import time
import openai
from typing import Literal

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 模型名稱爲示例,請以平臺模型列表中的實際 ID 爲準
ARGON_MODEL = "gemini-4-argon"
CARBON_MODEL = "gemini-4-carbon"

Difficulty = Literal["simple", "daily", "complex", "extreme"]

def route(difficulty: Difficulty) -> tuple[str, str]:
    """按任務難度返回 (模型, 推理檔位)"""
    if difficulty == "simple":
        return CARBON_MODEL, "low"      # 分類、摘要、元數據提取
    if difficulty == "daily":
        return ARGON_MODEL, "medium"    # 日常開發、頻繁交互
    if difficulty == "complex":
        return CARBON_MODEL, "medium"   # 根因調查、常規 Agent 任務
    return CARBON_MODEL, "high"         # 多文件工程、證明、安全審計

def run_task(prompt: str, difficulty: Difficulty) -> dict:
    model, effort = route(difficulty)
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        # 推理檔位參數的映射方式請以平臺文檔爲準;
        # Carbon 不支持 thinking_budget,傳入會報 400
        reasoning_effort=effort,
    )
    usage = resp.usage
    return {
        "model": model,
        "effort": effort,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,  # 含思考 Token
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    result = run_task("爲訂單服務設計分庫分表遷移方案,並列出驗證步驟", "extreme")
    print(result["model"], result["effort"], result["seconds"], "s")
    print("輸出 Token:", result["completion_tokens"])
🚀 快速上手建議:推薦先在 API易 apiyi.com 註冊並領取免費測試額度,用上面的路由函數把同一批真實任務分別交給 Argon 和 Carbon 的不同檔位,記錄耗時與
completion_tokens。一個 API Key 即可完成全部對照,不需要分別對接多套 SDK。
Gemini 4 Argon 和 Carbon 決策建議
如果只能記住一條規則:默認用 Argon,遇到值得深想的任務再升級到 Carbon。具體落地可以分三步:
- 建立分流規則:按上文場景表把任務分爲簡單、日常、複雜、極難四類,日常類默認走 Argon。
- 小樣本對照:每類挑 10—20 個真實任務,對比 Argon 與 Carbon 各檔位的通過率、總 Token 和總耗時。
- 按任務成本定檔:選擇能達到質量線的最低檔位,並定期複測,因爲模型、價格和榜單都可能更新。
對於多 Agent 系統,也可以參考 Google /swarm 的思路:讓 Carbon 負責規劃、協調和審查,讓 Argon 或更輕量的模型負責批量執行。這樣既能用上 Carbon 的深度推理,又不會讓每個環節都承擔它的延遲。
💡 選擇建議:兩款模型 Token 單價相同,真正拉開差距的是你的任務結構。我們建議在 API易 apiyi.com 上用 OpenAI 兼容接口同時接入 Argon 和 Carbon,在代碼層通過路由切換,後續調整策略時無需改動業務代碼。
常見問題 FAQ
Q1:Gemini 4 Argon 和 Carbon 是什麼關係?
根據 Google DeepMind 模型卡,Gemini 4 Carbon 基於 Gemini 4 Argon 構建,兩者同屬 Gemini 4 推理模型系列,共享 1M Token 上下文和內置工具能力。Carbon 每輪投入更多思考 Token 做探索和驗證,Argon 更強調響應速度和單輪效率。Google 未披露兩者的參數量和架構差異。
Q2:Carbon 會完全取代 Argon 嗎?
不會。Google 明確表示 Argon 仍是大多數工程和知識工作任務的理想選擇,Carbon 適合更困難、更長週期的任務。從 AutomationBench-AA 兩者幾乎持平、MKA 中 Argon 在科學領域領先等數據看,Argon 在很多場景依然有競爭力。
Q3:兩款模型的價格一樣嗎?什麼時候調價?
Google 開發者文檔顯示兩者使用相同的每 Token 價格。首發價每百萬輸入/輸出 Token 爲 2/10 美元,有效期至 2026 年 11 月 30 日;12 月 1 日起調整爲 4/20 美元。思考 Token 計入輸出費用,所以單價相同不代表任務成本相同。
Q4:Carbon 首次回答很慢,適合做聊天應用嗎?
不太適合對實時性要求高的場景。AA v5.0.1 中 Carbon High 首個答案 Token 延遲約 68 秒,Argon High 約 37 秒,Carbon Low 約 12 秒。實時交互建議用 Argon,Carbon 更適合後臺複雜分析和長週期 Agent 任務。
Q5:如何通過 API 快速對比 Argon 和 Carbon?
推薦使用支持多模型的 API 聚合平臺:
1. 訪問 API易 apiyi.com 註冊賬號,獲取 API Key 和免費測試額度;
2. 將代碼中的 base_url 設置爲 `https://api.apiyi.com/v1`;
3. 只修改 `model` 參數即可在兩款模型間切換,再結合推理檔位做對照。
Q6:沒有 Google AI Ultra 訂閱能用 Carbon 嗎?
可以。Ultra 訂閱決定的是消費者端(Gemini App 等)能否直接選擇 Carbon,AI Pro 主要包含 Argon。開發者通過 Gemini API 付費層即可調用 Carbon,無需購買 Ultra;需要注意 Google 官方 Carbon API 不提供免費層。
Q7:Carbon 有哪些已知限制?
模型卡披露:仍可能出現幻覺,高推理等級可能消耗大量 Token,可能響應較慢或超時,知識截止爲 2026 年 3 月,Prompt Injection 防護仍需改進。另外 `thinking_budget` 不受支持、採樣參數會被忽略,遷移舊代碼時需要檢查。
Gemini 4 Argon 和 Carbon 核心要點 Key Takeaways
- 關係定位:Carbon 基於 Argon 構建,兩者是分工互補,不是高低配替代。
- 核心差異:Carbon 每輪思考更多、驗證更充分;Argon 響應更快、單輪更省。
- 基準表現:AA v5.0.1 High 配置下 Carbon 綜合 60 分,Argon 50 分。
- 成本真相:單價相同,AA 任務中 Carbon High 每任務成本反而低於 Argon High。
- 檔位選擇:Carbon 默認 MEDIUM,按“夠用的最低檔”原則選擇 LOW/MEDIUM/HIGH。
- 上手方式:通過 API易 apiyi.com 用一套 OpenAI 兼容代碼同時測試兩款模型。
總結
Gemini 4 Argon 和 Carbon 的區別可以歸納爲三點:
- 推理投入不同:Argon 負責效率,Carbon 用更多思考 Token 挑戰複雜推理極限。
- 延遲與成本要分開看:Carbon 首次響應更慢,但在特定評測中完整任務成本可能更低。
- 選擇依據是任務難度:日常工程優先 Argon,複雜工程、科學推理、安全審計再交給 Carbon。
不要把所有請求都交給最高推理等級,先用真實任務測出每類工作的“夠用檔位”,纔是控制質量、速度和成本的關鍵。推薦通過 API易 apiyi.com 快速驗證兩款模型在你業務上的實際表現,平臺支持按量計費和多模型統一接口。
📚 參考資料
- Gemini 4 Carbon Model Card:Google DeepMind 官方模型卡
- 鏈接:
deepmind.google/models/model-cards/gemini-4-carbon -
說明:Carbon 基於 Argon 構建、上下文規格、官方評測與已知限制
-
Choosing between Carbon and Argon:Google AI Studio 開發者文檔
- 鏈接:
aistudio.google.com/docs/whats-new-gemini-4-carbon -
說明:兩款模型的官方定位差異與 Thinking Level 選擇建議
-
Gemini 4 Carbon Developer Guide:Google Cloud 開發者指南
- 鏈接:
docs.cloud.google.cn/gemini-enterprise-agent-platform/models/guides/gemini-4-carbon -
說明:推理等級、API 參數限制與長解碼說明
-
Gemini API 定價:Google AI for Developers
- 鏈接:
ai.google.dev/gemini-api/docs/pricing -
說明:首發價、12 月調價、緩存與思考 Token 計費規則
-
Gemini 4 Carbon vs Gemini 4 Argon:Artificial Analysis 對比頁
- 鏈接:
artificialanalysis.ai/zh/models/comparisons/gemini-4-carbon-vs-gemini-4-argon -
說明:AA Index v5.0.1 High 配置下的能力、成本與延遲對比
-
MKA 多模態知識工作評測:Artificial Analysis
- 鏈接:
artificialanalysis.ai/zh/evaluations/mka - 說明:分行業領先模型與任務成本數據
作者:APIYI 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多模型接入資料可訪問 docs.apiyi.com 文檔中心