Catatan penulis: Artikel ini membandingkan Gemini 4 Argon dan Carbon dari sisi upaya penalaran, kecepatan respons, dan biaya tugas, supaya developer bisa memilih model sesuai tingkat kesulitan tugasnya.
Google merilis Gemini 4 Argon pada 13 Oktober 2026, lalu mengumumkan Gemini 4 Carbon untuk pertama kalinya pada 28 Oktober. Pada 10 November, Carbon resmi dibuka untuk developer, perusahaan, dan konsumen. Reaksi pertama banyak developer: apakah Carbon adalah versi upgrade yang menggantikan Argon? Artikel ini membandingkan perbedaan nyata keduanya dari 5 dimensi: upaya penalaran, latensi respons, biaya tugas, skenario penggunaan, dan tingkat penalaran.
Ini bukan analisis yang berujung pada kesimpulan “spesifikasi tertinggi pasti paling bagus”. Dokumentasi developer resmi Google menyebutkan bahwa Argon tetap menjadi pilihan yang direkomendasikan untuk sebagian besar pekerjaan engineering dan pekerjaan berbasis pengetahuan, sedangkan Carbon ditujukan untuk tugas yang membutuhkan penalaran lebih dalam dan siklus verifikasi yang lebih panjang. Artikel ini terutama merujuk pada dokumentasi resmi Google, dan data pihak ketiga akan disertai keterangan versi evaluasi dan tingkat penalarannya.
Nilai utama: Setelah membaca artikel ini, kamu akan tahu tugas mana yang cukup diserahkan ke Argon, tugas mana yang layak diserahkan ke Carbon, dan cara memakai Thinking Level untuk mengatur keseimbangan antara kualitas, kecepatan, dan biaya.
7 Istilah yang Perlu Dipahami Sebelum Membandingkan Gemini 4 Argon dan Carbon
Saat membandingkan dua model penalaran, ada beberapa konsep yang sering tercampur. Pisahkan dulu supaya angka-angka di bagian berikutnya tidak disalahartikan:
- Tingkat penalaran (Thinking Level): pengaturan yang mengontrol seberapa besar usaha berpikir model. Carbon menyediakan tiga tingkat: LOW, MEDIUM, dan HIGH.
- Token berpikir: Token yang dihasilkan model saat bernalar, dan ditagih sebagai Token keluaran.
- Biaya tugas: total biaya seluruh pemanggilan model untuk menyelesaikan satu tugas, bukan biaya satu permintaan.
- Latensi penalaran: waktu dari saat model menerima permintaan sampai menghasilkan hasil. Artikel ini terutama melihat latensi Token jawaban pertama.
- Pembacaan cache: skema penagihan untuk konteks masukan yang dipakai ulang, dengan harga jauh lebih murah daripada masukan biasa.
- Agent: agen cerdas yang bisa menjalankan tugas bertahap lewat alat, misalnya menulis kode, menjalankan pengujian, lalu memperbaikinya.
- Benchmark: metode untuk menilai dan membandingkan model memakai sekumpulan tugas tetap. Kesimpulannya hanya berlaku untuk konfigurasi pengujian tersebut.
Mengapa Google Merilis Gemini 4 Argon dan Carbon Sekaligus
Menurut model card Carbon dari Google DeepMind, Gemini 4 Carbon dibangun di atas Gemini 4 Argon. Artinya, keduanya punya fondasi model yang sama, dan Carbon adalah versi yang diperkuat lagi untuk penalaran tingkat sulit, rekayasa perangkat lunak yang kompleks, alur kerja Agent jangka panjang, riset ilmiah, dan pertahanan keamanan siber. Perlu dicatat bahwa Google tidak mengungkap jumlah parameter Carbon dan tidak membuka perbedaan arsitektur komputasi internal keduanya, jadi klaim semacam “Carbon beberapa kali lebih besar dari Argon” tidak punya dasar.
Kalau Carbon memang lebih kuat, kenapa tidak langsung menggantikan Argon? Karena keduanya menangani jenis pekerjaan yang berbeda. Pengembangan fitur sehari-hari dan perubahan kode yang sering berinteraksi lebih mementingkan kecepatan respons dan biaya Token per putaran. Sementara tugas seperti desain arsitektur, investigasi akar masalah lintas subsistem, dan pembuktian ilmiah lebih menuntut kemampuan model untuk berulang kali mengajukan hipotesis, memverifikasi, dan memperbaikinya. Saran pemilihan model di dokumentasi pengembang Google juga berupa pembagian peran, bukan penggantian: Argon menangani sebagian besar pekerjaan rekayasa sehari-hari, Carbon menangani tugas penalaran yang lebih sulit dan berjangka panjang.
Pembagian peran ini juga terlihat di produk Google sendiri. Pada fitur pratinjau multi-Agent /swarm di Antigravity, Google menyarankan agar Carbon menangani desain arsitektur keseluruhan, koordinasi tugas, dan tinjauan keamanan, sedangkan implementasi kode rutin dan perubahan file secara paralel diserahkan ke model yang lebih cepat dan ringan. Di sisi konsumen pun sama: hak akses model pada langganan Google AI Pro terutama Argon, sedangkan Carbon baru termasuk dalam langganan Ultra.
Perbedaan Inti Gemini 4 Argon dan Carbon: Investasi Penalaran per Giliran
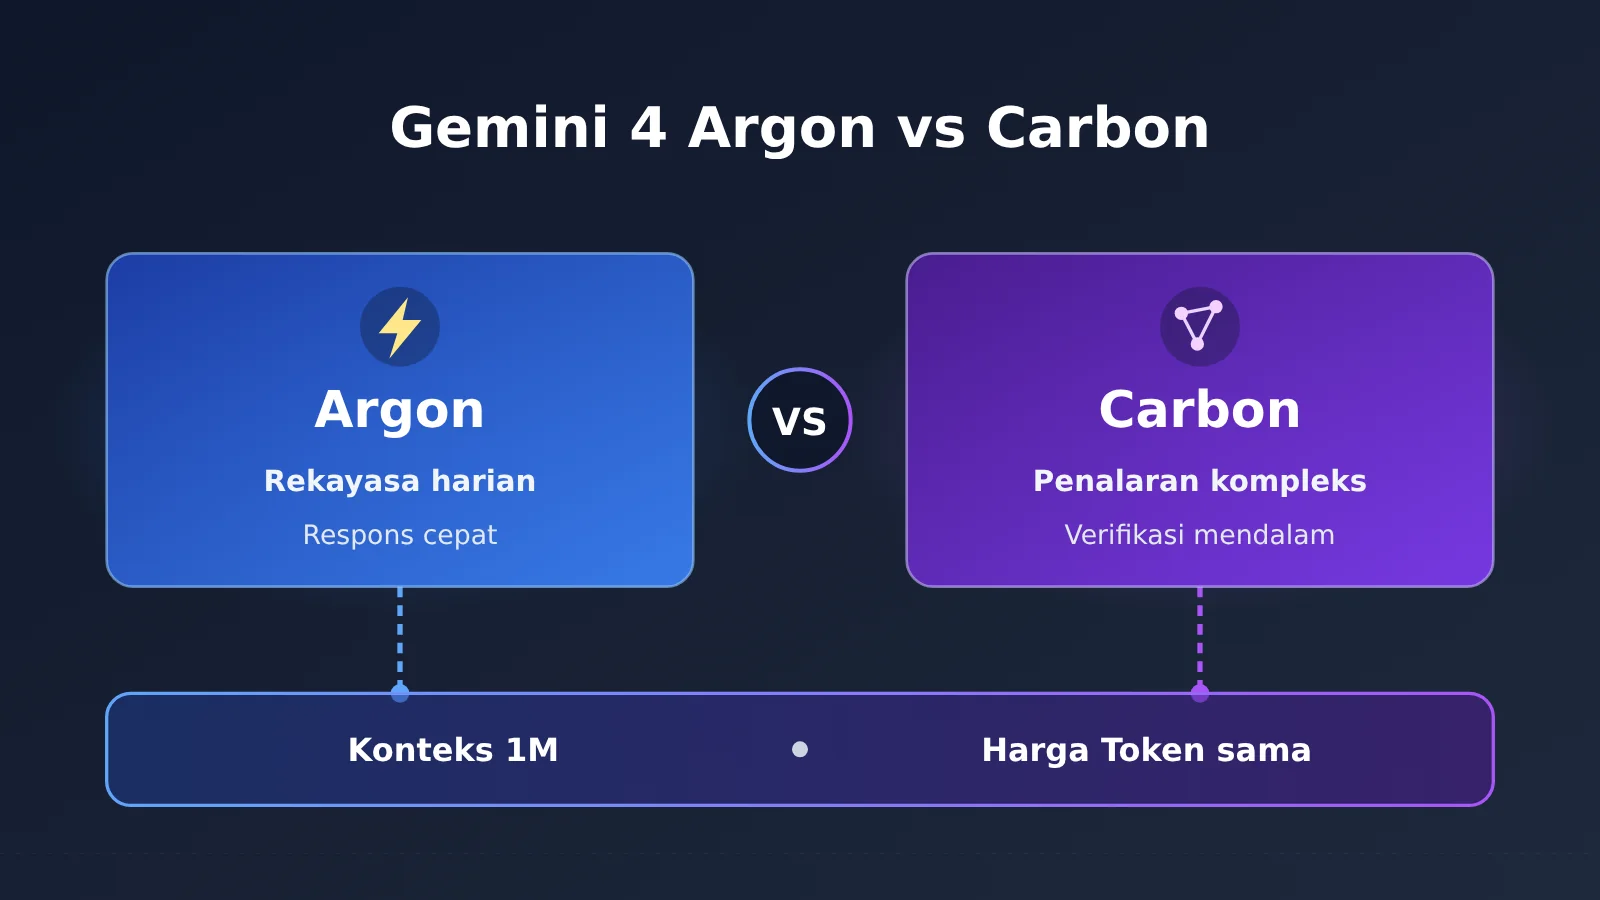
Google memberikan penjelasan paling langsung di bagian “Choosing between Carbon and Argon” dalam panduan developer Carbon. Carbon menghabiskan lebih banyak token berpikir di setiap giliran untuk mengeksplorasi dan memverifikasi hasil kerjanya secara lebih menyeluruh. Argon, sebaliknya, menawarkan respons lebih cepat dengan konsumsi token per giliran yang lebih rendah, sehingga cocok untuk pemrograman interaktif dan pengembangan fitur sehari-hari. Keduanya sama-sama memiliki jendela konteks terpadu 1M token (1.048.576 token, dibagi untuk input dan output), memakai kemampuan alat bawaan yang sama, dan dikenai harga per token yang sama.
| Dimensi Perbandingan | Gemini 4 Argon | Gemini 4 Carbon | Lebih Cocok |
|---|---|---|---|
| Posisi produk | Model penalaran umum berkinerja tinggi dan efisien | Model penalaran kompleks yang lebih mendalam | Tergantung tugas |
| Token berpikir per giliran | Relatif lebih sedikit | Lebih banyak di setiap giliran | Argon lebih hemat |
| Kecepatan respons | Lebih cepat | Lebih lambat pada tugas kompleks | Argon |
| Pengembangan interaktif | Lebih cocok | Bisa dipakai untuk tugas berat | Argon |
| Pengembangan fitur sehari-hari | Direkomendasikan | Biasanya tidak perlu | Argon |
| Desain arsitektur, investigasi akar masalah | Mampu menangani | Lebih cocok untuk investigasi yang sangat kompleks dan mendalam | Carbon |
| Pembuktian ilmiah, audit keamanan | Mampu menangani / didukung | Lebih cocok untuk penalaran dan verifikasi yang kompleks | Carbon |
| Jendela konteks dan harga per token | Jendela konteks 1M bersama, harga sama | Jendela konteks 1M bersama, harga sama | Seimbang |
Dari tabel ini terlihat bahwa garis pemisah antara Gemini 4 Argon dan Carbon bukan soal “bisa atau tidak bisa”, melainkan “apakah layak berpikir lebih lama”. Argon juga mampu menangani desain arsitektur dan investigasi akar masalah. Namun, ketika masalahnya sudah serumit itu sampai butuh beberapa putaran hipotesis dan verifikasi, Carbon mau mengeluarkan lebih banyak token berpikir demi hasil yang lebih andal.
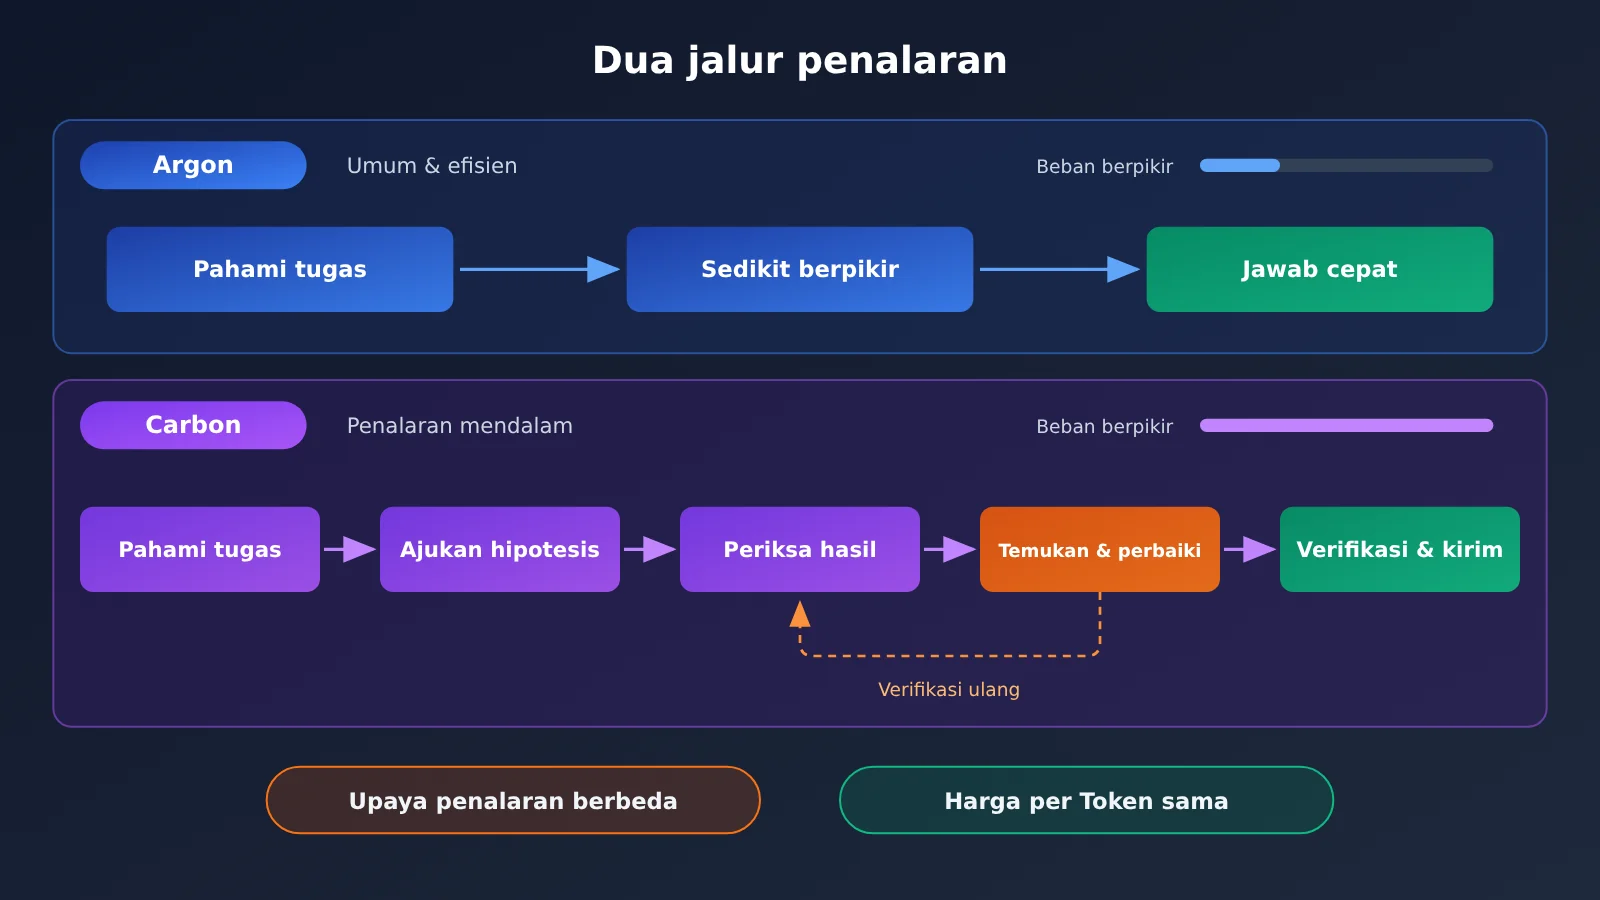
Cara kerja Carbon lebih mirip siklus eksekusi yang utuh: memahami tujuan dan batasan, memecah tugas, menyusun rencana, memanggil alat, memeriksa hasil antara, mengenali kesalahan, memperbaiki dan memverifikasi ulang, lalu menyerahkan hasil akhir. Siklus inilah yang membuatnya unggul pada tugas berjangka panjang, sekaligus menjelaskan mengapa waktu tunggu untuk jawaban pertamanya lebih lama.
Perbandingan Benchmark Independen Gemini 4 Argon dan Carbon
Klaim resmi perlu diverifikasi dengan data independen. Artificial Analysis menyediakan halaman perbandingan langsung Carbon dan Argon di Intelligence Index v5.0.1. Semua data di bawah ini adalah hasil dengan konfigurasi penalaran High.
| Metrik (AA v5.0.1, penalaran High) | Carbon High | Argon High | Selisih |
|---|---|---|---|
| Indeks kemampuan komprehensif | 60 | 50 | Carbon +10 |
| AutomationBench-AA | 77.8% | 77.5% | Hampir setara |
| Terminal-Bench 4.0 | 65.2% | 57.1% | Carbon unggul |
| FrontierCode 2.0 | 40.6% | 25.7% | Carbon unggul jauh |
| AA-Omniscience (skor keandalan pengetahuan) | 54 | 46 | Carbon unggul |
| HLE-Diamond | 69.1% | 56.7% | Carbon unggul |
| Biaya per tugas | $7.76 | $9.95 | Carbon lebih murah |
| Waktu per tugas | 25,6 menit | 28,9 menit | Carbon lebih singkat |
| Latensi Token jawaban pertama | sekitar 68 detik | sekitar 37 detik | Argon lebih cepat |
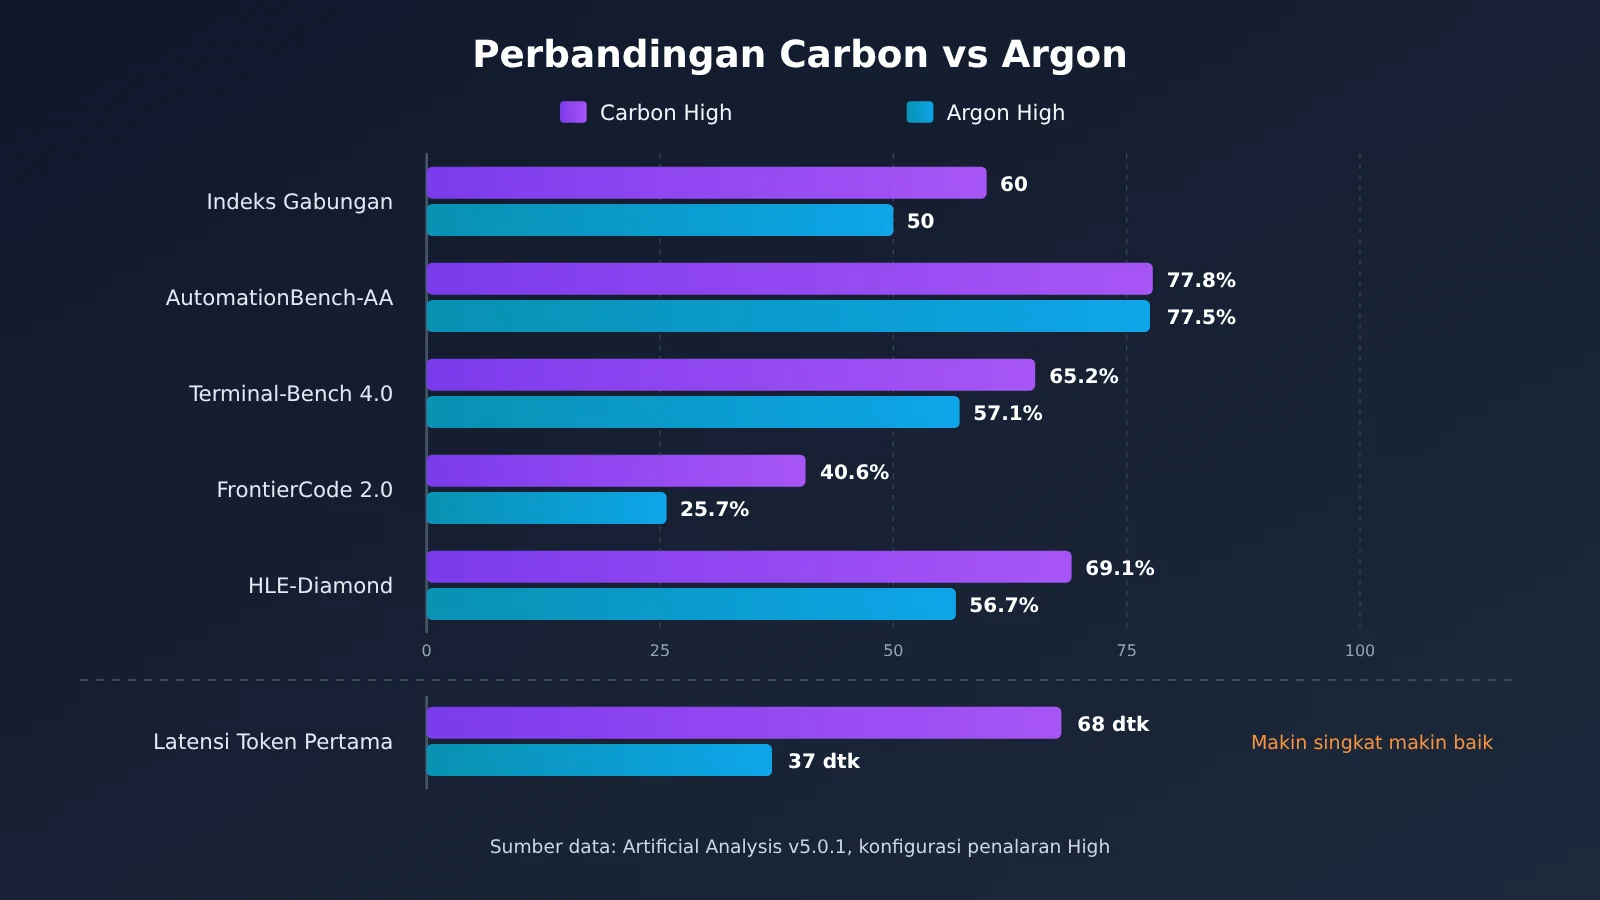
Beberapa kesimpulan yang patut dicermati:
- Selisih terbesar ada di rekayasa kompleks dan penalaran kompleks: di FrontierCode 2.0 Carbon unggul hampir 15 poin persentase, di HLE-Diamond sekitar 12 poin persentase, dan di Terminal-Bench 4.0 sekitar 8 poin persentase.
- Selisih pada tugas otomasi rutin sangat kecil: AutomationBench-AA hanya berbeda 0,3 poin persentase. Artinya, untuk tugas otomatis yang berbasis alur kerja, Argon sudah lebih dari cukup.
- Keandalan pengetahuan membaik: skor AA-Omniscience 54 berbanding 46. Agentic Honesty Benchmark di model card Google juga menunjukkan Carbon 92% dan Argon 70%.
- Respons pertama Argon jauh lebih cepat: sekitar 37 detik berbanding sekitar 68 detik. Ini adalah harga langsung dari penalaran ekstra yang dilakukan Carbon.
Model card resmi Google (waktu evaluasi tercatat Oktober 2026, umumnya Pass@1 dengan tingkat penalaran tertinggi yang tersedia) menunjukkan tren yang sama. Di SWE-sweep, Carbon meraih 9.6% dan Argon 4.3%. Di GraphWalks (256k—1M, BFS F1), Carbon 96.2% dan Argon 84.2%. Di Terminal-Bench Science 0.1, Carbon 64.8% dan Argon 52.9%. Model card resmi dan Artificial Analysis memakai sistem evaluasi dan titik waktu yang berbeda, jadi sebaiknya jangan dicampur dalam satu peringkat. Selain itu, halaman model Carbon mencatat waktu per tugas pada konfigurasi High sebesar 24,9 menit, sedikit berbeda dari 25,6 menit di halaman perbandingan. Tabel di artikel ini mengikuti data halaman perbandingan.
Skor benchmark juga bukan segalanya. Dalam evaluasi kerja berbasis pengetahuan multimodal MKA yang dirilis bersama oleh Google DeepMind dan Artificial Analysis, tidak ada satu model pun yang unggul di seluruh 10 industri: Argon unggul di bidang sains, sedangkan Carbon unggul di bidang kesehatan. Ini mengingatkan kita bahwa skor komprehensif Carbon yang lebih tinggi tidak berarti ia mengalahkan Argon di setiap bidang.
💡 Catatan perbandingan: benchmark hanya mencerminkan performa pada kumpulan tugas yang tetap. Cara paling andal untuk menentukan apakah kebutuhan bisnis Anda memerlukan Carbon adalah menjalankan tugas nyata Anda sendiri di kedua model. Lewat APIYI (apiyi.com), Anda bisa berpindah antara kedua model dengan satu kunci API dan satu set kode yang kompatibel dengan OpenAI, sehingga uji perbandingan skala kecil jadi lebih mudah.
Mengapa Gemini 4 Carbon Memakai Lebih Banyak Token per Putaran, tetapi Belum Tentu Lebih Mahal
Ini bagian yang paling sering disalahpahami. Gemini 4 Argon dan Carbon punya harga per Token yang sama: sebelum 30 November 2026, harga peluncurannya 2 dolar AS per sejuta Token input dan 10 dolar AS per sejuta Token output. Mulai 1 Desember, harganya naik menjadi 4 dolar AS dan 20 dolar AS. Harga input yang di-cache mendapat diskon 95% dari harga input. Token berpikir dihitung sebagai Token output, jadi karena Carbon lebih banyak “berpikir” di tiap putaran, tagihan per putaran biasanya memang lebih tinggi.
Namun tagihan per tugas tidak sama dengan tagihan per putaran. Dalam perbandingan konfigurasi High di Artificial Analysis v5.0.1, biaya per tugas Carbon adalah 7,76 dolar AS, sedangkan Argon 9,95 dolar AS. Jadi Carbon justru sekitar 22% lebih murah, dan waktunya juga sekitar 3 menit lebih singkat. Penjelasan yang masuk akal: biaya satu tugas utuh ditentukan oleh berapa putaran yang dibutuhkan, seberapa banyak jalan memutar yang diambil, dan berapa kali pekerjaan harus diulang. Kalau Carbon berpikir lebih banyak di awal dan lebih jarang salah, putaran percobaan ulang dan perbaikan di belakang bisa berkurang.
| Konfigurasi (AA v5.0.1) | Skor gabungan | Biaya per tugas | Waktu per tugas | Latensi jawaban pertama |
|---|---|---|---|---|
| Carbon Low | 54 | $7,19 | 22,3 menit | 12,37 detik |
| Carbon Medium | 58 | $6,59 | 23,3 menit | 23,16 detik |
| Carbon High | 60 | $7,76 | 24,9 menit | 67,54 detik |
| Argon High | 50 | $9,95 | 28,9 menit | sekitar 37 detik |
Data ini juga memuat temuan yang berlawanan dengan intuisi: biaya tugas Carbon Medium justru lebih rendah daripada Low. Level penalaran yang lebih rendah memang lebih hemat per putaran, tetapi bisa membutuhkan lebih banyak putaran untuk menyelesaikan tugas. Meski begitu, perhatikan batasan perbandingannya:
- Biaya di atas adalah biaya rata-rata per tugas dalam sistem evaluasi tersebut, dihitung dengan harga standar 4/20 dolar AS, bukan harga satu permintaan API biasa. Kalau dihitung dengan harga peluncuran, biaya untuk penggunaan Token yang sama kira-kira separuhnya.
- Waktu seperti 24,9 menit adalah waktu tertimbang untuk tugas evaluasi Agent. Bukan berarti pertanyaan biasa harus menunggu 25 menit.
- Kesimpulan ini hanya berlaku untuk rangkaian tugas AA Index. Kalau tugas Anda sederhana dan selesai dalam satu atau dua putaran, keunggulan per putaran dari Argon atau level yang lebih rendah akan langsung terlihat sebagai tagihan yang lebih kecil.
💰 Saran biaya: Saat mengevaluasi model, catat “total Token dan total waktu untuk menyelesaikan satu tugas”, jangan hanya membandingkan harga satuan. APIYI (apiyi.com) memakai penagihan sesuai pemakaian, dan konsolnya menampilkan rincian penggunaan tiap pemanggilan, sehingga cocok untuk menghitung biaya tugas Argon dan Carbon yang sebenarnya pada kasus bisnis Anda.
Kapan Memilih Gemini 4 Argon, Kapan Memilih Carbon
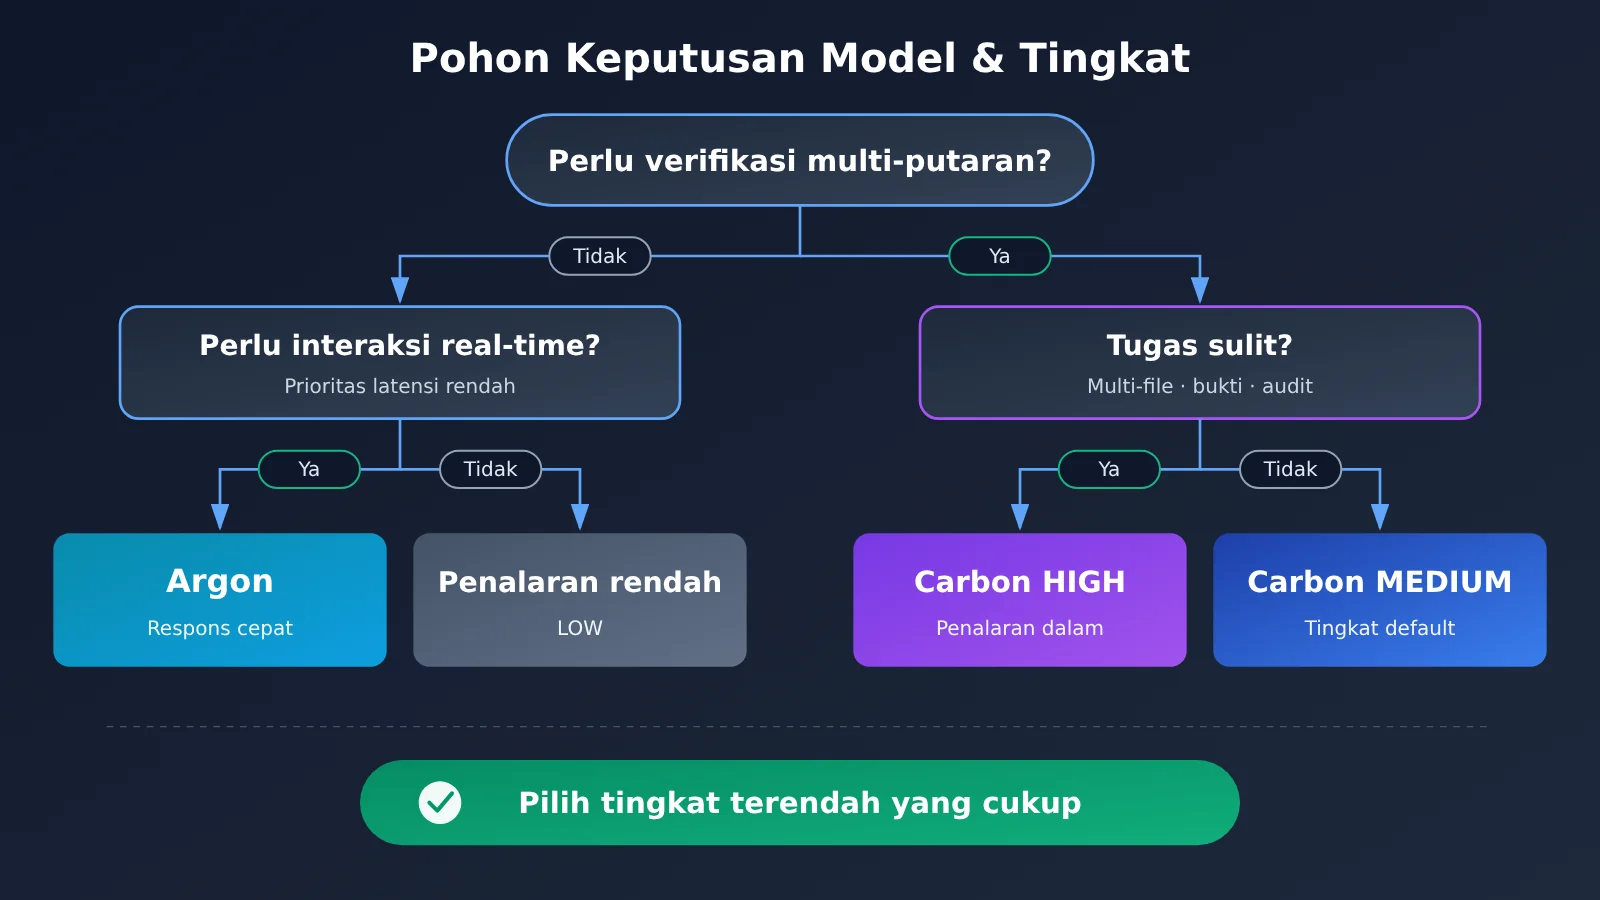
Berdasarkan positioning resmi Google dan data di atas, kita bisa membagi pekerjaan menurut tingkat kesulitan tugas. Prinsip intinya: tanyakan dulu apakah tugas tersebut layak dikerjakan dengan penalaran yang lebih dalam, baru tentukan model dan tingkatannya.
| Jenis tugas | Model yang disarankan | Tingkat yang disarankan | Alasan |
|---|---|---|---|
| Pengembangan fitur sehari-hari, perubahan kode rutin | Argon | Default atau sedang | Respons cepat, biaya per putaran rendah, cocok untuk interaksi yang sering |
| Pemrograman interaktif, bantuan real-time di IDE | Argon | Sedang | Latensi respons pertama jauh lebih rendah |
| Proyek kompleks multi-file, desain arsitektur | Carbon | HIGH | Selisih di FrontierCode dan Terminal-Bench terlihat jelas |
| Investigasi akar masalah mendalam lintas subsistem | Carbon | MEDIUM / HIGH | Perlu eksplorasi banyak hipotesis dan verifikasi berulang |
| Penalaran ilmiah tingkat sulit, pembuktian formal | Carbon | HIGH | Secara resmi, pembuktian formal masuk kategori penggunaan HIGH |
| Audit keamanan, penemuan celah | Carbon | HIGH | Menurut positioning resmi, lebih cocok untuk audit yang kompleks |
| Klasifikasi sederhana, ringkasan, ekstraksi metadata | Tingkat penalaran rendah | LOW | Sensitif terhadap biaya, tidak butuh penalaran mendalam |
Skenario yang Cocok untuk Gemini 4 Argon
- Pekerjaan pengembangan dengan interaksi yang sering: menulis satu fungsi, mengubah gaya tampilan, menambah tes. Menunggu 37 detik dan 68 detik terasa sangat berbeda.
- Pekerjaan pengetahuan rutin dan alur otomasi: di AutomationBench-AA keduanya nyaris seimbang, jadi tidak perlu membayar mahal untuk selisih yang kecil.
- Pekerjaan pengetahuan di bidang sains: pada evaluasi MKA, Argon unggul di bidang sains, jadi layak dicoba lebih dulu.
Skenario yang Cocok untuk Gemini 4 Carbon
- Tugas Agent jangka panjang yang berjalan di latar belakang: tidak peduli dengan latensi pertama, lebih mementingkan hasil yang benar dalam sekali jalan.
- Pekerjaan teknik dan keputusan arsitektur yang kompleks: migrasi multi-file, refaktor sistem, audit kode yang rumit.
- Tugas yang menuntut hasil bisa diverifikasi: penalaran ilmiah, audit keamanan, laporan analisis yang perlu memeriksa dirinya sendiri.
Umpan balik awal dari komunitas juga mendukung pembagian peran ini. Di Hacker News dan Reddit, ada developer yang menilai Carbon bisa menemukan masalah yang terlewat oleh model lain, tetapi ada juga yang mengeluhkan waktu tunggu jawaban pertama yang terlalu lama dan kuota yang cepat habis. Seorang pengguna Reddit memakai Carbon Medium di proyek Go untuk memigrasikan sebuah library yang melibatkan 230 file, dan berhasil dijalankan pada percobaan pertama. Namun, penulisnya juga menjelaskan bahwa sampelnya hanya 4 tahap dan bukan eksperimen terkontrol, jadi ini hanya layak dijadikan contoh kasus sebagai referensi.
Cara Menggunakan Thinking Level untuk Mengontrol Kualitas, Kecepatan, dan Biaya Gemini 4 Carbon
Carbon menyediakan tiga tingkat penalaran: LOW, MEDIUM, dan HIGH. Model publik gemini-4-carbon memakai MEDIUM secara default. Pembagian penggunaan yang disarankan secara resmi adalah sebagai berikut: LOW untuk klasifikasi, perangkuman, dan ekstraksi metadata; MEDIUM untuk kode umum, pemanggilan alat, tanya jawab dokumen, dan pemahaman video; HIGH untuk rekayasa perangkat lunak multi-file, perancangan arsitektur, pembuktian formal, dan penemuan celah keamanan.
Default MEDIUM bukan tanpa alasan. Di AA v5.0.1, Carbon Medium meraih skor gabungan 58, hanya 2 poin di bawah High, tetapi biaya per tugasnya paling rendah dan latensi jawaban pertamanya sekitar sepertiga dari High. Pada tes keandalan fakta AA-Omniscience, proporsi jawaban karangan Medium adalah 4,2%, lebih rendah daripada High yang 11,4% dan Low yang 20,0% (ini adalah metrik dari tes tertentu, bukan tingkat halusinasi secara umum). Google juga menyarankan pengembang untuk mencoba berbagai tingkat dan memilih tingkat terendah yang masih memenuhi standar kualitas, bukan langsung memakai HIGH tanpa pertimbangan.
Ada beberapa batasan teknis Carbon yang perlu diperhatikan saat pemanggilan:
thinking_budgettidak didukung, dan penggunaannya akan mengembalikan HTTP 400.- Tingkat MINIMAL tidak didukung.
temperature,top_p, dantop_kakan diabaikan.- Context Caching eksplisit tidak didukung, tetapi prefiks petunjuk yang sama dengan panjang 4096 token atau lebih bisa memicu cache implisit otomatis.
Contoh Minimalis
Berikut cara memanggil Gemini 4 Carbon lewat antarmuka yang kompatibel dengan OpenAI. Cukup sekitar 10 baris kode dan langsung bisa dijalankan:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # ID model mengikuti daftar model di platform
    messages=[{"role": "user", "content": "分析这段服务超时日志的可能根因"}]
)
print(response.choices[0].message.content)
Lihat kode implementasi lengkap: merutekan Argon dan Carbon berdasarkan tingkat kesulitan tugas
import time
import openai
from typing import Literal

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Nama model hanya contoh, gunakan ID sebenarnya dari daftar model di platform
ARGON_MODEL = "gemini-4-argon"
CARBON_MODEL = "gemini-4-carbon"

Difficulty = Literal["simple", "daily", "complex", "extreme"]

def route(difficulty: Difficulty) -> tuple[str, str]:
    """Mengembalikan (model, tingkat penalaran) sesuai tingkat kesulitan tugas"""
    if difficulty == "simple":
        return CARBON_MODEL, "low"      # Klasifikasi, ringkasan, ekstraksi metadata
    if difficulty == "daily":
        return ARGON_MODEL, "medium"    # Pengembangan harian, interaksi yang sering
    if difficulty == "complex":
        return CARBON_MODEL, "medium"   # Investigasi akar masalah, tugas Agent biasa
    return CARBON_MODEL, "high"         # Rekayasa multi-file, pembuktian, audit keamanan

def run_task(prompt: str, difficulty: Difficulty) -> dict:
    model, effort = route(difficulty)
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        # Cara pemetaan parameter tingkat penalaran mengikuti dokumentasi platform;
        # Carbon tidak mendukung thinking_budget, jika dikirim akan error 400
        reasoning_effort=effort,
    )
    usage = resp.usage
    return {
        "model": model,
        "effort": effort,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,  # Termasuk token berpikir
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    result = run_task("为订单服务设计分库分表迁移方案,并列出验证步骤", "extreme")
    print(result["model"], result["effort"], result["seconds"], "s")
    print("输出 Token:", result["completion_tokens"])
🚀 Saran untuk memulai: Sebaiknya daftar dulu di APIYI apiyi.com dan klaim kuota uji coba gratis. Lalu gunakan fungsi routing di atas untuk mengirim kumpulan tugas nyata yang sama ke Argon dan Carbon di berbagai tingkat penalaran, dan catat waktu proses serta
completion_tokens-nya. Satu kunci API sudah cukup untuk seluruh perbandingan ini, tanpa perlu mengintegrasikan beberapa SDK sekaligus.
Rekomendasi Memilih Gemini 4 Argon dan Carbon
Kalau hanya bisa mengingat satu aturan: pakai Argon sebagai default, lalu naik ke Carbon untuk tugas yang memang butuh pemikiran mendalam. Penerapannya bisa dibagi menjadi tiga langkah:
- Buat aturan pembagian tugas: Kelompokkan tugas menjadi empat kategori sesuai tabel skenario di atas, yaitu sederhana, harian, kompleks, dan sangat sulit. Tugas kategori harian langsung diarahkan ke Argon.
- Uji dengan sampel kecil: Ambil 10–20 tugas nyata dari tiap kategori, lalu bandingkan tingkat keberhasilan, total Token, dan total waktu proses antara Argon dan setiap level Carbon.
- Tentukan level berdasarkan biaya tugas: Pilih level terendah yang masih memenuhi standar kualitas, dan lakukan pengujian ulang secara berkala karena model, harga, dan papan peringkat bisa saja berubah.
Untuk sistem multi-Agent, kamu juga bisa meniru pendekatan Google /swarm: Carbon bertugas merencanakan, mengoordinasikan, dan meninjau, sedangkan Argon atau model yang lebih ringan menangani eksekusi massal. Dengan begitu, kamu tetap mendapat kemampuan penalaran mendalam Carbon tanpa membuat setiap tahap menanggung latensinya.
💡 Saran memilih: Harga Token per unit kedua model ini sama, jadi yang benar-benar membedakan adalah struktur tugasmu. Kami menyarankan untuk mengintegrasikan Argon dan Carbon sekaligus lewat antarmuka yang kompatibel dengan OpenAI di APIYI apiyi.com, lalu atur peralihannya lewat routing di level kode. Dengan begitu, saat strategi perlu disesuaikan nanti, kode bisnis tidak perlu diubah.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa hubungan antara Gemini 4 Argon dan Carbon?
Berdasarkan model card Google DeepMind, Gemini 4 Carbon dibangun di atas Gemini 4 Argon. Keduanya sama-sama bagian dari seri model penalaran Gemini 4, dengan jendela konteks 1M Token dan kemampuan alat bawaan yang sama. Carbon menggunakan lebih banyak Token berpikir di setiap putaran untuk eksplorasi dan verifikasi, sedangkan Argon lebih mengutamakan kecepatan respons dan efisiensi per putaran. Google tidak mengungkap perbedaan jumlah parameter maupun arsitektur di antara keduanya.
Q2: Apakah Carbon akan sepenuhnya menggantikan Argon?
Tidak. Google menegaskan bahwa Argon tetap menjadi pilihan ideal untuk sebagian besar tugas rekayasa dan pekerjaan berbasis pengetahuan, sementara Carbon cocok untuk tugas yang lebih sulit dan berjangka panjang. Lihat saja datanya: di AutomationBench-AA skor keduanya hampir sama, dan di MKA Argon justru unggul di bidang sains. Artinya, Argon masih kompetitif di banyak skenario.
Q3: Apakah harga kedua model sama? Kapan harganya naik?
Dokumentasi developer Google menunjukkan bahwa keduanya memakai harga per Token yang sama. Harga peluncuran adalah 2/10 dolar AS per sejuta Token input/output, berlaku sampai 30 November 2026. Mulai 1 Desember, harga disesuaikan menjadi 4/20 dolar AS. Token berpikir dihitung sebagai biaya output, jadi harga satuan yang sama bukan berarti biaya tugasnya juga sama.
Q4: Jawaban pertama Carbon lambat. Apakah cocok untuk aplikasi chat?
Kurang cocok untuk skenario yang menuntut respons real-time. Di AA v5.0.1, latensi Token jawaban pertama Carbon High sekitar 68 detik, Argon High sekitar 37 detik, dan Carbon Low sekitar 12 detik. Untuk interaksi real-time, sebaiknya pakai Argon. Carbon lebih pas untuk analisis kompleks di latar belakang dan tugas Agent berjangka panjang.
Q5: Bagaimana cara membandingkan Argon dan Carbon dengan cepat lewat API?
Disarankan memakai platform agregator API yang mendukung banyak model:
1. Kunjungi APIYI (apiyi.com), daftar akun, lalu ambil kunci API dan kuota uji coba gratis;
2. Atur base_url di kode Anda ke `https://api.apiyi.com/v1`;
3. Cukup ubah parameter `model` untuk berpindah antara kedua model, lalu bandingkan hasilnya pada tingkat penalaran yang berbeda.
Q6: Kalau tidak berlangganan Google AI Ultra, apakah masih bisa memakai Carbon?
Bisa. Langganan Ultra hanya menentukan apakah pengguna di sisi konsumen (seperti Gemini App) bisa langsung memilih Carbon, sedangkan AI Pro terutama mencakup Argon. Developer bisa memanggil Carbon lewat tingkat berbayar Gemini API tanpa perlu membeli Ultra. Perlu diingat bahwa API resmi Carbon dari Google tidak menyediakan tingkat gratis.
Q7: Apa saja keterbatasan Carbon yang sudah diketahui?
Model card mengungkapkan beberapa hal: halusinasi masih mungkin terjadi, tingkat penalaran tinggi bisa menghabiskan banyak Token, respons bisa lambat atau timeout, batas pengetahuan modelnya sampai Maret 2026, dan perlindungan terhadap Prompt Injection masih perlu ditingkatkan. Selain itu, `thinking_budget` tidak didukung dan parameter sampling akan diabaikan, jadi periksa dulu kode lama Anda saat melakukan migrasi.
Poin Penting Gemini 4 Argon dan Carbon (Key Takeaways)
- Posisi keduanya: Carbon dibangun di atas Argon. Keduanya saling melengkapi dengan pembagian tugas yang berbeda, bukan versi tinggi dan rendah yang saling menggantikan.
- Perbedaan utama: Carbon berpikir lebih banyak dan memverifikasi lebih teliti di setiap putaran. Argon merespons lebih cepat dan lebih hemat per putaran.
- Hasil benchmark: Pada konfigurasi High di AA v5.0.1, skor gabungan Carbon 60, sedangkan Argon 50.
- Fakta soal biaya: Harga satuannya sama. Pada tugas-tugas AA, biaya per tugas Carbon High justru lebih rendah daripada Argon High.
- Memilih level: Carbon secara default memakai MEDIUM. Pilih LOW/MEDIUM/HIGH dengan prinsip “level terendah yang sudah cukup”.
- Cara memulai: Lewat APIYI (apiyi.com), Anda bisa menguji kedua model sekaligus dengan satu set kode yang kompatibel dengan OpenAI.
Kesimpulan
Perbedaan Gemini 4 Argon dan Carbon bisa diringkas menjadi tiga hal:
- Porsi penalaran berbeda: Argon fokus pada efisiensi, sedangkan Carbon memakai lebih banyak token berpikir untuk menembus batas penalaran yang kompleks.
- Latensi dan biaya perlu dilihat terpisah: Respons pertama Carbon lebih lambat, tetapi pada evaluasi tertentu biaya untuk menyelesaikan satu tugas penuh bisa lebih rendah.
- Dasar pemilihan adalah tingkat kesulitan tugas: Untuk pekerjaan rekayasa sehari-hari, utamakan Argon. Serahkan ke Carbon untuk rekayasa yang kompleks, penalaran ilmiah, dan audit keamanan.
Jangan menyerahkan semua permintaan ke level penalaran tertinggi. Uji dulu tugas-tugas nyata Anda untuk menemukan “level yang cukup” bagi setiap jenis pekerjaan. Cara inilah yang menjaga keseimbangan antara kualitas, kecepatan, dan biaya. Kami menyarankan Anda memverifikasi performa kedua model pada kasus bisnis Anda lewat APIYI (apiyi.com). Platform ini mendukung penagihan sesuai pemakaian dan antarmuka terpadu untuk banyak model.
📚 Referensi
- Gemini 4 Carbon Model Card: Kartu model resmi Google DeepMind
- Tautan:
deepmind.google/models/model-cards/gemini-4-carbon -
Keterangan: Carbon dibangun di atas Argon, spesifikasi konteks, evaluasi resmi, dan keterbatasan yang sudah diketahui
-
Choosing between Carbon and Argon: Dokumentasi developer Google AI Studio
- Tautan:
aistudio.google.com/docs/whats-new-gemini-4-carbon -
Keterangan: Perbedaan posisi resmi kedua model dan saran memilih Thinking Level
-
Gemini 4 Carbon Developer Guide: Panduan developer Google Cloud
- Tautan:
docs.cloud.google.cn/gemini-enterprise-agent-platform/models/guides/gemini-4-carbon -
Keterangan: Tingkat penalaran, batasan parameter API, dan penjelasan decoding panjang
-
Harga Gemini API: Google AI for Developers
- Tautan:
ai.google.dev/gemini-api/docs/pricing -
Keterangan: Harga peluncuran, penyesuaian harga Desember, serta aturan penagihan cache dan token berpikir
-
Gemini 4 Carbon vs Gemini 4 Argon: Halaman perbandingan Artificial Analysis
- Tautan:
artificialanalysis.ai/zh/models/comparisons/gemini-4-carbon-vs-gemini-4-argon -
Keterangan: Perbandingan kemampuan, biaya, dan latensi pada konfigurasi AA Index v5.0.1 High
-
Evaluasi Kerja Pengetahuan Multimodal MKA: Artificial Analysis
- Tautan:
artificialanalysis.ai/zh/evaluations/mka - Keterangan: Model terdepan per industri dan data biaya per tugas
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami lewat beranda situs APIYI. Materi integrasi model lainnya tersedia di pusat dokumentasi docs.apiyi.com