著者注:Terraのトークン単価はLunaの10倍ですが、正答率の差は4.7〜18.7ポイントです。この記事では、Plotly、DualEntry、OSWorldなどの実際のテストデータをもとに、バッチ自動化における「正しい結果を1件得るためのコスト」を計算します。
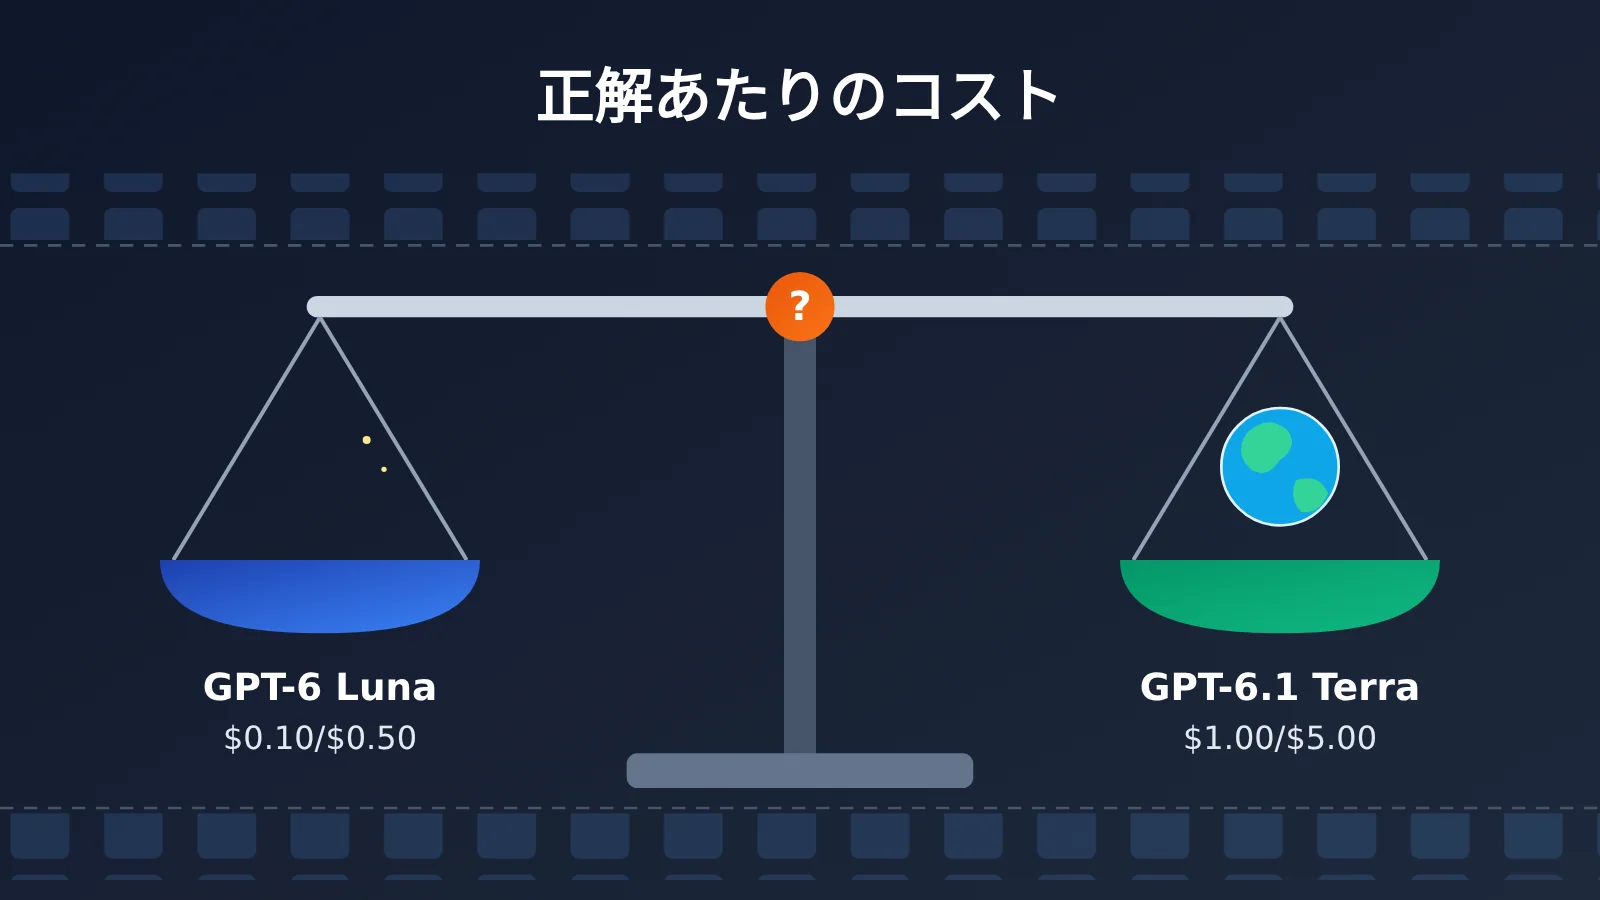
OpenAIは2026年10月26日、GPT-6.1 Terraをリリースしました。GPT-6 Lunaのリリースからわずか1か月余りです。両モデルのAPI価格には実に10倍の差があります。一方、第三者による同一条件のテストでは、Terraの正答率がLunaを上回る幅は、5ポイント未満から約19ポイントまでさまざまでした。バッチ自動化において、この価格差に見合う価値があるのか。開発者の間で大きな話題になっています。
この記事は、印象だけで書いたモデルレビューではありません。Plotly、DualEntry、Artificial AnalysisはTerraのリリース当日にテスト結果を公開し、OpenAIもOSWorld 2.1、MMMU-Pro、事実誤認率のデータを公表しています。これらのデータを照らし合わせ、追加で支払う費用によって、実際に役立つ正しい結果がどれだけ増えるのかを検証します。
この記事でわかること:GPT-6.1 TerraとGPT-6 Lunaの差が大きいバッチタスクと、ほとんど差がないタスクを確認できます。あわせて、「Lunaで一次選別+ルールによる検証+Terraで補完」というハイブリッド構成のコードも紹介します。
GPT-6.1 Terra と GPT-6 Luna の基本情報
両モデルは同じ GPT-6 ファミリーに属しますが、位置づけは大きく異なります。OpenAI は Luna を、明確な処理を高頻度かつ大量に行うタスク向けの高効率モデルと説明しています。一方、Terra は視覚推論、正確なコンピューター操作、自然な文章作成を得意とし、Luna と Sol の中間を埋めるモデルです。
| 項目 | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| リリース日 | 2026 年 9 月 22 日 | 2026 年 10 月 26 日 |
| API ID | gpt-6-luna |
gpt-6.1-terra |
| 公式の位置づけ | 高頻度・大量処理・ルールが明確なタスク | 視覚推論、コンピューター操作、複数ステップのタスク |
| コンテキスト / 最大出力 | 1,050,000 / 128,000 トークン | 1,050,000 / 128,000 トークン |
| 推論強度 | none から max までの 6 段階、デフォルトは medium | none から max までの 6 段階、デフォルトは medium |
| 主な用途 | タグ分類、メールの振り分け、フィールド抽出 | 請求書の入力、商品画像の照合、画面操作 |
仕様を見ると、両者はほとんど同じです。どちらもテキストと画像の入力、Structured Outputs、Function Calling、Responses API、Batch API のほか、Web Search、File Search、Computer Use などのツールに対応しています。主な違いは、価格と複雑なタスクにおける能力の 2 点です。
なお、OpenAI のモデル選択ガイドは「大量処理には Luna」「精度重視なら Terra」とは述べていません。公式の推奨は、同じ実際の入力データでテストし、品質要件を満たす最も低コストな構成を選ぶことです。これが、この記事のすべてのデータを読み解くうえでの前提になります。
GPT-6.1 Terra と GPT-6 Luna の API 価格差
OpenAI 公式の Standard API における短いコンテキスト向けの価格です。単位は米ドル / 100 万トークンです。
| 料金項目 | GPT-6 Luna | GPT-6.1 Terra | Terra / Luna |
|---|---|---|---|
| 入力トークン | $0.10 | $1.00 | 10 倍 |
| キャッシュ済み入力 | $0.01 | $0.05 | 5 倍 |
| 出力トークン | $0.50 | $5.00 | 10 倍 |
| 30 分間のキャッシュ書き込み | $0.125 | $1.25 | 10 倍 |
| Batch 入力 / 出力 | 約 $0.05 / $0.25 | 約 $0.50 / $2.50 | 10 倍 |
Batch と Flex モードの料金は Standard の約半分、Fast モードは約 2 倍です。見落としやすい費用も 2 つあります。1 つ目は、1 回のリクエストの入力が 272,000 トークンを超えると、リクエスト全体の入力とキャッシュが 2 倍、出力が 1.5 倍の料金になることです。2 つ目は、Web 検索やコンピューター操作などのツールに追加料金がかかる場合があり、推論トークン、再試行、複数ターンのエージェント呼び出しによっても実際の消費量が変わることです。
つまり「10 倍高い」とは、同じ課金条件でのトークン単価を指し、すべての作業が 10 倍高くなるという意味ではありません。理論上の試算をしてみましょう。1 件あたり入力 1,000 トークン、出力 200 トークンで、キャッシュも再試行も使わないと仮定すると、10 万件の処理費用は Standard モードで Luna が約 $20、Terra が約 $200 です。Batch ならそれぞれ約 $10 と $100 になります。これは公開単価から計算した理論値であり、実際の請求額ではありません。
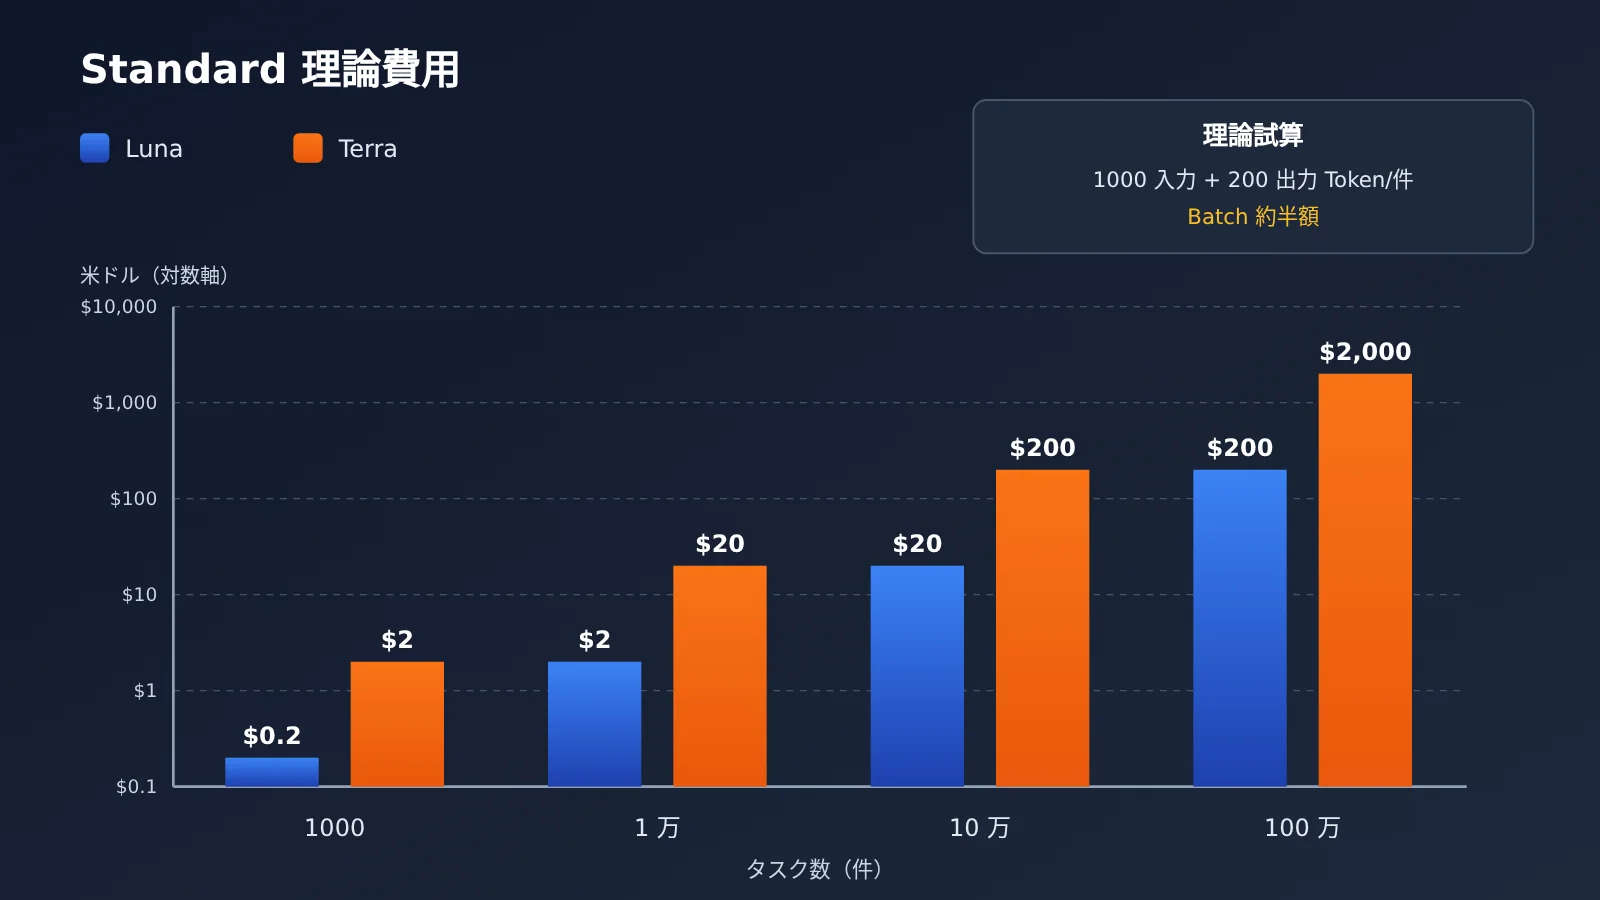
GPT-6.1 TerraとGPT-6 Lunaの比較:4つの実測データ
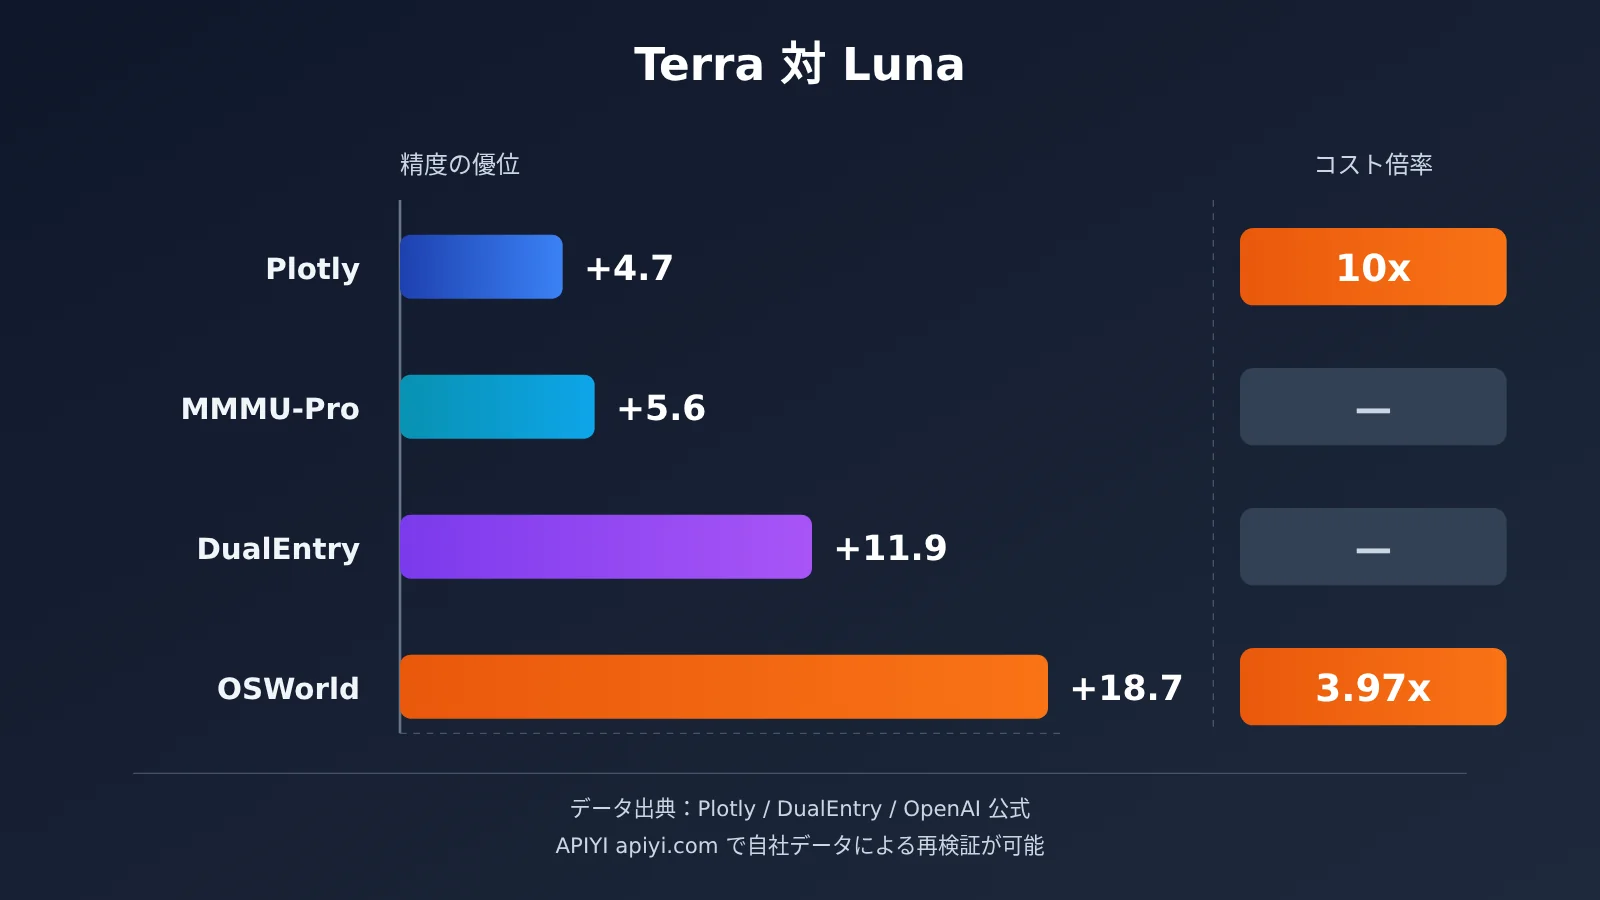
単価だけでは「いくらかかるか」しかわかりません。次に見たいのは「その費用で何が得られるか」です。以下の4つのデータはそれぞれ異なる機関によるもので、テストするタスクの種類も異なります。タスクの難易度によって正答率の差がどう広がるのかを見ていきましょう。
Plotlyのデータ分析43問:費用は10倍、正解は2問増
PlotlyとMilaの研究者が開発したDataAnalyticsBenchは、風力発電事業者のデータウェアハウスを模したベンチマークです。約2,000万行の合成データを使用しています。2つのモデルが同じツールを使って43問に回答した結果は、次のとおりです。
| 指標 | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| 正解数 | 38/43(88.4%) | 40/43(93.0%) |
| テスト全体の費用 | $0.13 | $1.31 |
| 1問あたりの所要時間の中央値 | 18秒 | 15秒 |
| 通常の分析 / 曖昧な質問 / 対応不可能なリクエスト / データ品質 | すべて満点 | すべて満点 |
| 統計上の落とし穴 | 3/5 | 4/5 |
| 隠れたパターンの発見 | 2/5 | 3/5 |
特に注目したいのは、項目別の成績です。通常の分析、曖昧な要件の識別、対応できないリクエストの拒否、基本的なデータ品質の問題の発見では、両者の成績は完全に一致しました。差が出たのは、より深い分析が必要な「統計上の落とし穴」と「隠れたパターンの発見」の2項目だけで、Terraはそれぞれ1問多く正解しています。
全体の結果から概算すると、Terraは$1.18多くかけて正解を2問増やしたことになり、正解を1問増やすための追加費用は約$0.59です。これはテスト全体の費用から算出した限界費用であり、本番環境で誤答を修正する際の安定した費用ではありません。その1問が経営判断に関わるなら、$0.59は安いと言えます。一方、社内レポートで重要度の低いパターンを1つ多く見つけるだけなら、10倍のコストをかける必要はないでしょう。
もう1つ注目したいのは、Terraのほうが1問あたりの回答時間が短かった点です。ただし、これは生成速度が速いためではなく、回答が短く、モデル呼び出しの回数も少なかったためです(平均で約4.5回のモデル呼び出し、出力は約1,460トークン)。Terraの出力速度は約64トークン/秒でした。なお、サンプルは43問のみで、TerraはOpenRouterのデフォルトの推論設定で実行されています。この結果から、あらゆる企業のデータ分析で93%の正答率を出せるとは言えません。
DualEntryの会計タスク101件:差は11.9ポイントに拡大
DualEntryのAccounting AI Benchmarkは、実際の業務により近いベンチマークです。101件のタスクは、取引分類、仕訳、買掛金、売掛金、銀行口座の照合、財務報告、月次決算、会計知識の8分野をカバーしています。各モデルは3回テストを実施し、少なくとも2回成功した場合に合格と判定されます。
結果はLunaが66.3%、Terraが78.2%、比較対象のGPT-6.1 Solが81.2%でした。Terraの分野別成績は、取引分類が13/13、仕訳が12/13、銀行口座の照合が10/12だった一方、買掛金は7/13、売掛金と月次決算はいずれも7/12でした。DualEntryによると、買掛金の分野ではTerraとLunaが同率最下位でした。
大量の処理を自動化するうえでは、1回の正答率よりも安定性が重要です。3回すべて正解したタスクの割合は、Terraが65.3%、Solが68.3%で、Lunaはさらに低い結果でした(原文に具体的な数値の記載はありません)。同じ種類の会計タスクでも、今日は正解して明日は間違えるようでは、人手で原因を調べるコストが急速に増えてしまいます。Terraはこのテストで、1タスクあたり平均16.1秒を要し、トークンコストは約$0.042、3回分の合計は約$12.73でした。Lunaのコストは原文で明確に開示されていないため、ここでは推算しません。
OSWorld 2.1と事実誤り率:複雑なタスクほど差が大きい
OpenAIがTerraの発表で示したデスクトップ操作ベンチマーク「OSWorld 2.1」は、モデルが画面を理解し、正しいボタンをクリックして、複数のステップからなる操作を完了できるかを評価します。最高推論設定では、Lunaが55.5%、Terraが74.2%で、差は18.7ポイントです。タスクあたりの推定コストはそれぞれ0.30ドルと1.19ドルで、10倍ではなく約3.97倍にとどまります。同じタスクを完了するまでに消費するトークン数が、モデルによって異なるためです。
事実誤り率のテストでは、さらに大きな差が見られました。公式が用意した難しい事実問題で、LunaのLow / Medium / Maxの3段階における誤り率は、それぞれ44.3%、31.2%、18.4%。Terraは16.7%、10.1%、4.3%でした。TerraはLow設定でも、LunaをMaxに設定した場合より誤り率が低くなっています。 画像理解のMMMU-Proでは、最高推論設定でLunaが79.9%、Terraが85.5%でした。
これらはすべてOpenAI公式のグラフに基づくデータであり、第三者による独立した再検証ではありません。難しい事実問題は意図的に誤りを誘発するよう設計されたもので、Lunaが日常的な文章作成で44.3%の誤り率を示すという意味ではありません。OSWorldのスコアも、そのテスト条件に限って当てはまるものです。
Artificial Analysis総合指数:推論強度の最適化も重要
Artificial Analysisによる独立評価は、別の視点を与えてくれます。Max設定での総合知能指数は、Lunaが約38、Terraが約48。それぞれの総合ベンチマークコストは約0.07ドルと0.40ドルで、約5.7倍の差があります。コーディングエージェント指数では差がさらに大きく、Lunaが31、Terraが48です。
一方、長文文書の理解を測るAA-LCRは反例です。最高推論設定では、どちらも約83%でした。また、TerraはLowとMediumの設定では、同機関のテスト範囲内で「コストと能力」のパレートフロンティア上に位置していますが、Max設定では必ずしも最適とは限りません。つまり、大量のタスクを自動化する際は、モデルだけでなく推論強度も調整する必要があります。
GPT-6.1 Terra と GPT-6 Luna で始めるバッチ自動化
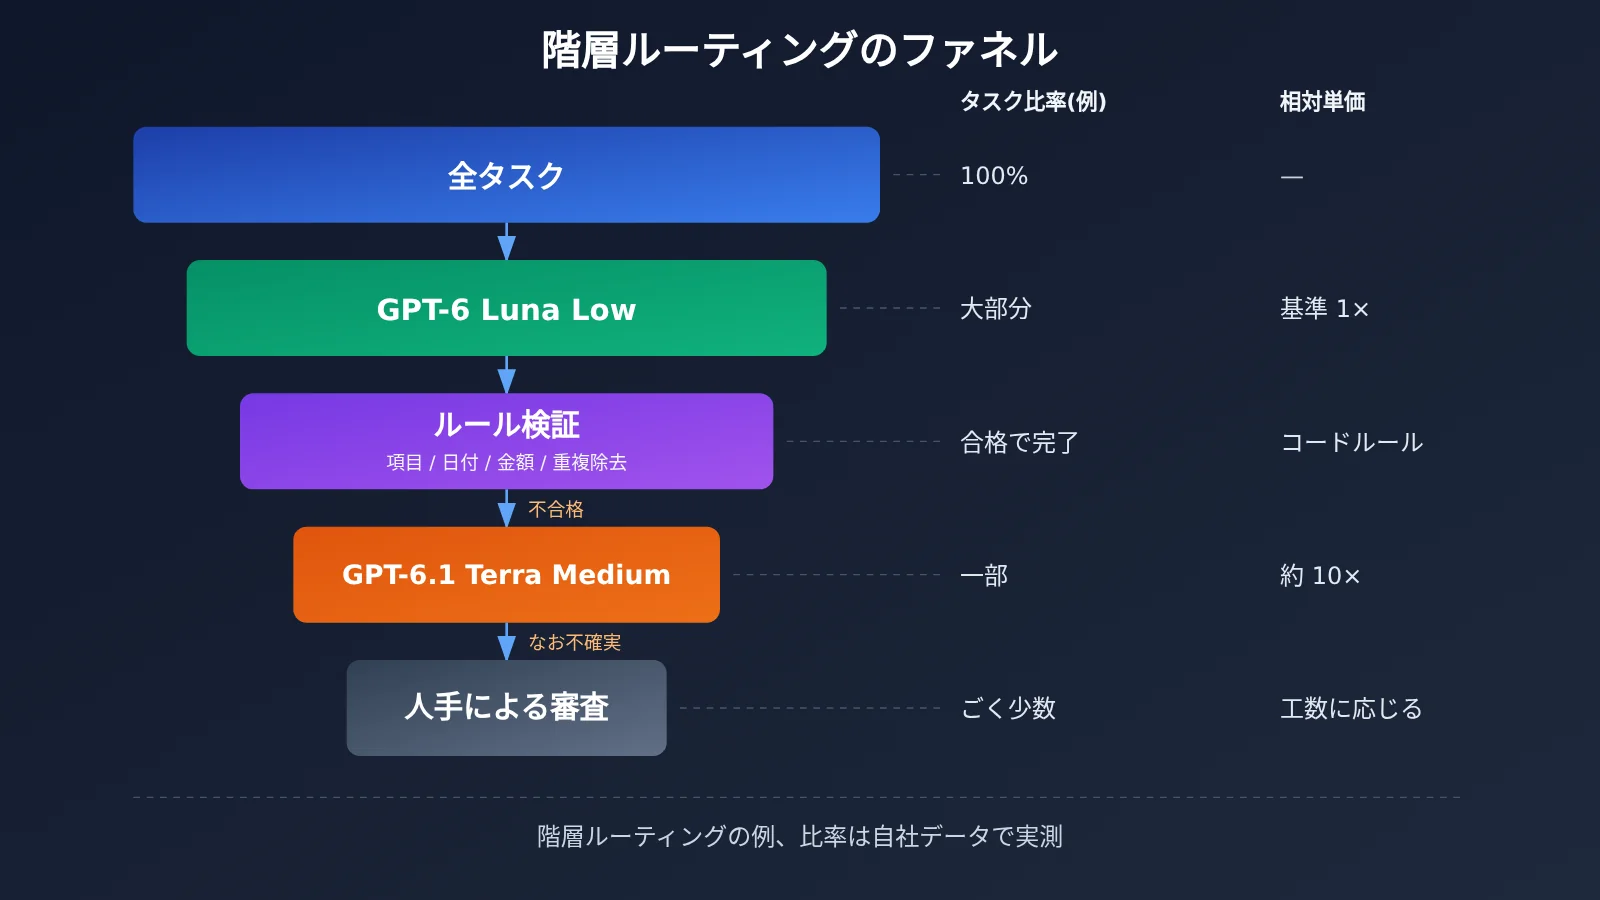
ここまでのデータをまとめると、実用的な結論が見えてきます。ルールが明確なタスクの大半は Luna に任せ、複雑なタスクやリスクの高いタスク、検証を通過しなかったタスクだけを Terra に引き上げる方法です。以下は、まず Luna で請求書の項目を抽出し、プログラムのルールで検証して、不合格の場合にのみ Terra に渡す、最小限の実行例です。
import json, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def extract(model, text, effort="low"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": f"抽取 JSON:amount, tax, total, date\n{text}"}])
    return json.loads(r.choices[0].message.content)

def valid(d):
    return all(k in d for k in ("amount", "tax", "total", "date")) and \
        abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) < 0.01

result = extract("gpt-6-luna", "发票:金额 100.00,税额 6.00,合计 106.00,日期 2026-10-20")
if not valid(result):
    result = extract("gpt-6.1-terra", "...", effort="medium")
print(result)
階層型ルーティングの実装コード全体を見る
import json
import re
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

PROMPT = "从以下文本抽取 JSON,字段:amount, tax, total, date(YYYY-MM-DD)。缺失填 null。\n"

def call_model(model: str, text: str, effort: str = "low") -> Optional[dict]:
    try:
        resp = client.chat.completions.create(
            model=model,
            reasoning_effort=effort,
            response_format={"type": "json_object"},
            messages=[{"role": "user", "content": PROMPT + text}],
        )
        return json.loads(resp.choices[0].message.content)
    except Exception as e:
        print(f"[{model}] 调用失败: {e}")
        return None

def rule_check(d: Optional[dict]) -> list:
    """程序化规则校验:结构化输出只保证格式,不保证事实,所以必须二次校验"""
    if not d:
        return ["empty"]
    errors = []
    for k in ("amount", "tax", "total", "date"):
        if d.get(k) is None:
            errors.append(f"missing:{k}")
    if not errors:
        if abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) > 0.01:
            errors.append("sum_mismatch")
        if not re.match(r"^\d{4}-\d{2}-\d{2}$", str(d["date"])):
            errors.append("bad_date")
    return errors

def route(text: str) -> dict:
    # 第1層:すべての入力を Luna Low で処理
    d = call_model("gpt-6-luna", text, "low")
    if not rule_check(d):
        return {"data": d, "tier": "luna"}
    # 第2層:検証を通過しなかったものを Terra Medium に引き上げ
    d = call_model("gpt-6.1-terra", text, "medium")
    errs = rule_check(d)
    if not errs:
        return {"data": d, "tier": "terra"}
    # 第3層:まだ不確かなものを人によるレビューのキューに送る
    return {"data": d, "tier": "human_review", "errors": errs}

if __name__ == "__main__":
    samples = [
        "发票号 A001,金额 100.00 元,税额 6.00 元,价税合计 106.00 元,开票日期 2026-10-20",
        "收据:总计一百零六元整,含税,十月二十日",
    ]
    for s in samples:
        print(route(s))
🚀 クイックスタート:公式では、まず1つのAPIキーで両モデルの呼び出しを確認してから、手元のサンプルで試すことを推奨しています。APIYI の apiyi.com は OpenAI 互換インターフェースを提供しており、
gpt-6-lunaとgpt-6.1-terraはmodelパラメータを切り替えるだけで利用できます。新規ユーザーには無料のテスト枠があり、まずは小規模な比較実験を行うのに適しています。
この構成の鍵となるのは、2つ目のステップです。「Luna が自信があると言っている」ことを正しさの根拠にしてはいけません。モデルが自己申告する信頼度は、必ずしも信頼できるとは限らないからです。フィールドの欠落がないか、日付が有効か、金額が合っているか、重要なフィールドが原文と一致しているか、重複レコードがないかといった、検証可能なルールを優先しましょう。
GPT-6.1 Terra と GPT-6 Luna の影響分析
開発者への影響:タスクの種類に応じた使い分け
公式の位置づけと上記のテスト結果を踏まえ、よくあるバッチ処理について、最初のモデル選びの目安を示します。これらは公開ベンチマークに基づく提案であり、すべての場面で実証されているわけではありません。本番運用前に、自分のデータで検証する必要があります。
| 業務シーン | 最初の選択肢 | 理由 | 利用可能なプラットフォーム |
|---|---|---|---|
| 10万本の記事へのタグ付け | GPT-6 Luna | ルールが明確で、サンプリング検証も可能。Plotly の通常分析では両モデルとも満点 | APIYI apiyi.com、OpenAI 公式 |
| 請求書・注文画面のスクリーンショットからの入力 | GPT-6.1 Terra | 画像の理解と操作の能力で優位。ただし金額はプログラムによる検証が必要 | APIYI apiyi.com、OpenAI 公式 |
| 毎日の AI ニュースまとめ | Luna で一次選別 + Terra で精読 | 重複排除とタグ付けは Luna、重要度の判断は Terra に任せる | APIYI、OpenAI 公式 |
| カスタマーサポートのメール振り分けと下書き | Luna を中心に使用 | 苦情や返金などのリスクが高い問い合わせは、上位の担当者または人間の担当者に引き継ぐ | APIYI、OpenAI 公式 |
| Web ページやコードの一括修正 | Terra または Sol | コーディングエージェント指数は Terra が48、Luna が31 | APIYI、OpenAI 公式 |
開発者が見落としがちなもう一つのポイントは、スループットです。公式が示す Build ティアでは、Luna の1分あたりのトークン上限は200万、Batch キューの上限は2,000万です。一方、Terra はそれぞれ100万と300万です。Launch ティアでは、Luna が1,000万と10億、Terra が400万と2億です。10万件以上のバッチ処理では、Luna のほうがキューに登録できる量が明らかに多くなります。ただし、これは利用枠の上限であって生成速度ではなく、アカウントごとに制限が異なる場合もあります。
業界への影響:「単価の比較」から「合格結果あたりのコストの比較」へ
Terra の発表当日、Reddit コミュニティでは意見が分かれました。Terra は中途半端な位置づけで、Luna はすでに十分安く、Sol のほうが高性能だという声がある一方、Terra Low の事実誤認率はすでに Luna Max を下回っており、単価だけで判断すべきではないという指摘もありました。また、Codex ユーザーからは、推論強度を高く設定した Terra の利用枠消費量は、中程度の Sol より必ずしも少なくないという報告もありました。Luna についても、複雑な開発タスクでは手戻りによって利用枠の節約効果が相殺されたという声がありました。いずれも個別の事例です。しかも、Codex のサブスクリプション利用枠と API のトークン課金は別物であり、これらの報告から API 費用を推計することはできません。
ただ、これらの声は共通の傾向を示しています。大量のタスクを自動化する際の評価基準が、「1回の呼び出しにいくらかかるか」から「合格結果を1件得るのにいくらかかるか」へと変わりつつあるのです。次のシンプルな式で考えるとわかりやすいでしょう。
総コスト = API 呼び出しコスト + ツールコスト + 再試行コスト + 人手による確認コスト + エラーによる損失
Luna は最初の2項目で圧倒的な優位性があり、Terra はエラー率の低さによって残りの3項目を抑えます。どちらがお得かは、事業において1件のエラーがどれほどの損失につながるかによって変わります。MultiAI による少数サンプルでの観察結果も、この点を裏付けています。Terra は推論をオフにすると一部の論理・計算タスクで誤りが生じましたが、Medium に切り替えると明らかに改善しました。一方、Luna は単純なタスクでは良好な結果を出したものの、複数のステップを要する論理タスクでは誤りが増えました。
自分で比較実験を行う方法
公開データでは、まだいくつかの重要な疑問が解決していません。たとえば、実際の中国語記事10万件を分類した場合の両モデルのエラー率、長期運用時の安定性、混合運用で実際にどれだけコストを削減できるか、人的レビューのコスト削減で Terra の割高分を相殺できるかといった点です。これらは自分で検証するしかありません。
現実的な方法としては、正解を用意した実際の業務サンプルを200〜500件準備します。たとえば、単純な分類、重要情報の抽出、複雑な内容の識別を各100件、ファクトチェックと複数ステップにわたるツール操作を各50件用意します。そのうえで、同じ入力、同じプロンプト、同じツール、同じ判定基準を使い、Luna Low、Luna Medium、Terra Low、Terra Medium の4つの設定をそれぞれ試します。一部のタスクは複数回実行し、安定性も確認しましょう。
最後に、正確率、1000件あたりの API コスト、平均処理時間と P95 処理時間、人的レビューとやり直しの回数、合格した結果1000件あたりの総合コストという5つの指標に注目します。サードパーティのプラットフォームを通じてデプロイする場合は、そのプラットフォームの実際の課金ルールを基準とし、データ処理に関する規約やコンプライアンス要件も確認してください。
よくある質問 FAQ
Q1:GPT-6.1 Terra と GPT-6 Luna の主な違いは何ですか?
両者の仕様はほぼ同じで、コンテキストウィンドウはいずれも 1,050,000 Token、対応するツールも共通しています。違いは、Luna の単価が Terra の 10 分の 1 で、ルールが明確な高頻度タスクに適していることです。一方、Terra は視覚理解、コンピューター操作、複雑な分析、事実の正確性で明らかに優れており、複数の手順が必要で、ミスの影響が大きいタスクに向いています。
Q2:Terra は 10 倍高いのに、精度は少ししか上がらないのですか?
タスクの種類によります。Plotly のデータ分析テストでは約 4.7 ポイントの差でしたが、DualEntry の会計タスクでは 11.9 ポイント、OSWorld のデスクトップ操作では 18.7 ポイントの差がありました。また、OSWorld のタスクあたりのコスト差は約 3.97 倍にとどまり、常に 10 倍になるわけではありません。
Q3:Luna の推論強度を max にすれば、Terra の代わりになりますか?
一部の性能は改善しますが、モデル自体の能力差は埋まりません。公式の難易度の高い事実問題では、Luna Max の誤答率は 18.4% で、Terra Low の 16.7% を上回っています。また、推論強度を上げると Token の消費量が増えるため、Luna のコスト面での優位性が失われる可能性もあります。
Q4:API を使って 2 つのモデルを手早く比較するにはどうすればよいですか?
同じコードでモデル名を切り替えて比較することをおすすめします。
1. APIYI apiyi.com にアクセスして登録し、APIキーと無料テスト枠を取得する
2. base_url を `https://api.apiyi.com/v1` に設定する
3. `gpt-6-luna` と `gpt-6.1-terra` でそれぞれ同じサンプルを処理し、精度と Token 消費量を記録する
Q5:大量のタスクのコストをさらに抑えるにはどうすればよいですか?
リアルタイムでの応答が不要なタスクには、Batch API を優先的に使いましょう。料金は Standard の約半額で、公式の処理時間枠は 24 時間です。また、1 回の入力を 272,000 Token 以内に抑えることで、長いコンテキストに対する追加料金を避けられます。APIYI apiyi.com は従量課金のため、まず少量で各タスクの実際の Token 消費量を把握してから、処理量を増やすこともできます。
Q6:これらのテスト結果にはどのような制約がありますか?
Plotly は 43 問のみで、合成データを使用しています。OSWorld、MMMU-Pro、事実に関する誤答率は OpenAI の公式データであり、独立した再検証の結果ではありません。MultiAI の 24/24 と 18/18 は同じ問題セットを使用していないため、直接比較できません。また、Structured Outputs が保証するのは形式の正しさだけで、各フィールドの内容が事実であることは保証しません。どのベンチマークスコアも、実際の業務における精度と同じとは限りません。
GPT-6.1 Terra と GPT-6 Luna の重要ポイント Key Takeaways
- 単価は10倍差:Luna は入力 $0.10、出力 $0.50、Terra はそれぞれ $1.00、$5.00
- 簡単なタスクでは差が小さい:Plotly の通常分析や曖昧な質問の識別など、両モデルとも満点の項目がある
- 複雑なタスクでは差が大きい:会計タスクでは Terra が11.9ポイント、デスクトップ操作では18.7ポイント上回る
- 事実の正確さにも差がある:Terra Low のエラー率は16.7%で、Luna Max の18.4%を下回る
- 推論強度の調整も重要:Terra Low / Medium は、Max よりもコスト効率に優れる
- 段階的なルーティングが最もお得:Luna による一次選別、ルールによる検証、Terra による補完、人間によるレビューを組み合わせる
- 本番投入前にテスト:自社サンプル200〜500件を使い、APIYI apiyi.com で4つの設定を比較する
まとめ
GPT-6.1 Terra と GPT-6 Luna のどちらが大量の自動化処理に適しているかは、タスクの難易度とミスの代償によって変わります。
- ルールが明確で、自動検証できるタスク:Luna は低コストで始められる選択肢です。Plotly のテストでは、通常の分析において両モデルは同じ成績でした。
- 画像認識、複数ステップの操作、財務などのリスクが高いタスク:Terra の追加コストに見合う価値があります。正答率では最大18.7ポイントの差がついています。
- 本当に最適化すべきもの:API の1回あたりの価格ではなく、再試行、レビュー、ミスによる損失を含む、合格結果1件あたりの総コストです。
多くのチームにとっては、どちらか一方を選ぶよりも、簡単な作業の大半を Luna に任せ、本当に難しい部分を Terra で処理するほうが効果的です。まずは自社の業務サンプルで小規模な比較を行い、その結果を見て振り分けの割合を決めることをおすすめします。
APIYI apiyi.com を使えば、両モデルが自社の業務でどの程度の性能を発揮するか、手軽に検証できます。1つの APIキーでモデルを切り替えられ、従量課金なので、タスク1,000件あたりのコストも正確に算出しやすくなります。
📚 参考資料
- OpenAI:Introducing GPT-6.1 Terra:リリース発表。OSWorld、MMMU-Pro、事実誤認率のグラフを掲載
- リンク:
openai.com/index/introducing-gpt-6-1-terra -
概要: Terra の公式な位置付けとベンチマークデータの出典
-
OpenAI API Pricing とモデルページ:Luna、Terra の料金、機能、レート制限
- リンク:
developers.openai.com/api/docs/pricing -
概要: Standard、Batch、Flex、Fast の料金の出典
-
OpenAI Batch API ドキュメント:バッチ処理のコストと処理時間
- リンク:
developers.openai.com/api/docs/guides/batch -
概要: 大量の非同期タスクでコストを削減する方法
-
Plotly:GPT-6.1 Terra Benchmark Results for Data Analysis:43 問のデータ分析テストによる比較
- リンク:
plotly.com/blog/gpt-6-1-terra-plotly-data-analytics-bench -
概要: 正答率、費用、所要時間、項目別の成績
-
DualEntry:GPT-6.1 Terra Accounting Benchmark:101 件の会計タスクを使ったテスト
- リンク:
dualentry.com/blog/gpt-6-1-terra-accounting-benchmark -
概要: 正答率、タスクの分類、3 回のテストにおける安定性
-
Artificial Analysis:GPT-6.1 Terra 評価:総合的な知能指数とコスト効率
- リンク:
artificialanalysis.ai/models/releases/gpt-6-1-terra - 概要: 推論強度ごとの独立したテスト結果
著者: APIYI 技術チーム
技術に関するお問い合わせ: APIYI 公式サイトのトップページからお気軽にお問い合わせください。モデルの利用に関する資料は docs.apiyi.com のドキュメントセンターでもご覧いただけます。