著者注:Agent のコンテキスト自動圧縮について、3つのトリガー、要約に残す情報の選び方、実行可能なコードを解説します。長い対話でも重要なタスク情報を失わずに、Token の消費を抑えるための内容です。
Codex のようなコーディング Agent で何時間も作業を続けていると、こんな疑問が浮かぶかもしれません。入力欄の近くには権限モードと現在のモデルしか表示されず、コンテキストの使用量が見えない。それなら、いつ新しいウィンドウを開けばよいのでしょうか?対話が長くなるほど、各リクエストに含める履歴も増え、利用枠の消費も速くなります。この記事では、Agent のコンテキスト自動圧縮(Context Compaction)のトリガーと要約戦略を解説します。Codex のようなツールの仕組みを理解し、自分の Agent にも同じ機能を実装するための手引きです。
「チャット履歴をこまめに整理しましょう」という一般的なアドバイスではありません。 OpenAI と Anthropic の公式ドキュメントで公開されている圧縮の仕組みをもとに、実際の開発経験も踏まえた実践的な方法を紹介します。
この記事で得られること:Agent のコンテキスト自動圧縮がいつ実行されるのか、要約に何を残して何を削るべきかが分かります。また、そのまま改造して使える Python の実装も紹介します。
Agentのコンテキスト自動圧縮:重要ポイント
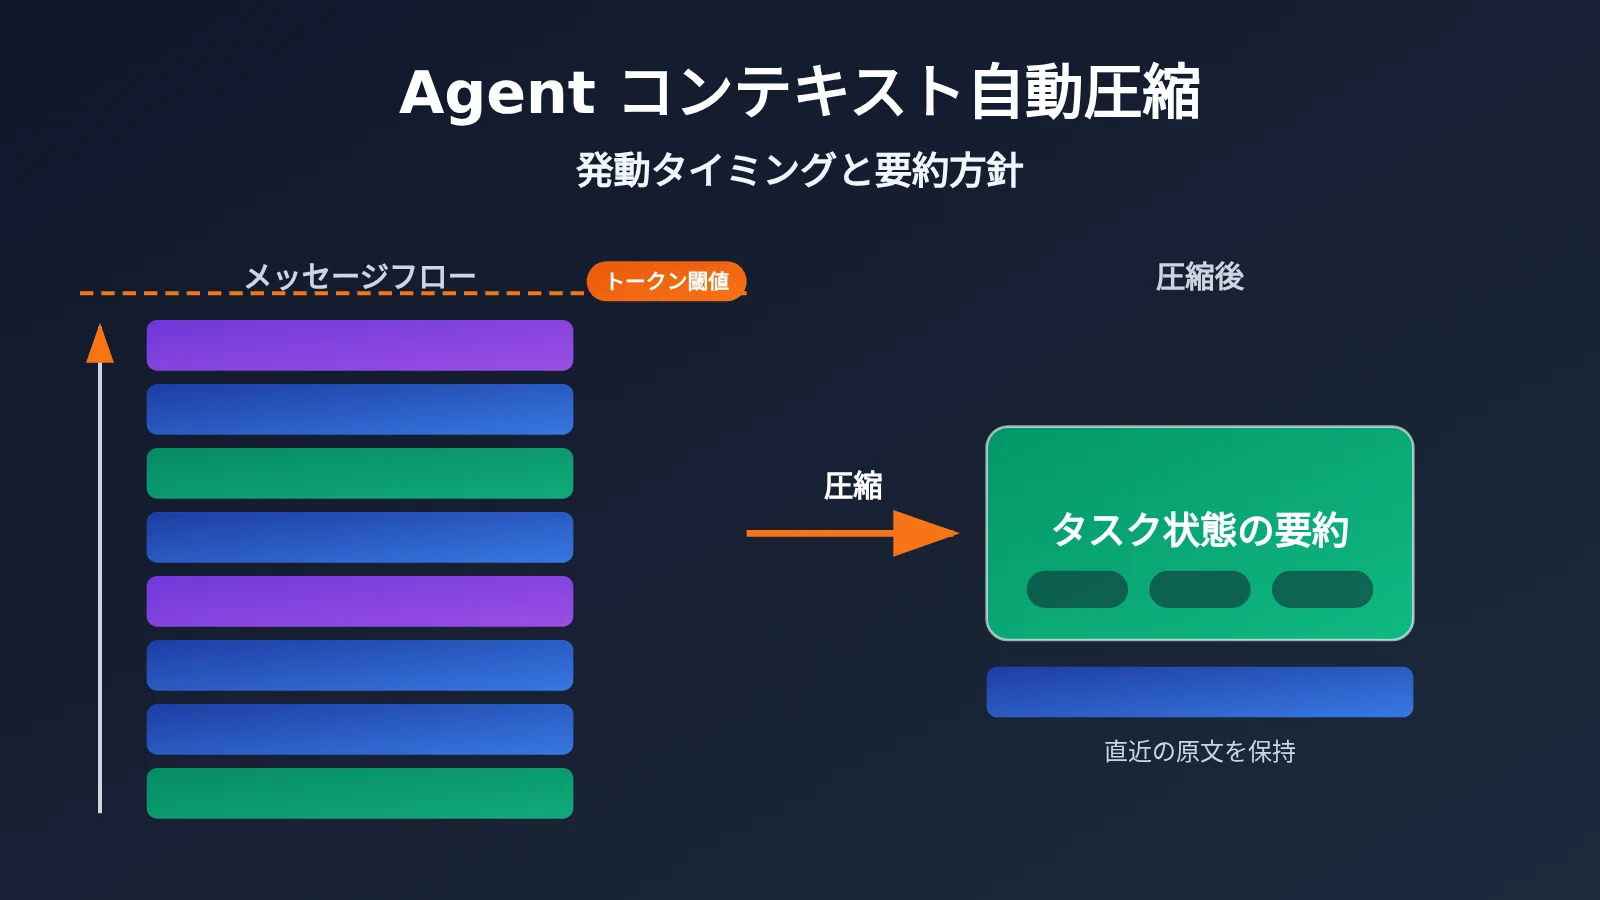
結論から言うと、Agentのコンテキスト自動圧縮は通常、コンテキストが指定されたToken数の閾値に達すると実行され、それまでの会話やツール呼び出しの記録を「作業を続けられる」状態の説明にまとめます。目的は単に会話履歴を短くすることではありません。タスクの進捗、重要な事実、実行済みの操作、主要な判断、次のアクションを残しながら、冗長な途中経過を取り除くことです。
| ポイント | 説明 | メリット |
|---|---|---|
| Token数の閾値で実行 | コンテキストが設定されたToken数に達すると自動的に圧縮 | 手動操作なしでコンテキストウィンドウの上限超過を防ぐ |
| 能動的な圧縮 | アプリケーションが特定のタイミング(タスクの一段階が完了したときなど)で圧縮を呼び出す | 意味の区切りで圧縮でき、情報の損失を抑えられる |
| フレームワークによる自動管理 | SDKやAgent Runtimeがコンテキストの逼迫状況に応じて判断 | すぐに使え、素早く構築するのに適している |
| 切り詰めではなく要約 | 進捗、事実、判断、次のアクションを保持 | 圧縮後もAgentが作業を続けられる |
| 段階ごとの圧縮 | 毎ターンの圧縮は推奨されない | キャッシュヒット率と情報の完全性を両立できる |
なぜAgentにはコンテキストの自動圧縮が必要なのか
大規模言語モデルのAPI自体はステートレスです。いわゆる「複数ターンの会話」では、毎回messagesの履歴全体をモデルに送り直しています。そのため、50ターン目のリクエストには前の49ターン分の内容がすべて含まれ、入力Token数は線形、あるいはそれ以上のペースで増えていきます。Agentの場合はさらに深刻です。ツール呼び出しの結果(ファイルの内容、ターミナルの出力、検索結果など)は長くなりがちで、数回のツール呼び出しだけでコンテキストウィンドウの大半を使い切ることもあります。
これによって、直接的に2つの問題が生じます。1つはコストです。各ターンの入力Token数が多いほど、利用枠の消費も速くなります。もう1つは品質です。コンテキストが長すぎると、モデルが序盤の重要な情報に注意を向けにくくなり、ウィンドウの上限を超えてエラーになることもあります。Agentのコンテキスト自動圧縮は、この2つの問題のバランスを取るための仕組みです。情報が揃っていて、ウィンドウにも余裕があるうちに、履歴を簡潔な状態説明へと「折りたたみ」、後続のリクエストを軽くします。
Codexでコンテキスト使用量が表示されないことについて
クライアントがコンテキストウィンドウのサイズを表示しなくなった理由については、公式の明確な説明を確認できていないため、ここでは推測を控えます。確かなのは、Codexにはコンテキストの圧縮機能が備わっており、長い会話でも元の履歴がすべて無制限に蓄積されるわけではないということです。各ターンの消費量を正確に確認したい場合は、APIレベルの呼び出しログを見るのが最も確実です。具体的な方法は後述します。
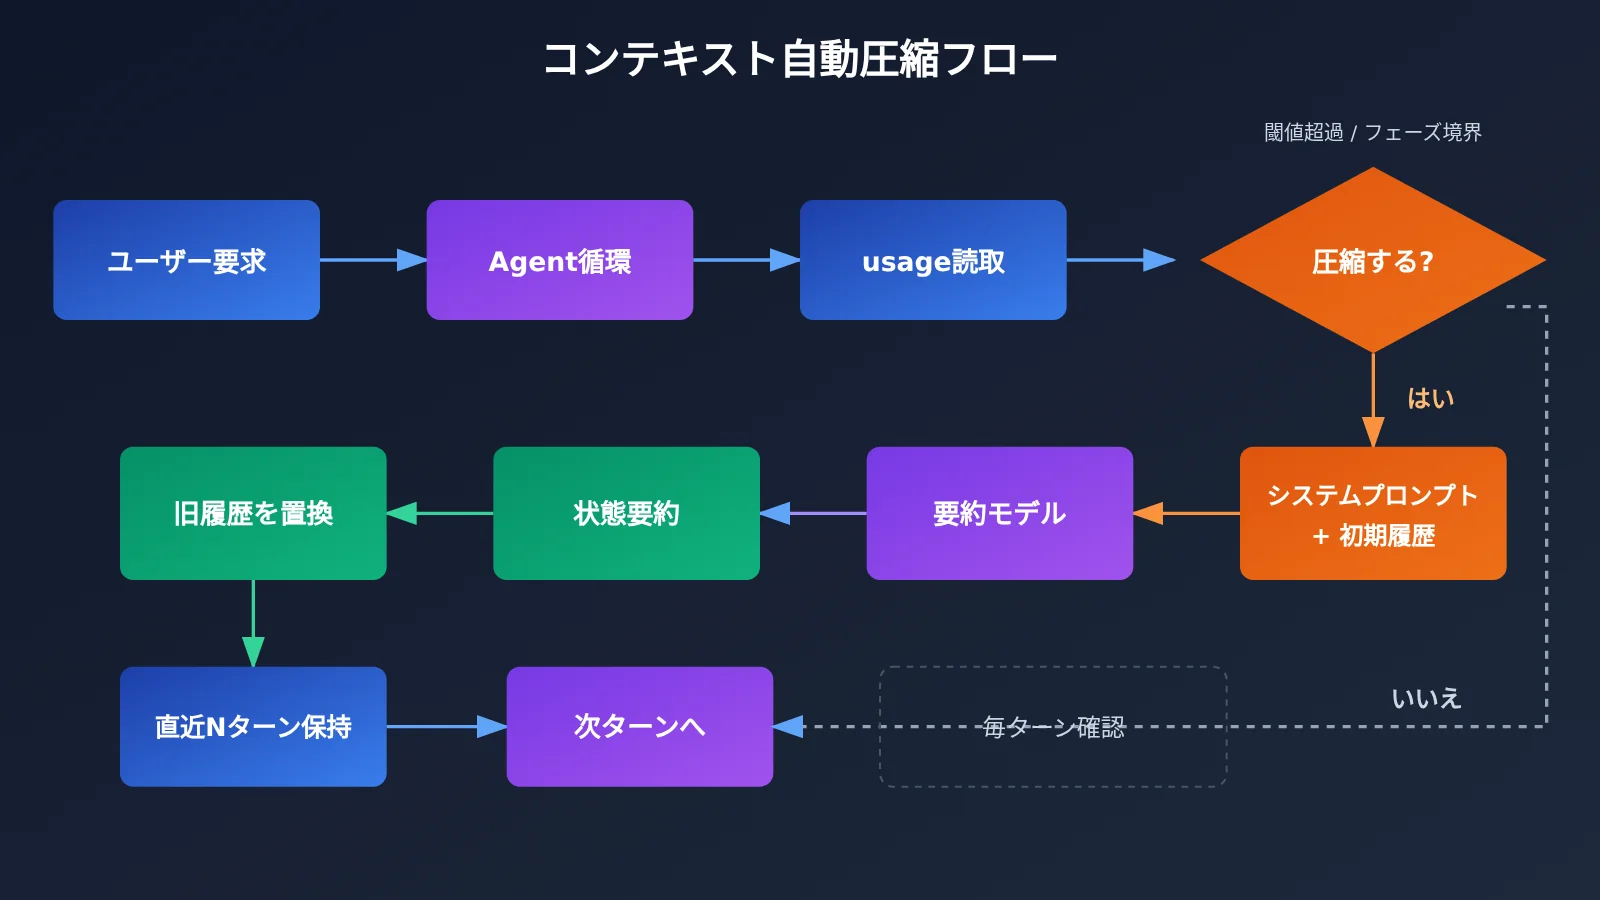
Agentのコンテキスト自動圧縮を実行する3つのタイミング
「コンテキストを80%使ったら圧縮する」と考えている人は多いですが、これは公式ルールではありません。公式APIドキュメントでは、固定のウィンドウ使用率ではなく、主にToken数のしきい値でトリガー条件を定義しています。また、圧縮は上限に近づくまで待つ必要はなく、OpenAIとAnthropicはいずれも能動的な圧縮に対応しています。
公式実装のトリガールールを比較
| 実装方式 | 自動トリガーのルール | 公式の説明 |
|---|---|---|
| OpenAI Responses API | レンダリング後のToken数がcompact_thresholdに到達 |
しきい値をカスタマイズ可能。サーバー側で自動処理 |
| OpenAI Agents SDK | コンテキストの逼迫状況または明示的なしきい値ポリシー | 自動、固定しきい値、強制圧縮に対応 |
| Anthropic Messages API | 入力Token数がtrigger.valueに到達 |
デフォルトは150,000、最小は50,000 |
| Anthropic Tool Runner | context_token_thresholdに到達 |
デフォルトは100,000 |
| Anthropicのオンデマンド圧縮 | アプリケーションが能動的に実行 | 完結した会話ターンの終了後に呼び出し可能 |
この表からわかる共通点は、ほとんどの自動トリガーが「入力Token数」を判断基準とし、しきい値を設定できることです。同時に、いずれも「アプリケーションが圧縮のタイミングを決める」方法を用意しています。
タイミング1:Tokenのしきい値によるトリガー
最も基本的な安全策です。各呼び出しの終了後にAPIが返す入力Token数を読み取り、設定したしきい値を超えたら圧縮を実行します。しきい値はウィンドウの上限ぎりぎりに設定しないようにしましょう。圧縮そのものに古い履歴を要約用モデルへ再送する必要があり、次のターンのツール出力用にも余裕を残さなければならないためです。
実践では、Anthropicのデフォルト値を参考に、コンテキストウィンドウの長いモデルでしきい値を10万Token程度に設定し、しきい値を超えた後もツール呼び出しの戻り値を丸ごと収められる余裕を確保するとよいでしょう。
タイミング2:タスクの段階が切り替わるときに能動的に圧縮
この方法なら、情報の損失を最小限に抑えられます。OpenAIは、毎ターン圧縮するのではなく、意味のある作業段階が完了してから圧縮することを推奨しています。例えば、Agentが「バグの特定 → コードの修正 → テストの成功」という一連の作業を終えた直後なら、途中の試行錯誤はもう不要です。「どのファイルを、なぜ変更したか」「テストに合格したか」だけを記憶しておけば十分です。
段階の切り替わりで圧縮すると、タスクが途中のツール呼び出しを残していない「きれいな」状態にあるため、正確な要約を作りやすくなります。
タイミング3:コンテキストの逼迫状況に応じた管理をフレームワークに任せる
Agents SDKやTool Runnerのようなフレームワークを使っている場合は、組み込みの圧縮ポリシーを有効にし、コンテキストの逼迫状況に応じた判断をランタイムに任せることができます。手間はかかりませんが、要約内容を細かく制御しにくいため、プロトタイプ段階や汎用的な用途に向いています。
🎯 技術的なアドバイス:3つのタイミングは併用できます。おすすめは「段階の切り替わりでの能動的な圧縮を基本とし、Tokenのしきい値によるトリガーを安全策にする」組み合わせです。モデルごとにしきい値の設定が適切か検証したい場合は、APIYI apiyi.comを通じて同じAPIキーでOpenAI、Claude、Geminiなどのモデルを切り替え、比較テストできます。
Agentのコンテキスト自動圧縮における要約戦略
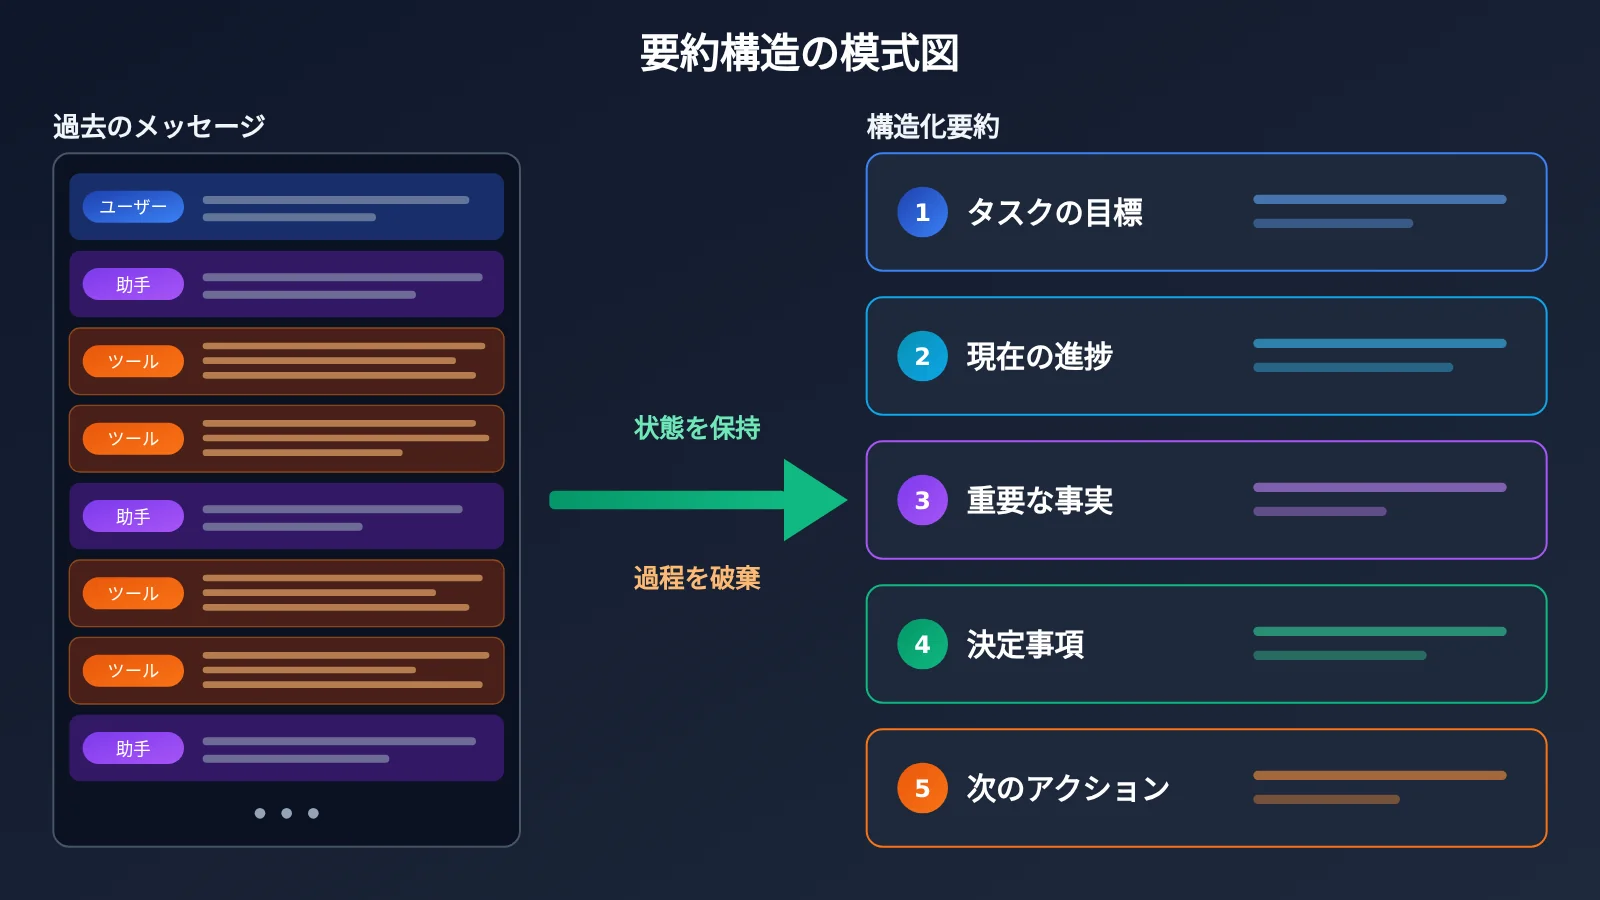
圧縮のトリガーは「いつ圧縮するか」を決め、要約戦略は「どのように圧縮するか」を決めます。圧縮の失敗としてよく見られるのは、Agentが圧縮後にユーザーの当初の制約を忘れたり、すでに実行した操作を繰り返したりすることです。根本的な原因は、要約に「何を話したか」だけが記録され、「タスクの状態」が記録されていないことにあります。
要約に残すべき内容と捨ててもよい内容
| カテゴリ | 残すべき内容 | 捨ててもよい内容 |
|---|---|---|
| タスクの目標 | ユーザーの当初の要望、厳守すべき制約、受け入れ基準 | あいさつ、重複する確認 |
| タスクの進捗 | 完了したステップ、現在の段階 | 各ステップの詳細な推論過程 |
| 重要な事実 | ファイルパス、関数名、設定値、エラーの重要な行 | ファイルの全内容、長大なログ |
| 重要な決定 | 選択した方針とその理由 | 却下された方針についての詳細な議論 |
| 次のアクション | やることリスト、未解決の問題 | 完了済みで、その後に影響しない詳細 |
要約戦略を実践する5つのステップ
- システムプロンプトを必ず保持する:システムプロンプトは圧縮の対象にせず、常にmessagesの先頭に置きます。
- 直近N往復を原文のまま保持する:直近の数往復は現在の操作と密接に関係していることが多いため、そのまま残し、それより前の部分だけを圧縮します。
- 構造化された要約テンプレートを使う:要約モデルに「目標 / 進捗 / 事実 / 決定 / 次のステップ」の5項目で出力するよう指示し、自由な要約による情報の抜け漏れを防ぎます。
- ツールの結果を先に軽量化する:非常に長いツールの返却結果は、エラーの最初と最後の数行や、検索結果のタイトルと結論など、重要な部分だけを残します。
- ユーザーの発言を別途保存する:ユーザーが示した明確な制約(「公開インターフェースを変更しない」など)は、モデルに書き換えさせず、一字一句そのまま保存することをおすすめします。
なかでも、構造化されたテンプレートが最も重要です。モデルは「自由な要約」では会話の雰囲気をまとめる傾向がありますが、項目を構造化することで、一つずつ確認させ、行動につながる状態情報を保持できます。
Agent のコンテキスト自動圧縮クイックスタート
ここでは、クライアント側で messages を手動管理する汎用的な実装を紹介します。OpenAI 互換のインターフェースであれば、どれでも利用できます。各ターンの呼び出し後に usage.prompt_tokens から入力トークン数を読み取り、しきい値を超えたら、過去の履歴を要約モデルに渡して圧縮する仕組みです。
最小限のサンプル
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "system", "content": "你是一个编码助手。"}]
messages.append({"role": "user", "content": "帮我检查这个函数的边界条件"})

resp = client.chat.completions.create(model="gpt-4o-mini", messages=messages)
messages.append({"role": "assistant", "content": resp.choices[0].message.content})

# 每轮记录输入 Token,作为是否压缩的判断依据
print("本轮输入 Token:", resp.usage.prompt_tokens)
Agentのコンテキスト自動圧縮の実装コード全体を見る
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MAIN_MODEL = "gpt-4o-mini"      # 主任务模型,可按需替换
SUMMARY_MODEL = "gpt-4o-mini"   # 摘要模型,可用更便宜的模型
TOKEN_THRESHOLD = 100_000       # 输入 Token 阈值,兜底触发
KEEP_RECENT = 6                 # 保留最近 N 条消息原文

SUMMARY_PROMPT = """请把以下 Agent 对话历史压缩为任务状态摘要,严格按五个栏目输出:
【任务目标】用户原始需求与硬性约束(约束请逐字保留)
【当前进度】已完成的步骤与当前阶段
【关键事实】文件路径、函数名、配置值、关键报错
【已做决策】采用的方案及原因
【下一步行动】待办事项与未解决问题
不要记录寒暄和推理过程,不要编造历史中没有的信息。"""


def compact(messages: list) -> list:
    """把早期历史压缩为一条摘要消息,保留系统提示与最近对话。"""
    system_msg = messages[0]
    old = messages[1:-KEEP_RECENT]
    recent = messages[-KEEP_RECENT:]
    if not old:
        return messages

    history_text = "\n".join(f"[{m['role']}] {m['content']}" for m in old)
    resp = client.chat.completions.create(
        model=SUMMARY_MODEL,
        messages=[
            {"role": "system", "content": SUMMARY_PROMPT},
            {"role": "user", "content": history_text},
        ],
    )
    summary = resp.choices[0].message.content
    summary_msg = {"role": "user", "content": f"(以下为之前对话的压缩摘要)\n{summary}"}
    return [system_msg, summary_msg] + recent


class CompactingAgent:
    def __init__(self, system_prompt: str):
        self.messages = [{"role": "system", "content": system_prompt}]
        self.last_prompt_tokens = 0

    def chat(self, user_input: str) -> str:
        # 时机一:上一轮输入 Token 超过阈值时先压缩
        if self.last_prompt_tokens > TOKEN_THRESHOLD:
            self.messages = compact(self.messages)

        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MAIN_MODEL, messages=self.messages)
        reply = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": reply})
        self.last_prompt_tokens = resp.usage.prompt_tokens
        return reply

    def finish_stage(self):
        # 时机二:完成一个任务阶段后主动压缩
        self.messages = compact(self.messages)
        self.last_prompt_tokens = 0


agent = CompactingAgent("你是一个严谨的编码助手。")
print(agent.chat("帮我定位登录接口偶发 500 的原因"))
agent.finish_stage()  # 修复完成后,在阶段边界主动压缩
🚀 クイックスタート:APIYIのapiyi.comに登録すると、無料のテスト枠を利用できます。上記のコードは、APIキーを置き換えるだけで実行できます。OpenAI互換のインターフェースに対応しており、メインモデルと要約モデルにはそれぞれ異なるメーカーのモデルを選べるため、コストを管理しやすくなります。
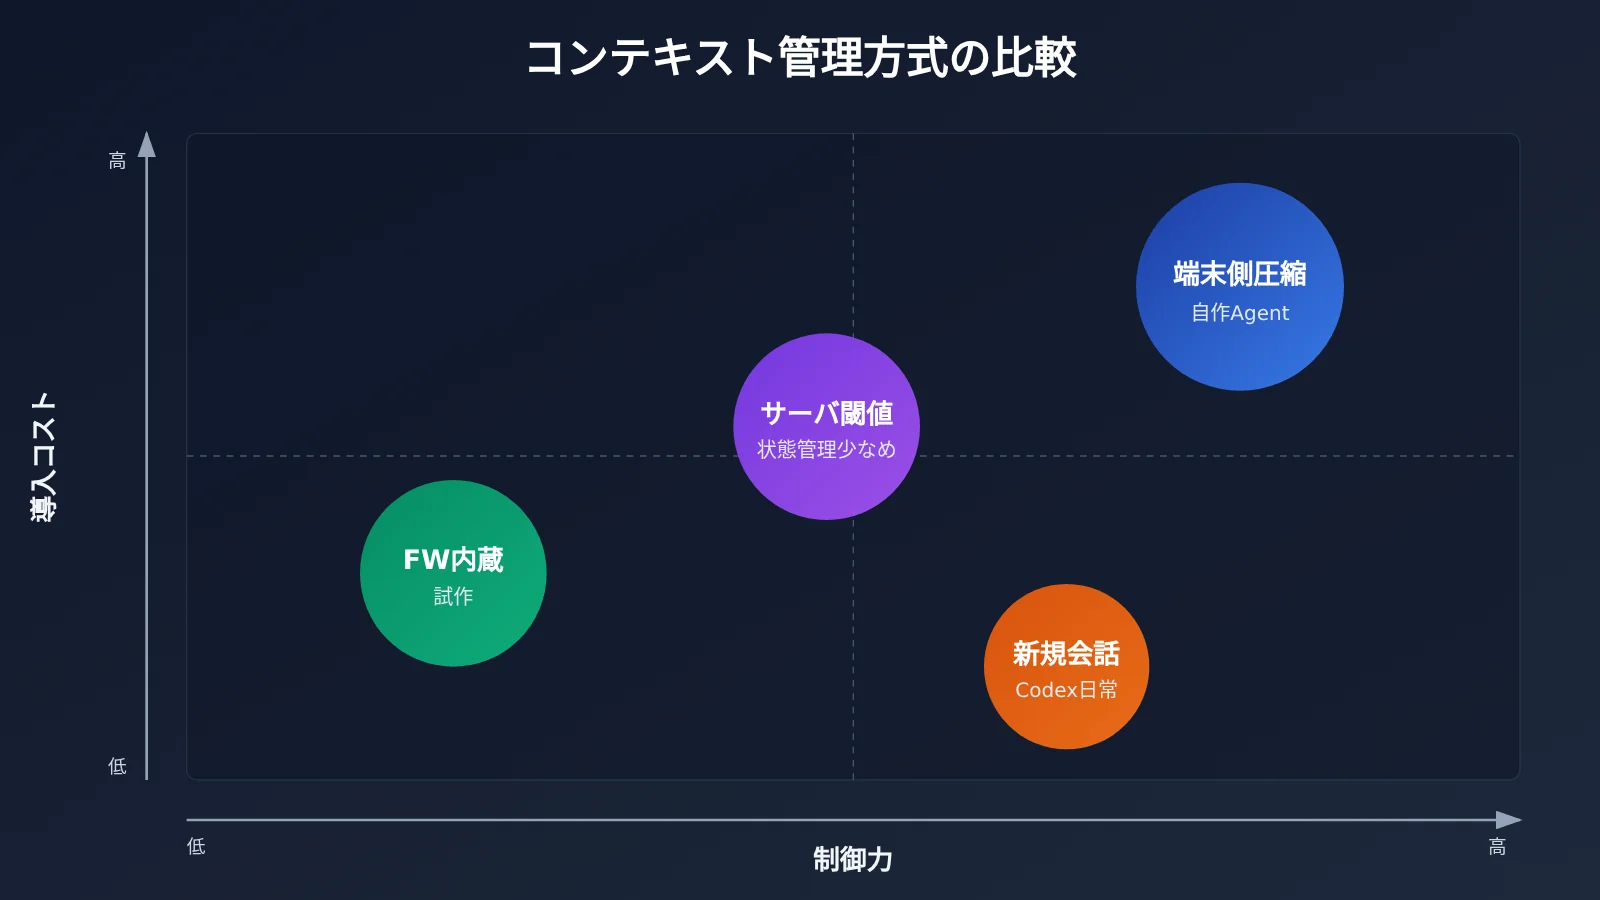
Agentのコンテキスト自動圧縮:実装方法の比較
| 方法 | 主な特徴 | 適した場面 | 利用可能なプラットフォーム |
|---|---|---|---|
| クライアント側での手動圧縮 | messagesを自分で組み立て、要約ロジックを完全に制御できる | 自社開発のAgent、要約テンプレートをカスタマイズしたい場合 | APIYI apiyi.com、各社の公式API |
| サーバー側での閾値による圧縮 | Responses APIのcompact_thresholdなどを利用 |
クライアント側の状態管理を減らしたい場合 | 対応するインターフェースを提供するプラットフォーム |
| フレームワーク組み込みの圧縮 | Agents SDKやTool Runnerが自動管理 | プロトタイプの構築、汎用的なタスク | 対応するSDKに依存 |
| 新しいセッションを開始 | 手動で要約してから新しいウィンドウを開く | Codexなどのクライアントを日常的に使用する場合 | 任意のクライアント |
クライアント側での手動圧縮は制御の自由度が高い一方、トークン数の管理や要約品質の維持を自分で行う必要があります。サーバー側の圧縮は履歴を組み立てる手間を省けますが、要約の詳細は開発者から見えません。自社開発のAgentでは、「クライアント側の構造化された要約+閾値によるバックアップ」を組み合わせるのが、一般的にはより堅実です。
Agentのコンテキスト自動圧縮とキャッシュコストの関係
圧縮すれば必ずコストを削減できるように思えますが、プロンプトキャッシュも考慮する必要があります。APIYIのOpenAIキャッシュ料金に関する説明によると、キャッシュにヒットした入力部分は、通常の入力料金の10%で課金されます。長い会話では、過去のメッセージが先頭部分にそのまま保持されているとキャッシュにヒットしやすく、各ターンで新たに「通常料金」が適用されるトークンは実際にはそれほど多くありません。
いったん圧縮を実行すると、メッセージの先頭部分が新しい要約に置き換わるため、次のリクエストではキャッシュが無効になり、通常料金で再計算されます。これが、公式が「毎ターンの圧縮」を推奨しない理由です。頻繁に圧縮するとキャッシュが繰り返し途切れ、かえって圧縮しない場合より高くつくこともあります。より合理的なのは、一定の段階では履歴をそのまま増やしてキャッシュを十分に活用し、段階の終了時やしきい値に近づいたときにまとめて圧縮する方法です。
よくある質問 FAQ
Q1: Agentのコンテキスト自動圧縮とは何ですか?
コンテキストが一定のトークン数に達したときや、タスクのフェーズの区切りに到達したときに、過去の会話やツール呼び出しの記録をタスク状態の要約にまとめ、元の履歴と置き換えることです。各ターンの入力トークンを削減しながら、進捗、事実、決定事項、次のアクションを保持し、Agentが作業を続けられるようにします。
Q2: コンテキストの圧縮と履歴の単純な切り捨てはどう違いますか?
切り捨ては古いメッセージを削除するだけなので実装は簡単ですが、ユーザーの当初の要件や制約が失われます。一方、圧縮はモデルを使って履歴を構造化された要約にまとめるため、情報をより多く保持できます。その代わり、要約のためのモデル呼び出しが1回増え、圧縮後にキャッシュを再構築する必要があります。
Q3: 「80%まで使ったら圧縮する」という共通ルールはありますか?
ありません。公式ドキュメントでは主にトークン数のしきい値で実行条件が定義されています。例えば、Anthropic Messages APIではデフォルトが150,000、最小が50,000、Tool Runnerではデフォルトが100,000です。しきい値は、使用するモデルのコンテキストウィンドウのサイズと、1回のツール出力の量に合わせて設定しましょう。
Q4: Codexではどのタイミングで新しいウィンドウを開くべきですか?
機能の開発が完了してテストに合格したときなど、タスクのフェーズがひと区切りついた後に新しく開くのがおすすめです。新しいウィンドウを開く前に、Agentに「目標 / 進捗 / 事実 / 決定事項 / 次のステップ」の形式で要約を出力させ、新しいセッションの冒頭に貼り付けるとよいでしょう。現在のタスクと無関係な話題に切り替える場合も、新しいウィンドウを開けば、無関係な履歴による継続的な使用枠の消費を避けられます。
Q5: クライアントにコンテキストの使用量が表示されない場合、トークン消費量をどう確認できますか?
APIレベルで確認できます。OpenAI Codexの利用シナリオに関するドキュメントに従ってCodexの接続先をAPIYIに設定すると、呼び出しのたびにAPIYI(apiyi.com)の管理画面に詳細なログと使用量の統計が記録されます。長い会話で各ターンの入力トークンがどのように増えているかを確認し、圧縮や新しいセッションを開始するタイミングを判断できます。
Q6: 自分の圧縮戦略の効果を手早く検証するにはどうすればよいですか?
本記事の完全なコードを使い、「圧縮なし」「しきい値による圧縮」「フェーズごとの圧縮」の3つのモードで同じ複数ステップのタスクを実行し、総トークン消費量とタスクの完了品質を比較します。APIYI(apiyi.com)では、1つのAPIキーでメインモデルと要約モデルに異なるメーカーのモデルを使用できるため、コストと品質のバランスを見つけやすくなります。
Q7: コンテキスト圧縮にはどのような既知の制限がありますか?
まず、要約で細部が抜け落ちる可能性があります。特に、コード内の目立たない設定値などは見落とされやすい点です。また、圧縮のたびにキャッシュが無効になるため、頻繁に圧縮するとコストが増加します。さらに、要約モデルが存在しない情報を「補完」してしまうこともあります。対策として、構造化されたテンプレートを使い、ユーザーの制約を一字一句そのまま保持しましょう。ファイルパスなどの重要な事実は、要約だけに頼らず、外部のタスクメモファイルにも書き留めておきます。
Agentのコンテキスト自動圧縮:重要ポイント
- 圧縮の本質:長い履歴を単に削るのではなく、作業を続行できるタスク状態に変換することです。
- 3つの発動タイミング:Tokenのしきい値による最終手段、段階の区切りでの能動的な圧縮、フレームワークによるコンテキスト負荷に応じた管理があります。
- 80%ルールはない:公式の基準はToken数のしきい値です。ウィンドウのサイズやツール出力の量に合わせて設定します。
- 構造化された要約:目標、進捗、事実、決定事項、次のステップの5項目で出力し、ユーザーの制約は一字一句そのまま残します。
- 毎ターン圧縮しない:頻繁な圧縮はキャッシュヒットを妨げるため、段階ごとにまとめて圧縮するほうがコストを抑えられます。
- ログで見えない部分を補う:クライアントで使用量が表示されない場合は、APIYI apiyi.comの呼び出しログで各ターンのToken増加量を確認できます。
まとめ
Agentのコンテキスト自動圧縮の重要ポイントは次のとおりです。
- 発動タイミング:段階の区切りでの能動的な圧縮を基本とし、Tokenのしきい値による発動を最終手段にします。手早く始めるなら、フレームワークの組み込み戦略が適しています。
- 要約戦略:システムプロンプトと直近数ターンの原文を残し、それ以前の履歴を5項目の構造化された要約に圧縮します。
- コストのバランス:圧縮するとキャッシュが無効になるため、「段階内では安定して増やし、段階の終わりにまとめて圧縮する」というペースが適切です。
普段Codexを使っているなら、「段階が完了したら要約して新しいウィンドウを開く」を手動版の圧縮として実践できます。Agentを自作しているなら、この記事のコードをそのまま改造して使えます。効果を手早く検証するには、APIYI apiyi.comがおすすめです。無料のテスト枠と複数モデルに対応した統一インターフェースが提供されており、呼び出しログと組み合わせることで、圧縮前後のToken数の変化を明確に確認できます。
📚 参考資料
- OpenAI Responses API ドキュメント:コンテキスト圧縮と
compact_thresholdの設定 - リンク:
platform.openai.com/docs/api-reference/responses -
内容: サーバー側での自動圧縮と状態管理に関する公式説明
-
OpenAI Agents SDK ドキュメント:Agent 実行時のコンテキスト管理戦略
- リンク:
openai.github.io/openai-agents-python -
内容: 自動圧縮、固定しきい値、強制圧縮などの設定方法
-
Anthropic コンテキスト圧縮ドキュメント:Messages API と Tool Runner の圧縮トリガーパラメータ
- リンク:
docs.anthropic.com - 内容:
trigger.value、context_token_thresholdのデフォルト値と、必要に応じた圧縮方法
著者: APIYI 技術チーム
技術に関するお問い合わせ: APIYI の公式サイトからお気軽にお問い合わせください。Codex の設定、複数ターンの対話、キャッシュの課金などに関する資料は、ドキュメントセンター docs.apiyi.com をご覧ください。