筆者注:オープンソース化済みの Kimi K3 の実測データをもとに、K3.1 Pro をローカル環境に導入する際のハードウェア要件、月額コスト、100万トークンあたりのコスト、損益分岐点を試算します。レンタル、購入、API利用のどれを選ぶべきか判断するための参考にしてください。
まず結論です。Kimi K3.1 Pro はまもなくオープンソース化される予定ですが、ローカル導入は個人向けではありません。 公式発表によると、完全な重みは11月4日までに公開される予定で、3Tクラスのオープンソース重みモデルとして位置づけられています。2026年10月26日時点では、K3.1 Pro の重みはまだ公開されていません。この記事に記載するハードウェア要件とVRAMの数値は、すべてオープンソース化済みの Kimi K3 の実測値をもとに試算したものです。重みの公開後に再検証が必要です。
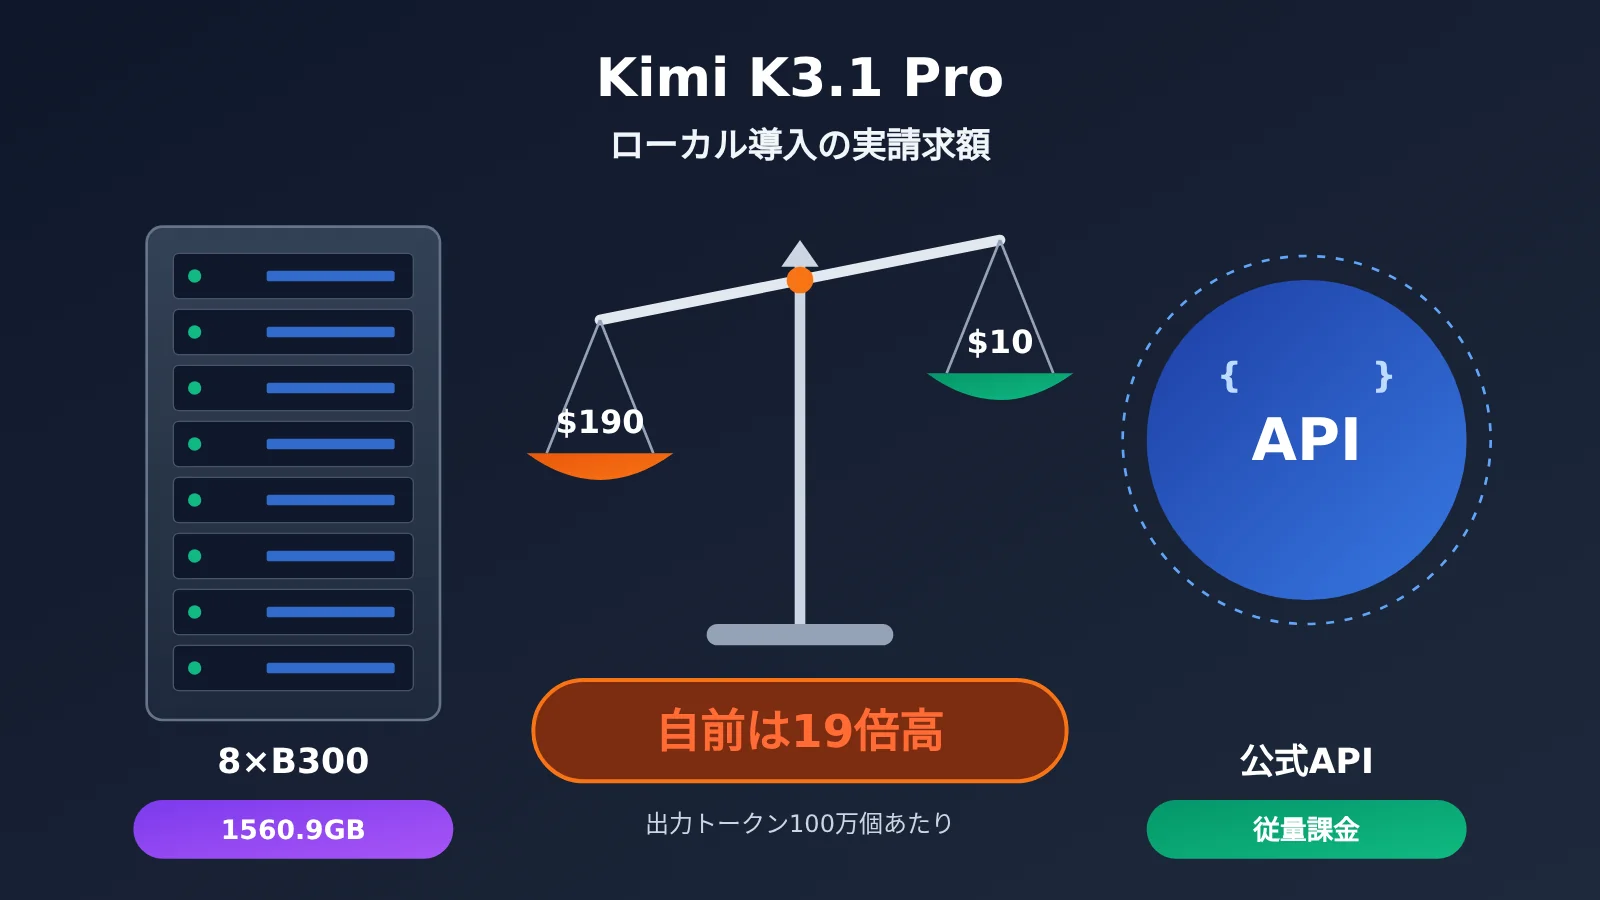
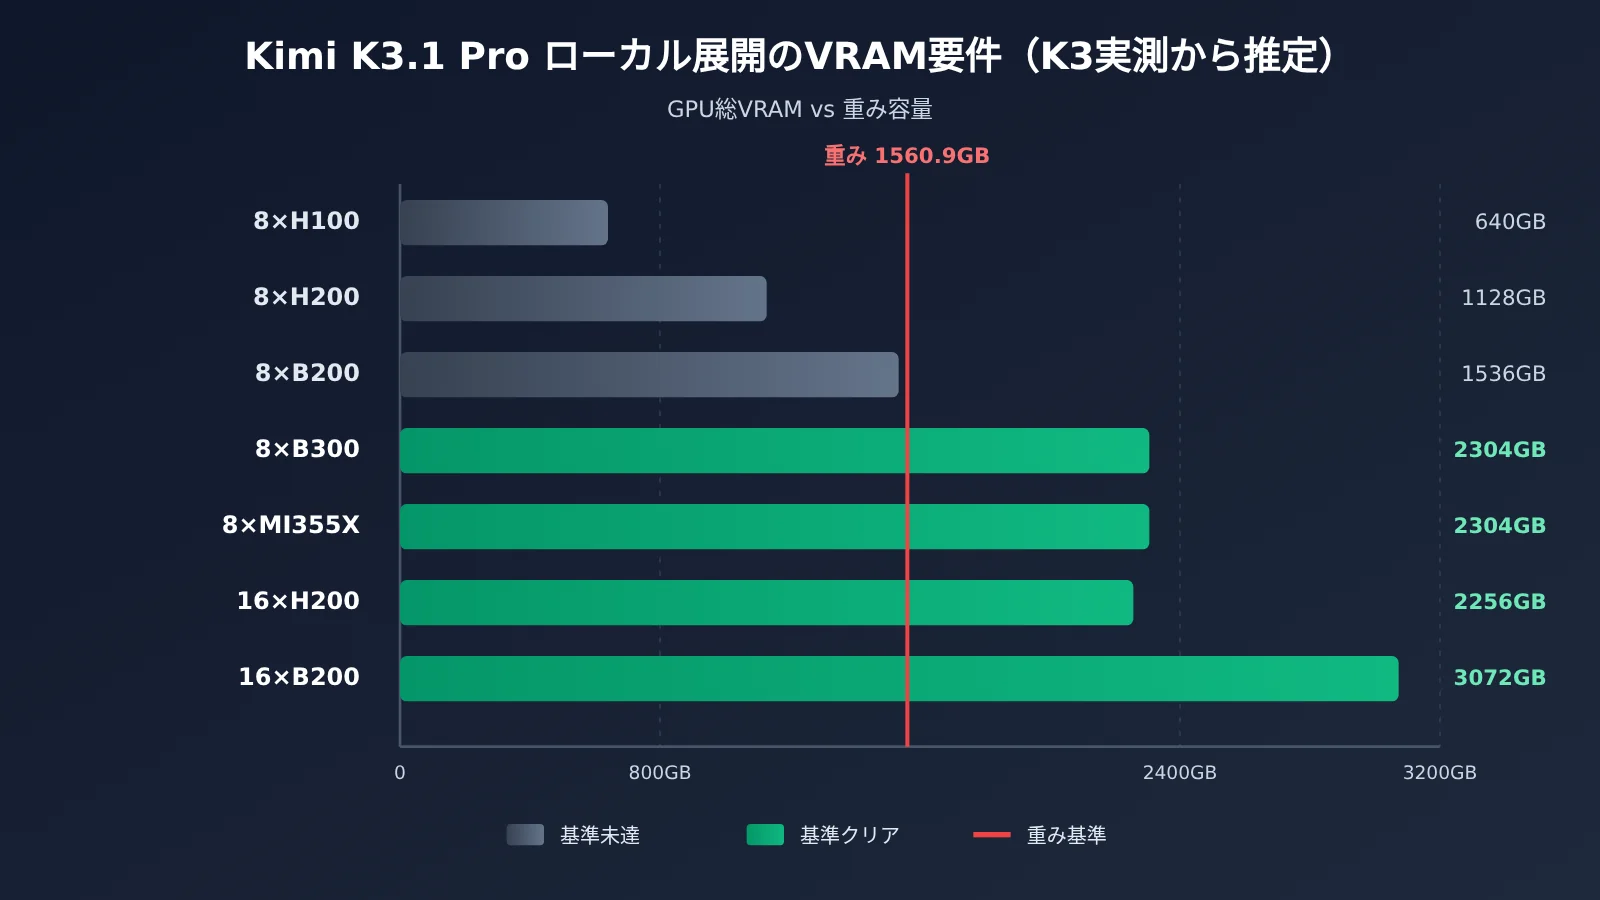
K3 の実測では、重みだけで1,560.9GBあります。B300を8枚搭載すればかろうじて収まりますが、H200を8枚搭載しても約400GB不足します。B300を8枚搭載したマシンを自分だけで使う場合、100万出力トークンあたりのコストは約190.00ドル。公式APIの10.00ドルと比べて、19倍です。
これは導入を思いとどまらせるための記事ではありません。「自前で運用すべきか」を判断するためのガイドです。各数値には、公式発表、第三者による実測、筆者の試算のどれに当たるかを明記しています。ご自身の利用量に当てはめて計算できます。
この記事のポイント:読み終えるころには、Kimi K3.1 Pro を自前で運用する場合の実際のコストを把握し、チェックリストを使って、マシンをレンタルするか、購入するか、APIを利用するか判断できるようになります。
Kimi K3.1 Proのローカルデプロイに関する重要ポイント
| 要点 | 結論 | 事実の区分 |
|---|---|---|
| 重みの公開状況 | まだ公開されておらず、公式発表では11月4日までに公開予定 | 公式発表 |
| 重みの容量 | K3の重みは1560.9GB。K3.1 Proは同じアーキテクチャを採用 | 第三者による実測(K3) |
| 最低構成の単体マシン | 8×B300 / 8×GB300 / 8×MI355X | 推論フレームワークの構成例+実測 |
| 自前運用時の単価 | 出力100万トークンあたり約$190.00 | 第三者の実測請求額 |
| APIと同等のコストになる条件 | 長期にわたり安定して1,500 tok/s以上で出力 | 本記事の推定 |
Kimi K3.1 Proのローカルデプロイに関する事実の区分
本記事では、事実を3つの区分に分けています。読み進める際は、それぞれを区別してください。公式発表は、Moonshotがkimi.aiのブログ、platform.kimi.aiのドキュメント、Hugging Faceのモデルカードで示している内容を指します。第三者による実測は、AWS、GPUStack、OpenZeka、Modalのユーザーなどが公開したテストデータを指し、記事内に出典と日付を記載します。本記事の推定は、公開価格とスループットをもとに算出した結果です。計算式と前提条件を示しますが、公式データではありません。
推定の根拠にも、公式情報を用いています。K3.1 ProはKimi K3の後学習版(post-trained version of Kimi K3)で、アーキテクチャを引き継ぎ、RLの後学習に使う計算量を増やしたモデルです。そのため、K3のパラメーター数、量子化形式、重みの容量は、K3.1 Proをデプロイする際の下限を見積もるための妥当な参考値になります。
Kimi K3.1 Proのローカルデプロイに必要なハードウェア:なぜB300が8基必要なのか
【公式情報】K3のモデルカードによると、総パラメータ数は2.8T、アクティブパラメータ数は104B、層数は93です。ルーティングされるエキスパートは896個で、各トークンにつき16個を選択します。さらに、共有エキスパートが2個あります。コンテキストウィンドウは1,048,576です。重みにはMXFP4、アクティベーションにはMXFP8を採用し、SFT段階から量子化を考慮した学習を行っています。
【第三者による実測】Hugging Faceリポジトリ内のファイルを個別に集計した結果、96個のsafetensorsシャードの合計は1,560,936,091,448バイト、約1,560.9GBでした。実測サイズが「2.8T × 0.5 byte = 1,400GB」という理論値を上回るのは、configで注意機構、共有エキスパート、lm_head、ビジョンタワーなどがホワイトリストに登録され、高精度のまま保持されているためです。vLLMのレシピでは、必要な最小GPUメモリは1,680GBとされ、少なくとも8基のGB300が必要と明記されています。実際の本番トラフィックに対応するには、複数ノードが必要です。
| 構成 | 合計GPUメモリ | 実行可否 | 説明 |
|---|---|---|---|
| 8×H100 80GB | 640GB | 不可 | 重みのサイズはGPUメモリの2.4倍 |
| 32×H100 | 2.56TB | ぎりぎり可能 | SGLangのレシピはありますが、HopperはMXFP4をネイティブサポートしていないため、実行時に逆量子化が必要 |
| 8×H200 141GB | 1.13TB | 不可 | 約400GB不足。惜しい構成です |
| 16×H200(2台) | 2.26TB | 可能 | 同様に逆量子化が必要 |
| 8×B200 180GB | 1.44TB | 不可 | 約120GB不足 |
| 16×B200 / GB200 | 2.88TB | 可能 | Blackwellのリファレンス構成 |
| 8×B300 / GB300 | 2.30TB | 可能 | 公式のデフォルト構成。1台にぎりぎり収まる |
| 8×MI355X | 2.30TB | 可能 | AMDによるday-0検証済み |
| 単体GPU / RTX 4090 / 512GB Mac | — | 不可 | RTX 4090では、重みを格納するだけでも75枚必要 |
KVキャッシュは、むしろボトルネックではありません。K3ではGated MLAを使うのは24層のみで、トークンあたり約27KiBです。残りの69層ではKDAを採用しており、シーケンスごとに必要な状態は固定です。第三者による計算では、コンテキスト長が1Mの場合、ユーザー1人あたりのKVキャッシュは約29.5GB、8Kの場合は約0.7GBです。本当のボトルネックは、1.56TBに及ぶ重みそのものです。
それでもデプロイする場合は、フレームワーク側の以下の必須条件を確認してください(vLLMのレシピとSGLangのCookbookに基づく、K3向けの情報です)。
- vLLMイメージ:
vllm/vllm-openai:kimi-k3。CUDA 13版のみで、ドライバーはr580以降、vLLMは0.27.0以降が必要 - 並列化方式:TP / TEPは最低8基、DEPは最低16基が必要。分散KVキャッシュは、記載されているすべてのハードウェアで非対応
- SGLangのノード構成:B300は1ノード・8基、B200とH200はどちらも2ノード・8基が必要
- Moonshotによる2026年8月時点の見解(第三者による伝聞):本番環境では64基以上のアクセラレーターを搭載したスーパーノードを推奨
Kimi K3.1 Proのローカル導入にかかる実際の費用:4つの方法の月額コスト
以下では、B300を8基搭載したサーバー1台を24時間365日稼働させる場合の月額コストを試算します。為替レートは一律で1米ドル=7.25元とします。価格の出典は、ComputeUnionが2026年10月24~25日に収集した従量課金の料金、Modalのユーザーによる実測請求額、「演算能力レンタル業界調査」の議事録(2026年5月20日、新浪財経転載)の3種類です。
⚠️ 中国国内のサーバー一式のレンタル・購入価格(H200が1台あたり月約8万元、B300の5年契約が1台あたり月16~19万元、B300のスポット価格が1台あたり680~700万元など)は、業界調査に基づくもので、メーカーの公開価格ではありません。あくまで価格帯の参考としてご覧ください。主流の契約対象は8基搭載のサーバー一式で、契約期間は最低1年です。
| 方法 | 計算条件 | 月額コスト | 備考 |
|---|---|---|---|
| 海外の従量課金レンタル(24時間365日) | B300サーバー一式:1時間あたり342~464元 × 730時間 | 約24.98~33.87万元(3.45~4.67万米ドル) | 第三者の料金情報+本記事の試算 |
| Modalの実測(24時間365日) | 1時間あたり56.79米ドル × 730時間 | 41,457.00米ドル、約30.06万元 | 第三者による実測請求額 |
| 中国国内での5年契約レンタル | 業界調査に基づく | 16~19万元 | 非公開価格。最低契約期間は1年 |
| 買い切り+電気代 | 680~700万元を3年間で定額償却し、電気代約0.88万元を加算 | 約19.8~20.3万元 | 運用エンジニアの人件費、予備部品、設置場所、帯域幅は含まない |
| 1日4時間だけ稼働して停止 | 海外の従量課金 | 約2.6~3.0万元 | 再起動のたびに約27分のコールドスタートが発生 |
電気代は本記事の仮定に基づく試算です。負荷は13.2kW、PUEは1.3、電気料金は1kWhあたり0.7元とし、1時間あたりの電気代は約12元です。買い切りの方法が最も安く見えますが、表には運用エンジニアの人件費を含めていません。小規模チームにとって、これは最大の隠れたコストです。
「1日4時間だけ稼働して停止すればよい」と考えると節約できそうですが、実際には簡単ではありません。Modalの実測ではコールドスタートに約27分かかり、1.56TBの重みの読み込み、JITコンパイル、51個のCUDAグラフのキャプチャが必要です。短時間のタスクでは、推論そのものより起動待ちのほうが長くなることもあります。
Kimi K3.1 Proの単位コスト:スループットによってAPIより何倍高くなるかが決まる
月額料金は表面的な請求額にすぎません。本当にコストパフォーマンスを左右するのは、100万トークンあたりの単位コストです。この記事では、次の式で試算します。100万出力トークンあたりのコスト = 1時間あたりのマシンコスト ÷ 1時間あたりの出力トークン数(百万単位)。分子には、Modalでの実測値である56.79ドル/時間を一律に使用しています。
【第三者による実測】8×B300構成でのスループットデータは次のとおりです。
- Modalの単機構成(TP8、ネイティブMXFP4):安定稼働時は92 tok/s、TTFTは0.92~1.02秒
- OpenZeka(DGX B300、TP8、vLLM):同時実行数1で105.7 tok/s、同時実行数64では1人あたり32.45 tok/s。チャットなら150人、Agentなら50人をサポートできると推定
- AWS公式サンプル(2026年7月29日、p6-b300.48xlarge):同時実行数8で516 tok/s、高負荷時の合計スループットは4,634 tok/s
- GPUStack(2026年7月30日):入力64K、同時実行数10の場合、vLLMのエンドツーエンド処理時間は100.5秒。prefillの合計スループットは約19K~23K tok/s
| 安定出力スループット | 1時間あたりの出力 | 100万出力トークンあたりのコスト | 公式APIの10.00ドルとの比較 |
|---|---|---|---|
| 92 tok/s(単一リクエストで最大稼働) | 0.33M | 171.50ドル(原著者の算出では190.00ドル) | 約17~19倍 |
| 500 tok/s | 1.80M | 31.50ドル | 約3倍 |
| 1,000 tok/s | 3.60M | 15.80ドル | 約1.6倍 |
| 1,500 tok/s | 5.40M | 10.50ドル | ほぼ同等 |
| 3,000 tok/s | 10.80M | 5.30ドル | 約半額 |
| 4,634 tok/s(AWSの実測ピーク) | 16.68M | 3.40ドル | 約3分の1 |
1人、あるいは数人で使う場合、実際のコストは1行目に近くなります。同時実行数が伸びないと、マシンの大半がアイドル状態になり、100万出力トークンあたりのコストは約190.00ドルに達します。これがタイトルの「19倍高い」の根拠です。自前で運用する場合にAPIと同等の単位コストを実現できるのは、スループットを長期にわたって1,500 tok/s以上に維持できる場合に限られます。
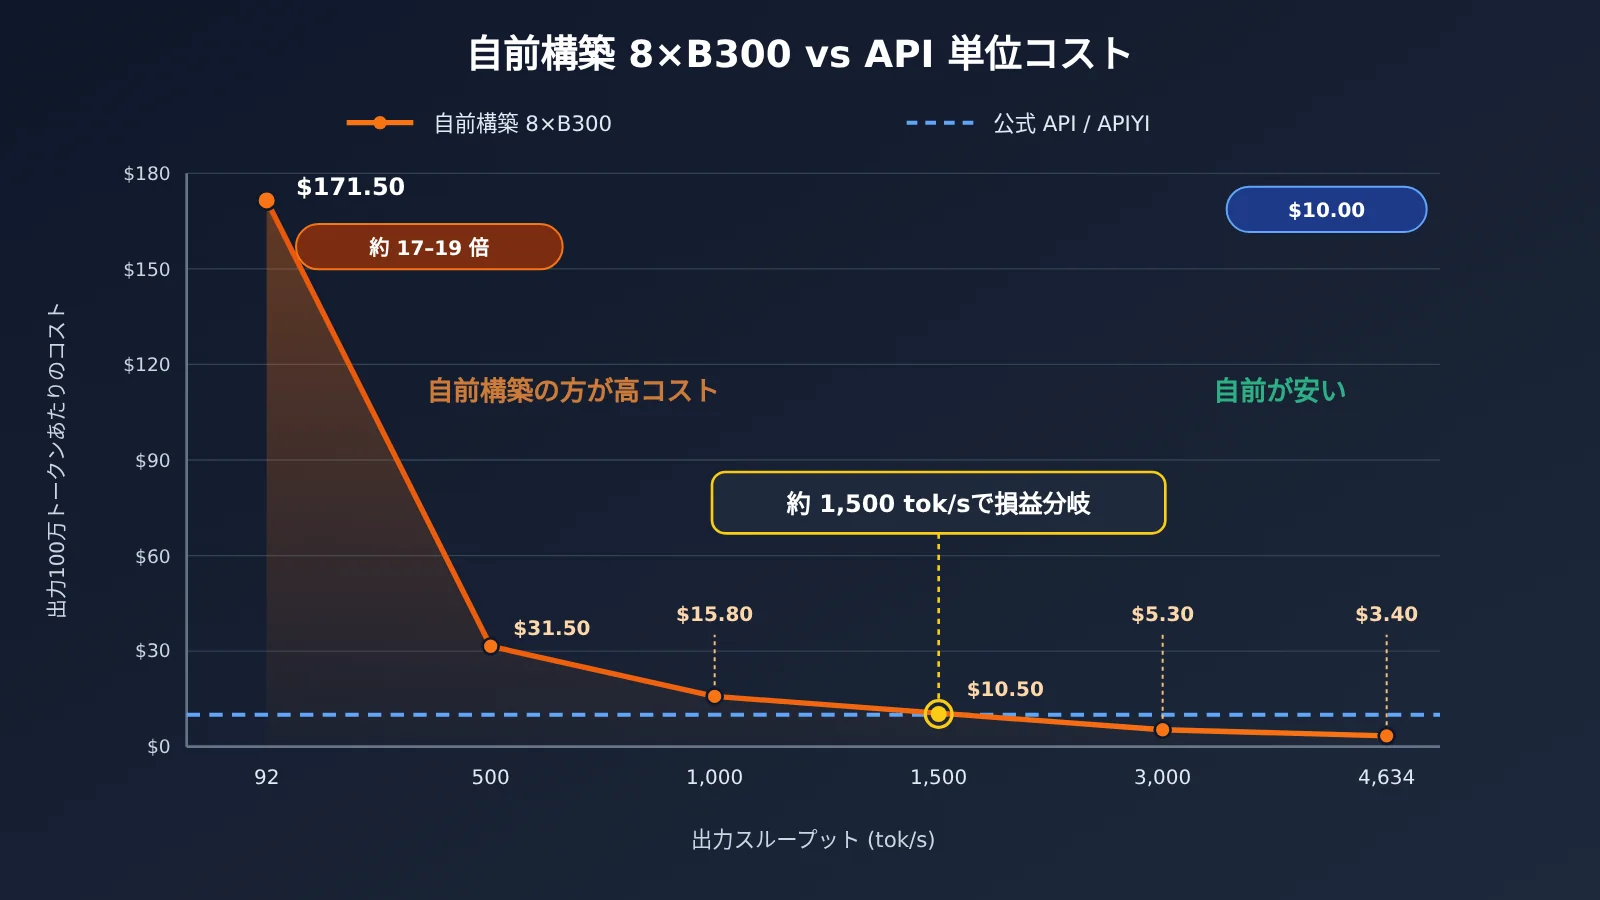
💡 比較について:上図のAPI基準線には、公式料金の100万出力トークンあたり10.00ドルを使用しています。APIYI apiyi.comのkimi-k3.1-proの出力料金は公式と同額のため、そのまま比較対象にできます。
Kimi K3.1 Proのローカル導入で損益分岐点を超えるには、毎月どれだけのトークンが必要か
別の視点から考えてみましょう。毎月どれだけのトークンを使えば、自前で運用した場合にAPIとコストが同等になるのでしょうか。以下の試算では、公式APIの料金を入力 $2.00/出力 $10.00 とし、入力と出力の比率を5:1(一般的なAgentの利用シーンを想定)としています。キャッシュヒットは考慮していません。
| 自前運用の方法 | 月額コスト | 損益分岐に必要な月間入力トークン数 | 損益分岐に必要な月間出力トークン数 |
|---|---|---|---|
| 海外で従量課金、24時間365日稼働 | $41,457.00 | 約104億 | 約20.7億 |
| 国内の5年リース一体型サーバー | 19万元 | 約65.5億 | 約13.1億 |
| 買い切り(減価償却費+電気代) | 20.3万元 | 約69.8億 | 約14億 |
毎月十数億の出力トークンとは、どれほどの量でしょうか。OpenZekaの試算では、8×B300の1台でAgentの同時利用ユーザーを50人支えられます。10人以下の小規模チームでは、この規模には到底届きません。
見落としがちな要素がもう一つあります。それはキャッシュです。公式APIのキャッシュヒット料金は100万トークンあたりわずか $0.20 で、Agentや長文ドキュメントを扱う場面では、キャッシュヒット率も一般に低くありません。キャッシュの割合が高いほどAPIのコストは下がり、自前運用との損益分岐点はさらに上がります。
Kimi K3.1 Proを自前で運用すべきケース
自前での運用が不可能というわけではありませんが、明確な理由が必要です。次のようなケースでは、自前での運用が妥当な選択肢になります。
- コンプライアンスやオフライン運用が必須:データを社内ネットワークの外に出せない、物理的な隔離が必要といった場合は、APIがどれだけ安価でも利用できません。ただし、公式APIはすでにゼロデータ保持(ZDR)に対応しています。まずは、それでコンプライアンス要件を満たせるか確認しましょう。
- ファインチューニングや蒸留を行いたい:K3.1 Proをベースに特定分野向けの追加学習を行う、または30B〜120Bクラスの小型モデルに蒸留する場合は、完全な重みを入手する必要があります。
- 遊休GPUと専任の運用担当者がいる:8×B300、8×MI355X、またはH200を2台、すぐに使える状態で保有し、さらにvLLM/SGLangに詳しいエンジニアが運用を担当できるなら、追加コストを抑えられます。
- 十分な利用量がある:長期にわたって安定的に1,500 tok/s以上を処理でき、月間の出力が10億トークン規模に達する場合です。
ライセンスも事前に確認しておきましょう。K3はKimi K3 Licenseを採用しており、第三者による要約によれば、モデルサービスの外部提供による年間収入が2,000万ドルを超える場合は、別途ライセンスが必要です。K3.1 Proのライセンスは、重みの公開後にHugging FaceリポジトリのLICENSEを確認してください。現時点では、公式に代わって結論を出すことはできません。
Kimi K3.1 Proを自前で構築しないほうがいいケース
次のような目的であれば、自前で構築すると損をする可能性が高いです。
- コストを抑えたい:スループットが長期的に1,500 tok/sを超えない限り、単位コストはAPIより高くなります。個人利用では約19倍です。
- 長時間のタスクを実行しつつ、必要に応じて起動・停止したい:コールドスタートに約27分かかるため、必要なときだけ起動・停止する運用はほぼ現実的ではありません。
- 自分や小規模チームだけで使いたい:同時実行数を十分に確保できず、毎時$56.79を払って92 tok/sの速度を得ることになります。
- 量子化すれば1台に収まると期待している:コミュニティによる方法は、いずれも本番環境での利用には向きません。Unsloth 1-bit(UD-IQ1_S、594GB)は、8×A100で約9 tok/sです。出力100万トークンあたりに換算すると$620.00で、フルモデル構成より3.3倍高くなります。また、1-bitモデルとフルモデルのtop-1一致率は約79%です。
kimi-k3-in-cは8.24GBのメモリでフルウェイトを実行できますが、速度は1トークンあたり10〜32秒で、技術デモの域を出ません。
本当に「ローカルで実行」するのに適しているのは、今後コミュニティから登場する蒸留版です。それまでは、個人や小規模チームにとってAPIを使うのが最も手軽です。
Kimi K3.1 Proをすぐに使う:まずAPIで業務を動かす
自前で構築するか決める前に、まずはAPIで実際の業務を1か月ほど運用し、入力・出力・キャッシュヒットの実際の割合を確認することを強くおすすめします。そのうえで、上記の損益表を使ってコストを計算しましょう。APIYI apiyi.comではkimi-k3.1-proを提供しており、価格は公式と同じです。入力$2.00 / 出力$10.00 / キャッシュ読み取り$0.20(単位:100万トークンあたりの米ドル)。モデル名と価格は、プラットフォームのモデル一覧をご確認ください。
接続時のポイント(OpenAI互換インターフェース):
- APIYI apiyi.comに登録してAPIキーを作成します。新規ユーザーには無料のテスト枠があります。
- SDKのbase_urlを
https://api.apiyi.com/v1に設定します。 - モデルIDに
kimi-k3.1-proを指定します。速度を重視する場合はkimi-k3.1-pro-highspeed(入力$4.00 / 出力$20.00)に変更できます。 - 推論強度パラメーター
reasoning_effortは、low/high/maxから選べます。公式のデフォルトはmaxです。公式の評価設定はtemperature = 1.0、top_p = 0.95です。 - 複数ターンの対話やツール呼び出しでは、
reasoning_contentを含むassistantメッセージをそのまま返す必要があります。返さないと、コンテキストに不整合が生じます。 - 統計スクリプトを用意し、
prompt_tokens、completion_tokens、キャッシュヒット量を日ごとに記録します。将来自前で構築するか判断する際の参考になります。
| モデル | 入力 | 出力 | キャッシュ読み取り | 利用可能なプラットフォーム |
|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | APIYI apiyi.com、Kimi公式API |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | APIYI、Kimi公式API |
| kimi-k3 | $3.00 | $15.00 | $0.30 | APIYI |
🚀 すぐに始める:プロジェクトがまだ検証段階なら、APIYI apiyi.comで同じAPIキーを使い、kimi-k3.1-proとほかの主要モデルを並行して試すのがおすすめです。まずはK3.1 Proが自分のタスクに最適かを確かめてから、自前で構築するか検討しましょう。
Kimi K3.1 Proのローカルデプロイに関するよくある質問
Q1:Kimi K3.1 Proの重みは、もうダウンロードできますか?
まだできません。公式発表では「The full model weights will be released by Nov 4」とされており、2026年11月4日までに公開される予定です。この記事のハードウェアに関する数値は、すでにオープンソース化されているK3をもとに推定しています。重みの公開後は、実際のファイルサイズを確認して改めて見直してください。
Q2:H200を8基搭載してもKimi K3.1 Proを動かせないのはなぜですか?
H200を8基搭載した場合の総VRAM容量は1.13TBですが、K3の重みは実測で1,560.9GBあり、約400GB不足します。また、HopperはMXFP4をネイティブサポートしていません。そのため、H200を16基搭載したマシンを2台使っても、実行時の逆量子化が必要になり、十分な速度が出ません。
Q3:「19倍高い」というのは、どのように算出していますか?
この数字はサードパーティによる実測値に基づいています。ModalでB300を8基使う場合、1時間あたり56.79ドルで、単一リクエストの定常状態における処理速度は約92 tok/sです。これを出力トークン100万件あたりのコストに換算すると約190.00ドルとなり、公式APIの出力料金10.00ドルで割ると19倍です。92 tok/sで厳密に計算すると171.50ドルですが、元記事の算出には実運用で発生するオーバーヘッドも含まれています。
Q4:小規模チームがKimi K3.1 Proを自前で運用して、コストを抑える方法はありますか?
基本的にはありません。機材を買い切る方法でも月額約20万元かかり、人件費は含まれていません。量子化して1台に詰め込む方法は、かえって高くつき、性能も下がります。小規模チームには、APIを従量課金で利用する方法が現実的です。たとえばAPIYI apiyi.com経由でkimi-k3.1-proを呼び出せば、使った分だけ支払えます。キャッシュヒットした分は、トークン100万件あたり0.20ドルです。
Q5:Kimi K3.1 ProをAPI経由ですぐに呼び出すには、どうすればよいですか?
APIYI apiyi.comに登録してAPIキーを取得し、base_urlを`https://api.apiyi.com/v1`、モデル名を`kimi-k3.1-pro`に設定してください。既存のOpenAI SDKのコードは、ほとんど変更せずに使えます。複数ターンの会話では、`reasoning_content`を引き継いで送信する必要がある点に注意してください。
Q6:Kimi K3.1 Proのローカルデプロイには、どのような既知の制約がありますか?
主に3点あります。1つ目は、コールドスタートに約27分かかるため、弾力的なスケーリングには向かないことです。2つ目は、vLLMのイメージがCUDA 13版のみで、ドライバーにはr580以降が必要なことです。古いクラスターでは、事前にアップグレードが必要です。3つ目は、一覧にあるハードウェアでは分散KVキャッシュがサポートされておらず、複数マシンへの拡張が制限されることです。
Q7:ローカルデプロイが現実的になるのは、いつごろですか?
コミュニティから30B〜120Bクラスの蒸留モデルが登場すれば、個人や小規模チームでもローカルで動かせるようになります。フルサイズの3Tクラスのモデルは、当面、データセンター級の負荷であり続けるでしょう。
Kimi K3.1 Proのローカルデプロイ:要点
- 重みは未公開:公式は11月4日までの公開を約束しています。現時点の数値はすべてK3をもとにした推定です
- 必要なハードウェア:重みのサイズは1,560.9 GB。単一マシンで動かすには、最低でも8基のB300、GB300、またはMI355Xが必要です
- 月額コストの目安:単一マシンを24時間365日稼働させる場合、月額約16万〜34万元。方式によって異なります
- 単位あたりのコスト:自前運用では出力トークン100万個あたり約190.00ドルで、公式APIの19倍です
- コストが見合う条件:長期的に1,500 tok/s以上のスループットを維持し、月間出力が10億トークン規模に達すること
- まず試す方法:まずはAPIYI(apiyi.com)経由で
kimi-k3.1-proを呼び出し、実際の業務で試しましょう。自前運用するかどうかは、データを見て判断できます
Kimi K3.1 Proのデプロイ方法:セルフチェックリスト
次の5つの質問に答えると、マシンをレンタルするか、購入するか、APIを使うかを判断できます。
- コンプライアンス要件によりデータを社内ネットワークの外に出せず、公式のZDRでも要件を満たせないか?——いいえなら、そのままAPIを使いましょう
- 微調整や蒸留のために重みを使う必要があるか?——はいなら、短期間だけ従量課金でマシンを借り、使い終わったら停止する方法を検討しましょう
- 月間出力トークン数が安定して13億を超えているか?——いいえなら、自前運用のほうが必ず高くつきます
- 空いている8基のB300/MI355X級マシンと、専任の運用担当者がすでにいるか?——はいなら自前運用を検討できます。そうでなければ、このためだけにマシンを購入するのは避けましょう
- 業務上、いつでも起動・停止でき、柔軟に規模を拡大・縮小する必要があるか?——はいなら、起動に27分かかる自前運用では間に合わないため、APIを選びましょう
まとめ
Kimi K3.1 Proをローカルで運用する際の要点は次のとおりです。
- 導入のハードルが高い:K3をもとに推算すると、重みのサイズは約1.56TB。8×B300でようやく搭載できます
- 個人利用には高コスト:単一マシンで運用した場合、出力100万トークンあたり約190.00ドル。API利用の約19倍です
- 大規模運用で初めて採算が合う:スループットが長期にわたって1,500 tok/sを超え、月間の出力が10億トークン規模になって、ようやく自社運用を検討する段階です
国内の大半の開発者や小規模チームにとっては、まずAPIで業務を動かし、利用量のデータを蓄積してから、自社運用する価値があるかを判断するのが適切です。Kimi K3.1 Proの呼び出しには、APIYI(apiyi.com)の利用がおすすめです。価格は公式と同じで、新規ユーザー向けの無料枠もあります。1つのAPIキーで、ほかの主要モデルも手軽に比較できます。
📚 参考資料
- Kimi K3.1 Pro公式発表ブログ:重みの公開時期とモデルの位置づけ
- リンク:
kimi.ai/blog/kimi-k3-1-pro -
説明:公式発表。重みが11月4日までに公開されることを確認できます
-
Kimi公式API料金表:K3.1 Proの入力・出力・キャッシュ料金
- リンク:
platform.kimi.ai/docs/pricing/chat -
説明:本記事でAPI料金との比較に使用した情報源です
-
Kimi K3モデルカード:アーキテクチャ、量子化、ライセンス
- リンク:
huggingface.co/moonshotai/Kimi-K3 -
説明:総パラメータ数2.8T、MXFP4量子化、Kimi K3 Licenseについて確認できます
-
vLLM Kimi K3 Recipe:最小VRAM容量とデプロイ要件
- リンク:
recipes.vllm.ai/moonshotai/Kimi-K3 -
説明:最低8×GB300、最小VRAM容量1,680GB
-
AWSによる8×B300の推論実測:スループットのデータ
- リンク:
github.com/aws-samples/sample-llm-inference-on-eks -
説明:高並列時の総スループットは4,634 tok/s
-
GPUStackによる8×B300の実測:長文コンテキストでのvLLMとSGLangの比較
- リンク:
cnblogs.com/gpustack/p/22073008 - 説明:入力64K/200K時のエンドツーエンド処理時間
著者:APIYI技術チーム
技術に関するお問い合わせ:APIYI公式サイトのトップページからお気軽にご連絡ください。モデル接続に関する資料は、docs.apiyi.comのドキュメントセンターでもご覧いただけます。